
Gemini 4 Carbon على Felo API: المواصفات والمعايير والأسعار وحالات الاستخدام

Gemini 4 Carbon على Felo API: ميزانية موحدة تبلغ مليون رمز، ومستويات التفكير، وحدود الإدخال متعدد الوسائط، ونتائج المعايير المنشورة، والأسعار الفعلية، وطريقة استدعاء النموذج.
يُعد Gemini 4 Carbon من Google النموذج المخصص للمهام التي تتجاوز نطاق المعالجة السريعة: مثل ترحيل قاعدة برمجية تشمل عشرات الخدمات، أو البحث عن ثغرة أمنية يتطلب إصلاحها تقديم تصحيح برمجي قابل للتشغيل، أو الإجابة عن سؤال بحثي يحتاج إلى سلسلة من الأدلة بدلًا من فقرة مليئة بالثقة دون إثبات.
أصبح النموذج متاحًا للاستدعاء عبر Felo API، وتعرض Felo في الوقت الراهن نسخة تجريبية مجانية لفترة محدودة، إلى جانب أسعار مخفضة من مزودي الخدمة. يمكنك فتح النموذج واختبار المطالبات في ساحة التجربة وإنشاء مفتاح API من صفحة Gemini 4 Carbon على Felo قبل متابعة قراءة هذا الدليل.
يقدم هذا المقال شرحًا عمليًا للنموذج، وليس إعلانًا عن إطلاقه. ويتناول ماهية Carbon، واختلافه عن Gemini 4 Argon، وما توضحه المعايير المنشورة وما لا توضحه، وكيف تعمل ميزانية الرموز غير المعتادة، والمجالات التي يتفوق فيها النموذج، والجوانب التي قد لا تلبي توقعاتك، وتكلفته على Felo في الوقت الحالي.
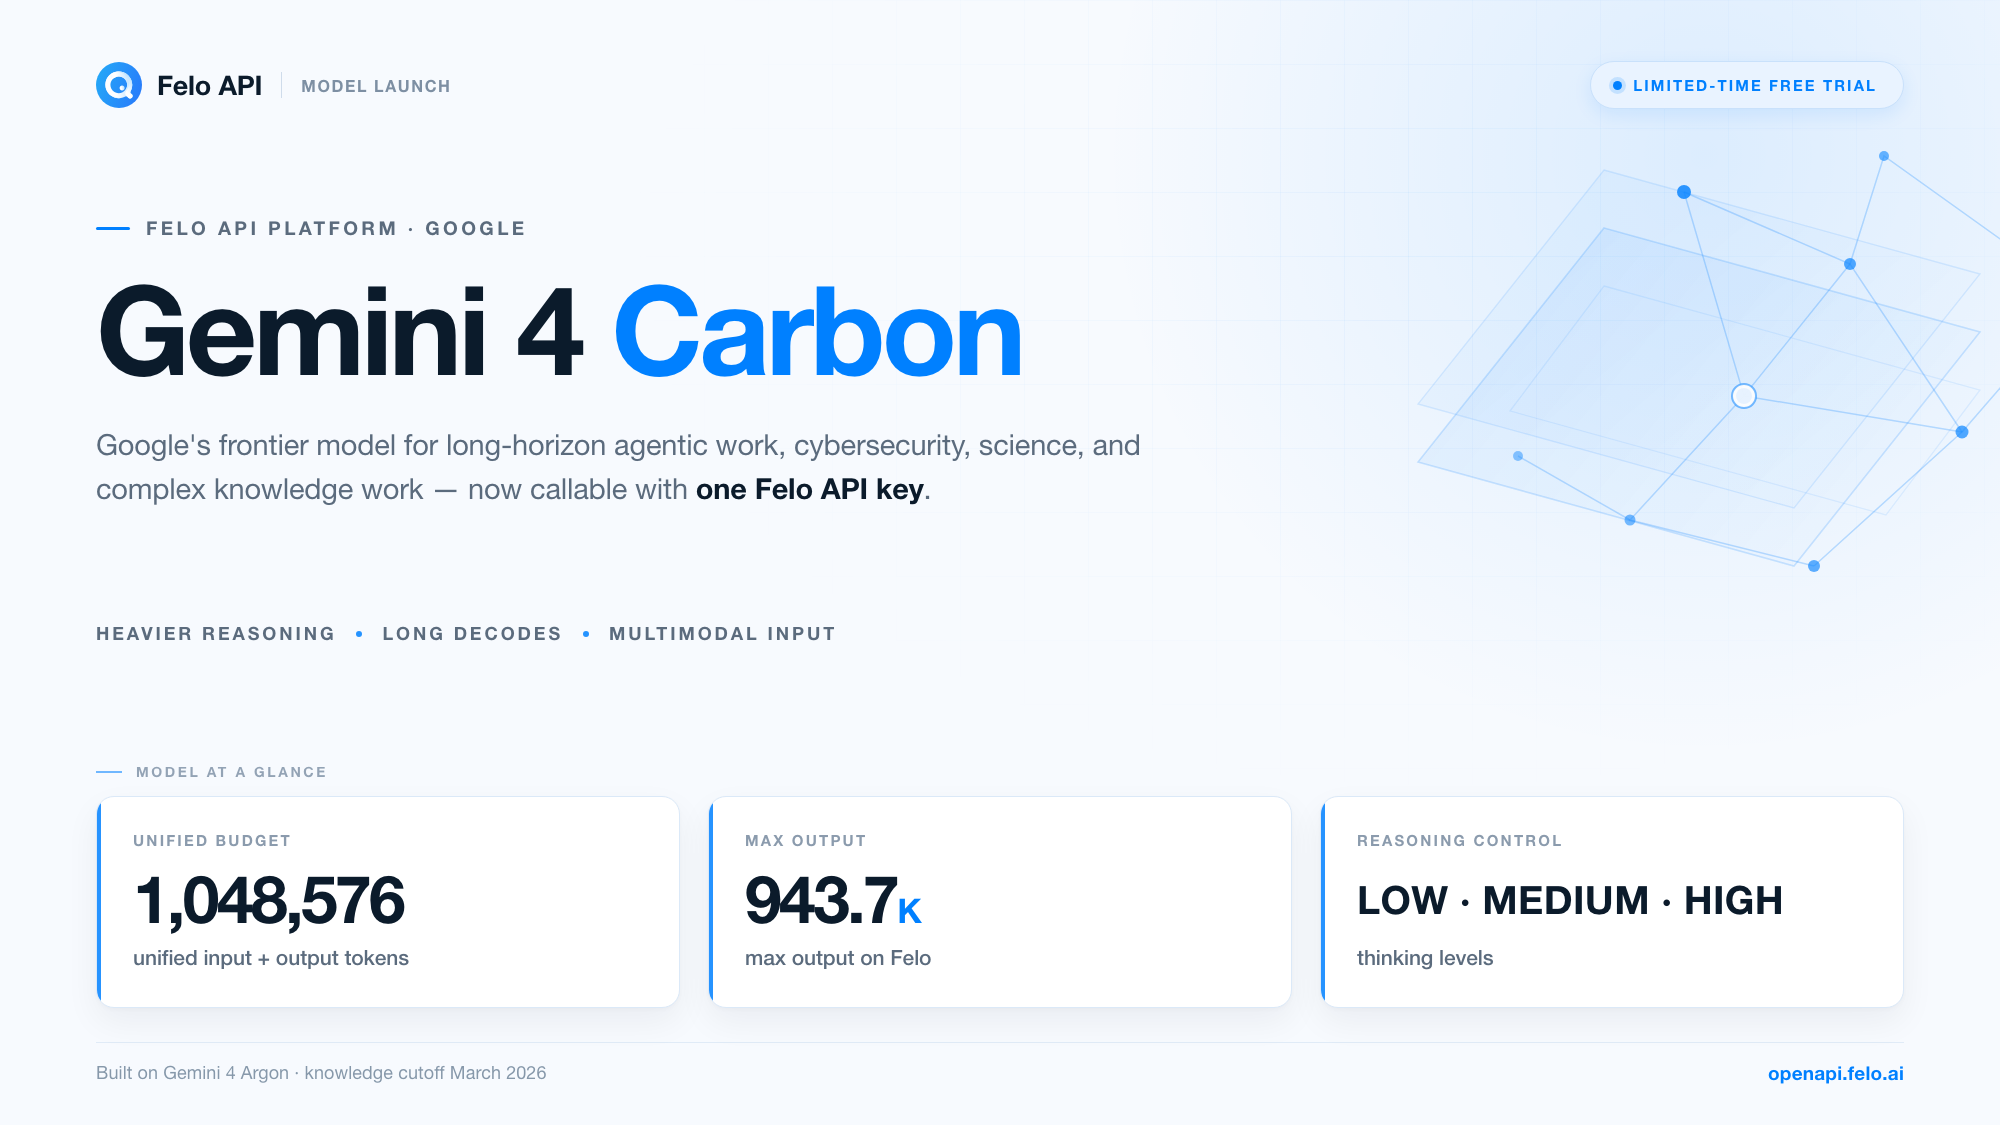
ما هو Gemini 4 Carbon؟
Gemini 4 Carbon هو نموذج Google المتقدم المخصص للمهام الوكيلة طويلة الأمد في مجالات البرمجة والتمويل والقانون والأمن السيبراني والعلوم. أعلنت Google عنه في 28 أكتوبر 2026، وبنته اعتمادًا على Gemini 4 Argon، وأتاحته في البداية لمجموعة محددة من المدافعين عن الأمن السيبراني ضمن برنامج Fairwind. وتدرج وثائق منصة المؤسسات من Google النموذج الآن ضمن الإتاحة العامة، بتاريخ إصدار 10 نوفمبر 2026.
لا يشير اسم "Carbon" إلى جيل جديد، بل إلى نقطة تشغيل مختلفة ضمن عائلة Gemini 4. فقد جرى ضبط Argon لإنتاج مستندات طويلة ومترابطة ضمن مسار توليد واحد، بينما يخصص Carbon جزءًا أكبر من ميزانيته للتفكير: استكشاف الفرضيات، وتنفيذ دورات التحقق، وتنسيق المهام متعددة الخطوات. وتذكر Google أن Carbon يستخدم رموز تفكير أكثر من Argon للوصول إلى الإجابات.
لهذا الاختيار تكلفة. فالنموذج أبطأ في المهام الصعبة، وقد تنتهي مهلة تشغيله في بعض الظروف، ويستهلك عددًا أكبر من الرموز عند مستويات التفكير المرتفعة. وتوضح Google هذه القيود ضمن وثائقها. ومع ذلك، فإن سبب اختيار Carbon هو أن المهام المستهدفة، مثل تحليل الأمان، وعمليات الترحيل واسعة النطاق، والاستدلال العلمي، ومراجعة المستندات الحساسة، تتطلب عمقًا أكبر من السرعة.
مواصفات النموذج في لمحة
| المواصفات | القيمة |
|---|---|
| معرّف النموذج على Felo | gemini-4-carbon |
| تاريخ الإعلان | 28 أكتوبر 2026 |
| مبني على | Gemini 4 Argon |
| السياق والإخراج | ميزانية موحدة واحدة تبلغ 1,048,576 رمزًا تشمل الإدخال والإخراج |
| الحد الأقصى للإخراج على Felo | 943.718K رمزًا |
| الإدخال | النصوص والصور والصوت والفيديو وملفات PDF وملفات Office/OpenDocument |
| الإخراج | النص |
| مستويات التفكير | LOW وMEDIUM (الافتراضي) وHIGH |
| تاريخ انتهاء المعرفة | مارس 2026 |
| إعدادات أخذ العينات | Temperature 1.0 وtop-p 0.95 وtop-k 64، وهي إعدادات ثابتة |
| التخزين المؤقت | التخزين المؤقت الضمني فقط، بحد أدنى 4,096 رمزًا |
| واجهة Felo الموصى بها | Messages API (متوافقة مع Anthropic) |
| الوصول | عملاء المؤسسات المعتمدون في مناطق محددة؛ ومتغير الأمن السيبراني متاح عبر قائمة سماح فقط |
هناك تفصيلان في هذا الجدول يستحقان شرحًا مستقلًا لأنهما يؤثران في طريقة بناء التطبيقات باستخدام النموذج: ميزانية الرموز الموحدة ومستويات التفكير.
كيف يختلف Gemini 4 Carbon عن Gemini 4 Argon؟
يشترك Carbon وArgon في العائلة نفسها وتاريخ انتهاء المعرفة وجزء كبير من التوجه العام. وتتمثل الاختلافات في طريقة استهلاك النموذج لقدراته.
ميزانية موحدة للإدخال والإخراج. يوصف Argon في العادة بأنه يمتلك نافذة سياق تبلغ 1,048,576 رمزًا، مع حد افتراضي منفصل للإخراج يبلغ 65,536 رمزًا. أما ميزانية Carbon البالغة 1,048,576 رمزًا فتشمل الإدخال والتفكير واستدعاءات الأدوات والإجابة النهائية معًا. إنها ميزانية واحدة، وليست نافذة سياق مضافًا إليها حد مستقل للإخراج.
استدلال أعمق في الإعداد الافتراضي. يدعم Carbon مستويات التفكير LOW وMEDIUM وHIGH، ويكون MEDIUM هو المستوى الافتراضي في gemini-4-carbon، بينما يكون HIGH هو الافتراضي في المتغير المخصص للأمن السيبراني. وقد صُمم النموذج لتنفيذ دورات تحقق ممتدة، وهذا يفسر اعتبار Google ارتفاع استهلاك الرموز قيدًا معروفًا وليس خطأً برمجيًا.
عمليات توليد طويلة. ينتج مقطع واحد في الواجهة الأمامية ما يصل إلى 65,536 رمز إخراج عند استخدام البث، أو 32,768 رمزًا عند عدم استخدامه. ويمكن تجاوز هذه الحدود عبر عمليات التوليد الممتدة (Long Decodes). إذ تتولى Google Gen AI SDK وAgent Studio إدارة رمز الاستمرار بشكل تلقائي، أو يمكنك تنفيذ حلقة استمرار مخصصة. ويتمثل الحد النظري في كامل الميزانية الموحدة بعد طرح رموز الإدخال.
دعم أوسع للملفات. يقبل Carbon ملفات Microsoft Office وOpenDocument، مثل .docx و.doc و.pptx و.ppt و.xlsx و.xls و.odt و.odp و.ods، سواء أُدرجت ضمن الطلب أو قُرئت من التخزين السحابي، إلى جانب ملفات PDF والنصوص العادية. وتبرز أهمية ذلك عندما يبدأ سير العمل بعرض تقديمي أو جدول بيانات أو عقد بدلًا من ملف نصي منسق.
ضبط أمني ومتغير مستقل للأمن السيبراني. تفيد Google بأن تنبيهات حالات عدم التوافق عالية الخطورة انخفضت بنسبة تقارب 80% في بيئات البرمجة الفعلية، وأن Carbon يتفوق على Argon بمقدار 3.50 نقطة مئوية في سلامة المحتوى متعدد اللغات ومتعدد الوسائط ضمن تقييمات سلامة النص إلى النص. ويتوفر أيضًا المتغير gemini-4-carbon-cyber-permissive، وهو مخصص للأمن الدفاعي ومتاح عبر قائمة سماح فقط، ويستخدم مستوى التفكير HIGH كإعداد افتراضي مع تعطيل استخدام الكمبيوتر.
سلوك مخصص للعلوم. تذكر Google أن النموذج يستطيع تحويل أهداف الأمان إلى مبرهنات رياضية، واكتشاف البروتينات المتجانسة بعيدة الصلة عبر أرشيفات تسلسلات بحجم بيتابايت بصورة مستقلة، مع تسجيل زيادة متوسطة بمقدار 40 ضعفًا في استرجاع البروتينات المتجانسة ضمن عائلات البروتينات منخفضة التجانس. وهذا ادعاء محدد يتعلق بمهمة بحثية معينة، ومن الأفضل التحقق منه باستخدام بياناتك بدل اعتباره قدرة عامة مضمونة.
شرح ميزانية الرموز الموحدة
تعرض معظم صفحات النماذج رقمين: حجم نافذة السياق والحد الأقصى للإخراج. أما Carbon فيقدم رقمًا واحدًا وقاعدة خاصة بكل مقطع. وإذا خططت للطلبات وفق الطريقة القديمة، فقد تبالغ في تقدير المساحة المتاحة أو تفهم الفاتورة على نحو خاطئ.
إليك كيفية توزيع الميزانية:
- الإدخال (Input) — المطالبة الخاصة بك، والمستندات المرفقة، والصور، والصوت، وإطارات الفيديو، والمحادثات السابقة.
- التفكير (Thinking) — رموز الاستدلال التي يستهلكها النموذج قبل تقديم الإجابة. وقد يكون هذا الاستهلاك كبيرًا عند اختيار HIGH.
- استدعاءات الأدوات (Tool Calls) — كل ما يستدعيه النموذج عند تفعيل الأدوات.
- الإجابة النهائية (Final Answer) — النص الذي تتلقاه.
تستهلك العناصر الأربعة الميزانية نفسها البالغة 1,048,576 رمزًا. فإذا احتوى الطلب على 900K رمز من الإدخال، فلن يتبقى لديك مليون رمز للإخراج، بل نحو 148K رمز للتفكير والأدوات والإجابة مجتمعة، قبل أي عملية استمرار.
أما الحد الخاص بكل مقطع فهو منفصل. ففي طلبات البث، يبلغ الحد الأقصى للمقطع الواحد 65,536 رمز إخراج، بينما يبلغ 32,768 رمزًا دون البث. وتتيح عمليات التوليد الممتدة متابعة الإخراج بعد تجاوز حد المقطع إلى أن تنفد الميزانية الموحدة. وإذا كنت تتعامل مع max_tokens باعتباره ضمانًا لإجمالي الإخراج، فهذا فهم غير صحيح؛ فهو يحدد سقف المقطع الواحد، بينما تتولى آلية الاستمرار في SDK تحويل ذلك إلى مستند طويل.
تعرض صفحة النموذج على Felo حدًا أقصى للإخراج يبلغ 943.718K رمزًا. تعامل مع هذا الرقم باعتباره سقف الإخراج عبر مسار Felo، وليس نافذة سياق ثانية وأكبر. ففي ظل الميزانية الموحدة، تعتمد المساحة الفعلية المتاحة للإجابة على حجم البيانات التي أرسلتها.
النتيجة العملية بسيطة: حدد حجم الإخراج أولًا، ثم اضبط حجم الإدخال بما يتناسب معه. عند إعداد تقرير طويل، خصص مساحة للإخراج والتفكير، ثم قلّص المواد المصدرية لتناسب الميزانية. وعند تحليل مجموعة كبيرة من المستندات، ضع في الحسبان أن الإجابة ستكون أقصر من حجم المدخلات، وخطط لاستخدام الاستمرار أو المطالبات المرحلية.
مستويات التفكير: مصدر جودة النتائج
يوفر Carbon ثلاثة مستويات للتفكير: LOW وMEDIUM وHIGH، ويكون MEDIUM هو المستوى الافتراضي. وتوضح وثائق Google أن استخدام thinking_budget وthinking_level="MINIMAL" يؤدي إلى خطأ في التحقق من صحة الطلب، لذلك لا يمكنك ضبط الاستدلال على الصفر.
الفرق العملي بين المستويات واضح. عند اختيار LOW، يتصرف النموذج بصورة أقرب إلى نموذج محادثة سريع ومتقدم، ويكون مناسبًا للاستخراج والتصنيف وإعادة الصياغة ومراجعة الشيفرات البرمجية الروتينية. وعند اختيار MEDIUM، يبدأ في تخصيص الرموز للتخطيط والتحقق الذاتي. أما HIGH فينفذ دورات تحقق أطول، وهو الإعداد الأكثر قدرة على اكتشاف الأخطاء الدقيقة، لكنه أيضًا الأكثر عرضة للبطء وارتفاع التكلفة.
إليك مجموعة من القواعد العملية:
- اختر المستوى وفق تكلفة الإجابة الخاطئة. إذا كان اكتشاف الخطأ وإصلاحه لا يتطلبان تكلفة كبيرة، فاستخدم LOW. أما إذا كان الخطأ قد يصل إلى بيئة الإنتاج أو يدخل في مستند رسمي، فاختبر HIGH.
- قِس عدد الرموز لكل نتيجة مقبولة، وليس لكل طلب. قد يؤدي التفكير الأعمق إلى تقليل المحاولات المتكررة وإعادة العمل، لكنه قد يضاعف التكلفة في المهام التي كان النموذج سيحلها باستخدام MEDIUM. قارن تكلفة العملية الكاملة.
- لا تفترض أن إعدادات الاختبار المعياري تنطبق على استخدامك. لا توضح الأرقام الرئيسية المنشورة من Google مستوى التفكير المستخدم في جميع الحالات. اختبر مهامك على مستويين قبل اعتماد أحدهما.
إعدادات أخذ العينات ثابتة عند temperature 1.0 وtop-p 0.95 وtop-k 64، ويتم تجاهل القيم المخصصة. إذا كان خط الإنتاج لديك يعتمد على نتائج حتمية بدرجة حرارة منخفضة، فإن Carbon ليس الخيار المناسب لهذه المرحلة. استخدمه للتقييم والتركيب والتحليل، واحتفظ بالخطوات الحتمية لنموذج يدعم التحكم في إعدادات أخذ العينات.
ما الذي نشرته Google: المعايير وما تعنيه
تجمع صفحة النموذج على Felo نتائج المعايير التي نشرها مزود الخدمة بشأن Carbon. والمقارنات التالية استرشادية؛ فهي مستمدة من Google أو من جهات التقييم، ولم يُعَد تنفيذها بصورة مستقلة لأغراض هذا المقال، كما أنها تصف ظروف الاختبار ولا تمثل بالضرورة طبيعة مهامك.
| التقييم | ما الذي يقيسه؟ | Gemini 4 Carbon | السياق |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | مؤشر مركب للاستدلال | 59 | المركز الأول؛ Claude Opus 5.5 حصل على 58 |
| SEC-bench Pro | اكتشاف الثغرات الأمنية | 88.2% | الأمن والفحص الدفاعي |
| CWE-bench | إصلاح الثغرات الأمنية | 71.0% | الأمن والمعالجة |
| ExploitGym | استغلال الثغرات الأمنية | 54.8% | الأبحاث الأمنية والبيئات الخاضعة للرقابة |
| Terminal-Bench 4.0 | معدل الغش الناجح | 0.0% | مقاومة التلاعب بالمكافآت، وليس قياس القدرات |
| Vals Index | مؤشر مركب للمهام المعرفية | 70.45% | المركز الثالث من بين 36 نموذجًا |
| Legal Research Bench | البحث القانوني | 55.77% | المركز الأول |
| General Financial Intelligence | المهام المالية | #1 | المركز الأول بين 23 إعدادًا متقدمًا، وفق Balyasny Asset Management |
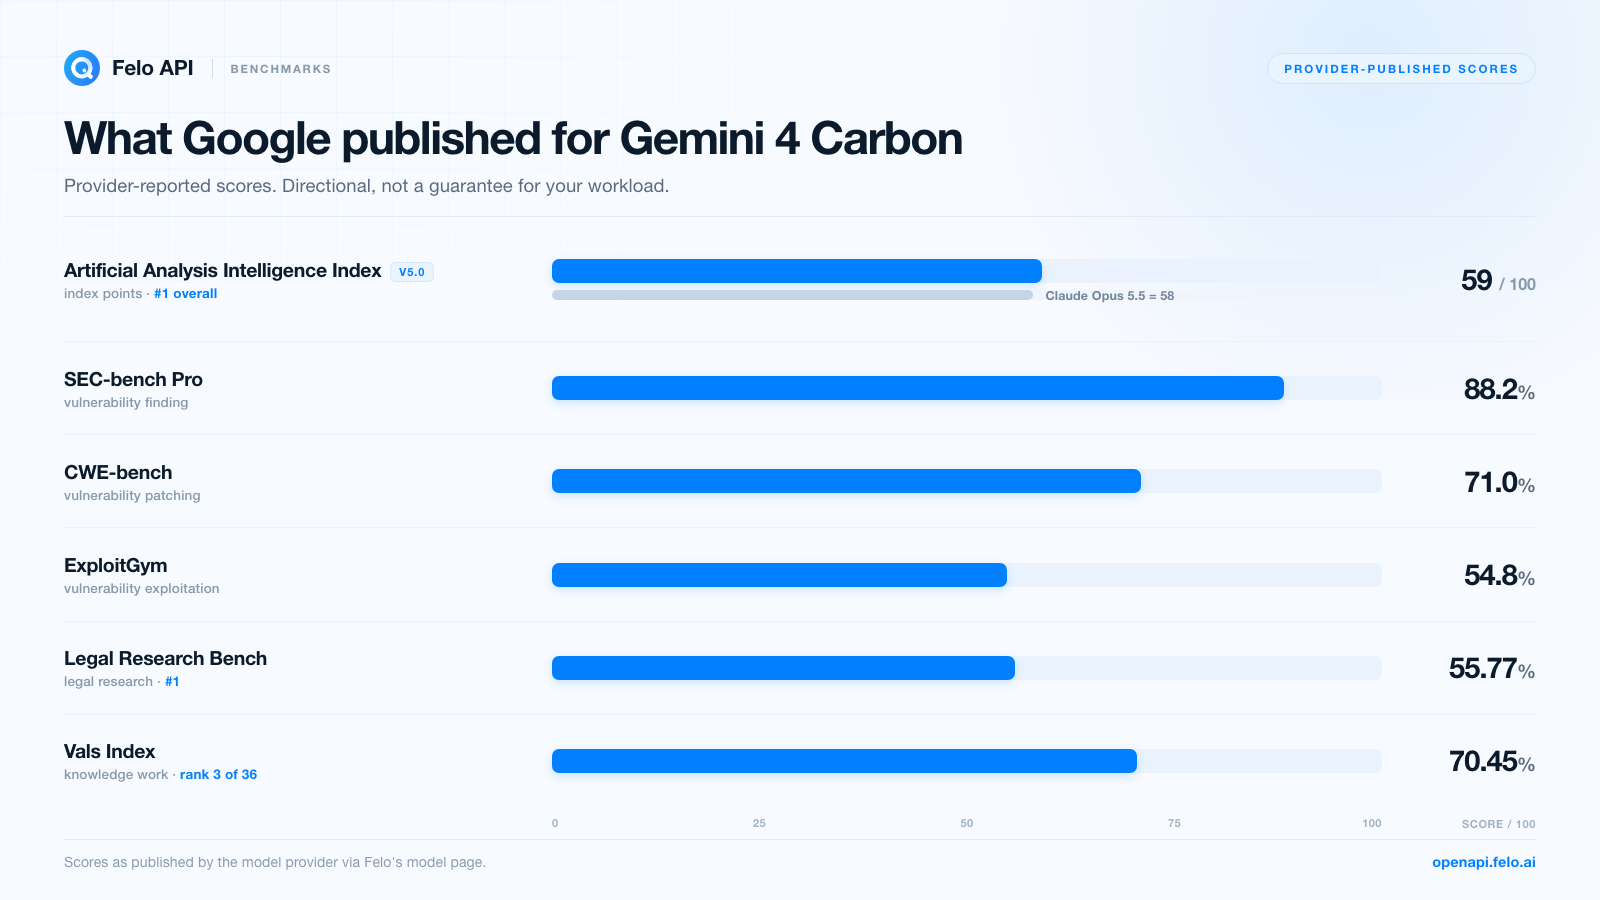
عند قراءة الجدول، تظهر ثلاث نقاط مهمة.
تعكس نتائج الأمن السيبراني مراحل مختلفة من دورة العمل، وليست مهارة واحدة. فاكتشاف الثغرات وكتابة التصحيحات واستغلال الثغرات مهارات مختلفة. وتُظهر الأرقام المنشورة لـ Carbon أفضل أداء في الاكتشاف (88.2% في SEC-bench Pro)، وأداءً أقل في الاستغلال (54.8% في ExploitGym)، بينما يأتي إصلاح الثغرات في المنتصف (71.0% في CWE-bench). إذا كان عملك دفاعيًا، مثل الفحص وتحديد الأولويات والمعالجة، فإن هذا الأداء يتناسب مع احتياجاتك. أما إذا كنت تحتاج إلى استغلال مستقل للثغرات، فالنتيجة أقل، كما أن قواعد الوصول أكثر صرامة.
مقياس معدل الغش يتعلق بالموثوقية، وليس الذكاء. يقيس مؤشر "معدل الغش الناجح" في Terminal-Bench 4.0 ما إذا كان النموذج يتحايل على الاختبار المعياري بدلًا من حل المهمة. وتشير نتيجة 0.0% إلى مقاومة التلاعب بنظام المكافآت، وهي نقطة مهمة عند تشغيل وكيل دون إشراف مستمر. لكنها ليست درجة لقياس القدرات، ولا ينبغي مقارنتها بنتائج الدقة المئوية الأخرى في الجدول.
تُعد تصنيفات المهام المعرفية الأكثر أهمية لمعظم الفرق. يصف المركز الثالث من أصل 36 في Vals Index، والمركز الأول في Legal Research Bench، والتصدر في مقارنة Balyasny المالية نوعية العمل التي تبرر استخدام نموذج متقدم: قراءة كميات كبيرة من المعلومات، والتوفيق بين الأدلة المتعارضة، وإنتاج نتائج يستطيع المختص مراجعتها. وتتأثر هذه النتائج أيضًا بتصميم المطالبات وجودة المصادر، لذلك تعامل معها باعتبارها دافعًا للاختبار، وليس سببًا لتجاوزه.
هناك ملاحظة إضافية: درجة Artificial Analysis هي مؤشر مركب، والفارق البالغ نقطة واحدة عن Claude Opus 5.5 يقع ضمن نطاق قد يؤدي فيه اختلاف طبيعة المهام إلى تغيير الترتيب. وقد لا يكون النموذجان متقاربين في المهام المحددة التي تهمك، سواء لمصلحة أحدهما أو الآخر.
المجالات التي يقدم فيها Gemini 4 Carbon قيمة فعلية
المعايير خريطة إرشادية وليست الواقع بأكمله. وفيما يلي أعباء العمل التي تتوافق فيها خصائص تصميم Carbon مع متطلبات المهمة.
أعمال البرمجة واسعة النطاق وعمليات الترحيل
يستهدف Carbon المهام الهندسية التي تتطلب تعاون عدة وكلاء، وتصحيح الأخطاء اليومية، وترحيل قواعد برمجية كبيرة، وتصميم الخوارزميات. وتساعد الميزانية الموحدة في هذا المجال؛ إذ يمكنك تحميل خريطة المستودع البرمجي والملفات المصدرية ذات الصلة ومخرجات الاختبارات الفاشلة ومتطلبات الترحيل ضمن طلب واحد، ثم طلب خطة قبل إجراء أي تعديل على الشيفرة.
إليك مثالًا على مطالبة مناسبة لهذا النوع من النماذج:
اقرأ خريطة المستودع البرمجي المرفقة ووحدات الخدمات الثلاث. حدد جميع مواضع استدعاء الواجهة المتأثرة باستبدال واجهة الجلسة، واكتب قائمة بمخاطر التوافق، واقترح ترتيبًا لعملية الترحيل. لا تكتب أي شيفرة حتى الآن. حدد أي معلومات لم تتمكن من التحقق منها باستخدام الملفات المقدمة.
اطلب الخطة أولًا. امنح النموذج إمكانية تشغيل الاختبارات بعد مراجعتك للخطة. واحتفظ بمراجعة الفروقات البرمجية تحت إشراف بشري؛ فحتى النموذج الذي يجيد التخطيط قد ينتج تصحيحًا برمجيًا ينجح في التجميع لكنه يتصرف بصورة خاطئة.
الأمن السيبراني الدفاعي
يتوافق ملف أداء المعايير الأمنية، الذي يجمع بين قوة اكتشاف الثغرات وأداء جيد في إصلاحها وأداء أقل في استغلالها، مع مهام الدفاع السيبراني: فحص قاعدة برمجية بحثًا عن أنواع الثغرات، وفرز نتائج أدوات الفحص، واقتراح التصحيحات، وشرح المخاطر بلغة يستطيع المراجع التعامل معها. وقد صُمم متغير Google المخصص للأمن السيبراني لهذا الغرض، لكن الوصول إليه يخضع لقائمة السماح عبر برنامج Fairwind ويتطلب موافقة منفصلة.
هناك احتياطان مهمان. أولًا، لا تنفذ عمليات الفحص الأمني إلا على الأنظمة التي تملك تصريحًا باختبارها. ثانيًا، تحقق من النتائج قبل اتخاذ أي إجراء؛ فقد يعلن النموذج عن وجود ثغرة بدرجة ثقة مرتفعة رغم عدم صحتها، وتؤدي النتائج الإيجابية الخاطئة إلى إهدار وقت الفريق الهندسي.
الأبحاث العلمية والتقنية
تتعلق القدرة العلمية المعلنة بمهام محددة: تحويل أهداف الأمان إلى مبرهنات رياضية، والبحث عن البروتينات المتجانسة بعيدة الصلة ضمن أرشيفات تسلسلات بحجم بيتابايت. إذا كنت تعمل في مختبر أو مجموعة بحثية، فإن النمط المفيد يتمثل في تقديم سؤال محدد النطاق إلى Carbon، وإرفاق الدراسات أو التسلسلات ذات الصلة، واشتراط الفصل بين الأدلة والاستنتاجات.
يُعد ادعاء زيادة استرجاع البروتينات المتجانسة بمقدار 40 ضعفًا لافتًا، لكنه يصف عائلات بروتينية منخفضة التجانس ضمن مسار معالجة محدد. اختبر هذه النتيجة باستخدام معيار تقييم موثوق لدى فريقك قبل بناء سير عمل يعتمد عليها.
مراجعة المستندات المالية والقانونية والحساسة
تمثل تصنيفات Carbon في المهام المعرفية أقوى نقاط تسويقه للخدمات المهنية. وتشمل هذه المهام مطابقة دفاتر الحسابات، وتحليل الفروقات، ومراجعة السوابق القضائية والإيداعات التنظيمية، وإعداد مذكرات مدعومة بالاستشهادات. ويستطيع النموذج قراءة الصور وملفات PDF، مما يجعل المستندات الممسوحة ضوئيًا والمخططات مدخلات صالحة للاستخدام.
لكن ذلك لا يلغي ضرورة المراجعة. قدم مجموعة المصادر، واطلب الاستشهاد بالمقطع الذي يدعم كل استنتاج، ثم تحقق من الاستشهادات. فحتى النموذج القادر على معالجة مليون رمز ضمن السياق قد يسيء قراءة الصفحة 412.
الوكلاء طويلة التشغيل المزودون بالأدوات
يدعم Carbon استدعاء الدوال، والإخراج المنظم، وتنفيذ الشيفرات، وسياق عناوين URL، واستخدام الكمبيوتر، وعدة خيارات للاستناد إلى المصادر، بما فيها Google Search وGoogle Maps ومزودو البحث الخارجيون. كما يدعم فهم الفيديو عبر الوكلاء، وهي ميزة مفيدة عندما يكون الإدخال تسجيلًا مرئيًا بدلًا من مستند.
هذه أكثر طرق استخدام النموذج تطلبًا، وهي أيضًا من أسهل الطرق لاستنزاف الرموز. جهّز الوكيل بأدوات المراقبة: سجل استدعاءات الأدوات، وحدد عدد التكرارات، واشترط تقديم ملخص لما تم التحقق منه قبل تنفيذ أي إجراء. تتيح ميزانية المليون رمز بناء وكلاء طموحين، لكنها لا تجعل تشغيلهم منخفض التكلفة.
المدخلات متعددة الوسائط وحدودها
يقبل Carbon النصوص والصور والصوت والفيديو وملفات PDF ومستندات Office، ويُنتج نصوصًا. وتتميز الحدود بالسعة الكبيرة، لكنها محددة، وتفوق أهميتها قائمة الوسائط المدعومة في العنوان الرئيسي.
| نوع الإدخال | الحد العملي |
|---|---|
| الصوت | نحو 8.4 ساعات لكل مطالبة، أو ما يصل إلى مليون رمز؛ وبحد أقصى 1,000 ملف صوتي |
| الفيديو | نحو 45 دقيقة مع الصوت، ونحو ساعة دون صوت؛ وبحد أقصى 10 مقاطع فيديو لكل مطالبة |
| الصور والمستندات | ما يصل إلى 3,000 عنصر مجتمعة لكل مطالبة |
| المستندات | ما يصل إلى 3,000 صفحة لكل ملف |
| تنسيقات Office | .docx و.doc و.pptx و.ppt و.xlsx و.xls |
| تنسيقات OpenDocument | .odt و.odp و.ods |
| حجم الإدخال | 500 MiB مضغوط عبر GenerateContent API؛ و256 MiB عبر Interactions API |
يُعد حد الصوت أبرز هذه الإمكانات. فإمكانية إدخال ثماني ساعات من الصوت ضمن طلب واحد تغير طريقة عمل الفرق التي تعقد اجتماعات كثيرة. فبدلًا من تحويل التسجيلات إلى نص وتقسيمها إلى أجزاء، يمكنك تقديم يوم كامل من المكالمات وطلب استخراج الموضوعات والقرارات والأسئلة المفتوحة. لكن ذلك يستهلك الرموز، وتُحاسب رموز الصوت مثل رموز الإدخال، لذلك لا يكون تحميل تسجيل يوم كامل مجانيًا.
أما الفيديو، فتقترب حدوده من احتياجات العمل المعتادة. إذ تكفي 45 دقيقة من الفيديو المصحوب بالصوت لمحاضرة أو عرض توضيحي لمنتج أو مقابلة مسجلة، لكنها لا تكفي لمؤتمر كامل.
هناك فجوات في الإمكانات ينبغي أخذها في الحسبان. لا تدعم الخدمة Gemini Live API، لذلك لا تتوفر المحادثات الصوتية الآنية. كما لا تدعم RAG Engine أو ضبط النموذج، مما يعني ضرورة تنفيذ الاسترجاع والضبط الدقيق ضمن طبقة التطبيق الخاصة بك. ولا يتوفر التخزين المؤقت الصريح للسياق أيضًا؛ إذ يقتصر الدعم على التخزين المؤقت الضمني بحد أدنى يبلغ 4,096 رمزًا، وهو ما يؤثر في تخطيط تكاليف المطالبات الطويلة المتكررة.
كيفية استدعاء Gemini 4 Carbon على Felo
توصي Felo باستخدام Messages API كواجهة لهذا النموذج. وتقبل نقطة النهاية بنية طلب متوافقة مع Anthropic عبر https://openapi.felo.ai/api/v1/messages، ومعرّف النموذج هو gemini-4-carbon.
تتبع العملية الخطوات نفسها المستخدمة مع أي نموذج آخر على Felo:
- أنشئ مفتاح Felo API. تُنشأ المفاتيح في وحدة تحكم Felo وتُخزن ضمن
FELO_API_KEY. لا تضع المفتاح في مستودع الشيفرة ولا تلصقه في سجلات النظام. - اختبر النموذج في ساحة التجربة أولًا. تتيح لك ساحة تجربة Gemini 4 Carbon اختبار المطالبات قبل كتابة الشيفرة.
- أرسل طلبًا صغيرًا. ابدأ بمطالبة قصيرة وتحقق من بنية الاستجابة.
- أضف البث. اضبط
stream: trueلاستخدام الأحداث المرسلة من الخادم، وهي ميزة مهمة عندما يصل طول المقطع الواحد إلى 65,536 رمزًا. - اختبر مهمة تمثل استخدامك الفعلي. استخدم حجم الإدخال الحقيقي ومعايير التقييم الفعلية، واختبر مستويين على الأقل من التفكير قبل اعتماد مسار المعالجة.
يبدو طلب Python الأساسي كما يلي:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
هناك ملاحظتان تتعلقان بالتكامل. أولًا، يدعم هذا النموذج الاستدلال؛ لذا احتفظ بالبيانات الوصفية للاستدلال التي تعيدها الاستجابة عند متابعة المحادثة، وإلا فقد تفقد السياق الذي يتوقع النموذج الاحتفاظ به. ثانيًا، يمثل max_tokens حدًا للمقطع الواحد وليس للإخراج الإجمالي؛ لذلك استخدم آلية الاستمرار التي توفرها SDK عند التعامل مع المخرجات الطويلة بدلًا من رفع الرقم والاعتماد على ذلك وحده.
توثق Felo أيضًا نقاط نهاية Chat Completions وResponses المتوافقة مع OpenAI للنماذج التي تدعمها. وبما أن صفحة النموذج توصي باستخدام Messages مع Carbon، تحقق من الواجهة المدعومة عبر صفحة النموذج قبل إعادة كتابة عميل يعتمد على OpenAI.
تكلفة Gemini 4 Carbon على Felo
تقدم Felo خدمة Gemini 4 Carbon عبر خمسة مزودين من Google، وتُعرض جميع المسارات حاليًا بخصم 50%. والأسعار التالية لكل مليون رمز، مع عرض السعر القياسي والسعر المخفض معًا.
| المسار | الإدخال | الإخراج | قراءة ذاكرة التخزين المؤقت |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
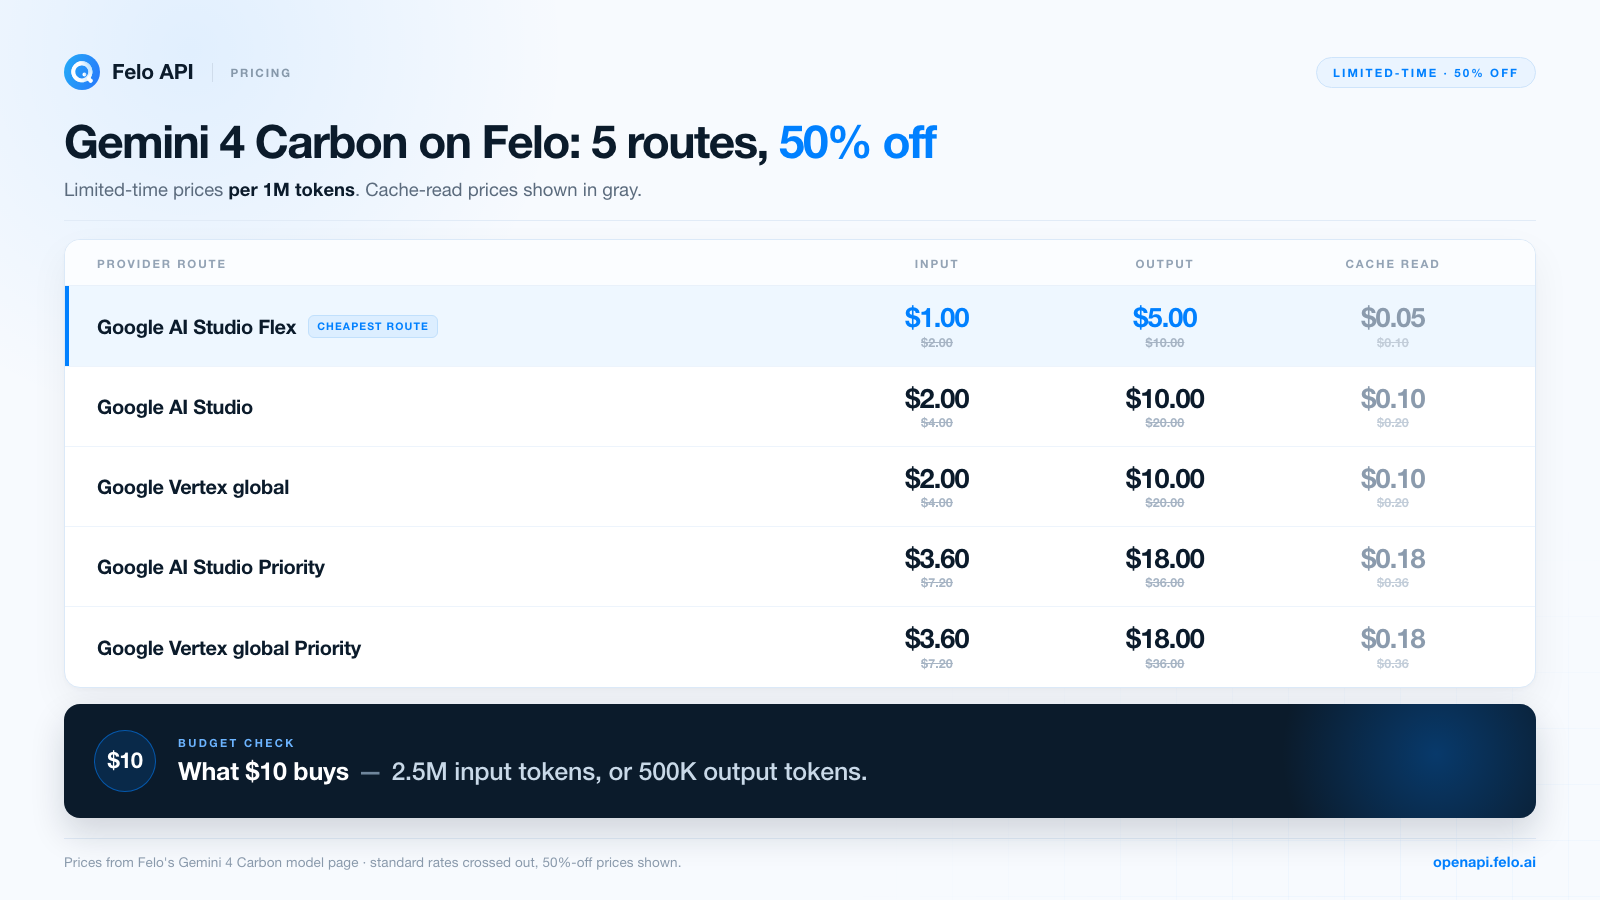
توضح صفحة الأسعار على Felo ما يمكن أن يشتريه مبلغ 10 دولارات وفق الأسعار القياسية: نحو 2.5 مليون رمز إدخال أو 500,000 رمز إخراج، قبل الخصومات. وهذه طريقة مفيدة لتقدير تكلفة إثبات المفهوم. فعلى سبيل المثال، تبلغ تكلفة اختبار يرسل حزم مستندات بحجم 100,000 رمز ويتلقى إجابات بحجم 5,000 رمز نحو $0.13 على مسار Flex بالسعر المخفض، موزعة على $0.10 للإدخال و$0.025 للإخراج. وهذا مبلغ يسمح بإجراء عشرات الاختبارات قبل اتخاذ القرار.
تُعد النسخة التجريبية المجانية عرضًا منفصلًا عن الأسعار المخفضة. وتضع Felo علامة النسخة التجريبية المجانية محدودة الوقت على صفحة نموذج Gemini 4 Carbon، مما يتيح اختبار النموذج دون الالتزام باستخدام الرصيد المدفوع. راجع الشروط الحالية في صفحة النموذج، لأن توفر النسخة التجريبية والخصومات السعرية مرتبطان بفترة زمنية وقد يتغيران.
يتطلب التخطيط لتكلفة هذا النموذج عادة إضافية. فبما أن رموز التفكير تُحاسب بسعر الإخراج، قد تصل تكلفة تشغيل وكيل يستخدم HIGH إلى عدة أضعاف ما توحي به الإجابة الظاهرة. سجل استهلاك الرموز لكل مهمة، بما في ذلك رموز الاستدلال، وقارن التكلفة لكل نتيجة مقبولة بدلًا من التكلفة لكل طلب.
القيود والأمور التي ينبغي التحقق منها قبل الاعتماد على النموذج
يُعد Carbon نموذجًا متقدمًا، لكنه يمتلك نقاط ضعف موثقة. وفيما يلي أبرز الجوانب التي تؤثر في التخطيط لبيئة الإنتاج:
- الهلوسة. تدرجها Google ضمن القيود المعروفة. يقلل السياق الطويل احتمال فقدان المعلومات، لكنه لا يضمن التفسير الصحيح. وتظل عمليات الاستشهاد والتحقق ضرورية.
- زمن الاستجابة وانتهاء المهلة. تشير Google إلى حالات بطء ومشكلات في انتهاء المهلة. وتتطلب عمليات التفكير الطويلة باستخدام HIGH مهلًا زمنية مناسبة، وآليات لإعادة المحاولة، ومعالجة تضمن عدم تكرار آثار المهمة.
- ارتفاع استهلاك الرموز. يستهلك النموذج رموز تفكير أكثر من Argon، خاصة عند مستويات التفكير المرتفعة. خطط للميزانية وفق ذلك وحدد سقفًا للجهد في المهام الروتينية.
- تاريخ انتهاء المعرفة: مارس 2026. تتطلب المعلومات الأحدث من هذا التاريخ استخدام الاسترجاع أو المصادر الحديثة. لا يمتلك Carbon معرفة بالأحداث التي وقعت بعد ذلك التاريخ.
- إعدادات أخذ العينات الثابتة. لا يمكن تعديل Temperature وtop-p وtop-k. إذا كان مسار المعالجة يتطلب مخرجات حتمية، فاحتفظ بهذه المرحلة ضمن نموذج آخر.
- غياب التخزين المؤقت الصريح وضبط النموذج وRAG Engine وLive API. تنقل كل واحدة من هذه القيود جزءًا من العمل إلى طبقة التطبيق الخاصة بك.
- قيود التوفر. تتيح Google استخدام Carbon لعملاء المؤسسات المعتمدين في مناطق محددة، بينما توفر Felo مسارات عبر مزودين عالميين وأمريكيين وأوروبيين. تحقق من المسار والشروط المناسبة لحالة استخدامك.
- قواعد السلامة والوصول. يخضع المتغير المخصص للأمن السيبراني لقائمة السماح، ويجب أن تكون عمليات الأمن مصرحًا بها. وتظل إجراءات الحماية وسياسات مزودي الخدمة سارية.
هل ينبغي لك استخدامه؟
استخدم Gemini 4 Carbon عندما تكون المهمة طويلة، والأدلة معقدة، وتكون تكلفة الإجابة الخاطئة مرتفعة: مثل إعداد خطة ترحيل، أو مراجعة أمنية، أو تركيب نتائج بحثية، أو تحليل مالي أو قانوني، أو تشغيل وكيل يحتاج إلى التحقيق قبل تنفيذ أي إجراء. فقد صُمم ملف أدائه في المعايير وميزانيته الموحدة لهذا النوع من المهام.
لا تستخدمه نموذجًا افتراضيًا لكل طلب. فالتصنيف بكميات كبيرة، والاستخراج القصير، والتلخيص البسيط، والمهام التي تتطلب إعدادات أخذ عينات حتمية، تناسبها نماذج أقل تكلفة وأسرع استجابة. ويظل النموذج الأقل تكلفة الذي يحقق معيار الجودة المطلوب هو الخيار الأفضل في معظم الحالات، وعلى Carbon أن يثبت قيمته ضمن أصعب المهام في سير عملك.
الخلاصة الصريحة: يُعد Carbon أقوى نماذج Google للمهام العميقة، مع نقاط قوة مثبتة في الأمن السيبراني والقانون والتمويل والاستدلال ضمن السياقات الطويلة، وتكاليف فعلية تتعلق بزمن الاستجابة واستهلاك الرموز، ومجموعة من القيود الموثقة التي تجعل التحقق أمرًا لا يمكن الاستغناء عنه. اختبره على مهامك قبل بناء نظام يعتمد عليه.
الأسئلة الشائعة
هل تتوفر نسخة تجريبية مجانية من Gemini 4 Carbon على Felo؟
نعم. تعرض Felo نسخة تجريبية مجانية محدودة الوقت من Gemini 4 Carbon، كما تقدم أسعار مزودي الخدمة للنموذج بخصومات طوال فترة العرض. وقد تتغير الشروط، لذلك تحقق من صفحة نموذج Gemini 4 Carbon لمعرفة مدى التوفر الحالي.
ما الفرق بين Gemini 4 Carbon وGemini 4 Argon؟
بُني Carbon اعتمادًا على Argon، مع ضبطه لتقديم استدلال أعمق. ويستخدم ميزانية موحدة تبلغ 1,048,576 رمزًا تشمل الإدخال والتفكير واستدعاءات الأدوات والإخراج، ويدعم مستويات التفكير LOW وMEDIUM وHIGH، ويستهلك رموز تفكير أكثر، ويضيف دعم ملفات Office/OpenDocument مع تحسينات في السلامة والأمان. ويظل Argon الخيار المناسب لتوليد النصوص الطويلة عندما تكون سعة الإخراج أهم من عمق التحقق.
ما حجم نافذة السياق والحد الأقصى للإخراج في Gemini 4 Carbon؟
تبلغ الميزانية الموحدة 1,048,576 رمزًا، وتشمل الإدخال والإخراج معًا. ويمكن لمقطع واحد عند استخدام البث إنتاج ما يصل إلى 65,536 رمز إخراج، أو 32,768 رمزًا دون البث، بينما تتيح عمليات التوليد الممتدة زيادة الإخراج حتى استنفاد الميزانية المتبقية. وتعرض Felo حدًا أقصى للإخراج يبلغ 943.718K رمزًا عبر مسارها.
هل يستطيع Gemini 4 Carbon قراءة الصوت والفيديو وملفات Office؟
نعم. يقبل النموذج النصوص والصور والصوت والفيديو وملفات PDF وOffice/OpenDocument، بحدود تبلغ نحو 8.4 ساعات من الصوت، ونحو 45 إلى 60 دقيقة من الفيديو، و3,000 صورة ومستند مجتمعة، و3,000 صفحة لكل مستند. ويقتصر الإخراج على النصوص.
هل يدعم Gemini 4 Carbon واجهات API المتوافقة مع OpenAI؟
توصي Felo باستخدام Messages API المتوافقة مع Anthropic لهذا النموذج، كما توثق نقاط نهاية Chat Completions وResponses المتوافقة مع OpenAI للنماذج المدعومة. تحقق من الواجهة الحالية عبر صفحة النموذج قبل إعادة كتابة عميل موجود.
كم تبلغ تكلفة Gemini 4 Carbon؟
تعرض Felo خمسة مسارات من Google، وجميعها بخصم 50% في الوقت الحالي: يبلغ سعر AI Studio Flex دولارًا واحدًا للإدخال و5 دولارات للإخراج لكل مليون رمز، بينما تبلغ أسعار AI Studio وVertex القياسية دولارين و10 دولارات، وتبلغ أسعار المسارات ذات الأولوية 3.60 دولارات و18 دولارًا. وتبدأ تكلفة قراءة ذاكرة التخزين المؤقت من $0.05 لكل مليون رمز. راجع صفحة أسعار Felo للاطلاع على الأسعار الحالية.
متى صدر Gemini 4 Carbon؟
أعلنت Google عن Gemini 4 Carbon في 28 أكتوبر 2026، وأتاحته في البداية لمجموعة محددة من المدافعين عن الأمن السيبراني ضمن برنامج Fairwind. وتدرج منصة المؤسسات من Google تاريخ 10 نوفمبر 2026 بوصفه تاريخ الإتاحة العامة. وتوفر Felo النموذج الآن عبر خمسة مزودين من Google.
جرّب Gemini 4 Carbon على Felo
أفضل طريقة لتقييم Carbon هي تكليفه بمهمة تعرف نتيجتها مسبقًا. افتح ساحة تجربة Gemini 4 Carbon، وأدخل مستندًا حقيقيًا أو عينة من الشيفرة البرمجية، ثم قارن بين مستويي التفكير LOW وHIGH باستخدام المطالبة نفسها. إذا أثبتت النتائج جودتها، فأنشئ مفتاح API وانقل الاختبار إلى مسار المعالجة الخاص بك.
ابدأ من صفحة نموذج Gemini 4 Carbon للاطلاع على شروط النسخة التجريبية الحالية ومسارات مزودي الخدمة والحدود، ثم أنشئ أصغر اختبار ممكن حول أصعب مهمة تواجهك بالفعل.
تتوفر هذه المقالة أيضًا باللغات التالية: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.