বৈষম্যমূলক এআই: সিদ্ধান্ত গ্রহণের মডেল, উদাহরণ ও ব্যবহার

বৈষম্যমূলক এআই এবং সিদ্ধান্ত গ্রহণের মডেল কীভাবে ইনপুট শ্রেণিবদ্ধ করে, রাউটিং করে ও স্কোর নির্ধারণ করে, জেনারেটিভ এআই থেকে কীভাবে আলাদা এবং ডেভেলপাররা কোথায় এগুলো ব্যবহার করতে পারেন তা জানুন।
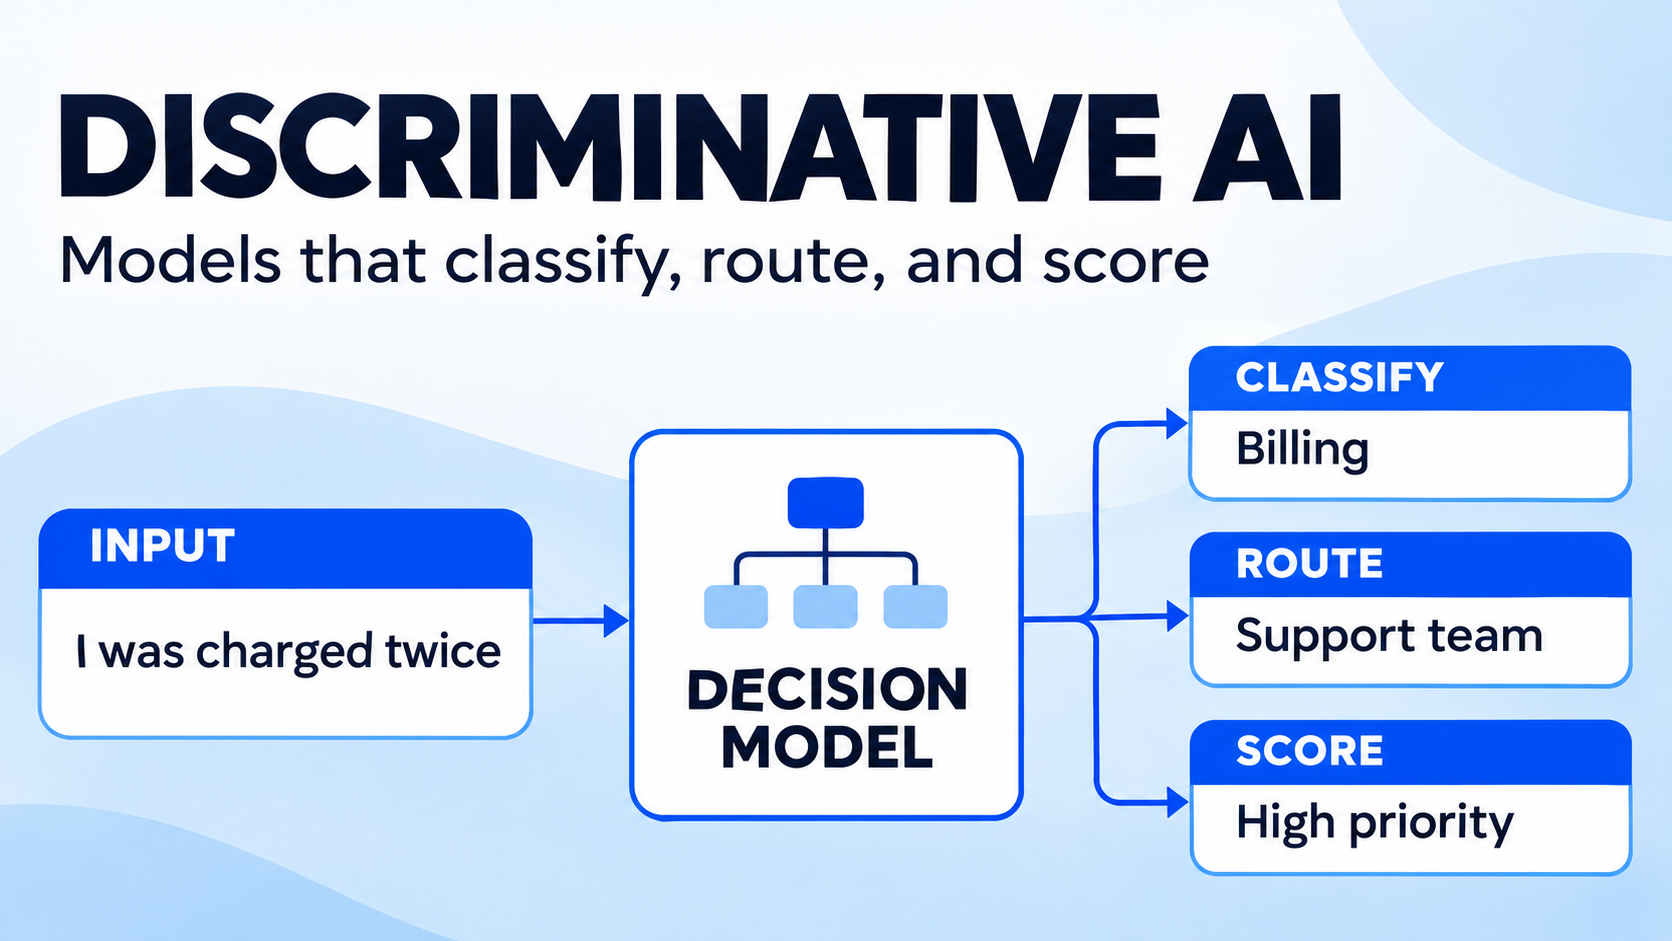
একটি গ্রাহক সহায়তার অনুরোধ এসেছে: “আমার কাছ থেকে দুইবার টাকা নেওয়া হয়েছে এবং আমি টাকা ফেরত চাই।” আপনার অ্যাপ্লিকেশনের জন্য এআই মডেলের লেখা কোনো অনুচ্ছেদ প্রয়োজন নাও হতে পারে। এর আগে একটি সিদ্ধান্ত নেওয়া প্রয়োজন হতে পারে: এই টিকিটটি বিলিং বিভাগ, প্রযুক্তিগত সহায়তা দল নাকি বিক্রয় বিভাগে পাঠানো উচিত?
বৈষম্যমূলক এআই (Discriminative AI) ইনপুট থেকে কোনো লেবেল, স্কোর বা নির্দিষ্ট লক্ষ্যবস্তু অনুমানের জন্য তৈরি। সিদ্ধান্ত গ্রহণের মডেলের একটি নতুন শ্রেণি এই ধারণাকে ডেভেলপার API-তে নিয়ে এসেছে: একটি মডেলকে প্রাসঙ্গিক তথ্য এবং নির্দিষ্ট প্রশ্ন দিন, আর এটি সফটওয়্যারের ব্যবহারের উপযোগী কাঠামোবদ্ধ সিদ্ধান্ত বা সম্ভাব্যতার মান ফেরত দেবে। এই নির্দেশিকায় ব্যাখ্যা করা হয়েছে, এসব মডেল কীভাবে কাজ করে, জেনারেটিভ এআইয়ের পাশাপাশি এগুলোর অবস্থান কোথায় এবং কীভাবে এগুলোর কার্যকারিতা মূল্যায়ন করবেন।
বৈষম্যমূলক এআই কী?
বৈষম্যমূলক এআই কোনো ইনপুট সম্পর্কে পূর্বাভাস দেয়। একটি স্প্যাম ফিল্টার অনুমান করে কোনো ইমেইল স্প্যাম কি না; একটি ক্লাসিফায়ার গ্রাহক সহায়তার টিকিটকে কোনো দলের কাছে বরাদ্দ করে; একটি ঝুঁকি নির্ধারণকারী মডেল নির্দিষ্ট কোনো ফলাফলের সম্ভাবনা অনুমান করে।
মেশিন লার্নিংয়ে, বৈষম্যমূলক মডেলগুলো সাধারণত ইনপুট x থেকে লক্ষ্যবস্তু y-এর মধ্যে একটি ম্যাপিং শেখে অথবা শর্তাধীন সম্ভাব্যতা P(y | x) নির্ধারণ করে। লক্ষ্যবস্তুটি কোনো শ্রেণি, সংখ্যাসূচক মান বা অন্য কোনো কাঠামোবদ্ধ আউটপুট হতে পারে। লজিস্টিক রিগ্রেশন, সাপোর্ট ভেক্টর মেশিন এবং অনেক নিউরাল ক্লাসিফায়ার বৈষম্যমূলক পদ্ধতির উদাহরণ। সব বৈষম্যমূলক মডেল সম্ভাব্যতার মান ফেরত দেয় না, আর সব সংখ্যাসূচক স্কোরও সঠিকভাবে ক্যালিব্রেট করা থাকে না।
এর মূল ধারণাটি আজকের এআই অ্যাসিস্ট্যান্টের আগের। নতুন বিষয় হলো, এখন সাধারণ উদ্দেশ্যে ব্যবহারের উপযোগী সিদ্ধান্ত গ্রহণের API পাওয়া যায়, যেখানে স্বাভাবিক ভাষায় কাজের বিবরণ এবং উত্তর বেছে নেওয়ার বিকল্প দেওয়া যায়। ফলে ডেভেলপাররা শ্রেণিবিন্যাস বা স্কোর নির্ধারণের নানা কাজে একই ইন্টারফেস ব্যবহার করতে পারেন।
এআই সিদ্ধান্ত গ্রহণের মডেল কী?
বর্তমান API ব্যবস্থায়, একটি সিদ্ধান্ত গ্রহণের মডেল (Decision Model) বলতে এমন মডেল বা পরিষেবাকে বোঝায়, যা সরবরাহ করা ইনপুট সম্পর্কে নির্দিষ্ট সীমার মধ্যে থাকা প্রশ্নের উত্তর দেওয়ার জন্য তৈরি। মুক্তধারার উত্তর তৈরি করার পরিবর্তে, এটি নিচের মতো নির্দিষ্ট ধরনের ফলাফল ফেরত দেয়:
- হ্যাঁ/না সম্ভাব্যতা: এই বার্তায় টাকা ফেরতের অনুরোধ থাকার সম্ভাবনা কত?
- নির্বাচন: এই টিকিটটি কোন বিভাগের কাছে পাঠানো উচিত?
- স্কোর: নির্ধারিত মানের মূল্যায়ন কাঠামোতে এই উত্তরটির অবস্থান কোথায়?
উদাহরণস্বরূপ, একটি সিদ্ধান্ত গ্রহণের মডেল প্রতিটি বিভাগের জন্য সম্ভাব্যতার মানসহ একটি বিলিং লেবেল ফেরত দিতে পারে। আপনার অ্যাপ্লিকেশন এই ফলাফল ব্যবহার করে টিকিটটি সংশ্লিষ্ট বিভাগে পাঠাতে, আরও তথ্য চাইতে অথবা মানব পর্যালোচকের কাছে পাঠাতে পারে।
TypeSafe তাদের Jev মডেল পরিবারকে “System One” মডেল হিসেবে উল্লেখ করে। Liquid AI তাদের d1 decision model-কে এমন একটি মডেল হিসেবে বর্ণনা করে, যা টেক্সট ও ছবি গ্রহণ করে এবং আউটপুট টোকেন তৈরি না করে সম্ভাব্যতার মান ফেরত দেয়। বৈষম্যমূলক মডেল নিয়ে Google Codelab-এ একটি অ্যাপ্লিকেশনে জেনারেটিভ মডেলের পাশাপাশি সিদ্ধান্ত গ্রহণের মডেল ব্যবহারের উদাহরণ দেখানো হয়েছে।
এই পরিভাষাগুলো পরস্পর সম্পর্কিত, তবে একে অপরের বিকল্প নয়। বৈষম্যমূলক মডেলিং মেশিন লার্নিংয়ের একটি বিস্তৃত ধারণা; সিদ্ধান্ত গ্রহণের মডেল হলো নির্দিষ্ট সীমার মধ্যে সিদ্ধান্ত নেওয়ার জন্য তৈরি পণ্য বা ইন্টারফেস। একটি জেনারেটিভ মডেলকেও প্রম্পটের মাধ্যমে টেক্সট শ্রেণিবদ্ধ করতে বলা যায়, যদিও এর অন্তর্নিহিত কনটেন্ট তৈরির প্রক্রিয়া এবং উত্তর দেওয়ার ধরন আলাদা।
বৈষম্যমূলক এআই বনাম জেনারেটিভ এআই
| বৈষম্যমূলক এআই | জেনারেটিভ এআই | |
|---|---|---|
| সাধারণ প্রশ্ন | “এই ইনপুটের সঙ্গে কোন শ্রেণিটি মেলে?” | “কী উত্তর বা কনটেন্ট তৈরি করা উচিত?” |
| প্রচলিত আউটপুট | লেবেল, পূর্বাভাস, স্কোর বা সম্ভাব্যতা | টেক্সট, কোড, ছবি, অডিও বা অন্য তৈরি করা কনটেন্ট |
| কাজের উদাহরণ | গ্রাহকের টিকিট নির্দিষ্ট বিভাগে পাঠানো | গ্রাহকের জন্য উত্তরের খসড়া তৈরি |
| যে সক্ষমতা যাচাই করা উচিত | নির্দিষ্ট সীমার মধ্যে ধারাবাহিক সিদ্ধান্ত এবং ব্যবহারযোগ্য স্কোর | নমনীয় সংশ্লেষণ, ব্যাখ্যা ও কনটেন্ট তৈরি |
| মূল্যায়নের প্রধান বিষয় | শ্রেণিবিন্যাসের ভুল, ক্যালিব্রেশন এবং থ্রেশহোল্ড | নির্ভুলতা, নির্দেশনা অনুসরণ, নিরাপত্তা ও উপযোগিতা |
এই বিভাজনের অর্থ এই নয় যে একটি মডেল কেবল একটি কাজ করতে পারে। একটি LLM JSON ফরম্যাটে লেবেল ফেরত দিতে পারে, আবার একটি সিদ্ধান্ত গ্রহণের ব্যবস্থা বৃহত্তর কর্মপ্রবাহের অংশ হিসেবে জেনারেটিভ মডেল ব্যবহার করতে পারে। ব্যবহারিক পার্থক্য হলো, প্রতিটি উপাদান কোন কাজের জন্য অপ্টিমাইজ করা হয়েছে এবং কী কাজ করার জন্য উন্মুক্ত করা হয়েছে। শুধু কাঠামোবদ্ধ API উত্তর পাওয়া গেলেই প্রমাণ হয় না যে এর সম্ভাব্যতার মান ক্যালিব্রেট করা হয়েছে অথবা এর অন্তর্নিহিত মডেলটি বৈষম্যমূলক।
টাকা ফেরতের টিকিটটির কথা বিবেচনা করুন। একটি সিদ্ধান্ত গ্রহণের মডেল সমস্যাটিকে বিলিং-সংক্রান্ত হিসেবে শনাক্ত করতে পারে এবং এর জরুরিতা অনুমান করতে পারে। এরপর একটি জেনারেটিভ মডেল প্রাসঙ্গিক টাকা ফেরত নীতি ব্যবহার করে সহানুভূতিশীল উত্তরের খসড়া তৈরি করতে পারে। কোনো পদক্ষেপ নেওয়ার আগে অ্যাপ্লিকেশনটির নীতি, অনুমতি এবং প্রয়োজনীয় মানব অনুমোদন যাচাই করা উচিত।
অ্যাপ্লিকেশনে সিদ্ধান্ত গ্রহণের মডেল কীভাবে কাজ করে
সঠিক স্কিমা প্রদানকারীভেদে আলাদা হয়, তবে একটি সাধারণ সিদ্ধান্ত গ্রহণের অনুরোধে তিনটি অংশ থাকে:
- অবস্থা (State): মূল্যায়নের জন্য প্রয়োজনীয় তথ্য, যেমন টিকিটের টেক্সট বা কোনো ছবি।
- প্রশ্ন ও মানদণ্ড (Question and criteria): যে সিদ্ধান্ত নিতে হবে এবং অনুমোদিত উত্তর বা স্কোরের স্তরগুলোর বিবরণ।
- নির্দিষ্ট ধরনের উত্তর (Typed response): অ্যাপ্লিকেশনের ব্যাখ্যার জন্য ফেরত দেওয়া লেবেল, স্কোর বা সম্ভাব্যতার বণ্টন।
উদাহরণ:
State: "I was charged twice for my subscription."
Question: Which team should handle this request?
Options: billing, technical support, sales
Illustrative result: billing
এটি একটি ধারণাগত উদাহরণ, প্রকৃত API উত্তর নয়। এন্ডপয়েন্টের ওপর নির্ভর করে মডেলটি আত্মবিশ্বাসের মাত্রা বা সম্ভাব্যতার মানও দিতে পারে। নির্দিষ্ট মডেল ও API-এর ডকুমেন্টেশন অনুসরণ করুন। সব প্রদানকারী একই অনুরোধের ফরম্যাট ব্যবহার করে বা একই ধরনের ইনপুট সমর্থন করে—এমন ধারণা করবেন না।
সম্ভাব্যতার স্কোরের অর্থ কী?
একটি পূর্বাভাসিত সম্ভাব্যতার মান তখনই কার্যকর, যখন আপনি এর নির্ভরযোগ্যতা বোঝেন। কোনো সিস্টেম যদি একই ধরনের অনেক পূর্বাভাসে 0.8 স্কোর দেয়, তাহলে সঠিকভাবে ক্যালিব্রেট করা সিস্টেমে সেই গোষ্ঠীর প্রায় ৮০% পূর্বাভাস সঠিক হওয়ার কথা। একটি নির্দিষ্ট 0.8 স্কোর কোনো ব্যক্তিগত সিদ্ধান্তের নির্ভুলতা নিশ্চিত করে না।
নিজস্ব ডেটায় ক্যালিব্রেশন যাচাই করুন, বিশেষ করে মডেল, লেবেল, ভাষা বা ইনপুটের উৎস পরিবর্তনের পর। কম আত্মবিশ্বাসের ক্ষেত্রগুলো পর্যালোচনার জন্য পাঠাতে থ্রেশহোল্ড ব্যবহার করতে পারেন। তবে ভুল ইতিবাচক (False Positive) এবং ভুল নেতিবাচক (False Negative) ফলাফলের খরচ বিবেচনা করে থ্রেশহোল্ড নির্ধারণ করুন। জালিয়াতি পর্যালোচনার সারি এবং নিরীহ কনটেন্ট সুপারিশের জন্য আলাদা নিয়ম প্রয়োজন।
বৈষম্যমূলক এআইয়ের উদাহরণ ও ব্যবহারক্ষেত্র
গ্রাহক সহায়তার টিকিট শ্রেণিবিন্যাস ও রাউটিং
একটি সিদ্ধান্ত গ্রহণের মডেল আগত বার্তাগুলোকে বিলিং, প্রযুক্তিগত সহায়তা বা অ্যাকাউন্ট ব্যবস্থাপনা বিভাগে বরাদ্দ করতে পারে। অস্পষ্ট অনুরোধের জন্য “অন্যান্য” অথবা “পর্যালোচনা প্রয়োজন” বিকল্প রাখুন এবং একাধিক সমস্যা থাকা বার্তা পরীক্ষা করুন। শুধু সামগ্রিক নির্ভুলতা নয়, প্রতিটি বিভাগের ভুলের হার মূল্যায়ন করুন। নিয়মিত প্রশ্নে ভরা ডেটাসেটে ভালো ফল করলেও জরুরি বিলিং অভিযোগ শনাক্ত করতে ব্যর্থ হলে মডেলটি কার্যকর হবে না।
কনটেন্ট মডারেশন
একটি মডারেশন কর্মপ্রবাহে কোনো কনটেন্ট নির্ধারিত নীতিমালার শ্রেণিতে পড়ে কি না, তা জানতে চাওয়া যায়। মডেলকে স্পষ্ট মানদণ্ড ও উদাহরণ দিন, প্রান্তিক পরিস্থিতি পরীক্ষা করুন এবং অনিশ্চিত বা গুরুত্বপূর্ণ ক্ষেত্রগুলো প্রশিক্ষিত পর্যালোচকদের কাছে পাঠান। সিদ্ধান্ত গ্রহণের স্কোর আপনার নীতিমালা বাস্তবায়নের একটি ইনপুট, কোনো কনটেন্ট নিয়ম লঙ্ঘন করেছে—তার প্রমাণ নয়।
LLM এবং এজেন্ট রাউটিং
কোনো LLM কল করার আগে একটি অ্যাপ্লিকেশন অনুরোধটিকে বিষয়, জটিলতা বা প্রয়োজনীয় ইনপুটের ধরন অনুযায়ী শ্রেণিবদ্ধ করতে পারে। এরপর রাউটিং উপাদানটি একটি কর্মপ্রবাহ বেছে নিতে বা অতিরিক্ত তথ্য চাইতে পারে। পরবর্তী ব্যবস্থার সঙ্গে রাউটিং পরীক্ষা করুন: প্রথম ধাপের খরচ কম হলেও যদি এটি জটিল অনুরোধগুলোকে ভুল পথে পাঠায়, তাহলে সেই সুবিধা কাজে আসবে না।
নথি ও ছবির প্রাথমিক শ্রেণিবিন্যাস
একটি মাল্টিমোডাল সিদ্ধান্ত গ্রহণের মডেল কোনো ছবি বা নথিকে পূর্বনির্ধারিত শ্রেণিতে ফেলতে পারে, যেমন চালান, রসিদ বা গ্রাহক সহায়তার স্ক্রিনশট। আপনার প্রয়োজনীয় ইনপুট ফরম্যাট এবং ছবি ব্যবস্থাপনা নির্দিষ্ট এন্ডপয়েন্ট সমর্থন করে কি না যাচাই করুন। শ্রেণিবিন্যাস এবং নথির প্রতিটি তথ্যক্ষেত্র বের করা দুটি আলাদা কাজ। নির্বাচিত মডেল ও API উভয় কাজ সমর্থন করে কি না পরীক্ষা করুন।
মূল্যায়ন কাঠামোভিত্তিক স্কোরিং
একটি মডেল “গুরুত্বপূর্ণ প্রমাণ অনুপস্থিত,” “আংশিকভাবে সমর্থিত” এবং “সম্পূর্ণভাবে সমর্থিত”-এর মতো বিবরণ ব্যবহার করে কোনো উত্তরকে নির্ধারিত ক্রমের স্কেলে স্থান দিতে পারে। পর্যালোচকদের লেবেল নির্ধারণে মতের মিল আছে কি না এবং মডেলটি একই ধরনের উত্তরকে একইভাবে মূল্যায়ন করে কি না পরীক্ষা করুন। যাচাই ছাড়া মূল্যায়ন কাঠামোর স্কোরকে বস্তুনিষ্ঠ পরিমাপ হিসেবে উপস্থাপন করবেন না।
Felo মডেল ক্যাটালগে থাকা সিদ্ধান্ত গ্রহণের মডেল
Felo মডেল ক্যাটালগে একটি Decisions আউটপুট ফিল্টার রয়েছে। ২ নভেম্বর, ২০২৬ তারিখে তালিকাভুক্ত উদাহরণগুলো হলো:
| ক্যাটালগে তালিকাভুক্ত মডেল | বর্ণিত ব্যবহার | ক্যাটালগে প্রদর্শিত ইনপুট |
|---|---|---|
| TypeSafe Jev 1.14 | রাউটিং, শ্রেণিবিন্যাস এবং মডারেশন | টেক্সট ও ছবি; তালিকায় ছবির সমর্থনকে পরীক্ষামূলক বলা হয়েছে |
| LiquidAI d1.1 | হ্যাঁ/না, নির্বাচন এবং স্কোরভিত্তিক সিদ্ধান্ত | টেক্সট ও ছবি |
| Baseten Joey 1 | শ্রেণিবিন্যাস এবং রাউটিং | টেক্সট ও ছবি |
| Perplexity Decider Flash V1.2 | শ্রেণিবিন্যাস, রাউটিং এবং স্কোরিং | টেক্সট ও ছবি |
এই বিবরণগুলো ক্যাটালগের তথ্যের প্রতিফলন, স্বাধীন কার্যকারিতা পরীক্ষার ফল নয় এবং কোনো একটি মডেলকে সেরা হিসেবে সুপারিশও করে না। প্রাপ্যতা, ফিচার সমর্থন, কনটেক্সট সীমা এবং মূল্য পরিবর্তিত হতে পারে। ডেভেলপমেন্ট শুরুর আগে বর্তমান তালিকা ও এন্ডপয়েন্টের ডকুমেন্টেশন যাচাই করুন, বিশেষ করে পরীক্ষামূলক বা মাল্টিমোডাল ফিচারের ক্ষেত্রে। কোনো মডেল ক্যাটালগে তালিকাভুক্ত থাকলেই প্রমাণ হয় না যে প্রতিটি প্ল্যাটফর্মে প্রদানকারীর সব নেটিভ API ফিচার পাওয়া যাবে।
এআই সিদ্ধান্ত গ্রহণের মডেল কীভাবে মূল্যায়ন করবেন
একটি নির্দিষ্ট সিদ্ধান্ত দিয়ে শুরু করুন এবং নির্ভরযোগ্য লেবেলযুক্ত প্রতিনিধিত্বমূলক উদাহরণের একটি সেট তৈরি করুন। কঠিন পরিস্থিতি, সংখ্যালঘু শ্রেণি, অনুপস্থিত কনটেক্সট এবং যেসব ক্ষেত্রে মানুষের হস্তক্ষেপ প্রয়োজন—সেসব উদাহরণ অন্তর্ভুক্ত করুন। এরপর মডেলটির ফলাফলকে একটি সাধারণ বেসলাইন, বিদ্যমান ক্লাসিফায়ার অথবা কাঠামোবদ্ধ আউটপুটসহ একটি LLM-এর সঙ্গে তুলনা করুন।
শুধু নির্ভুলতা নয়, আরও কিছু বিষয় পরিমাপ করুন:
- Precision এবং Recall: কোন ধরনের ভুল গুরুত্বপূর্ণ এবং প্রতিটি শ্রেণিতে সেগুলো কতবার ঘটে?
- Calibration: বিভিন্ন কেসের গোষ্ঠীতে পূর্বাভাসিত সম্ভাব্যতা কি পর্যবেক্ষিত ফলাফলের সঙ্গে মেলে?
- Coverage: নির্ধারিত থ্রেশহোল্ডে কত শতাংশ অনুরোধ স্বয়ংক্রিয়ভাবে পরিচালনা করা যায়?
- Latency এবং Reliability: সম্পূর্ণ API কল কি আপনার প্রোডাকশন ব্যবস্থার শর্ত পূরণ করে?
- Cost: পুনরায় চেষ্টা, একাধিক প্রশ্ন, ছবি প্রক্রিয়াকরণ এবং মানব পর্যালোচনাসহ প্রতিটি কার্যকর সিদ্ধান্তের খরচ কত?
- Robustness: বিভিন্ন ভাষা, ফরম্যাট, অপরিচিত উদাহরণ এবং পরিবর্তনশীল ট্রাফিকের ক্ষেত্রেও কি কার্যকারিতা বজায় থাকে?
লেবেল ও থ্রেশহোল্ড নির্ধারণের পর আলাদা করে রাখা একটি টেস্ট সেট ব্যবহার করুন। প্রোডাকশন ব্যবস্থায় প্রয়োজন অনুযায়ী ফলাফল লগ করুন, মতবিরোধ পর্যালোচনা করুন এবং মডেলের সংস্করণ, নীতিমালা বা ইনপুটের বণ্টন পরিবর্তনের পর পুনর্মূল্যায়ন করুন। গুরুত্বপূর্ণ সিদ্ধান্তের ক্ষেত্রে কার্যকর মানব তদারকির ব্যবস্থা তৈরি করুন এবং প্রযোজ্য শর্তাবলি যাচাই করুন।
সচরাচর জিজ্ঞাসিত প্রশ্ন
বৈষম্যমূলক এআই কি সিদ্ধান্ত গ্রহণের মডেলের সমান?
ঠিক তা নয়। বৈষম্যমূলক এআই বলতে ইনপুট থেকে কোনো লক্ষ্যবস্তু অনুমানের একটি বিস্তৃত পদ্ধতিকে বোঝায়। সিদ্ধান্ত গ্রহণের মডেল হলো নতুন একটি পণ্যশ্রেণি, যা নির্বাচন, স্কোর এবং সম্ভাব্যতার মতো নির্দিষ্ট সীমার মধ্যে থাকা আউটপুটের ওপর গুরুত্ব দেয়। কিছু সিদ্ধান্ত গ্রহণের মডেল বৈষম্যমূলক কৌশল ব্যবহার করে, তবে এই দুটি পরিভাষা একই বিষয় বোঝায় না।
একটি LLM কি শ্রেণিবিন্যাস বা সিদ্ধান্ত গ্রহণ করতে পারে?
হ্যাঁ। একটি জেনারেটিভ LLM-কে কনটেন্ট শ্রেণিবিন্যাস বা কাঠামোবদ্ধ আউটপুট ফেরত দেওয়ার নির্দেশনা দেওয়া যায়। একটি নির্দিষ্ট সিদ্ধান্ত গ্রহণের মডেল আরও ভালো, দ্রুত বা কম খরচে কাজ করবে কি না, তা নির্ভর করে কাজ, মডেল, প্রদানকারী এবং মূল্যায়ন পদ্ধতির ওপর। নিজের উদাহরণ ব্যবহার করে উভয় পদ্ধতি পরীক্ষা করুন।
সিদ্ধান্ত গ্রহণের মডেলের সম্ভাব্যতার মান কি সব সময় নির্ভুল হয়?
না। কোনো নির্দিষ্ট ডেটাসেট বা উপগোষ্ঠীর ক্ষেত্রে একটি মডেলের সম্ভাব্যতার মান ভুলভাবে ক্যালিব্রেট করা থাকতে পারে। কর্মপ্রবাহ স্বয়ংক্রিয় করতে থ্রেশহোল্ড ব্যবহারের আগে ক্যালিব্রেশন এবং ভুল সিদ্ধান্তের পরিণতি পরিমাপ করুন।
কখন জেনারেটিভ এআই ব্যবহার করা উচিত?
যখন কোনো কাজে খসড়া তৈরি, ব্যাখ্যা, সংশ্লেষণ বা মুক্তধারার কনটেন্ট তৈরির প্রয়োজন হয়, তখন জেনারেটিভ মডেল ব্যবহার করুন। অনেক অ্যাপ্লিকেশনে সিদ্ধান্ত গ্রহণের মডেল এবং জেনারেটিভ মডেল একসঙ্গে কাজ করে: একটি রাউটিং বা শ্রেণিবিন্যাস করে, অন্যটি উত্তর তৈরি করে।
বৈষম্যমূলক এআই ডেভেলপারদের কর্মপ্রবাহে স্পষ্ট ও পরিমাপযোগ্য সিদ্ধান্ত যুক্ত করার সুযোগ দেয়। একটি নির্দিষ্ট সীমার মধ্যে থাকা কাজ দিয়ে শুরু করুন, গুরুত্বপূর্ণ ভুলগুলো পরীক্ষা করুন এবং প্রাপ্ত প্রমাণের ভিত্তিতে কতটুকু কাজ স্বয়ংক্রিয় করা যায় তা নির্ধারণ করুন।
Felo ক্যাটালগে সিদ্ধান্ত গ্রহণের মডেল দেখুন →
এই পোস্টটি নিম্নলিখিত ভাষায়ও উপলব্ধ: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español and Português।