
Felo API-তে Gemini 4 Carbon: বৈশিষ্ট্য, বেঞ্চমার্ক, মূল্য এবং ব্যবহারের ক্ষেত্র

Felo API-তে Gemini 4 Carbon: এর 1M-টোকেনের সমন্বিত বাজেট, থিংকিং লেভেল, মাল্টিমোডাল সীমা, প্রকাশিত বেঞ্চমার্ক, প্রকৃত মূল্য এবং API ব্যবহারের পদ্ধতি।
Google-এর Gemini 4 Carbon এমন কাজের জন্য তৈরি একটি মডেল, যেগুলো অল্প সময়ে শেষ করা সম্ভব নয়। যেমন, কয়েক ডজন সার্ভিসে পরিবর্তন আনা প্রয়োজন এমন কোডবেস মাইগ্রেশন, কার্যকর প্যাচ তৈরির মাধ্যমে শেষ করতে হয় এমন নিরাপত্তা দুর্বলতা অনুসন্ধান, অথবা একাধিক প্রমাণের ধারাবাহিকতা প্রয়োজন এমন গবেষণামূলক প্রশ্ন।
Felo API-এর মাধ্যমে এই মডেল ব্যবহার করা যায়। Felo-তে সীমিত সময়ের জন্য বিনামূল্যের ট্রায়াল এবং ছাড়যুক্ত প্রোভাইডার রেট রয়েছে। এই নির্দেশিকা পড়ার আগে আপনি Felo-এর Gemini 4 Carbon পেজে গিয়ে মডেলটি খুলতে, প্লেগ্রাউন্ডে প্রম্পট পরীক্ষা করতে এবং API কী তৈরি করতে পারেন।
এই নিবন্ধটি একটি ব্যবহারিক নির্দেশিকা, কোনো উদ্বোধনী ঘোষণা নয়। এতে Gemini 4 Carbon-এর প্রকৃত পরিচয়, Gemini 4 Argon-এর সঙ্গে এর পার্থক্য, প্রকাশিত বেঞ্চমার্ক থেকে কী জানা যায় এবং কী জানা যায় না, এর ব্যতিক্রমী টোকেন বাজেটের কার্যপদ্ধতি, মডেলটির শক্তিশালী ও দুর্বল দিক এবং Felo-তে এর বর্তমান মূল্য নিয়ে আলোচনা করা হয়েছে।
Gemini 4 Carbon কী
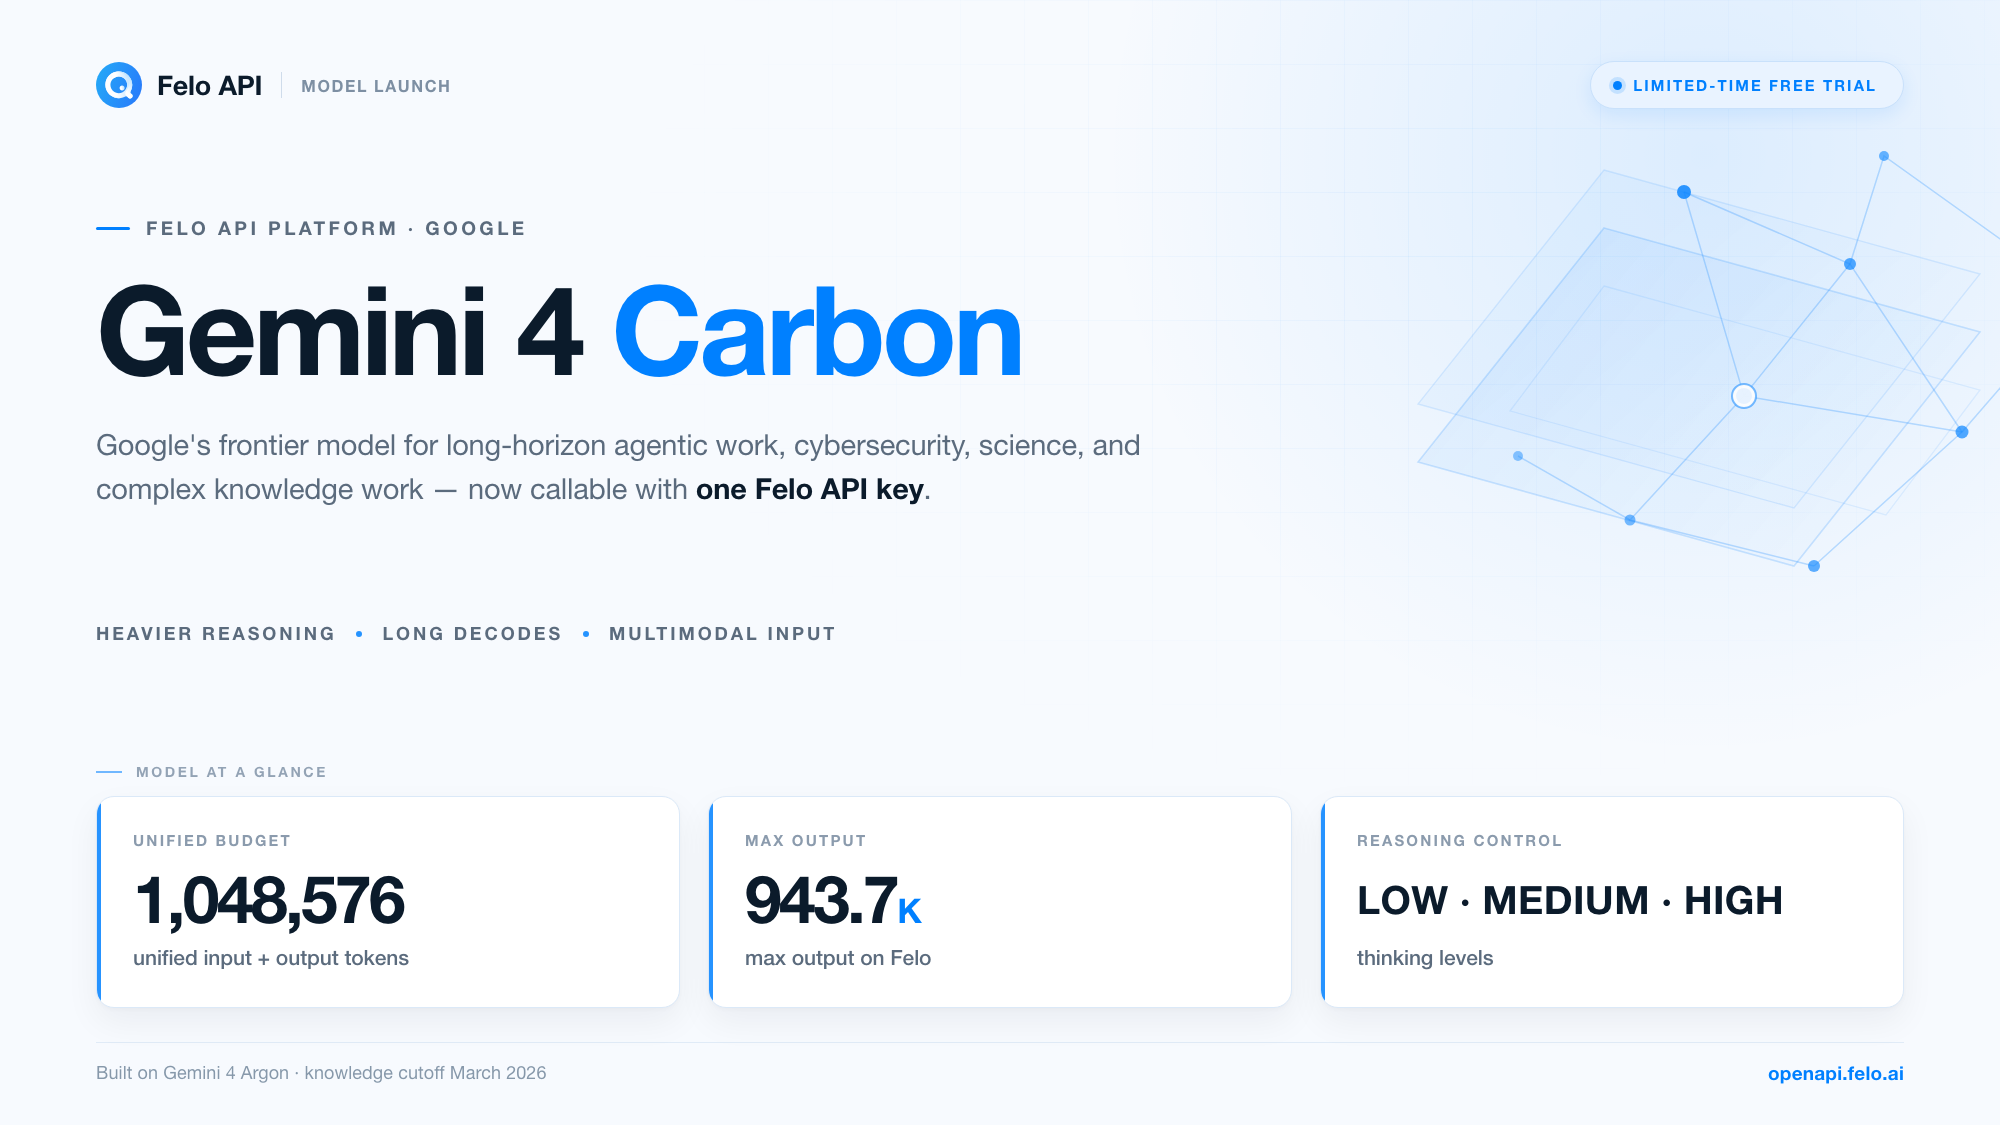
Gemini 4 Carbon হলো কোডিং, অর্থনীতি, আইন, সাইবার নিরাপত্তা এবং বিজ্ঞানের দীর্ঘমেয়াদি এজেন্টভিত্তিক কাজের জন্য Google-এর উন্নত মডেল। Google ২০২৬ সালের ২৮ অক্টোবর মডেলটি ঘোষণা করে। এটি Gemini 4 Argon-এর ওপর ভিত্তি করে তৈরি এবং প্রাথমিক পর্যায়ে Fairwind Program-এর মাধ্যমে নির্বাচিত কিছু সাইবার নিরাপত্তা বিশেষজ্ঞের জন্য উন্মুক্ত করা হয়। Google-এর এন্টারপ্রাইজ প্ল্যাটফর্মের নথিতে মডেলটিকে সাধারণ ব্যবহারের জন্য উপলভ্য হিসেবে দেখানো হয়েছে, যার প্রকাশের তারিখ ১০ নভেম্বর, ২০২৬।
"Carbon" নামটি নতুন প্রজন্মের কোনো মডেল নির্দেশ করে না। এটি Gemini 4 পরিবারের মধ্যে একটি ভিন্ন কার্যপদ্ধতি নির্দেশ করে। Argon-কে একটি ধারাবাহিক প্রক্রিয়ায় দীর্ঘ ও সুসংগঠিত নথি তৈরির জন্য সাজানো হয়েছিল। Carbon তার বাজেটের বড় অংশ চিন্তা-ভাবনার জন্য ব্যয় করে: সম্ভাব্য সমাধান অনুসন্ধান, যাচাইয়ের একাধিক ধাপ এবং বহু-পর্যায়ের কাজের সমন্বয়। Google-এর ভাষ্য অনুযায়ী, উত্তর তৈরির জন্য Carbon Argon-এর তুলনায় বেশি thinking token ব্যবহার করে।
এই সুবিধার বিনিময়ে কিছু খরচ রয়েছে। কঠিন কাজে মডেলটির গতি কম, কিছু পরিস্থিতিতে টাইমআউট হতে পারে এবং উচ্চতর থিংকিং লেভেলে বেশি টোকেন ব্যয় হয়। Google এই সীমাবদ্ধতাগুলো স্পষ্টভাবে উল্লেখ করেছে। তবু Carbon ব্যবহারের কারণ হলো, এর লক্ষ্যভুক্ত কাজগুলো—নিরাপত্তা বিশ্লেষণ, বড় কোড মাইগ্রেশন, বৈজ্ঞানিক যুক্তি এবং গুরুত্বপূর্ণ নথি পর্যালোচনা—গতির চেয়ে গভীর বিশ্লেষণকে বেশি গুরুত্ব দেয়।
এক নজরে মডেলের বৈশিষ্ট্য
| বৈশিষ্ট্য | মান |
|---|---|
| Felo-তে মডেল ID | gemini-4-carbon |
| ঘোষণার তারিখ | ২৮ অক্টোবর, ২০২৬ |
| ভিত্তি মডেল | Gemini 4 Argon |
| কনটেক্সট ও আউটপুট | ইনপুট ও আউটপুট মিলিয়ে 1,048,576 টোকেনের একটি সমন্বিত বাজেট |
| Felo-তে তালিকাভুক্ত সর্বোচ্চ আউটপুট | 943.718K টোকেন |
| ইনপুট | টেক্সট, ছবি, অডিও, ভিডিও, PDF এবং Office/OpenDocument ফাইল |
| আউটপুট | টেক্সট |
| থিংকিং লেভেল | LOW, MEDIUM (ডিফল্ট), HIGH |
| জ্ঞানভান্ডারের শেষ তারিখ | মার্চ ২০২৬ |
| স্যাম্পলিং | Temperature 1.0, top-p 0.95, top-k 64, নির্দিষ্ট |
| ক্যাশিং | শুধু Implicit caching, সর্বনিম্ন 4,096 টোকেন |
| প্রস্তাবিত Felo ইন্টারফেস | Messages API (Anthropic-compatible) |
| অ্যাক্সেস | নির্বাচিত অঞ্চলের যাচাইকৃত এন্টারপ্রাইজ গ্রাহক; সাইবার সংস্করণ শুধু অনুমোদিত তালিকার জন্য |
এই তালিকার দুটি বিষয় আলাদা আলোচনার দাবি রাখে, কারণ এগুলো মডেলটির সঙ্গে আপনার অ্যাপ্লিকেশন তৈরির পদ্ধতি বদলে দেয়: সমন্বিত টোকেন বাজেট এবং থিংকিং লেভেল।
Gemini 4 Carbon ও Gemini 4 Argon-এর পার্থক্য
Carbon এবং Argon একই মডেল পরিবার, একই জ্ঞানভান্ডারের শেষ তারিখ এবং অনেক ক্ষেত্রে একই ধরনের ব্যবহারের লক্ষ্য ভাগ করে। পার্থক্যটি মূলত মডেল তার সক্ষমতা কীভাবে ব্যয় করে, সেখানে।
ইনপুট ও আউটপুটের সমন্বিত বাজেট। Argon-কে সাধারণত 1,048,576-টোকেনের কনটেক্সট উইন্ডো এবং আলাদা 65,536-টোকেনের ডিফল্ট আউটপুট হিসেবে বর্ণনা করা হয়। Carbon-এর 1,048,576 টোকেন ইনপুট, চিন্তা-ভাবনা, টুল কল এবং চূড়ান্ত উত্তর—সবকিছুর জন্য একসঙ্গে বরাদ্দ। এটি একটি একক বাজেট, কনটেক্সট উইন্ডোর সঙ্গে আলাদা আউটপুট সীমা নয়।
ডিফল্টভাবেই গভীর যুক্তি বিশ্লেষণ। Carbon-এ LOW, MEDIUM এবং HIGH থিংকিং লেভেল রয়েছে। gemini-4-carbon-এর ডিফল্ট MEDIUM এবং cyber-permissive সংস্করণের ডিফল্ট HIGH। এটি দীর্ঘ যাচাই প্রক্রিয়া চালানোর জন্য তৈরি। তাই Google বেশি টোকেন ব্যবহারের বিষয়টিকে বাগ নয়, বরং পরিচিত সীমাবদ্ধতা হিসেবে উল্লেখ করেছে।
দীর্ঘ ডিকোড। স্ট্রিমিং চালু থাকলে একটি foreground segment সর্বোচ্চ 65,536 আউটপুট টোকেন তৈরি করতে পারে। স্ট্রিমিং বন্ধ থাকলে এই সীমা 32,768 টোকেন। দীর্ঘ ডিকোডের মাধ্যমে এই সীমার বাইরে আউটপুট চালিয়ে যাওয়া যায়। Google Gen AI SDK এবং Agent Studio স্বয়ংক্রিয়ভাবে continuation token পরিচালনা করে। চাইলে নিজস্ব continuation loop-ও তৈরি করা যায়। তাত্ত্বিক সর্বোচ্চ সীমা হলো ইনপুট বাদ দেওয়ার পর অবশিষ্ট সমন্বিত বাজেট।
আরও সমৃদ্ধ ফাইল সমর্থন। PDF এবং সাধারণ টেক্সটের পাশাপাশি Carbon Microsoft Office ও OpenDocument ফাইল গ্রহণ করে—.docx, .doc, .pptx, .ppt, .xlsx, .xls, .odt, .odp, .ods। ফাইলগুলো সরাসরি ইনলাইন হিসেবে অথবা ক্লাউড স্টোরেজ থেকে দেওয়া যায়। আপনার কাজের শুরু যদি সাধারণ টেক্সট এক্সপোর্টের পরিবর্তে প্রেজেন্টেশন, স্প্রেডশিট বা চুক্তিপত্র দিয়ে হয়, তাহলে এই সুবিধা গুরুত্বপূর্ণ।
নিরাপত্তাভিত্তিক সমন্বয় এবং আলাদা সাইবার সংস্করণ। Google জানিয়েছে, লাইভ কোডিং পরিবেশে উচ্চ-তীব্রতার misalignment সতর্কতা প্রায় 80% কমেছে। টেক্সট-টু-টেক্সট নিরাপত্তা মূল্যায়নে বহুভাষিক ও মাল্টিমোডাল কনটেন্ট নিরাপত্তার ক্ষেত্রে Carbon, Argon-এর তুলনায় 3.50 percentage point ভালো ফল করেছে। এছাড়া gemini-4-carbon-cyber-permissive নামে একটি সংস্করণ রয়েছে। এটি শুধু অনুমোদিত তালিকাভুক্ত ব্যবহারকারীদের জন্য, প্রতিরক্ষামূলক নিরাপত্তার কাজে তৈরি, ডিফল্ট HIGH থিংকিং ব্যবহার করে এবং computer use সুবিধা বাদ দেয়।
বিজ্ঞানভিত্তিক বিশেষ সক্ষমতা। Google-এর দাবি, মডেলটি নিরাপত্তার লক্ষ্যকে গাণিতিক উপপাদ্যে রূপান্তর করতে পারে এবং petabase-স্কেলের সিকোয়েন্স আর্কাইভে দূরবর্তী homolog নিজে থেকে খুঁজে বের করতে পারে। কম-homolog প্রোটিন পরিবারের ক্ষেত্রে homolog শনাক্তকরণে গড়ে 40 গুণ বৃদ্ধির কথাও জানানো হয়েছে। এটি একটি নির্দিষ্ট গবেষণামূলক কাজের জন্য সীমিত দাবি। সাধারণ সক্ষমতা হিসেবে গ্রহণ না করে নিজের ডেটায় এর ফল পরীক্ষা করা উচিত।
সমন্বিত টোকেন বাজেটের ব্যাখ্যা
বেশিরভাগ মডেলের পেজে দুটি সংখ্যা থাকে: একটি কনটেক্সট উইন্ডো এবং একটি সর্বোচ্চ আউটপুট। Carbon-এ রয়েছে একটি সংখ্যা এবং প্রতি-সেগমেন্টের একটি নিয়ম। পুরোনো পদ্ধতিতে অনুরোধ পরিকল্পনা করলে আপনার হাতে থাকা জায়গা সম্পর্কে ভুল ধারণা তৈরি হতে পারে অথবা বিলের হিসাব ভুল হতে পারে।
বাজেটটি চারটি অংশে বিভক্ত:
- ইনপুট — আপনার প্রম্পট, সংযুক্ত নথি, ছবি, অডিও, ভিডিও ফ্রেম এবং আগের কথোপকথন।
- চিন্তা-ভাবনা — উত্তর দেওয়ার আগে মডেল যে reasoning token ব্যবহার করে। HIGH লেভেলে এর পরিমাণ অনেক হতে পারে।
- টুল কল — টুল সক্রিয় থাকলে মডেল যেসব টুল ব্যবহার করে।
- চূড়ান্ত উত্তর — আপনি যে টেক্সটটি পান।
এই চারটি অংশ একই 1,048,576 টোকেন থেকে বরাদ্দ পায়। 900K টোকেনের ইনপুটসহ একটি অনুরোধে আউটপুটের জন্য 1M টোকেন অবশিষ্ট থাকে না। চিন্তা-ভাবনা, টুল এবং উত্তর মিলিয়ে প্রায় 148K টোকেন থাকে, continuation ব্যবহারের আগেই।
প্রতি-সেগমেন্টের সীমা আলাদা। স্ট্রিমিং অনুরোধে একটি সেগমেন্টের সর্বোচ্চ আউটপুট 65,536 টোকেন। স্ট্রিমিং বন্ধ থাকলে তা 32,768 টোকেন। দীর্ঘ ডিকোড সেগমেন্টের সীমা পার হওয়ার পরও সমন্বিত বাজেট শেষ না হওয়া পর্যন্ত আউটপুট চালিয়ে যেতে পারে। আপনার ইন্টিগ্রেশন যদি max_tokens-কে মোট আউটপুটের প্রতিশ্রুতি হিসেবে ধরে, তাহলে সেটি ভুল। এটি একটি সেগমেন্টের সীমা নির্ধারণ করে। SDK-এর continuation ব্যবস্থাই দীর্ঘ নথি তৈরির সুযোগ দেয়।
Felo-এর মডেল পেজে সর্বোচ্চ আউটপুট হিসেবে 943.718K টোকেন উল্লেখ করা হয়েছে। এটিকে Felo-এর রুটে আউটপুটের সর্বোচ্চ সীমা হিসেবে বিবেচনা করুন, দ্বিতীয় কোনো বড় কনটেক্সট উইন্ডো হিসেবে নয়। সমন্বিত বাজেটে আপনার উত্তর কতটা জায়গা পাবে, তা নির্ভর করে আপনি কতটুকু ইনপুট পাঠিয়েছেন তার ওপর।
এর নকশাগত সিদ্ধান্তটি সহজ: প্রথমে আউটপুটের আকার নির্ধারণ করুন, তারপর সেই অনুযায়ী ইনপুট সাজান। দীর্ঘ প্রতিবেদন তৈরির ক্ষেত্রে আউটপুট ও চিন্তা-ভাবনার জন্য বাজেট সংরক্ষণ করুন এবং সেই অনুযায়ী উৎস উপাদান কমান। বড় নথির সেট বিশ্লেষণের ক্ষেত্রে মেনে নিন যে উত্তর ইনপুটের তুলনায় ছোট হবে। continuation অথবা একাধিক ধাপের প্রম্পটের পরিকল্পনা রাখুন।
থিংকিং লেভেল: মানের উৎস কোথায়
Carbon-এ তিনটি থিংকিং লেভেল রয়েছে: LOW, MEDIUM এবং HIGH। ডিফল্ট হলো MEDIUM। Google-এর নথিতে স্পষ্ট বলা হয়েছে, thinking_budget এবং thinking_level="MINIMAL" ব্যবহার করলে validation error আসে। অর্থাৎ যুক্তি বিশ্লেষণ সম্পূর্ণ বন্ধ করার সুযোগ নেই।
ব্যবহারিক পার্থক্যটি স্পষ্ট। LOW লেভেলে মডেলটি দ্রুতগতির উন্নত চ্যাট মডেলের মতো আচরণ করে: তথ্য বের করা, শ্রেণিবিন্যাস, পুনর্লিখন এবং সাধারণ কোড পর্যালোচনার জন্য উপযোগী। MEDIUM লেভেলে এটি পরিকল্পনা ও নিজের কাজ যাচাই করার জন্য টোকেন ব্যয় শুরু করে। HIGH লেভেলে দীর্ঘ যাচাই প্রক্রিয়া চলে। সূক্ষ্ম ভুল শনাক্ত করার সম্ভাবনা এই সেটিংয়ে বেশি, তবে ধীরগতি ও বেশি খরচের সম্ভাবনাও বেশি।
ব্যবহারিক কাজে কয়েকটি নিয়ম অনুসরণ করা যায়:
- ভুল উত্তরের খরচ অনুযায়ী লেভেল নির্বাচন করুন। কোনো ভুল শনাক্ত ও সংশোধনের খরচ কম হলে LOW ব্যবহার করুন। ভুলটি যদি উৎপাদন পরিবেশে চলে যায় অথবা কোনো আইনি নথিতে যুক্ত হয়, তাহলে HIGH পরীক্ষা করুন।
- প্রতি অনুরোধের টোকেন নয়, গ্রহণযোগ্য ফলপ্রতি টোকেন পরিমাপ করুন। উচ্চতর থিংকিং লেভেল পুনরায় চেষ্টা ও কাজের পুনরাবৃত্তি কমাতে পারে। তবে MEDIUM-এ সমাধানযোগ্য কাজে খরচ কয়েক গুণ বাড়াতে পারে। পুরো প্রক্রিয়ার খরচ তুলনা করুন।
- বেঞ্চমার্কের সেটিং আপনার কাজেও প্রযোজ্য ধরে নেবেন না। Google-এর প্রকাশিত প্রধান ফলাফলে ব্যবহৃত থিংকিং লেভেল সব ক্ষেত্রে উল্লেখ করা হয়নি। কোনো পাইপলাইনে যুক্ত করার আগে নিজের কাজ দুটি লেভেলে পরীক্ষা করুন।
স্যাম্পলিং নির্দিষ্ট: temperature 1.0, top-p 0.95 এবং top-k 64। কাস্টম মান উপেক্ষা করা হয়। আপনার পাইপলাইন যদি কম temperature-ভিত্তিক নির্ধারিত ফলাফলের ওপর নির্ভর করে, তাহলে সেই ধাপের জন্য Carbon উপযুক্ত নয়। বিচার-বিশ্লেষণ ও তথ্য সমন্বয়ের কাজে এটি ব্যবহার করুন। নির্ধারিত ফলাফল প্রয়োজন এমন ধাপ অন্য কোনো স্যাম্পলিং নিয়ন্ত্রণ সমর্থনকারী মডেলে রাখুন।
Google-এর প্রকাশিত তথ্য: বেঞ্চমার্ক ও তার অর্থ
Felo-এর মডেল পেজে Carbon-এর জন্য প্রোভাইডার-প্রকাশিত বেঞ্চমার্কের ফলাফল একত্র করা হয়েছে। নিচের তুলনাগুলোকে দিকনির্দেশক হিসেবে দেখুন। ফলাফলগুলো Google অথবা মূল্যায়নকারী প্রোভাইডারের কাছ থেকে এসেছে। এই নিবন্ধের জন্য সেগুলো স্বাধীনভাবে পুনরায় পরীক্ষা করা হয়নি। এগুলো নির্দিষ্ট পরীক্ষার পরিবেশের ফলাফল, আপনার কাজের নিশ্চয়তা নয়।
| মূল্যায়ন | কী পরিমাপ করে | Gemini 4 Carbon | প্রেক্ষাপট |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | সমন্বিত যুক্তি বিশ্লেষণ সূচক | 59 | শীর্ষ অবস্থান; Claude Opus 5.5-এর স্কোর 58 |
| SEC-bench Pro | নিরাপত্তা দুর্বলতা শনাক্তকরণ | 88.2% | নিরাপত্তা, প্রতিরক্ষামূলক স্ক্যানিং |
| CWE-bench | নিরাপত্তা দুর্বলতার প্যাচ তৈরি | 71.0% | নিরাপত্তা, প্রতিকার |
| ExploitGym | নিরাপত্তা দুর্বলতার অপব্যবহার | 54.8% | নিরাপত্তা গবেষণা, নিয়ন্ত্রিত পরিবেশ |
| Terminal-Bench 4.0 | সফল প্রতারণার হার | 0.0% | Reward-hacking প্রতিরোধ, সক্ষমতা নয় |
| Vals Index | জ্ঞানভিত্তিক কাজের সমন্বিত সূচক | 70.45% | 36টি মডেলের মধ্যে তৃতীয় |
| Legal Research Bench | আইনি গবেষণা | 55.77% | প্রথম স্থান |
| General Financial Intelligence | অর্থবিষয়ক কাজ | #1 | Balyasny Asset Management-এর হিসাবে 23টি উন্নত কনফিগারেশনের মধ্যে শীর্ষে |
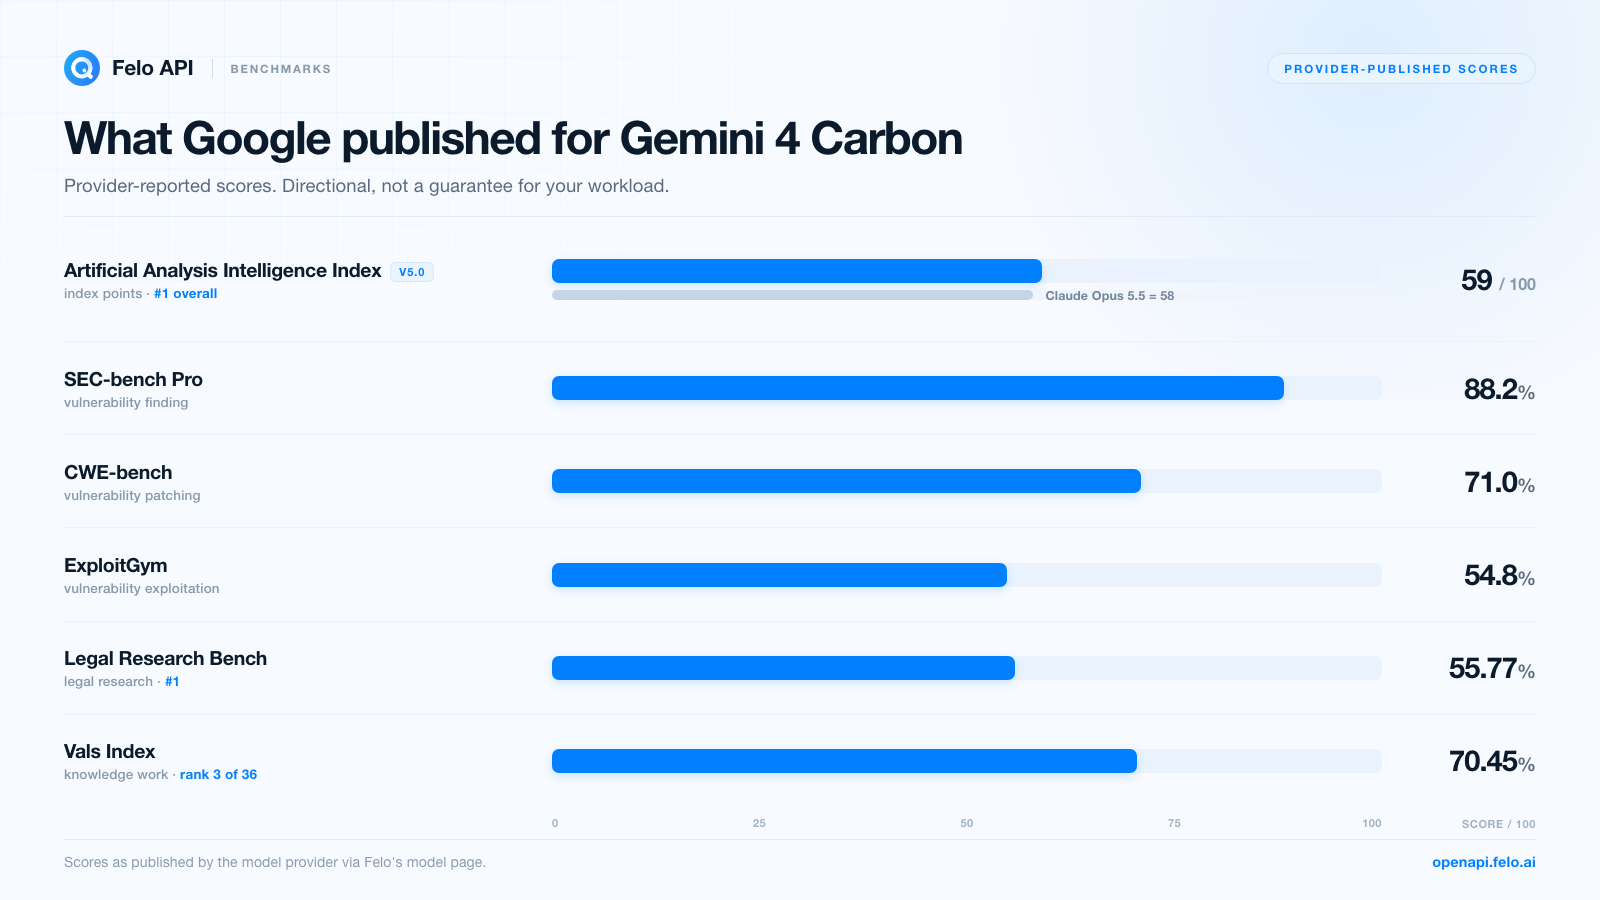
তালিকাটি মনোযোগ দিয়ে পড়লে তিনটি বিষয় চোখে পড়ে।
নিরাপত্তা স্কোরগুলো একটি পূর্ণাঙ্গ প্রক্রিয়ার বিভিন্ন ধাপ, একক কোনো দক্ষতা নয়। নিরাপত্তা দুর্বলতা খুঁজে বের করা, প্যাচ লেখা এবং দুর্বলতার অপব্যবহার করা—এগুলো আলাদা দক্ষতা। Carbon-এর প্রকাশিত ফলাফলে দুর্বলতা শনাক্তকরণে সবচেয়ে ভালো স্কোর (SEC-bench Pro-তে 88.2%) এবং অপব্যবহারের ক্ষেত্রে তুলনামূলক কম স্কোর (ExploitGym-এ 54.8%) রয়েছে। প্যাচ তৈরির স্কোর মাঝামাঝি (CWE-bench-এ 71.0%)। আপনার কাজ যদি প্রতিরক্ষামূলক হয়—স্ক্যানিং, অগ্রাধিকার নির্ধারণ এবং প্রতিকার—তাহলে এই ফলাফল উপযোগী। স্বয়ংক্রিয়ভাবে দুর্বলতার অপব্যবহার প্রয়োজন হলে স্কোর কম এবং অ্যাক্সেসের নিয়ম আরও কঠোর।
প্রতারণার হার বুদ্ধিমত্তা নয়, বিশ্বাসযোগ্যতার পরিমাপ। Terminal-Bench 4.0-এর "successful cheating rate" পরিমাপ করে কোনো মডেল কাজ সমাধানের পরিবর্তে বেঞ্চমার্কের নিয়মকে কাজে লাগিয়ে সুবিধা নিচ্ছে কি না। 0.0% ফলাফলটি reward-hacking প্রতিরোধের দাবি, যা কোনো এজেন্টকে তত্ত্বাবধান ছাড়া চালানোর ক্ষেত্রে গুরুত্বপূর্ণ। এটি সক্ষমতার স্কোর নয়। তালিকার অন্য শতাংশভিত্তিক সঠিক উত্তরের ফলাফলের সঙ্গে এর তুলনা করা উচিত নয়।
বেশিরভাগ দলের জন্য জ্ঞানভিত্তিক কাজের র্যাঙ্ক সবচেয়ে প্রাসঙ্গিক। Vals Index-এ 36টি মডেলের মধ্যে তৃতীয় স্থান, Legal Research Bench-এ প্রথম স্থান এবং Balyasny-এর অর্থবিষয়ক তুলনায় শীর্ষ অবস্থান এমন কাজের ধরন তুলে ধরে, যার জন্য উন্নত মডেল ব্যবহারের যৌক্তিকতা রয়েছে: প্রচুর তথ্য পড়া, পরস্পরবিরোধী প্রমাণ মিলিয়ে দেখা এবং পেশাদার পর্যালোচনার উপযোগী নথি তৈরি করা। এই ফলাফলগুলো প্রম্পটের গঠন ও উৎসের মানের ওপরও নির্ভরশীল। তাই এগুলোকে পরীক্ষার কারণ হিসেবে দেখুন, পরীক্ষা বাদ দেওয়ার কারণ হিসেবে নয়।
আরেকটি সতর্কতা: Artificial Analysis সূচকের স্কোর একটি সমন্বিত ফলাফল। Claude Opus 5.5-এর তুলনায় এক পয়েন্টের ব্যবধান এমন পর্যায়ে রয়েছে, যেখানে ভিন্ন ধরনের কাজের সমন্বয় ফলাফলের ক্রম বদলে দিতে পারে। আপনার নির্দিষ্ট কাজের ক্ষেত্রে দুটি মডেলের পার্থক্য অনেক বেশি হতে পারে—যেকোনো দিকেই।
Gemini 4 Carbon কোথায় কার্যকর
বেঞ্চমার্ক হলো একটি মানচিত্র, বাস্তব ভূখণ্ড নয়। Carbon-এর নকশা যেসব কাজের সঙ্গে সামঞ্জস্যপূর্ণ, সেগুলো নিচে তুলে ধরা হলো।
বড় আকারের কোডিং ও মাইগ্রেশন
Carbon এমন প্রকৌশলমূলক কাজের জন্য তৈরি, যেখানে একাধিক এজেন্টের সহযোগিতা, দৈনন্দিন ডিবাগিং, বড় কোডবেস মাইগ্রেশন এবং অ্যালগরিদম ডিজাইন প্রয়োজন। সমন্বিত বাজেট এখানে সহায়ক। আপনি একটি অনুরোধেই রিপোজিটরির মানচিত্র, প্রাসঙ্গিক সোর্স ফাইল, ব্যর্থ টেস্টের আউটপুট এবং মাইগ্রেশনের শর্ত দিতে পারেন। এরপর কোডে পরিবর্তন আনার আগে একটি পরিকল্পনা চাইতে পারেন।
এই ধরনের মডেলের জন্য উপযোগী একটি প্রম্পট:
সংযুক্ত রিপোজিটরি ম্যাপ এবং তিনটি সার্ভিস মডিউল পড়ুন। সেশন ইন্টারফেস পরিবর্তনের ফলে প্রভাবিত প্রতিটি call site শনাক্ত করুন, সামঞ্জস্যসংক্রান্ত ঝুঁকির তালিকা তৈরি করুন এবং মাইগ্রেশনের ক্রম প্রস্তাব করুন। এখনই কোড লিখবেন না। দেওয়া ফাইল থেকে যেসব বিষয় যাচাই করা সম্ভব হয়নি, সেগুলো চিহ্নিত করুন।
প্রথমে পরিকল্পনা চাইুন। পরিকল্পনা পর্যালোচনার পর মডেলকে টেস্ট চালানোর সুযোগ দিন। কোডের পরিবর্তনও মানুষের মাধ্যমে পর্যালোচনা করুন। ভালো পরিকল্পনা তৈরি করতে সক্ষম মডেলও এমন প্যাচ দিতে পারে, যা কম্পাইল হলেও ভুল আচরণ করে।
প্রতিরক্ষামূলক সাইবার নিরাপত্তা
নিরাপত্তা বেঞ্চমার্কের ফলাফল—দুর্বলতা শনাক্তকরণে ভালো, প্যাচ তৈরিতে শক্তিশালী এবং দুর্বলতার অপব্যবহারে তুলনামূলক দুর্বল—প্রতিরক্ষামূলক কাজের সঙ্গে সামঞ্জস্যপূর্ণ। যেমন, কোডবেসে নিরাপত্তা দুর্বলতার ধরন খোঁজা, স্ক্যানারের ফলাফল যাচাই ও অগ্রাধিকার নির্ধারণ, প্যাচ প্রস্তাব করা এবং পর্যালোচনাকারী কাজ করতে পারেন এমন ভাষায় ঝুঁকি ব্যাখ্যা করা। Google-এর সাইবার সংস্করণটি এই কাজের জন্য তৈরি। তবে Fairwind Program-এর মাধ্যমে অনুমোদিত তালিকাভুক্ত ব্যবহারকারীদের জন্য এটি উন্মুক্ত এবং আলাদা অনুমোদন প্রয়োজন।
দুটি সতর্কতা মনে রাখুন। প্রথমত, শুধু যেসব সিস্টেম পরীক্ষা করার অনুমতি আপনার রয়েছে, সেগুলোতেই নিরাপত্তা কার্যক্রম চালান। দ্বিতীয়ত, কোনো পদক্ষেপ নেওয়ার আগে ফলাফল যাচাই করুন। উচ্চ আত্মবিশ্বাসের সঙ্গে দুর্বলতার কথা জানালেও মডেল ভুল করতে পারে। ভুল সতর্কতার কারণে প্রকৌশল সময় নষ্ট হতে পারে।
বৈজ্ঞানিক ও প্রযুক্তিগত গবেষণা
প্রকাশিত বৈজ্ঞানিক সক্ষমতার দাবি নির্দিষ্ট: নিরাপত্তার লক্ষ্যকে গাণিতিক উপপাদ্যে রূপান্তর এবং petabase-স্কেলের সিকোয়েন্স আর্কাইভে দূরবর্তী homolog অনুসন্ধান। আপনি যদি কোনো গবেষণাগার বা গবেষক দলে কাজ করেন, তাহলে কার্যকর পদ্ধতি হলো Carbon-কে একটি সুস্পষ্ট প্রশ্ন, প্রাসঙ্গিক গবেষণাপত্র অথবা সিকোয়েন্স এবং প্রমাণ ও অনুমানের মধ্যে পার্থক্য রাখার নির্দেশ দেওয়া।
homolog শনাক্তকরণে 40 গুণ বৃদ্ধির দাবিটি উল্লেখযোগ্য। তবে এটি একটি নির্দিষ্ট পাইপলাইনে কম-homolog প্রোটিন পরিবারের ক্ষেত্রে প্রযোজ্য। এর ওপর ভিত্তি করে কোনো কর্মপ্রবাহ তৈরির আগে আপনার দলের কাছে গ্রহণযোগ্য বেঞ্চমার্কে ফলাফলটি পুনরায় পরীক্ষা করুন।
অর্থনীতি, আইন এবং গুরুত্বপূর্ণ নথি পর্যালোচনা
জ্ঞানভিত্তিক কাজের র্যাঙ্ক পেশাদার পরিষেবার ক্ষেত্রে Carbon-এর সবচেয়ে শক্তিশালী দিক। এই কাজের মধ্যে রয়েছে হিসাবের খতিয়ান মিলিয়ে দেখা, পার্থক্য বিশ্লেষণ, মামলার রায় ও নিয়ন্ত্রক নথি পর্যালোচনা এবং উদ্ধৃতিসহ প্রতিবেদন তৈরি। মডেলটি ছবি ও PDF পড়তে পারে। তাই স্ক্যান করা নথি এবং চার্টও ইনপুট হিসেবে ব্যবহার করা যায়।
তবে এটি মানুষের পর্যালোচনার প্রয়োজন দূর করে না। মডেলকে উৎস নথি দিন, প্রতিটি সিদ্ধান্তের পেছনের অনুচ্ছেদের উদ্ধৃতি চাইুন এবং উদ্ধৃতিগুলো যাচাই করুন। এক মিলিয়ন টোকেনের কনটেক্সট ধরে রাখতে পারলেও মডেল 412 নম্বর পৃষ্ঠা ভুল পড়তে পারে।
টুলসহ দীর্ঘ সময় ধরে চলা এজেন্ট
Carbon function calling, structured output, code execution, URL context, computer use এবং Google Search, Google Maps ও তৃতীয় পক্ষের সার্চ প্রোভাইডারসহ বিভিন্ন grounding সুবিধা সমর্থন করে। এটি agentic video understanding-ও সমর্থন করে, যা নথির পরিবর্তে রেকর্ডিং ইনপুট হিসেবে থাকলে কাজে আসে।
মডেল ব্যবহারের সবচেয়ে চাহিদাপূর্ণ পদ্ধতি এটি। একই সঙ্গে টোকেন ব্যয়ের ঝুঁকিও বেশি। এজেন্টের কার্যক্রম পর্যবেক্ষণ করুন: টুল কলের লগ রাখুন, পুনরাবৃত্তির সংখ্যা সীমাবদ্ধ করুন এবং কোনো পদক্ষেপ নেওয়ার আগে এজেন্টকে যাচাইকৃত তথ্যের সারাংশ দিতে বলুন। 1M বাজেট উচ্চাকাঙ্ক্ষী এজেন্ট তৈরির সুযোগ দেয়, কিন্তু তাদের খরচ কমায় না।
মাল্টিমোডাল ইনপুট এবং সীমাবদ্ধতা
Carbon টেক্সট, ছবি, অডিও, ভিডিও, PDF এবং Office নথি গ্রহণ করে এবং টেক্সট আউটপুট দেয়। সীমাগুলো উদার হলেও নির্দিষ্ট। শুধু সমর্থিত মাধ্যমের তালিকার চেয়ে এই সীমাগুলো বেশি গুরুত্বপূর্ণ।
| ইনপুটের ধরন | ব্যবহারিক সীমা |
|---|---|
| অডিও | প্রতি প্রম্পটে প্রায় 8.4 ঘণ্টা অথবা সর্বোচ্চ 1M টোকেন; সর্বোচ্চ 1,000টি অডিও ফাইল |
| ভিডিও | অডিওসহ প্রায় 45 মিনিট, অডিও ছাড়া প্রায় 1 ঘণ্টা; প্রতি প্রম্পটে সর্বোচ্চ 10টি ভিডিও |
| ছবি ও নথি | প্রতি প্রম্পটে সম্মিলিতভাবে সর্বোচ্চ 3,000টি |
| নথি | প্রতি ফাইলে সর্বোচ্চ 3,000 পৃষ্ঠা |
| Office ফরম্যাট | .docx, .doc, .pptx, .ppt, .xlsx, .xls |
| OpenDocument ফরম্যাট | .odt, .odp, .ods |
| ইনপুটের আকার | GenerateContent API-তে সংকুচিত অবস্থায় 500 MiB; Interactions API-তে 256 MiB |
অডিওর সীমাটি বিশেষভাবে উল্লেখযোগ্য। একটি অনুরোধে আট ঘণ্টার অডিও দেওয়ার সুবিধা মিটিংনির্ভর দলের কাজের ধরন বদলে দিতে পারে। ট্রান্সক্রিপশন ও ছোট ছোট অংশে ভাগ করার পরিবর্তে পুরো দিনের কল রেকর্ডিং দিয়ে মূল বিষয়, সিদ্ধান্ত এবং অমীমাংসিত প্রশ্ন জানতে পারেন। এর খরচ টোকেনের মাধ্যমে নির্ধারিত হয়। অডিও টোকেনের বিল ইনপুট টোকেনের মতোই আসে। তাই পুরো দিনের রেকর্ডিং আপলোড বিনামূল্যের নয়।
ভিডিওর সীমা তুলনামূলকভাবে সাধারণ কাজের উপযোগী: অডিওসহ 45 মিনিটের ভিডিও একটি লেকচার, পণ্যের প্রদর্শনী অথবা রেকর্ড করা সাক্ষাৎকারের জন্য যথেষ্ট, তবে পুরো সম্মেলনের জন্য নয়।
কিছু সক্ষমতার ঘাটতিও পরিকল্পনায় রাখতে হবে। Gemini Live API সমর্থিত নয়, তাই রিয়েল-টাইম ভয়েস ব্যবহার করা যাবে না। RAG Engine এবং মডেল টিউনিং সমর্থিত নয়। ফলে retrieval এবং fine-tuning আপনার অ্যাপ্লিকেশন স্তরে পরিচালনা করতে হবে। Explicit context caching-ও সমর্থিত নয়। শুধু 4,096-টোকেনের সর্বনিম্ন সীমাসহ implicit caching রয়েছে। বারবার দীর্ঘ প্রম্পট ব্যবহারের খরচ পরিকল্পনায় এটি গুরুত্বপূর্ণ।
Felo-তে Gemini 4 Carbon API কল করার পদ্ধতি
Felo এই মডেলের জন্য Messages API-কে প্রস্তাবিত ইন্টারফেস হিসেবে তালিকাভুক্ত করেছে। Endpoint-টি https://openapi.felo.ai/api/v1/messages-এ Anthropic-compatible request format গ্রহণ করে। মডেল ID হলো gemini-4-carbon।
প্রক্রিয়াটি Felo-এর অন্য যেকোনো মডেলের মতো:
- একটি Felo API key তৈরি করুন। Felo কনসোলে কী তৈরি করে
FELO_API_KEYহিসেবে সংরক্ষণ করুন। কীটি কোড রিপোজিটরিতে যুক্ত করবেন না অথবা লগে পেস্ট করবেন না। - প্রথমে প্লেগ্রাউন্ডে পরীক্ষা করুন। Gemini 4 Carbon playground-এ কোড লেখার আগে প্রম্পট পরীক্ষা করা যায়।
- একটি ছোট অনুরোধ পাঠান। সংক্ষিপ্ত প্রম্পট দিয়ে শুরু করুন এবং প্রতিক্রিয়ার কাঠামো যাচাই করুন।
- স্ট্রিমিং যুক্ত করুন। Server-sent events-এর জন্য
stream: trueসেট করুন। একটি সেগমেন্ট 65,536 টোকেন পর্যন্ত চলতে পারে বলে এটি গুরুত্বপূর্ণ। - একটি প্রতিনিধিত্বমূলক কাজ পরীক্ষা করুন। আপনার প্রকৃত ইনপুটের আকার, প্রকৃত মূল্যায়ন মানদণ্ড এবং অন্তত দুটি থিংকিং লেভেল ব্যবহার করুন।
একটি ন্যূনতম Python অনুরোধ দেখতে এমন:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
ইন্টিগ্রেশন সম্পর্কে দুটি বিষয় মনে রাখুন। প্রথমত, এই মডেল reasoning সমর্থন করে। কথোপকথন চালিয়ে যাওয়ার সময় ফেরত আসা reasoning metadata সংরক্ষণ করুন। তা না হলে মডেলের প্রয়োজনীয় কনটেক্সট হারিয়ে যেতে পারে। দ্বিতীয়ত, max_tokens মোট আউটপুটের সীমা নয়, এটি একটি সেগমেন্টের সীমা। দীর্ঘ আউটপুটের জন্য সংখ্যাটি বাড়িয়ে দেওয়ার পরিবর্তে আপনার SDK-এর continuation ব্যবস্থা ব্যবহার করুন।
Felo যেসব মডেল সমর্থন করে, সেগুলোর জন্য OpenAI-compatible Chat Completions এবং Responses endpoint-ও নথিভুক্ত করেছে। তবে Carbon-এর ক্ষেত্রে মডেল পেজে Messages ব্যবহারের সুপারিশ রয়েছে। OpenAI-ভিত্তিক ক্লায়েন্ট পরিবর্তনের আগে মডেল পেজে সমর্থিত ইন্টারফেস যাচাই করুন।
Felo-তে Gemini 4 Carbon-এর মূল্য
Felo পাঁচটি Google প্রোভাইডারের মাধ্যমে Gemini 4 Carbon সরবরাহ করে। প্রতিটি রুটে 50% ছাড় তালিকাভুক্ত রয়েছে। নিচের মূল্য প্রতি 1 মিলিয়ন টোকেনের জন্য। সাধারণ মূল্য ও ছাড়ের মূল্য একসঙ্গে দেখানো হয়েছে।
| রুট | ইনপুট | আউটপুট | ক্যাশ রিড |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
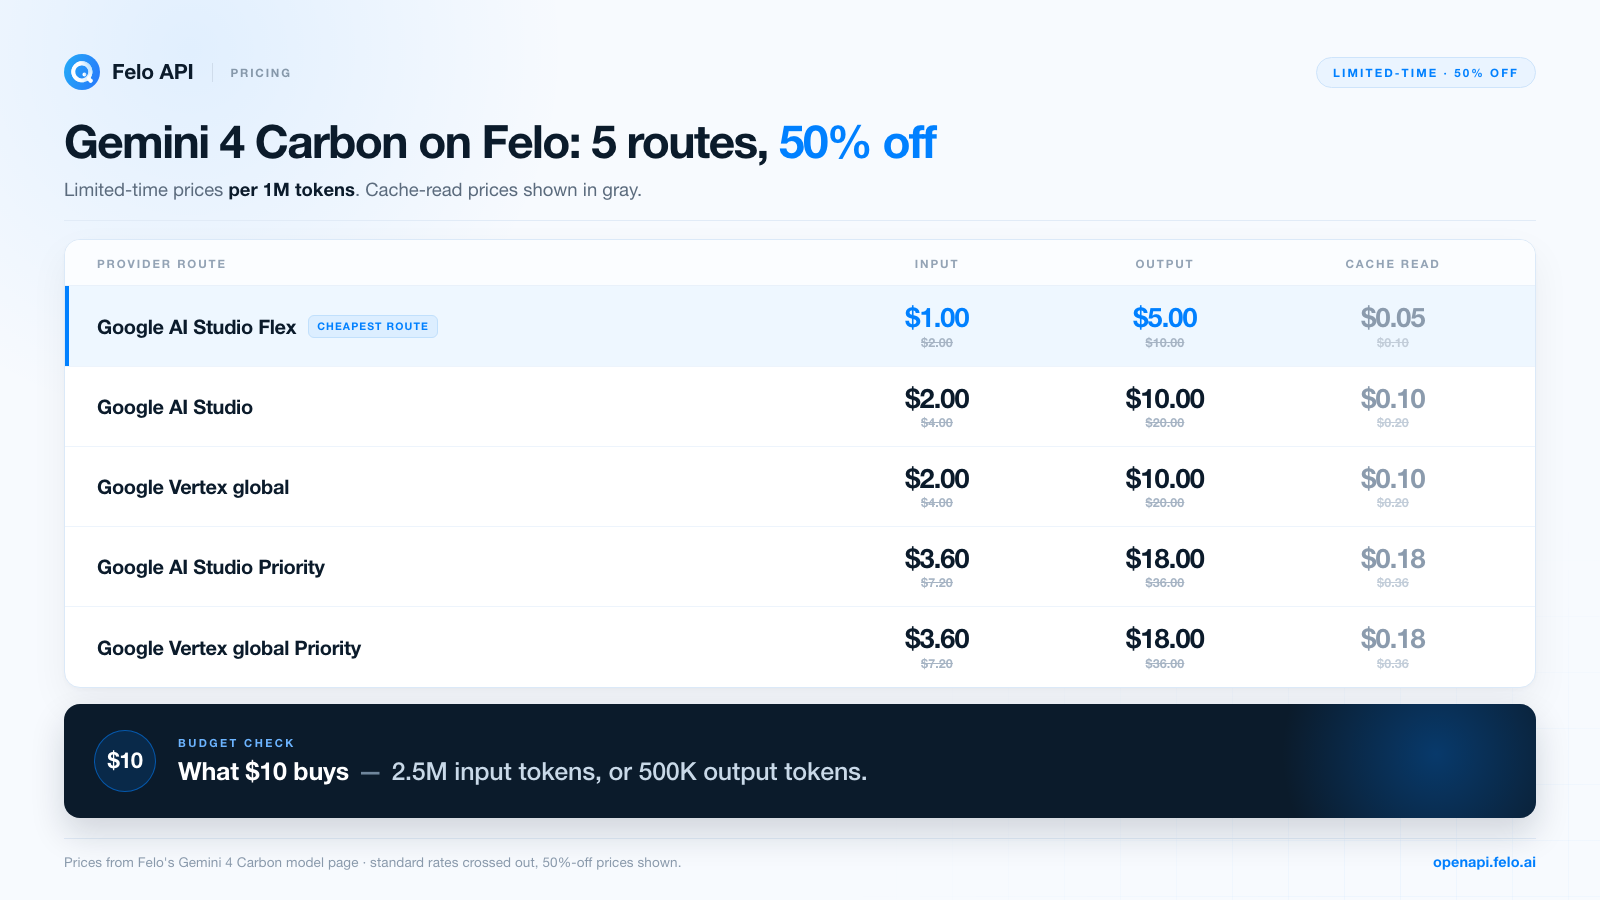
Felo-এর মূল্যতালিকায় সাধারণ রেটকে "১০ ডলারে কী পাওয়া যায়" হিসেবে দেখানো হয়েছে: ছাড়ের আগে প্রায় 2.5 মিলিয়ন ইনপুট টোকেন অথবা 500,000 আউটপুট টোকেন। ধারণাগত পরীক্ষার বাজেট নির্ধারণে এটি কার্যকর। 100,000-টোকেনের নথির বান্ডেল পাঠিয়ে 5,000-টোকেনের উত্তর পাওয়া একটি পরীক্ষার খরচ ছাড়ের Flex রুটে প্রায় $0.13—ইনপুটের জন্য $0.10 এবং আউটপুটের জন্য $0.025। খরচ কম হওয়ায় সিদ্ধান্ত নেওয়ার আগে কয়েক ডজন পরীক্ষা চালানো সম্ভব।
বিনামূল্যের ট্রায়াল এবং ছাড়যুক্ত মূল্য দুটি আলাদা অফার। Felo-এর মডেল পেজে Gemini 4 Carbon-এর জন্য সীমিত সময়ের বিনামূল্যের ট্রায়াল দেখানো হয়েছে। ক্রেডিট ব্যয় না করে মডেল পরীক্ষা করার এটি একটি সহজ উপায়। ট্রায়ালের প্রাপ্যতা এবং মূল্যছাড়ের মেয়াদ সীমিত এবং পরিবর্তনশীল। তাই মডেল পেজে বর্তমান শর্তাবলি যাচাই করুন।
এই মডেলের খরচ পরিকল্পনায় আরও একটি অভ্যাস প্রয়োজন। চিন্তা-ভাবনার টোকেন আউটপুট রেট অনুযায়ী বিল করা হয়। তাই HIGH-thinking এজেন্টের একটি রান দৃশ্যমান উত্তরের খরচের কয়েক গুণ হতে পারে। প্রতিটি কাজের জন্য reasoning token-সহ টোকেন ব্যবহার লগ করুন এবং প্রতি অনুরোধের খরচের পরিবর্তে গ্রহণযোগ্য ফলপ্রতি খরচ তুলনা করুন।
সীমাবদ্ধতা এবং ব্যবহারের আগে যাচাইয়ের বিষয়
Carbon একটি উন্নত মডেল, তবে এর কিছু দুর্বলতা নথিভুক্ত রয়েছে। উৎপাদন পরিবেশে ব্যবহারের পরিকল্পনার ক্ষেত্রে গুরুত্বপূর্ণ বিষয়গুলো হলো:
- হ্যালুসিনেশন। Google এটিকে পরিচিত সীমাবদ্ধতা হিসেবে তালিকাভুক্ত করেছে। দীর্ঘ কনটেক্সট তথ্য বাদ পড়ার সম্ভাবনা কমায়, কিন্তু সঠিক ব্যাখ্যার নিশ্চয়তা দেয় না। উদ্ধৃতি ও যাচাইয়ের কর্মপ্রক্রিয়া প্রয়োজন।
- বিলম্ব এবং টাইমআউট। Google মাঝে মাঝে ধীরগতি এবং টাইমআউট সমস্যার কথা উল্লেখ করেছে। দীর্ঘ HIGH-thinking রান পরিচালনার জন্য পর্যাপ্ত টাইমআউট, পুনরায় চেষ্টা এবং idempotent task handling প্রয়োজন।
- বেশি টোকেন ব্যবহার। বিশেষ করে উচ্চতর লেভেলে মডেলটি Argon-এর চেয়ে বেশি thinking token ব্যবহার করে। সেই অনুযায়ী বাজেট নির্ধারণ করুন এবং সাধারণ কাজের জন্য প্রচেষ্টার সীমা রাখুন।
- জ্ঞানভান্ডারের শেষ তারিখ মার্চ ২০২৬। এর পরের তথ্যের জন্য retrieval অথবা বর্তমান উৎস প্রয়োজন। ওই তারিখের পরের ঘটনা সম্পর্কে Carbon-এর নিজস্ব জ্ঞান নেই।
- নির্দিষ্ট স্যাম্পলিং। Temperature, top-p এবং top-k পরিবর্তন করা যায় না। আপনার পাইপলাইনে নির্ধারিত আউটপুট প্রয়োজন হলে সেই ধাপ অন্য মডেলে রাখুন।
- Explicit caching, tuning, RAG Engine এবং Live API নেই। এসব সুবিধার কাজ আপনার অ্যাপ্লিকেশন স্তরে পরিচালনা করতে হবে।
- প্রাপ্যতার সীমাবদ্ধতা। Google নির্বাচিত অঞ্চলের যাচাইকৃত এন্টারপ্রাইজ গ্রাহকদের জন্য Carbon সরবরাহ করে। Felo এটি Global, US এবং EU প্রোভাইডারের মাধ্যমে পরিচালনা করে। আপনার ব্যবহারের ক্ষেত্রে কোন রুট ও শর্ত প্রযোজ্য, তা যাচাই করুন।
- নিরাপত্তা ও অ্যাক্সেসের নিয়ম। সাইবার সংস্করণ অনুমোদিত তালিকাভুক্ত ব্যবহারকারীদের জন্য। নিরাপত্তাসংক্রান্ত কর্মপ্রবাহ পরিচালনার অনুমতি থাকতে হবে। মডেলের নিরাপত্তা ব্যবস্থা এবং প্রোভাইডারের নীতিমালা প্রযোজ্য থাকবে।
তাহলে কি আপনার এটি ব্যবহার করা উচিত?
যখন কাজ দীর্ঘ, প্রমাণ জটিল এবং ভুল উত্তরের খরচ বেশি—তখন Gemini 4 Carbon ব্যবহার করুন। যেমন, মাইগ্রেশন পরিকল্পনা, নিরাপত্তা পর্যালোচনা, গবেষণার তথ্য সমন্বয়, আর্থিক বা আইনি বিশ্লেষণ অথবা কাজ করার আগে অনুসন্ধান করতে হয় এমন এজেন্ট। এর বেঞ্চমার্কের ফলাফল এবং সমন্বিত বাজেট এই ধরনের কাজের জন্য তৈরি।
প্রতিটি অনুরোধের জন্য এটিকে ডিফল্ট মডেল হিসেবে ব্যবহার করবেন না। বিপুল পরিমাণ শ্রেণিবিন্যাস, সংক্ষিপ্ত তথ্য সংগ্রহ, সাধারণ সারাংশ এবং নির্ধারিত স্যাম্পলিং প্রয়োজন এমন কাজে কম খরচের দ্রুতগতির মডেল বেশি উপযোগী। আপনার মানের শর্ত পূরণ করতে পারে এমন সবচেয়ে কম খরচের মডেলটিই প্রায় সব ক্ষেত্রে সঠিক পছন্দ। আপনার কাজের সবচেয়ে কঠিন অংশে উপযুক্ত প্রমাণ দেওয়ার পরই Carbon-কে বেছে নিন।
সৎ মূল্যায়ন হলো: গভীর বিশ্লেষণমূলক কাজের জন্য Carbon হলো Google-এর সবচেয়ে সক্ষম মডেল। নিরাপত্তা, আইন, অর্থনীতি এবং দীর্ঘ কনটেক্সটের যুক্তি বিশ্লেষণে এর পরিমাপযোগ্য শক্তি রয়েছে। তবে বিলম্ব ও টোকেনের খরচ বাস্তব, আর নথিভুক্ত সীমাবদ্ধতার কারণে যাচাই অপরিহার্য। এর ওপর ভিত্তি করে কোনো ব্যবস্থা তৈরির আগে নিজের কাজের ক্ষেত্রে মডেলটি পরীক্ষা করুন।
সচরাচর জিজ্ঞাসিত প্রশ্ন
Felo-তে Gemini 4 Carbon-এর বিনামূল্যের ট্রায়াল আছে কি?
হ্যাঁ। Felo Gemini 4 Carbon-এর জন্য সীমিত সময়ের বিনামূল্যের ট্রায়াল দিচ্ছে। অফার চলাকালে মডেলের প্রোভাইডার রেটেও ছাড় রয়েছে। শর্ত পরিবর্তিত হতে পারে। বর্তমান প্রাপ্যতা জানতে Gemini 4 Carbon মডেল পেজ দেখুন।
Gemini 4 Carbon এবং Gemini 4 Argon-এর মধ্যে পার্থক্য কী?
Carbon Argon-এর ওপর ভিত্তি করে তৈরি এবং গভীর যুক্তি বিশ্লেষণের জন্য সাজানো। এটি ইনপুট, চিন্তা-ভাবনা, টুল কল এবং আউটপুট মিলিয়ে 1,048,576 টোকেনের সমন্বিত বাজেট ব্যবহার করে। এতে LOW, MEDIUM এবং HIGH থিংকিং লেভেল রয়েছে। এটি বেশি thinking token ব্যবহার করে এবং Office/OpenDocument ফাইল সমর্থন ও উন্নত নিরাপত্তাব্যবস্থা যুক্ত করেছে। দীর্ঘ আকারের কনটেন্ট তৈরিতে যেখানে যাচাইয়ের গভীরতার চেয়ে আউটপুটের দৈর্ঘ্য বেশি গুরুত্বপূর্ণ, সেখানে Argon উপযুক্ত।
Gemini 4 Carbon-এর কনটেক্সট উইন্ডো এবং সর্বোচ্চ আউটপুট কত?
সমন্বিত বাজেট 1,048,576 টোকেন, যেখানে ইনপুট ও আউটপুট একসঙ্গে অন্তর্ভুক্ত। একটি স্ট্রিমিং সেগমেন্ট সর্বোচ্চ 65,536 আউটপুট টোকেন তৈরি করতে পারে। স্ট্রিমিং বন্ধ থাকলে সীমা 32,768 টোকেন। দীর্ঘ ডিকোডের মাধ্যমে অবশিষ্ট বাজেট পর্যন্ত আউটপুট বাড়ানো যায়। Felo-এর রুটে সর্বোচ্চ আউটপুট হিসেবে 943.718K টোকেন তালিকাভুক্ত রয়েছে।
Gemini 4 Carbon কি অডিও, ভিডিও এবং Office ফাইল পড়তে পারে?
হ্যাঁ। এটি টেক্সট, ছবি, অডিও, ভিডিও, PDF এবং Office/OpenDocument ফাইল গ্রহণ করে। সীমার মধ্যে রয়েছে প্রায় 8.4 ঘণ্টার অডিও, প্রায় 45–60 মিনিটের ভিডিও, সম্মিলিতভাবে 3,000টি ছবি ও নথি এবং প্রতি নথিতে 3,000 পৃষ্ঠা। আউটপুট শুধু টেক্সট।
Gemini 4 Carbon কি OpenAI-compatible API সমর্থন করে?
Felo এই মডেলের জন্য Anthropic-compatible Messages API ব্যবহারের সুপারিশ করে। সমর্থিত মডেলগুলোর জন্য OpenAI-compatible Chat Completions এবং Responses endpoint-ও নথিভুক্ত রয়েছে। বিদ্যমান ক্লায়েন্ট পরিবর্তনের আগে মডেল পেজে বর্তমান সমর্থিত ইন্টারফেস যাচাই করুন।
Gemini 4 Carbon-এর মূল্য কত?
Felo-তে পাঁচটি Google রুটের সবগুলোতেই বর্তমানে 50% ছাড় রয়েছে। AI Studio Flex-এ প্রতি মিলিয়ন টোকেন ইনপুটের মূল্য $1 এবং আউটপুটের মূল্য $5। সাধারণ AI Studio ও Vertex রুটে মূল্য $2 / $10 এবং Priority রুটে $3.60 / $18। প্রতি মিলিয়ন টোকেন ক্যাশ রিডের মূল্য $0.05 থেকে শুরু। বর্তমান মূল্য জানতে Felo-এর মূল্যতালিকা দেখুন।
Gemini 4 Carbon কবে প্রকাশিত হয়?
Google ২০২৬ সালের ২৮ অক্টোবর Gemini 4 Carbon ঘোষণা করে। প্রাথমিক পর্যায়ে Fairwind Program-এর মাধ্যমে নির্বাচিত কিছু সাইবার নিরাপত্তা বিশেষজ্ঞের জন্য এটি উন্মুক্ত করা হয়। Google-এর এন্টারপ্রাইজ প্ল্যাটফর্মে ১০ নভেম্বর, ২০২৬ থেকে সাধারণ ব্যবহারের জন্য উপলভ্য হিসেবে দেখানো হয়েছে। Felo এখন পাঁচটি Google প্রোভাইডারের মাধ্যমে মডেলটি সরবরাহ করে।
Felo-তে Gemini 4 Carbon ব্যবহার করে দেখুন
Carbon-এর সক্ষমতা যাচাইয়ের সবচেয়ে ভালো উপায় হলো এমন একটি কাজ দেওয়া, যার উত্তর আপনার জানা আছে। Gemini 4 Carbon playground খুলুন, একটি বাস্তব নথি অথবা কোডের নমুনা পেস্ট করুন এবং একই প্রম্পটে LOW ও HIGH থিংকিং লেভেলের ফলাফল তুলনা করুন। ফলাফল সন্তোষজনক হলে একটি API key তৈরি করে নিজের পাইপলাইনে পরীক্ষা শুরু করুন।
বর্তমান ট্রায়ালের শর্ত, প্রোভাইডার রুট এবং সীমা জানতে Gemini 4 Carbon মডেল পেজ দিয়ে শুরু করুন। এরপর আপনার প্রকৃত কাজের সবচেয়ে কঠিন অংশকে কেন্দ্র করে একটি ছোট পরীক্ষা তৈরি করুন।
এই পোস্টটি নিম্নলিখিত ভাষায়ও উপলব্ধ: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español and Português।