Die besten KI-Antwort-Engines 2027: 14 Online-Suchtools & 17 Agenten-Such-APIs
Datenbasierter 2027-Guide zu den 31 besten KI-Antwort-Engines: 14 Online-KI-Suchtools für Menschen und 17 Such-APIs für Claude Code, Codex CLI & OpenClaw.
Als wir unseren Überblick zu KI-Antwort-Engines für 2025 veröffentlichten, stand ein Ziel im Vordergrund: Ein Tool finden, das zehn Webseiten lesen und zusammenfassen kann, ohne zu halluzinieren. Zwei Jahre später erzählt „eine Frage im Chatfeld beantworten“ nur noch die halbe Geschichte – und einige der damaligen Favoriten (wie Phind) haben sich zurückgezogen oder neu ausgerichtet, während der Markt reifte.
Im Jahr 2027 teilt sich die Suche in zwei klare Bereiche.
Auf der einen Seite nutzen menschliche Forschende Online-KI-Antwort-Engines, die nicht nur das Web zusammenfassen, sondern Sprachbarrieren überwinden, Fachartikel prüfen und Recherche direkt in Präsentationen oder kollaborative Berichte verwandeln. Auf der anderen Seite greifen autonome KI-Agenten – Tools wie Claude Code, Codex CLI, pi coding agent, OpenClaw und Hermes Agent – am stärksten auf die Internetsuche zu. Agenten können keine überladene Browser-Oberfläche bedienen oder CAPTCHAs lösen; sie benötigen schnelles, token-effizientes JSON, vollständige Markdown-Extraktion und MCP-kompatible Tool-Endpunkte.
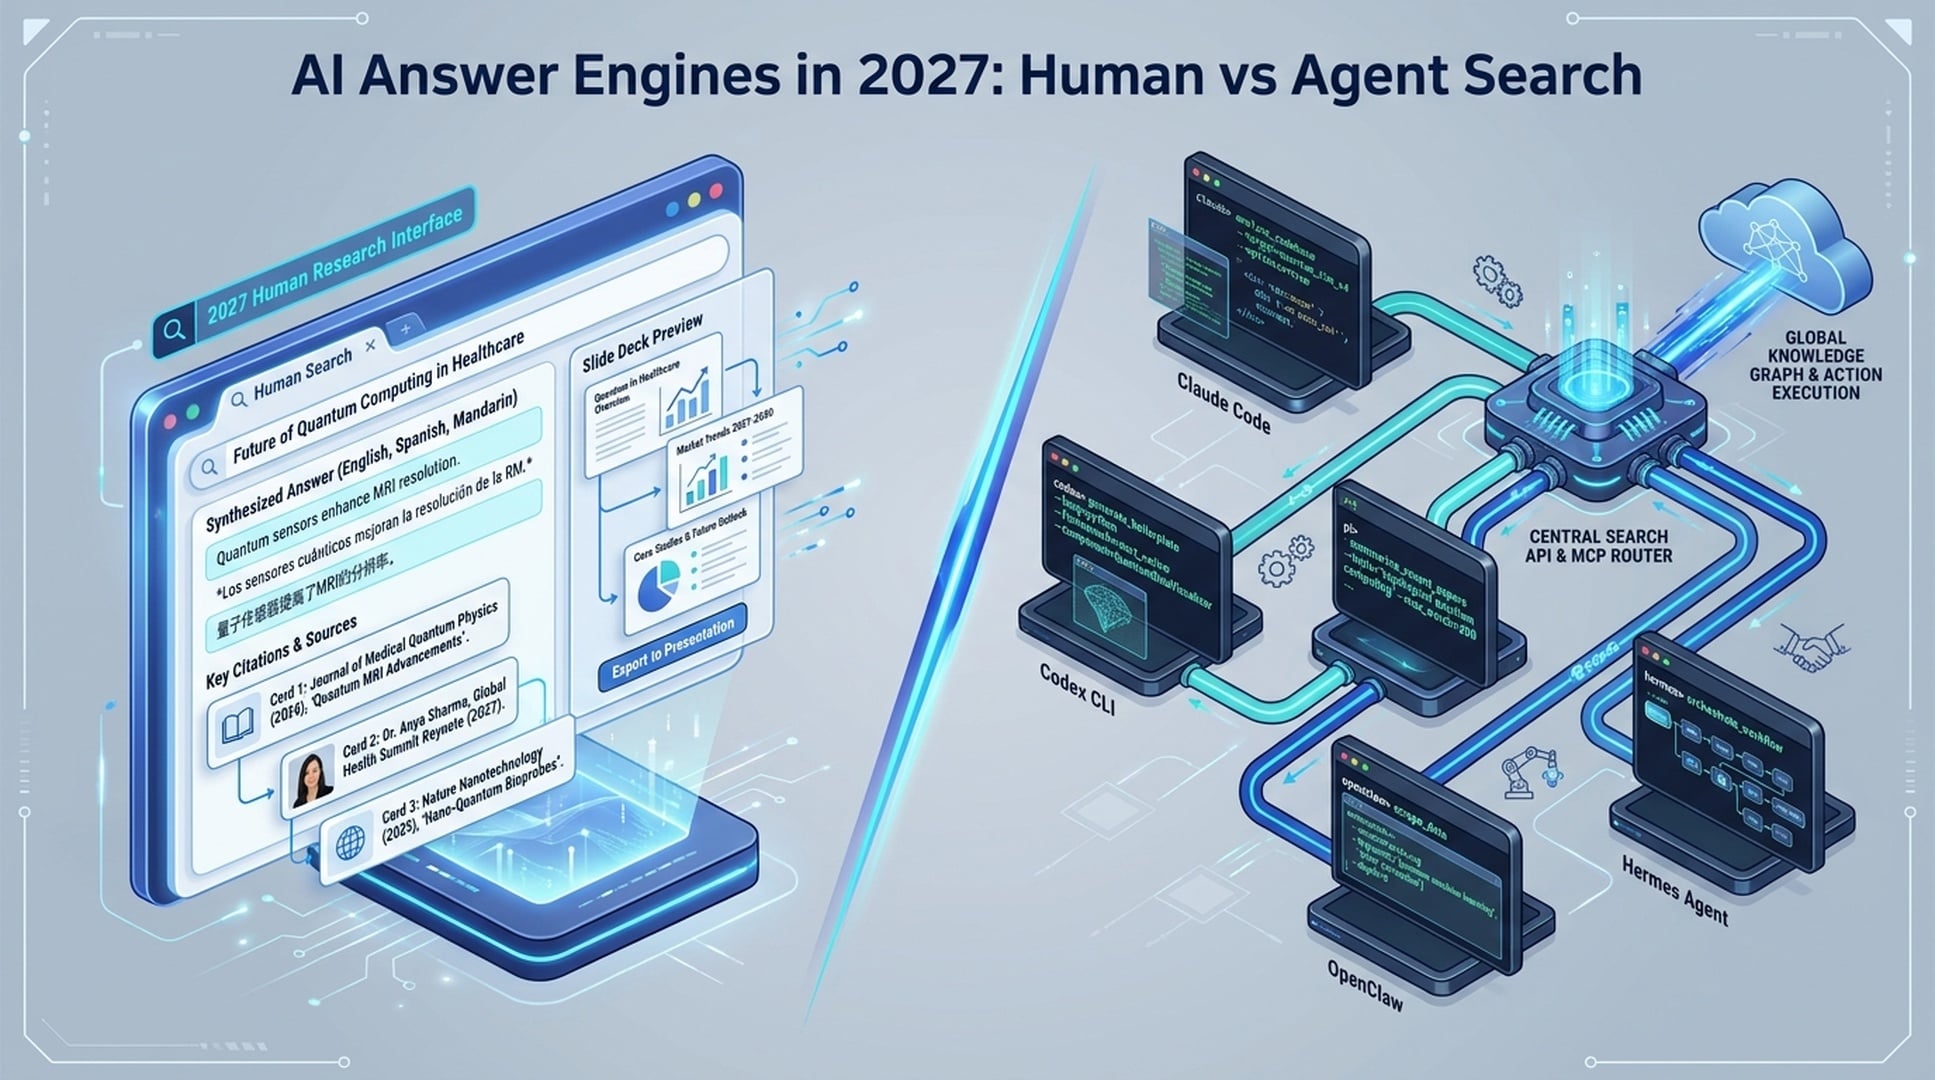
Damit dieser Guide für 2027 widerspiegelt, was Menschen und Entwickler tatsächlich nutzen, kombinierten wir Ahrefs-Daten zu organischer Suche & Markeninteresse (USA + global) mit aktuellen X (Twitter) Benchmarks zur Entwickler-Adoption. Teil 1 behandelt die 14 besten Online-KI-Antwort-Engines für Menschen, während Teil 2 die 17 besten Suchdienste und APIs für KI-Agenten vergleicht.
Teil 1: Die 14 besten Online-KI-Antwort-Engines für Menschen (Web, Wissenschaft & Datenschutz)
Wer am Schreibtisch einen Markt recherchiert, medizinische oder wissenschaftliche Aussagen prüft oder Anbieter vergleicht, braucht eine Antwort-Engine, die Quellen zitiert, aktuelle Community-Diskussionen einbezieht und den Weg von Rohdaten zum fertigen Ergebnis unterstützt.
1. Felo AI Search: Am besten für mehrsprachige Tiefenrecherche & Sofort-Ergebnisse
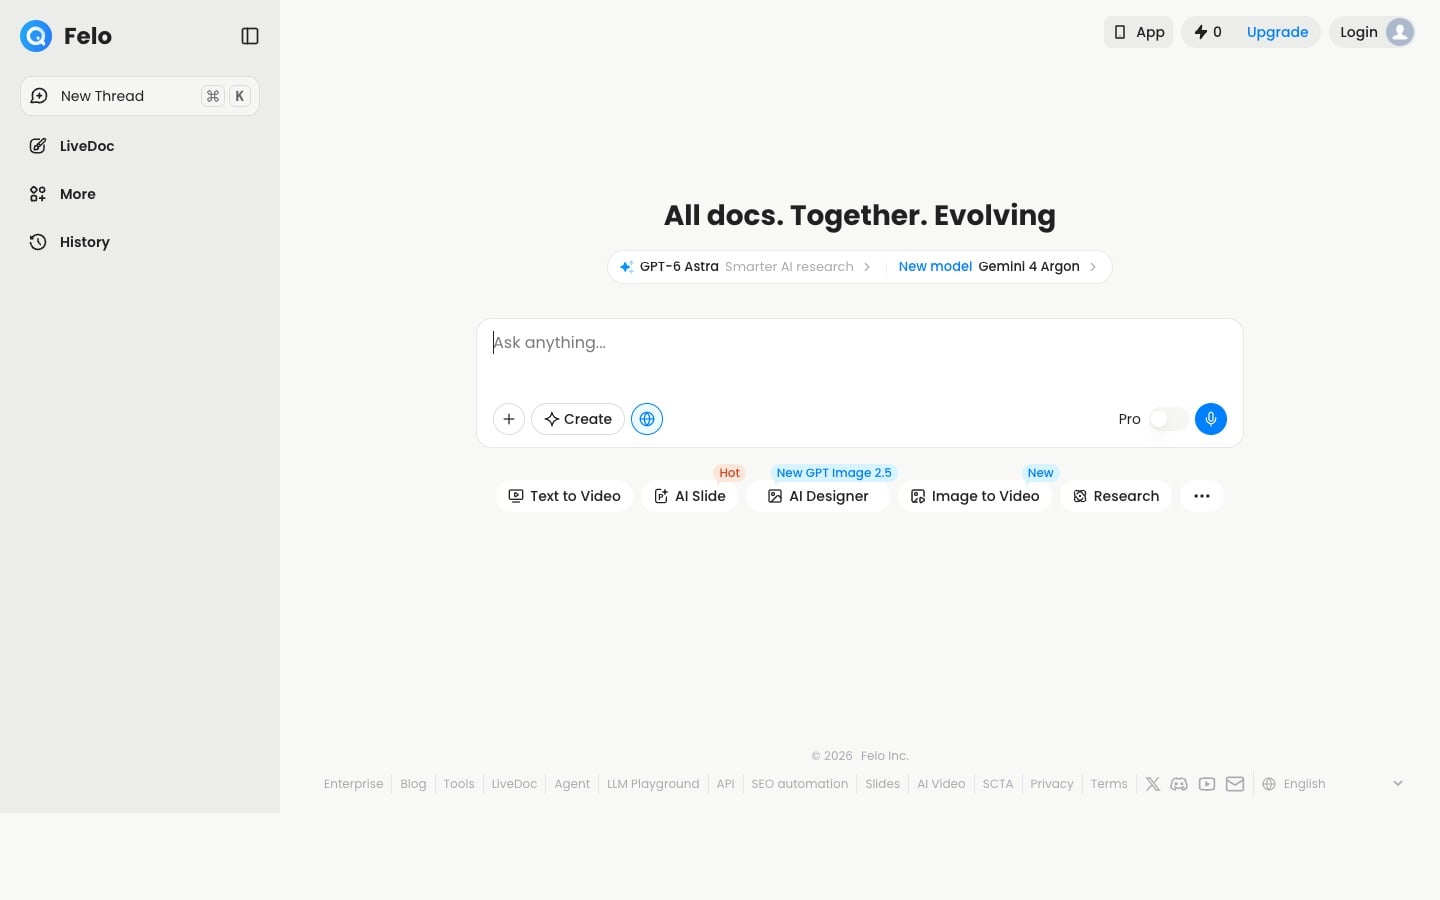
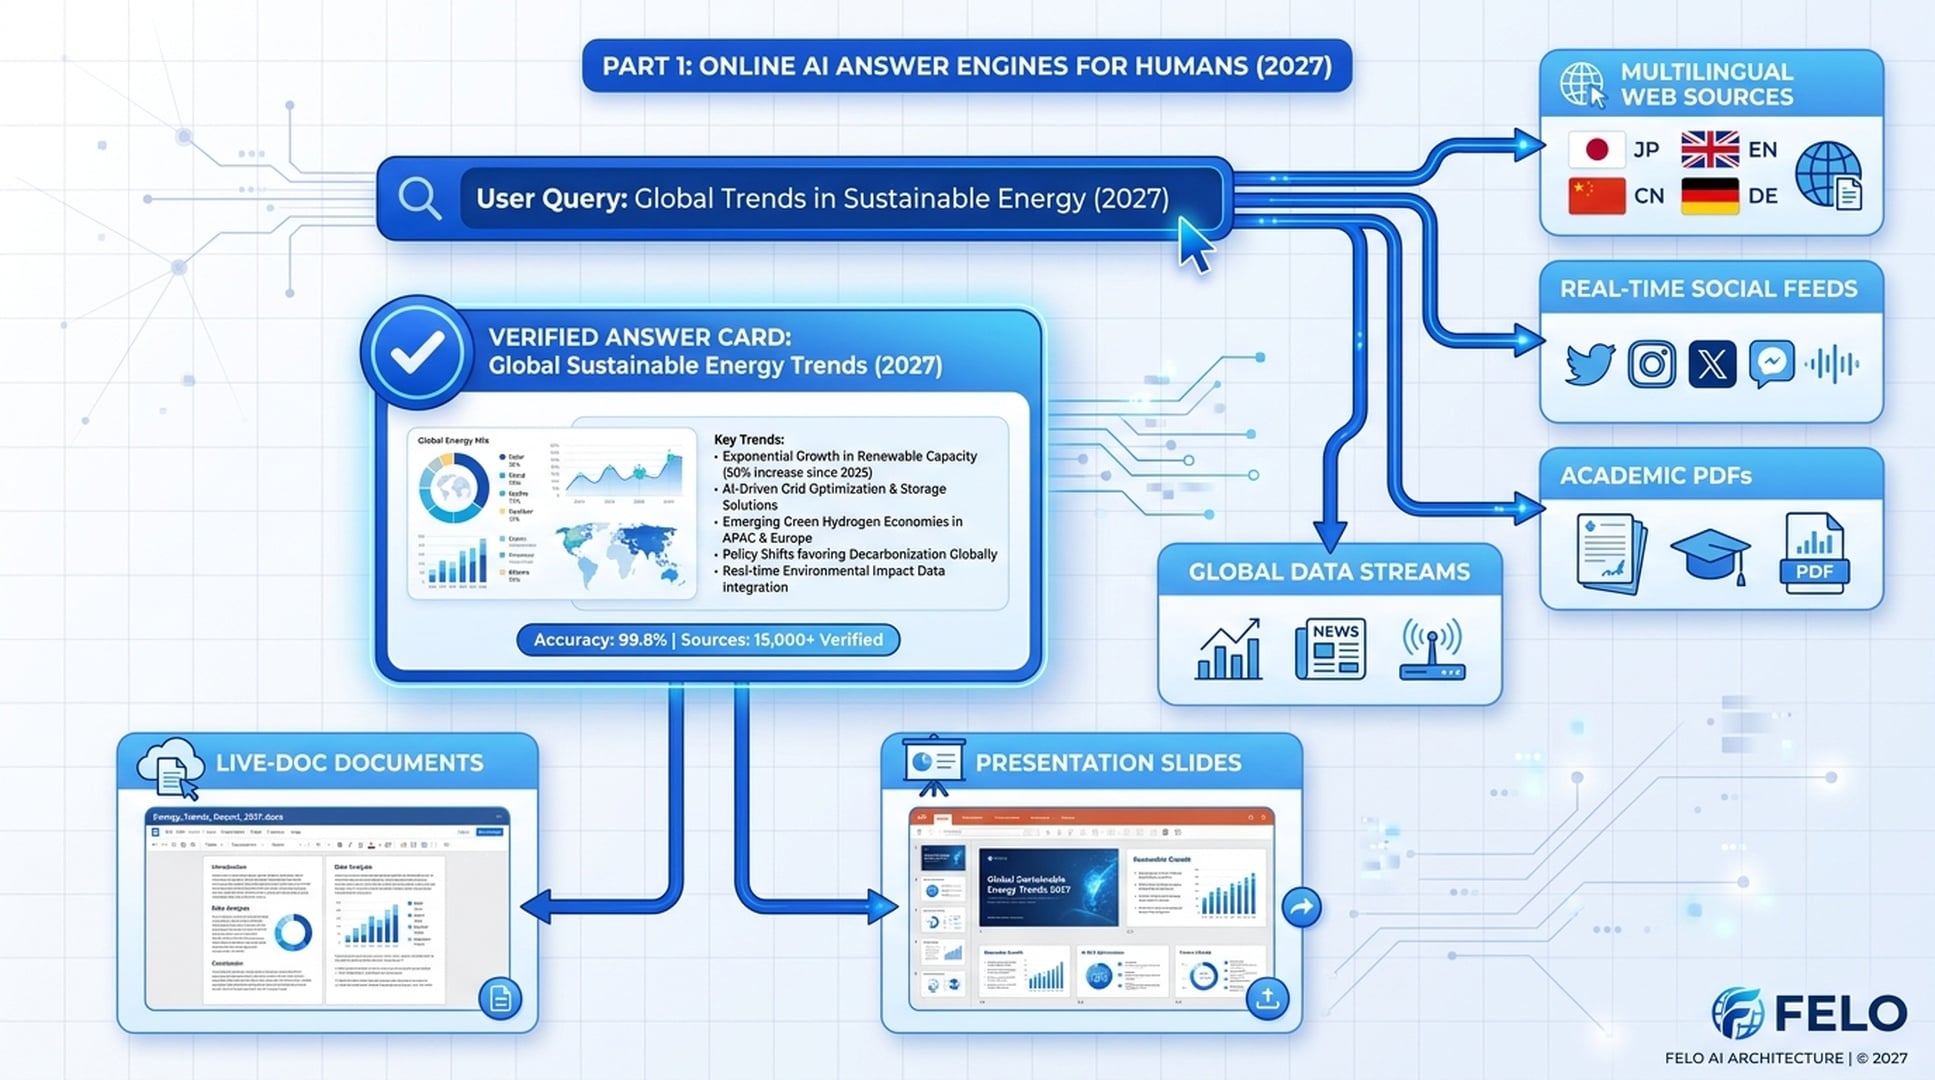
Viele KI-Antwort-Engines halten Nutzer weiter in einer rein englischen Filterblase – und nach der Antwort muss man den Text noch in Google Docs oder PowerPoint kopieren, um weiterzuarbeiten. Gestartet in Tokio und inzwischen weltweit genutzt, löst Felo AI Search beide Probleme in einem einzigen Workspace.
Stellt man eine Frage in der eigenen Sprache, durchsucht Felos Cross-Language-Retrieval-Engine Quellen auf Japanisch, Englisch, Chinesisch, Deutsch, Koreanisch und vielen weiteren Sprachen und fasst die Ergebnisse mit klickbaren Zitaten in der Ausgangssprache zusammen. Noch besser: Die Suche ist nur der erste Schritt – Felo verbindet direkt zu Felo LiveDoc (kollaborativer KI-Dokumenten-Workspace) und Felo Slides (Präsentationen auf Knopfdruck).
Wichtige Highlights:
- Mehrsprachige Tiefensuche: In einer Sprache fragen, Primärdaten und Regulierungsdokumente aus lokalen Quellen weltweit ziehen und eine einheitliche Zusammenfassung lesen.
- Echtzeit-Social & Community-Signale: Live-Indexierung von Reddit-Threads, X (Twitter)-Diskussionen und YouTube-Transkripten neben klassischen Webseiten und wissenschaftlichen PDFs.
- Pipeline von Suche zu Ergebnis: Jede Recherche direkt in ein thematisches PowerPoint-Deck (Felo Slides), Mindmap oder geteilten LiveDoc-Bericht verwandeln – ohne die Seite zu verlassen.
- Eigene Recherche-Agenten: Wiederholbare Recherche-Workflows mit Felo Agent bauen und externe Daten via MCP-Server anbinden.
Am besten geeignet für: Globale Teams, Analysten, Marketer und Studierende, die überprüfbare Antworten wollen, die direkt in Präsentationen und Dokumente übergehen.
2. Perplexity AI: Am besten für schnelles Faktenchecken & wissenschaftliche Zitate
Perplexity bleibt der Maßstab für schnelle, zitatorientierte Recherche. Die Oberfläche verzichtet auf Smalltalk und setzt auf nummerierte Fußnoten, Quellenkarten und schnelle Rückfragen. Mit Pro Search und Deep Research plant Perplexity mehrstufige Anfragen, stellt Rückfragen bei Unklarheiten und erstellt strukturierte Briefings aus Dutzenden Quellen.
Wichtige Highlights:
- Quellenprüfung Inline: Jede Aussage ist mit einer klickbaren Quellenkarte verknüpft, um den Originalartikel sofort zu prüfen.
- Fokus-Modi: Suche gezielt auf wissenschaftliche Arbeiten, SEC-Filings, Reddit-Diskussionen, YouTube-Videos oder WolframAlpha-Berechnungen eingrenzen.
- Modell-Flexibilität: Bezahlende Nutzer können zwischen Modellen von Anthropic, OpenAI und Perplexitys eigenen Sonar-Modellen wechseln.
Am besten geeignet für: Journalisten, wissenschaftliche Forschende und alle, die schnelles, belegtes Faktenchecken brauchen.
3. ChatGPT Search: Bester All-in-One-Konversationsassistent
OpenAI hat das Echtzeit-Web-Browsing direkt in die Hauptleiste von ChatGPT integriert und damit den umständlichen „Browse with Bing“-Schalter früherer Jahre abgeschafft. ChatGPT Search glänzt, wenn die Suchanfrage eigentlich nur ein Zwischenschritt in einer längeren kreativen oder analytischen Sitzung ist – etwa, um aktuelle Wettbewerberpreise zu holen und das Modell direkt danach ein Positionspapier oder eine Python-Simulation in Canvas schreiben zu lassen.
Wichtige Highlights:
- Absichts-Erkennung ohne Reibung: Erkennt automatisch, wann Live-Websuche nötig ist (z. B. bei aktuellen Ereignissen, Doku-Updates oder Preisen), bleibt aber für Denkaufgaben im Gesprächsmodus.
- Deep Research Agent: Kann 5 bis 20 Minuten autonom hunderte Seiten durchsuchen und einen Analysten-Bericht erstellen.
- Canvas & Code Interpreter Integration: Suchergebnisse direkt in Python-Visualisierungen oder parallele Dokumentenbearbeitung einbinden.
Am besten geeignet für: Wissensarbeiter, die ohnehin für Schreiben, Coden und Brainstorming in ChatGPT arbeiten.
4. Google Gemini & Google AI Mode: Am besten für Google-Workspace-Nutzer
Googles Antwort-Strategie läuft jetzt zweigleisig: Google AI Mode im klassischen Suchfeld und die eigenständige Gemini-App, die auf Googles multimodalen Modellen basiert. Während die klassische Suchseite weiter organische Links und Werbung mischt, bietet der AI Mode eine dedizierte Konversationsfläche mit Googles Echtzeit-Index, Maps-Daten und YouTubes Videokatalog.
Wichtige Highlights:
- Native Workspace-Anbindung: Webantworten mit eigenen Gmail-Threads, Google Docs, Drive-PDFs und Google Sheets abgleichen.
- Unübertroffener Lokal- & Handelsgraph: Holt Echtzeit-Ladenbestände, Flugpreise und Maps-Bewertungen, die Drittanbieter kaum abbilden.
- Multimodales Verständnis: Lange Videos, Audiodateien oder 500-seitige PDFs einwerfen und Aussagen gegen Googles Live-Index prüfen.
Am besten geeignet für: Teams mit Google Workspace und Nutzer, die stark auf lokale, Shopping- und YouTube-Daten setzen.
5. Microsoft Copilot Search: Am besten für Enterprise-M365-Umgebungen
Für Unternehmen mit Microsoft 365 verbindet Microsoft Copilot öffentliche Websuche (über Bings Index) und internes Firmenwissen (über Microsoft Graph). Statt zwischen externer Antwort-Engine und Intranet zu wechseln, beantwortet Copilot Fragen mit aktuellen Branchennachrichten und internen SharePoint-Präsentationen, Teams-Chats und Outlook-Mails.
Wichtige Highlights:
- Schutz von Unternehmensdaten: Kommerzielle Anfragen trainieren keine öffentlichen Modelle, interne Berechtigungen bleiben strikt über Microsoft Graph geregelt.
- In-App-Office-Anbindung: Webrecherche direkt in Word, Excel oder PowerPoint einbinden, ohne die Office-Suite zu verlassen.
Am besten geeignet für: Unternehmen, die tief in Microsoft 365, SharePoint und Teams arbeiten.
6. Brave Search (Answer with AI): Bester unabhängiger Datenschutz-Index
Mit fast 1,94 Millionen monatlichen globalen Suchanfragen (brave search laut Ahrefs) ist Brave der unangefochtene Marktführer für datenschutzfreundliche Suche. Anders als Meta-Suchtools, die im Hintergrund Google- oder Bing-Ergebnisse einkaufen, betreibt Brave Search einen eigenen Index mit über 30 Milliarden Seiten. Die Answer with AI-Engine liefert Sofortantworten, Vergleichstabellen und Foren-Insights – ohne Nutzerdaten zu speichern oder Tracking-Anzeigen zu schalten.
Am besten geeignet für: Nutzer mit Fokus auf Datenschutz, die einen unabhängigen Suchindex abseits von Google und Microsoft wollen.
7. Grok Search (xAI): Am besten für Echtzeit-X (Twitter)-Stimmung & Breaking News
Mit über 8,03 Millionen monatlichen globalen Suchanfragen (2,07 Mio. allein in den USA) ist Grok von xAI die Anlaufstelle, wenn ein Cloud-Ausfall, geopolitisches Ereignis oder Open-Source-Release vor wenigen Minuten stattfand. Während klassische Webcrawler bei aktuellen Ereignissen hinterherhinken, zapft Grok direkt den Echtzeit-X (Twitter)-Datenstrom und Live-Websuche an – ideal für Entwicklerstimmung und News.
Am besten geeignet für: Breaking News, Krypto-/Marktstimmung und Echtzeit-Entwicklerreaktionen auf X.
8. Consensus: Beste KI-Antwort-Engine für peer-reviewte wissenschaftliche Arbeiten
Allgemeine Web-Antwort-Engines mischen oft peer-reviewte Studien mit beliebigen SEO-Blogs. Gestützt auf über 200 Millionen wissenschaftliche Arbeiten und 135.000 globale monatliche Markensuchen (consensus ai, DR 80), beschränkt Consensus Antworten strikt auf veröffentlichte Fachliteratur. Das Consensus Meter zeigt visuell, ob die Wissenschaftsgemeinde bei einer medizinischen, ökonomischen oder psychologischen Frage zustimmt („Ja“, „Nein“ oder „Möglich“).
Am besten geeignet für: Ärztinnen, Kliniker, Promovierende und Wissenschaftsjournalisten, die nur peer-reviewte Zitate akzeptieren.
9. Elicit: Am besten für systematische Literaturreviews & Datentabellen
Mit 143.000 globalen monatlichen Suchanfragen (48.000 in den USA, DR 76) geht Elicit tiefer als klassische Frage-Antwort-Tools. Auf eine Forschungsfrage findet Elicit relevante Arbeiten und baut eine strukturierte Extraktionsmatrix – zieht automatisch Stichprobengrößen, Methoden, Interventionstypen und Kernergebnisse aus Dutzenden PDFs in eine sortierbare Tabelle.
Am besten geeignet für: F&E-Teams, Biotech-Analysten und Wissenschaftler, die formale Literaturreviews durchführen.
10. Liner AI: Bester Recherche-Copilot für Studierende & wissenschaftliches Markieren
Mit 14.000 monatlichen Markensuchen (liner ai) und starker Nutzung an US- und asiatischen Universitäten kombiniert Liner eine wissenschaftliche KI-Antwort-Engine mit Web/PDF-Highlighter und Schreib-Workspace. Jeder Satz in Liners Antwort verlinkt direkt auf die markierte Passage in der Quelle – ideal, um Zitate zu sammeln und ein Literaturverzeichnis zu erstellen.
Am besten geeignet für: Studierende, Forschende und Essay-Autorinnen.
11. Kagi Search: Beste werbefreie Premium-Suchmaschine für Power-User & Entwickler
Auf Hacker News und in Entwickler-X-Threads hat Kagi Search (DR 79, 7.100 monatliche Suchen nach kagi search) Kultstatus – dank eines einfachen Modells: Man zahlt ein Abo und Kagi liefert keine Werbung, kein Tracking, keinen SEO-Spam. Nutzer können vertrauenswürdige Domains anpinnen (z. B. GitHub oder MDN), Content-Farmen blockieren und Quick Answer-Synthesen oder Kagi Assistant mit voller Modellkontrolle auslösen.
Am besten geeignet für: Softwareentwickler und Power-User, die für einen anpassbaren, spamfreien Webindex zahlen.
12. iAsk.Ai: Beste kostenlose Antwort-Engine für viele Fragen & Hausaufgaben
Bereits in unserem 2025-Überblick vorgestellt, bleibt iAsk.Ai 2027 ein Traffic-Gigant – mit über 216.000 monatlichen organischen US-Besuchen (DR 70) und 18.000 monatlichen Markensuchen. Die Oberfläche ist schnell, ohne Login und erlaubt Fragen zu Fakten, Wissenschaft oder Hausaufgaben – mit Umschaltung zwischen Websuche, Wissenschaftsmodus und Sofort-Zusammenfassung.
Am besten geeignet für: Studierende und Gelegenheitsnutzer, die eine schnelle, kostenlose Antwort-Engine ohne Anmeldung suchen.
13. DuckDuckGo (Duck.ai & KI-gestützte Suche): Beste anonyme Alltagssuche
Mit 42.000 globalen monatlichen Suchen speziell nach duckduckgo ai (zusätzlich zu den Millionen Kernnutzern) bietet DuckDuckGo zwei Wege, KI anonym zu nutzen: KI-gestützte Suchzusammenfassungen direkt oben in den Ergebnissen (jederzeit abschaltbar) und Duck.ai – ein anonymes Proxy für Chats mit Modellen von OpenAI, Anthropic, Meta und Mistral, bei dem IP-Adressen entfernt werden.
Am besten geeignet für: Alltagsnutzer, die optionale KI-Antworten und privaten Chat ohne Account wollen.
14. You.com (ARI & Custom Research Agents): Am besten für Enterprise-Finanz- & mehrstufige Recherche
Mit 25.000 globalen monatlichen Markensuchen (you.com, DR 79) hat sich You.com vom Meta-Suchtool zum Enterprise-Research-Tool entwickelt. Die ARI (Advanced Research & Insights)-Engine liest hunderte Primärquellen gleichzeitig und wird stark von Finanzdienstleistern, Beratungen und Unternehmen genutzt – inklusive dedizierter Web-Search-API für KI-Workflows.
Am besten geeignet für: Finanzanalysten und Unternehmen, die eigene, mehrquellige Recherche-Workflows bauen.
Schnellvergleich: Top 14 Online-KI-Antwort-Engines (2027-Daten)
| # | Engine | Hauptstärke | Ahrefs-Nachfrage / Reichweite | Eingebaute Ergebnisse |
|---|---|---|---|---|
| 1 | Felo AI Search | Mehrsprachige Tiefensuche + 1-Klick Slides & LiveDoc | DR 63 · 66,5K US org traffic · Global mehrsprachig | ✅ Felo Slides (PPT), LiveDoc, Mindmap |
| 2 | Perplexity AI | Schnelles Faktenchecken mit Fußnoten & Pro Search | DR 91 · 3,08M global brand vol | Pages (Textberichte) |
| 3 | ChatGPT Search | Einheitlicher Chat, Coding und Deep Research | 100M+ aktive Nutzer · Native OpenAI-Suche | Canvas (Text & Code) |
| 4 | Google Gemini / AI Mode | Google Workspace + Maps, Shopping & YouTube | 174K global vol (google ai mode) | Export zu Google Docs/Slides |
| 5 | Microsoft Copilot | Enterprise Microsoft 365 Graph + Bing | In Windows & M365 Enterprise integriert | Export zu Word/Excel/PPT |
| 6 | Brave Search AI | Unabhängiger 30B+ Seitenindex & kein Tracking | 1,94M global vol (brave search) | Antwortkarten & Tabellen |
| 7 | Grok Search (xAI) | Live-X (Twitter)-Datenstrom + Breaking News | 8,03M global vol (grok) | Thread- & Postsynthese |
| 8 | Consensus | Peer-reviewter Konsensmesser | DR 80 · 135K global vol (consensus ai) | Zitatlisten & Studien-Snapshots |
| 9 | Elicit | Systematische Literaturreviews & Datentabellen | DR 76 · 143K global vol (elicit) | Multi-Paper-Extraktionsmatrix |
| 10 | Liner AI | Passagegenaues Markieren & Zitieren | 14K global vol (liner ai) | Essay- & Literaturverzeichnis-Entwürfe |
| 11 | Kagi Search | Bezahlter, werbefreier, anpassbarer Index | DR 79 · 7,1K global vol (kagi search) | Saubere Zusammenfassungen & Domain-Ranking |
| 12 | iAsk.Ai | Kostenlos, schnelle Q&A & Hausaufgabenhilfe | DR 70 · 216K US org traffic | Sofort-Textzusammenfassungen |
| 13 | DuckDuckGo AI | Anonyme KI-Suche & Duck.ai | 42K global vol (duckduckgo ai) | Private Antwort-Snippets |
| 14 | You.com | Enterprise ARI Deep Research & Custom Agents | DR 79 · 25K global vol (you.com) | Deep-Research-Berichte |
Teil 2: Die 17 besten Suchdienste & APIs für KI-Agenten (2027)
Wer von der Browser-Registerkarte zum autonomen Agenten wechselt, erlebt völlig neue Suchregeln.
Die beliebtesten Agenten-Frameworks – darunter Claude Code, Codex CLI, pi coding agent, OpenClaw und Hermes Agent – führen dutzende Tool-Aufrufe in einer Task-Schleife aus. Rohes HTML aus klassischen Scraper-Tools bläht das Kontextfenster mit Navigationsmenüs, Cookie-Bannern und Inline-JavaScript auf und verbrennt unnötig viele Token.
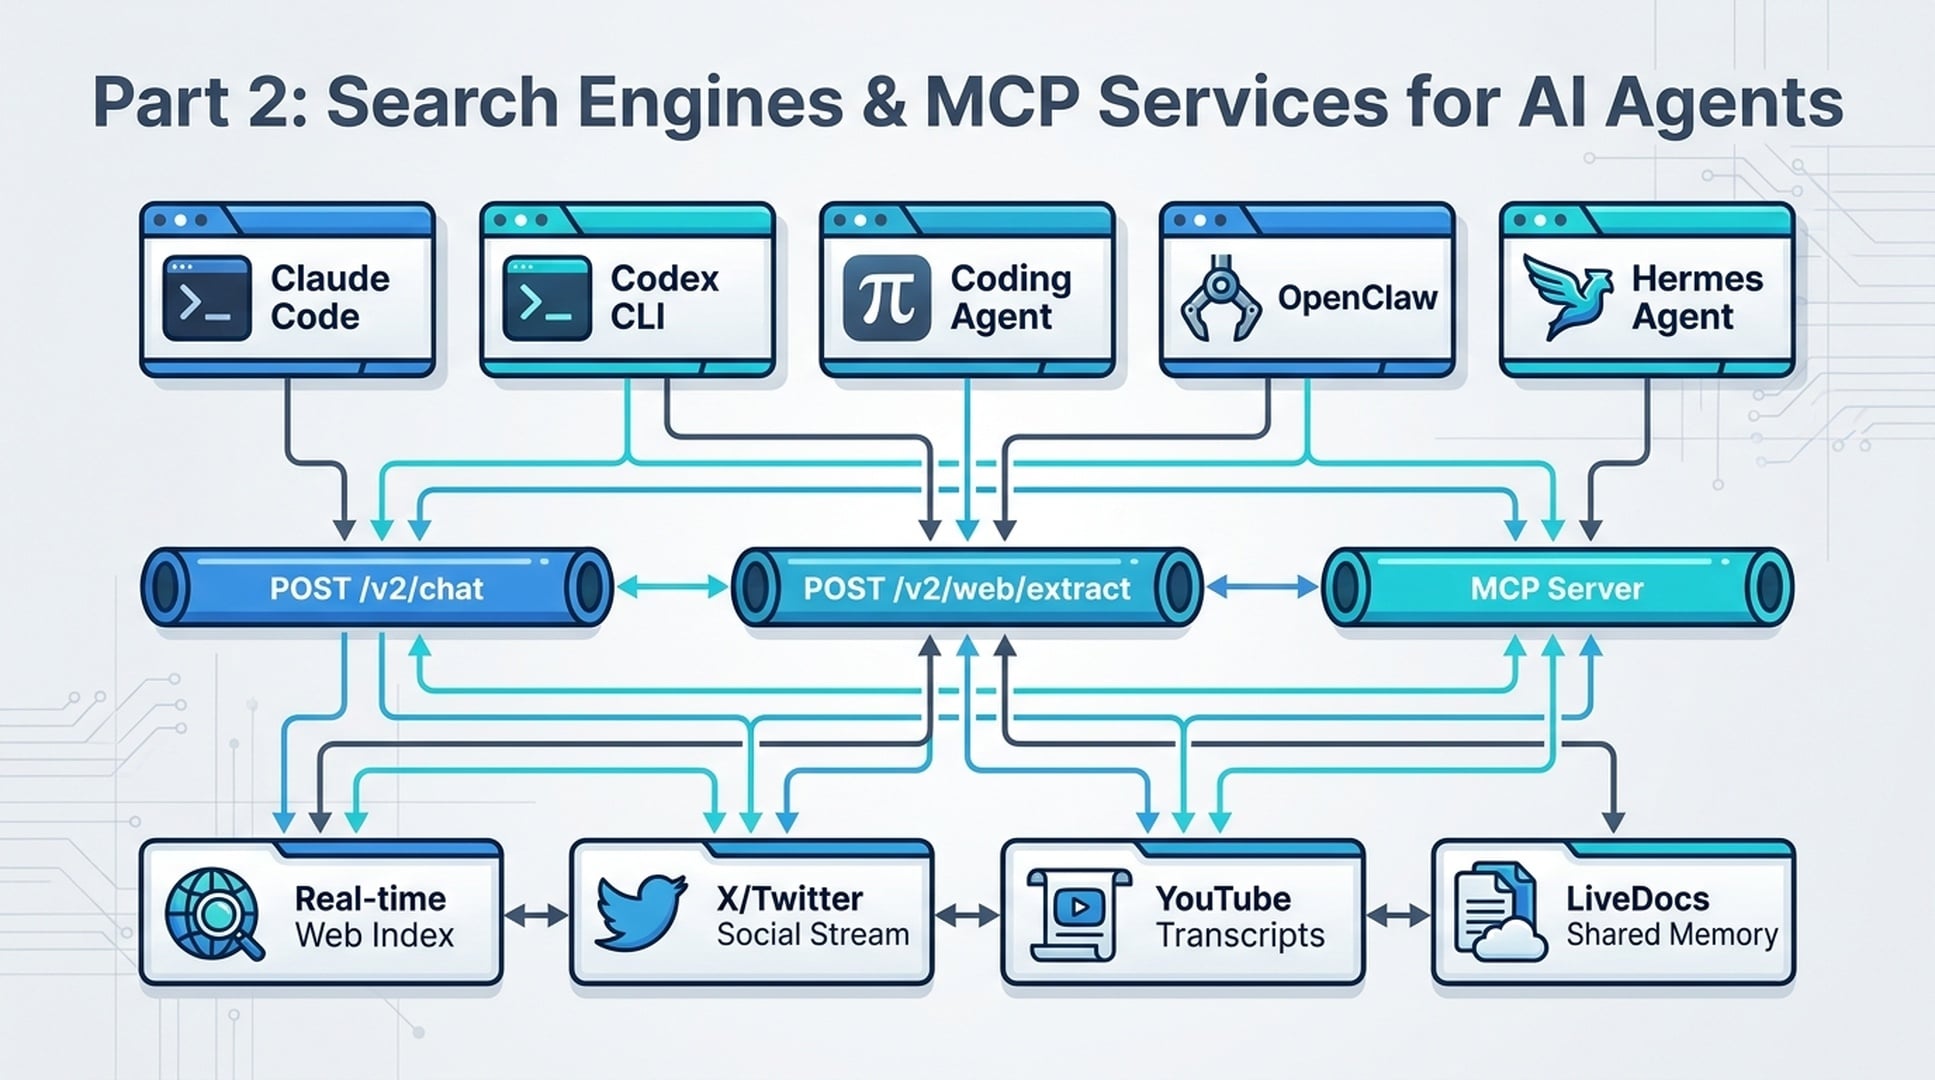
Wie Entwickler 2027 Agenten-Suche wählen (Daten von X & Ahrefs)
Laut Ahrefs-Suchvolumen und Live-Benchmarks auf X (Twitter) gliedert sich die Agenten-Suchlandschaft 2027 in vier Ebenen:
- Vereinheitlichte Agenten-Tool- & Ergebnis-Stacks (Felo OpenAPI, plus direkter, anbieterfreier Zugang zu Anthropic Web Search API und OpenAI Web Search API): Suche + Web-Fetch + X/YouTube + LiveDocs Memory + PPT/Page-Ausgabe unter einem API-Key.
- Agent-native Such- & Grounding-APIs (Tavily, Exa, Parallel Web Systems, Brave Search API, Perplexity Sonar, Linkup, DeepSeek Search & Fetch): Speziell für LLMs optimierte Chunks, Highlights oder Antworten für $0,75–$8 pro 1.000 Calls.
- Markdown-Extraktion & Agenten-Crawler (Firecrawl, Jina Reader, Crawl4AI): Wandeln komplexe JS-lastige Dokusites in sauberes Markdown.
- Rohes SERP & Enterprise-Web-Infrastruktur (SerpApi, Serper.dev, Apify, Bright Data): Hochvolumiges Google SERP-JSON, Proxy-Unlocking und fertige MCP-Scraping-Actors.
Hier sind die 17 besten Suchdienste für KI-Agenten 2027 – mit offiziellen Schnittstellen und echten Entwickler-Trade-offs.
1. Felo OpenAPI & MCP Search Stack: Bester All-in-One-Such-, Extraktions-, Social- & Ergebnis-Layer für Agenten
Die meisten Such-APIs enden nach zehn Snippets. Felo OpenAPI wurde speziell für Agenten-Frameworks wie Claude Code, Codex CLI, pi, OpenClaw und Hermes Agent gebaut, die suchen, lesen, merken und Ergebnisse unter einem API-Key und einer Basis-URL produzieren.
Statt Tavily für Suche, Jina für Seitenlesen, einen separaten Twitter-Scraper und einen eigenen Slide-Generator zu kombinieren, bietet Felo einen mehrschichtigen Agenten-Stack:
- KI-Suche (
POST /v2/chat): Konversationsfähige, Echtzeit-Antwort-Engine-API mit synthetisierten Antworten und optimierter Query-Analyse für Agenten. - Web-Fetch / Extraktion (
POST /v2/web/extract): Extrahiert saubere, strukturierte Inhalte aus jeder Ziel-URL, damit Agenten Primärquellen prüfen können. - X (Twitter)-Suche (
POST /v2/x/tweet/search&/v2/x/user/tweets): Agenten können Live-Entwicklerdiskussionen, Produktlaunches und Social-Stimmung direkt abfragen. - YouTube-Untertitel (
GET /v2/youtube/subtitling): Holt komplette Videotranskripte, damit Agenten Konferenzvorträge, Tutorials und Demos auswerten können. - LiveDocs Memory & Output APIs (
POST /v2/ppts,/v2/mindmap,/v2/landing_page): Agenten speichern Recherche in geteilter semantischer Memory (LiveDocs) und verwandeln sie in PowerPoint-Decks oder Landing Pages – plus Frontier-LLMs (Claude, GPT, Grok) via OpenAI- und Anthropic-kompatible Endpunkte.
Warum Agenten-Entwickler es wählen:
- Dedizierte Setups und Skills für Claude Code, Codex CLI, OpenClaw, pi und Hermes Agent.
- Ersetzt 4–5 separate API-Abos durch einen Key (
openapi.felo.ai).
2. Anthropic Web Search API (über Felo OpenAPI): Beste Claude-basierte Zitatsuche ohne separaten Anbieter-Account
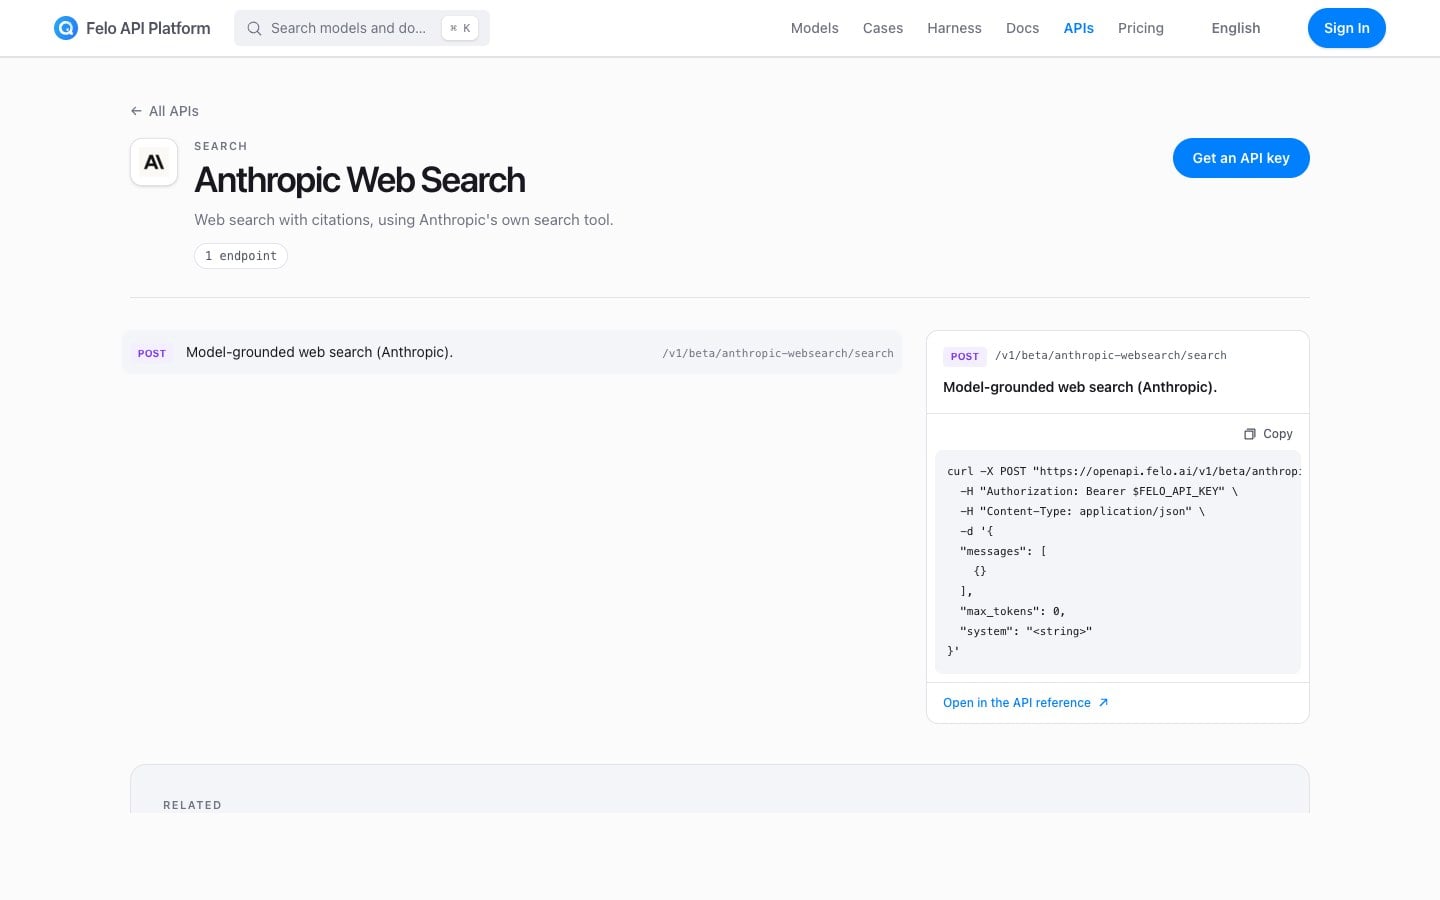
Viele Entwickler auf Claude Code, pi oder eigenen Anthropic-Tool-Loops wollen Anthropics native, modellbasierte Websuche mit Inline-Zitaten – ohne separate Anthropic-Limits, regionale Abrechnung oder zusätzliche Anbieter-Keys. Über Anthropic Web Search auf Felo OpenAPI (POST /v1/beta/anthropic-websearch/search) kann der Agent Anthropics eigenes Suchtool direkt mit dem bestehenden $FELO_API_KEY nutzen.
Stärken:
- Native Claude-basierte Websuche mit strukturierten Zitaten über ein einziges Endpoint (
https://openapi.felo.ai/v1/beta/anthropic-websearch/search). - Kein separater Anbieter-Account nötig: Nutzt Standard-Parameter wie
messages,max_tokens,systemunter einheitlicher Felo-Abrechnung.
Einschränkungen: Fokussiert auf Claude-basierte Suchsynthese; für Rohseiten-Scraping oder Social-Feeds mit Felo /v2/web/extract oder /v2/x/tweet/search kombinieren.
3. OpenAI Web Search API (über Felo OpenAPI): Beste OpenAI-basierte Suche für Codex & Responses-Workflows
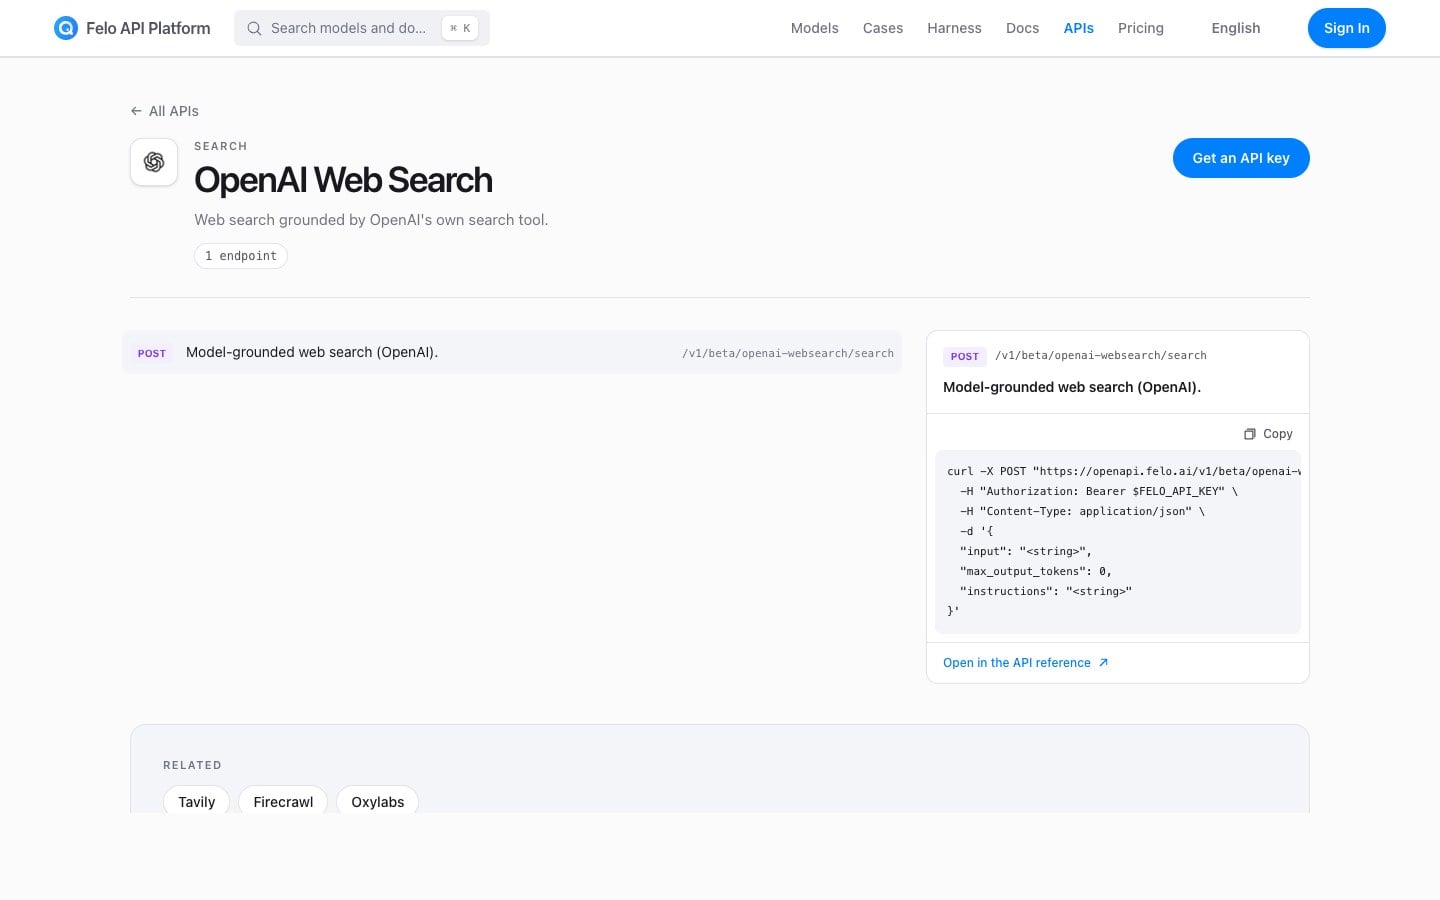
Wer OpenAIs Responses-Schema (input, instructions, max_output_tokens) oder Codex CLI nutzt, erhält mit OpenAI Web Search auf Felo OpenAPI (POST /v1/beta/openai-websearch/search) direkten Zugang zu OpenAIs eigenem Suchtool – ebenfalls ohne separaten OpenAI-Account.
Stärken:
- Nutzt OpenAIs natives Suchtool via
https://openapi.felo.ai/v1/beta/openai-websearch/search. - Ideal für Teams mit Codex CLI oder Multi-Modell-Agenten, die Anthropic- und OpenAI-Websuche unter einem
$FELO_API_KEYbündeln.
Einschränkungen: Für modellbasierte Suchantworten, nicht für Multi-Page-Site-Crawling.
4. Tavily Search API: Beste RAG-Suche für LangChain & LangGraph
Mit 32.000 globalen monatlichen Suchen (tavily, DR 79, $4,50 CPC laut Ahrefs) war Tavily eine der ersten APIs speziell für LLM-Agenten und bleibt Standardempfehlung in LangChain- und LangGraph-Vorlagen. Ein API-Call durchsucht mehrere Quellen, bewertet Relevanz zum Prompt und liefert kompakte Content-Chunks plus optional Kurzantwort.
Stärken:
- Saubere
search- undextract-Endpunkte mit einstellbarer Suchtiefe (basicvs.advanced). - Tiefe native Integrationen in LangChain, LlamaIndex und CrewAI.
Einschränkungen: Nur Websuche und Extraktion – keine X/Social-Suche, YouTube-Transkripte, Workspace-Memory oder Ergebnisgenerierung.
5. Exa (ehemals Metaphor): Beste neuronale & semantische Suche für technische Entdeckung
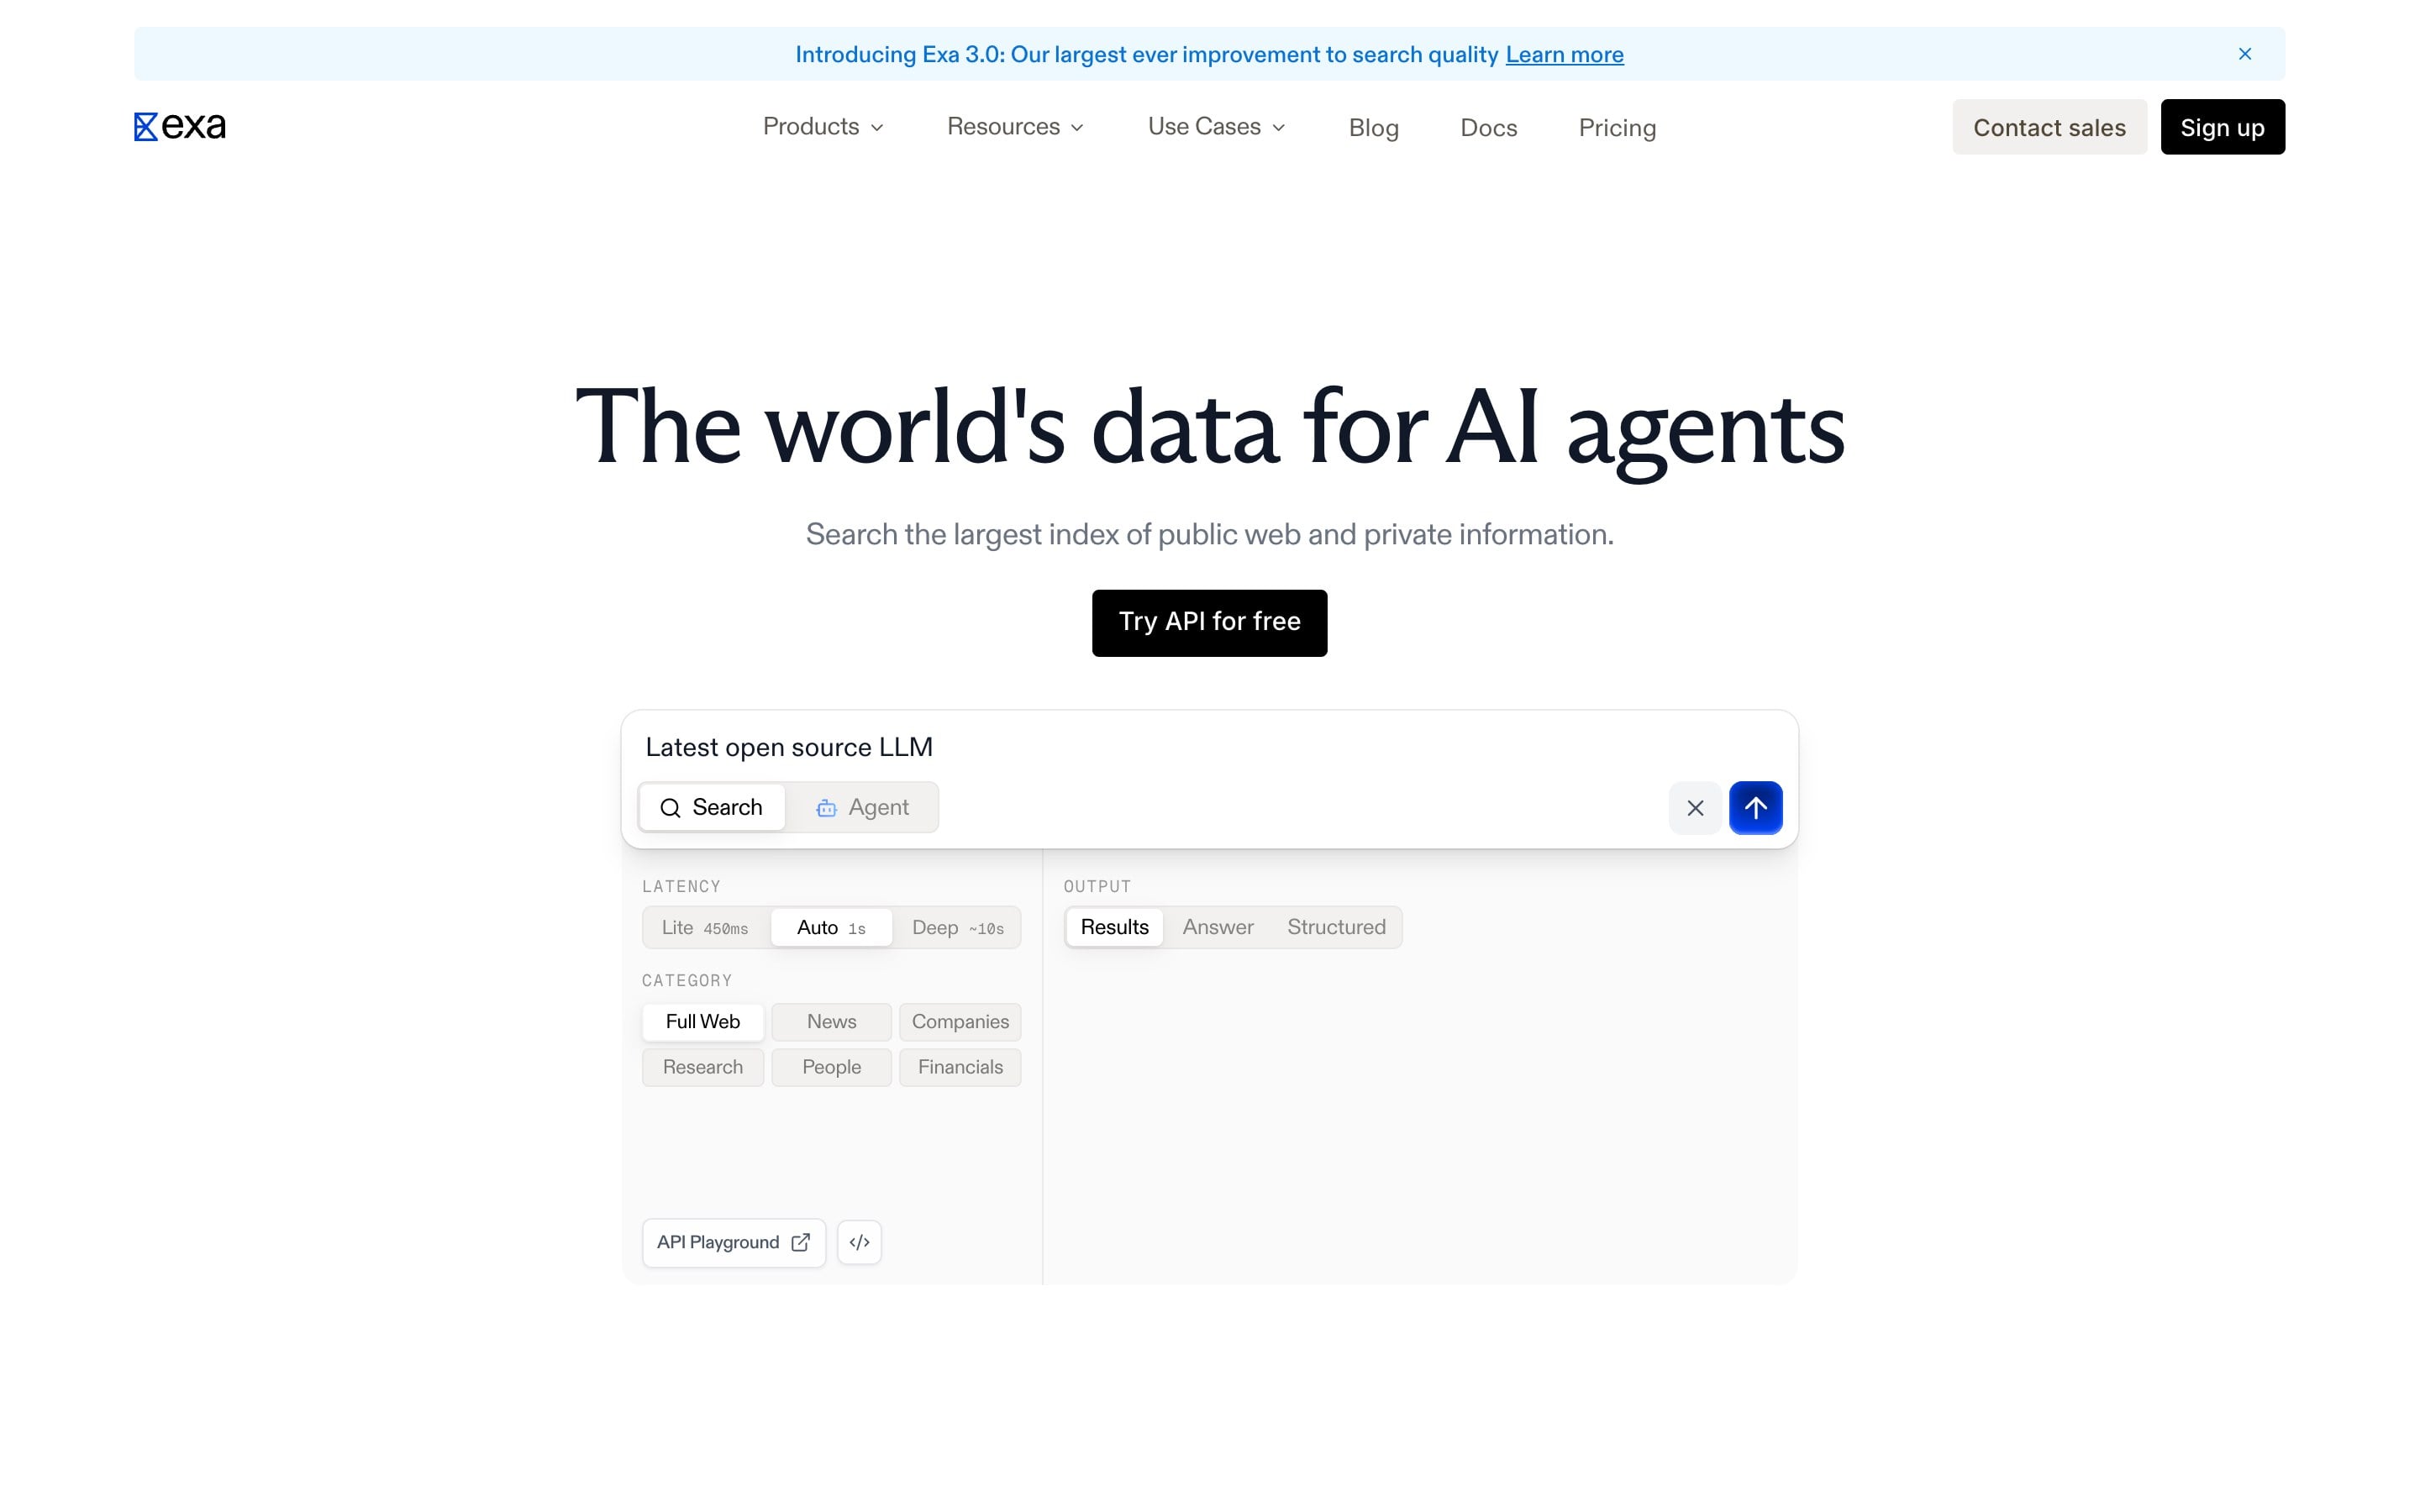
Mit 23.100+ monatlichen US-Visits und 16.000 globalen Markensuchen (exa ai, DR 79) nutzt Exa neuronale Embeddings für semantische Suche und Linkstruktur statt reiner Keywords. Auf X bewerten Entwickler Exa am höchsten, wenn Agenten „frühe Open-Source-Rust-Vektordatenbanken“ oder „Paper-Benchmarks zu KV-Cache-Kompression“ finden sollen, wo Keywords versagen.
Stärken:
- Neuronale Suche + Kategorie-Filter (Papers, GitHub, Firmen, News, Tweets, Personen).
- Token-effizienter Highlights-Modus und weit verbreiteter MCP-Server (z. B. in pi coding agent und Claude Code).
Einschränkungen: Weniger geeignet für exakte Navigationsanfragen oder Office-Output-Workflows.
6. Parallel Web Systems (parallel.ai): Schnellste, pareto-optimale Suche & Extraktion für Deep-Research-Agenten
Einer der heißesten Agenten-Infrastruktur-Durchbrüche auf X 2026–2027 (DR 77, 18.000+ US-Visits, 6.800 globale Suchen nach parallel web systems): Parallel baute eine Such- und Extraktionsengine speziell für KI-Agenten. In unabhängigen Benchmarks auf X erreicht Parallel das Pareto-Optimum bei Genauigkeit, Latenz und Kosten (~$1 pro 1.000 Seiten), bietet dedizierte Search-, Extract- und Deep-Research-APIs plus offiziellen MCP-Server.
Stärken:
- Speziell für deklarative Agentenziele statt klassische Keyword-Suche gebaut.
- Sub-Sekunden-Latenz für Voice/Chat-Agenten, skalierbar bis Multi-Hop-Deep-Research.
Einschränkungen: Reine Web-Intelligenz – keine Slide-/Dokumentgenerierung oder Multi-Provider-LLM-Routing.
7. Brave Search API (mit LLM-Kontext): Bester unabhängiger Webindex für Agenten mit hohem Anfragevolumen
Mit 30.000 globalen monatlichen Suchen nach brave search api ist die Brave Search API der Standard für Entwickler, die große Mengen roher, unabhängiger Webdaten ohne Google/Bing-Limits brauchen. Sie ist fester Bestandteil in OpenClaw, pi coding agent und MCP-Server-Repos und bietet einen LLM Context-Endpunkt für Modell-Grounding.
Stärken:
- Basierend auf Braves eigenem 30B+ Seitenindex (täglich 100M+ Updates).
- Planbare Preise (~$3–$5 pro 1.000 Anfragen) und sehr niedrige Latenz.
Einschränkungen: Liefert primär SERP-Snippets und Grounding-Kontext; komplexes Site-Crawling braucht eigene Reader-Tools.
8. Firecrawl: Bester Managed Web Scraper, Crawler & strukturierter Extractor für Agenten
Mit 105.000 globalen monatlichen Suchen (30.000 in den USA, DR 80, 44,6K US-Visits laut Ahrefs) ist Firecrawl Standard, wenn Agenten komplette Dokusites crawlen (docs.example.com/*), dynamisches JavaScript rendern und jede Unterseite in sauberes Markdown oder JSON verwandeln sollen. Seit Ende 2026 gibt es auch einen 270M+ Profile-People-Data-Endpunkt für Sales- und Recruiting-Agenten.
Stärken:
- Kombiniert
/search,/scrape,/crawlund schema-getriebenes/extractplus gehostete MCP-Tools für Claude Code und Cursor. - Headless-Browser-Rendering, Anti-Bot-Rotation und PDF-Parsing inklusive.
Einschränkungen: Credits steigen bei Multi-Page-Crawls; für YouTube-Transkripte oder Slides braucht es weitere Tools.
9. Jina Reader API (r.jina.ai & s.jina.ai): Beste Zero-Setup-URL-zu-Markdown-Pipeline
Jina AI (DR 77, $4,50 CPC) machte Jina Reader bei Entwicklern beliebt: Einfach https://r.jina.ai/ vor eine URL setzen und sauberes, LLM-fähiges Markdown erhalten – oder https://s.jina.ai/ vor eine Suchanfrage für Top-Web-Ergebnisse als Markdown.
Stärken:
- Kein SDK nötig – funktioniert mit einfachem
curloderfetchin jedem bash-fähigen Agenten. - Unterstützt von Jinas spezialisierten ReaderLM-Modellen für HTML-zu-Markdown.
Einschränkungen: Rate-Limit ohne bezahlte Tokens; keine Social/X-Suche oder Workspace-Memory.
10. Crawl4AI: Beste Open-Source- & Self-Hosted-Webcrawler für KI-Agenten
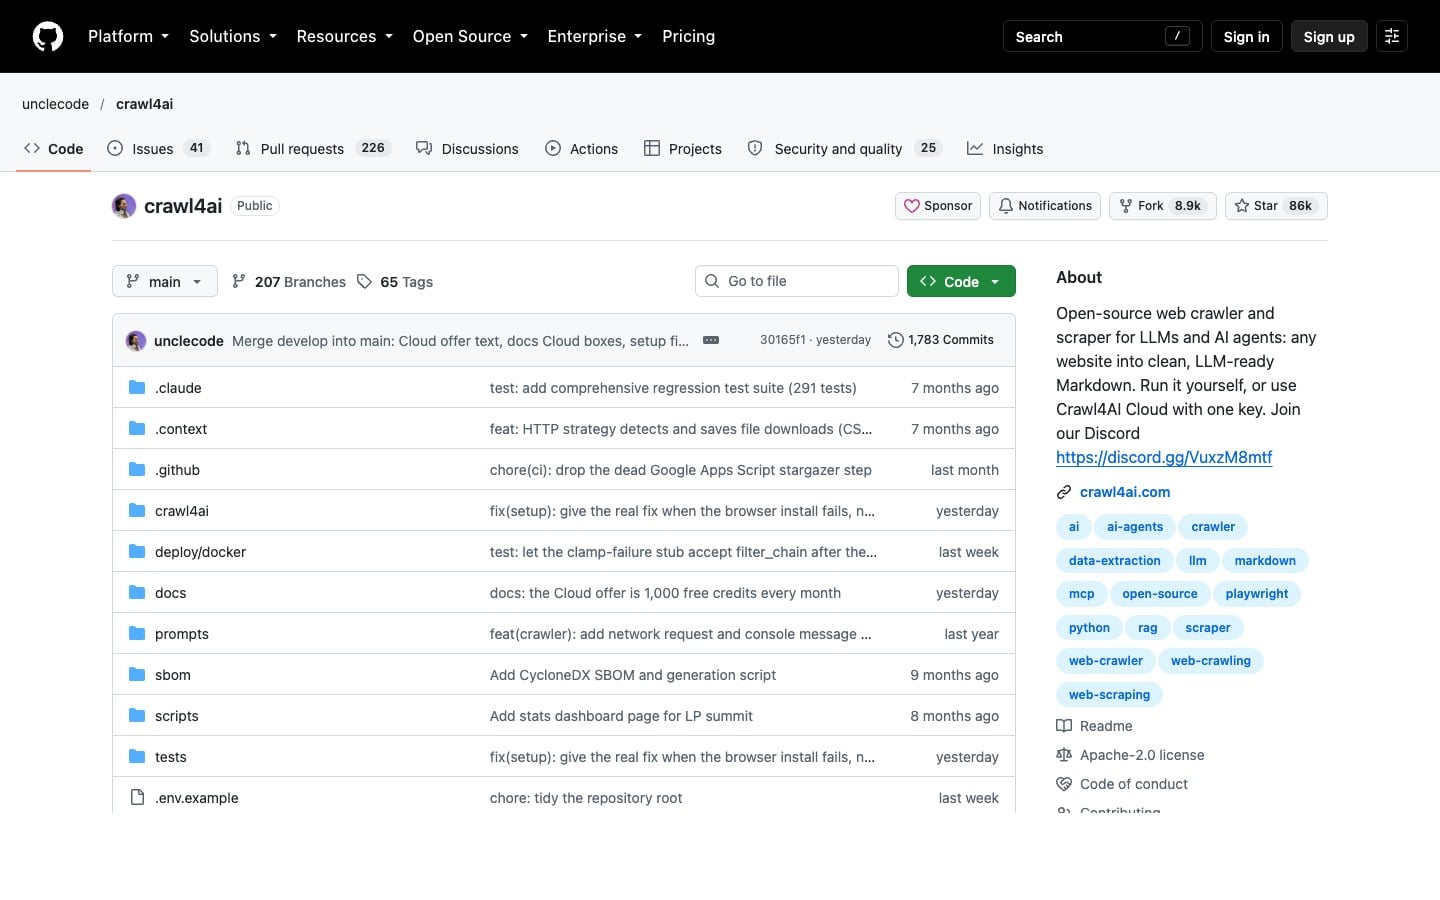
Mit 17.000 globalen monatlichen Suchen (crawl4ai) und über 50.000 GitHub-Stars ist Crawl4AI die #1 Open-Source-Alternative zu Firecrawl. Wer keine API-Kosten pro Seite will oder Extraction im eigenen VPC braucht, setzt Crawl4AI lokal via Docker/Python oder verbindet zu Crawl4AI Cloud.
Stärken:
- 100% Open-Source, selbst hostbar, gibt sauberes Markdown mit Heuristik-Rauschfilter (
fit_markdown) aus. - Unterstützt persistente Browsersessions, eigene JS-Hooks und lokale LLM-Extraktion.
Einschränkungen: Self-Hosting erfordert eigenes Playwright-Management, Speicher und Proxy-Rotation bei blockierten IPs.
11. Perplexity Sonar API: Am besten für zitierte Prosa-Antworten per Drop-In
Mit 2.500 monatlichen Suchen nach perplexity sonar ist die Perplexity Sonar API die schnellste Option, wenn der Agent keine mehrstufige Such-/Scrape-Schleife orchestrieren soll, sondern eine einzige OpenAI-kompatible Chat-Completions-Antwort mit Zitat-URLs braucht.
Stärken:
- Drop-in-OpenAI-SDK-Kompatibilität (
sonar,sonar-pro,sonar-deep-researchModelle). - Hohe Faktengenauigkeit bei Single-Turn-Q&A.
Einschränkungen: Tokenkosten plus Suchgebühren summieren sich bei 30+ Sub-Queries; kein Rohseiten-Extraktionsendpunkt.
12. Linkup (linkup.so): Am besten für verifizierbares Enterprise-Grounding & Premium-Publisher-Daten
Mit 6.100 globalen monatlichen Suchen (linkup, DR 65, $6,00 CPC) ist Linkup eine schnell wachsende europäische und US-Agenten-API mit Fokus auf verifizierbares, compliance-sicheres Grounding. Neben schnellen Search- und Fetch-Endpunkten kooperiert Linkup direkt mit Premium-Publishern und Datenanbietern, sodass Enterprise-Agenten lizenzierte Fakten ohne Copyright-Risiken erhalten.
Stärken:
- Starke Performance bei SimpleQA-Benchmarks mit niedriger Latenz (
standardund Multi-Hop-deep-Modus). - Offizieller MCP-Server und Integrationen in LangChain, LlamaIndex und Claude Desktop.
Einschränkungen: Kleineres Ökosystem für kreative/Output-Tools als All-in-One-Workspaces.
13. SerpApi: Am besten für Multi-Engine-Struktur-SERP-JSON (Google, Scholar, Maps, News)
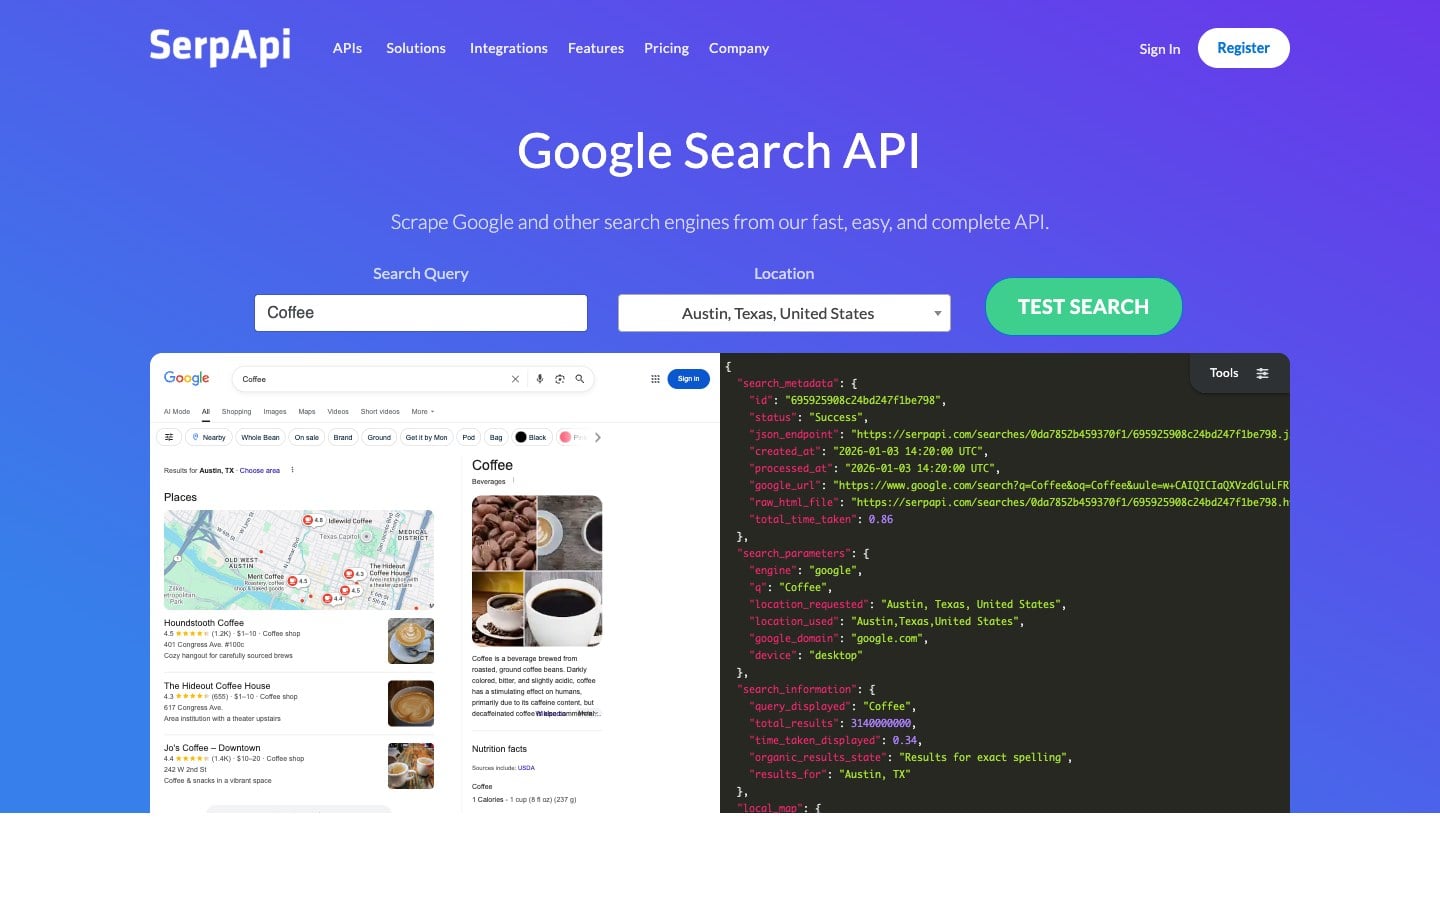
Mit 63.000 globalen monatlichen Suchen (20.000 in den USA) und 34.700+ US-Visits (DR 79) ist SerpApi der bewährte Veteran im Such-Scraping. Ursprünglich nicht für LLMs gebaut, setzen Agenten auf SerpApi, wenn sie strukturierte Daten aus Google-Vertikalen brauchen – etwa Google Scholar, Patente, Flüge, Maps oder Shopping.
Stärken:
- 40+ Suchmaschinen und Vertikalen mit garantiertem CAPTCHA-Solving und Geotargeting bis auf Stadtebene.
- Rechtlicher US-Schutz für Enterprise-Compliance.
Einschränkungen: Teuer bei hohem Volumen (~$10–$15/1.000 Suchen), gibt großes Roh-SERP-JSON aus, das vor LLM-Input aufbereitet werden muss.
14. Serper (serper.dev): Beste günstige, schnelle Google-SERP-API
Mit 11.000 globalen monatlichen Suchen (serper, DR 74) ist Serper.dev auf X Favorit, wenn Agenten rohe Google-Ergebnisse, News oder Bilder in 1–2 Sekunden für $0,30 bis $1,00 pro 1.000 Anfragen brauchen – ein Bruchteil von SerpApi.
Stärken:
- Extrem schnelle Antwort (~1s) und günstigster Weg, Google-SERP-Snippets in Agenten-Pipelines zu holen.
- Native Unterstützung in pi coding agent, CrewAI und AutoGPT.
Einschränkungen: Liefert nur SERP-Metadaten und kurze Snippets – für vollständige Seiten braucht es Extraktions-APIs (wie Felo /v2/web/extract, Firecrawl oder Jina).
15. Apify (Actors & MCP Server): Bester Marktplatz für 90.000+ fertige Web-Scraper für Agenten
Mit 273.000 globalen monatlichen Suchen (50.000 in den USA, DR 82, 96,9K US-Visits) hat Apify sich stark auf KI-Agenten-Infrastruktur ausgerichtet. Über den RAG Web Browser und den offiziellen Apify MCP Server kann ein Agent über 90.000 fertige Cloud-„Actors“ aufrufen – für Google-Suche, Instagram/TikTok/LinkedIn-Profile, Amazon-Reviews oder Markdown-Crawling.
Stärken:
- Größte Auswahl an Site-spezifischen Scrapers (Social, E-Commerce, Maps, Jobbörsen) über ein MCP-Gateway.
Einschränkungen: Actor-Startzeiten und Compute-Preise können langsamer und komplexer als reine REST-Suche sein.
16. Bright Data (AI Web Access & SERP API): Bester Enterprise-Proxy & Anti-Bot-Unlocker für Agenten
Mit 27.000 globalen monatlichen Suchen (bright data, DR 79, 31,7K US-Visits) liefert Bright Data die Webzugangsschicht für viele Fortune-500-KI-Teams. Wenn Agenten Seiten hinter strengen Firewalls (Cloudflare/DataDome) lesen müssen, routet Bright Data mit Web Unlocker, SERP API und Remote Browser for AI Agents über ein 150M+ Residential-IP-Netz und gibt sauberes Markdown aus.
Stärken:
- Höchste Erfolgsrate auf geschützten E-Commerce-, Reise- und Finanzportalen, plus gehosteter MCP-Server.
Einschränkungen: Enterprise-orientierte Abrechnung und Konfiguration; überdimensioniert für reine Entwicklerdokus, News und Tech-Blogs.
17. DeepSeek Search & Fetch API: Günstigste native Suche für Coding- & Research-Agenten
Im Oktober 2026 brachte DeepSeek die offiziellen Search & Fetch APIs – liefern rohe Suchergebnisse und bereinigte Seiteninhalte für $0,75 pro 1.000 Calls (mit Gratis-Tiers für Claude Code und Codex). Innerhalb von 24 Stunden banden Open-Source-Maintainer DeepSeek Search & Fetch direkt in Hermes Agent und pi-Erweiterungen (web-deepseek) als günstige, schnelle Alternative zu Exa und Parallel ein.
Stärken:
- Aggressive Preise ($0,75/1K Calls) mit Search- und Clean-Page-Fetch für Coding-Agenten.
Einschränkungen: Neues Ökosystem mit weniger vertikalen Endpunkten (keine nativen YouTube-Untertitel, X-Timeline oder PPT/LiveDoc-Generierung).
Master-Vergleichstabelle: 17 Suchdienste für KI-Agenten (2027)
| # | Service | Kategorie | KI-Antwort | Vollseiten-Extrakt | X / YouTube-Daten | Ergebnisse & Memory | Typische Preise / Reichweite |
|---|---|---|---|---|---|---|---|
| 1 | Felo OpenAPI | All-in-One-Agenten-Stack | ✅ /v2/chat | ✅ /v2/web/extract | ✅ X + YouTube | ✅ LiveDocs + PPT/Mindmap | Einheitlicher Key (openapi.felo.ai) |
| 2 | Anthropic Web Search API | Claude-basierte Suche | ✅ (/v1/beta/anthropic-websearch/search) | Über Felo Extract | ❌ | Über Felo OpenAPI | Kein Anthropic-Account nötig |
| 3 | OpenAI Web Search API | OpenAI-basierte Suche | ✅ (/v1/beta/openai-websearch/search) | Über Felo Extract | ❌ | Über Felo OpenAPI | Kein OpenAI-Account nötig |
| 4 | Tavily | Agenten-RAG-Suche | ✅ | ✅ | ❌ | ❌ | DR 79 · 32K global vol · ~$5–$8/1K |
| 5 | Exa | Neuronale semantische Suche | ✅ | ✅ | Teilweise (Tweets) | ❌ | DR 79 · 16K global vol · ~$5/1K |
| 6 | Parallel (parallel.ai) | Schnelle Agenten-Web-Infrastruktur | ✅ | ✅ | ❌ | ❌ | DR 77 · 18K US org traffic · ~$1/1K |
| 7 | Brave Search API | Unabhängiger Webindex | ✅ (LLM Context) | ❌ | ❌ | ❌ | 30K global vol · ~$3–$5/1K |
| 8 | Firecrawl | Managed Crawl & Extract | ❌ | ✅ (Deep crawl) | ❌ | ❌ | DR 80 · 105K global vol |
| 9 | Jina Reader | URL-zu-Markdown | ❌ | ✅ (r.jina.ai) | ❌ | ❌ | DR 77 · Instant prefix API |
| 10 | Crawl4AI | Open-Source-Crawler | ❌ | ✅ (Self-hosted) | ❌ | ❌ | 17K global vol · 50K+ GitHub stars |
| 11 | Perplexity Sonar | Zitierte Chat-Completions | ✅ (Kernfokus) | ❌ | ❌ | ❌ | 2,5K global vol · Token + Request Fee |
| 12 | Linkup (linkup.so) | Enterprise-Grounding | ✅ | ✅ | ❌ | ❌ | DR 65 · 6,1K global vol · €5/1K |
| 13 | SerpApi | Multi-Vertical SERP-JSON | ❌ | ❌ | YouTube-Metadaten | ❌ | DR 79 · 63K global vol · ~$10–$15/1K |
| 14 | Serper.dev | Schnelle Google-SERP | ❌ | ❌ | ❌ | ❌ | DR 74 · 11K global vol · ~$0,30–$1/1K |
| 15 | Apify | 90K+ Scraper Actors & MCP | Über Actors | ✅ | ✅ (über Actors) | ❌ | DR 82 · 273K global vol |
| 16 | Bright Data | Enterprise-Unlocker & SERP | ❌ | ✅ (Markdown) | ✅ (Datasets) | ❌ | DR 79 · 27K global vol |
| 17 | DeepSeek Search/Fetch | Günstige Suche & Fetch | ❌ | ✅ | ❌ | ❌ | ~$0,75/1K Calls · Claude/Codex-ready |
Wie populäre KI-Agenten 2027 Suche anbinden
Wer einen KI-Agenten lokal im Terminal oder im Team-Workflow nutzt, findet hier die aktuellen Anbindungen der führenden Agenten-Frameworks:
1. Claude Code
Claude Code glänzt bei Code-Reasoning, Bash-Ausführung und Datei-Edits – aber die eingebauten Webtools reichen nicht für Social-Signale, Videotranskripte oder Office-Outputs. Mit Felo OpenAPI (über CLI-Skills oder MCP-Server) kann Claude Code Live-Dokumentation suchen (POST /v2/chat), ganze Referenzseiten extrahieren (POST /v2/web/extract), X auf Breaking-Change-Reports prüfen und sogar Architektur-Review-Slides generieren (POST /v2/ppts).
2. Codex CLI
OpenAIs Codex CLI nutzt standardmäßig einen gecachten Web-Snapshot, wodurch neue Dokus oder CVEs fehlen können. Entwickler erweitern Codex via config.toml, MCP-Server oder Felos Codex-Integration und erhalten Echtzeit-Websuche, URL-Extraktion und günstiges Multi-Modell-Routing unter einem API-Key.
3. pi Coding Agent
Der pi coding agent setzt auf Geschwindigkeit, Erweiterbarkeit und sauberes Kontextmanagement. In pi kombinieren Entwickler native web_search- und fetch_content-Tools (für parallele Anfragen an Exa, Brave, Tavily, Firecrawl, Jina) mit CLI-Skills wie felo-search (~/.agents/skills/felo-search/scripts/search.sh) und felo-x-search – so recherchieren Subagenten, prüfen Aussagen und schreiben Code parallel, ohne das Hauptkontextfenster zu belasten.
4. OpenClaw
OpenClaw eignet sich für autonome Recherche und mehrstufige Workflows, hat aber ohne externe APIs keine persistente Memory oder Live-Social-Pulse. Mit Felo OpenAPI erhält OpenClaw Live-Websuche, X-Stimmungsanalyse, YouTube-Transkripte und LiveDocs-Memory – so erinnert sich der Agent an vergangene Recherche.
5. Hermes Agent & Custom MCP Harnesses
Für Teams mit Multi-Agenten-Pipelines in Hermes Agent oder eigenen MCP-Clients zählt Protokollkonsistenz. Mit Felo OpenAPIs REST- und SuperAgent-SSE-Endpunkten plus Standard-MCP-Servern (z. B. auf mcpmeasure.com) können Hermes-Agenten Suche → Extraktion → LiveDocs-Memory → PPT/Landing-Page-Generierung verkettet nutzen – ohne für fünf Anbieter eigene Glue-Codes zu schreiben.
Kurzes Beispiel: Felo Search & Web Extraction aus jedem Agenten aufrufen
Da Felo OpenAPI saubere REST-Endpunkte mit Bearer-Token-Auth nutzt, kann jeder Agent mit Bash- oder HTTP-Tool sie in Sekunden ansprechen:
# 1. Echtzeit-KI-Antwortsuche (POST /v2/chat)
curl -s -X POST "https://openapi.felo.ai/v2/chat" \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "Compare MCP server authentication changes in the 2026-2027 spec"
  }'

# 2. Anthropic-Modell-basierte Websuche (kein separater Anthropic-Account nötig)
curl -s -X POST "https://openapi.felo.ai/v1/beta/anthropic-websearch/search" \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "messages": [{"role": "user", "content": "Latest stable release of Claude Code and key MCP updates"}],
    "max_tokens": 1024
  }'

# 3. OpenAI-Modell-basierte Websuche (kein separater OpenAI-Account nötig)
curl -s -X POST "https://openapi.felo.ai/v1/beta/openai-websearch/search" \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "input": "Compare Codex CLI web search configuration options",
    "max_output_tokens": 1024
  }'

# 4. Sauberen Inhalt aus einer URL extrahieren (POST /v2/web/extract)
curl -s -X POST "https://openapi.felo.ai/v2/web/extract" \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "url": "https://modelcontextprotocol.io/specification"
  }'
Der Agent erhält strukturiertes JSON mit synthetisierter answer, query_analysis-Begriffen und extrahiertem Seiteninhalt – bereit für den nächsten Reasoning-Schritt oder zum Speichern in LiveDocs.
Häufig gestellte Fragen (FAQ)
Was ist der Unterschied zwischen einer Online-KI-Antwort-Engine und einer Agenten-Such-API?
Eine Online-KI-Antwort-Engine (wie Felo AI Search, Perplexity oder ChatGPT Search) richtet sich an Menschen – mit visueller Oberfläche, klickbaren Quellenkarten und interaktiver Dokument- oder Slide-Erstellung. Eine Agenten-Such-API (wie Felo OpenAPI, Tavily oder Exa) richtet sich an Software-Agenten wie Claude Code oder OpenClaw – sie liefert maschinenlesbares JSON, saubere Markdown-Extraktion und schnelle Endpunkte ohne UI-Overhead.
Welche KI-Antwort-Engine ist 2027 am besten für mehrsprachige Recherche?
Felo AI Search führt bei Cross-Language-Recherche. Sie übersetzt die Absicht in native Anfragen in Zielsprachen (z. B. Japanisch, Chinesisch, Koreanisch, Englisch, europäische Sprachen), holt Primärquellen und fasst die Antwort in der gewünschten Sprache zusammen.
Welche Such-API ist am besten für Claude Code, Codex CLI, pi und OpenClaw?
Wer einen einzigen API-Key für Websuche, Vollseiten-Extraktion, X (Twitter)-Suche, YouTube-Transkripte, Shared Memory (LiveDocs) und Ergebnisgenerierung (PPTs, Mindmaps, Landing Pages) will, fährt mit Felo OpenAPI am umfassendsten. Für reine, unabhängige SERP-Snippets eignet sich Brave Search API; für semantische Vektorsuche ist Exa eine starke Spezialoption.
Warum sollte ich meinen KI-Agenten nicht einfach Google scrapen lassen?
Rohes Webscraping löst CAPTCHAs aus, bricht bei Layoutänderungen und bringt zehntausende Token an HTML/JavaScript-Rauschen ins Kontextfenster. Agenten-Such-APIs liefern vorgefiltertes Markdown und synthetisierte Antworten mit weniger Token und geringerer Latenz.
Fazit: Die richtige Engine für Menschen – und für Agenten wählen
2025 fühlte sich der Wechsel von zehn blauen Links zur KI-Antwort-Engine wie ein Superkraft-Upgrade an. 2027 rüsten die klügsten Teams beide Seiten ihres Workflows auf:
- Für die eigene tägliche Recherche: Felo AI Search nutzen, um Sprachbarrieren zu überwinden, Echtzeit-Web- und Social-Evidenz zu holen und Antworten in LiveDocs und Felo Slides zu verwandeln.
- Für KI-Agenten (Claude Code, Codex CLI, pi, OpenClaw, Hermes Agent): Felo OpenAPI anbinden, damit Agenten das Live-Web durchsuchen, ganze Seiten lesen, X und YouTube verfolgen, Kontext merken und echte Ergebnisse liefern – alles mit einem API-Key.
Felo AI Search kostenlos testen → | Kostenlosen Felo OpenAPI-Key für Agenten holen →
Dieser Beitrag ist auch in folgenden Sprachen verfügbar: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.