Diskriminative KI: Entscheidungsmodelle, Beispiele und Anwendungsfälle

Erfahren Sie, wie diskriminative KI und Entscheidungsmodelle Eingaben klassifizieren, weiterleiten und bewerten, worin sie sich von generativer KI unterscheiden und wo Entwickler sie einsetzen können.
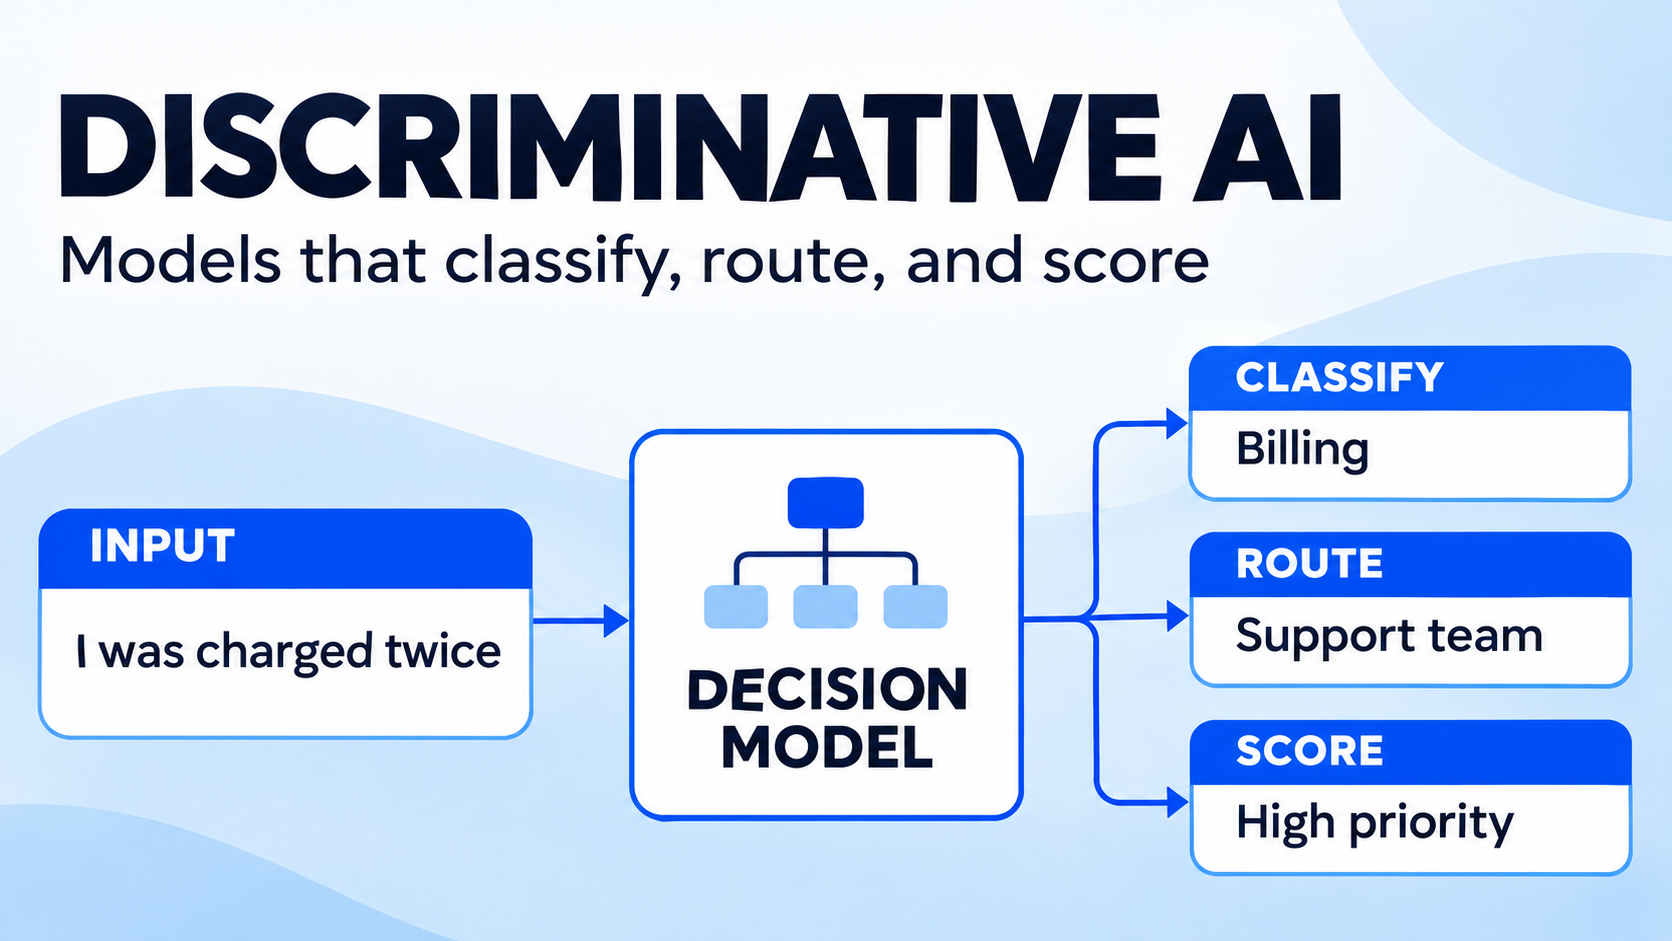
Eine Supportanfrage geht ein: „Mir wurde der Betrag doppelt berechnet und ich benötige eine Rückerstattung.“ Ihre Anwendung benötigt nicht zwingend einen Absatz von einem KI-Modell. Zunächst braucht sie möglicherweise eine Entscheidung: Soll dieses Ticket an die Buchhaltung, den technischen Support oder den Vertrieb gehen?
Diskriminative KI ist darauf ausgelegt, aus einer Eingabe ein Label, einen Score oder ein anderes Ziel vorherzusagen. Eine neuere Gruppe von Entscheidungsmodellen bringt dieses Konzept in Entwickler-APIs ein: Ein Modell erhält Kontext und eine klar definierte Frage und liefert eine strukturierte Entscheidung oder Wahrscheinlichkeiten zurück, die Software nutzen kann. Dieser Leitfaden erklärt, wie diese Modelle funktionieren, wie sie sich neben generativer KI einsetzen lassen und wie ihre Leistung bewertet werden kann.
Was ist diskriminative KI?
Diskriminative KI sagt etwas über eine Eingabe voraus. Ein Spamfilter erkennt, ob eine E-Mail Spam ist; ein Klassifikator ordnet ein Supportticket einem Team zu; ein Risikomodell schätzt die Wahrscheinlichkeit eines bestimmten Ereignisses.
Im maschinellen Lernen lernen diskriminative Modelle häufig eine Zuordnung von der Eingabe x zu einem Ziel y oder schätzen die bedingte Wahrscheinlichkeit P(y | x). Das Ziel kann eine Klasse, ein numerischer Wert oder eine andere strukturierte Ausgabe sein. Logistische Regression, Support Vector Machines und viele neuronale Klassifikatoren sind Beispiele für diskriminative Ansätze. Nicht jedes diskriminative Modell liefert eine Wahrscheinlichkeit, und nicht jeder numerische Score ist gut kalibriert.
Die zugrunde liegende Idee existiert bereits vor den heutigen KI-Assistenten. Neu ist die Verfügbarkeit universell einsetzbarer Entscheidungs-APIs, die Aufgabenbeschreibungen und Antwortoptionen in natürlicher Sprache entgegennehmen. Dadurch können Entwickler dieselbe Schnittstelle für zahlreiche Klassifizierungs- und Bewertungsaufgaben nutzen.
Was ist ein KI-Entscheidungsmodell?
In der aktuellen API-Landschaft bezeichnet ein Entscheidungsmodell in der Regel ein Modell oder einen Dienst, der begrenzte Fragen zu einer bereitgestellten Eingabe beantwortet. Anstatt eine freie Antwort zu formulieren, liefert es ein typisiertes Ergebnis wie:
- Ja/Nein-Wahrscheinlichkeit: Wie wahrscheinlich enthält diese Nachricht eine Rückerstattungsanfrage?
- Auswahl: Welche Abteilung soll dieses Ticket erhalten?
- Score: Wo liegt diese Antwort innerhalb eines festgelegten Qualitätsrasters?
Ein Entscheidungsmodell könnte beispielsweise ein Ticket als Abrechnungsproblem klassifizieren und Wahrscheinlichkeitswerte für jede Abteilung zurückgeben. Ihre Anwendung kann diese Ergebnisse nutzen, um das Ticket weiterzuleiten, zusätzliche Informationen anzufordern oder es einer menschlichen Prüfstelle vorzulegen.
TypeSafe bezeichnet seine Jev-Modellfamilie als „System One“-Modelle. Liquid AI beschreibt sein d1-Entscheidungsmodell als Modell, das Text und Bilder entgegennimmt und Wahrscheinlichkeiten ohne die Generierung von Ausgabetokens zurückgibt. Das Google-Codelab zu diskriminativen Modellen zeigt den Einsatz eines Entscheidungsmodells zusammen mit einem generativen Modell innerhalb einer Anwendung.
Die Begriffe hängen zusammen, sind aber nicht austauschbar. Diskriminatives Modellieren ist ein umfassendes Konzept des maschinellen Lernens; ein Entscheidungsmodell ist ein Produkt oder eine Schnittstelle für klar abgegrenzte Entscheidungen. Ein generatives Modell kann auf entsprechende Anweisungen hin ebenfalls Text klassifizieren, auch wenn sein zugrunde liegender Generierungsprozess und sein Antwortformat anders aufgebaut sind.
Diskriminative KI vs. generative KI
| Diskriminative KI | Generative KI | |
|---|---|---|
| Typische Frage | „Welche Kategorie passt zu dieser Eingabe?“ | „Welche Antwort oder welcher Inhalt soll erstellt werden?“ |
| Häufige Ausgabe | Label, Vorhersage, Score oder Wahrscheinlichkeit | Text, Code, Bild, Audio oder andere generierte Inhalte |
| Beispielaufgabe | Ein Kundenticket weiterleiten | Eine Antwort an den Kunden formulieren |
| Zu untersuchende Stärke | Konsistente, klar abgegrenzte Entscheidungen und nutzbare Scores | Flexible Synthese, Erklärungen und Inhaltserstellung |
| Zentrale Evaluierungskriterien | Klassifizierungsfehler, Kalibrierung und Schwellenwerte | Genauigkeit, Befolgung von Anweisungen, Sicherheit und Nutzen |
Die Abgrenzung bedeutet nicht, dass ein Modell nur eine bestimmte Aufgabe erfüllen kann. Ein LLM kann JSON-Labels zurückgeben, und ein Entscheidungssystem kann ein generatives Modell innerhalb eines größeren Workflows einsetzen. Der praktische Unterschied liegt darin, wofür die jeweilige Komponente optimiert und vorgesehen ist. Eine strukturierte API-Antwort allein beweist weder die Kalibrierung ihrer Wahrscheinlichkeiten noch den diskriminativen Charakter des zugrunde liegenden Modells.
Betrachten wir das Rückerstattungsticket. Ein Entscheidungsmodell könnte das Problem als Abrechnungsangelegenheit erkennen und die Dringlichkeit einschätzen. Anschließend könnte ein generatives Modell eine einfühlsame Antwort auf Grundlage der geltenden Rückerstattungsrichtlinien formulieren. Bevor die Anwendung eine Aktion ausführt, sollte sie weiterhin Richtlinien, Berechtigungen und erforderliche menschliche Freigaben prüfen.
Wie Entscheidungsmodelle in einer Anwendung funktionieren
Das genaue Schema unterscheidet sich je nach Anbieter. Eine typische Entscheidungsanfrage enthält jedoch drei Bestandteile:
- Zustand: Die zu bewertenden Informationen, beispielsweise der Text eines Tickets oder ein Bild.
- Frage und Kriterien: Die zu treffende Entscheidung sowie Beschreibungen der zulässigen Antworten oder Bewertungsstufen.
- Typisierte Antwort: Ein Label, ein Score oder eine Wahrscheinlichkeitsverteilung, die an die Anwendung zurückgegeben wird.
Ein Beispiel:
State: "I was charged twice for my subscription."
Question: Which team should handle this request?
Options: billing, technical support, sales
Illustrative result: billing
Dies ist ein konzeptionelles Beispiel und keine tatsächliche API-Antwort. Je nach Endpunkt kann das Modell auch Konfidenzwerte oder Wahrscheinlichkeiten liefern. Beachten Sie die Dokumentation des jeweiligen Modells und der API, anstatt davon auszugehen, dass alle Anbieter dasselbe Anfrageformat verwenden oder dieselben Modalitäten unterstützen.
Was bedeuten Wahrscheinlichkeitswerte?
Eine vorhergesagte Wahrscheinlichkeit ist nur dann nützlich, wenn Sie ihre Zuverlässigkeit kennen. Wenn ein System vielen ähnlichen Vorhersagen den Wert 0,8 zuweist, sollte ein gut kalibriertes System innerhalb dieser Gruppe in etwa 80 % der Fälle richtig liegen. Ein einzelner Wert von 0,8 garantiert jedoch keine korrekte Einzelentscheidung.
Prüfen Sie die Kalibrierung anhand Ihrer eigenen Daten, insbesondere nach Änderungen an Modellen, Labels, Sprachen oder Eingabequellen. Sie können Schwellenwerte festlegen, um Fälle mit geringer Konfidenz zur Prüfung weiterzuleiten. Wählen Sie diese Schwellenwerte anhand der Kosten falsch positiver und falsch negativer Ergebnisse. Eine Warteschlange zur Betrugsprüfung erfordert andere Regeln als eine harmlose Inhaltsempfehlung.
Beispiele und Anwendungsfälle für diskriminative KI
Klassifizierung und Weiterleitung von Supporttickets
Ein Entscheidungsmodell kann eingehende Nachrichten den Bereichen Abrechnung, technischer Support oder Kontoverwaltung zuordnen. Ergänzen Sie einen Pfad „Sonstiges“ oder „Prüfung erforderlich“ für mehrdeutige Anfragen und testen Sie Nachrichten mit mehreren Anliegen. Bewerten Sie die Fehlerrate für jede Kategorie und nicht nur die Gesamtgenauigkeit: Ein Modell, das dringende Beschwerden zur Abrechnung übersieht, kann bei einem Datensatz mit überwiegend routinemäßigen Fragen dennoch gute Ergebnisse erzielen.
Inhaltsmoderation
Ein Moderationsworkflow kann prüfen, ob ein Inhalt unter eine festgelegte Richtlinienkategorie fällt. Geben Sie dem Modell klare Kriterien und Beispiele, bewerten Sie Grenzfälle und leiten Sie unsichere oder folgenreiche Fälle an geschulte Prüfer weiter. Ein Entscheidungs-Score ist eine Eingabe für Ihren Richtlinienprozess und kein Beweis dafür, dass ein Inhalt gegen eine Regel verstößt.
Routing von LLMs und Agenten
Vor dem Aufruf eines LLM kann eine Anwendung eine Anfrage nach Thema, Komplexität oder erforderlicher Modalität klassifizieren. Eine Routing-Komponente kann anschließend einen Workflow auswählen oder zusätzliche Informationen anfordern. Testen Sie das Routing zusammen mit dem nachgelagerten System: Ein kostengünstiger erster Schritt ist nicht hilfreich, wenn er schwierige Anfragen regelmäßig in den falschen Prozess leitet.
Triage von Dokumenten und Bildern
Ein multimodales Entscheidungsmodell kann klassifizieren, ob ein Bild oder Dokument zu einer vordefinierten Kategorie gehört, beispielsweise Rechnung, Quittung oder Support-Screenshot. Prüfen Sie, ob der konkrete Endpunkt das benötigte Eingabeformat und die gewünschte Bildverarbeitung unterstützt. Klassifizierung ist nicht dasselbe wie das Extrahieren sämtlicher Felder aus einem Dokument. Prüfen Sie daher, ob das ausgewählte Modell und die API beide Aufgaben unterstützen.
Bewertung anhand eines Kriterienrasters
Ein Modell kann eine Antwort anhand einer abgestuften Skala einordnen. Mögliche Beschreibungen sind beispielsweise „Wichtige Belege fehlen“, „Teilweise belegt“ und „Vollständig belegt“. Prüfen Sie, ob menschliche Prüfer mit den Labels übereinstimmen und ob das Modell ähnliche Antworten konsistent bewertet. Stellen Sie Bewertungen anhand eines Kriterienrasters ohne Validierung nicht als objektive Messwerte dar.
Verfügbare Entscheidungsmodelle im Felo-Modellkatalog
Der Felo-Modellkatalog enthält einen Ausgabefilter Decisions. Die folgenden Beispiele waren am 2. November 2026 aufgeführt:
| Katalogeintrag | Beschriebener Anwendungsbereich | Im Katalog angegebene Eingaben |
|---|---|---|
| TypeSafe Jev 1.14 | Routing, Klassifizierung und Moderation | Text und Bild; die Bildunterstützung wird im Eintrag als experimentell bezeichnet |
| LiquidAI d1.1 | Ja/Nein-, Auswahl- und Bewertungsentscheidungen | Text und Bild |
| Baseten Joey 1 | Klassifizierung und Routing | Text und Bild |
| Perplexity Decider Flash V1.2 | Klassifizierung, Routing und Bewertung | Text und Bild |
Diese Beschreibungen geben den Kataloginhalt wieder. Sie stellen keine unabhängigen Leistungstests dar und sind keine Empfehlung für ein bestimmtes Modell. Verfügbarkeit, Funktionsumfang, Kontextlimits und Preise können sich ändern. Prüfen Sie vor der Entwicklung den aktuellen Eintrag und die Dokumentation des Endpunkts. Dies gilt besonders für experimentelle und multimodale Funktionen. Ein Modelleinstieg im Katalog belegt nicht, dass sämtliche nativen API-Funktionen eines Anbieters über jede Plattform verfügbar sind.
Wie Sie ein KI-Entscheidungsmodell bewerten
Beginnen Sie mit einer klar abgegrenzten Entscheidung und einer Auswahl repräsentativer Beispiele mit verlässlichen Labels. Berücksichtigen Sie schwierige Fälle, seltene Kategorien, fehlenden Kontext und Beispiele, bei denen ein Mensch übernehmen sollte. Vergleichen Sie das Modell anschließend mit einer einfachen Baseline, einem vorhandenen Klassifikator oder einem LLM mit strukturierter Ausgabe.
Messen Sie mehr als nur die Genauigkeit:
- Precision und Recall: Welche Fehler sind relevant und wie häufig treten sie für jede Klasse auf?
- Kalibrierung: Stimmen die vorhergesagten Wahrscheinlichkeiten bei Gruppen von Fällen mit den beobachteten Ergebnissen überein?
- Abdeckung: Welcher Anteil der Anfragen kann beim gewählten Schwellenwert automatisiert bearbeitet werden?
- Latenz und Zuverlässigkeit: Erfüllt der vollständige API-Aufruf Ihre Produktionsanforderungen?
- Kosten: Wie hoch sind die Kosten pro nützlicher Entscheidung, einschließlich erneuter Versuche, mehrerer Fragen, Bildverarbeitung und menschlicher Prüfung?
- Robustheit: Bleibt die Leistung bei verschiedenen Sprachen, Formaten, unbekannten Beispielen und verändertem Anfrageaufkommen stabil?
Verwenden Sie nach der Anpassung von Labels und Schwellenwerten einen separaten Testsatz. Protokollieren Sie in der Produktion geeignete Ergebnisse, prüfen Sie Abweichungen und bewerten Sie das Modell erneut, wenn sich Modellversion, Richtlinien oder Eingabeverteilung ändern. Sorgen Sie bei Entscheidungen mit erheblichen Folgen für eine wirksame menschliche Aufsicht und prüfen Sie die geltenden Anforderungen.
Häufig gestellte Fragen
Ist diskriminative KI dasselbe wie ein Entscheidungsmodell?
Nicht genau. Diskriminative KI bezeichnet einen umfassenden Ansatz zur Vorhersage eines Ziels aus einer Eingabe. Entscheidungsmodelle sind eine neuere Produktkategorie mit Schwerpunkt auf begrenzten Ausgaben wie Auswahlmöglichkeiten, Scores und Wahrscheinlichkeiten. Einige Entscheidungsmodelle verwenden diskriminative Techniken, doch die Begriffe beschreiben nicht dasselbe.
Kann ein LLM Inhalte klassifizieren oder Entscheidungen treffen?
Ja. Ein generatives LLM kann durch entsprechende Anweisungen Inhalte klassifizieren oder strukturierte Ausgaben zurückgeben. Ob ein spezialisiertes Entscheidungsmodell eine bessere, schnellere oder kostengünstigere Leistung erbringt, hängt von der Aufgabe, dem Modell, dem Anbieter und der Evaluierungsmethode ab. Testen Sie beide Ansätze anhand Ihrer eigenen Beispiele.
Sind die Wahrscheinlichkeiten von Entscheidungsmodellen immer korrekt?
Nein. Ein Modell kann Wahrscheinlichkeiten ausgeben, die für einen bestimmten Datensatz oder eine bestimmte Untergruppe schlecht kalibriert sind. Messen Sie die Kalibrierung und die Folgen möglicher Fehler, bevor Sie Schwellenwerte zur Automatisierung eines Workflows einsetzen.
Wann sollte ich stattdessen generative KI verwenden?
Verwenden Sie ein generatives Modell, wenn eine Aufgabe das Formulieren, Erklären, Zusammenführen oder Erstellen offener Inhalte erfordert. Bei vielen Anwendungen arbeiten ein Entscheidungsmodell und ein generatives Modell zusammen: Das eine leitet weiter oder klassifiziert, während das andere die Antwort erstellt.
Diskriminative KI bietet Entwicklern eine Möglichkeit, explizite und messbare Entscheidungen in einen Workflow einzubinden. Beginnen Sie mit einer klar abgegrenzten Aufgabe, testen Sie die relevanten Fehler und legen Sie anhand der Ergebnisse fest, welcher Automatisierungsgrad sinnvoll ist.
Entscheidungsmodelle im Felo-Katalog entdecken →
Dieser Beitrag ist auch in folgenden Sprachen verfügbar: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.