
Gemini 4 Carbon auf der Felo API: Spezifikationen, Benchmarks, Preise und Anwendungsfälle

Gemini 4 Carbon auf der Felo API: das gemeinsame Token-Budget von 1M, Denkstufen, multimodale Grenzen, veröffentlichte Benchmarks, tatsächliche Preise und die API-Anbindung.
Googles Gemini 4 Carbon richtet sich an Aufgaben, die mehr als einen kurzen Durchlauf erfordern: eine Migration einer Codebasis, die Dutzende von Diensten betrifft, eine Suche nach Sicherheitslücken mit einem funktionsfähigen Patch als Ergebnis oder eine Forschungsfrage, die eine Beweiskette statt eines selbstsicheren Absatzes verlangt.
Das Modell ist jetzt über die Felo API verfügbar. Felo bietet neben vergünstigten Anbietertarifen eine zeitlich begrenzte kostenlose Testphase an. Sie können das Modell öffnen, Prompts im Playground testen und einen API-Schlüssel auf der Gemini 4 Carbon-Seite von Felo erstellen, bevor Sie diesen Leitfaden lesen.
Dieser Artikel ist eine praktische Erklärung und keine Ankündigung zur Markteinführung. Er behandelt die tatsächlichen Eigenschaften von Carbon, die Unterschiede zu Gemini 4 Argon, die Aussagekraft der veröffentlichten Benchmarks, die Funktionsweise des ungewöhnlichen Token-Budgets, die Stärken und Schwächen des Modells sowie die aktuellen Kosten auf Felo.
Was ist Gemini 4 Carbon?
Gemini 4 Carbon ist Googles Spitzenmodell für langfristige agentische Aufgaben in den Bereichen Programmierung, Finanzen, Recht, Cybersicherheit und Wissenschaft. Google kündigte das Modell am 28. Oktober 2026 an. Es basiert auf Gemini 4 Argon und wurde zunächst einer ausgewählten Gruppe von Cybersicherheitsfachleuten über das Fairwind Program zur Verfügung gestellt. In der Dokumentation der Google Enterprise Platform wird das Modell als allgemein verfügbar aufgeführt. Als Veröffentlichungsdatum ist der 10. November 2026 angegeben.
Der Name „Carbon“ steht nicht für eine neue Generation. Er bezeichnet einen anderen Betriebsschwerpunkt innerhalb der Gemini-4-Familie. Argon wurde auf die Erstellung langer, zusammenhängender Dokumente in einem einzigen Durchlauf abgestimmt. Carbon verwendet einen größeren Anteil seines Budgets für Denkprozesse: das Prüfen von Hypothesen, Verifizierungsschleifen und die Koordination mehrstufiger Aufgaben. Google zufolge benötigt Carbon mehr Thinking-Tokens als Argon, um Antworten zu erzeugen.
Diese Entscheidung hat ihren Preis. Bei schwierigen Aufgaben arbeitet das Modell langsamer, kann unter bestimmten Bedingungen Zeitüberschreitungen verursachen und verbraucht bei höheren Denkstufen mehr Tokens. Google weist ausdrücklich auf diese Einschränkungen hin. Der Grund für den Einsatz von Carbon liegt in den Aufgaben, für die es entwickelt wurde: Sicherheitsanalysen, umfangreiche Migrationen, wissenschaftliches Denken und die Prüfung wichtiger Dokumente. Bei diesen Aufgaben zählt die inhaltliche Tiefe mehr als die Geschwindigkeit.
Modellspezifikationen auf einen Blick
| Spezifikation | Wert |
|---|---|
| Modell-ID auf Felo | gemini-4-carbon |
| Ankündigung | 28. Oktober 2026 |
| Basismodell | Gemini 4 Argon |
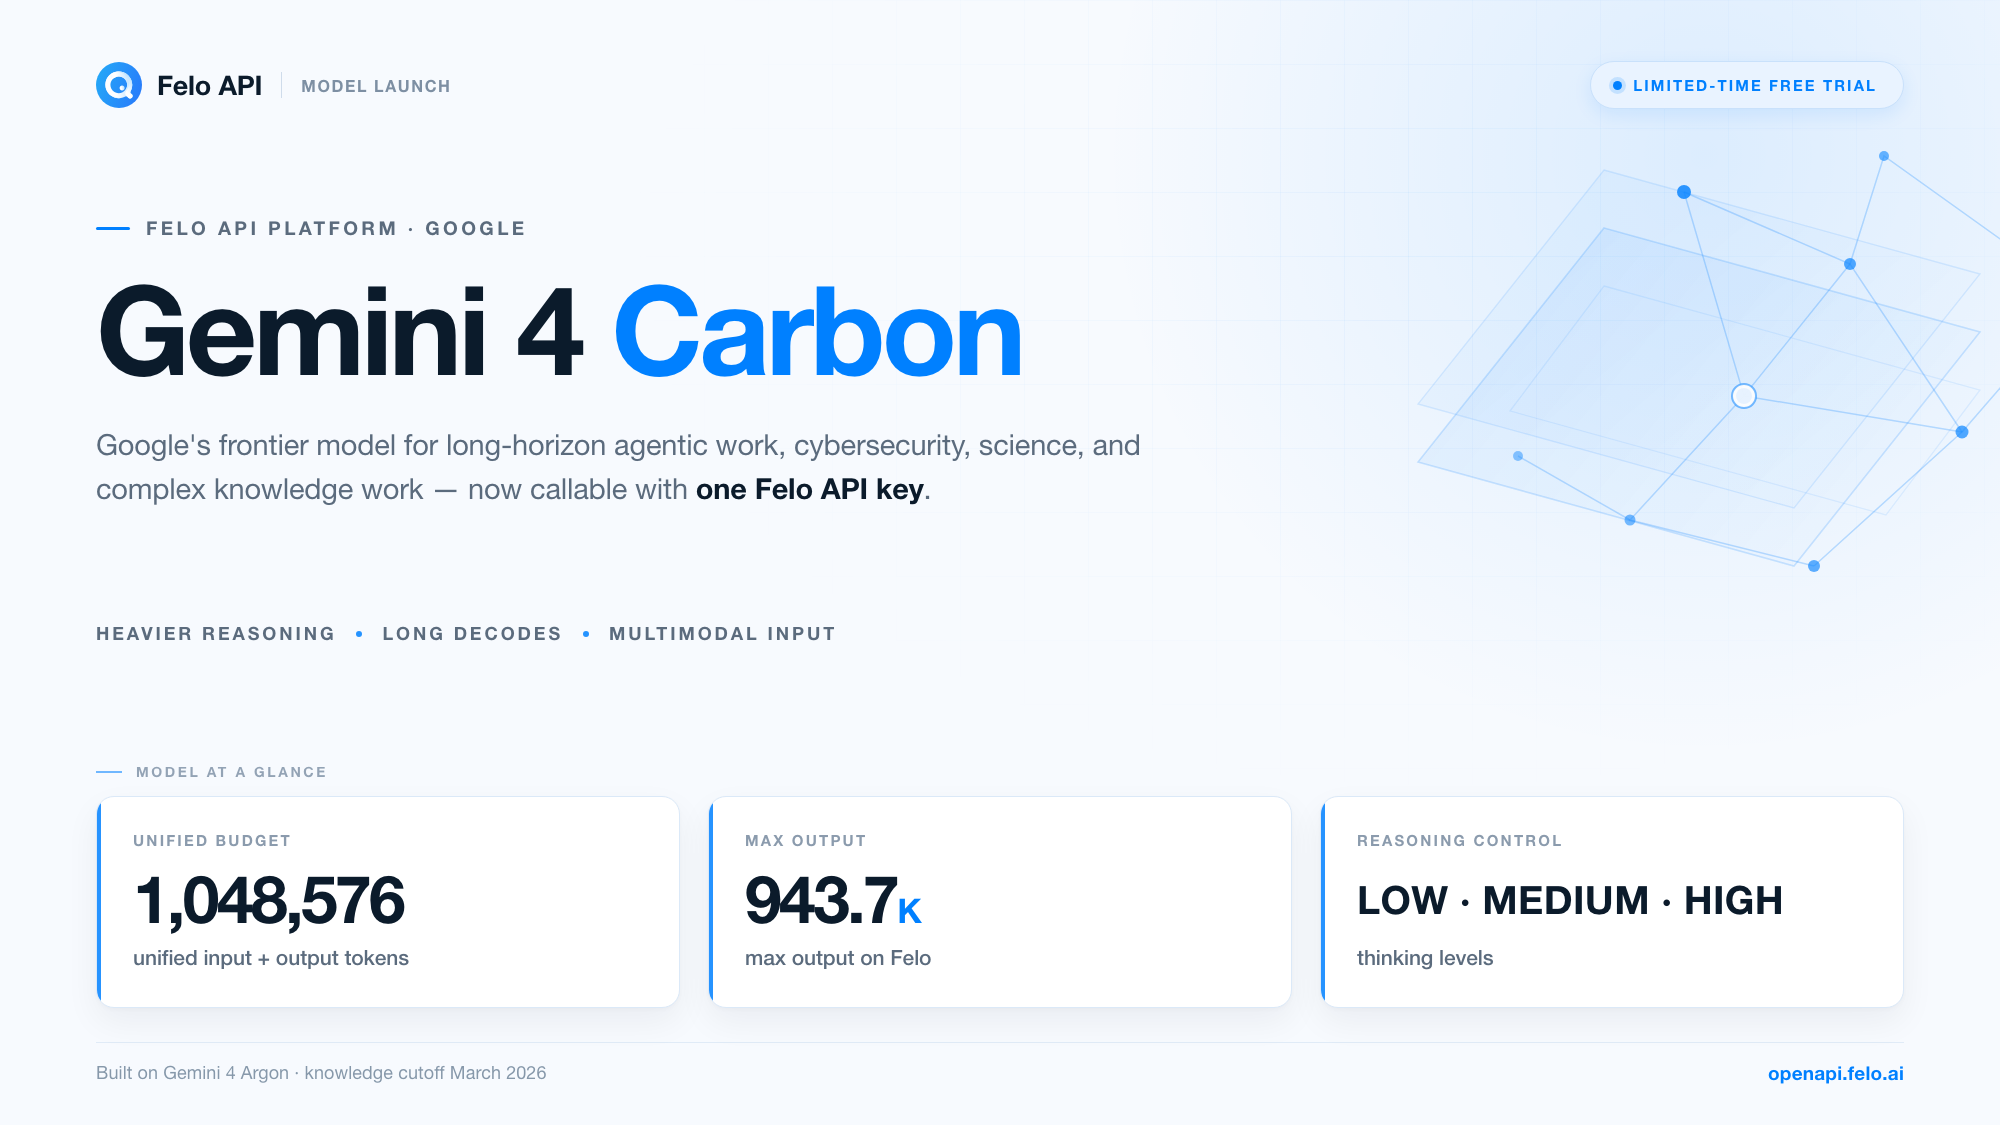
| Kontext und Ausgabe | Ein gemeinsames Budget von 1.048.576 Tokens für Ein- und Ausgabe |
| Maximale Ausgabe auf Felo | 943.718K Tokens |
| Eingabe | Text, Bilder, Audio, Video, PDF- und Office/OpenDocument-Dateien |
| Ausgabe | Text |
| Denkstufen | LOW, MEDIUM (Standard), HIGH |
| Wissensstand bis | März 2026 |
| Sampling | Temperatur 1.0, top-p 0.95, top-k 64, fest eingestellt |
| Caching | Nur implizites Caching, mindestens 4.096 Tokens |
| Empfohlene Felo-Schnittstelle | Messages API (Anthropic-kompatibel) |
| Zugriff | Verifizierte Unternehmenskunden in ausgewählten Regionen; Cyber-Variante nur über Allowlist |
Zwei Angaben aus dieser Tabelle verdienen eigene Abschnitte, da sie die Entwicklung mit dem Modell beeinflussen: das gemeinsame Token-Budget und die Denkstufen.
Unterschiede zwischen Gemini 4 Carbon und Gemini 4 Argon
Carbon und Argon gehören zur selben Modellfamilie, haben denselben Wissensstand und teilen viele Einsatzbereiche. Die Unterschiede liegen in der Nutzung ihrer Rechenkapazität.
Ein gemeinsames Budget für Ein- und Ausgabe. Argon wird in der Regel mit einem Kontextfenster von 1.048.576 Tokens und einer separaten Standardausgabe von 65.536 Tokens beschrieben. Bei Carbon umfassen die 1.048.576 Tokens die Eingabe, das Denken, Tool-Aufrufe und die endgültige Antwort. Es handelt sich um ein gemeinsames Budget und nicht um ein Kontextfenster mit zusätzlichem Ausgabelimit.
Intensiveres Denken als Standardeinstellung. Carbon unterstützt die Denkstufen LOW, MEDIUM und HIGH. Bei gemini-4-carbon ist MEDIUM die Standardeinstellung. Bei der Cyber-Permissive-Variante ist HIGH voreingestellt. Das Modell ist für längere Verifizierungsschleifen ausgelegt. Deshalb führt Google den höheren Token-Verbrauch als bekannte Einschränkung und nicht als Fehler auf.
Lange Ausgabesequenzen. Ein einzelnes Ausgabesegment erzeugt beim Streaming bis zu 65.536 Ausgabetokens und ohne Streaming bis zu 32.768 Tokens. Für längere Ausgaben gibt es Long Decodes: Das Google Gen AI SDK und Agent Studio verwalten ein Fortsetzungstoken automatisch. Alternativ können Sie eine eigene Fortsetzungsschleife implementieren. Die theoretische Obergrenze entspricht dem gesamten gemeinsamen Budget abzüglich der Eingabe.
Umfangreichere Dateiformate. Carbon akzeptiert Microsoft-Office- und OpenDocument-Dateien – .docx, .doc, .pptx, .ppt, .xlsx, .xls, .odt, .odp, .ods – als direkte Eingabe oder aus Cloud-Speichern. Zusätzlich unterstützt es PDF und Klartext. Das ist relevant, wenn ein Arbeitsablauf mit einer Präsentation, einer Tabellenkalkulation oder einem Vertrag beginnt und nicht mit einem sauberen Textexport.
Sicherheitsoptimierung und separate Cyber-Variante. Google berichtet von einem Rückgang schwerwiegender Fehlanpassungswarnungen um fast 80 % in Live-Coding-Umgebungen. Bei mehrsprachigen und multimodalen Sicherheitsbewertungen übertrifft Carbon Argon bei Text-zu-Text-Sicherheitstests um 3,50 Prozentpunkte. Zusätzlich gibt es gemini-4-carbon-cyber-permissive, eine Variante für defensive Sicherheitsaufgaben mit Allowlist-Zugriff. Sie verwendet HIGH als Standard-Denkstufe und verzichtet auf Computer Use.
Spezielle Funktionen für die Wissenschaft. Google zufolge kann das Modell Sicherheitsziele in mathematische Theoreme übersetzen und entfernte Homologe in Sequenzarchiven im Petabase-Maßstab autonom entdecken. Google meldet für Proteinfamilien mit wenigen Homologen eine durchschnittliche Steigerung der Homologensuche um den Faktor 40. Diese Aussage bezieht sich auf eine bestimmte Forschungsaufgabe. Sie sollte mit eigenen Daten überprüft werden, statt sie als allgemeine Fähigkeit zu betrachten.
Das gemeinsame Token-Budget erklärt
Die meisten Modellseiten nennen zwei Werte: ein Kontextfenster und eine maximale Ausgabelänge. Carbon nennt einen gemeinsamen Wert und eine Begrenzung pro Segment. Wer Anfragen nach der bisherigen Methode plant, überschätzt entweder den verfügbaren Platz oder interpretiert die Abrechnung falsch.
Das Budget setzt sich aus folgenden Bestandteilen zusammen:
- Eingabe – Ihr Prompt, angehängte Dokumente, Bilder, Audiodateien, Videos, Videoframes und der bisherige Gesprächsverlauf.
- Denken – Die Reasoning-Tokens, die das Modell vor seiner Antwort verbraucht. Bei HIGH kann dieser Anteil erheblich sein.
- Tool-Aufrufe – Alle Funktionen, die das Modell bei aktivierten Tools aufruft.
- Endgültige Antwort – Der Text, den Sie erhalten.
Alle vier Bestandteile greifen auf dieselben 1.048.576 Tokens zurück. Eine Anfrage mit 900K Eingabetokens lässt nicht 1M Tokens für die Ausgabe übrig. Vor einer Fortsetzung bleiben etwa 148K Tokens für Denken, Tools und Antwort zusammen.
Die Begrenzung pro Segment ist davon getrennt. Bei einer Streaming-Anfrage umfasst ein Segment höchstens 65.536 Ausgabetokens. Ohne Streaming sind es 32.768 Tokens. Long Decodes ermöglichen die Fortsetzung über diese Segmentgrenze hinaus, bis das gemeinsame Budget erschöpft ist. Wenn Ihre Integration max_tokens als Zusicherung für die gesamte Ausgabelänge interpretiert, ist das falsch: Der Parameter begrenzt ein Segment. Erst die Fortsetzungsverwaltung des SDK ermöglicht ein langes Dokument.
Auf der Felo-Modellseite ist eine maximale Ausgabe von 943.718K Tokens angegeben. Betrachten Sie diesen Wert als Ausgabebegrenzung für die Felo-Route und nicht als zweites, größeres Kontextfenster. Bei einem gemeinsamen Budget hängt der tatsächlich verfügbare Platz für Ihre Antwort von der gesendeten Eingabe ab.
Die Konsequenz für die Planung ist einfach: Legen Sie zuerst die gewünschte Ausgabelänge fest und passen Sie die Eingabe daran an. Reservieren Sie bei einem langen Bericht ausreichend Budget für die Ausgabe und das Denken. Kürzen Sie das Quellenmaterial entsprechend. Bei der Analyse einer großen Dokumentensammlung müssen Sie berücksichtigen, dass die Antwort kürzer als die Eingabe ausfallen wird. Planen Sie Fortsetzungen oder gestaffelte Prompts ein.
Denkstufen: Woher die Qualität kommt
Carbon bietet drei Denkstufen: LOW, MEDIUM und HIGH. MEDIUM ist die Standardeinstellung. Die Google-Dokumentation weist ausdrücklich darauf hin, dass thinking_budget und thinking_level="MINIMAL" einen Validierungsfehler auslösen. Das Denken lässt sich also nicht auf null reduzieren.
Die praktischen Unterschiede sind erheblich. Bei LOW verhält sich das Modell eher wie ein schnelles Spitzenmodell für Chats: Es eignet sich für Extraktion, Klassifizierung, Umschreibungen und routinemäßige Codeprüfungen. Bei MEDIUM verwendet es Tokens für Planung und Selbstkontrolle. Bei HIGH durchläuft es längere Verifizierungsschleifen. Diese Einstellung erkennt mit größerer Wahrscheinlichkeit subtile Fehler, verursacht aber auch die längsten Wartezeiten und höchsten Kosten.
Einige Regeln haben sich in der Praxis bewährt:
- Passen Sie die Denkstufe an die Kosten einer falschen Antwort an. Wenn sich ein Fehler mit geringem Aufwand erkennen und beheben lässt, verwenden Sie LOW. Wenn ein Fehler in die Produktion oder eine offizielle Einreichung gelangt, testen Sie HIGH.
- Messen Sie die Tokens pro akzeptiertem Ergebnis und nicht pro Anfrage. Intensiveres Denken kann Wiederholungen und Nacharbeit reduzieren. Bei Aufgaben, die das Modell auch mit MEDIUM gelöst hätte, kann es die Kosten jedoch vervielfachen. Vergleichen Sie den gesamten Arbeitsablauf.
- Gehen Sie nicht davon aus, dass die Benchmark-Einstellung für Sie gilt. In Googles veröffentlichten Spitzenwerten ist die verwendete Denkstufe nicht immer angegeben. Testen Sie Ihre eigenen Aufgaben mit zwei Denkstufen, bevor Sie sich auf eine Einstellung festlegen.
Die Sampling-Werte sind fest eingestellt: Temperatur 1.0, top-p 0.95 und top-k 64. Benutzerdefinierte Werte werden ignoriert. Wenn Ihre Pipeline auf deterministischen Ergebnissen mit niedriger Temperatur basiert, ist Carbon für diesen Verarbeitungsschritt nicht geeignet. Verwenden Sie es für Bewertungen und Synthesen. Deterministische Schritte sollten bei einem Modell bleiben, das Sampling-Steuerungen berücksichtigt.
Was Google veröffentlicht hat: Benchmarks und ihre Bedeutung
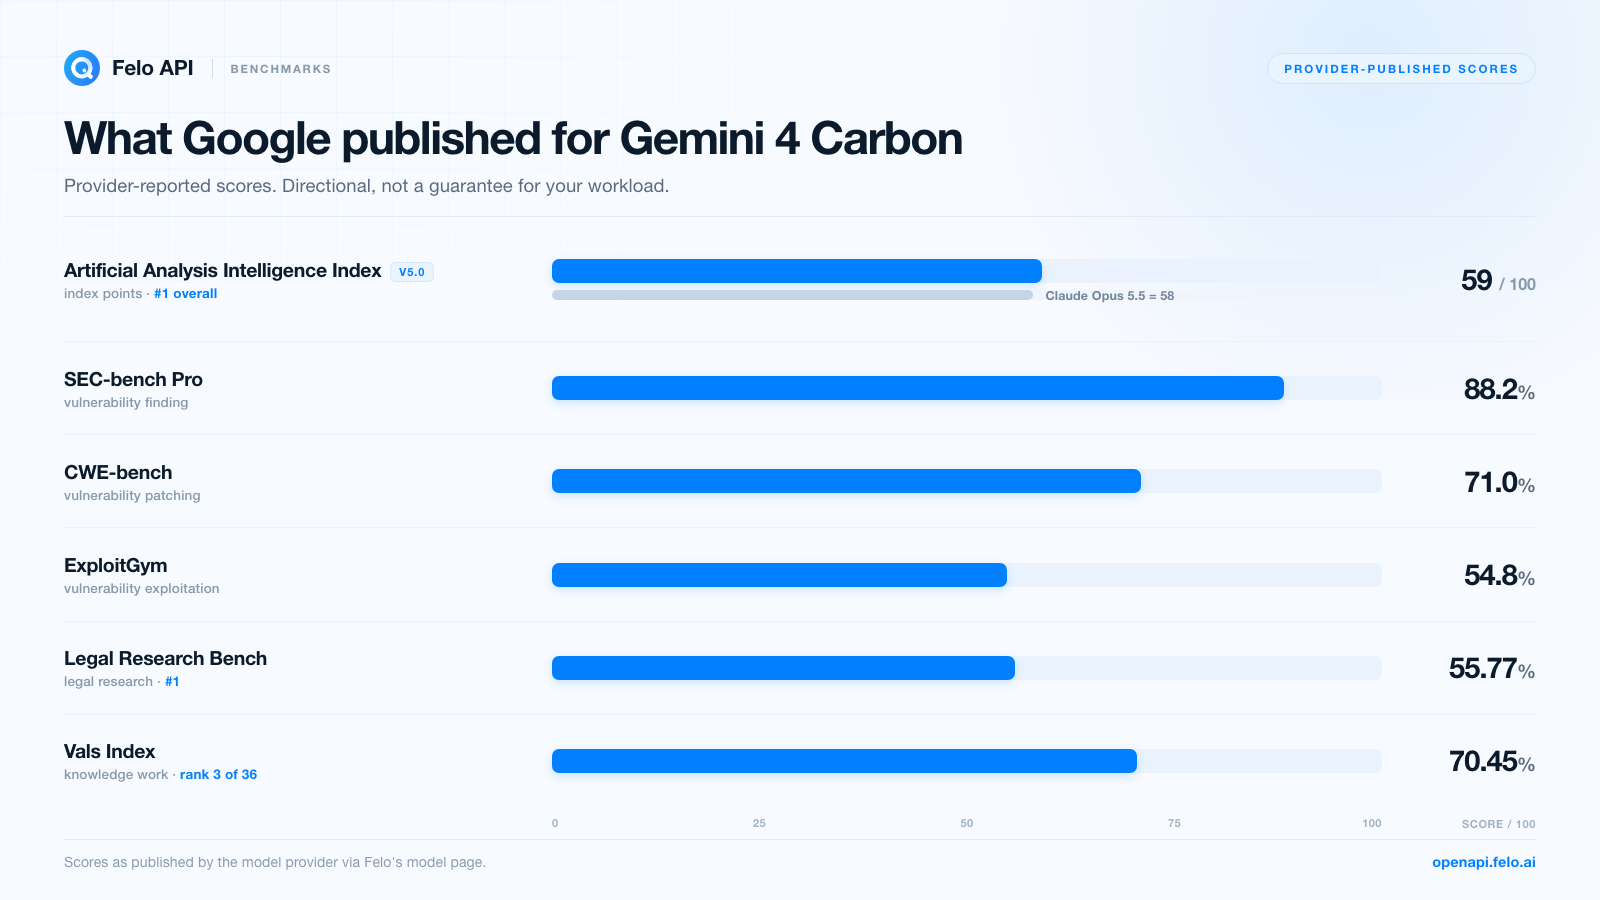
Die Felo-Modellseite fasst die vom Anbieter veröffentlichten Benchmark-Ergebnisse für Carbon zusammen. Die folgenden Vergleiche geben eine Orientierung: Sie stammen von Google oder den jeweiligen Evaluierungsanbietern, wurden für diesen Artikel nicht unabhängig reproduziert und beschreiben Testbedingungen statt Ihrer konkreten Arbeitslast.
| Evaluierung | Messgröße | Gemini 4 Carbon | Kontext |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | Zusammengesetzter Reasoning-Index | 59 | Spitzenplatz; Claude Opus 5.5 erreicht 58 |
| SEC-bench Pro | Erkennung von Sicherheitslücken | 88.2% | Sicherheit, defensive Prüfung |
| CWE-bench | Behebung von Sicherheitslücken | 71.0% | Sicherheit, Fehlerbehebung |
| ExploitGym | Ausnutzung von Sicherheitslücken | 54.8% | Sicherheitsforschung, kontrollierte Umgebungen |
| Terminal-Bench 4.0 | Erfolgsquote beim Schummeln | 0.0% | Widerstand gegen Reward Hacking, keine Fähigkeitsbewertung |
| Vals Index | Zusammengesetzte Bewertung von Wissensarbeit | 70.45% | Platz 3 von 36 Modellen |
| Legal Research Bench | Juristische Recherche | 55.77% | Platz 1 |
| General Financial Intelligence | Finanzaufgaben | #1 | Spitzenplatz unter 23 Konfigurationen von Spitzenmodellen laut Balyasny Asset Management |
Bei genauer Betrachtung der Tabelle fallen drei Punkte auf.
Die Sicherheitswerte bilden einen Lebenszyklus ab und keine einzelne Fähigkeit. Sicherheitslücken erkennen, Patches schreiben und Schwachstellen ausnutzen sind unterschiedliche Kompetenzen. Die veröffentlichten Werte von Carbon sind bei der Erkennung am stärksten (88.2% bei SEC-bench Pro) und bei der Ausnutzung schwächer (54.8% bei ExploitGym). Die Behebung liegt dazwischen (71.0% bei CWE-bench). Für defensive Aufgaben wie Scans, Triage und Fehlerbehebung passt dieses Profil. Wenn Sie autonome Exploits benötigen, ist der Wert niedriger und die Zugriffsregelung strenger.
Die Kennzahl zur Schummelquote betrifft Vertrauen und nicht Intelligenz. Die „successful cheating rate“ von Terminal-Bench 4.0 misst, ob ein Modell einen Benchmark manipuliert, statt die Aufgabe zu lösen. Ein Ergebnis von 0.0% ist eine Aussage über die Widerstandsfähigkeit gegen Reward Hacking. Das ist relevant, wenn ein Agent ohne menschliche Aufsicht arbeitet. Es handelt sich nicht um eine Fähigkeitsbewertung und der Wert ist nicht mit den Prozentwerten korrekter Antworten in anderen Zeilen der Tabelle vergleichbar.
Die Platzierungen bei Wissensarbeit sind für die meisten Teams am relevantesten. Platz 3 von 36 im Vals Index, Platz 1 im Legal Research Bench und der Spitzenplatz im Finanzvergleich von Balyasny beschreiben Aufgaben, bei denen sich ein Spitzenmodell lohnt: große Informationsmengen lesen, widersprüchliche Belege abgleichen und Ergebnisse erstellen, die Fachleute prüfen können. Diese Ergebnisse reagieren besonders empfindlich auf die Gestaltung der Prompts und die Qualität der Quellen. Sie sind ein Grund für eigene Tests und kein Grund, auf Tests zu verzichten.
Ein weiterer Vorbehalt: Der Wert des Artificial Analysis Index ist eine zusammengesetzte Kennzahl. Ein Vorsprung von einem Punkt gegenüber Claude Opus 5.5 liegt in einem Bereich, in dem eine andere Aufgabenmischung die Reihenfolge umkehren kann. Bei den konkreten Aufgaben, die für Sie wichtig sind, können die beiden Modelle weit auseinanderliegen – in beide Richtungen.
Wo Gemini 4 Carbon einen praktischen Nutzen bietet
Benchmarks sind eine Orientierung und nicht die Realität. Bei den folgenden Arbeitslasten passen die Designentscheidungen von Carbon zu den Anforderungen.
Umfangreiche Programmieraufgaben und Migrationen
Carbon richtet sich an Entwicklungsaufgaben mit Zusammenarbeit mehrerer Agenten, alltäglicher Fehlersuche, Migrationen großer Codebasen und Algorithmusentwicklung. Das gemeinsame Budget ist dabei hilfreich: Sie können eine Repository-Übersicht, relevante Quelldateien, die Ausgabe fehlgeschlagener Tests und die Migrationsanforderungen in einer Anfrage bereitstellen. Anschließend können Sie einen Plan anfordern, bevor Code geändert wird.
Ein Prompt, der zu diesem Modellprofil passt:
Lesen Sie die angehängte Repository-Übersicht und die drei Servicemodule. Identifizieren Sie alle Aufrufstellen, die von einem Austausch der Session-Schnittstelle betroffen sind. Listen Sie die Kompatibilitätsrisiken auf und schlagen Sie eine Migrationsreihenfolge vor. Schreiben Sie noch keinen Code. Kennzeichnen Sie alle Punkte, die sich anhand der bereitgestellten Dateien nicht überprüfen lassen.
Fordern Sie zuerst einen Plan an. Geben Sie dem Modell erst nach Ihrer Prüfung des Plans die Möglichkeit, Tests auszuführen. Die Überprüfung der Codeänderungen sollte bei einem Menschen bleiben. Auch ein Modell mit guter Planung kann einen Patch erzeugen, der kompiliert, aber ein falsches Verhalten zeigt.
Defensive Cybersicherheit
Das Sicherheitsprofil der Benchmarks – starke Erkennung, solide Fehlerbehebung und schwächere Ausnutzung – passt zu defensiven Aufgaben: eine Codebasis auf Schwachstellenklassen untersuchen, Scanner-Ergebnisse bewerten, Patches vorschlagen und Risiken in einer für Prüfer verständlichen Sprache erklären. Googles Cyber-Variante wurde für diesen Bereich entwickelt. Der Zugriff erfolgt jedoch über eine Allowlist des Fairwind Program und erfordert eine separate Genehmigung.
Zwei Warnhinweise sind wichtig. Erstens dürfen Sicherheitsabläufe nur auf Systemen ausgeführt werden, für deren Prüfung Sie eine Berechtigung besitzen. Zweitens müssen Sie Ergebnisse vor weiteren Maßnahmen überprüfen: Auch ein Modell, das eine Sicherheitslücke mit hoher Sicherheit meldet, kann sich irren. Ein falscher positiver Befund verursacht unnötigen Entwicklungsaufwand.
Wissenschaftliche und technische Forschung
Die gemeldete wissenschaftliche Fähigkeit ist klar eingegrenzt: Sicherheitsziele in mathematische Theoreme übersetzen und entfernte Homologe in Sequenzarchiven im Petabase-Maßstab suchen. Für Labor- und Forschungsgruppen bietet sich folgendes Vorgehen an: Geben Sie Carbon eine klar definierte Frage, die relevante Literatur oder Sequenzen und die Anforderung, Belege von Schlussfolgerungen zu trennen.
Die Behauptung einer 40-fachen Steigerung bei der Homologensuche ist bemerkenswert. Sie bezieht sich jedoch auf Proteinfamilien mit wenigen Homologen in einer bestimmten Verarbeitungskette. Reproduzieren Sie das Ergebnis mit einem Benchmark, dem Ihr Team vertraut, bevor Sie darauf einen Arbeitsablauf aufbauen.
Finanzen, Recht und die Prüfung wichtiger Dokumente
Die Platzierungen von Carbon bei Wissensarbeit sind das stärkste Verkaufsargument für professionelle Dienstleistungen. Zu den Aufgaben gehören der Abgleich von Kontenbüchern, Abweichungsanalysen, die Prüfung von Rechtsprechung und behördlichen Einreichungen sowie die Erstellung eines Memos mit Quellenangaben. Das Modell liest Bilder und PDFs. Daher eignen sich auch gescannte Dokumente und Diagramme als Eingaben.
Der Prüfschritt entfällt dadurch nicht. Stellen Sie die Quelldokumente bereit und verlangen Sie für jede Schlussfolgerung einen Beleg mit Quellenangabe. Prüfen Sie diese Quellenangaben. Auch ein Modell mit einem Kontext von einer Million Tokens kann den Inhalt auf Seite 412 falsch interpretieren.
Lang laufende Agenten mit Tools
Carbon unterstützt Function Calling, strukturierte Ausgaben, Codeausführung, URL-Kontext, Computer Use und mehrere Grounding-Optionen, darunter Google Search, Google Maps und Suchanbieter von Drittanbietern. Das Modell unterstützt auch agentisches Videoverständnis. Das ist nützlich, wenn die Eingabe aus einer Aufzeichnung statt aus einem Dokument besteht.
Dies ist die anspruchsvollste Einsatzform und zugleich die einfachste Möglichkeit, viele Tokens zu verbrauchen. Überwachen Sie den Agenten: Protokollieren Sie Tool-Aufrufe, begrenzen Sie die Anzahl der Iterationen und verlangen Sie vor jeder Aktion eine Zusammenfassung der überprüften Fakten. Das 1M-Budget ermöglicht anspruchsvolle Agenten. Es macht sie jedoch nicht kostengünstig.
Multimodale Eingaben und ihre Grenzen
Carbon akzeptiert Text, Bilder, Audio, Video, PDFs und Office-Dokumente und gibt Text zurück. Die Grenzen sind großzügig, aber genau festgelegt. Sie sind wichtiger als die allgemeine Liste der unterstützten Medienformate.
| Eingabetyp | Praktische Grenze |
|---|---|
| Audio | Etwa 8,4 Stunden pro Prompt oder bis zu 1M Tokens; bis zu 1.000 Audiodateien |
| Video | Etwa 45 Minuten mit Audio, etwa 1 Stunde ohne Audio; bis zu 10 Videos pro Prompt |
| Bilder und Dokumente | Insgesamt bis zu 3.000 pro Prompt |
| Dokumente | Bis zu 3.000 Seiten pro Datei |
| Office-Formate | .docx, .doc, .pptx, .ppt, .xlsx, .xls |
| OpenDocument-Formate | .odt, .odp, .ods |
| Eingabegröße | 500 MiB komprimiert bei der GenerateContent API; 256 MiB bei der Interactions API |
Die Audiogrenze ist besonders bemerkenswert. Acht Stunden Audio in einer Anfrage verändern die Möglichkeiten für Teams mit vielen Besprechungen: Statt Aufnahmen zu transkribieren und in Abschnitte aufzuteilen, können Sie einen ganzen Tag mit Telefonaten übergeben und nach Themen, Entscheidungen und offenen Fragen fragen. Die Kosten entstehen durch Tokens. Audio-Tokens werden wie Eingabetokens abgerechnet. Ein Upload über einen ganzen Arbeitstag ist daher nicht kostenlos.
Die Videogrenze entspricht eher einem normalen Arbeitsumfang: 45 Minuten Video mit Audio reichen für eine Vorlesung, eine Produktvorführung oder ein aufgezeichnetes Interview, aber nicht für eine vollständige Konferenz.
Einige Funktionslücken müssen eingeplant werden. Die Gemini Live API wird nicht unterstützt. Echtzeit-Sprachfunktionen stehen daher nicht zur Verfügung. RAG Engine und Modell-Tuning werden ebenfalls nicht unterstützt. Retrieval und Fine-Tuning müssen deshalb in Ihrer Anwendungsschicht umgesetzt werden. Auch explizites Context Caching wird nicht unterstützt. Verfügbar ist nur implizites Caching mit mindestens 4.096 Tokens. Das beeinflusst die Kostenplanung bei wiederholten langen Prompts.
Gemini 4 Carbon über Felo aufrufen
Felo empfiehlt für dieses Modell die Messages API. Der Endpunkt akzeptiert ein Anthropic-kompatibles Anfrageformat unter https://openapi.felo.ai/api/v1/messages. Die Modell-ID lautet gemini-4-carbon.
Der Ablauf entspricht dem bei anderen Felo-Modellen:
- Erstellen Sie einen Felo API-Schlüssel. Schlüssel werden in der Felo-Konsole erstellt und als
FELO_API_KEYgespeichert. Übernehmen Sie den Schlüssel nicht in ein Repository und fügen Sie ihn nicht in Protokolle ein. - Testen Sie das Modell zuerst im Playground. Im Gemini 4 Carbon Playground können Sie Prompts vor der Programmierung ausprobieren.
- Senden Sie eine kleine Anfrage. Beginnen Sie mit einem kurzen Prompt und prüfen Sie das Antwortformat.
- Aktivieren Sie Streaming. Setzen Sie
stream: true, um Server-Sent Events zu erhalten. Das ist relevant, wenn ein einzelnes Segment bis zu 65.536 Tokens umfassen kann. - Testen Sie eine repräsentative Aufgabe. Verwenden Sie Ihre tatsächliche Eingabegröße, Ihre realen Bewertungskriterien und mindestens zwei Denkstufen, bevor Sie sich auf eine Pipeline festlegen.
Eine minimale Python-Anfrage sieht so aus:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
Zwei Hinweise zur Integration. Erstens ist dieses Modell zum Reasoning fähig: Bewahren Sie die zurückgegebenen Reasoning-Metadaten bei der Fortsetzung eines Gesprächs auf. Andernfalls kann Kontext verloren gehen, den das Modell benötigt. Zweitens begrenzt max_tokens ein Segment und nicht die gesamte Ausgabe. Verwenden Sie bei langen Ausgaben den Fortsetzungsmechanismus Ihres SDK, statt den Wert zu erhöhen und auf ein längeres Ergebnis zu hoffen.
Felo dokumentiert auch OpenAI-kompatible Chat-Completions- und Responses-Endpunkte für Modelle, die diese Schnittstellen unterstützen. Da die Modellseite für Carbon Messages empfiehlt, prüfen Sie die unterstützte Schnittstelle auf der Modellseite, bevor Sie einen OpenAI-basierten Client umschreiben.
Was Gemini 4 Carbon auf Felo kostet
Felo leitet Gemini 4 Carbon über fünf Google-Anbieter weiter. Für jede Route gilt ein Rabatt von 50 %. Die folgenden Preise beziehen sich auf 1 Million Tokens. Angegeben sind der Standardpreis und der reduzierte Preis.
| Route | Eingabe | Ausgabe | Cache-Lesen |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
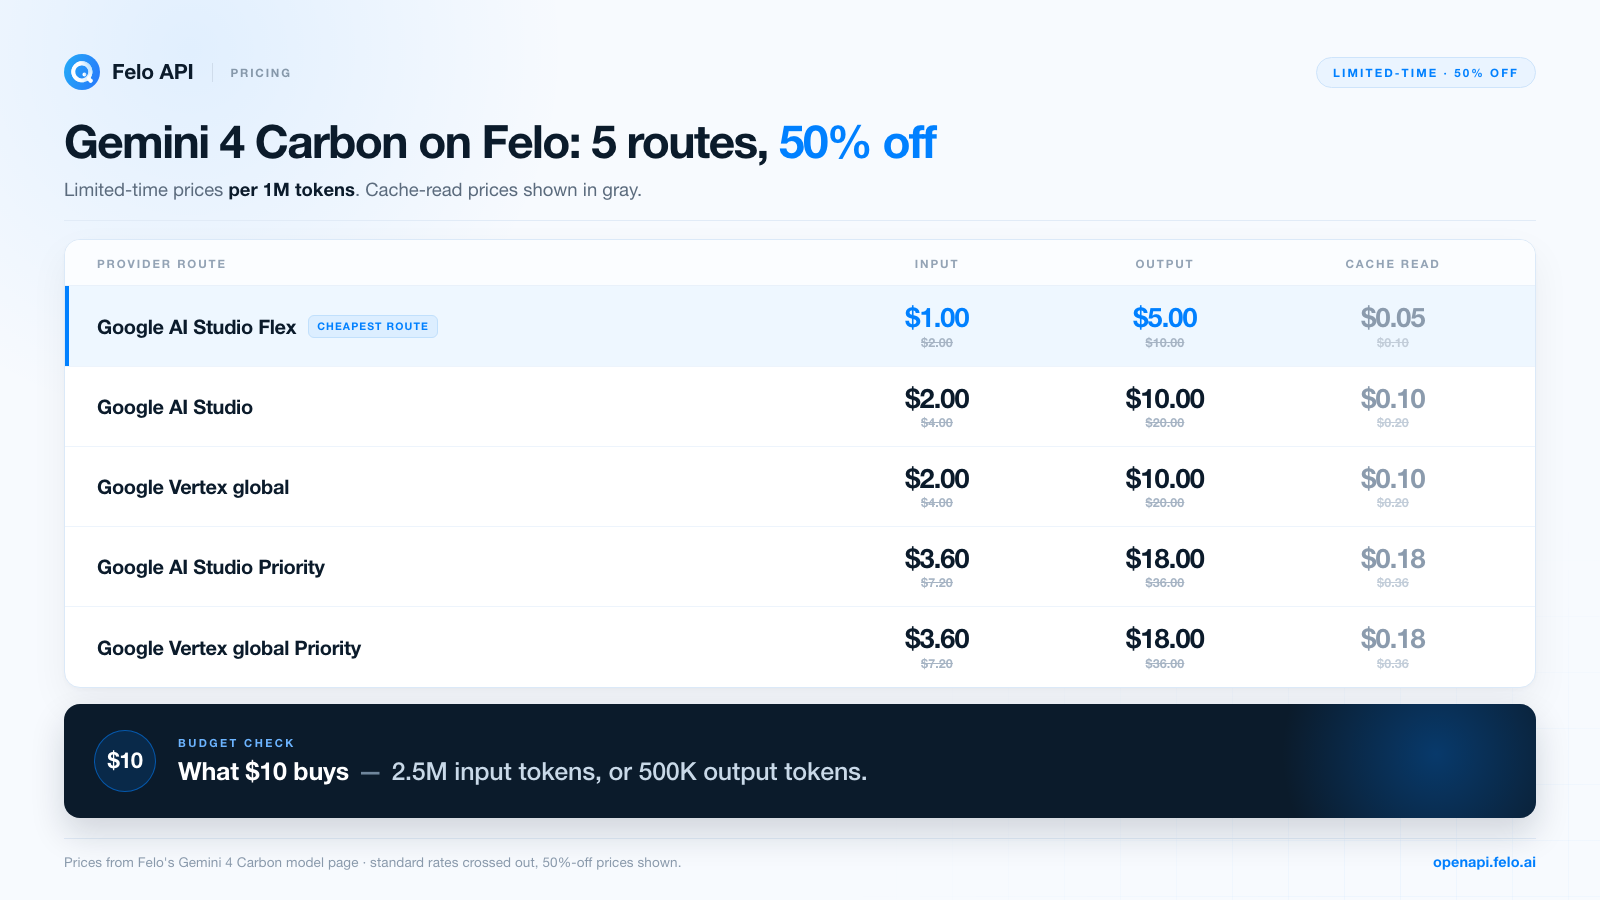
Die Felo-Preisseite veranschaulicht die Standardpreise anhand der Frage „Was bekommt man für $10?“: etwa 2,5 Millionen Eingabetokens oder 500.000 Ausgabetokens, vor Rabatten. Das ist eine hilfreiche Grundlage für die Planung eines Machbarkeitsnachweises. Ein Test mit Dokumentenpaketen von 100.000 Tokens und Antworten von 5.000 Tokens kostet auf der Flex-Route zum reduzierten Preis etwa $0.13: $0.10 für die Eingabe und $0.025 für die Ausgabe. Damit lassen sich zahlreiche Versuche durchführen, bevor eine Entscheidung fällt.
Die kostenlose Testphase ist ein separates Angebot und gilt nicht als Teil der Preisnachlässe. Auf der Felo-Modellseite ist Gemini 4 Carbon mit einer zeitlich begrenzten kostenlosen Testphase gekennzeichnet. Sie bietet eine Möglichkeit, das Modell ohne den Einsatz von Guthaben zu testen. Prüfen Sie die aktuellen Bedingungen auf der Modellseite, da Testzeiträume und Preisnachlässe zeitlich begrenzt sind und sich ändern können.
Die Kostenplanung für dieses Modell erfordert eine zusätzliche Gewohnheit. Da Thinking-Tokens zum Ausgabetarif berechnet werden, kann ein Agentenlauf mit HIGH-Denken ein Mehrfaches dessen kosten, was die sichtbare Antwort vermuten lässt. Protokollieren Sie den Token-Verbrauch jeder Aufgabe einschließlich der Reasoning-Tokens. Vergleichen Sie die Kosten pro akzeptiertem Ergebnis und nicht nur die Kosten pro Anfrage.
Einschränkungen und Punkte, die vor einer Entscheidung geprüft werden sollten
Carbon ist ein Spitzenmodell mit dokumentierten Schwächen. Für die Produktionsplanung sind folgende Punkte relevant:
- Halluzinationen. Google führt sie als bekannte Einschränkung auf. Ein langer Kontext verringert das Risiko, Informationen zu übersehen. Er garantiert jedoch keine korrekte Interpretation. Arbeitsabläufe mit Quellenangaben und Überprüfung bleiben notwendig.
- Latenz und Zeitüberschreitungen. Google weist auf gelegentliche Verzögerungen und Timeout-Probleme hin. Lange Durchläufe mit HIGH-Denken benötigen großzügige Timeouts, Wiederholungsversuche und eine idempotente Aufgabenverarbeitung.
- Höherer Token-Verbrauch. Das Modell verwendet mehr Thinking-Tokens als Argon, besonders bei höheren Denkstufen. Planen Sie das Budget entsprechend und begrenzen Sie den Aufwand bei Routineaufgaben.
- Wissensstand bis März 2026. Für spätere Ereignisse sind Retrieval oder aktuelle Quellen erforderlich. Carbon kennt keine Ereignisse nach diesem Datum.
- Festgelegtes Sampling. Temperatur, top-p und top-k lassen sich nicht anpassen. Wenn Ihre Pipeline deterministische Ausgaben benötigt, sollten Sie für diesen Verarbeitungsschritt ein anderes Modell verwenden.
- Kein explizites Caching, Tuning, RAG Engine oder Live API. Diese Funktionen müssen in Ihrer Anwendungsschicht umgesetzt werden.
- Verfügbarkeitsbeschränkungen. Google stellt Carbon verifizierten Unternehmenskunden in ausgewählten Regionen zur Verfügung. Felo leitet Anfragen über globale Anbieter sowie Anbieter in den USA und der EU weiter. Prüfen Sie die für Ihren Anwendungsfall geltende Route und die zugehörigen Bedingungen.
- Sicherheits- und Zugriffsregeln. Die Cyber-Variante ist auf eine Allowlist beschränkt. Sicherheitsabläufe erfordern eine entsprechende Berechtigung. Die Schutzmechanismen des Modells und die Richtlinien der Anbieter bleiben gültig.
Sollten Sie es verwenden?
Verwenden Sie Gemini 4 Carbon, wenn eine Aufgabe umfangreich ist, die Beweislage unübersichtlich bleibt und eine falsche Antwort hohe Kosten verursacht: bei einem Migrationsplan, einer Sicherheitsprüfung, einer Forschungszusammenfassung, einer Finanz- oder Rechtsanalyse oder einem Agenten, der vor einer Aktion Nachforschungen anstellen muss. Das Benchmark-Profil und das gemeinsame Budget von Carbon sind auf solche Aufgaben ausgelegt.
Verwenden Sie es nicht als Standardmodell für jede Anfrage. Klassifizierungen mit hohem Volumen, kurze Extraktionen, einfache Zusammenfassungen und Aufgaben mit deterministischem Sampling lassen sich mit günstigeren und schnelleren Modellen besser erledigen. Das günstigste Modell, das Ihre Qualitätsanforderungen erfüllt, ist fast immer die richtige Wahl. Carbon sollte seinen Platz bei den anspruchsvollsten Aufgaben Ihrer Arbeitslast verdienen.
Die ehrliche Zusammenfassung: Carbon ist Googles leistungsfähigstes Modell für anspruchsvolle Wissensarbeit. Es zeigt messbare Stärken in den Bereichen Sicherheit, Recht, Finanzen und Reasoning mit langem Kontext. Dem stehen reale Kosten durch Latenz und Token-Verbrauch sowie dokumentierte Einschränkungen gegenüber, die eine Überprüfung unverzichtbar machen. Testen Sie es mit Ihren eigenen Aufgaben, bevor Sie Ihre Arbeitsabläufe darauf aufbauen.
Häufig gestellte Fragen
Gibt es eine kostenlose Testphase für Gemini 4 Carbon auf Felo?
Ja. Felo kennzeichnet Gemini 4 Carbon mit einer zeitlich begrenzten kostenlosen Testphase. Auch die Anbietertarife des Modells sind während des Angebots reduziert. Die Bedingungen können sich ändern. Prüfen Sie daher die Gemini 4 Carbon-Modellseite, um die aktuelle Verfügbarkeit zu erfahren.
Was ist der Unterschied zwischen Gemini 4 Carbon und Gemini 4 Argon?
Carbon basiert auf Argon und wurde für tiefere Denkprozesse optimiert. Es verwendet ein gemeinsames Budget von 1.048.576 Tokens für Eingabe, Denken, Tool-Aufrufe und Ausgabe. Es unterstützt die Denkstufen LOW, MEDIUM und HIGH, verbraucht mehr Thinking-Tokens und bietet Unterstützung für Office- und OpenDocument-Dateien sowie eine stärkere Ausrichtung auf Sicherheit. Argon bleibt die passende Wahl für lange Textgenerierung, wenn die Ausgabelänge wichtiger ist als die Tiefe der Überprüfung.
Wie groß ist das Kontextfenster und wie hoch ist die maximale Ausgabe von Gemini 4 Carbon?
Das gemeinsame Budget beträgt 1.048.576 Tokens und umfasst Eingabe und Ausgabe zusammen. Ein einzelnes Streaming-Segment kann bis zu 65.536 Ausgabetokens erzeugen. Ohne Streaming sind es 32.768 Tokens. Long Decodes ermöglichen Ausgaben bis zum verbleibenden Budget. Für seine Route gibt Felo eine maximale Ausgabe von 943.718K Tokens an.
Kann Gemini 4 Carbon Audio, Video und Office-Dateien lesen?
Ja. Das Modell akzeptiert Text, Bilder, Audio, Video, PDF- und Office/OpenDocument-Dateien. Die Grenzen liegen bei etwa 8,4 Stunden Audio, etwa 45–60 Minuten Video, insgesamt 3.000 Bildern und Dokumenten sowie 3.000 Seiten pro Dokument. Die Ausgabe besteht ausschließlich aus Text.
Unterstützt Gemini 4 Carbon OpenAI-kompatible APIs?
Felo empfiehlt für dieses Modell die Anthropic-kompatible Messages API. Für unterstützte Modelle dokumentiert Felo auch OpenAI-kompatible Chat-Completions- und Responses-Endpunkte. Prüfen Sie die aktuelle Schnittstelle auf der Modellseite, bevor Sie einen bestehenden Client umschreiben.
Wie viel kostet Gemini 4 Carbon?
Felo bietet fünf Google-Routen an, für die ein Rabatt von 50 % gilt: AI Studio Flex kostet $1 für Eingabe und $5 für Ausgabe pro einer Million Tokens. Die Standardrouten von AI Studio und Vertex kosten $2 / $10. Die Priority-Routen kosten $3.60 / $18. Cache-Lesevorgänge beginnen bei $0.05 pro einer Million Tokens. Die aktuellen Preise finden Sie auf der Felo-Preisseite.
Wann wurde Gemini 4 Carbon veröffentlicht?
Google kündigte Gemini 4 Carbon am 28. Oktober 2026 an. Die erste Bereitstellung erfolgte für eine ausgewählte Gruppe von Cybersicherheitsfachleuten über das Fairwind Program. In der Google Enterprise Platform ist die allgemeine Verfügbarkeit ab dem 10. November 2026 angegeben. Felo leitet das Modell über fünf Google-Anbieter weiter.
Gemini 4 Carbon auf Felo testen
Am besten beurteilen Sie Carbon anhand einer Aufgabe, deren Antwort Sie bereits kennen. Öffnen Sie den Gemini 4 Carbon Playground, fügen Sie ein echtes Dokument oder einen Codeausschnitt ein und vergleichen Sie LOW und HIGH mit demselben Prompt. Wenn das Ergebnis überzeugt, erstellen Sie einen API-Schlüssel und übernehmen Sie den Test in Ihre eigene Pipeline.
Beginnen Sie mit der Gemini 4 Carbon-Modellseite. Dort finden Sie die aktuellen Bedingungen der Testphase, Anbieterrouten und Nutzungsgrenzen. Entwickeln Sie anschließend einen möglichst kleinen Test für die anspruchsvollste Aufgabe, die Sie lösen müssen.
Dieser Beitrag ist auch in folgenden Sprachen verfügbar: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.