MiMo V2.6 Pro jetzt auf Felo OpenAPI: Xiaomis führendes Open-Weights-Modell

Xiaomis MiMo V2.6 Pro, das stärkste Open-Weights-Modell im Artificial Analysis Index, ist auf Felo OpenAPI für $0.43/$0.87 pro Million Token verfügbar.
Xiaomi veröffentlichte MiMo V2.6 Pro am 22. September und platzierte das Modell an der Spitze der Open-Weights-Tabelle: 46 im Artificial Analysis Intelligence Index, vor Kimi K3 und Qwen3.8 Max. Xiaomi lieferte die Gewichte, den technischen Bericht und den Trainingscode mit aus.
Ab heute ist mimo-v2.6-pro auf Felo OpenAPI verfügbar. Der gleiche Schlüssel, den du bereits für Claude-, GPT- und Grok-Routen verwendest. Die gleiche Basis-URL. Nur eine Zeile in deiner Konfiguration ändert sich.
Der Preis neben der Benchmark-Zahl macht dieses Release besonders. Nahezu frontierfähige Reasoning-Leistung für $0.43 pro Million Input-Token und $0.87 pro Million Output-Token verändert, was ein Agenten-Loop leisten kann.
Was Xiaomi tatsächlich geliefert hat
Die Ankündigung wirkt ungewöhnlich offen für einen Flaggschiff-Launch und lässt sich dadurch ehrlich zusammenfassen.
MiMo V2.6 Pro ist Xiaomis Flaggschiff mit Billionen Parametern und aktuell das stärkste Open-Weights-Modell. Xiaomi stellt das klar und benennt selbst den Gegenpunkt: Es besteht weiterhin eine Lücke zu den stärksten Closed-Modellen, Claude Fable 5.1 und GPT-6 Astra. Auf den meisten Agenten-Benchmarks beansprucht Xiaomi Gleichstand mit Claude Opus 5 und GPT-5.6 Sol.
Das ist die eigene Bewertung des Herstellers. Behandle sie wie jede Launch-Tabelle: als Behauptung, nicht als Ergebnis. Doch zwei Aspekte lassen sich bei diesem Release überprüfen, was bei Benchmarks selten möglich ist.
Die Gewichte sind öffentlich. MiMo V2.6 Pro und Flash wurden mit offenen Gewichten, einem technischen Bericht und dem Reinforcement-Learning-Code ausgeliefert. Du kannst selbst hosten, feinjustieren oder verifizieren.
Auch der Trainingslauf war öffentlich. Xiaomi führte die RL-Phase live über etwa sechs Tage durch. Pro und Flash absolvierten jeweils 30 Trainingsschritte und sammelten zusammen fast 750.000 Trajektorien; der Pro-Lauf allein wird mit etwa $2,62 Millionen angegeben. Auf DeepSWE v1.1, einem unabhängigen Software-Engineering-Benchmark mit langer Perspektive, steigerte das Pro-Modell sich von 48,8 auf 65,7.
Zusätzlich zu den Gewichten veröffentlichte Xiaomi über 7.000 Reinforcement-Learning-Task-Umgebungen aus den Bereichen Softwareentwicklung, Schwachstellenreproduktion, wissensintensive Arbeit und Webdesign – das Trainingsmaterial, nicht nur das Ergebnis.
Das Datenblatt
| Spezifikation | MiMo V2.6 Pro |
|---|---|
| Modell-ID | mimo-v2.6-pro |
| Hersteller | Xiaomi |
| Größe | Flaggschiff mit Billionen Parametern |
| Kontextfenster | 1.000.000 Token |
| Maximaler Output | 128.000 Token |
| Input | Text, Bild, Video, Audio |
| Output | Text |
| Fähigkeiten | Reasoning, Tool-Calls, strukturierter Output, Streaming |
| Intelligence Index | 46 (Xiaomi meldet 46,32) |
Zwei Zeilen verdienen Aufmerksamkeit.
Die Input-Seite ist omni-modal. Text, Bilder, Videos und Audio gelangen gemeinsam in denselben Prompt. Die meisten Modelle in dieser Preisklasse lesen Text und vielleicht einen Screenshot. Einen Mitschnitt, eine Bilderserie oder eine Audiospur ohne Transkript einzuspeisen, stellt eine andere Aufgabe dar und war der Schwerpunkt des Trainings.
Das Kontextfenster umfasst eine Million Token. Der Trainingslauf nutzte selbst 1M-Token-Kontext und Xiaomi positionierte das Modell für multimodale, multi-agenten und multi-harness Aufgaben. Fragen zum gesamten Codebase, Dokumentensätze über ein Jahr und lange Agenten-Threads passen ohne Kompression.
Xiaomi zeigte das Modell auch an Aufgaben, die sich nachträglich leicht überprüfen lassen. Es erzeugte eine vollständige Lean-4-Formalisation des Hauptsatzes aus Period Three Implies Chaos, über 6.000 Zeilen Quellcode, deren Beweis der Lean-Kernel ohne unbelegte Platzhalter prüft. Außerdem arbeitete es mit Xiaomis Materialforschern an Kandidaten für Metall-Organische Frameworks zur PFAS-Bindung. Benchmarks lassen sich manipulieren. Ein Beweis, der kompiliert, nicht.
Was Felo OpenAPI hinzufügt
Ein Modell aufzurufen ist einfach. Der Grund, MiMo V2.6 Pro über Felo OpenAPI statt über einen weiteren Anbieter laufen zu lassen, liegt darin, dass das Modell in einen bereits verbundenen Stack integriert wird.
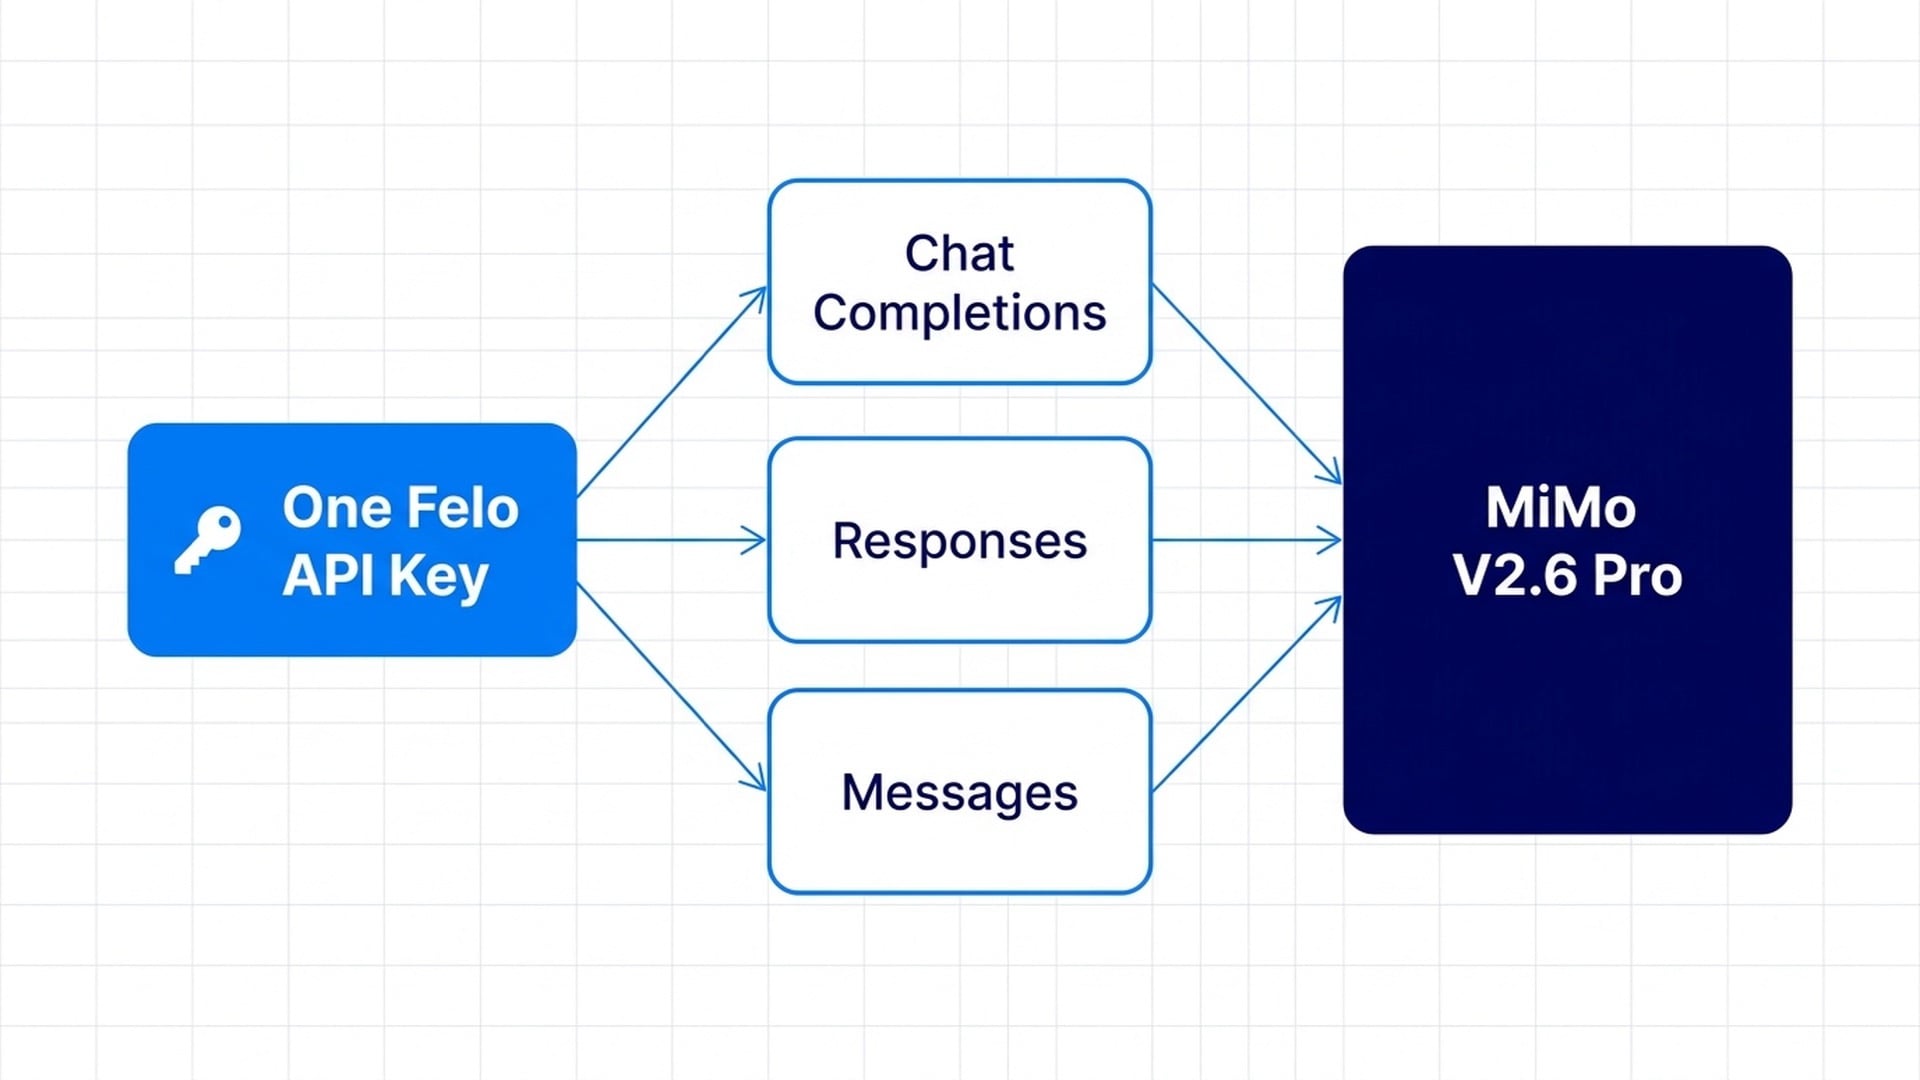
Ein Schlüssel, drei Protokolle. Felo OpenAPI stellt das Modell auf jeder Oberfläche bereit, die dein Client spricht:
| Oberfläche | Endpoint | Verwendung |
|---|---|---|
| Chat Completions | https://openapi.felo.ai/api/v1/chat/completions | OpenAI-kompatible Apps und Agenten |
| Responses | https://openapi.felo.ai/api/v1/responses | Agenten- und Workflow-Anfragen |
| Messages | https://openapi.felo.ai/api/v1/messages | Anthropic-kompatible Clients |
Richte ein bestehendes OpenAI-SDK auf https://openapi.felo.ai/api/v1 oder einen Claude-Client auf https://openapi.felo.ai/api und setze die Modell-ID. Es gibt kein separates Konto, keine zweite Abrechnung und kein anbieter-spezifisches SDK.
Es integriert sich in die Agenten, die du bereits betreibst. Felo OpenAPI listet MiMo V2.6 Pro als kompatibel mit Claude Code und Codex, genauso wie die Claude- und GPT-Routen. Wenn ein Agent heute auf Felo zeigt, genügt eine Konfigurationsänderung.
Das Modell steht nicht allein. Hier trennt sich Gateway von Plattform. Suche, Web-Fetch, X-Suche, YouTube-Untertitel, PPT-Generierung, Mindmaps, LiveDocs-Memory und SuperAgent-Workflows laufen hinter demselben Schlüssel. Ein Modell mit Million-Token-Kontext und omni-modalem Input ist nur dann nützlich, wenn es auch aktuelle Informationen erreichen und Ergebnisse erzeugen kann. Auf Felo gelingt das.
Die Vorgängerversion, mimo-v2.5-pro, ist bereits auf der Plattform. V2.6 ist das Upgrade, und der Wechsel kostet nur eine Änderung.
So sieht das von Anfang bis Ende aus
Ein Wettbewerbsbrief eignet sich als Testfall, weil er alle Fähigkeiten gleichzeitig verlangt. Auf Felo OpenAPI deckt ein Schlüssel den gesamten Ablauf ab:
- Web Fetch zieht drei Preislisten der Konkurrenz als Markdown.
- Search ergänzt Informationen, die auf den Seiten fehlen – Finanzierung, Mitarbeiterzahl, aktuelle Releases.
- MiMo V2.6 Pro liest alles in einem einzigen 1M-Token-Kontext, zusammen mit einem Screenshot jeder Preistabelle, und analysiert Text und Bild gemeinsam statt über eine OCR-Transkription.
- PPT API verwandelt das Fazit in eine Präsentation.
Die Alternative wären vier Anbieter, vier Schlüssel, vier Rechnungen und eine eigene Glue-Schicht. Diese Glue-Schicht ist die Steuer, die dieser Stack entfernt, und meist der Grund, warum ein Agenten-Demo nie zum Produkt wird.
Schnellstart
Drei Schritte von Null zur Antwort.
1. API-Schlüssel holen aus deinem Felo API Platform-Konto und exportieren.
export FELO_API_KEY="YOUR_API_KEY"
2. Erste Anfrage stellen. Die Modell-ID lautet mimo-v2.6-pro.
curl https://openapi.felo.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mimo-v2.6-pro",
    "messages": [
      {"role": "user", "content": "Summarize the tradeoffs between sparse and dense attention."}
    ]
  }'
Oder über das OpenAI SDK, nur die Basis-URL ändern:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FELO_API_KEY"],
    base_url="https://openapi.felo.ai/api/v1",
)

completion = client.chat.completions.create(
    model="mimo-v2.6-pro",
    messages=[{"role": "user", "content": "Explain the tradeoffs between sparse and dense attention."}],
    max_tokens=1024,
)
print(completion.choices[0].message.content)
3. Streaming aktivieren durch Hinzufügen von stream: true.
curl -N https://openapi.felo.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mimo-v2.6-pro",
    "stream": true,
    "messages": [{"role": "user", "content": "Hello"}]
  }'
Ein praktischer Hinweis für Multi-Turn-Arbeit: Dies ist ein Reasoning-Modell. Wenn dein Protokoll oder deine Route Reasoning-Controls bereitstellt, behalte die Reasoning-Metadaten und gib sie weiter, wenn du das Gespräch fortsetzt. Das Weglassen in der Mitte ist der häufigste Grund, warum ein Reasoning-Modell schlechter wirkt als es ist.
Die Kostenrechnung
Hier verdient MiMo V2.6 Pro seinen Platz. Veröffentliche Felo OpenAPI-Tarife pro Million Token:
| Modell | Input / M | Output / M |
|---|---|---|
| GPT-6 Astra | $10.00 | $50.00 |
| Claude Opus 5.5 | $4.00 | $20.00 |
| GPT-6 Sol | $2.00 | $10.00 |
| MiMo V2.6 Pro | $0.43 | $0.87 |
| DeepSeek V4.1 Flash | $0.15 | $0.60 |
| GLM 5.3 Flash | $0.15 | $0.50 |
Das sind die veröffentlichten Tarife von Felo OpenAPI für den gesamten Katalog – fairer Vergleich: gleiche Plattform, gleicher Schlüssel, gleiche Rechnung. Für MiMo V2.6 Pro entspricht der Preis Xiaomis eigener Liste, $0.435 Input und $0.87 Output. Die Route gibt das Modell zum Listenpreis weiter, ohne Aufschlag.
Jetzt die Rechnung für eine realistische Agenten-Arbeitslast: Dein Loop liest einen 200.000-Token-Repository-Ausschnitt, erzeugt 20.000 Token Änderungen und läuft 50-mal am Tag:
- 10M Input-Token pro Tag, 1M Output-Token pro Tag
- Bei GPT-6 Astra: $100 + $50 = $150 pro Tag
- Bei Claude Opus 5.5: $40 + $20 = $60 pro Tag
- Bei MiMo V2.6 Pro: $4.30 + $0.87 = $5.17 pro Tag
Das ist etwa 29-mal günstiger als GPT-6 Astra für die gleiche Arbeit, auf einem Modell, das laut Xiaomi nahe an Claude Opus 5 und GPT-5.6 Sol liegt. Die Behauptung stammt vom Anbieter; der Preis steht fest. Wenn die Behauptung zu zwei Dritteln zutrifft, verändert sich die Wirtschaftlichkeit von Agenten.
Der sekundäre Effekt zählt mehr als die Ersparnis selbst. Wenn ein Loop $5 statt $150 pro Tag kostet, kürzt du den Kontext nicht mehr aus Spargründen. Du wechselst nicht mehr zu einem schwächeren Modell für Routineaufgaben. Du lässt ihn mit größerem Prompt erneut laufen. Die meisten Agenten-Qualitätsprobleme sind verkappte Budgetprobleme.
Wo es passt – und wo nicht
Greife darauf zurück, wenn du multimodales Reasoning über Bilder, Video oder Audio brauchst; Langkontext-Analysen, bei denen das gesamte Dokument sichtbar bleibt; agentische Aufgaben mit hohem Tokenverbrauch; Videoverständnis; oder wenn du ein Open-Weights-Modell willst, dessen Verhalten du prüfen und dessen Gewichte du später selbst hosten kannst.
Greife nicht darauf zurück, wenn du die absolute Spitze beim schwierigsten Reasoning brauchst und Kosten keine Rolle spielen. Xiaomi sagt es selbst: Claude Fable 5.1 und GPT-6 Astra liegen weiterhin vorn. Für eine einzelne hochkritische Aufgabe pro Tag lohnt sich das Frontier-Modell.
Eine Erwartung vor dem Wechsel eines latenzsensitiven Endpunkts: Felo stuft die Latenz dieser Route als deep ein, das Modell analysiert vor der Antwort. Das passt für Analyse und Agentenplanung, aber nicht für Autocomplete oder Echtzeit-Chat, wo eine schnelle Schicht besser geeignet ist.
Kurz gesagt: Das ist das Modell für hohe Qualität ohne hohe Rechnung. Die Rechnung macht den Unterschied.
Häufige Fragen
Ist MiMo V2.6 Pro identisch mit MiMo V2.6 Flash? Nein. Flash ist das günstigere, schnellere Geschwistermodell aus demselben Release und aktuell nicht auf Felo OpenAPI. Pro ist die Flaggschiff-Route.
Welchen Endpoint soll ich aufrufen?
Wenn du bereits ein OpenAI SDK nutzt, verwende Chat Completions unter https://openapi.felo.ai/api/v1/chat/completions. Für Claude-Clients nutze die Anthropic-kompatible Oberfläche unter https://openapi.felo.ai/api. Der Responses-Endpunkt eignet sich für Agenten- und Workflow-Anfragen.
Unterstützt das Modell Tool-Calls und strukturierten Output? Ja. Felo OpenAPI listet Reasoning, Tools, JSON, Streaming und Vision als unterstützte Fähigkeiten für diese Route. Tool-Definitionen folgen dem kompatiblen Schema, sodass bestehender Tool-Call-Code übernommen werden kann.
Kann ich das Modell weiterhin selbst hosten? Das ist der Sinn von Open Weights. Xiaomi veröffentlichte die Gewichte und den technischen Bericht, sodass eine Route über Felo heute keine Bindung für morgen bedeutet.
Wie vergleicht es sich mit den Closed-Flagships? Xiaomis eigene Einordnung ist fair: Vor allen anderen Open-Weights-Modellen, weiterhin hinter Claude Fable 5.1 und GPT-6 Astra, etwa auf Augenhöhe mit Claude Opus 5 und GPT-5.6 Sol auf den meisten Agenten-Benchmarks. Die letzte Spalte zählt: Fähigkeit pro Dollar.
MiMo V2.6 Pro ausprobieren
Hole einen Schlüssel von der Felo API Platform, setze die Basis-URL auf https://openapi.felo.ai/api/v1, stelle das Modell auf mimo-v2.6-pro und starte die Arbeitslast, die du bisher rationiert hast. Die Modellseite enthält das vollständige Datenblatt, aktuelle Preise und Copy-Paste-Beispiele in TypeScript, Python, cURL und Claude Code.
MiMo V2.6 Pro auf Felo OpenAPI entdecken →
Dieser Beitrag ist auch in folgenden Sprachen verfügbar: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.