GPT-6.1 Sol API: Nahezu Astra-Leistung zu geringeren Kosten
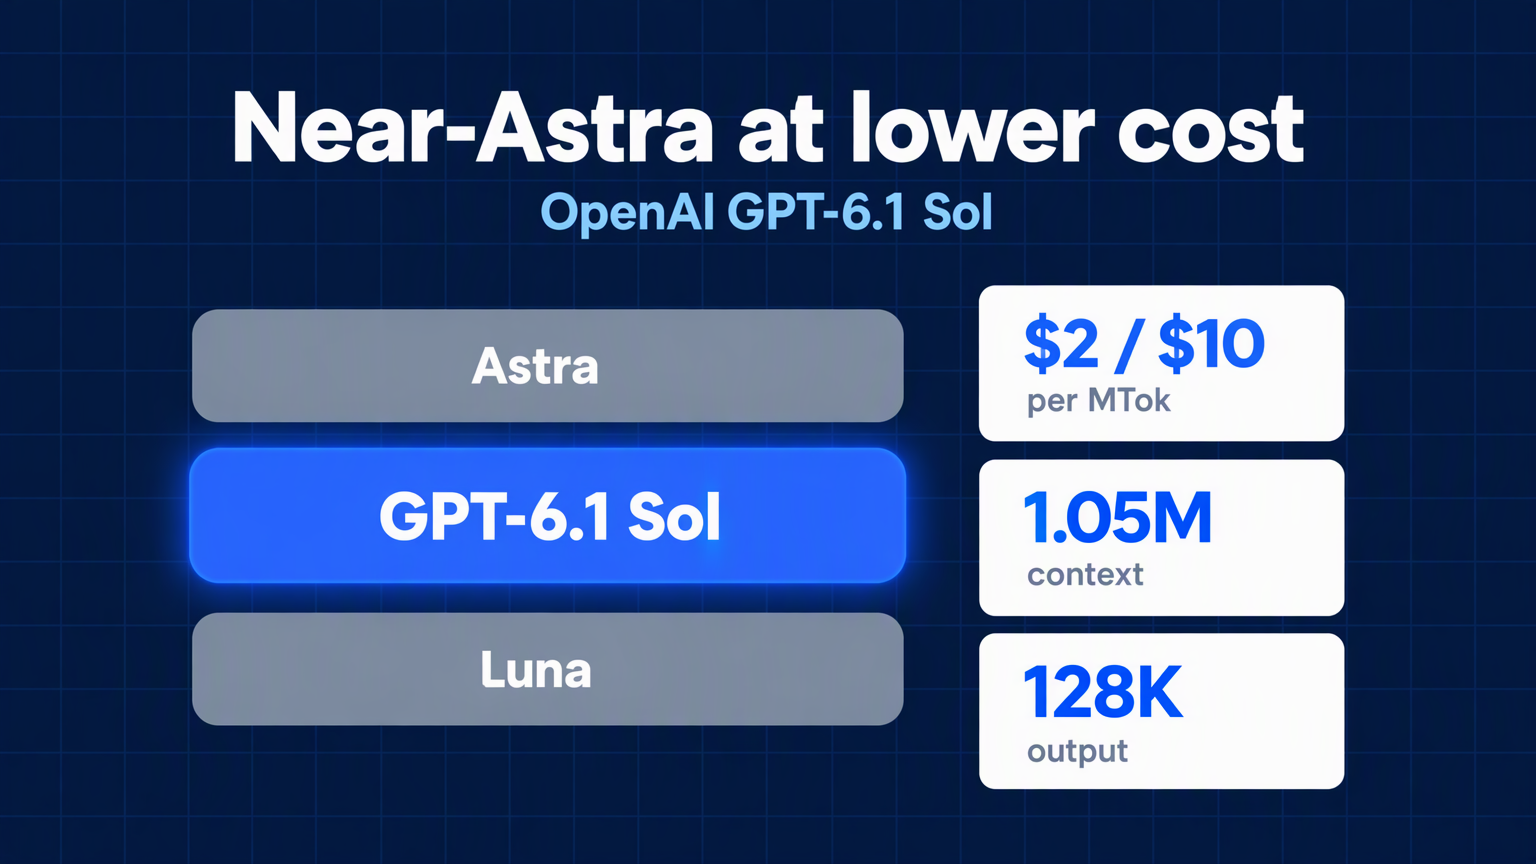
OpenAI GPT-6.1 Sol bietet nahezu Astra-Leistung für Programmierung, Computeranwendungen und professionelle Arbeit zu $2/$10 pro Million Token mit einem Kontextfenster von 1,05M.
OpenAIs neuestes Sol-Modell strebt nicht nach maximaler Intelligenz. Es soll den Betrieb über den ganzen Tag hinweg bezahlbar machen.
GPT-6.1 Sol positioniert sich zwischen dem Flaggschiff GPT-6 Astra und dem leichten GPT-6 Luna. Die Modellseite von OpenAI beschreibt es mit einem Satz: "Nahezu Astra-Leistung für komplexe Aufgaben zu geringeren Kosten." Für Teams, die agentenbasierte Programmierwerkzeuge, Computer-Agenten und dokumentenlastige Workflows entwickeln, steht genau dieser Kompromiss im Mittelpunkt.
Dieser Leitfaden zeigt, welche Funktionen GPT-6.1 Sol mitbringt, wie viel es kostet, worin es sich von GPT-6 Sol und Astra unterscheidet und wie es über die Felo API Platform angesprochen wird.
Was GPT-6.1 Sol ist
GPT-6.1 Sol ist ein Modell für komplexe Programmierung, Computeranwendungen und professionelle Arbeit. OpenAI sieht es als ausgewogene Option in der GPT-6-Familie: leistungsfähiger als Luna, günstiger als Astra und stark genug, sodass viele Produktionsaufgaben das Flaggschiff nicht benötigen.
Die Modellseite gibt klare Hinweise zur Nutzung: Vergleiche Sol mit Astra bei eigenen Aufgaben und entscheide, ob der Qualitätsunterschied den Preisunterschied rechtfertigt. Diese Anleitung passt zum Zweck des Modells. Sol dient der Kostenkontrolle, nicht als Benchmark.
Felos Modellseite fasst die Position aus Plattformperspektive zusammen. GPT-6.1 Sol ist "ein Upgrade zu GPT-6 Sol, weiterhin unterhalb des Flaggschiffs GPT-6 Astra positioniert." Es bewältigt agentenbasierte Programmierung, Computeranwendungen, dokumentenlastige professionelle Arbeit und mehrstufige Workflow-Automatisierung und erreicht bei diesen Aufgaben Ergebnisse nahe Astra-Niveau zu deutlich geringeren Kosten. Im Vergleich zu GPT-6 Sol verzeichnet Felo weniger sachliche Fehler und eine genauere Einhaltung expliziter Vorgaben.
GPT-6.1 Sol kommt zum Einsatz, wenn Aufgaben schwierig, lang und wiederholbar sind — und die Rechnung planbar bleiben muss.
GPT-6.1 Sol Spezifikationen im Überblick
OpenAI veröffentlicht die vollständigen Spezifikationen auf der Modellseite. Hier die Kurzfassung.
| Spezifikation | GPT-6.1 Sol |
|---|---|
| Model ID | gpt-6.1-sol |
| Default snapshot | gpt-6.1-sol |
| Kontextfenster | 1.050.000 Token |
| Maximale Input-Token | 922.000 |
| Maximale Output-Token | 128.000 |
| Wissensstand | 30. April 2026 |
| Input-Modalitäten | Text, Bild |
| Output-Modalitäten | Text |
| Nicht unterstützte Modalitäten | Audio, Video |
| Reasoning-Token-Unterstützung | Ja |
| Reasoning-Aufwand | low, medium (Standard), high, xhigh, max |
| Nicht unterstützter Reasoning-Aufwand | none, minimal |
| Datenresidenz | USA und EU |
Zwei Details sind wichtiger als die Hauptzahlen.
Erstens: Reasoning-Aufwand lässt sich nicht abschalten. GPT-6.1 Sol unterstützt weder none noch minimal. Wer von einem Modell migriert, das diese Einstellungen erlaubte, soll laut OpenAI mit low starten und die Ergebnisse vergleichen.
Zweitens: Tool-Aufrufe benötigen die Responses API. GPT-6.1 Sol unterstützt Chat Completions für Anfragen ohne Tools, aber jeder Workflow mit Funktionsaufrufen, Dateisuche, Websuche oder Computersteuerung muss auf Responses umstellen. Das gilt nicht nur für Sol — OpenAI entwickelt die gesamte Plattform in diese Richtung.
GPT-6.1 Sol Preise: Was $2/$10 tatsächlich bieten
OpenAIs Standardpreise für GPT-6.1 Sol liegen bei $2 pro Million Input-Token und $10 pro Million Output-Token. Die vollständige Token-Tabelle enthält Cache-Preise, die für lang laufende Agenten relevant sind.
| Metrik | Preis pro 1M Token |
|---|---|
| Input | $2.00 |
| Gecachter Input | $0.10 |
| Cache-Schreibvorgänge | $2.50 |
| Output | $10.00 |
Einige Regeln stehen hinter dieser Tabelle:
- Gecachter Input kostet 5% des normalen Preises. OpenAI berechnet Cache-Lesevorgänge bei GPT-6.1 Sol mit 0,05x, im Vergleich zu 0,1x bei den meisten GPT-5.6 und neueren Modellen. Das bringt einen deutlichen Vorteil für Agenten, die bei jedem Durchlauf einen großen System-Prompt oder Repository-Kontext wiederverwenden.
- Cache-Schreibvorgänge kosten 1,25x des normalen Input-Preises. $2.50 pro Million Token für das Schreiben eines Prefix in den Cache, danach $0.10 pro Million für das Lesen.
- Langer Kontext kostet mehr. Prompts über 272K Input-Token werden mit 2x Input- und Cache-Rate sowie 1,5x Output für die gesamte Anfrage berechnet. Bei dieser Größe kostet Input $4, gecachter Input $0.20, Cache-Schreibvorgänge $5 und Output $15 pro Million Token.
- Batch und Flex sind 50% günstiger. Wer asynchrone Verarbeitung toleriert, zahlt effektiv $1 Input und $5 Output pro Million Token.
- Fast Mode kostet das Doppelte von Standard. Bezahlt wird für geringere Latenz, nicht für mehr Intelligenz.
- Regionale Verarbeitung erhöht den Preis um 10%, sofern verfügbar.
Der Cache-Leserabatt ist das stille Highlight. Ein Programmieragent, der denselben 100.000-Token-Repository-Kontext über zwanzig Durchläufe wiederverwendet, zahlt $0.10 pro Million gecachter Token statt $2.00 pro Million frischer Input-Token. Über eine lange Sitzung hinweg summiert sich das schnell.
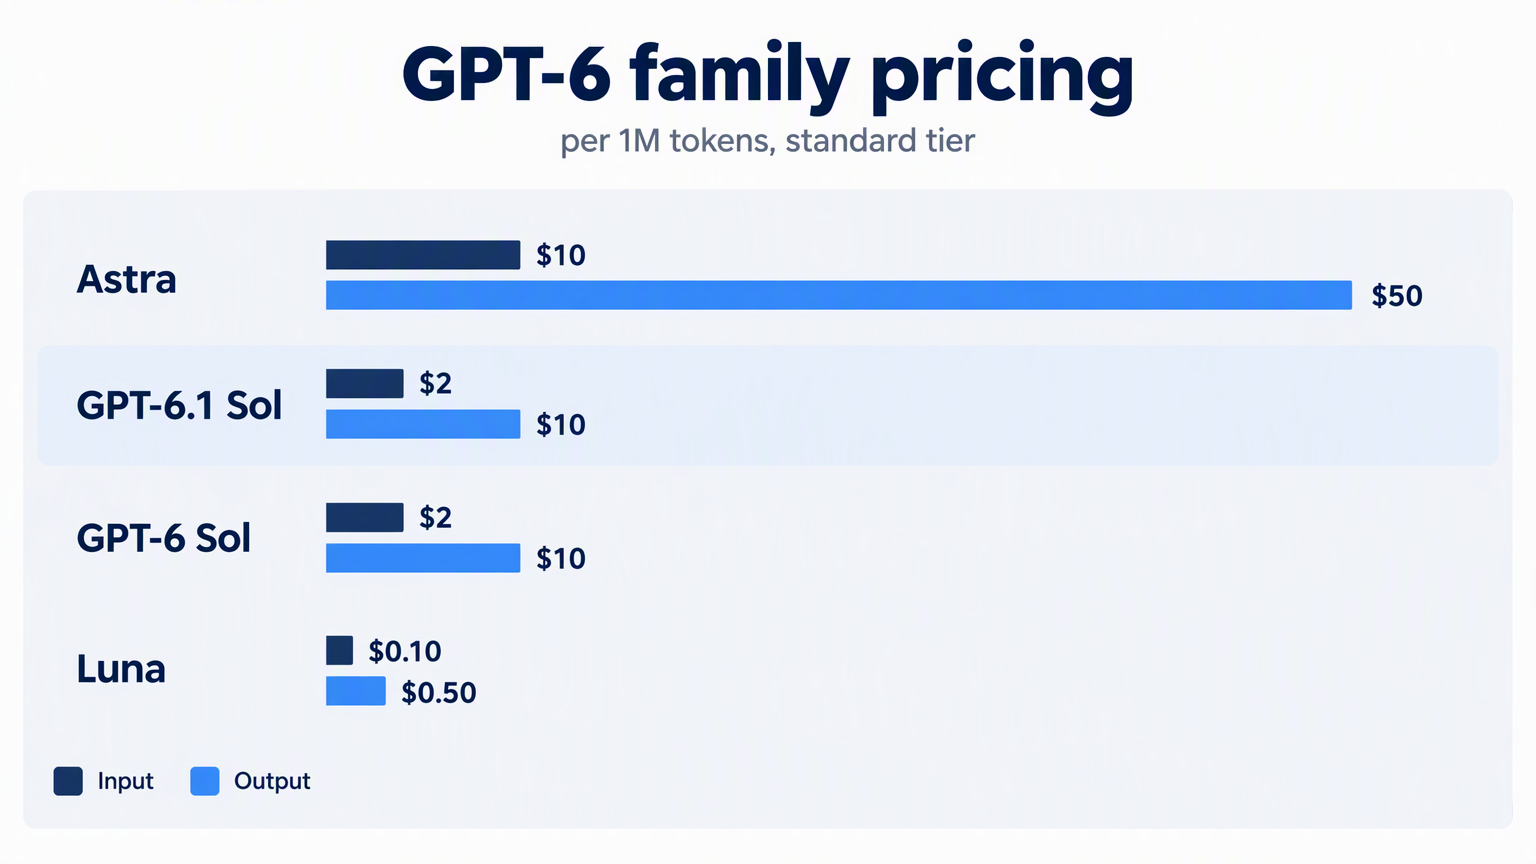
Zum Vergleich: GPT-6 Astra kostet $10 Input und $50 Output pro Million Token. GPT-6.1 Sol liegt bei einem Fünftel des Preises auf beiden Seiten. GPT-6 Luna ist noch günstiger mit $0.10 Input und $0.50 Output, verzichtet aber auf die nahezu Astra-Fähigkeit, die Sol interessant macht.
Was GPT-6 Neues bringt, das Sol nutzen kann
GPT-6.1 Sol übernimmt die Plattformfunktionen, die OpenAI mit Astra eingeführt hat. Einige davon sind speziell für agentenbasierte Workloads relevant.
Asynchrones Tool-Calling
Normalerweise pausiert ein Funktionsaufruf das Modell, bis die Anwendung ein Ergebnis zurückgibt. Mit asynchronem Tool-Calling wird async: true in der Tool-Definition gesetzt und das Modell arbeitet weiter — es denkt, ruft andere Tools auf oder beantwortet unabhängige Teile der Anfrage — während die Anwendung den langsamen Job im Hintergrund ausführt.
Die Anwendung führt das Tool aus und verwaltet offene Aufgaben. Nach Abschluss wird das Ergebnis in einer späteren Responses-Anfrage mit der ursprünglichen call_id zurückgegeben. OpenAIs Dokumentation beschreibt dies als Möglichkeit, langsame Abfragen früh zu starten und die Antwort zu ergänzen, sobald die Daten vorliegen.
Für Sol passt das gut. Ein Programmieragent kann eine lange Testreihe starten, andere Dateien prüfen und die Testergebnisse einfügen, sobald sie verfügbar sind.
Mid-Turn Steering
Mid-Turn Steering erlaubt es, während der Modellbearbeitung eine Korrektur oder neue Anforderung zu senden. Über eine WebSocket-Verbindung zur Responses API bleibt erledigte Arbeit erhalten und die Aktualisierung wird in die Fortsetzung eingebaut.
Wichtig: Steering verändert nicht bereits gesendeten Output, macht keine früheren Aktionen rückgängig und stoppt keine Tools, die schon laufen. Es beeinflusst den weiteren Verlauf, nicht den bisherigen. Wenn Steering die ursprüngliche Antwort unterbricht, endet diese mit incomplete_details.reason: "steered" und eine neue Antwort enthält die Aktualisierung.
Reasoning im Gespräch ändern
Reasoning-Aufwand kann während eines Gesprächs durch ein configuration_update Input-Item angepasst werden. Die aktualisierte Einstellung gilt, bis eine weitere Änderung erfolgt. OpenAI empfiehlt, den request-level reasoning.effort unverändert zu lassen, damit das Prompt-Prefix cachebar bleibt.
Diese Kombination — günstige Cache-Lesevorgänge plus anpassbarer Reasoning-Aufwand — macht Sol wirtschaftlich für gemischte Workloads. Routineaufgaben laufen mit low, schwierige Aufgaben mit xhigh, ohne das Gespräch neu zu schreiben.
Multi-Agent (Beta)
Multi-Agent steht als Beta-Funktion für GPT-6.1 Sol und alle GPT-5.6 Modelle bereit. Ein Hauptagent kann Subagenten erzeugen, die parallel arbeiten, jeweils mit eigenem Kontext, und deren Ergebnisse zu einer finalen Antwort zusammenführen.
OpenAIs Dokumentation empfiehlt dies für Aufgaben, die sich in unabhängige Workstreams teilen: verschiedene Teile eines großen Codes untersuchen, Vorschläge vergleichen, Quellen parallel recherchieren oder mehrere Fehlerursachen gleichzeitig prüfen. Standardmäßig sind max_concurrent_subagents auf 3 gesetzt.
Der Kompromiss liegt im Tokenverbrauch. Mehr Agenten bedeuten mehr Token, daher lohnt sich Multi-Agent, wenn Geschwindigkeit und fokussierter Kontext wichtiger sind als reine Token-Effizienz.
Kompaktierung und persistentes Reasoning
Lang laufende Agenten füllen irgendwann das Kontextfenster. Kompaktierung reduziert die Kontextgröße und bewahrt den Zustand für spätere Durchläufe. Serverseitige Kompaktierung wird durch context_management mit compact_threshold in einer Responses-Anfrage aktiviert; der Server gibt ein verschlüsseltes Kompaktierungs-Item aus, sobald die Tokenzahl den Schwellenwert überschreitet.
GPT-6.1 Sol unterstützt auch reasoning.context: "all_turns", wodurch kompatible Reasoning-Items aus früheren Durchläufen in die nächste Sample übernommen werden. Persistentes Reasoning bleibt undurchsichtig — die API gibt nie den Rohtext des Modells zurück — aber es sorgt für Kontinuität über eine lange Sitzung hinweg.
WebSocket-Modus
WebSocket-Modus hält eine dauerhafte Verbindung zur Responses API und sendet pro Durchlauf nur neue Input-Items. OpenAI berichtet bis zu 40% schnellere End-to-End-Ausführung bei Rollouts mit 20 oder mehr Tool-Aufrufen. Für ein Modell, das auf agentenbasierte Programmierung und Computeranwendungen ausgelegt ist, bringt das einen direkten Latenzvorteil.
GPT-6.1 Sol vs GPT-6 Sol vs Astra vs Luna
Die GPT-6-Familie umfasst nun vier Stufen. Die Auswahl hängt vor allem vom benötigten Qualitätsniveau und der Häufigkeit des Workflows ab.
| Modell | Positionierung | Input / Output pro 1M | Am besten geeignet für |
|---|---|---|---|
| GPT-6 Astra | Höchste Intelligenz | $10 / $50 | Anspruchsvolles Reasoning, Programmierung, professionelle Arbeit |
| GPT-6.1 Sol | Nahezu Astra zu geringeren Kosten | $2 / $10 | Komplexe Programmierung, Computeranwendungen, dokumentenlastige Arbeit |
| GPT-6 Sol | Vorherige Sol-Stufe | $2 / $10 | Bestehende Sol-Workloads vor Upgrade |
| GPT-6 Luna | Schnellste und kosteneffizienteste | $0.10 / $0.50 | Fokussierte, volumenstarke Aufgaben |
GPT-6.1 Sol und GPT-6 Sol haben denselben Listenpreis, aber es sind unterschiedliche Modelle. Felos Seite beschreibt GPT-6.1 Sol als Upgrade mit weniger sachlichen Fehlern und genauerer Einhaltung expliziter Vorgaben. Die Cache-Leserate ist halbiert: $0.10 pro Million Token statt $0.20. Wer GPT-6 Sol bereits produktiv nutzt, erhält mit dem Upgrade bessere Qualität und günstigere Cache-Nutzung zum gleichen Preis.
OpenAIs Modell-Auswahl-Leitfaden ordnet Reasoning-Aufwand den Aufgabentypen zu:
- GPT-6.1 Sol mit medium — komplexe technische Arbeit und koordinierte Ergebnisse, die überarbeitet werden.
- GPT-6.1 Sol mit extra high — ausgefeilte Ergebnisse, verbundene visuelle Systeme und Entscheidungen aus widersprüchlichen Daten.
- Astra mit low — prägnante Texte und Inhaltsanpassungen, die Fakten und Nuancen bewahren.
- Astra mit medium — ambitionierte Projekte mit breitem Kontext, zuverlässigen Interaktionen und vollständigen Ergebnissen.
- Astra mit extra high — anspruchsvolle Analysen und komplexe Ergebnisse mit hohen Anforderungen.
- Luna mit low — feingranulare Bearbeitungen, klar abgegrenzte Problemlösungen und einfache Datenextraktion.
- Luna mit extra high — aktuellen Kontext über mehrere Apps finden, Arbeit priorisieren und Probleme mit klaren Vorgaben lösen.
Die praktische Regel aus OpenAIs Codex-Leitfaden: Sol für wiederholte, lang laufende Arbeit über Code, Apps und Dokumente, wenn Kosten zählen. Astra für die anspruchsvollsten Aufgaben. Luna für klare, wiederholbare Aufgaben.
GPT-6.1 Sol über Felo API Platform ansprechen
Die Felo API Platform stellt GPT-6.1 Sol über kompatible Endpunkte bereit, sodass das bestehende SDK weiter genutzt und nur die Basis-URL geändert wird.
Das Modell ist verfügbar unter:
- Chat Completions:
POST https://openapi.felo.ai/api/v1/chat/completions - Responses:
POST https://openapi.felo.ai/api/v1/responses - Messages (Anthropic-kompatibel):
POST https://openapi.felo.ai/api/v1/messages
Schritt 1: API-Schlüssel erhalten
Einen Schlüssel im Felo API Platform-Konto erstellen und exportieren:
export FELO_API_KEY="YOUR_API_KEY"
Schritt 2: Erste Anfrage stellen
curl https://openapi.felo.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "messages": [
      {"role": "user", "content": "Explain the tradeoff between reasoning effort and cost."}
    ]
  }'
Schritt 3: Kompatibles SDK nutzen
Jedes OpenAI-kompatible SDK auf https://openapi.felo.ai/api/v1 richten. Für Claude-Clients die Anthropic-kompatible Basis-URL https://openapi.felo.ai/api verwenden.
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FELO_API_KEY,
  baseURL: "https://openapi.felo.ai/api/v1",
});

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  input: "Review this pull request for correctness, security, and missing tests.",
});

console.log(response.output_text);
Schritt 4: Streaming aktivieren, wenn benötigt
stream: true hinzufügen, um serverseitige Events während der Modellbearbeitung zu erhalten.
Felos Modellseite listet GPT-6.1 Sol mit $2.00 pro Million Input-Token und $10.00 pro Million Output-Token, wobei der Einführungspreis bis zu 50% unter den offiziellen API-Preisen liegen kann. Die endgültigen Kosten hängen vom Modell, Input/Output-Mix, Cache-Nutzung und dem aktiven Plan ab. Cache-Lesevorgänge werden zum halben Preis von GPT-6 Sol abgerechnet.
Die Plattform unterstützt Reasoning, Tools, JSON-Output, Streaming und Vision für dieses Modell und bietet einen Playground zum Testen von Prompts vor dem Schreiben von Code.
Beste Anwendungsfälle für GPT-6.1 Sol
OpenAIs Leitfaden empfiehlt komplexe Projekte, bei denen Kosten zählen. Einige Muster stechen hervor.
Agentenbasierte Programmierung im großen Maßstab
Ein Programmieragent, der ein Repository liest, Änderungen vorschlägt, Tests ausführt und iteriert, entspricht genau dem Workload, für den Sol entwickelt wurde. Das 1,05M-Kontextfenster fasst große Codebasen, der Cache-Leserabatt belohnt die Wiederverwendung von Repository-Kontext und asynchrones Tool-Calling hält den Agenten produktiv, während Tests laufen.
OpenAIs Codex-Leitfaden empfiehlt Sol für wiederholte, lang laufende Arbeit über Code und Apps, wenn Kosten zählen, und reserviert Astra für die anspruchsvollsten Aufgaben.
Computeranwendungen und Workflow-Automatisierung
GPT-6.1 Sol unterstützt alle Responses-Tools, darunter computer_use, hosted_shell, apply_patch, mcp und tool_search. Damit eignet es sich für Agenten, die Software bedienen, Formulare ausfüllen, Daten zwischen Systemen bewegen oder mehrstufige Geschäftsprozesse automatisieren.
Felos Modellseite nennt Computeranwendungen und Workflow-Automatisierung als Hauptanwendungsfälle.
Dokumentenlastige professionelle Arbeit
Sol akzeptiert Text und Bilder, darunter gescannte Dokumente, Diagramme, Screenshots und Präsentationen. OpenAIs Modell-Auswahl-Leitfaden nennt zwei Beispiele: eine Vorstandspräsentation aus Finanzdaten erstellen und eine Website aus einem Produktbrief bauen. Beide erfordern große Inputs, mehrere Überarbeitungen und eine Qualitätsstufe, die unter "bestmöglich", aber deutlich über "günstig und schnell" liegt.
Forschung und Analyse mit parallelen Workstreams
Mit aktiviertem Multi-Agent-Beta kann Sol eine Forschungsaufgabe in unabhängige Workstreams teilen, diese parallel ausführen und die Ergebnisse zusammenführen. Anbieter-Vergleiche, Pull-Request-Prüfung aus drei Perspektiven oder die Untersuchung mehrerer Fehlerhypothesen passen gut dazu.
Volumenstarke Batch-Verarbeitung
Batch- und Flex-Preise senken Sols Rate auf $1 Input und $5 Output pro Million Token. Für nächtliche Dokumentenverarbeitung, Massensummarisation oder groß angelegte Extraktion, bei der das Ergebnis geprüft wird, verändert diese Preisstruktur die wirtschaftlichen Möglichkeiten.
Migrations-Checkliste: Von GPT-6 Sol zu GPT-6.1 Sol wechseln
OpenAI empfiehlt, vor dem Wechsel von gpt-6-sol zu gpt-6.1-sol die Migrationshinweise zu prüfen. Hier die Kurzfassung.
- Model-ID setzen.
modelaufgpt-6.1-soländern. - Reasoning-Aufwand korrigieren. GPT-6.1 Sol unterstützt weder
nonenochminimal.nonedurchlowersetzen und Migration vonminimalmitlowtesten. - Tool-Calling auf Responses umstellen. Chat Completions funktioniert für Anfragen ohne Tools. Jede Funktionsausführung, Websuche, Dateisuche, Computeranwendung oder MCP-Workflow benötigt die Responses API.
- Nicht unterstützte Parameter entfernen. Wenn Reasoning-Aufwand nicht
noneist,temperature,top_pundtop_logprobsentfernen. Bei Chat Completions auchlogprobsentfernen. Bei Responsesmessage.output_text.logprobsausincludeentfernen. - Prompt-Caching-Konfiguration aktualisieren. Wer von GPT-5.5 oder älter migriert, ersetzt
prompt_cache_retentiondurchprompt_cache_options.ttlmit"30m". configuration_updatefür Reasoning-Wechsel nutzen. Wenn die App den Aufwand zwischen Durchläufen anpasst,configuration_update-Items statt Änderung von request-levelreasoning.effortverwenden, damit das Prompt-Prefix cachebar bleibt.- Datenresidenz prüfen. GPT-6.1 Sol unterstützt Datenresidenz in USA und EU. Fast Mode ist nicht mit EU-Datenresidenz verfügbar.
- Mit Astra testen. Beide Modelle bei repräsentativen Aufgaben ausführen und Qualität, Latenz und Gesamtkosten vergleichen — inklusive Reasoning-Token, die als Output-Token abgerechnet werden.
Einschränkungen und Verfügbarkeit
GPT-6.1 Sol ersetzt Astra nicht überall und ist noch nicht überall verfügbar.
Leistungsgrenzen. OpenAI positioniert Sol unterhalb von Astra. Für anspruchsvollstes Reasoning und höchste Anforderungen bleibt Astra das empfohlene Modell. Sol ist die kosteneffiziente Option für komplexe Arbeit, nicht die maximale Qualitätsoption.
Kein Fine-Tuning. GPT-6.1 Sol unterstützt kein Fine-Tuning oder vorhergesagte Outputs. Es unterstützt auch keine Embeddings, Bildgenerierung, Video, Sprache, Transkription, Übersetzung oder Moderationsendpunkte. Es ist ein Text-und-Bild-in, Text-out Reasoning-Modell.
Kein Audio- oder Video-Input. Input-Modalitäten sind ausschließlich Text und Bild.
Reasoning lässt sich nicht deaktivieren. Die Aufwände none und minimal werden nicht unterstützt, jede Anfrage enthält Reasoning-Overhead.
Rollout läuft noch. OpenAIs Einführung umfasst Plus, Pro, Business, Enterprise und Edu-Pläne in Codex auf Desktop und CLI sowie ChatGPT Work im Web und auf Mobilgeräten. Bei Enterprise und Edu bleibt das Modell standardmäßig deaktiviert, bis ein Administrator es freischaltet. Free und Go-Pläne sind zum Start nicht enthalten.
Fast Mode mit Einschränkungen. Standard und Fast Mode sind zum Start verfügbar, Fast Mode kostet das Doppelte von Standard und ist mit EU-Datenresidenz nicht verfügbar. Ultrafast-Unterstützung für GPT-6.1 Sol folgt später.
Rate-Limits gelten. Standard-Limits reichen von 500 RPM und 500.000 TPM auf Tier 1 bis 15.000 RPM und 40.000.000 TPM auf Tier 5.
FAQ
Was ist GPT-6.1 Sol?
GPT-6.1 Sol ist OpenAIs ausgewogenes GPT-6-Modell, positioniert zwischen dem Flaggschiff GPT-6 Astra und dem leichten GPT-6 Luna. OpenAI beschreibt es als nahezu Astra-Leistung für komplexe Programmierung, Computeranwendungen und professionelle Arbeit zu geringeren Kosten.
Wie viel kostet GPT-6.1 Sol?
OpenAI listet GPT-6.1 Sol mit $2 pro Million Input-Token und $10 pro Million Output-Token. Gecachter Input kostet $0.10 pro Million Token, Cache-Schreibvorgänge $2.50 pro Million Token. Prompts über 272K Input-Token werden zu höheren Long-Context-Raten abgerechnet.
Wie groß ist das Kontextfenster von GPT-6.1 Sol?
GPT-6.1 Sol hat ein Kontextfenster von 1.050.000 Token, maximal 922.000 Input-Token und maximal 128.000 Output-Token.
Unterstützt GPT-6.1 Sol Tool-Calling?
Ja, aber Tool-Calling erfordert die Responses API. Chat Completions wird für Anfragen ohne Tools unterstützt.
Kann Reasoning bei GPT-6.1 Sol deaktiviert werden?
Nein. GPT-6.1 Sol unterstützt low, medium, high, xhigh und max Reasoning-Aufwand. none und minimal werden nicht unterstützt.
Wie unterscheidet sich GPT-6.1 Sol von GPT-6 Sol?
GPT-6.1 Sol ist laut Felos Modellseite ein Upgrade zu GPT-6 Sol mit weniger sachlichen Fehlern und genauerer Einhaltung expliziter Vorgaben. Beide haben denselben Listenpreis, aber GPT-6.1 Sol halbiert die gecachte Input-Rate auf $0.10 pro Million Token.
Ist GPT-6.1 Sol auf der Felo API Platform verfügbar?
Ja. Die Felo API Platform stellt GPT-6.1 Sol über Chat Completions, Responses und Anthropic-kompatible Messages-Endpunkte bereit. Der Einführungspreis kann bis zu 50% unter den offiziellen API-Preisen liegen, Cache-Lesevorgänge werden zum halben Preis von GPT-6 Sol abgerechnet.
Fazit
GPT-6.1 Sol löst ein praktisches Problem: Das beste Modell ist oft zu teuer für jede Aufgabe, das günstigste Modell reicht oft nicht aus. Sol bietet einen Mittelweg mit nahezu Astra-Fähigkeit, einem Kontextfenster von 1,05M, einer Cache-Leserate von 5% und einem Preis, der bei einem Fünftel von Astra liegt.
Für Teams, die Programmieragenten, Computer-Workflows und dokumentenlastige Automatisierung entwickeln, ist es das Modell für den ersten Test. Mit Astra vergleichen, Reasoning-Token-Verbrauch beobachten und den Kosten-Qualitäts-Kompromiss entscheiden lassen.
GPT-6.1 Sol kann im Felo API Platform Playground ausprobiert oder direkt mit einem Felo API-Schlüssel angesprochen werden.
Quellen
- GPT-6.1 Sol Modellseite — OpenAI
- GPT-6 verwenden — OpenAI
- Modellauswahl — OpenAI
- API-Preise — OpenAI
- Codex und ChatGPT Modellverfügbarkeit — OpenAI
- Asynchrones Tool-Calling — OpenAI
- Mid-Turn Steering — OpenAI
- Reasoning-Modelle — OpenAI
- Prompt-Caching — OpenAI
- Kompaktierung — OpenAI
- Multi-Agent — OpenAI
- WebSocket-Modus — OpenAI
- Fast Mode — OpenAI
- Datenresidenz — OpenAI
- GPT-6.1 Sol — Felo API Platform
Dieser Beitrag ist auch in folgenden Sprachen verfügbar: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.