
Gemini 4 Carbon en Felo API: especificaciones, benchmarks, precios y casos de uso

Gemini 4 Carbon en Felo API: su presupuesto unificado de 1 millón de tokens, niveles de razonamiento, límites multimodales, benchmarks publicados, precios reales y cómo utilizarlo.
Gemini 4 Carbon de Google es el modelo que la empresa orienta a tareas que superan lo que puede resolverse en una sola interacción rápida: una migración de código que afecta a decenas de servicios, una búsqueda de vulnerabilidades que debe terminar con un parche funcional o una investigación que requiere una cadena de pruebas en lugar de un párrafo lleno de afirmaciones.
Ahora se puede utilizar a través de Felo API, y Felo ofrece una prueba gratuita por tiempo limitado junto con tarifas de proveedores con descuento. Puedes abrir el modelo, probar prompts en el entorno de pruebas y crear una clave desde la página de Gemini 4 Carbon en Felo antes de leer el resto de esta guía.
Este artículo es una explicación práctica, no un anuncio de lanzamiento. Aborda qué es Carbon, en qué se diferencia de Gemini 4 Argon, qué revelan y qué no revelan los benchmarks publicados, cómo funciona su inusual presupuesto de tokens, cuáles son sus puntos fuertes, dónde puede decepcionar y cuánto cuesta utilizarlo en Felo.
Qué es Gemini 4 Carbon
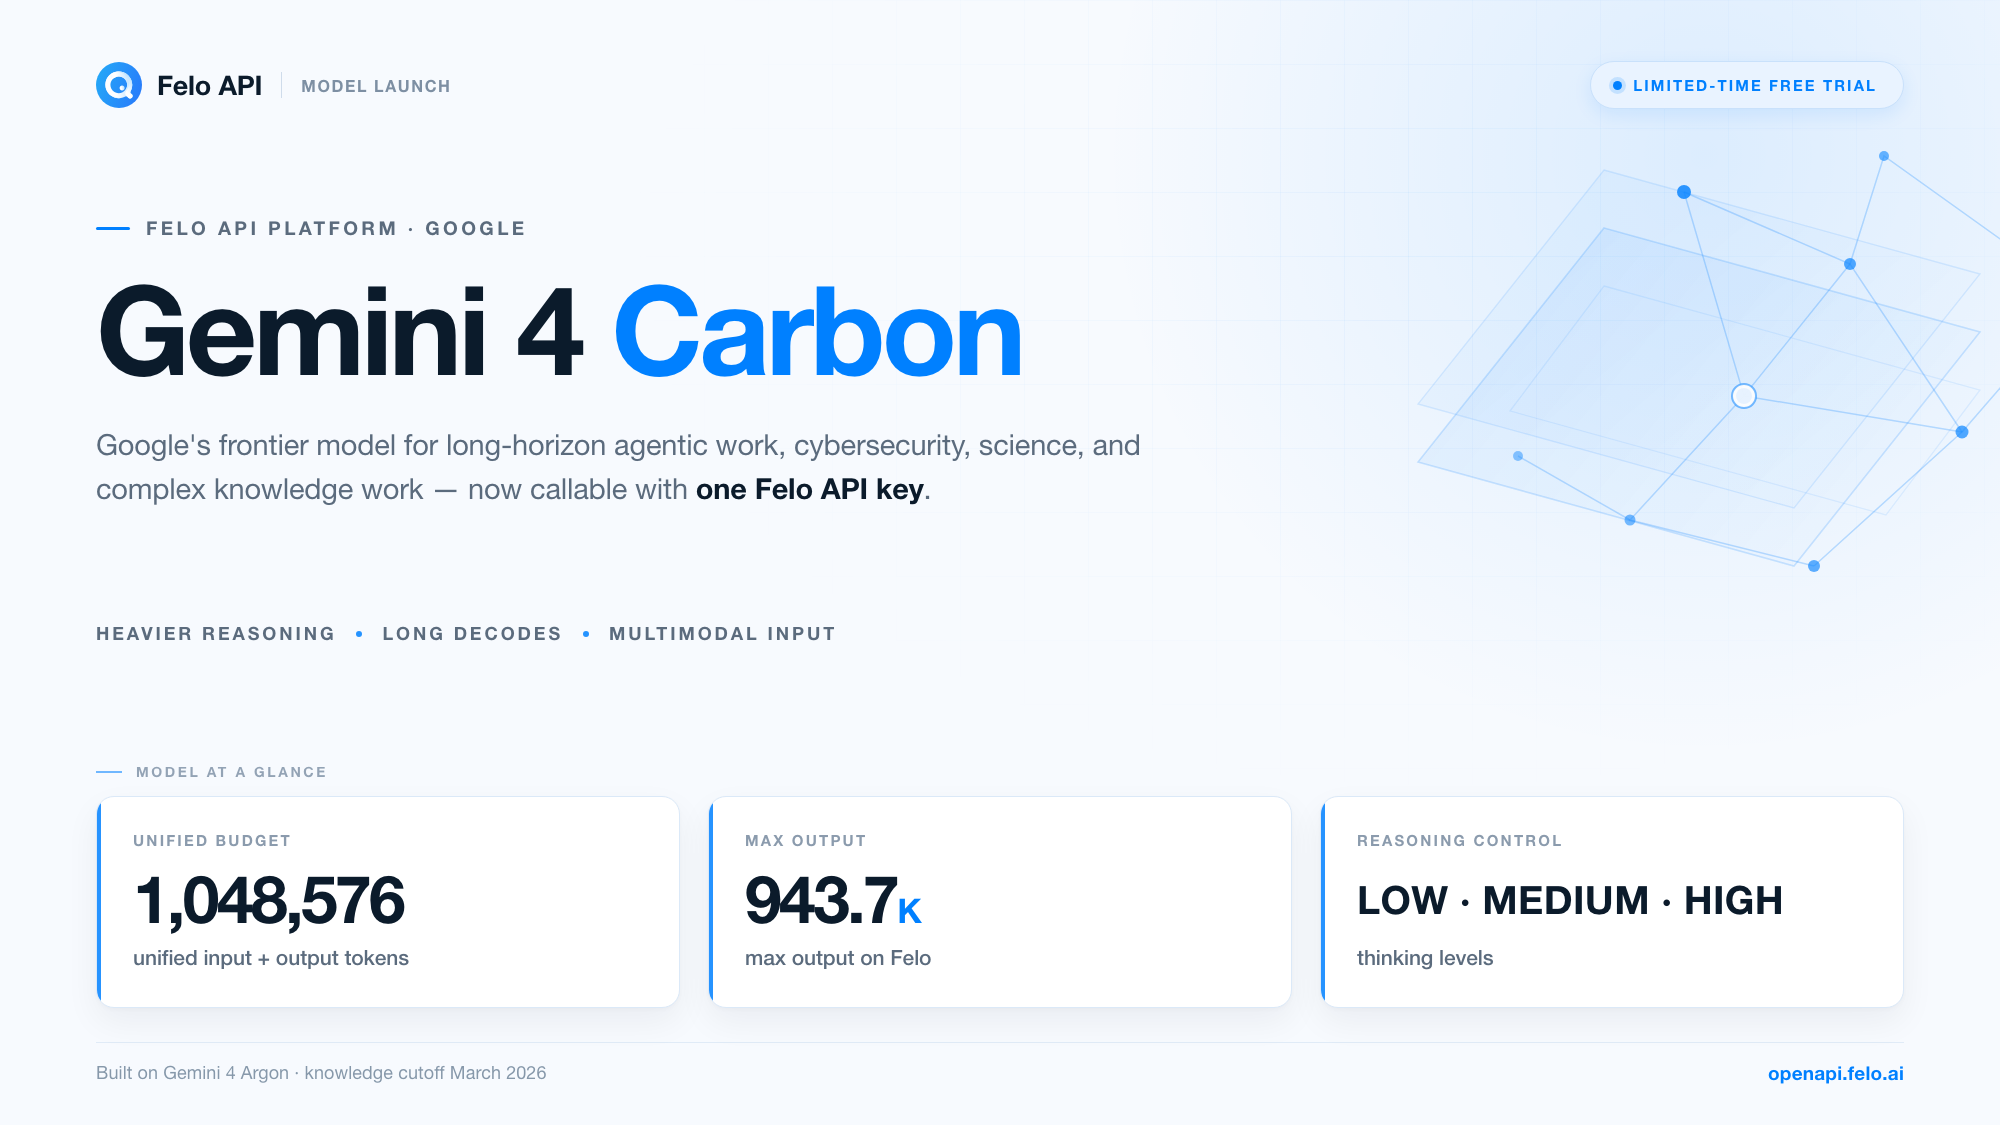
Gemini 4 Carbon es el modelo de frontera de Google para tareas agénticas de larga duración en programación, finanzas, derecho, ciberseguridad y ciencia. Google lo anunció el 28 de octubre de 2026, lo desarrolló sobre la base de Gemini 4 Argon y lo lanzó inicialmente para un grupo selecto de especialistas en defensa de la ciberseguridad a través de su programa Fairwind. La documentación de la plataforma empresarial de Google ya incluye el modelo con disponibilidad general y fecha de lanzamiento del 10 de noviembre de 2026.
El nombre «Carbon» no indica una nueva generación. Representa un punto operativo distinto dentro de la familia Gemini 4. Argon se optimizó para producir documentos extensos y coherentes en una sola trayectoria, mientras que Carbon destina una mayor parte de su presupuesto al razonamiento: explorar hipótesis, ejecutar ciclos de verificación y coordinar tareas con varios pasos. Google afirma que utiliza más tokens de razonamiento que Argon para llegar a sus respuestas.
Esta diferencia tiene un coste. El modelo tarda más en tareas complejas, puede agotar el tiempo de espera bajo ciertas condiciones y consume más tokens con niveles de razonamiento elevados. Google reconoce estas limitaciones de forma expresa. La razón para elegir Carbon es que los trabajos a los que se dirige —análisis de seguridad, migraciones de gran escala, razonamiento científico y revisión de documentos de alto riesgo— requieren profundidad por encima de velocidad.
Especificaciones del modelo de un vistazo
| Especificación | Valor |
|---|---|
| ID del modelo en Felo | gemini-4-carbon |
| Anuncio | 28 de octubre de 2026 |
| Basado en | Gemini 4 Argon |
| Contexto y salida | Un presupuesto unificado de 1,048,576 tokens para entrada y salida |
| Salida máxima indicada en Felo | 943.718K tokens |
| Entrada | Texto, imágenes, audio, vídeo, PDF y archivos Office/OpenDocument |
| Salida | Texto |
| Niveles de razonamiento | LOW, MEDIUM (predeterminado), HIGH |
| Fecha límite de conocimiento | Marzo de 2026 |
| Muestreo | Temperatura 1.0, top-p 0.95, top-k 64, valores fijos |
| Caché | Solo caché implícita, mínimo de 4,096 tokens |
| Interfaz recomendada en Felo | Messages API (compatible con Anthropic) |
| Acceso | Clientes empresariales verificados en regiones seleccionadas; variante cibernética con acceso exclusivo mediante lista de permitidos |
Dos detalles de esta tabla merecen una explicación propia porque afectan a la forma de desarrollar aplicaciones con el modelo: el presupuesto unificado de tokens y los niveles de razonamiento.
En qué se diferencia Gemini 4 Carbon de Gemini 4 Argon
Carbon y Argon pertenecen a la misma familia, comparten la fecha límite de conocimiento y gran parte de su posicionamiento. Las diferencias están relacionadas con la forma en que cada modelo utiliza su capacidad.
Un presupuesto unificado para entrada y salida. Argon suele describirse con una ventana de contexto de 1,048,576 tokens y una salida predeterminada independiente de 65,536 tokens. En Carbon, los 1,048,576 tokens cubren la entrada, el razonamiento, las llamadas a herramientas y la respuesta final. Se trata de un único presupuesto, no de una ventana de contexto más una asignación de salida.
Mayor razonamiento de forma predeterminada. Carbon admite los niveles de razonamiento LOW, MEDIUM y HIGH. MEDIUM es el valor predeterminado en gemini-4-carbon, mientras que HIGH es el predeterminado en la variante con permisos de ciberseguridad. El modelo está diseñado para ejecutar ciclos de verificación prolongados. Por eso Google presenta el mayor consumo de tokens como una limitación conocida y no como un error.
Generación de salidas extensas. Un único segmento en primer plano genera hasta 65,536 tokens de salida durante la transmisión o 32,768 tokens sin transmisión. Para superar estos límites se utilizan generaciones prolongadas: Google Gen AI SDK y Agent Studio gestionan de forma automática un token de continuación, o puedes implementar un ciclo de continuación personalizado. El límite teórico corresponde al presupuesto unificado completo menos los tokens de entrada.
Mayor compatibilidad con archivos. Carbon admite archivos de Microsoft Office y OpenDocument —.docx, .doc, .pptx, .ppt, .xlsx, .xls, .odt, .odp, .ods— como contenido integrado o desde almacenamiento en la nube, además de PDF y texto sin formato. Esto resulta importante cuando el flujo de trabajo comienza con una presentación, una hoja de cálculo o un contrato en lugar de una exportación de texto.
Ajustes de seguridad y una variante cibernética independiente. Google informa de una reducción de casi el 80 % en las alertas de desalineación de gravedad alta en entornos de programación reales. También afirma que Carbon supera a Argon en seguridad de contenido multilingüe y multimodal por 3.50 puntos porcentuales en evaluaciones de seguridad de texto a texto. Existe otra variante, gemini-4-carbon-cyber-permissive, con acceso exclusivo mediante lista de permitidos para tareas de defensa de ciberseguridad. Su nivel de razonamiento predeterminado es HIGH y no incluye el uso del ordenador.
Comportamiento especializado para ciencia. Google afirma que el modelo puede convertir objetivos de seguridad en teoremas matemáticos y descubrir homólogos remotos de forma autónoma en archivos de secuencias a escala de petabases. La empresa informa de un aumento medio de 40 veces en la recuperación de homólogos para familias de proteínas con pocos homólogos. Esta afirmación se refiere a una tarea de investigación concreta. Conviene reproducir los resultados con tus propios datos en lugar de aceptarlos como una capacidad general.
Explicación del presupuesto unificado de tokens
La mayoría de las páginas de modelos ofrecen dos cifras: una ventana de contexto y una salida máxima. Carbon ofrece una sola cifra y una regla por segmento. Si planificas las solicitudes con el método tradicional, puedes sobreestimar el espacio disponible o interpretar mal el coste.
Así se distribuye el presupuesto:
- Entrada — tu prompt, los documentos adjuntos, las imágenes, el audio, los fotogramas de vídeo y la conversación anterior.
- Razonamiento — los tokens que el modelo consume para razonar antes de responder. Con HIGH, esta cantidad puede ser considerable.
- Llamadas a herramientas — cualquier herramienta que invoque el modelo cuando estas funciones estén habilitadas.
- Respuesta final — el texto que recibes.
Los cuatro elementos utilizan el mismo presupuesto de 1,048,576 tokens. Una solicitud con 900K tokens de entrada no deja 1M de tokens para la salida. Deja cerca de 148K para el razonamiento, las herramientas y la respuesta en conjunto, antes de cualquier continuación.
El límite por segmento es independiente. En una solicitud con transmisión, un segmento admite hasta 65,536 tokens de salida; sin transmisión, el límite es de 32,768. Las generaciones prolongadas permiten continuar después del límite del segmento hasta agotar el presupuesto unificado. Si tu integración interpreta max_tokens como una promesa de salida total, esa interpretación es incorrecta: el parámetro limita un segmento y la gestión de continuaciones del SDK permite generar un documento extenso.
La página del modelo de Felo indica una salida máxima de 943.718K tokens. Interpreta esta cifra como el límite de salida en la ruta de Felo, no como una segunda ventana de contexto más amplia. Con un presupuesto unificado, el espacio real disponible para la respuesta depende del contenido que envíes.
La implicación para el diseño es sencilla: decide primero el tamaño de la salida y adapta la entrada a ese límite. Para un informe extenso, reserva espacio para la salida y el razonamiento, y reduce el material de origen hasta ajustarlo. Para analizar un conjunto amplio de documentos, acepta que la respuesta será más corta que la entrada y planifica continuaciones o prompts por etapas.
Niveles de razonamiento: de dónde procede la calidad
Carbon ofrece tres niveles de razonamiento: LOW, MEDIUM y HIGH. MEDIUM es el valor predeterminado. La documentación de Google especifica que thinking_budget y thinking_level="MINIMAL" generan un error de validación, por lo que no es posible reducir el razonamiento a cero.
La diferencia práctica es considerable. Con LOW, el modelo se comporta como un modelo de chat de frontera con respuesta rápida: resulta adecuado para extracción, clasificación, reescritura y revisión rutinaria de código. Con MEDIUM, empieza a dedicar tokens a la planificación y la autocorrección. Con HIGH, ejecuta ciclos de verificación más largos. Es la configuración con mayor capacidad para detectar errores sutiles, pero también la que puede consumir más tiempo y recursos.
Algunas reglas útiles para el trabajo diario:
- Adapta el nivel al coste de una respuesta incorrecta. Si un error es fácil y barato de detectar y corregir, utiliza LOW. Si un error llega a producción o a una presentación oficial, prueba HIGH.
- Mide los tokens por resultado aceptado, no los tokens por solicitud. Un mayor razonamiento puede reducir los reintentos y el trabajo repetido. También puede multiplicar el coste en tareas que el modelo habría resuelto con MEDIUM. Compara el ciclo completo.
- No des por hecho que la configuración del benchmark coincide con la tuya. Las cifras principales publicadas por Google no siempre indican el nivel de razonamiento utilizado. Prueba tus propias tareas con dos niveles antes de elegir uno.
Los parámetros de muestreo están fijados en temperatura 1.0, top-p 0.95 y top-k 64. Los valores personalizados se ignoran. Si tu proceso depende de un comportamiento determinista con baja temperatura, Carbon no es el modelo adecuado para esa etapa. Utilízalo para tareas de criterio y síntesis, y reserva los pasos deterministas para un modelo que respete los controles de muestreo.
Qué publicó Google: benchmarks y su significado
La página del modelo de Felo reúne los resultados de los benchmarks publicados por el proveedor para Carbon. Las comparaciones siguientes ofrecen una orientación: proceden de Google o del proveedor de evaluación, no se han reproducido de forma independiente para este artículo y describen condiciones de prueba, no tu carga de trabajo.
| Evaluación | Qué mide | Gemini 4 Carbon | Contexto |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | Índice compuesto de razonamiento | 59 | Primer puesto; Claude Opus 5.5 obtiene 58 |
| SEC-bench Pro | Detección de vulnerabilidades | 88.2% | Seguridad, análisis defensivo |
| CWE-bench | Aplicación de parches para vulnerabilidades | 71.0% | Seguridad, corrección |
| ExploitGym | Explotación de vulnerabilidades | 54.8% | Investigación de seguridad, entornos controlados |
| Terminal-Bench 4.0 | Tasa de trampas exitosas | 0.0% | Resistencia a la manipulación de recompensas, no capacidad |
| Vals Index | Índice compuesto de trabajo intelectual | 70.45% | Puesto 3 de 36 modelos |
| Legal Research Bench | Investigación jurídica | 55.77% | Puesto 1 |
| General Financial Intelligence | Tareas financieras | #1 | Primero entre 23 configuraciones de modelos de frontera, según Balyasny Asset Management |
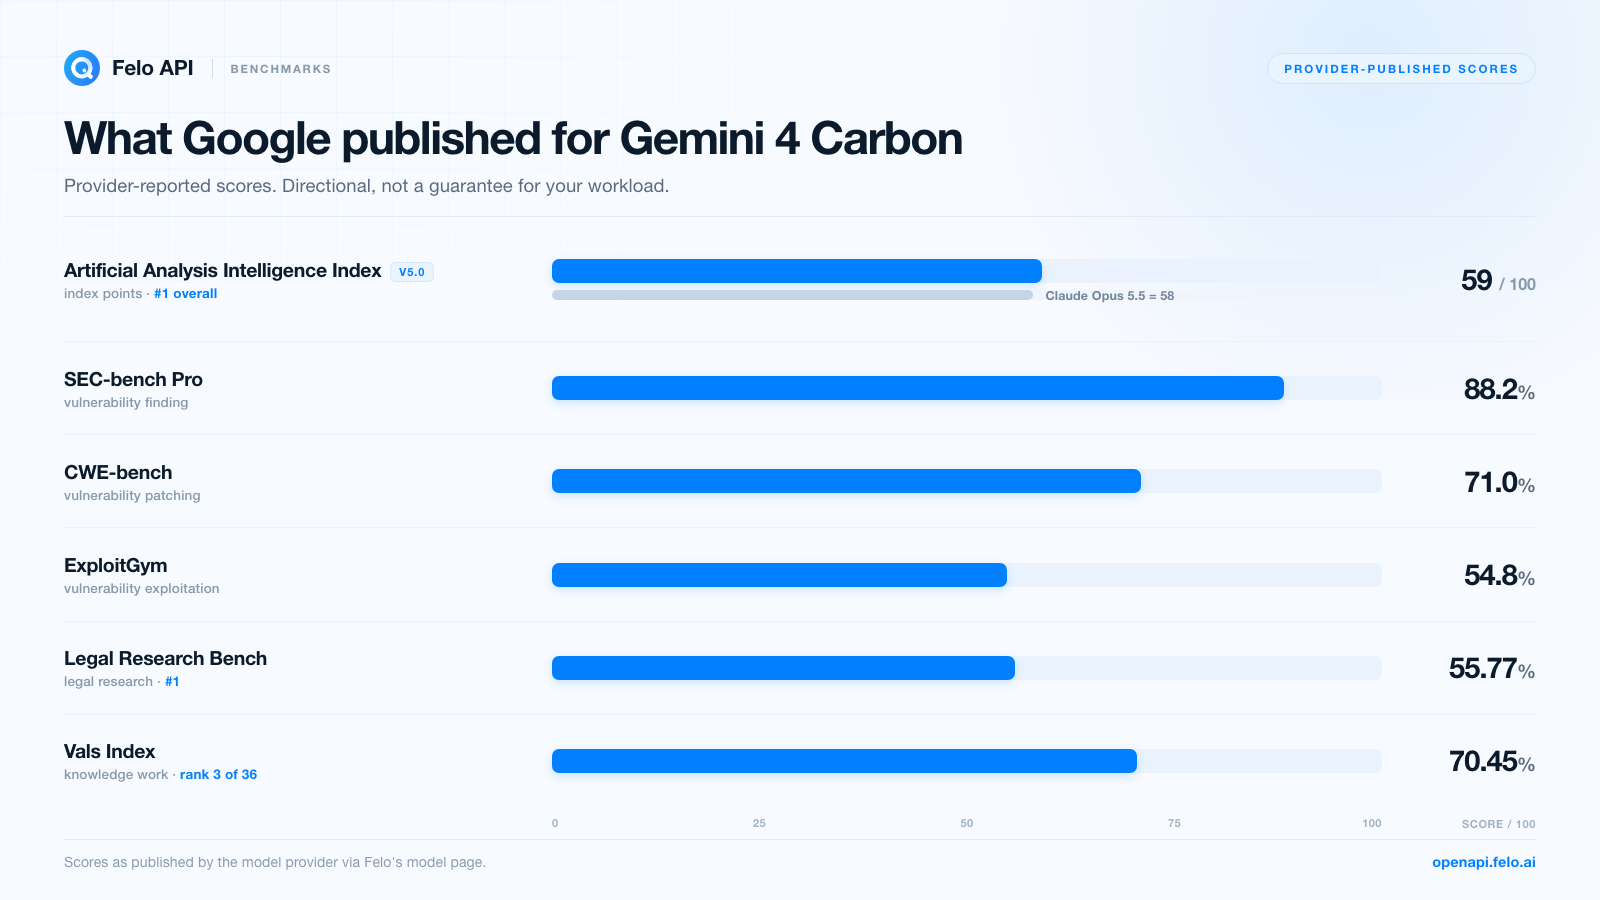
Al examinar la tabla, destacan tres aspectos.
Las puntuaciones de seguridad representan un ciclo de trabajo, no una única habilidad. Detectar vulnerabilidades, redactar parches y explotar vulnerabilidades son habilidades distintas. Las cifras publicadas de Carbon son más altas en detección (88.2% en SEC-bench Pro) y más bajas en explotación (54.8% en ExploitGym), con la corrección en un punto intermedio (71.0% en CWE-bench). Si tu trabajo es defensivo —análisis, clasificación de alertas y corrección—, este perfil resulta adecuado. Si necesitas explotación autónoma, la puntuación es menor y las reglas de acceso son más estrictas.
La métrica de trampas mide la confianza, no la inteligencia. La «tasa de trampas exitosas» de Terminal-Bench 4.0 mide si un modelo manipula un benchmark en lugar de resolver la tarea. Un resultado del 0.0% representa una afirmación sobre la resistencia a la manipulación de recompensas. Esto importa cuando permites que un agente trabaje sin supervisión. No es una puntuación de capacidad y no debe compararse con los resultados de porcentaje de aciertos de otras filas de la tabla.
Las posiciones en tareas de conocimiento son las más relevantes para la mayoría de los equipos. El puesto 3 de 36 en Vals Index, el primer puesto en Legal Research Bench y el liderazgo en la comparación financiera de Balyasny describen el tipo de trabajo que justifica el uso de un modelo de frontera: leer grandes volúmenes de información, conciliar pruebas contradictorias y producir un resultado que un profesional pueda revisar. Estos resultados también dependen mucho del diseño del prompt y de la calidad de las fuentes. Tómalos como un motivo para probar el modelo, no como una razón para omitir las pruebas.
Hay otra advertencia: la puntuación de Artificial Analysis es un índice compuesto, y una ventaja de un punto sobre Claude Opus 5.5 entra dentro de un margen en el que una combinación distinta de tareas puede invertir el orden. En las tareas concretas que te interesan, los dos modelos pueden mostrar diferencias importantes en cualquier dirección.
Dónde resulta útil Gemini 4 Carbon
Los benchmarks son un mapa, no el territorio. Estas son las cargas de trabajo en las que las decisiones de diseño de Carbon coinciden con las necesidades de la tarea.
Programación a gran escala y migraciones
Carbon está orientado a tareas de ingeniería que requieren colaboración entre varios agentes, depuración cotidiana, migraciones de grandes bases de código y diseño de algoritmos. El presupuesto unificado resulta útil en este contexto: puedes incluir un mapa del repositorio, los archivos fuente pertinentes, los resultados de las pruebas fallidas y los requisitos de migración en una sola solicitud. Después puedes pedir un plan antes de realizar cambios en el código.
Un prompt adecuado para este tipo de modelo:
Lee el mapa del repositorio adjunto y los tres módulos de servicio. Identifica todos los puntos de llamada afectados por la sustitución de la interfaz de sesión, enumera los riesgos de compatibilidad y propone un orden de migración. No escribas código todavía. Señala cualquier elemento que no hayas podido verificar a partir de los archivos proporcionados.
Solicita primero un plan. Permite que el modelo ejecute pruebas cuando hayas revisado ese plan. Mantén la revisión de las diferencias bajo supervisión humana: un modelo que planifica bien también puede producir un parche que compile y cuyo comportamiento sea incorrecto.
Ciberseguridad defensiva
El perfil de los benchmarks de seguridad —alta capacidad de detección, buena capacidad de corrección y menor capacidad de explotación— encaja con tareas defensivas: analizar una base de código en busca de clases de vulnerabilidades, clasificar los resultados de los escáneres, proponer parches y explicar los riesgos con un lenguaje útil para los revisores. La variante cibernética de Google está diseñada para este trabajo, pero su acceso está restringido mediante el programa Fairwind y requiere una aprobación independiente.
Hay dos precauciones. En primer lugar, ejecuta flujos de trabajo de seguridad solo contra sistemas que tengas autorización para probar. En segundo lugar, verifica los hallazgos antes de actuar: un modelo que informa de una vulnerabilidad con gran confianza también puede equivocarse, y un falso positivo supone una pérdida de tiempo de ingeniería.
Investigación científica y técnica
La capacidad científica comunicada es específica: transformar objetivos de seguridad en teoremas matemáticos y buscar homólogos remotos en archivos de secuencias a escala de petabases. Si trabajas en un laboratorio o grupo de investigación, un patrón útil consiste en proporcionar a Carbon una pregunta bien delimitada, la bibliografía o las secuencias pertinentes y la instrucción de separar las pruebas de las inferencias.
La afirmación de una recuperación de homólogos 40 veces mayor resulta llamativa, pero describe familias de proteínas con pocos homólogos dentro de un proceso específico. Reproduce el resultado con un benchmark de confianza para tu equipo antes de desarrollar un flujo de trabajo basado en él.
Finanzas, derecho y revisión de documentos de alto riesgo
Las posiciones de Carbon en tareas de conocimiento son su principal argumento para los servicios profesionales. El trabajo incluye conciliar libros contables, analizar desviaciones, revisar jurisprudencia y documentos regulatorios, y elaborar informes con citas. El modelo puede leer imágenes y PDF, por lo que los documentos escaneados y los gráficos también sirven como material de entrada.
Esto no elimina la necesidad de revisión. Proporciona el conjunto de fuentes, solicita una cita para cada conclusión y comprueba las referencias. Un modelo capaz de procesar un millón de tokens de contexto también puede interpretar mal la página 412.
Agentes de larga duración con herramientas
Carbon admite llamadas a funciones, salida estructurada, ejecución de código, contexto de URL, uso del ordenador y varias opciones de fundamentación, entre ellas Google Search, Google Maps y proveedores de búsqueda externos. También admite comprensión agéntica de vídeo, una función útil cuando la entrada es una grabación en lugar de un documento.
Esta es la forma más exigente de utilizar el modelo y la que puede consumir más tokens. Instrumenta el agente: registra las llamadas a herramientas, limita las iteraciones y exige que resuma lo que ha verificado antes de actuar. El presupuesto de 1M permite crear agentes ambiciosos, pero no reduce su coste.
Entradas multimodales y sus límites
Carbon acepta texto, imágenes, audio, vídeo, PDF y documentos Office, y devuelve texto. Los límites son amplios, pero específicos, y tienen más importancia que la lista general de modalidades.
| Tipo de entrada | Límite práctico |
|---|---|
| Audio | Cerca de 8.4 horas por prompt o hasta 1M de tokens; hasta 1,000 archivos de audio |
| Vídeo | Cerca de 45 minutos con audio y cerca de 1 hora sin audio; hasta 10 vídeos por prompt |
| Imágenes y documentos | Hasta 3,000 elementos combinados por prompt |
| Documentos | Hasta 3,000 páginas por archivo |
| Formatos Office | .docx, .doc, .pptx, .ppt, .xlsx, .xls |
| Formatos OpenDocument | .odt, .odp, .ods |
| Tamaño de entrada | 500 MiB comprimidos en GenerateContent API; 256 MiB en Interactions API |
El límite de audio destaca entre los demás. Ocho horas de audio en una sola solicitud cambian las posibilidades de un equipo con muchas reuniones: en lugar de transcribir y dividir el contenido en fragmentos, puedes entregar una jornada completa de llamadas y solicitar temas, decisiones y preguntas pendientes. El coste está en los tokens, y los tokens de audio se facturan como tokens de entrada. Por tanto, subir una jornada completa de grabaciones no es gratis.
El límite de vídeo se acerca más a una sesión de trabajo habitual: 45 minutos de vídeo con audio bastan para una clase, una demostración de producto o una entrevista grabada, pero no para una conferencia completa.
Hay carencias funcionales que conviene tener en cuenta. Gemini Live API no es compatible, por lo que no hay voz en tiempo real. RAG Engine y el ajuste del modelo tampoco son compatibles, de modo que la recuperación de información y el ajuste fino deben gestionarse en la capa de aplicación. El almacenamiento explícito en caché de contexto tampoco está disponible: solo existe la caché implícita con un mínimo de 4,096 tokens. Esto afecta a la planificación de costes cuando se repiten prompts extensos.
Cómo utilizar Gemini 4 Carbon en Felo
Felo indica Messages API como la interfaz recomendada para este modelo. El endpoint acepta una estructura de solicitud compatible con Anthropic en https://openapi.felo.ai/api/v1/messages, y el ID del modelo es gemini-4-carbon.
El proceso es el mismo que para cualquier otro modelo de Felo:
- Crea una clave de Felo API. Las claves se crean en la consola de Felo y se almacenan como
FELO_API_KEY. No incluyas la clave en el repositorio ni la pegues en los registros. - Prueba primero el entorno de pruebas. El entorno de pruebas de Gemini 4 Carbon permite probar prompts antes de escribir código.
- Envía una solicitud pequeña. Comienza con un prompt breve y confirma la estructura de la respuesta.
- Añade transmisión. Configura
stream: truepara recibir eventos enviados por el servidor. Esto importa cuando un solo segmento puede alcanzar 65,536 tokens. - Prueba una tarea representativa. Utiliza el tamaño real de tus entradas, tus criterios de evaluación y al menos dos niveles de razonamiento antes de incorporar el modelo a un proceso.
Una solicitud básica en Python tiene este aspecto:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
Hay dos observaciones sobre la integración. En primer lugar, este modelo tiene capacidad de razonamiento: conserva los metadatos de razonamiento devueltos cuando continúes una conversación, o puedes perder el contexto que el modelo espera recibir. En segundo lugar, max_tokens establece un límite por segmento, no un límite total. Para generar respuestas extensas, utiliza el mecanismo de continuación que ofrece tu SDK en lugar de aumentar el valor y confiar en que sea suficiente.
Felo también documenta endpoints de Chat Completions y Responses compatibles con OpenAI para los modelos que admiten estas interfaces. Como la página del modelo recomienda Messages para Carbon, confirma la interfaz compatible en la página del modelo antes de adaptar un cliente basado en OpenAI.
Cuánto cuesta Gemini 4 Carbon en Felo
Felo ofrece Gemini 4 Carbon a través de cinco proveedores de Google, y todas las rutas tienen un descuento del 50 % en este momento. Los precios siguientes corresponden a 1 millón de tokens. Se muestran tanto la tarifa estándar como la tarifa con descuento.
| Ruta | Entrada | Salida | Lectura de caché |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
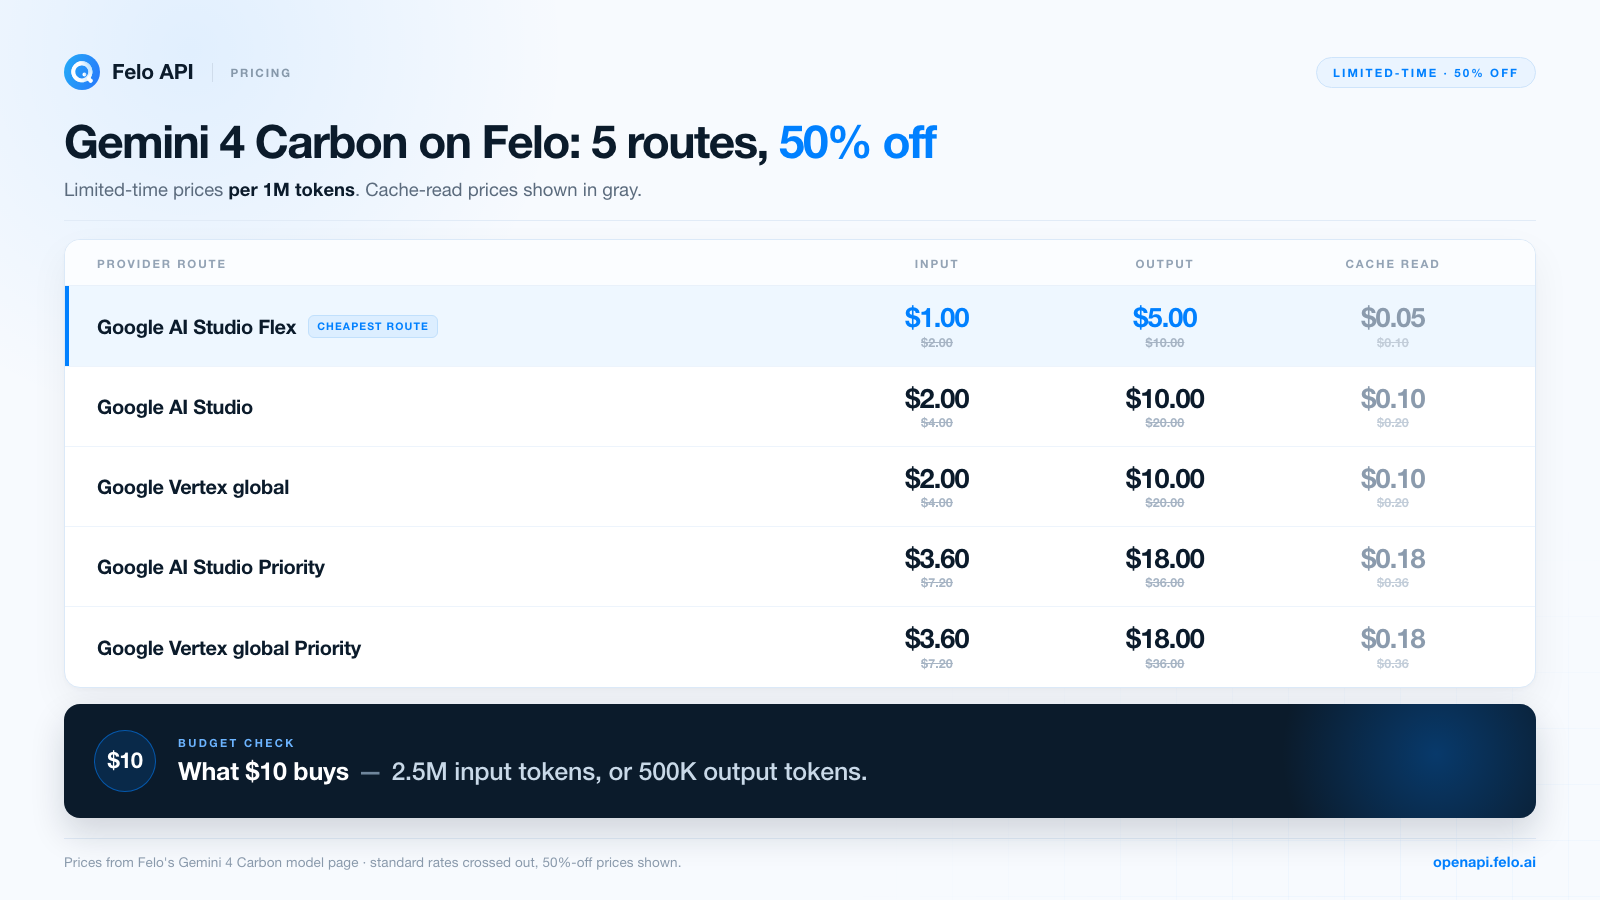
La página de precios de Felo traduce las tarifas estándar en una referencia práctica: «qué puedes comprar con $10». La cantidad equivale a cerca de 2.5 millones de tokens de entrada o 500,000 tokens de salida, antes de los descuentos. Es una referencia útil para calcular el tamaño de una prueba de concepto. Una prueba que envía paquetes de documentos de 100,000 tokens y recibe respuestas de 5,000 tokens cuesta cerca de $0.13 en la ruta Flex con la tarifa rebajada: $0.10 por la entrada y $0.025 por la salida. Este coste permite ejecutar decenas de pruebas antes de tomar una decisión.
La prueba gratuita es una oferta independiente de las tarifas con descuento. La página del modelo de Felo identifica Gemini 4 Carbon con una prueba gratuita por tiempo limitado. Es la forma más rápida de probar el modelo sin comprometer créditos. Consulta las condiciones actuales en la página del modelo, ya que la disponibilidad de la prueba y los descuentos de tarifas tienen una duración limitada y pueden cambiar.
La planificación de costes de este modelo requiere un hábito adicional. Como los tokens de razonamiento se facturan con la tarifa de salida, una ejecución de un agente con razonamiento HIGH puede costar varias veces más de lo que sugiere la respuesta visible. Registra el consumo de tokens por tarea, incluidos los tokens de razonamiento, y compara el coste por resultado aceptado en lugar del coste por solicitud.
Limitaciones y aspectos que debes verificar antes de comprometerte
Carbon es un modelo de frontera con debilidades documentadas. Estos son los aspectos relevantes para planificar su uso en producción:
- Alucinaciones. Google las incluye entre las limitaciones conocidas. Un contexto extenso reduce la posibilidad de omitir información, pero no garantiza una interpretación correcta. Los procesos de citación y verificación siguen siendo necesarios.
- Latencia y tiempos de espera. Google señala problemas ocasionales de lentitud y agotamiento del tiempo de espera. Las ejecuciones prolongadas con HIGH requieren tiempos de espera amplios, reintentos y gestión de tareas idempotentes.
- Mayor consumo de tokens. El modelo utiliza más tokens de razonamiento que Argon, sobre todo con niveles elevados. Ajusta el presupuesto y limita el esfuerzo en tareas rutinarias.
- Fecha límite de conocimiento: marzo de 2026. Cualquier información posterior requiere recuperación de datos o fuentes actuales. Carbon no conoce acontecimientos posteriores a esa fecha.
- Muestreo fijo. No es posible ajustar la temperatura, top-p ni top-k. Si tu proceso necesita resultados deterministas, reserva esa etapa para otro modelo.
- Sin caché explícita, ajuste fino, RAG Engine ni Live API. Cada una de estas carencias traslada trabajo a la capa de aplicación.
- Restricciones de disponibilidad. Google ofrece Carbon a clientes empresariales verificados en determinadas regiones. Felo lo distribuye a través de proveedores globales, de Estados Unidos y de la Unión Europea. Confirma la ruta y las condiciones aplicables a tu caso.
- Reglas de seguridad y acceso. La variante cibernética requiere autorización mediante una lista de permitidos, y los flujos de trabajo de seguridad necesitan permiso. Siguen vigentes las medidas de protección del modelo y las políticas de los proveedores.
Entonces, ¿deberías utilizarlo?
Utiliza Gemini 4 Carbon cuando la tarea sea extensa, las pruebas estén desordenadas y una respuesta incorrecta tenga un coste elevado: un plan de migración, una revisión de seguridad, una síntesis de investigación, un análisis financiero o jurídico, o un agente que deba investigar antes de actuar. Su perfil en los benchmarks y su presupuesto unificado están diseñados para este tipo de trabajo.
No lo utilices como opción predeterminada para todas las solicitudes. La clasificación de gran volumen, las extracciones breves, los resúmenes sencillos y cualquier tarea que requiera un muestreo determinista funcionan mejor con modelos más económicos y rápidos. El modelo más barato que cumpla tus requisitos de calidad suele ser la mejor elección. Carbon debe demostrar su valor en las tareas más difíciles de tu carga de trabajo.
La conclusión sincera: Carbon es el modelo de Google con mayor capacidad para trabajos de razonamiento profundo. Presenta fortalezas medidas en seguridad, derecho, finanzas y razonamiento con contextos extensos, pero también implica costes reales de latencia y consumo de tokens, además de limitaciones documentadas que hacen imprescindible la verificación. Pruébalo con tus propias tareas antes de desarrollar un sistema basado en él.
Preguntas frecuentes
¿Hay una prueba gratuita de Gemini 4 Carbon en Felo?
Sí. Felo ofrece Gemini 4 Carbon con una prueba gratuita por tiempo limitado, y las tarifas de los proveedores del modelo también tienen descuentos durante la vigencia de la oferta. Las condiciones pueden cambiar. Consulta la página del modelo Gemini 4 Carbon para conocer la disponibilidad actual.
¿Cuál es la diferencia entre Gemini 4 Carbon y Gemini 4 Argon?
Carbon está desarrollado sobre Argon y optimizado para un razonamiento más profundo. Utiliza un presupuesto unificado de 1,048,576 tokens que incluye entrada, razonamiento, llamadas a herramientas y salida; admite los niveles de razonamiento LOW, MEDIUM y HIGH; consume más tokens de razonamiento; y añade compatibilidad con archivos Office/OpenDocument y un posicionamiento más sólido en seguridad y protección. Argon sigue siendo una opción adecuada para generar contenido extenso cuando la longitud de salida importa más que la profundidad de verificación.
¿Cuál es la ventana de contexto y la salida máxima de Gemini 4 Carbon?
El presupuesto unificado es de 1,048,576 tokens e incluye la entrada y la salida. Un solo segmento con transmisión puede generar hasta 65,536 tokens de salida, o 32,768 sin transmisión. Las generaciones prolongadas permiten ampliar la salida hasta agotar el presupuesto restante. Felo indica una salida máxima de 943.718K tokens en su ruta.
¿Puede Gemini 4 Carbon leer audio, vídeo y archivos Office?
Sí. Admite texto, imágenes, audio, vídeo, PDF y archivos Office/OpenDocument. Sus límites son cerca de 8.4 horas de audio, entre 45 y 60 minutos de vídeo, 3,000 imágenes y documentos combinados y 3,000 páginas por documento. La salida es solo texto.
¿Gemini 4 Carbon admite API compatibles con OpenAI?
Felo recomienda su Messages API compatible con Anthropic para este modelo. También documenta endpoints de Chat Completions y Responses compatibles con OpenAI para los modelos que admiten estas interfaces. Confirma la interfaz actual en la página del modelo antes de modificar un cliente existente.
¿Cuánto cuesta Gemini 4 Carbon?
Felo ofrece cinco rutas de Google, todas con un descuento actual del 50 %: AI Studio Flex cuesta $1 por entrada y $5 por salida por millón de tokens; las rutas estándar de AI Studio y Vertex cuestan $2 / $10; y las rutas Priority cuestan $3.60 / $18. Las lecturas de caché comienzan en $0.05 por millón de tokens. Consulta la página de precios de Felo para conocer las tarifas vigentes.
¿Cuándo se lanzó Gemini 4 Carbon?
Google anunció Gemini 4 Carbon el 28 de octubre de 2026, con un lanzamiento inicial para un grupo selecto de especialistas en defensa de la ciberseguridad a través del programa Fairwind. La plataforma empresarial de Google indica disponibilidad general desde el 10 de noviembre de 2026. Felo ya distribuye el modelo a través de cinco proveedores de Google.
Prueba Gemini 4 Carbon en Felo
La forma más rápida de evaluar Carbon consiste en asignarle una tarea cuya respuesta ya conozcas. Abre el entorno de pruebas de Gemini 4 Carbon, pega un documento real o una muestra de código y compara el razonamiento LOW y HIGH con el mismo prompt. Si los resultados cumplen tus expectativas, crea una clave e incorpora la prueba a tu propio proceso.
Comienza en la página del modelo Gemini 4 Carbon para consultar las condiciones actuales de la prueba, las rutas de los proveedores y los límites. Después, desarrolla la prueba más pequeña posible en torno a la tarea más difícil que tengas.
Esta publicación también está disponible en English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, বাংলা and Português.