IA discriminative : modèles de décision, exemples et applications

Découvrez comment l’IA discriminative et les modèles de décision classent, acheminent et évaluent les données d’entrée, en quoi ils diffèrent de l’IA générative et comment les développeurs peuvent les utiliser.
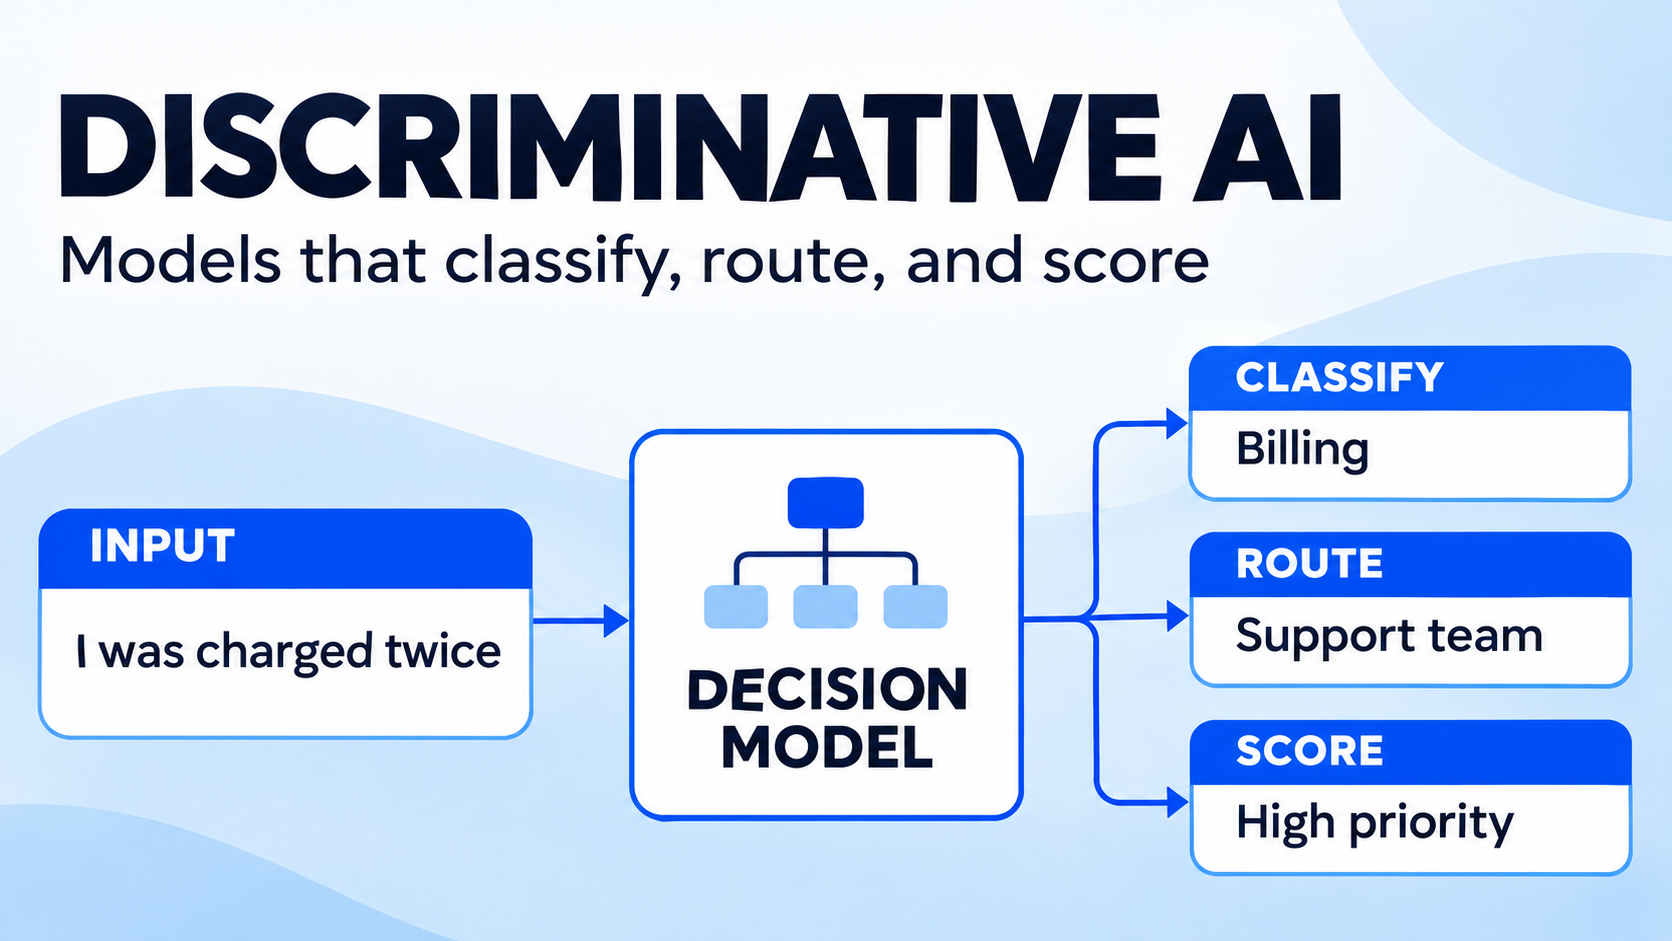
Une demande d’assistance arrive : « J’ai été facturé deux fois et je souhaite obtenir un remboursement. » Votre application n’a pas nécessairement besoin d’un paragraphe rédigé par un modèle d’IA. Elle doit peut-être prendre une décision : ce ticket doit-il être transmis au service de facturation, au support technique ou au service commercial ?
L’IA discriminative repose sur la prédiction d’une étiquette, d’un score ou d’une autre cible à partir d’une entrée. Une nouvelle catégorie de modèles de décision transpose cette idée aux API destinées aux développeurs : fournissez un contexte et une question définie à un modèle, qui renvoie une décision structurée ou des probabilités exploitables par un logiciel. Ce guide explique le fonctionnement de ces modèles, leur complémentarité avec l’IA générative et les méthodes d’évaluation.
Qu’est-ce que l’IA discriminative ?
L’IA discriminative prédit une caractéristique d’une entrée. Un filtre anti-spam prédit si un e-mail est indésirable ; un classificateur attribue un ticket d’assistance à une équipe ; un modèle de risque estime la probabilité d’un résultat défini.
En apprentissage automatique, les modèles discriminatifs apprennent en général une fonction qui associe une entrée x à une cible y, ou estiment la probabilité conditionnelle P(y | x). La cible peut être une classe, une valeur numérique ou une autre sortie structurée. La régression logistique, les machines à vecteurs de support et de nombreux classificateurs neuronaux sont des exemples d’approches discriminatives. Tous les modèles discriminatifs ne renvoient pas une probabilité, et tous les scores numériques ne sont pas bien calibrés.
Cette idée fondamentale précède les assistants IA actuels. La nouveauté réside dans la disponibilité d’API de décision polyvalentes qui acceptent des descriptions de tâches et des choix de réponse en langage naturel. Les développeurs peuvent ainsi appliquer une même interface à de nombreuses tâches de classification ou d'évaluation.
Qu’est-ce qu’un modèle de décision IA ?
Dans le paysage actuel des API, un modèle de décision désigne en général un modèle ou un service conçu pour répondre à des questions délimitées sur une entrée fournie. Au lieu de rédiger une réponse libre, il renvoie un résultat typé, tel que :
- Probabilité oui/non : Quelle est la probabilité que ce message contienne une demande de remboursement ?
- Choix : Quel service doit recevoir ce ticket ?
- Score : Où cette réponse se situe-t-elle sur une grille d’évaluation de qualité définie ?
Par exemple, un modèle de décision peut renvoyer une étiquette « facturation » ainsi que des estimations de probabilité pour chaque service. Votre application peut exploiter ces résultats pour acheminer le ticket, demander des informations supplémentaires ou le transmettre à un évaluateur humain.
TypeSafe désigne sa famille Jev comme des modèles « System One ». Liquid AI présente son modèle de décision d1 comme un modèle qui accepte du texte et des images et renvoie des probabilités sans générer de jetons de sortie. Le Codelab de Google sur les modèles discriminatifs montre comment utiliser un modèle de décision aux côtés d’un modèle génératif dans une application.
Ces termes sont liés, mais ne sont pas interchangeables. La modélisation discriminative est un vaste concept d’apprentissage automatique ; un modèle de décision est un produit ou une interface destiné aux décisions délimitées. Un modèle génératif peut aussi classer du texte à partir d'une instruction, même si son processus de génération sous-jacent et son format de réponse diffèrent.
Prenons l’exemple du ticket de remboursement. Un modèle de décision peut identifier le problème comme relevant de la facturation et estimer son degré d’urgence. Un modèle génératif peut ensuite rédiger une réponse empathique à partir de la politique de remboursement applicable. L’application doit encore vérifier les règles, les autorisations et toute approbation humaine requise avant d’agir.
IA discriminative vs IA générative
| IA discriminative | IA générative | |
|---|---|---|
| Question type | « Quelle catégorie correspond à cette entrée ? » | « Quelle réponse ou quel contenu faut-il produire ? » |
| Sortie courante | Étiquette, prédiction, score ou probabilité | Texte, code, image, audio ou autre contenu généré |
| Exemple de tâche | Acheminer un ticket client | Rédiger une réponse au client |
| Atout à examiner | Décisions cohérentes et délimitées, scores exploitables | Synthèse flexible, explications et création |
| Principal enjeu d’évaluation | Erreurs de classification, calibration et seuils | Exactitude, respect des instructions, sécurité et utilité |
La distinction ne signifie pas qu’un modèle ne peut effectuer qu’un seul type de tâche. Un LLM peut renvoyer des étiquettes au format JSON, et un système de décision peut intégrer un modèle génératif dans un flux de travail plus vaste. La différence pratique concerne les fonctions que chaque composant est optimisé pour remplir et les capacités qu’il expose. Une réponse d’API structurée ne prouve pas, à elle seule, que ses probabilités sont calibrées ou que son modèle sous-jacent est discriminatif.
Prenons le ticket de remboursement. Un modèle de décision peut identifier le problème comme relevant de la facturation et estimer son urgence. Un modèle génératif peut ensuite rédiger une réponse empathique à partir de la politique de remboursement applicable. L’application doit encore vérifier les règles, les autorisations et toute approbation humaine requise avant d’agir.
Fonctionnement des modèles de décision dans une application
Le schéma exact varie selon le fournisseur, mais une requête de décision type comporte trois éléments :
- État : Les informations à évaluer, comme le texte d’un ticket ou une image.
- Question et critères : La décision à prendre et les descriptions des réponses autorisées ou des niveaux de score.
- Réponse typée : Une étiquette, un score ou une distribution de probabilités que l’application doit interpréter.
Par exemple :
State: "I was charged twice for my subscription."
Question: Which team should handle this request?
Options: billing, technical support, sales
Illustrative result: billing
Il s’agit d’un exemple conceptuel, et non d’une réponse réelle d’API. Selon le point de terminaison, le modèle peut aussi fournir un niveau de confiance ou des probabilités. Consultez la documentation du modèle et de l’API concernés au lieu de supposer que tous les fournisseurs utilisent le même format de requête ou prennent en charge les mêmes modalités.
Que signifient les scores de probabilité ?
Une probabilité prédite n’est utile que si vous comprenez sa fiabilité. Si un système attribue un score de 0,8 à de nombreuses prédictions similaires, un système bien calibré devrait obtenir un taux de réussite d’environ 80 % sur cet ensemble. Un score individuel de 0,8 ne garantit pas qu’une décision particulière soit correcte.
Vérifiez la calibration sur vos propres données, en particulier après un changement de modèle, d’étiquettes, de langues ou de sources d’entrée. Vous pouvez définir des seuils pour envoyer les cas à faible niveau de confiance vers une procédure de vérification, mais choisissez ces seuils en fonction du coût des faux positifs et des faux négatifs. Une file d’examen des fraudes et une recommandation de contenu sans risque nécessitent des règles différentes.
Exemples et cas d’utilisation de l’IA discriminative
Classification et acheminement des tickets d’assistance
Un modèle de décision peut attribuer les messages entrants à la facturation, au support technique ou à la gestion des comptes. Ajoutez une catégorie « autre » ou « à vérifier » pour les demandes ambiguës et testez les messages qui comportent plusieurs problèmes. Évaluez le taux d’erreur par catégorie, et pas seulement la précision globale : un modèle qui ne détecte pas les réclamations urgentes liées à la facturation peut obtenir de bons résultats sur un jeu de données dominé par des questions courantes.
Modération de contenu
Un flux de modération peut demander si un contenu relève d’une catégorie définie par une politique. Fournissez au modèle des critères clairs et des exemples, évaluez les cas limites et transmettez les cas incertains ou à fort impact à des évaluateurs formés. Un score de décision constitue une donnée d’entrée pour votre processus de modération, et non une preuve qu’un contenu enfreint une règle.
Acheminement des LLM et des agents
Avant d’appeler un LLM, une application peut classer une demande selon son sujet, sa complexité ou la modalité requise. Un composant de routage peut ensuite sélectionner un flux de travail ou demander des informations supplémentaires. Testez le routage avec le système en aval : une première étape peu coûteuse n’apporte aucun avantage si elle envoie de façon répétée les demandes complexes vers le mauvais parcours.
Triage des documents et des images
Un modèle de décision multimodal peut classer une image ou un document dans une catégorie prédéfinie, telle qu’une facture, un reçu ou une capture d’écran d’assistance. Vérifiez que le point de terminaison concerné prend en charge le format d’entrée et le traitement des images dont vous avez besoin. La classification se distingue de l’extraction de tous les champs d’un document ; vérifiez si le modèle et l’API choisis prennent en charge ces deux tâches.
Évaluation selon une grille
Un modèle peut attribuer à une réponse une position sur une échelle ordonnée à partir de descriptions telles que « éléments essentiels manquants », « partiellement étayé » et « entièrement étayé ». Vérifiez si les évaluateurs sont d’accord avec les étiquettes et si le modèle traite les réponses similaires de manière cohérente. Évitez de présenter les scores de la grille comme des mesures objectives sans validation.
Modèles de décision disponibles dans le catalogue de modèles Felo
Le catalogue de modèles Felo comprend un filtre de sortie Decisions. Selon le catalogue au 2 novembre 2026, voici quelques exemples :
| Modèle répertorié | Utilisation décrite | Entrées indiquées dans le catalogue |
|---|---|---|
| TypeSafe Jev 1.14 | Routage, classification et modération | Texte et image ; la fiche indique que la prise en charge des images est expérimentale |
| LiquidAI d1.1 | Décisions oui/non, choix et scores | Texte et image |
| Baseten Joey 1 | Classification et routage | Texte et image |
| Perplexity Decider Flash V1.2 | Classification, routage et évaluation | Texte et image |
Ces descriptions reflètent le contenu du catalogue. Elles ne constituent ni des tests de performances indépendants ni une recommandation désignant un modèle comme le meilleur. La disponibilité, la prise en charge des fonctionnalités, les limites de contexte et les tarifs peuvent évoluer. Consultez la fiche et la documentation du point de terminaison en vigueur avant tout développement, en particulier pour les fonctionnalités expérimentales ou multimodales. La présence d’un modèle dans le catalogue ne garantit pas que toutes les fonctionnalités de l’API native du fournisseur soient accessibles sur chaque plateforme.
Comment évaluer un modèle de décision IA
Commencez par une décision bien délimitée et un ensemble d’exemples représentatifs dotés d’étiquettes fiables. Incluez des cas difficiles, des catégories minoritaires, des contextes incomplets et des exemples qui nécessitent une intervention humaine. Comparez ensuite le modèle à une référence simple, à un classificateur existant ou à un LLM produisant une sortie structurée.
Ne vous limitez pas à la précision :
- Précision et rappel : Quelles erreurs sont importantes et à quelle fréquence surviennent-elles pour chaque classe ?
- Calibration : Les probabilités prédites correspondent-elles aux résultats observés sur différents groupes de cas ?
- Couverture : Quelle proportion des demandes peut être traitée automatiquement avec le seuil choisi ?
- Latence et fiabilité : L’appel API complet répond-il à vos exigences de production ?
- Coût : Quel est le coût par décision utile, en incluant les nouvelles tentatives, les questions multiples, le traitement des images et la vérification humaine ?
- Robustesse : Les performances restent-elles stables selon les langues, les formats, les exemples inconnus et l’évolution du trafic ?
Utilisez un jeu de test distinct après le réglage des étiquettes et des seuils. En production, consignez les résultats lorsque cela est approprié, examinez les désaccords et procédez à une nouvelle évaluation lorsque la version du modèle, la politique ou la distribution des données d’entrée change. Pour les décisions à fort impact, prévoyez une supervision humaine adaptée et vérifiez les exigences applicables.
Foire aux questions
L’IA discriminative est-elle identique à un modèle de décision ?
Pas exactement. L’IA discriminative désigne une vaste approche qui consiste à prédire une cible à partir d’une entrée. Les modèles de décision constituent une catégorie de produits plus récente, axée sur des sorties délimitées telles que des choix, des scores et des probabilités. Certains modèles de décision utilisent des techniques discriminatives, mais ces deux termes ne désignent pas la même chose.
Un LLM peut-il effectuer une classification ou prendre des décisions ?
Oui. Un LLM génératif peut recevoir une instruction de classification de contenu ou de production de sorties structurées. La question de savoir si un modèle de décision dédié offre de meilleures performances, une vitesse supérieure ou un coût inférieur dépend de la tâche, du modèle, du fournisseur et de la méthode d’évaluation. Testez les deux solutions sur vos propres exemples.
Les probabilités des modèles de décision sont-elles toujours exactes ?
Non. Un modèle peut produire des probabilités mal calibrées sur un jeu de données ou un sous-groupe particulier. Mesurez la calibration et les conséquences des erreurs avant d’utiliser des seuils pour automatiser un flux de travail.
Dans quels cas faut-il privilégier l’IA générative ?
Utilisez un modèle génératif lorsque la tâche nécessite la rédaction, l’explication, la synthèse ou la production de contenu ouvert. Dans de nombreuses applications, un modèle de décision et un modèle génératif fonctionnent ensemble : le premier achemine ou classe les demandes, tandis que le second crée la réponse.
L’IA discriminative offre aux développeurs un moyen d’intégrer des décisions explicites et mesurables dans un flux de travail. Commencez par une tâche bien délimitée, testez les erreurs qui comptent et déterminez le niveau d’automatisation que les résultats permettent de justifier.
Découvrir les modèles de décision dans le catalogue Felo →
Cet article est également disponible en English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.