
Gemini 4 Carbon sur Felo API : spécifications, benchmarks, tarifs et cas d'utilisation

Gemini 4 Carbon sur Felo API : son budget unifié de 1 million de tokens, ses niveaux de raisonnement, ses limites multimodales, ses benchmarks publiés, ses tarifs et son utilisation via API.
Gemini 4 Carbon de Google est un modèle conçu pour les tâches complexes qui dépassent le cadre d'une simple requête : une migration de base de code impliquant des dizaines de services, une recherche de vulnérabilités qui doit aboutir à un correctif fonctionnel ou une question de recherche qui exige une chaîne de preuves plutôt qu'un paragraphe rempli d'affirmations.
Le modèle est accessible via Felo API, qui propose une offre d'essai gratuit à durée limitée ainsi que des tarifs fournisseurs réduits. Vous pouvez accéder au modèle, tester des prompts dans le playground et créer une clé depuis la page Gemini 4 Carbon sur Felo avant de poursuivre la lecture de ce guide.
Cet article est un guide pratique, pas une annonce de lancement. Il présente la nature de Carbon, ses différences avec Gemini 4 Argon, les enseignements et les limites des benchmarks publiés, le fonctionnement de son budget de tokens inhabituel, ses points forts, ses limites et ses tarifs sur Felo.
Qu'est-ce que Gemini 4 Carbon ?
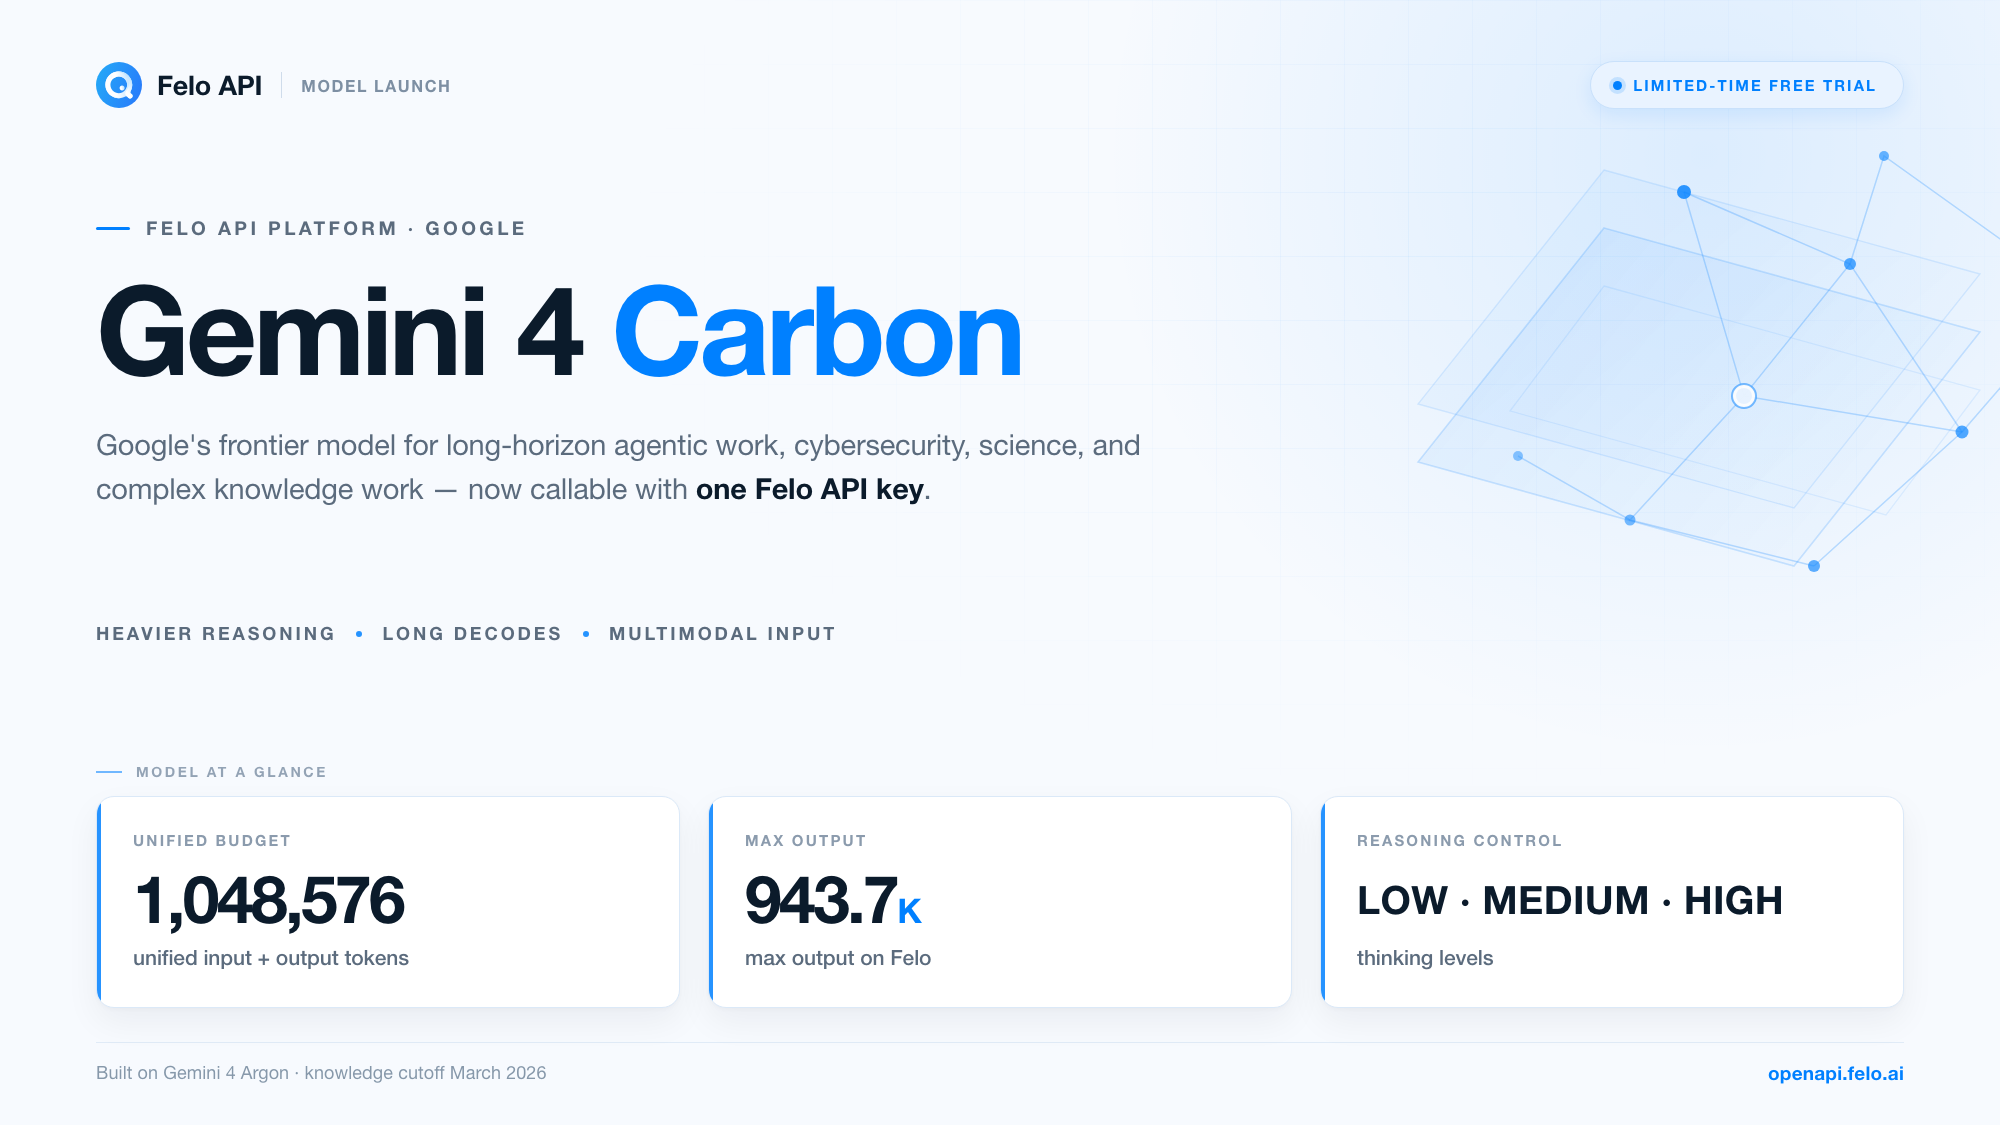
Gemini 4 Carbon est le modèle de pointe de Google pour les tâches agentiques de longue durée dans les domaines du développement logiciel, de la finance, du droit, de la cybersécurité et des sciences. Google l'a annoncé le 28 octobre 2026. Le modèle repose sur Gemini 4 Argon et a d'abord été mis à la disposition d'un groupe restreint de spécialistes de la cybersécurité dans le cadre du programme Fairwind. La documentation de la plateforme d'entreprise de Google répertorie désormais le modèle comme étant en disponibilité générale, avec une date de lancement fixée au 10 novembre 2026.
Le nom « Carbon » ne désigne pas une nouvelle génération de modèles. Il correspond à un positionnement différent au sein de la famille Gemini 4. Argon a été optimisé pour produire de longs documents cohérents en une seule trajectoire, tandis que Carbon consacre une plus grande part de son budget au raisonnement : exploration d'hypothèses, cycles de vérification et coordination de tâches en plusieurs étapes. Selon Google, Carbon utilise davantage de tokens de raisonnement qu'Argon pour parvenir à ses réponses.
Ce choix a un coût. Le modèle est plus lent sur les tâches complexes, peut subir des dépassements de délai dans certaines conditions et consomme davantage de tokens avec les niveaux de raisonnement élevés. Google mentionne explicitement ces limites. L'intérêt de Carbon réside dans les tâches auxquelles il est destiné — analyse de sécurité, migrations à grande échelle, raisonnement scientifique et examen de documents à forts enjeux — où la profondeur compte davantage que la vitesse.
Spécifications du modèle en un coup d'œil
| Spécification | Valeur |
|---|---|
| ID du modèle sur Felo | gemini-4-carbon |
| Date d'annonce | 28 octobre 2026 |
| Modèle de base | Gemini 4 Argon |
| Contexte et sortie | Un budget unifié de 1 048 576 tokens couvrant les entrées et les sorties |
| Sortie maximale indiquée sur Felo | 943.718K tokens |
| Entrées | Texte, images, audio, vidéo, PDF et fichiers Office/OpenDocument |
| Sorties | Texte |
| Niveaux de raisonnement | LOW, MEDIUM (par défaut), HIGH |
| Date limite des connaissances | Mars 2026 |
| Paramètres d'échantillonnage | Température 1.0, top-p 0.95, top-k 64, paramètres fixes |
| Mise en cache | Mise en cache implicite uniquement, minimum de 4 096 tokens |
| Interface Felo recommandée | Messages API (compatible avec Anthropic) |
| Accès | Clients professionnels vérifiés dans certaines régions ; variante cyber accessible sur liste d'autorisation |
Deux éléments de ce tableau méritent une explication détaillée, car ils influencent la conception des applications utilisant ce modèle : le budget unifié de tokens et les niveaux de raisonnement.
Différences entre Gemini 4 Carbon et Gemini 4 Argon
Carbon et Argon appartiennent à la même famille, partagent la même date limite de connaissances et présentent de nombreux points communs dans leur positionnement. Leurs différences concernent la manière dont chaque modèle utilise ses capacités.
Un budget unifié pour les entrées et les sorties. Argon est généralement présenté avec une fenêtre de contexte de 1 048 576 tokens et une limite de sortie par défaut distincte de 65 536 tokens. Pour Carbon, les 1 048 576 tokens couvrent ensemble les entrées, le raisonnement, les appels d'outils et la réponse finale. Il s'agit d'un budget unique, et non d'une fenêtre de contexte à laquelle s'ajoute une allocation de sortie.
Un raisonnement plus approfondi par défaut. Carbon propose trois niveaux de raisonnement : LOW, MEDIUM et HIGH. MEDIUM est le niveau par défaut pour gemini-4-carbon, tandis que HIGH est celui de la variante autorisant les usages cyber. Le modèle est conçu pour effectuer de longs cycles de vérification. Google présente donc sa consommation élevée de tokens comme une limite connue, et non comme un dysfonctionnement.
Des générations longues. Un segment unique en premier plan peut générer jusqu'à 65 536 tokens de sortie en streaming, ou 32 768 tokens sans streaming. Pour dépasser cette limite, il faut utiliser les générations prolongées (long decodes) : le SDK Google Gen AI et Agent Studio gèrent automatiquement un jeton de continuation, ou vous pouvez mettre en place une boucle de continuation personnalisée. La limite théorique correspond au budget unifié total, moins les tokens d'entrée.
Une meilleure prise en charge des fichiers. Carbon accepte les fichiers Microsoft Office et OpenDocument — .docx, .doc, .pptx, .ppt, .xlsx, .xls, .odt, .odp, .ods — en ligne ou depuis un espace de stockage cloud, en plus des PDF et du texte brut. Cette fonctionnalité est utile lorsque votre flux de travail commence par une présentation, un tableur ou un contrat plutôt que par une exportation de texte brut.
Optimisation de la sécurité et variante cyber distincte. Google indique que les alertes de désalignement à gravité élevée ont diminué de près de 80 % dans les environnements de développement en direct. Google rapporte également que Carbon dépasse Argon de 3,50 points de pourcentage en matière de sécurité des contenus multilingues et multimodaux lors des évaluations de sécurité texte-vers-texte. Il existe aussi gemini-4-carbon-cyber-permissive, une variante réservée aux utilisateurs figurant sur une liste d'autorisation pour les activités de sécurité défensive. Elle utilise HIGH par défaut et désactive l'utilisation de l'ordinateur.
Comportement adapté aux sciences. Selon Google, le modèle peut traduire des objectifs de sécurité en théorèmes mathématiques et découvrir de manière autonome des homologues distants dans des archives de séquences à l'échelle du péta-base. Google rapporte une augmentation moyenne de 40 fois de la récupération d'homologues pour les familles de protéines présentant peu d'homologues. Cette affirmation concerne une tâche de recherche précise. Il convient de la reproduire sur vos propres données plutôt que de la considérer comme une capacité générale.
Explication du budget unifié de tokens
La plupart des pages de modèles présentent deux chiffres : une fenêtre de contexte et une limite maximale de sortie. Carbon présente un seul chiffre, accompagné d'une limite par segment. Si vous planifiez vos requêtes selon l'ancienne méthode, vous risquez de surestimer l'espace disponible ou de mal interpréter votre facture.
Voici la répartition réelle du budget :
- Entrées — votre prompt, les documents joints, les images, les fichiers audio, les vidéos, les images extraites des vidéos et l'historique de conversation.
- Raisonnement — les tokens que le modèle utilise pour réfléchir avant de répondre. Avec le niveau HIGH, cette consommation peut être importante.
- Appels d'outils — toutes les opérations invoquées par le modèle lorsque les outils sont activés.
- Réponse finale — le texte que vous recevez.
Ces quatre éléments utilisent le même budget de 1 048 576 tokens. Une requête contenant 900K tokens d'entrée ne laisse pas 1M de tokens pour la sortie. Elle laisse environ 148K tokens pour le raisonnement, les outils et la réponse combinés, avant toute continuation.
La limite par segment est distincte. Dans une requête en streaming, un segment peut atteindre 65 536 tokens de sortie ; sans streaming, cette limite est de 32 768 tokens. Les générations prolongées permettent de dépasser la limite du segment jusqu'à épuisement du budget unifié. Si votre intégration interprète max_tokens comme une garantie de sortie totale, cette interprétation est incorrecte : ce paramètre limite un segment, tandis que le mécanisme de continuation du SDK permet de produire un document long.
La page du modèle sur Felo indique une sortie maximale de 943.718K tokens. Considérez cette valeur comme le plafond de sortie sur la route Felo, et non comme une seconde fenêtre de contexte plus grande. Avec un budget unifié, l'espace disponible pour votre réponse dépend du volume de données envoyé.
La conséquence pour la conception est simple : définissez d'abord la taille de sortie, puis adaptez les entrées à cette limite. Pour un rapport long, réservez le budget nécessaire à la sortie et au raisonnement, puis réduisez les sources en conséquence. Pour l'analyse d'un grand ensemble de documents, prévoyez une réponse plus courte que les entrées et organisez le travail en continuations ou en prompts successifs.
Niveaux de raisonnement : origine de la qualité
Carbon propose trois niveaux de raisonnement : LOW, MEDIUM et HIGH. MEDIUM est le niveau par défaut. La documentation de Google précise que thinking_budget et thinking_level="MINIMAL" entraînent une erreur de validation. Il n'est donc pas possible de ramener le raisonnement à zéro.
La différence pratique entre ces niveaux est importante. Avec LOW, le modèle se comporte comme un modèle conversationnel de pointe rapide : il convient à l'extraction, à la classification, à la reformulation et aux vérifications de code courantes. Avec MEDIUM, il consacre davantage de tokens à la planification et à l'auto-vérification. Avec HIGH, il effectue des cycles de vérification plus longs. Ce niveau offre les meilleures chances de détecter une erreur subtile, mais présente aussi le risque le plus élevé de lenteur et de coût.
Quelques règles pratiques :
- Adaptez le niveau au coût d'une mauvaise réponse. Si une erreur est peu coûteuse à détecter et à corriger, choisissez LOW. Si une erreur peut atteindre la production ou se retrouver dans un document juridique, testez HIGH.
- Mesurez les tokens par résultat accepté, et non les tokens par requête. Un raisonnement plus approfondi peut réduire les nouvelles tentatives et les reprises. Il peut aussi multiplier les coûts pour des tâches que le modèle aurait résolues avec MEDIUM. Comparez le coût du processus complet.
- Ne supposez pas que le niveau utilisé pour les benchmarks correspond à votre configuration. Les chiffres publiés par Google ne précisent pas toujours le niveau de raisonnement utilisé. Testez vos propres tâches avec deux niveaux avant de prendre une décision.
Les paramètres d'échantillonnage sont fixes : température 1.0, top-p 0.95 et top-k 64. Les valeurs personnalisées sont ignorées. Si votre pipeline dépend d'une détermination à faible température, Carbon ne convient pas à cette étape. Utilisez-le pour le jugement et la synthèse, et confiez les étapes déterministes à un modèle qui respecte les paramètres d'échantillonnage.
Publications de Google : benchmarks et interprétation
La page du modèle sur Felo rassemble les résultats des benchmarks publiés par le fournisseur pour Carbon. Les comparaisons ci-dessous donnent des indications générales : elles proviennent de Google ou du fournisseur d'évaluation, n'ont pas fait l'objet d'une réplication indépendante pour cet article et décrivent des conditions de test plutôt que votre charge de travail.
| Évaluation | Mesure | Gemini 4 Carbon | Contexte |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | Indice composite de raisonnement | 59 | Première place ; Claude Opus 5.5 obtient 58 |
| SEC-bench Pro | Détection de vulnérabilités | 88.2% | Sécurité, analyse défensive |
| CWE-bench | Correction de vulnérabilités | 71.0% | Sécurité, remédiation |
| ExploitGym | Exploitation de vulnérabilités | 54.8% | Recherche en sécurité, environnements contrôlés |
| Terminal-Bench 4.0 | Taux de triche réussie | 0.0% | Résistance au détournement des récompenses, et non capacité |
| Vals Index | Indice composite de travail intellectuel | 70.45% | Rang 3 sur 36 modèles |
| Legal Research Bench | Recherche juridique | 55.77% | Rang 1 |
| General Financial Intelligence | Tâches financières | #1 | Première place parmi 23 configurations de pointe, selon Balyasny Asset Management |
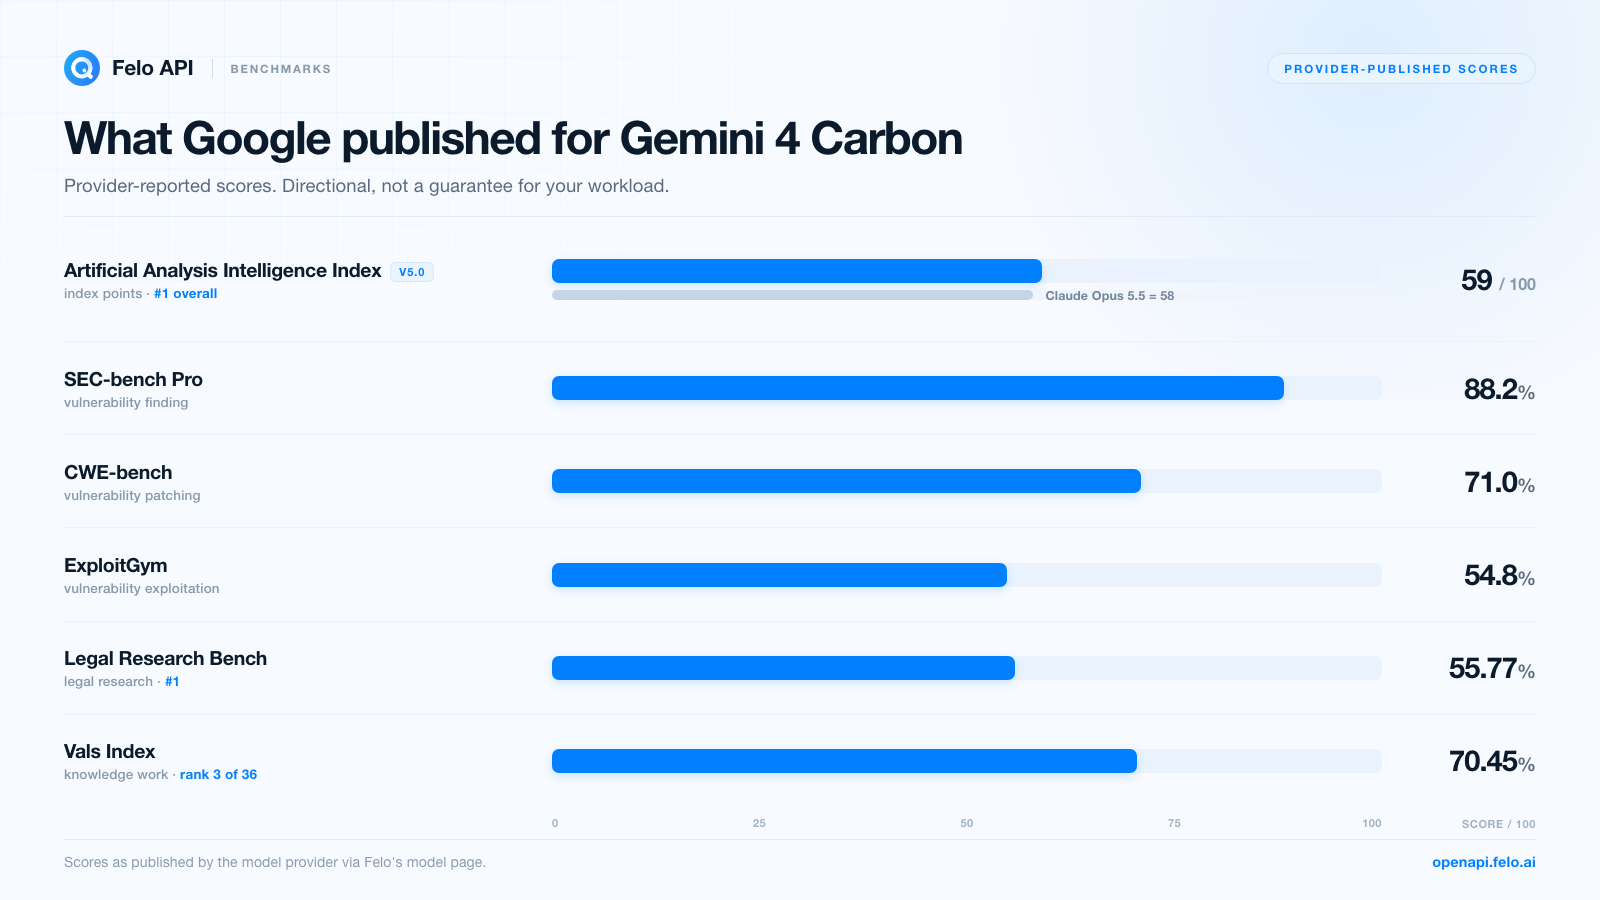
Une lecture attentive du tableau fait ressortir trois éléments.
Les scores de sécurité couvrent un cycle complet, et non une seule compétence. Détecter des vulnérabilités, rédiger des correctifs et exploiter des vulnérabilités sont des compétences distinctes. Les résultats publiés de Carbon sont les plus élevés pour la détection (88.2% sur SEC-bench Pro) et plus faibles pour l'exploitation (54.8% sur ExploitGym), tandis que la correction se situe entre les deux (71.0% sur CWE-bench). Ce profil correspond aux activités défensives : analyse, triage et remédiation. Si vous avez besoin d'une exploitation autonome, le score est plus faible et les règles d'accès sont plus strictes.
La mesure du taux de triche concerne la fiabilité, pas l'intelligence. Le « taux de triche réussie » de Terminal-Bench 4.0 mesure la capacité d'un modèle à détourner un benchmark plutôt qu'à résoudre la tâche. Un résultat de 0.0% indique une résistance au détournement des récompenses. Cette caractéristique compte lorsque vous laissez un agent fonctionner sans supervision. Il ne s'agit pas d'un score de capacité et il ne faut pas le comparer aux résultats exprimés en pourcentage de réponses correctes dans les autres lignes du tableau.
Les classements liés au travail intellectuel sont les plus pertinents pour la majorité des équipes. La troisième place sur 36 modèles dans le Vals Index, la première place sur Legal Research Bench et la première place dans la comparaison financière de Balyasny décrivent le type de travail qui justifie l'utilisation d'un modèle de pointe : lire de nombreux documents, rapprocher des éléments contradictoires et produire un résultat qu'un professionnel peut examiner. Ces résultats dépendent aussi fortement de la conception des prompts et de la qualité des sources. Considérez-les comme une raison de tester le modèle, et non comme une raison de supprimer les tests.
Une autre réserve s'impose : le score Artificial Analysis est un indice composite, et l'écart d'un point avec Claude Opus 5.5 reste assez faible pour qu'une autre combinaison de tâches inverse le classement. Sur les tâches précises qui vous intéressent, les deux modèles peuvent présenter des écarts importants, dans un sens comme dans l'autre.
Les cas d'utilisation concrets de Gemini 4 Carbon
Les benchmarks constituent une carte, pas le territoire. Voici les charges de travail pour lesquelles les choix de conception de Carbon correspondent aux besoins.
Développement logiciel à grande échelle et migrations
Carbon cible les tâches d'ingénierie qui nécessitent une collaboration entre plusieurs agents, le débogage quotidien, les migrations de grandes bases de code et la conception d'algorithmes. Le budget unifié est un atout dans ce contexte : vous pouvez charger une cartographie du dépôt, les fichiers sources pertinents, les résultats des tests en échec et les exigences de migration dans une seule requête, puis demander un plan avant toute modification du code.
Voici un exemple de prompt adapté à ce type de modèle :
Lisez la cartographie du dépôt jointe ainsi que les trois modules de service. Identifiez tous les points d'appel concernés par le remplacement de l'interface de session, dressez la liste des risques de compatibilité et proposez un ordre de migration. N'écrivez pas encore de code. Signalez tout élément que vous n'avez pas pu vérifier à partir des fichiers fournis.
Demandez d'abord un plan. Autorisez l'exécution des tests après avoir examiné ce plan. Confiez toujours l'examen des différences de code à un humain : un modèle capable de produire un bon plan peut aussi générer un correctif qui compile, mais dont le comportement reste incorrect.
Cybersécurité défensive
Le profil des benchmarks de sécurité — forte capacité de détection, bonne capacité de correction et capacité d'exploitation plus faible — correspond aux activités défensives : analyse d'une base de code pour détecter des catégories de vulnérabilités, triage des résultats des scanners, proposition de correctifs et explication des risques dans un langage exploitable par les évaluateurs. La variante cyber de Google est conçue pour ces tâches, mais son accès est réservé aux utilisateurs autorisés dans le cadre du programme Fairwind et nécessite une approbation distincte.
Deux précautions sont nécessaires. Premièrement, n'exécutez des opérations de sécurité que sur des systèmes que vous êtes autorisé à tester. Deuxièmement, vérifiez les résultats avant toute intervention : un modèle qui signale une vulnérabilité avec une grande confiance peut se tromper, et le coût d'un faux positif correspond à du temps d'ingénierie perdu.
Recherche scientifique et technique
Les capacités scientifiques rapportées sont précises : traduction d'objectifs de sécurité en théorèmes mathématiques et recherche d'homologues distants dans des archives de séquences à l'échelle du péta-base. Si vous travaillez dans un laboratoire ou un groupe de recherche, une méthode efficace consiste à fournir à Carbon une question bien délimitée, la littérature ou les séquences pertinentes, ainsi qu'une consigne qui distingue les preuves des déductions.
L'affirmation concernant une multiplication par 40 de la récupération d'homologues est remarquable, mais elle concerne des familles de protéines présentant peu d'homologues dans un pipeline précis. Reproduisez ce résultat sur un benchmark approuvé par votre équipe avant de construire un flux de travail autour de cette capacité.
Finance, droit et examen de documents à forts enjeux
Les classements de Carbon dans les tâches intellectuelles constituent son principal argument de vente pour les services professionnels. Les tâches concernées comprennent le rapprochement de grands livres comptables, l'analyse des écarts, l'examen de la jurisprudence et des documents réglementaires, ainsi que la rédaction de notes accompagnées de citations. Le modèle peut lire des images et des PDF. Les documents numérisés et les graphiques constituent donc des entrées exploitables.
Cela ne supprime pas l'étape de vérification. Fournissez les sources, demandez au modèle de citer le passage qui justifie chaque conclusion et vérifiez les références. Même un modèle capable de gérer un million de tokens de contexte peut mal interpréter la page 412.
Agents de longue durée avec outils
Carbon prend en charge les appels de fonctions, les sorties structurées, l'exécution de code, le contexte URL, l'utilisation de l'ordinateur et plusieurs options d'ancrage, dont Google Search, Google Maps et des fournisseurs de recherche tiers. Il prend aussi en charge la compréhension agentique des vidéos, une fonctionnalité utile lorsque l'entrée est un enregistrement plutôt qu'un document.
Cette approche est la plus exigeante pour le modèle et celle qui risque le plus d'épuiser les tokens. Instrumentez votre agent : enregistrez les appels d'outils, limitez le nombre d'itérations et exigez un résumé des éléments vérifiés avant toute action. Le budget de 1M rend possibles des agents ambitieux ; il ne les rend pas économiques.
Entrées multimodales et limites
Carbon accepte le texte, les images, l'audio, la vidéo, les PDF et les documents Office, et produit du texte. Les limites sont généreuses, mais précises. Elles comptent davantage que la simple liste des modalités prises en charge.
| Type d'entrée | Limite pratique |
|---|---|
| Audio | Environ 8,4 heures par prompt, ou jusqu'à 1M de tokens ; jusqu'à 1 000 fichiers audio |
| Vidéo | Environ 45 minutes avec audio, environ 1 heure sans audio ; jusqu'à 10 vidéos par prompt |
| Images et documents | Jusqu'à 3 000 éléments combinés par prompt |
| Documents | Jusqu'à 3 000 pages par fichier |
| Formats Office | .docx, .doc, .pptx, .ppt, .xlsx, .xls |
| Formats OpenDocument | .odt, .odp, .ods |
| Taille des entrées | 500 MiB compressés sur l'API GenerateContent ; 256 MiB sur l'API Interactions |
La limite audio est l'élément le plus remarquable. Huit heures d'audio dans une seule requête changent les possibilités d'une équipe qui organise de nombreuses réunions : au lieu de transcrire et de découper les fichiers, vous pouvez fournir une journée complète d'appels et demander une synthèse des thèmes, des décisions et des questions en suspens. Le coût reste lié aux tokens, et les tokens audio sont facturés comme des tokens d'entrée. Le chargement d'une journée complète d'enregistrements n'est donc pas gratuit.
La limite vidéo correspond davantage à un usage courant : 45 minutes de vidéo avec audio suffisent pour un cours, une démonstration de produit ou un entretien enregistré, mais pas pour une conférence complète.
Certaines lacunes fonctionnelles doivent être prises en compte. Gemini Live API n'est pas pris en charge, ce qui exclut la voix en temps réel. RAG Engine et le réglage du modèle ne sont pas pris en charge non plus : la récupération d'informations et le fine-tuning doivent donc être gérés dans la couche applicative. La mise en cache explicite du contexte n'est pas non plus disponible. Seule la mise en cache implicite est prise en charge, avec un minimum de 4 096 tokens, ce qui influence la planification des coûts pour les prompts longs répétés.
Comment appeler Gemini 4 Carbon sur Felo
Felo recommande l'API Messages pour ce modèle. Le point de terminaison accepte un format de requête compatible avec Anthropic à l'adresse https://openapi.felo.ai/api/v1/messages, et l'ID du modèle est gemini-4-carbon.
Le processus est identique à celui des autres modèles Felo :
- Créez une clé API Felo. Les clés sont créées dans la console Felo et stockées sous
FELO_API_KEY. Ne publiez pas cette clé dans votre dépôt et ne la copiez pas dans les journaux. - Commencez par tester dans le playground. Le playground Gemini 4 Carbon permet de tester des prompts avant d'écrire du code.
- Envoyez une petite requête. Commencez avec un prompt court et vérifiez le format de la réponse.
- Ajoutez le streaming. Définissez
stream: truepour activer les événements envoyés par le serveur. Cette option est importante lorsqu'un seul segment peut atteindre 65 536 tokens. - Testez une tâche représentative. Utilisez la taille réelle de vos entrées, vos critères d'évaluation et au moins deux niveaux de raisonnement avant d'adopter un pipeline.
Voici un exemple minimal de requête Python :
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
Deux remarques concernant l'intégration. Premièrement, ce modèle dispose de capacités de raisonnement : conservez les métadonnées de raisonnement renvoyées lorsque vous poursuivez une conversation, faute de quoi vous risquez de perdre le contexte attendu par le modèle. Deuxièmement, max_tokens correspond à une limite par segment et non à une limite totale. Pour les longues sorties, utilisez le mécanisme de continuation proposé par votre SDK au lieu d'augmenter ce nombre sans autre précaution.
Felo documente aussi des points de terminaison Chat Completions et Responses compatibles avec OpenAI pour les modèles qui les prennent en charge. Comme la page du modèle recommande Messages pour Carbon, vérifiez les interfaces prises en charge sur la page du modèle avant de modifier un client basé sur OpenAI.
Combien coûte Gemini 4 Carbon sur Felo ?
Felo distribue Gemini 4 Carbon via cinq fournisseurs Google, et chaque route bénéficie d'une réduction de 50 %. Les tarifs ci-dessous sont indiqués pour 1 million de tokens, avec les tarifs standards et les tarifs réduits.
| Route | Entrée | Sortie | Lecture du cache |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
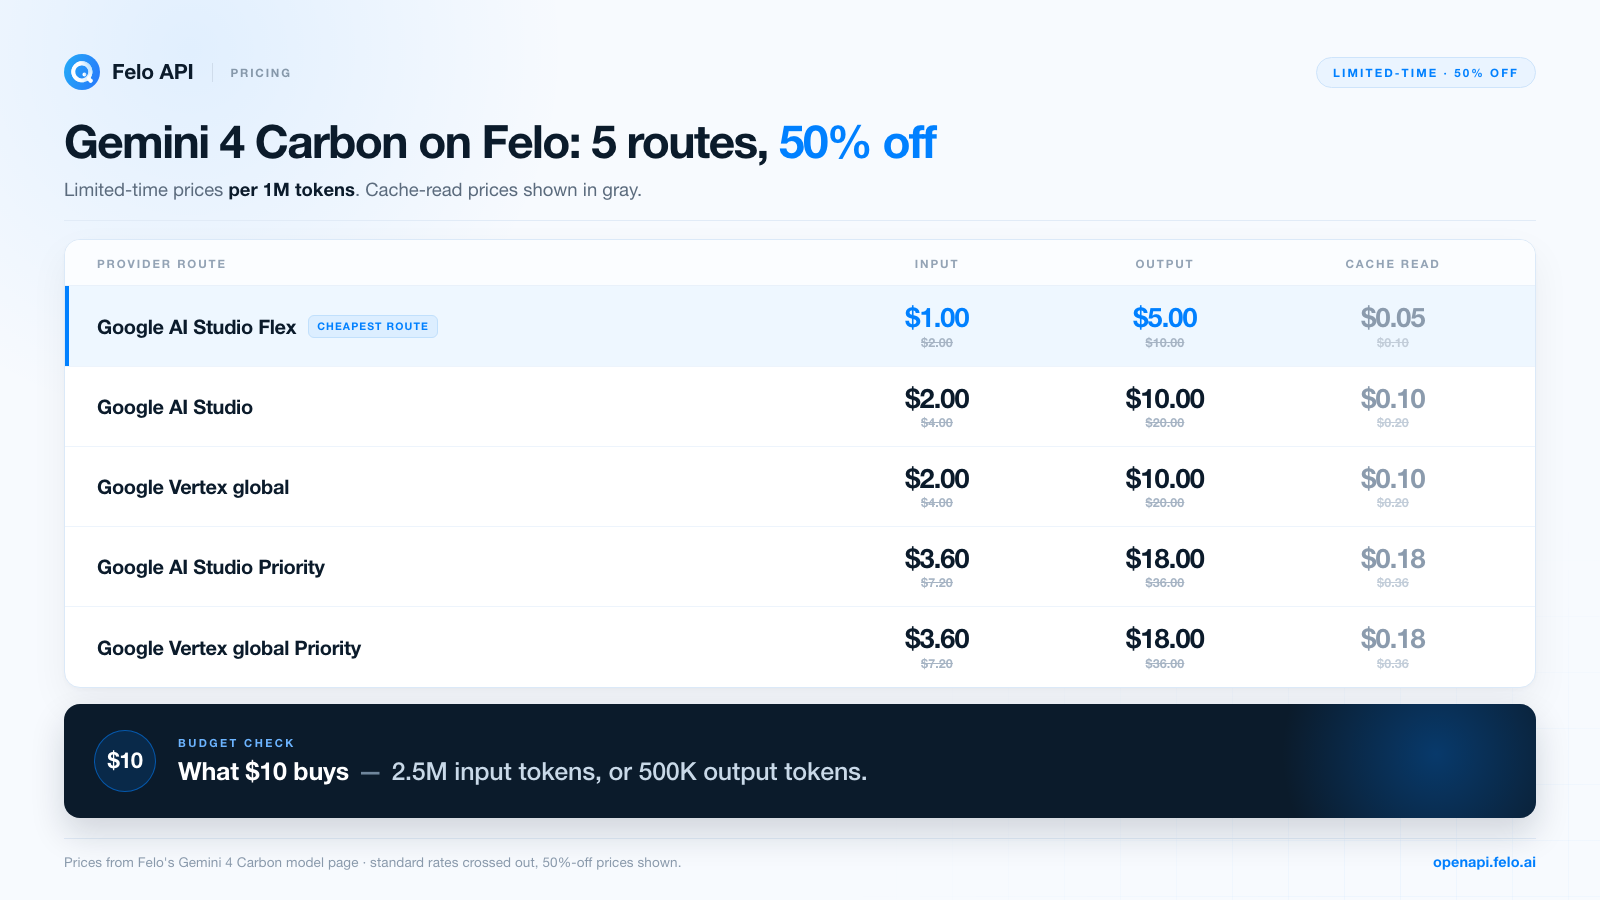
La page tarifaire de Felo traduit les tarifs standards en une estimation de ce que permettent d'acheter 10 dollars : environ 2,5 millions de tokens d'entrée ou 500 000 tokens de sortie, avant réduction. Cette estimation aide à dimensionner une preuve de concept. Un test qui envoie des ensembles de documents de 100 000 tokens et reçoit des réponses de 5 000 tokens coûte environ $0.13 sur la route Flex au tarif réduit — $0.10 pour les entrées et $0.025 pour les sorties. Ce montant permet de réaliser des dizaines d'essais avant de prendre une décision.
L'essai gratuit est une offre distincte des tarifs réduits. La page du modèle sur Felo affiche un essai gratuit à durée limitée pour Gemini 4 Carbon. Il s'agit du moyen le plus simple de tester le modèle sans engager de crédits. Consultez les conditions en vigueur sur la page du modèle, car la disponibilité de l'essai et les réductions tarifaires sont limitées dans le temps et peuvent changer.
La planification des coûts de ce modèle nécessite une précaution supplémentaire. Les tokens de raisonnement sont facturés au tarif des tokens de sortie. Une exécution d'agent avec HIGH peut donc coûter plusieurs fois le montant suggéré par la réponse visible. Enregistrez la consommation de tokens par tâche, y compris les tokens de raisonnement, et comparez le coût par résultat accepté plutôt que le coût par requête.
Limites et éléments à vérifier avant de vous engager
Carbon est un modèle de pointe dont les faiblesses sont documentées. Voici celles qui comptent pour la planification en production :
- Hallucinations. Google les répertorie parmi les limites connues. Un contexte long réduit le risque d'omettre des informations, mais ne garantit pas une interprétation correcte. Les processus de citation et de vérification restent nécessaires.
- Latence et dépassements de délai. Google signale des lenteurs et des problèmes de délai occasionnels. Les longues exécutions avec HIGH nécessitent des délais d'attente généreux, des mécanismes de nouvelle tentative et une gestion idempotente des tâches.
- Consommation élevée de tokens. Le modèle utilise davantage de tokens de raisonnement qu'Argon, en particulier avec les niveaux élevés. Prévoyez un budget adapté et limitez l'effort consacré aux tâches courantes.
- Date limite des connaissances : mars 2026. Toute information plus récente nécessite un système de récupération ou des sources actuelles. Carbon ne connaît pas les événements postérieurs à cette date.
- Paramètres d'échantillonnage fixes. La température, top-p et top-k ne peuvent pas être modifiés. Si votre pipeline exige des sorties déterministes, confiez cette étape à un autre modèle.
- Absence de mise en cache explicite, de réglage du modèle, de RAG Engine et de Live API. Ces fonctionnalités doivent être prises en charge dans votre couche applicative.
- Restrictions de disponibilité. Google réserve Carbon aux clients professionnels vérifiés dans certaines régions ; Felo le distribue via des fournisseurs mondiaux, américains et européens. Vérifiez la route et les conditions applicables à votre cas d'utilisation.
- Règles de sécurité et d'accès. La variante cyber est réservée aux utilisateurs autorisés, et les opérations de sécurité nécessitent une autorisation. Les mécanismes de protection du modèle et les politiques des fournisseurs restent applicables.
Alors, faut-il l'utiliser ?
Choisissez Gemini 4 Carbon lorsque la tâche est longue, que les preuves sont complexes et qu'une mauvaise réponse entraîne un coût élevé : plan de migration, audit de sécurité, synthèse de recherche, analyse financière ou juridique, ou agent qui doit enquêter avant d'agir. Son profil de benchmark et son budget unifié sont conçus pour ce type de travail.
Ne l'utilisez pas comme modèle par défaut pour toutes les requêtes. La classification à grand volume, les extractions courtes, les résumés simples et les tâches qui nécessitent un échantillonnage déterministe conviennent mieux à des modèles moins coûteux et plus rapides. Le modèle le moins cher qui satisfait vos critères de qualité constitue presque toujours le meilleur choix. Carbon doit justifier sa place sur les tâches les plus difficiles de votre charge de travail.
En résumé : Carbon est le modèle de Google le plus performant pour les travaux de raisonnement approfondi. Il présente des atouts mesurés en sécurité, en droit, en finance et dans le raisonnement à long contexte, mais entraîne des coûts réels en matière de latence et de consommation de tokens. Ses limites documentées rendent la vérification indispensable. Testez-le sur vos propres tâches avant de construire votre infrastructure autour de lui.
Questions fréquentes
Existe-t-il un essai gratuit de Gemini 4 Carbon sur Felo ?
Oui. Felo propose un essai gratuit à durée limitée pour Gemini 4 Carbon. Les tarifs des fournisseurs du modèle bénéficient aussi de réductions pendant la période de l'offre. Les conditions peuvent changer. Consultez la page du modèle Gemini 4 Carbon pour connaître les disponibilités actuelles.
Quelle est la différence entre Gemini 4 Carbon et Gemini 4 Argon ?
Carbon repose sur Argon et a été optimisé pour un raisonnement plus approfondi. Il utilise un budget unifié de 1 048 576 tokens couvrant les entrées, le raisonnement, les appels d'outils et les sorties ; propose les niveaux de raisonnement LOW, MEDIUM et HIGH ; consomme davantage de tokens de raisonnement ; et ajoute la prise en charge des fichiers Office/OpenDocument ainsi qu'un positionnement renforcé en matière de sécurité. Argon reste le choix adapté à la génération de longs contenus lorsque la longueur de sortie compte davantage que la profondeur de vérification.
Quelle est la fenêtre de contexte et la sortie maximale de Gemini 4 Carbon ?
Le budget unifié est de 1 048 576 tokens et couvre ensemble les entrées et les sorties. Un segment unique en streaming peut produire jusqu'à 65 536 tokens de sortie, ou 32 768 sans streaming. Les générations prolongées permettent d'atteindre la limite du budget restant. Felo indique une sortie maximale de 943.718K tokens sur sa route.
Gemini 4 Carbon peut-il lire des fichiers audio, vidéo et Office ?
Oui. Il accepte le texte, les images, l'audio, la vidéo, les PDF et les fichiers Office/OpenDocument. Les limites sont d'environ 8,4 heures d'audio, 45 à 60 minutes de vidéo, 3 000 images et documents combinés et 3 000 pages par document. Les sorties sont exclusivement textuelles.
Gemini 4 Carbon prend-il en charge les API compatibles avec OpenAI ?
Felo recommande son API Messages compatible avec Anthropic pour ce modèle et documente aussi les points de terminaison Chat Completions et Responses compatibles avec OpenAI pour les modèles pris en charge. Vérifiez l'interface disponible sur la page du modèle avant de modifier un client existant.
Combien coûte Gemini 4 Carbon ?
Felo propose cinq routes Google, toutes avec une réduction actuelle de 50 % : AI Studio Flex à $1 pour les entrées et $5 pour les sorties par million de tokens, les routes standard AI Studio et Vertex à $2 / $10, et les routes Priority à $3.60 / $18. La lecture du cache commence à $0.05 par million de tokens. Consultez la page tarifaire de Felo pour connaître les tarifs en vigueur.
Quand Gemini 4 Carbon a-t-il été lancé ?
Google a annoncé Gemini 4 Carbon le 28 octobre 2026. Le modèle a d'abord été mis à la disposition d'un groupe restreint de spécialistes de la cybersécurité dans le cadre du programme Fairwind. La plateforme d'entreprise de Google indique une disponibilité générale à partir du 10 novembre 2026. Felo distribue désormais le modèle via cinq fournisseurs Google.
Essayez Gemini 4 Carbon sur Felo
Le meilleur moyen d'évaluer Carbon consiste à lui confier une tâche dont vous connaissez déjà la réponse. Ouvrez le playground Gemini 4 Carbon, insérez un véritable document ou un exemple de code, puis comparez les niveaux de raisonnement LOW et HIGH avec le même prompt. Si les résultats répondent à vos attentes, créez une clé et intégrez le test à votre propre pipeline.
Commencez par consulter la page du modèle Gemini 4 Carbon pour connaître les conditions de l'essai gratuit, les routes fournisseurs et les limites en vigueur. Construisez ensuite le test le plus réduit possible autour de la tâche la plus difficile à laquelle vous êtes confronté.
Cet article est également disponible en English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.