GPT-6 Astra sur Felo OpenAPI : fenêtre de contexte de 1,05M et outils d’agent

Felo OpenAPI intègre GPT-6 Astra avec une fenêtre de contexte de 1,05M, une sortie maximale de 128K, et des endpoints Chat Completions, Responses et Messages compatibles.
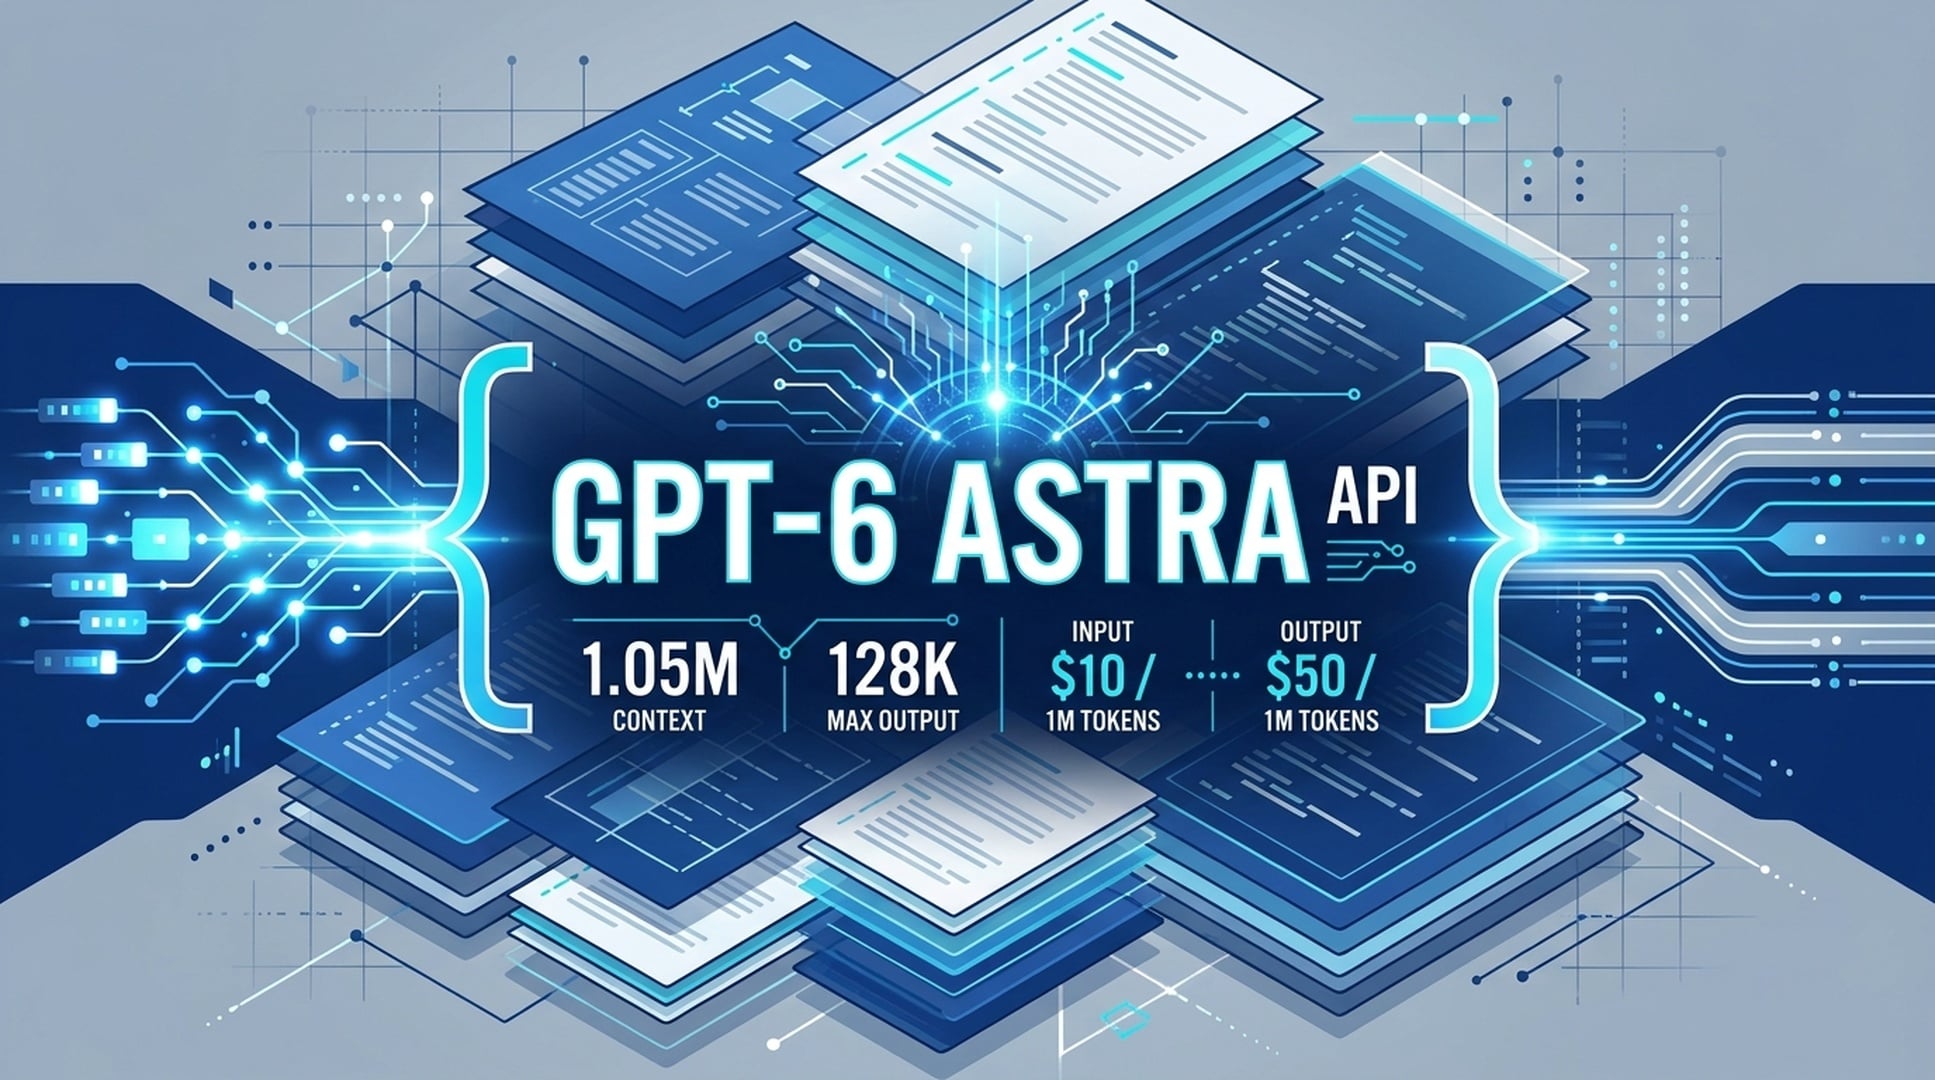
Les documents longs, le code complexe et les flux d’agents à étapes multiples obligent les équipes à diviser les appels de modèle. Felo OpenAPI propose GPT-6 Astra, pour qu’un seul identifiant de modèle prenne en charge ces charges de travail via des surfaces API compatibles.
Essayez GPT-6 Astra : https://openapi.felo.ai/models/openai/gpt-6-astra
Ce pour quoi GPT-6 Astra a été conçu
GPT-6 Astra représente le niveau phare GPT-6 sur la plateforme Felo API. OpenAI le décrit comme son modèle le plus performant pour le raisonnement complexe, la programmation, l’utilisation de l’ordinateur, la recherche et la création de documents. La page modèle Felo affiche Raisonnement, Outils, JSON, Streaming et Vision comme capacités.
Utilisez l’identifiant de modèle gpt-6-astra. La fenêtre de contexte atteint 1 050 000 tokens et la sortie maximale est de 128 000 tokens. OpenAI indique une date de connaissance limitée au 30 avril 2026. Cette capacité permet à une requête de contenir une spécification, un résumé de code, des définitions d’outils et un historique de conversation dans un seul contexte de travail.
OpenAI propose cinq niveaux d’effort de raisonnement : low, medium, high, xhigh et max. Choisissez le niveau qui correspond à l’objectif de qualité, au budget de latence et au coût de la requête.
L’annonce OpenAI indique que GPT-6 Astra est déployé auprès des entreprises dans le programme Trusted Access, avec un accès Plus, Pro, Business et Enterprise dans les jours suivants. Felo OpenAPI fournit une route modèle pour les développeurs qui ont besoin d’un accès API via sa plateforme.
Trois protocoles, un identifiant de modèle
La plateforme Felo API expose trois surfaces de requête compatibles :
- Chat Completions :
POST https://openapi.felo.ai/api/v1/chat/completions - Responses :
POST https://openapi.felo.ai/api/v1/responses - Messages :
POST https://openapi.felo.ai/api/v1/messages
Une application avec un client compatible OpenAI conserve sa structure de requête et modifie la valeur model en gpt-6-astra. Les clients de type Claude peuvent utiliser la surface Messages compatible Anthropic. La page modèle mentionne Claude Code, Codex, LLM API et d’autres clients agents comme cas d’utilisation.
Tarification adaptée au budget
La page modèle Felo actuelle affiche ces tarifs :
| Élément | Tarif |
|---|---|
| Entrée | 10,00 $ par 1M tokens |
| Sortie | 50,00 $ par 1M tokens |
La page précise que le tarif de lancement peut être jusqu’à 50 % inférieur aux tarifs API du fournisseur officiel. Le coût final dépend du modèle, du mélange entrée/sortie, de l’utilisation du cache et du plan actif. La page Felo actuelle affiche 10,00 $ / 1M tokens d’entrée et 50,00 $ / 1M tokens de sortie. Une estimation de coût inclut chaque variable ; le tarif affiché ne représente pas la facture complète.
La documentation modèle OpenAI indique des tarifs standards de 10,00 $ par 1M tokens d’entrée, 1,00 $ par 1M tokens d’entrée en cache et 50,00 $ par 1M tokens de sortie. Les écritures de cache utilisent 1,25x le tarif d’entrée non mis en cache. Les requêtes au-dessus de 272K tokens d’entrée utilisent 2x les tarifs d’entrée et de cache, plus 1,5x la sortie pour la requête complète. Batch et Flex utilisent 50 % des tarifs standards ; Fast mode utilise 2x les tarifs applicables. Ce sont des tarifs de référence OpenAI, non une substitution au prix du plan Felo ci-dessus.
| Source du prix | Entrée | Entrée en cache | Sortie |
|---|---|---|---|
| Page modèle Felo | 10,00 $ / 1M | La page indique les tarifs d’entrée en cache et d’écriture de cache | 50,00 $ / 1M |
| Guide modèle OpenAI | 10,00 $ / 1M | 1,00 $ / 1M | 50,00 $ / 1M |
Faire une première requête en cinq étapes
1. Créer une clé API
Créez une clé dans votre compte Felo API Platform et définissez-la comme variable d’environnement :
export FELO_API_KEY="YOUR_API_KEY"
2. Définir l’endpoint
Pour Chat Completions, utilisez :
https://openapi.felo.ai/api/v1/chat/completions
3. Définir l’identifiant de modèle
Passez "model": "gpt-6-astra" avec un tableau messages. Cette requête cURL teste la route :
curl https://openapi.felo.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-astra",
    "messages": [{"role": "user", "content": "Explain this API error."}]
  }'
4. Ajouter des outils ou une sortie structurée
Les paramètres compatibles incluent tools, tool_choice et response_format. Le support de chaque contrôle dépend du protocole choisi et de la route modèle. GPT-6 Astra prend en charge le raisonnement ; lorsque le protocole et la route exposent des contrôles de raisonnement, conservez les métadonnées de raisonnement retournées lors de la poursuite de la conversation.
OpenAI mentionne ces outils Responses API pour GPT-6 Astra : recherche web, recherche de fichiers, génération d’images, interpréteur de code, shell hébergé, application de patch, compétences, utilisation de l’ordinateur, MCP et recherche d’outils. Utilisez l’endpoint Responses quand un workflow nécessite ces outils hébergés. Les surfaces exposées et les outils activés par Felo peuvent dépendre de la route active.
5. Activer le streaming
Définissez stream sur true pour recevoir des événements envoyés par le serveur :
{
  "model": "gpt-6-astra",
  "stream": true,
  "messages": [{"role": "user", "content": "Summarize this log."}]
}
Liste de vérification avant lancement
- Estimez le coût d’entrée par rapport à la fenêtre de contexte de 1,05M.
- Définissez
max_tokenspour limiter la sortie dans le budget du projet. - Enregistrez les données d’entrée, de sortie, de cache et de plan pour chaque estimation de requête.
- Testez les prompts dans le Playground avant de connecter une application ou un client agent.
- Gardez des échantillons de régression pour les outils, la sortie JSON et le streaming.
- Définissez
reasoning_effortà un niveau pris en charge et enregistrez-le avec les données de latence et de coût. - Utilisez les règles de tarification OpenAI pour la comparaison ; utilisez le plan et la route Felo pour l’estimation payable.
Commencez par la page modèle
GPT-6 Astra regroupe raisonnement, programmation, analyse de contexte long et travail d’agent derrière une seule entrée de modèle. Felo OpenAPI offre aux équipes une voie de migration via Chat Completions, Responses et Messages. Un client existant reste en place tandis que la surface de requête s’adapte à la charge de travail.
Ouvrez la page modèle GPT-6 Astra pour les paramètres, exemples de code et accès au Playground.
Sources : Page modèle GPT-6 Astra sur Felo API Platform, Annonce OpenAI GPT-6 Astra, et Guide modèle OpenAI GPT-6 Astra (consulté le 04/09/2026). La tarification Felo a été vérifiée à nouveau le 04/09/2026.