API GPT-6.1 Sol : Performance proche d'Astra à moindre coût
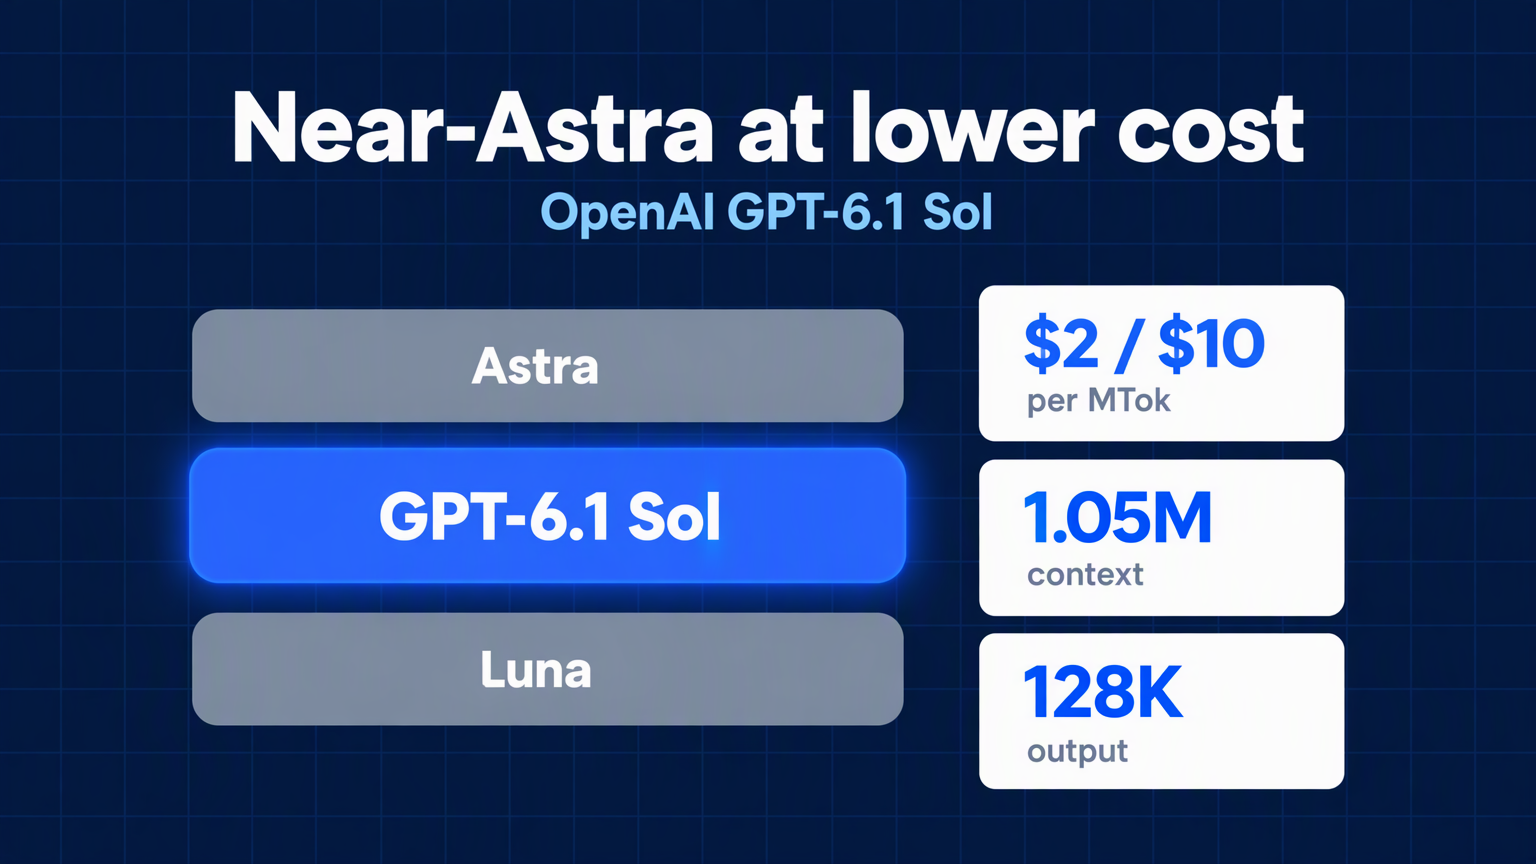
OpenAI GPT-6.1 Sol offre une performance proche d'Astra pour le codage, l'utilisation informatique et le travail professionnel à $2/$10 par million de tokens avec une fenêtre de contexte de 1,05M.
Le nouveau modèle Sol d’OpenAI ne cherche pas à être le plus intelligent. Il vise à être celui que l’on peut utiliser toute la journée sans dépasser son budget.
GPT-6.1 Sol se situe entre le modèle phare GPT-6 Astra et le modèle léger GPT-6 Luna. La page officielle du modèle le résume en une phrase : "Performance proche d'Astra pour des tâches complexes à un coût inférieur." Pour les équipes qui développent des outils de codage agentique, des agents pour l’utilisation informatique ou des workflows documentaires, ce compromis devient essentiel.
Ce guide présente les fonctionnalités de GPT-6.1 Sol, son coût, ses différences avec GPT-6 Sol et Astra, et la façon de l’appeler via la Felo API Platform.
Ce qu’est GPT-6.1 Sol
GPT-6.1 Sol est un modèle de raisonnement conçu pour le codage complexe, l’utilisation informatique et le travail professionnel. OpenAI le présente comme l’option équilibrée de la famille GPT-6 : plus performant que Luna, moins cher qu’Astra, et suffisamment robuste pour que de nombreux usages en production ne nécessitent pas le modèle phare.
La page du modèle indique comment l’utiliser : comparer Sol et Astra sur vos tâches, puis décider si la différence de qualité justifie la différence de prix. Ce conseil s’adresse directement aux utilisateurs et reflète l’objectif du modèle. Sol sert à maîtriser les coûts, pas à battre des records.
La page de Felo résume la même position côté plateforme. GPT-6.1 Sol est "une amélioration de GPT-6 Sol, toujours positionnée sous le modèle phare GPT-6 Astra." Il gère le codage agentique, l’utilisation informatique, le travail professionnel sur documents et l’automatisation de workflows multi-étapes, en approchant les résultats d’Astra sur ces tâches à un coût bien inférieur. Par rapport à GPT-6 Sol, Felo signale moins d’erreurs factuelles et un respect plus strict des restrictions explicites.
GPT-6.1 Sol s’utilise quand la tâche est difficile, longue, répétitive — et que la facture doit rester maîtrisée.
Spécifications de GPT-6.1 Sol en bref
OpenAI publie la fiche technique complète sur la page du modèle. Voici la version condensée.
| Spécification | GPT-6.1 Sol |
|---|---|
| ID du modèle | gpt-6.1-sol |
| Snapshot par défaut | gpt-6.1-sol |
| Fenêtre de contexte | 1 050 000 tokens |
| Nombre maximal de tokens en entrée | 922 000 |
| Nombre maximal de tokens en sortie | 128 000 |
| Date de connaissance | 30 avril 2026 |
| Modalités d'entrée | Texte, image |
| Modalités de sortie | Texte |
| Modalités non prises en charge | Audio, vidéo |
| Support des tokens de raisonnement | Oui |
| Effort de raisonnement | low, medium (par défaut), high, xhigh, max |
| Effort de raisonnement non pris en charge | none, minimal |
| Résidence des données | US et UE |
Deux points comptent plus que les chiffres principaux.
Premièrement, l’effort de raisonnement ne peut pas être désactivé. GPT-6.1 Sol ne prend pas en charge none ou minimal. Si vous migrez depuis un modèle qui permettait ces réglages, OpenAI recommande de commencer par low et de comparer les résultats sur des tâches représentatives.
Deuxièmement, l’appel d’outils nécessite l’API Responses. GPT-6.1 Sol accepte Chat Completions pour les requêtes sans outils, mais tout workflow qui appelle des fonctions, recherche des fichiers, navigue sur le web ou contrôle un ordinateur doit passer par Responses. Ce n’est pas une limitation propre à Sol — c’est la direction prise par toute la plateforme OpenAI.
Tarification de GPT-6.1 Sol : ce que $2/$10 permet réellement
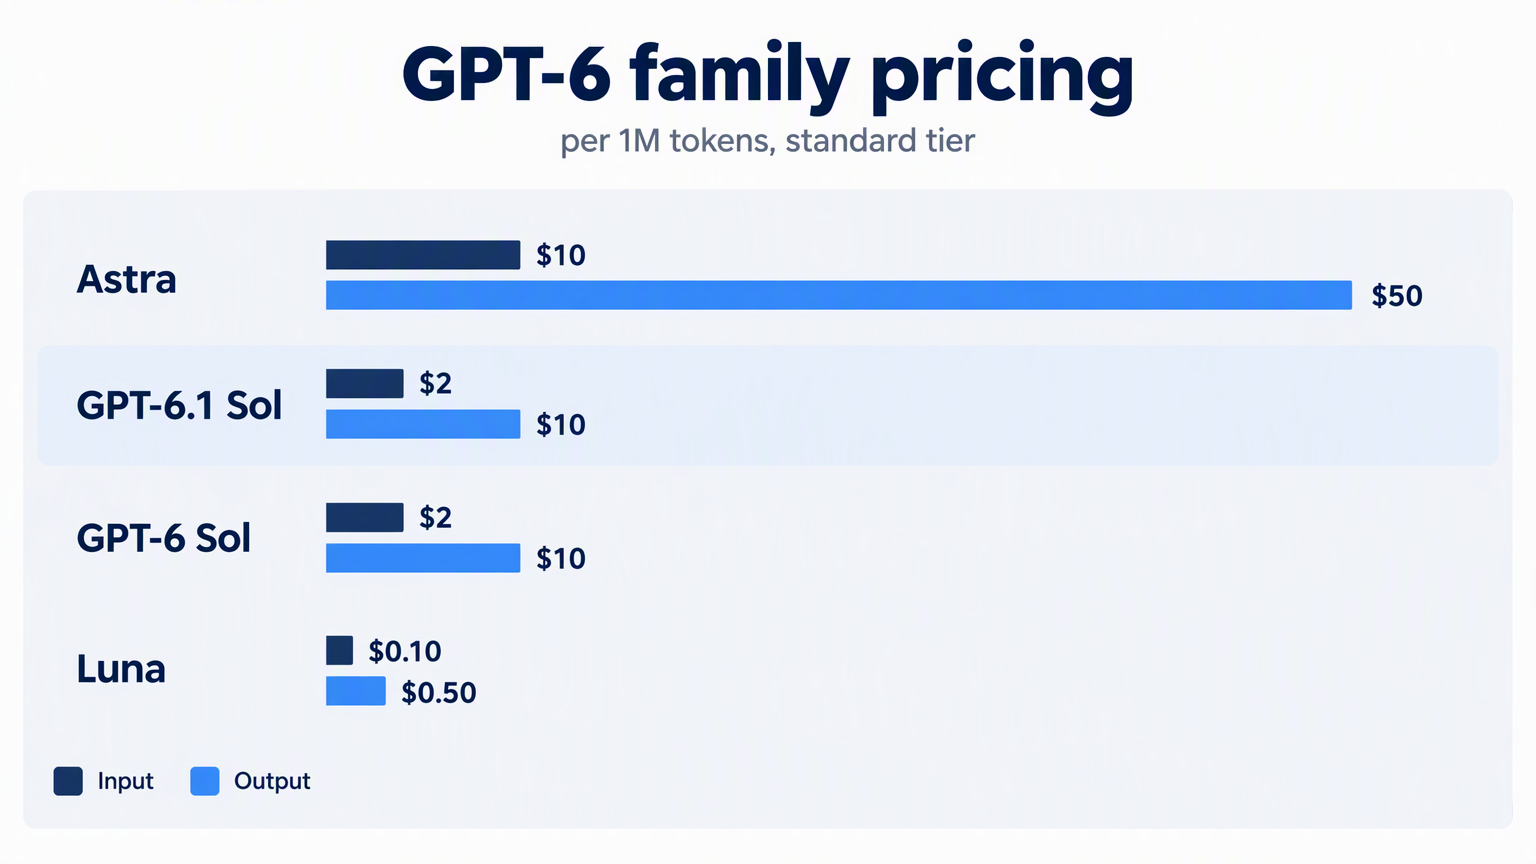
La tarification standard d’OpenAI pour GPT-6.1 Sol est $2 par million de tokens en entrée et $10 par million de tokens en sortie. Le tableau complet inclut le prix du cache, qui modifie le calcul pour les agents à long terme.
| Indicateur | Prix par 1M tokens |
|---|---|
| Entrée | $2.00 |
| Entrée en cache | $0.10 |
| Écriture en cache | $2.50 |
| Sortie | $10.00 |
Quelques règles accompagnent ce tableau :
- L’entrée en cache coûte 5% du tarif standard. OpenAI facture les lectures de cache de GPT-6.1 Sol à 0,05x, contre 0,1x pour la plupart des modèles GPT-5.6 et suivants. Cette réduction bénéficie aux agents qui réutilisent un prompt système ou un contexte de dépôt volumineux à chaque tour.
- Les écritures en cache coûtent 1,25x le tarif standard. Vous payez $2.50 par million de tokens pour écrire un préfixe en cache, puis $0.10 par million pour le relire.
- Les contextes longs coûtent plus cher. Les prompts au-dessus de 272K tokens en entrée sont facturés à 2x pour l’entrée et le cache, et 1,5x pour la sortie sur toute la requête. À cette taille, l’entrée passe à $4, l’entrée en cache à $0.20, l’écriture en cache à $5, et la sortie à $15 par million de tokens.
- Batch et Flex coûtent 50% moins cher. Si votre charge de travail accepte un traitement asynchrone, le tarif effectif tombe à $1 en entrée et $5 en sortie par million de tokens.
- Le mode rapide coûte 2x le standard. Vous payez pour une latence réduite, pas pour une intelligence accrue.
- Le traitement régional ajoute une majoration de 10% là où il est disponible.
La réduction sur la lecture de cache est le point clé. Un agent de codage qui réutilise le même contexte de dépôt de 100 000 tokens sur vingt tours paie $0.10 par million de tokens en cache au lieu de $2.00 par million de tokens en entrée fraîche. Sur une longue session, l’écart s’accumule vite.
À titre de comparaison, GPT-6 Astra affiche $10 en entrée et $50 en sortie par million de tokens. GPT-6.1 Sol coûte cinq fois moins cher des deux côtés. GPT-6 Luna est encore moins cher à $0.10 en entrée et $0.50 en sortie, mais il abandonne la capacité proche d’Astra qui rend Sol intéressant.
Nouveautés de GPT-6 utilisables par Sol
GPT-6.1 Sol hérite des fonctionnalités de la plateforme GPT-6 introduites avec la génération Astra. Plusieurs sont importantes pour les usages agentiques.
Appel d’outils asynchrone
Habituellement, un appel de fonction met le modèle en pause jusqu’à ce que votre application retourne un résultat. Avec l’appel d’outils asynchrone, on définit async: true sur un outil et le modèle continue — raisonnement, appel d’autres outils ou réponse à d’autres parties de la requête — pendant que l’application exécute le travail lent en arrière-plan.
Votre application exécute toujours l’outil et gère le travail en attente. Quand le job finit, vous retournez la sortie dans une requête Responses ultérieure avec le call_id d’origine. La documentation OpenAI décrit cela comme une façon de lancer les recherches lentes tôt et de compléter la réponse quand les données arrivent.
Pour Sol, ce fonctionnement s’adapte bien. Un agent de codage peut démarrer une suite de tests longue, continuer à examiner d’autres fichiers et intégrer les résultats des tests à leur arrivée.
Steering en cours de génération
Le steering en cours de génération permet à un utilisateur d’envoyer une correction ou une nouvelle exigence pendant que le modèle travaille. Sur une connexion WebSocket à l’API Responses, le serveur conserve le travail déjà effectué et intègre la mise à jour dans la suite.
Attention : le steering ne réécrit pas la sortie déjà envoyée, n’annule pas les actions précédentes et ne stoppe pas les outils déjà lancés. Il modifie la direction du travail, pas le passé. Si le steering interrompt la réponse initiale, celle-ci se termine par incomplete_details.reason: "steered" et une nouvelle réponse porte la mise à jour.
Modification de l’effort de raisonnement en conversation
On peut augmenter ou diminuer l’effort de raisonnement pendant une conversation en ajoutant un élément configuration_update en entrée. L’effort mis à jour reste actif jusqu’à ce qu’une nouvelle mise à jour le remplace. OpenAI recommande de garder le reasoning.effort au niveau de la requête inchangé pour que le préfixe du prompt reste en cache.
Cette combinaison — lecture de cache peu coûteuse et raisonnement ajustable — rend Sol économique pour des charges mixtes. Utilisez low pour les suivis routiniers, puis passez à xhigh quand la tâche devient difficile, sans réécrire la conversation.
Multi-agent (bêta)
La fonctionnalité multi-agent est disponible en bêta avec GPT-6.1 Sol et tous les modèles GPT-5.6. Un agent racine peut lancer des sous-agents qui travaillent en parallèle, chacun avec son propre contexte limité, puis synthétiser leurs résultats dans une réponse finale.
La documentation OpenAI la recommande pour les tâches divisées en flux indépendants : exploration de différentes parties d’un codebase, comparaison de propositions, recherche de sources en parallèle ou investigation de plusieurs causes possibles d’une panne. Le max_concurrent_subagents par défaut est 3.
Le compromis concerne l’utilisation des tokens. Plus d’agents signifie plus de tokens, donc le multi-agent s’impose quand la vitesse en parallèle et le contexte ciblé comptent plus que l’économie brute de tokens.
Compactage et raisonnement persistant
Les agents à long terme finissent par saturer leur fenêtre de contexte. Le compactage réduit la taille du contexte tout en préservant l’état nécessaire pour les tours suivants. On peut activer le compactage côté serveur en définissant context_management avec compact_threshold dans une requête Responses ; le serveur émet un élément de compactage chiffré quand le nombre de tokens rendus dépasse le seuil.
GPT-6.1 Sol prend aussi en charge reasoning.context: "all_turns", ce qui permet aux éléments de raisonnement compatibles des tours précédents de passer au tour suivant. Le raisonnement persistant reste opaque — l’API ne retourne jamais le texte brut du raisonnement du modèle — mais il assure une continuité sur une longue session.
Mode WebSocket
Le mode WebSocket maintient une connexion persistante à l’API Responses et n’envoie que les nouveaux éléments d’entrée à chaque tour. OpenAI annonce jusqu’à 40% d’exécution plus rapide pour les déploiements avec 20 appels d’outils ou plus. Pour un modèle centré sur le codage agentique et l’utilisation informatique, c’est un gain direct de latence.
GPT-6.1 Sol vs GPT-6 Sol vs Astra vs Luna
La famille GPT-6 compte désormais quatre niveaux. Le choix dépend surtout du niveau de qualité requis et de la fréquence d’exécution du workflow.
| Modèle | Positionnement | Entrée / Sortie par 1M | Usage optimal |
|---|---|---|---|
| GPT-6 Astra | Intelligence maximale | $10 / $50 | Raisonnement exigeant, codage, travail professionnel |
| GPT-6.1 Sol | Proche d’Astra à moindre coût | $2 / $10 | Codage complexe, usage informatique, travail sur documents |
| GPT-6 Sol | Ancien niveau Sol | $2 / $10 | Workflows Sol existants avant mise à niveau |
| GPT-6 Luna | Plus rapide et économique | $0.10 / $0.50 | Tâches ciblées, à fort volume |
GPT-6.1 Sol et GPT-6 Sol affichent le même prix principal, mais ce ne sont pas les mêmes modèles. La page de Felo décrit GPT-6.1 Sol comme une amélioration avec moins d’erreurs factuelles et un respect plus strict des restrictions explicites. Le tarif de lecture de cache est aussi divisé par deux : $0.10 par million de tokens au lieu de $0.20. Si vous utilisez déjà GPT-6 Sol en production, la mise à niveau améliore qualité et économie de cache au même prix.
Le guide de sélection de modèles d’OpenAI associe l’effort de raisonnement au type de tâche :
- GPT-6.1 Sol en medium — travail technique complexe et livrables coordonnés à réviser.
- GPT-6.1 Sol en extra high — livrables soignés, systèmes visuels connectés et décisions fondées sur des preuves contradictoires.
- Astra en low — rédaction concise et adaptation de contenu qui préservent faits et nuances.
- Astra en medium — projets ambitieux nécessitant un contexte large, des interactions fiables et des résultats complets.
- Astra en extra high — analyses exigeantes et livrables complexes avec des exigences strictes.
- Luna en low — modifications fines, résolution de problèmes bien cadrée et extraction de données simple.
- Luna en extra high — recherche de contexte actuel sur plusieurs applications, priorisation du travail et résolution de problèmes avec contraintes claires.
La règle pratique selon la guidance Codex d’OpenAI : utiliser Sol pour le travail répété et long sur code, applications et documents quand le coût compte. Garder Astra pour les tâches les plus exigeantes. Utiliser Luna pour les tâches claires et répétables.
Comment appeler GPT-6.1 Sol via Felo API Platform
Felo API Platform expose GPT-6.1 Sol via des endpoints compatibles, ce qui permet de garder votre SDK existant et de changer simplement l’URL de base.
Le modèle est disponible sur :
- Chat Completions :
POST https://openapi.felo.ai/api/v1/chat/completions - Responses :
POST https://openapi.felo.ai/api/v1/responses - Messages (compatible Anthropic) :
POST https://openapi.felo.ai/api/v1/messages
Étape 1 : Obtenir une clé API
Créez une clé depuis votre compte Felo API Platform et exportez-la :
export FELO_API_KEY="YOUR_API_KEY"
Étape 2 : Faire votre première requête
curl https://openapi.felo.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "messages": [
      {"role": "user", "content": "Explain the tradeoff between reasoning effort and cost."}
    ]
  }'
Étape 3 : Utiliser un SDK compatible
Pointez tout SDK compatible OpenAI vers https://openapi.felo.ai/api/v1. Pour les clients de type Claude, utilisez l’URL de base compatible Anthropic https://openapi.felo.ai/api.
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FELO_API_KEY,
  baseURL: "https://openapi.felo.ai/api/v1",
});

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  input: "Review this pull request for correctness, security, and missing tests.",
});

console.log(response.output_text);
Étape 4 : Activer le streaming si besoin
Ajoutez stream: true pour recevoir des événements serveur au fil du traitement du modèle.
La page de Felo indique GPT-6.1 Sol à $2.00 par million de tokens en entrée et $10.00 par million de tokens en sortie, avec un prix de lancement pouvant être jusqu’à 50% inférieur aux tarifs officiels des fournisseurs. Le coût final dépend du modèle, du mix entrée/sortie, de l’utilisation du cache et de votre plan actif. Les lectures de cache sont facturées à moitié du tarif de GPT-6 Sol.
La plateforme prend aussi en charge le raisonnement, les outils, la sortie JSON, le streaming et la vision pour ce modèle, et propose un Playground pour tester les prompts avant d’écrire du code.
Meilleurs cas d’usage pour GPT-6.1 Sol
Les recommandations d’OpenAI ciblent les projets complexes où le coût compte. Quelques usages concrets se démarquent.
Codage agentique à grande échelle
Un agent de codage qui lit un dépôt, propose des modifications, exécute des tests et itère correspond exactement au type de charge pour lequel Sol a été conçu. La fenêtre de contexte de 1,05M tokens accueille de grands codebases, la réduction sur la lecture de cache récompense la réutilisation du contexte de dépôt, et l’appel d’outils asynchrone maintient l’agent productif pendant l’exécution des tests.
La guidance Codex d’OpenAI recommande Sol pour le travail répété et long sur code et applications quand le coût compte, et réserve Astra pour les tâches les plus exigeantes.
Utilisation informatique et automatisation de workflows
GPT-6.1 Sol prend en charge l’ensemble des outils Responses, dont computer_use, hosted_shell, apply_patch, mcp et tool_search. Cela le rend adapté aux agents qui opèrent des logiciels, remplissent des formulaires, déplacent des données entre systèmes ou automatisent des processus métier multi-étapes.
La page de Felo cite l’utilisation informatique et l’automatisation de workflows multi-étapes comme usages principaux.
Travail professionnel sur documents
Sol accepte texte et images, ce qui couvre les documents scannés, graphiques, captures d’écran et présentations. Le guide de sélection de modèles d’OpenAI donne deux exemples : créer une présentation de conseil à partir de résultats financiers, et construire un site web à partir d’un brief produit. Les deux impliquent de grands volumes d’entrée, plusieurs révisions et une exigence de qualité supérieure au "bon marché et rapide" mais inférieure au "meilleur possible".
Recherche et analyse avec flux parallèles
Avec le mode multi-agent bêta, Sol peut diviser une tâche de recherche en flux indépendants, les exécuter en parallèle et synthétiser les résultats. Comparer des propositions de fournisseurs, examiner une pull request sous trois angles ou investiguer plusieurs hypothèses de panne conviennent bien.
Traitement batch à fort volume
La tarification Batch et Flex réduit le tarif de Sol à $1 en entrée et $5 en sortie par million de tokens. Pour le traitement de documents de nuit, la synthèse en masse ou l’extraction à grande échelle avec revue de sortie, ce tarif change la faisabilité économique.
Checklist de migration : passer de GPT-6 Sol à GPT-6.1 Sol
OpenAI recommande de consulter sa guidance de migration avant de passer de gpt-6-sol à gpt-6.1-sol. Voici la version condensée.
- Définir l’ID du modèle. Passez
modelàgpt-6.1-sol. - Corriger l’effort de raisonnement. GPT-6.1 Sol ne prend pas en charge
noneouminimal. Remplaceznoneparlowet testez la migration deminimalen partant delow. - Déplacer l’appel d’outils vers Responses. Chat Completions fonctionne pour les requêtes sans outils. Tout appel de fonction, recherche web, recherche de fichiers, usage informatique ou workflow MCP nécessite l’API Responses.
- Retirer les paramètres non pris en charge. Quand l’effort de raisonnement n’est pas
none, supprimeztemperature,top_pettop_logprobs. Dans Chat Completions, retirez aussilogprobs. Dans Responses, retirezmessage.output_text.logprobsdeinclude. - Mettre à jour la configuration de cache de prompt. Si vous migrez depuis GPT-5.5 ou antérieur, remplacez
prompt_cache_retentionparprompt_cache_options.ttlà"30m". - Utiliser
configuration_updatepour changer le raisonnement. Si votre application ajuste l’effort entre les tours, utilisez des élémentsconfiguration_updateau lieu de modifier lereasoning.effortau niveau de la requête, pour que le préfixe du prompt reste en cache. - Vérifier la résidence des données. GPT-6.1 Sol prend en charge la résidence US et UE. Le mode rapide n’est pas disponible avec résidence UE.
- Tester face à Astra. Exécutez les deux modèles sur des tâches représentatives et comparez qualité, latence et coût total — y compris les tokens de raisonnement, facturés comme tokens de sortie.
Limitations et disponibilité
GPT-6.1 Sol ne remplace pas Astra partout et n’est pas encore disponible partout.
Limites de capacité. OpenAI positionne Sol sous Astra. Pour le raisonnement le plus exigeant et les livrables à enjeux élevés, Astra reste recommandé. Sol optimise le coût pour le travail complexe, pas la qualité maximale.
Pas de fine-tuning. GPT-6.1 Sol ne prend pas en charge le fine-tuning ni les sorties prédites. Il ne gère pas non plus les embeddings, la génération d’images, vidéo, audio, transcription, traduction ou endpoints de modération. Il fonctionne en texte et image en entrée, texte en sortie.
Pas d’entrée audio ou vidéo. Les modalités d’entrée sont limitées à texte et image.
Le raisonnement ne peut pas être désactivé. Les efforts none et minimal ne sont pas pris en charge, donc chaque requête inclut un surcoût de raisonnement.
Le déploiement est en cours. Le lancement OpenAI inclut les plans Plus, Pro, Business, Enterprise et Edu dans Codex sur desktop et CLI, et ChatGPT Work sur web et mobile. Pour Enterprise et Edu, le modèle reste désactivé par défaut jusqu’à activation par un administrateur. Les plans Free et Go ne sont pas inclus au lancement.
Le mode rapide a des restrictions. Les modes Standard et Rapide sont disponibles au lancement, mais le mode Rapide coûte 2x le Standard et n’est pas disponible avec résidence UE. Le support Ultrafast pour GPT-6.1 Sol arrive plus tard.
Des limites de taux s’appliquent. Les limites standard vont de 500 RPM et 500 000 TPM sur le Tier 1 à 15 000 RPM et 40 000 000 TPM sur le Tier 5.
FAQ
Qu’est-ce que GPT-6.1 Sol ?
GPT-6.1 Sol est le modèle GPT-6 équilibré d’OpenAI, positionné entre le modèle phare GPT-6 Astra et le modèle léger GPT-6 Luna. OpenAI le décrit comme offrant une performance proche d’Astra pour le codage complexe, l’utilisation informatique et le travail professionnel à moindre coût.
Combien coûte GPT-6.1 Sol ?
OpenAI affiche GPT-6.1 Sol à $2 par million de tokens en entrée et $10 par million de tokens en sortie. L’entrée en cache coûte $0.10 par million de tokens, et l’écriture en cache $2.50 par million de tokens. Les prompts au-dessus de 272K tokens en entrée sont facturés à un tarif long-contexte plus élevé.
Quelle est la fenêtre de contexte de GPT-6.1 Sol ?
GPT-6.1 Sol dispose d’une fenêtre de contexte de 1 050 000 tokens, d’un maximum de 922 000 tokens en entrée et de 128 000 tokens en sortie.
GPT-6.1 Sol prend-il en charge l’appel d’outils ?
Oui, mais l’appel d’outils nécessite l’API Responses. Chat Completions est pris en charge pour les requêtes sans outils.
Peut-on désactiver le raisonnement sur GPT-6.1 Sol ?
Non. GPT-6.1 Sol prend en charge les efforts de raisonnement low, medium, high, xhigh et max. Il ne prend pas en charge none ou minimal.
Comment GPT-6.1 Sol se compare-t-il à GPT-6 Sol ?
GPT-6.1 Sol est une amélioration de GPT-6 Sol avec moins d’erreurs factuelles et un respect plus strict des restrictions explicites, selon la page de Felo. Les deux affichent le même prix principal, mais GPT-6.1 Sol divise par deux le tarif de lecture de cache à $0.10 par million de tokens.
GPT-6.1 Sol est-il disponible sur Felo API Platform ?
Oui. Felo API Platform expose GPT-6.1 Sol via les endpoints Chat Completions, Responses et Messages compatibles Anthropic. Le prix de lancement peut être jusqu’à 50% inférieur aux tarifs officiels des fournisseurs, et les lectures de cache sont facturées à moitié du tarif de GPT-6 Sol.
Conclusion
GPT-6.1 Sol répond à un problème concret : le meilleur modèle coûte trop cher pour chaque tâche, et le moins cher manque de qualité. Sol propose un compromis avec une capacité proche d’Astra, une fenêtre de contexte de 1,05M, un tarif de lecture de cache à 5%, et un prix cinq fois inférieur à Astra.
Pour les équipes qui développent des agents de codage, des workflows informatiques ou des automatisations documentaires, c’est le modèle à tester en premier. Comparez-le à Astra sur vos tâches, surveillez l’utilisation des tokens de raisonnement, et laissez le compromis coût-qualité décider.
Vous pouvez essayer GPT-6.1 Sol dans le Playground Felo API Platform ou l’appeler directement avec une clé API Felo.
Sources
- Page modèle GPT-6.1 Sol — OpenAI
- Utilisation de GPT-6 — OpenAI
- Sélection de modèle — OpenAI
- Tarification API — OpenAI
- Disponibilité des modèles Codex et ChatGPT — OpenAI
- Appel d’outils asynchrone — OpenAI
- Steering en cours de génération — OpenAI
- Modèles de raisonnement — OpenAI
- Cache de prompt — OpenAI
- Compactage — OpenAI
- Multi-agent — OpenAI
- Mode WebSocket — OpenAI
- Mode rapide — OpenAI
- Résidence des données — OpenAI
- GPT-6.1 Sol — Felo API Platform
Cet article est également disponible en English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.