विभेदक AI: निर्णय मॉडल, उदाहरण और उपयोग

जानें कि विभेदक AI और निर्णय मॉडल इनपुट को कैसे वर्गीकृत करते हैं, रूट करते हैं और स्कोर देते हैं, वे जनरेटिव AI से कैसे अलग हैं और डेवलपर उनका उपयोग किन क्षेत्रों में कर सकते हैं।
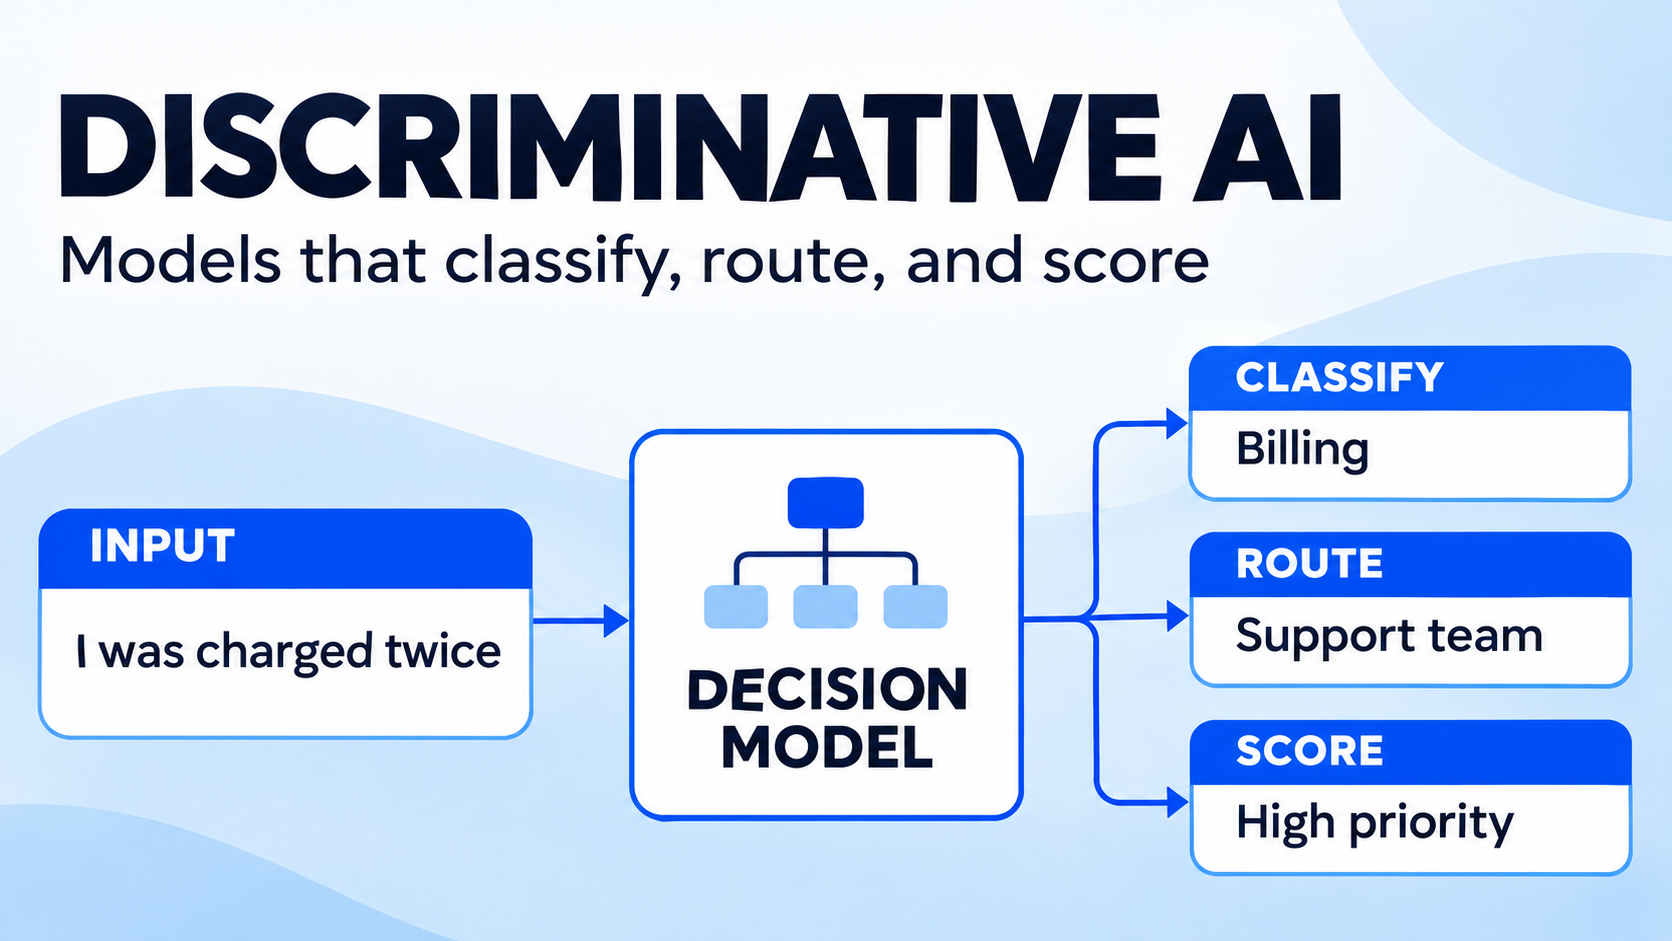
एक सहायता अनुरोध प्राप्त होता है: “मुझसे दो बार शुल्क लिया गया है और मुझे रिफंड चाहिए।” आपके एप्लिकेशन को AI मॉडल से एक पैराग्राफ की आवश्यकता नहीं है। उसे पहले एक निर्णय चाहिए: क्या इस टिकट को बिलिंग, तकनीकी सहायता या बिक्री विभाग के पास भेजा जाना चाहिए?
विभेदक AI (Discriminative AI) को किसी इनपुट से एक लेबल, स्कोर या अन्य लक्ष्य का अनुमान लगाने के लिए बनाया गया है। निर्णय मॉडल का एक नया समूह इस विचार को डेवलपर API तक लाता है: मॉडल को संदर्भ और एक निर्धारित प्रश्न दें, और वह एक संरचित निर्णय या संभावनाएँ लौटाता है, जिनका उपयोग सॉफ्टवेयर कर सकता है। यह गाइड बताती है कि ये मॉडल कैसे काम करते हैं, जनरेटिव AI के साथ इनकी भूमिका क्या है और इनका मूल्यांकन कैसे किया जाए।
विभेदक AI क्या है?
विभेदक AI किसी इनपुट के बारे में अनुमान लगाता है। स्पैम फ़िल्टर यह अनुमान लगाता है कि कोई ईमेल स्पैम है या नहीं; क्लासिफायर किसी सहायता टिकट को एक टीम सौंपता है; जोखिम मॉडल किसी निर्धारित परिणाम की संभावना का अनुमान लगाता है।
मशीन लर्निंग में, विभेदक मॉडल सामान्य रूप से इनपुट x से लक्ष्य y तक मैपिंग सीखते हैं या सशर्त प्रायिकता P(y | x) का अनुमान लगाते हैं। लक्ष्य कोई श्रेणी, संख्यात्मक मान या अन्य संरचित आउटपुट हो सकता है। लॉजिस्टिक रिग्रेशन, सपोर्ट वेक्टर मशीन और कई न्यूरल क्लासिफायर विभेदक दृष्टिकोण के उदाहरण हैं। हर विभेदक मॉडल प्रायिकता नहीं लौटाता और हर संख्यात्मक स्कोर अच्छी तरह कैलिब्रेटेड नहीं होता।
इसका मूल विचार आज के AI असिस्टेंट से पहले का है। नया पहलू सामान्य उपयोग वाले निर्णय API की उपलब्धता है, जो प्राकृतिक भाषा में कार्य विवरण और उत्तर के विकल्प स्वीकार करते हैं। इससे डेवलपर कई वर्गीकरण और स्कोरिंग कार्यों के लिए एक ही इंटरफ़ेस का उपयोग कर सकते हैं।
AI निर्णय मॉडल क्या है?
मौजूदा API परिदृश्य में, निर्णय मॉडल (Decision Model) का अर्थ ऐसे मॉडल या सेवा से है जिसे दिए गए इनपुट के बारे में सीमित दायरे वाले प्रश्नों के उत्तर देने के लिए बनाया गया है। मुक्त प्रारूप में उत्तर तैयार करने के बजाय, यह टाइप किया हुआ परिणाम लौटाता है, जैसे:
- हाँ/नहीं की प्रायिकता: इस संदेश में रिफंड का अनुरोध होने की कितनी संभावना है?
- विकल्प: इस टिकट को किस विभाग के पास भेजा जाना चाहिए?
- स्कोर: यह उत्तर निर्धारित गुणवत्ता मानदंड में किस स्थान पर आता है?
उदाहरण के लिए, कोई निर्णय मॉडल प्रत्येक विभाग के लिए लेबल और प्रायिकता अनुमान के साथ बिलिंग श्रेणी लौटा सकता है। आपका एप्लिकेशन इन परिणामों का उपयोग टिकट को सही विभाग तक पहुँचाने, अधिक जानकारी माँगने या किसी मानव समीक्षक के पास भेजने के लिए कर सकता है।
TypeSafe अपने Jev परिवार के मॉडल को “System One” मॉडल कहता है। Liquid AI अपने d1 निर्णय मॉडल को ऐसा मॉडल बताता है जो टेक्स्ट और इमेज स्वीकार करता है तथा आउटपुट टोकन जनरेट किए बिना प्रायिकताएँ लौटाता है। विभेदक मॉडल पर Google Codelab यह दिखाता है कि किसी एप्लिकेशन में निर्णय मॉडल का उपयोग जनरेटिव मॉडल के साथ कैसे किया जा सकता है।
ये शब्द आपस में संबंधित हैं, लेकिन एक-दूसरे के स्थान पर इस्तेमाल नहीं किए जा सकते। विभेदक मॉडलिंग मशीन लर्निंग की एक व्यापक अवधारणा है; निर्णय मॉडल सीमित दायरे वाले निर्णयों के लिए बनाया गया उत्पाद या इंटरफ़ेस है। जनरेटिव मॉडल भी प्रॉम्प्ट के आधार पर टेक्स्ट का वर्गीकरण कर सकता है, भले ही उसकी आंतरिक जनरेशन प्रक्रिया और उत्तर का प्रारूप अलग हो।
विभेदक AI बनाम जनरेटिव AI
| विभेदक AI | जनरेटिव AI | |
|---|---|---|
| सामान्य प्रश्न | “इस इनपुट के लिए कौन-सी श्रेणी उपयुक्त है?” | “कौन-सा उत्तर या कंटेंट तैयार किया जाना चाहिए?” |
| सामान्य आउटपुट | लेबल, अनुमान, स्कोर या प्रायिकता | टेक्स्ट, कोड, इमेज, ऑडियो या अन्य जनरेट किया गया कंटेंट |
| उदाहरण कार्य | ग्राहक सहायता टिकट को सही विभाग तक भेजना | ग्राहक के लिए उत्तर का मसौदा तैयार करना |
| जाँचने योग्य प्रमुख क्षमता | एकसमान सीमित निर्णय और उपयोगी स्कोर | लचीला संश्लेषण, व्याख्या और निर्माण |
| मूल्यांकन का मुख्य विषय | वर्गीकरण संबंधी त्रुटियाँ, कैलिब्रेशन और थ्रेशोल्ड | सटीकता, निर्देशों का पालन, सुरक्षा और उपयोगिता |
यह अंतर इस नियम पर आधारित नहीं है कि एक मॉडल केवल एक ही कार्य कर सकता है। LLM JSON लेबल लौटा सकता है और निर्णय प्रणाली किसी बड़े वर्कफ़्लो में जनरेटिव मॉडल का उपयोग कर सकती है। व्यावहारिक अंतर यह है कि प्रत्येक घटक को किस काम के लिए अनुकूलित किया गया है और उसे किस रूप में उपलब्ध कराया गया है। केवल संरचित API उत्तर से यह साबित नहीं होता कि उसकी प्रायिकताएँ कैलिब्रेटेड हैं या उसका मूल मॉडल विभेदक है।
रिफंड टिकट पर विचार करें। निर्णय मॉडल समस्या को बिलिंग श्रेणी में रख सकता है और उसकी तात्कालिकता का अनुमान लगा सकता है। इसके बाद जनरेटिव मॉडल संबंधित रिफंड नीति के आधार पर सहानुभूतिपूर्ण उत्तर का मसौदा तैयार कर सकता है। कोई भी कार्रवाई करने से पहले एप्लिकेशन को नीति, अनुमतियों और आवश्यक मानवीय स्वीकृति की जाँच करनी चाहिए।
किसी एप्लिकेशन में निर्णय मॉडल कैसे काम करते हैं
सटीक स्कीमा प्रदाता के अनुसार अलग होता है, लेकिन एक सामान्य निर्णय अनुरोध में तीन हिस्से होते हैं:
- स्थिति (State): वह जानकारी जिसका मूल्यांकन करना है, जैसे टिकट का टेक्स्ट या कोई इमेज।
- प्रश्न और मानदंड: लिया जाने वाला निर्णय और अनुमत उत्तरों या स्कोर स्तरों का विवरण।
- टाइप किया हुआ उत्तर: एप्लिकेशन की व्याख्या के लिए लौटाया गया लेबल, स्कोर या प्रायिकता वितरण।
उदाहरण:
State: "I was charged twice for my subscription."
Question: Which team should handle this request?
Options: billing, technical support, sales
Illustrative result: billing
यह एक वैचारिक उदाहरण है, वास्तविक API उत्तर नहीं। एंडपॉइंट के आधार पर मॉडल विश्वास स्तर या प्रायिकताएँ भी दे सकता है। यह मानने के बजाय कि सभी प्रदाता एक ही अनुरोध प्रारूप का उपयोग करते हैं या समान प्रकार के इनपुट का समर्थन करते हैं, संबंधित मॉडल और API के दस्तावेज़ों का पालन करें।
प्रायिकता स्कोर का क्या अर्थ है?
अनुमानित प्रायिकता तभी उपयोगी है जब आप उसकी विश्वसनीयता समझते हों। यदि कोई सिस्टम समान प्रकार के कई अनुमानों को 0.8 का स्कोर देता है, तो अच्छी तरह कैलिब्रेटेड सिस्टम में उस समूह के लगभग 80% अनुमान सही होने चाहिए। एक अकेला 0.8 स्कोर किसी व्यक्तिगत निर्णय की शुद्धता की गारंटी नहीं देता।
अपने डेटा पर कैलिब्रेशन की जाँच करें, खासकर मॉडल, लेबल, भाषाएँ या इनपुट स्रोत बदलने के बाद। कम विश्वास वाले मामलों को समीक्षा के लिए भेजने हेतु थ्रेशोल्ड का उपयोग किया जा सकता है, लेकिन इन थ्रेशोल्ड का चयन गलत सकारात्मक और गलत नकारात्मक परिणामों की लागत के आधार पर करें। धोखाधड़ी की समीक्षा के लिए कतार और सामान्य कंटेंट सुझाव के लिए अलग नियमों की आवश्यकता होती है।
विभेदक AI के उदाहरण और उपयोग के मामले
सहायता टिकट का वर्गीकरण और रूटिंग
निर्णय मॉडल आने वाले संदेशों को बिलिंग, तकनीकी सहायता या खाता प्रबंधन विभाग में वर्गीकृत कर सकता है। अस्पष्ट अनुरोधों के लिए “अन्य” या “समीक्षा आवश्यक” विकल्प जोड़ें और ऐसे संदेशों का परीक्षण करें जिनमें कई समस्याएँ हों। केवल समग्र सटीकता नहीं, बल्कि प्रत्येक श्रेणी की त्रुटि दर का मूल्यांकन करें: यदि किसी मॉडल का डेटासेट सामान्य प्रश्नों से भरा है, तो वह अच्छा प्रदर्शन दिखा सकता है, भले ही वह बिलिंग से जुड़ी तत्काल शिकायतों को पहचानने में विफल हो।
कंटेंट मॉडरेशन
मॉडरेशन वर्कफ़्लो यह पूछ सकता है कि कोई कंटेंट निर्धारित नीति श्रेणी में आता है या नहीं। मॉडल को स्पष्ट मानदंड और उदाहरण दें, कठिन मामलों का मूल्यांकन करें और अनिश्चित या गंभीर मामलों को प्रशिक्षित समीक्षकों के पास भेजें। निर्णय स्कोर आपकी नीति प्रक्रिया का एक इनपुट है, इस बात का प्रमाण नहीं कि कंटेंट किसी नियम का उल्लंघन करता है।
LLM और एजेंट रूटिंग
LLM को कॉल करने से पहले कोई एप्लिकेशन अनुरोध को विषय, जटिलता या आवश्यक इनपुट प्रकार के आधार पर वर्गीकृत कर सकता है। रूटिंग घटक इसके बाद वर्कफ़्लो चुन सकता है या अतिरिक्त जानकारी माँग सकता है। डाउनस्ट्रीम सिस्टम के साथ रूटिंग का परीक्षण करें: यदि पहला सस्ता चरण कठिन अनुरोधों को गलत प्रक्रिया में भेजता है, तो उसका कोई लाभ नहीं है।
दस्तावेज़ और इमेज की छँटाई
मल्टीमॉडल निर्णय मॉडल यह वर्गीकृत कर सकता है कि कोई इमेज या दस्तावेज़ निर्धारित श्रेणी में आता है या नहीं, जैसे इनवॉइस, रसीद या सहायता स्क्रीनशॉट। जाँचें कि संबंधित एंडपॉइंट आपके लिए आवश्यक इनपुट प्रारूप और इमेज प्रोसेसिंग का समर्थन करता है या नहीं। वर्गीकरण और किसी दस्तावेज़ के सभी फ़ील्ड निकालना अलग-अलग कार्य हैं; जाँचें कि चुना गया मॉडल और API दोनों कार्यों का समर्थन करते हैं या नहीं।
मानदंड आधारित स्कोरिंग
कोई मॉडल किसी उत्तर को ऐसे विवरणों के आधार पर क्रमबद्ध स्केल पर रख सकता है, जैसे “मुख्य प्रमाण अनुपस्थित”, “आंशिक समर्थन” और “पूर्ण समर्थन”। जाँचें कि समीक्षक लेबल पर सहमत हैं या नहीं और मॉडल समान उत्तरों के साथ एकसमान व्यवहार करता है या नहीं। सत्यापन के बिना मानदंड आधारित स्कोर को वस्तुनिष्ठ माप के रूप में प्रस्तुत न करें।
Felo मॉडल कैटलॉग में उपलब्ध निर्णय मॉडल
Felo मॉडल कैटलॉग में Decisions आउटपुट फ़िल्टर शामिल है। 2 नवंबर, 2026 को सूचीबद्ध उदाहरण:
| कैटलॉग में सूचीबद्ध मॉडल | वर्णित उपयोग | कैटलॉग में दिखाए गए इनपुट |
|---|---|---|
| TypeSafe Jev 1.14 | रूटिंग, वर्गीकरण और मॉडरेशन | टेक्स्ट और इमेज; सूची में इमेज समर्थन को प्रयोगात्मक बताया गया है |
| LiquidAI d1.1 | हाँ/नहीं, विकल्प और स्कोर संबंधी निर्णय | टेक्स्ट और इमेज |
| Baseten Joey 1 | वर्गीकरण और रूटिंग | टेक्स्ट और इमेज |
| Perplexity Decider Flash V1.2 | वर्गीकरण, रूटिंग और स्कोरिंग | टेक्स्ट और इमेज |
ये विवरण कैटलॉग पर आधारित हैं, स्वतंत्र प्रदर्शन परीक्षण नहीं हैं और न ही किसी एक मॉडल को सर्वश्रेष्ठ बताने की सिफारिश हैं। उपलब्धता, फीचर समर्थन, कॉन्टेक्स्ट सीमाएँ और मूल्य बदल सकते हैं। निर्माण शुरू करने से पहले मौजूदा सूची और एंडपॉइंट दस्तावेज़ों की जाँच करें, खासकर प्रयोगात्मक या मल्टीमॉडल सुविधाओं के लिए। किसी मॉडल की सूची में मौजूदगी से यह साबित नहीं होता कि प्रत्येक प्रदाता की मूल API सुविधा हर प्लेटफ़ॉर्म पर उपलब्ध है।
AI निर्णय मॉडल का मूल्यांकन कैसे करें
एक सीमित निर्णय और विश्वसनीय लेबल वाले प्रतिनिधि उदाहरणों के समूह से शुरुआत करें। कठिन मामलों, कम प्रतिनिधित्व वाली श्रेणियों, अधूरे संदर्भ और ऐसे उदाहरणों को शामिल करें जिनमें किसी मानव को निर्णय लेना चाहिए। इसके बाद मॉडल की तुलना किसी सरल बेसलाइन, मौजूदा क्लासिफायर या संरचित आउटपुट वाले LLM से करें।
केवल सटीकता नहीं, बल्कि इन मापदंडों का भी मूल्यांकन करें:
- प्रिसीजन और रिकॉल: कौन-सी त्रुटियाँ महत्वपूर्ण हैं और प्रत्येक श्रेणी में वे कितनी बार होती हैं?
- कैलिब्रेशन: क्या अनुमानित प्रायिकताएँ मामलों के समूहों में देखे गए परिणामों से मेल खाती हैं?
- कवरेज: आपके चुने गए थ्रेशोल्ड पर कितने अनुरोध स्वचालित रूप से संभाले जा सकते हैं?
- लेटेंसी और विश्वसनीयता: क्या पूरी API कॉल आपकी प्रोडक्शन आवश्यकताओं को पूरा करती है?
- लागत: उपयोगी निर्णय की प्रति इकाई लागत कितनी है, जिसमें दोबारा प्रयास, कई प्रश्न, इमेज प्रोसेसिंग और मानवीय समीक्षा शामिल हैं?
- मजबूती: क्या विभिन्न भाषाओं, प्रारूपों, अपरिचित उदाहरणों और बदलते ट्रैफ़िक में प्रदर्शन बना रहता है?
लेबल और थ्रेशोल्ड को समायोजित करने के बाद अलग रखे गए टेस्ट सेट का उपयोग करें। प्रोडक्शन में, जहाँ उचित हो वहाँ परिणाम लॉग करें, असहमतियों की समीक्षा करें और मॉडल संस्करण, नीति या इनपुट वितरण में बदलाव होने पर पुनर्मूल्यांकन करें। गंभीर परिणामों वाले निर्णयों के लिए सार्थक मानवीय निगरानी की व्यवस्था करें और लागू आवश्यकताओं की जाँच करें।
अक्सर पूछे जाने वाले प्रश्न
क्या विभेदक AI और निर्णय मॉडल एक ही हैं?
नहीं। विभेदक AI इनपुट से किसी लक्ष्य का अनुमान लगाने के व्यापक दृष्टिकोण को दर्शाता है। निर्णय मॉडल सीमित आउटपुट, जैसे विकल्प, स्कोर और प्रायिकताओं पर केंद्रित एक नई उत्पाद श्रेणी है। कुछ निर्णय मॉडल विभेदक तकनीकों का उपयोग करते हैं, लेकिन दोनों शब्द एक ही चीज़ का वर्णन नहीं करते।
क्या LLM वर्गीकरण या निर्णय ले सकता है?
हाँ। जनरेटिव LLM को कंटेंट का वर्गीकरण करने या संरचित आउटपुट लौटाने के लिए प्रॉम्प्ट दिया जा सकता है। कोई समर्पित निर्णय मॉडल बेहतर, तेज़ या कम लागत वाला प्रदर्शन करेगा या नहीं, यह कार्य, मॉडल, प्रदाता और मूल्यांकन पद्धति पर निर्भर करता है। अपने उदाहरणों पर दोनों का परीक्षण करें।
क्या निर्णय मॉडल की प्रायिकताएँ हमेशा सटीक होती हैं?
नहीं। किसी विशेष डेटासेट या उपसमूह पर मॉडल की प्रायिकताएँ खराब तरीके से कैलिब्रेटेड हो सकती हैं। वर्कफ़्लो को स्वचालित करने के लिए थ्रेशोल्ड का उपयोग करने से पहले कैलिब्रेशन और गलतियों के परिणामों का मूल्यांकन करें।
मुझे जनरेटिव AI का उपयोग कब करना चाहिए?
जब कार्य में मसौदा तैयार करना, व्याख्या करना, जानकारी का संश्लेषण करना या मुक्त प्रारूप में कंटेंट बनाना शामिल हो, तब जनरेटिव मॉडल का उपयोग करें। कई एप्लिकेशन में निर्णय मॉडल और जनरेटिव मॉडल साथ काम करते हैं: एक रूटिंग या वर्गीकरण करता है, जबकि दूसरा उत्तर तैयार करता है।
विभेदक AI डेवलपर को वर्कफ़्लो में स्पष्ट और मापने योग्य निर्णय शामिल करने का तरीका देता है। एक सीमित कार्य से शुरुआत करें, महत्वपूर्ण त्रुटियों का परीक्षण करें और उपलब्ध प्रमाण के आधार पर स्वचालन का स्तर तय करें।
Felo कैटलॉग में निर्णय मॉडल देखें →
यह पोस्ट इन भाषाओं में भी उपलब्ध है: English, 简体中文, 日本語, 한국어, 繁體中文, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português।