
Felo API पर Gemini 4 Carbon: स्पेसिफिकेशन, बेंचमार्क, मूल्य निर्धारण और उपयोग के मामले

Felo API पर Gemini 4 Carbon: इसका 1M-टोकन एकीकृत बजट, थिंकिंग स्तर, मल्टीमॉडल सीमाएँ, प्रकाशित बेंचमार्क, वास्तविक मूल्य और इसे API के माध्यम से उपयोग करने का तरीका।
Google का Gemini 4 Carbon उन कार्यों के लिए कंपनी का प्रमुख मॉडल है जिन्हें एक त्वरित प्रयास में पूरा करना संभव नहीं है: दर्जनों सेवाओं को प्रभावित करने वाला कोडबेस माइग्रेशन, ऐसा सुरक्षा-दोष खोज अभियान जिसका अंत काम करने वाले पैच के साथ होना चाहिए, या ऐसा शोध प्रश्न जिसके उत्तर के लिए आत्मविश्वास से भरे एक पैराग्राफ के बजाय साक्ष्यों की श्रृंखला आवश्यक हो।
यह मॉडल Felo API के माध्यम से उपलब्ध है। Felo सीमित अवधि के निःशुल्क ट्रायल के साथ प्रदाताओं की रियायती दरें भी पेश कर रहा है। इस गाइड को पढ़ने से पहले आप Felo के Gemini 4 Carbon पेज पर जाकर मॉडल खोल सकते हैं, प्लेग्राउंड में प्रॉम्प्ट आज़मा सकते हैं और API key बना सकते हैं।
यह लेख एक व्यावहारिक मार्गदर्शिका है, लॉन्च की घोषणा नहीं। इसमें बताया गया है कि Carbon क्या है, यह Gemini 4 Argon से कैसे अलग है, प्रकाशित बेंचमार्क क्या बताते हैं और क्या नहीं बताते, इसका असामान्य टोकन बजट कैसे काम करता है, मॉडल किन कार्यों में सक्षम है, किन कार्यों में निराश कर सकता है और Felo पर इसकी वर्तमान कीमत क्या है।
Gemini 4 Carbon क्या है?
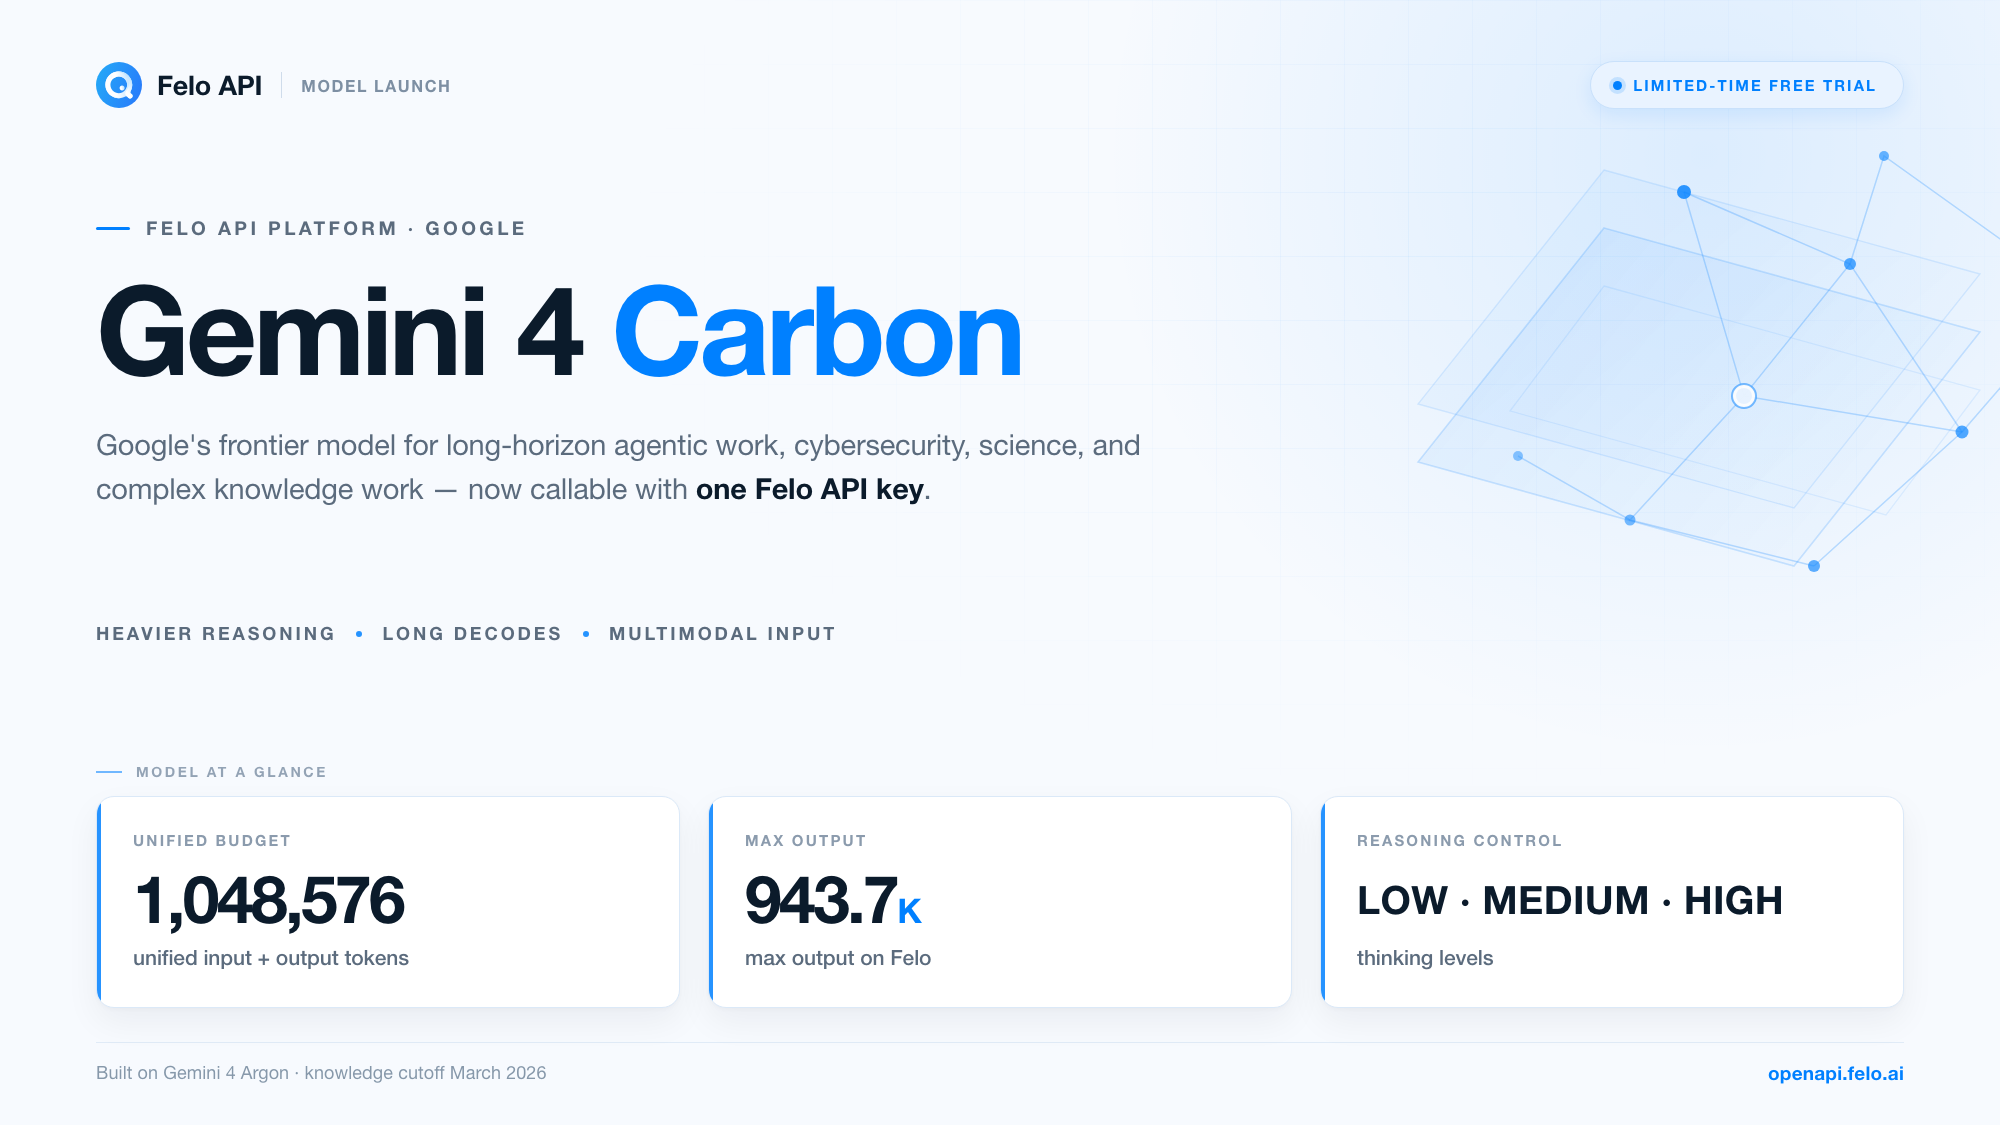
Gemini 4 Carbon, Google का प्रमुख मॉडल है। इसे कोडिंग, वित्त, कानूनी कार्य, साइबर सुरक्षा और विज्ञान के उन एजेंटिक कार्यों के लिए बनाया गया है जिनमें लंबी कार्य-प्रक्रिया और गहन विश्लेषण की आवश्यकता होती है। Google ने 28 अक्टूबर, 2026 को इसकी घोषणा की। यह Gemini 4 Argon पर आधारित है और शुरुआत में Fairwind Program के माध्यम से साइबर सुरक्षा क्षेत्र के चुनिंदा रक्षात्मक विशेषज्ञों के लिए जारी किया गया था। Google के एंटरप्राइज़ प्लेटफ़ॉर्म के दस्तावेज़ों में अब यह मॉडल सामान्य उपलब्धता की स्थिति में सूचीबद्ध है, जिसकी रिलीज़ तारीख 10 नवंबर, 2026 है।
"Carbon" नाम किसी नई पीढ़ी का संकेत नहीं देता। यह Gemini 4 परिवार के भीतर एक अलग संचालन शैली को दर्शाता है। Argon को एक ही प्रक्रिया में लंबे और सुसंगत दस्तावेज़ तैयार करने के लिए अनुकूलित किया गया था। Carbon अपने बजट का अधिक हिस्सा सोच-विचार पर खर्च करता है: संभावित परिकल्पनाओं की जाँच, सत्यापन के कई चरण और बहु-चरणीय कार्यों का समन्वय। Google के अनुसार, उत्तर तैयार करने के लिए यह Argon की तुलना में अधिक थिंकिंग टोकन का उपयोग करता है।
इस क्षमता की एक कीमत भी है। कठिन कार्यों में यह मॉडल धीमा है, कुछ परिस्थितियों में टाइमआउट हो सकता है और उच्च थिंकिंग स्तर पर अधिक टोकन खर्च करता है। Google इन सीमाओं को अपने दस्तावेज़ों में स्वीकार करता है। इसके बावजूद Carbon चुनने का कारण यह है कि इसके लक्षित कार्यों — सुरक्षा विश्लेषण, बड़े माइग्रेशन, वैज्ञानिक तर्क और महत्वपूर्ण दस्तावेज़ों की समीक्षा — में गति से अधिक गहराई का महत्व है।
मॉडल स्पेसिफिकेशन एक नज़र में
| स्पेसिफिकेशन | मान |
|---|---|
| Felo पर Model ID | gemini-4-carbon |
| घोषणा | 28 अक्टूबर, 2026 |
| आधारित मॉडल | Gemini 4 Argon |
| कॉन्टेक्स्ट और आउटपुट | इनपुट और आउटपुट को कवर करने वाला 1,048,576 टोकन का एकीकृत बजट |
| Felo पर सूचीबद्ध अधिकतम आउटपुट | 943.718K टोकन |
| इनपुट | टेक्स्ट, इमेज, ऑडियो, वीडियो, PDF और Office/OpenDocument फ़ाइलें |
| आउटपुट | टेक्स्ट |
| थिंकिंग स्तर | LOW, MEDIUM (डिफ़ॉल्ट), HIGH |
| नॉलेज कटऑफ | मार्च 2026 |
| सैंपलिंग | Temperature 1.0, top-p 0.95, top-k 64, निश्चित |
| कैशिंग | केवल इम्प्लिसिट कैशिंग, न्यूनतम 4,096 टोकन |
| अनुशंसित Felo इंटरफ़ेस | Messages API (Anthropic-compatible) |
| एक्सेस | चुनिंदा क्षेत्रों में सत्यापित एंटरप्राइज़ ग्राहक; साइबर वेरिएंट केवल Allowlist के माध्यम से |
इस तालिका के दो विवरणों पर अलग से चर्चा आवश्यक है, क्योंकि वे मॉडल के साथ एप्लिकेशन बनाने के तरीके को प्रभावित करते हैं: एकीकृत टोकन बजट और थिंकिंग स्तर।
Gemini 4 Carbon और Gemini 4 Argon में अंतर
Carbon और Argon एक ही मॉडल परिवार, नॉलेज कटऑफ और कई समान उपयोग क्षेत्रों को साझा करते हैं। इनके बीच का अंतर मॉडल की क्षमता के उपयोग के तरीके में है।
एकीकृत इनपुट और आउटपुट बजट। Argon को सामान्यतः 1,048,576 टोकन की कॉन्टेक्स्ट विंडो और अलग से 65,536 टोकन के डिफ़ॉल्ट आउटपुट के साथ वर्णित किया जाता है। Carbon के 1,048,576 टोकन इनपुट, थिंकिंग, टूल कॉल और अंतिम उत्तर — सभी के लिए साझा हैं। यह एक ही बजट है, कॉन्टेक्स्ट विंडो और अलग आउटपुट सीमा का संयोजन नहीं।
डिफ़ॉल्ट रूप से गहन तर्क क्षमता। Carbon में LOW, MEDIUM और HIGH थिंकिंग स्तर उपलब्ध हैं। gemini-4-carbon के लिए MEDIUM डिफ़ॉल्ट है, जबकि साइबर-अनुमति वाले वेरिएंट में HIGH डिफ़ॉल्ट है। इसे लंबे सत्यापन चक्रों के लिए बनाया गया है। इसी कारण Google अधिक टोकन उपयोग को एक ज्ञात सीमा के रूप में बताता है, बग के रूप में नहीं।
लंबे डिकोड। स्ट्रीमिंग के दौरान एक फ़ोरग्राउंड सेगमेंट अधिकतम 65,536 आउटपुट टोकन तैयार कर सकता है। बिना स्ट्रीमिंग के यह सीमा 32,768 टोकन है। इससे आगे जाने के लिए Long Decodes का उपयोग किया जाता है। Google Gen AI SDK और Agent Studio कंटिन्यूएशन टोकन का प्रबंधन अपने स्तर पर करते हैं, या आप स्वयं एक कस्टम कंटिन्यूएशन लूप चला सकते हैं। सैद्धांतिक अधिकतम सीमा आपके इनपुट को घटाने के बाद बचा पूरा एकीकृत बजट है।
अधिक फ़ाइल फ़ॉर्मेट का समर्थन। Carbon Microsoft Office और OpenDocument फ़ाइलें स्वीकार करता है — .docx, .doc, .pptx, .ppt, .xlsx, .xls, .odt, .odp, .ods — जिन्हें इनलाइन या क्लाउड स्टोरेज से भेजा जा सकता है। इसके अलावा PDF और सामान्य टेक्स्ट भी समर्थित हैं। यह सुविधा उन कार्यप्रवाहों में उपयोगी है जिनकी शुरुआत टेक्स्ट एक्सपोर्ट के बजाय प्रेज़ेंटेशन, स्प्रेडशीट या कॉन्ट्रैक्ट से होती है।
सुरक्षा अनुकूलन और अलग साइबर वेरिएंट। Google के अनुसार, लाइव कोडिंग वातावरण में उच्च-गंभीरता वाले Misalignment अलर्ट लगभग 80% घटे हैं। टेक्स्ट-टू-टेक्स्ट सुरक्षा मूल्यांकन में बहुभाषी और मल्टीमॉडल कंटेंट सुरक्षा के मामले में Carbon, Argon से 3.50 प्रतिशत अंक बेहतर प्रदर्शन करता है। इसके अलावा gemini-4-carbon-cyber-permissive नाम का एक अलग वेरिएंट भी है। यह रक्षात्मक सुरक्षा कार्यों के लिए केवल Allowlist के माध्यम से उपलब्ध है, इसका डिफ़ॉल्ट थिंकिंग स्तर HIGH है और इसमें कंप्यूटर उपयोग की सुविधा हटा दी गई है।
विज्ञान-केंद्रित व्यवहार। Google का कहना है कि यह मॉडल सुरक्षा लक्ष्यों को गणितीय प्रमेयों में बदल सकता है और पेटाबेस-स्तर के सीक्वेंस आर्काइव में दूरस्थ Homologs खोज सकता है। कंपनी कम-Homolog प्रोटीन परिवारों के लिए Homolog Retrieval में औसतन 40 गुना वृद्धि की रिपोर्ट करती है। यह एक विशिष्ट शोध कार्य से जुड़ा सीमित दावा है। इसे सामान्य क्षमता मानने के बजाय अपने डेटा पर इसकी पुष्टि करना उचित है।
एकीकृत टोकन बजट को समझें
अधिकांश मॉडल पेज दो संख्याएँ देते हैं: एक कॉन्टेक्स्ट विंडो और अधिकतम आउटपुट। Carbon एक संख्या और प्रति-सेगमेंट नियम देता है। यदि आप पुराने तरीके से अनुरोधों की योजना बनाते हैं, तो आपके पास उपलब्ध जगह का अनुमान गलत हो सकता है या बिल को समझने में गलती हो सकती है।
इस बजट का वास्तविक विभाजन इस प्रकार है:
- इनपुट — आपका प्रॉम्प्ट, संलग्न दस्तावेज़, इमेज, ऑडियो, वीडियो फ़्रेम और पिछली बातचीत।
- थिंकिंग — उत्तर तैयार करने से पहले मॉडल द्वारा उपयोग किए जाने वाले तर्क टोकन। HIGH स्तर पर इनकी संख्या काफी अधिक हो सकती है।
- टूल कॉल — टूल सक्षम होने पर मॉडल द्वारा उपयोग किए जाने वाले सभी टूल।
- अंतिम उत्तर — वह टेक्स्ट जो आपको प्राप्त होता है।
इन चारों के लिए 1,048,576 टोकन का एक ही बजट है। यदि किसी अनुरोध में 900K टोकन का इनपुट है, तो आउटपुट के लिए 1M टोकन उपलब्ध नहीं होंगे। कंटिन्यूएशन से पहले थिंकिंग, टूल और उत्तर के लिए कुल मिलाकर लगभग 148K टोकन ही बचेंगे।
प्रति-सेगमेंट सीमा इससे अलग है। स्ट्रीमिंग अनुरोध में एक सेगमेंट अधिकतम 65,536 आउटपुट टोकन तक सीमित है। बिना स्ट्रीमिंग के यह सीमा 32,768 है। Long Decodes सेगमेंट की सीमा पार करने के बाद भी प्रक्रिया जारी रखते हैं, जब तक एकीकृत बजट समाप्त नहीं हो जाता। यदि आपका इंटीग्रेशन max_tokens को कुल आउटपुट की गारंटी मानता है, तो यह गलत है। यह एक सेगमेंट की सीमा तय करता है। लंबे दस्तावेज़ के लिए SDK का कंटिन्यूएशन प्रबंधन आवश्यक है।
Felo के मॉडल पेज पर अधिकतम आउटपुट 943.718K टोकन सूचीबद्ध है। इसे Felo के रूट पर आउटपुट की अधिकतम सीमा मानें, दूसरी और बड़ी कॉन्टेक्स्ट विंडो नहीं। एकीकृत बजट में आपके उत्तर के लिए उपलब्ध जगह इस बात पर निर्भर करती है कि आपने कितना इनपुट भेजा है।
इस डिज़ाइन से जुड़ा व्यावहारिक नियम सरल है: पहले आउटपुट का आकार तय करें, फिर उसके अनुसार इनपुट की योजना बनाएँ। लंबी रिपोर्ट के लिए आउटपुट और थिंकिंग बजट सुरक्षित रखें और स्रोत सामग्री को उसी के अनुसार सीमित करें। बड़े दस्तावेज़ संग्रह के विश्लेषण में यह स्वीकार करें कि उत्तर इनपुट से छोटा होगा और कंटिन्यूएशन या चरणबद्ध प्रॉम्प्ट की योजना बनाएँ।
थिंकिंग स्तर: गुणवत्ता का आधार
Carbon में तीन थिंकिंग स्तर उपलब्ध हैं: LOW, MEDIUM और HIGH। MEDIUM डिफ़ॉल्ट है। Google के दस्तावेज़ों के अनुसार, thinking_budget और thinking_level="MINIMAL" देने पर Validation Error मिलता है। इसलिए तर्क क्षमता को शून्य पर सेट नहीं किया जा सकता।
इन स्तरों के व्यावहारिक अंतर स्पष्ट हैं। LOW पर मॉडल तेज़ Frontier Chat मॉडल की तरह काम करता है: डेटा निकालने, वर्गीकृत करने, दोबारा लिखने और सामान्य कोड समीक्षा के लिए उपयुक्त। MEDIUM पर यह योजना बनाने और स्वयं जाँच करने के लिए टोकन खर्च करता है। HIGH पर लंबे सत्यापन चक्र चलते हैं। यह सेटिंग सूक्ष्म त्रुटियों को पकड़ने की सबसे अधिक संभावना रखती है, लेकिन इसके साथ धीमी प्रतिक्रिया और अधिक लागत का जोखिम भी है।
व्यावहारिक उपयोग के लिए कुछ नियम:
- गलत उत्तर की कीमत के अनुसार स्तर चुनें। यदि गलती पकड़ना और सुधारना आसान है, तो LOW चुनें। यदि गलती प्रोडक्शन सिस्टम या किसी आधिकारिक दस्तावेज़ में पहुँच सकती है, तो HIGH का परीक्षण करें।
- प्रति अनुरोध टोकन के बजाय प्रति स्वीकृत परिणाम टोकन मापें। अधिक थिंकिंग से दोबारा प्रयास और सुधार का काम घट सकता है। उन कार्यों की लागत भी कई गुना हो सकती है जिन्हें मॉडल MEDIUM पर पूरा कर सकता था। पूरी प्रक्रिया की तुलना करें।
- यह न मानें कि बेंचमार्क में उपयोग की गई सेटिंग आपके लिए भी लागू होती है। Google के प्रकाशित मुख्य आँकड़ों में हर बार उपयोग किए गए थिंकिंग स्तर का उल्लेख नहीं है। किसी कार्यप्रवाह पर निर्णय लेने से पहले अपने कार्यों को दो थिंकिंग स्तरों पर जाँचें।
सैंपलिंग के मान Temperature 1.0, top-p 0.95 और top-k 64 पर निश्चित हैं। कस्टम मानों को अनदेखा किया जाता है। यदि आपकी पाइपलाइन कम-तापमान वाली Determinism पर निर्भर करती है, तो उस चरण के लिए Carbon उपयुक्त मॉडल नहीं है। इसका उपयोग निर्णय और संश्लेषण के लिए करें। निश्चित परिणामों वाले चरण किसी ऐसे मॉडल पर रखें जो सैंपलिंग नियंत्रण स्वीकार करता हो।
Google के प्रकाशित बेंचमार्क और उनका अर्थ
Felo का मॉडल पेज Carbon के लिए प्रदाता द्वारा प्रकाशित बेंचमार्क परिणामों को एकत्र करता है। नीचे दी गई तुलनाएँ प्रदर्शन की सामान्य दिशा बताती हैं। ये Google या मूल्यांकन प्रदाता से प्राप्त आँकड़े हैं, इस लेख के लिए इनकी स्वतंत्र रूप से पुनः जाँच नहीं की गई है और ये आपके कार्यभार के बजाय परीक्षण की परिस्थितियों को दर्शाते हैं।
| मूल्यांकन | क्या मापता है | Gemini 4 Carbon | संदर्भ |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | संयुक्त तर्क क्षमता सूचकांक | 59 | पहला स्थान; Claude Opus 5.5 का स्कोर 58 |
| SEC-bench Pro | सुरक्षा कमजोरियों की खोज | 88.2% | सुरक्षा, रक्षात्मक स्कैनिंग |
| CWE-bench | सुरक्षा कमजोरियों के पैच | 71.0% | सुरक्षा, सुधार |
| ExploitGym | सुरक्षा कमजोरियों का शोषण | 54.8% | सुरक्षा शोध, नियंत्रित परिस्थितियाँ |
| Terminal-Bench 4.0 | सफल धोखाधड़ी दर | 0.0% | Reward-Hacking प्रतिरोध, क्षमता नहीं |
| Vals Index | ज्ञान-आधारित कार्यों का संयुक्त मूल्यांकन | 70.45% | 36 मॉडलों में तीसरा स्थान |
| Legal Research Bench | कानूनी शोध | 55.77% | पहला स्थान |
| General Financial Intelligence | वित्तीय कार्य | #1 | Balyasny Asset Management के अनुसार 23 Frontier कॉन्फ़िगरेशन में शीर्ष स्थान |
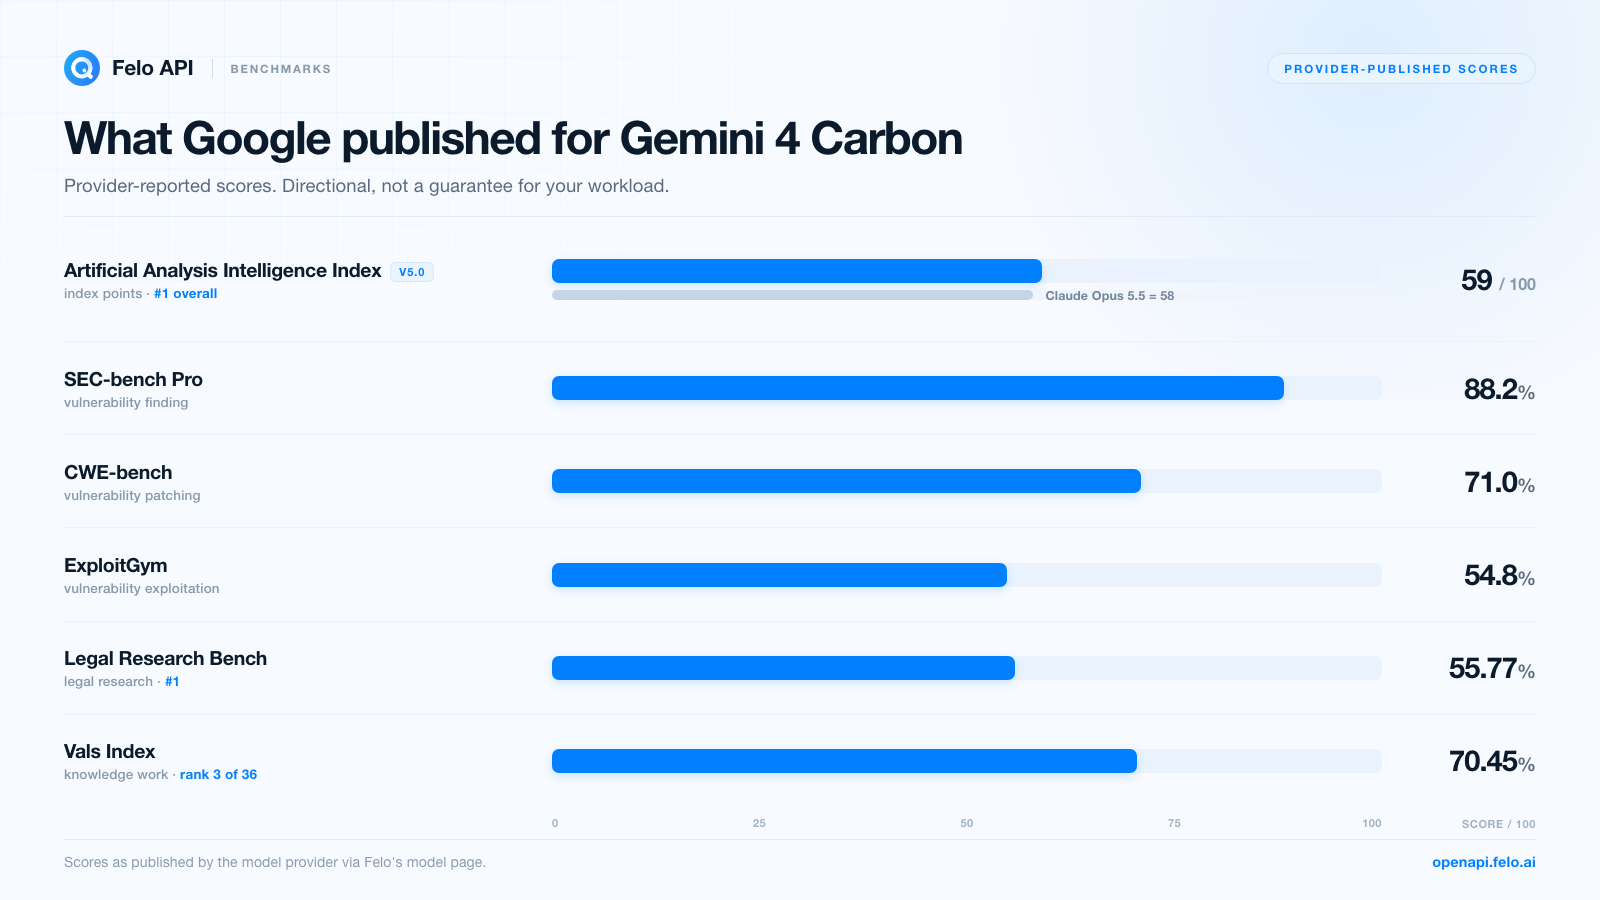
तालिका को ध्यान से पढ़ने पर तीन महत्वपूर्ण बातें सामने आती हैं।
सुरक्षा स्कोर एक पूरी प्रक्रिया दर्शाते हैं, कोई एक कौशल नहीं। सुरक्षा कमजोरियों की खोज, उनके पैच लिखना और उनका शोषण करना अलग-अलग कौशल हैं। Carbon के प्रकाशित आँकड़े कमजोरियों की खोज में सबसे मजबूत हैं (SEC-bench Pro पर 88.2%) और शोषण में कमजोर (ExploitGym पर 54.8%)। पैचिंग का प्रदर्शन इनके बीच है (CWE-bench पर 71.0%)। यदि आपका कार्य रक्षात्मक सुरक्षा से जुड़ा है — स्कैनिंग, प्राथमिकता निर्धारण और सुधार — तो यह प्रदर्शन उपयुक्त है। यदि आपको स्वायत्त रूप से कमजोरियों का शोषण करने की आवश्यकता है, तो स्कोर कम है और एक्सेस नियम अधिक सख्त हैं।
धोखाधड़ी दर का माप बुद्धिमत्ता के बजाय विश्वसनीयता से जुड़ा है। Terminal-Bench 4.0 का "successful cheating rate" यह मापता है कि मॉडल कार्य हल करता है या बेंचमार्क में हेरफेर करता है। 0.0% का परिणाम Reward-Hacking के प्रति प्रतिरोध का दावा है। यह उस समय महत्वपूर्ण है जब आप किसी एजेंट को बिना निगरानी के काम करने देते हैं। यह क्षमता का स्कोर नहीं है और इसकी तुलना तालिका के अन्य प्रतिशत-आधारित सही उत्तरों से नहीं करनी चाहिए।
ज्ञान-आधारित कार्यों की रैंकिंग अधिकांश टीमों के लिए अधिक उपयोगी है। Vals Index पर 36 मॉडलों में तीसरा स्थान, Legal Research Bench पर पहला स्थान और Balyasny की वित्तीय तुलना में शीर्ष स्थान ऐसे कार्यों का संकेत देते हैं जिनके लिए Frontier मॉडल की लागत उचित हो सकती है: बड़ी मात्रा में सामग्री पढ़ना, परस्पर विरोधी साक्ष्यों का मिलान करना और ऐसा दस्तावेज़ तैयार करना जिसकी पेशेवर समीक्षा संभव हो। ये परिणाम प्रॉम्प्ट डिज़ाइन और स्रोतों की गुणवत्ता से भी काफी प्रभावित होते हैं। इन्हें परीक्षण का कारण मानें, परीक्षण छोड़ने का आधार नहीं।
एक और सावधानी आवश्यक है: Artificial Analysis Index एक संयुक्त स्कोर है। Claude Opus 5.5 पर एक अंक की बढ़त उस सीमा में है जहाँ अलग-अलग कार्यों का मिश्रण रैंकिंग बदल सकता है। आपके विशिष्ट कार्यों में दोनों मॉडलों का प्रदर्शन बहुत अलग हो सकता है — किसी भी दिशा में।
Gemini 4 Carbon किन कार्यों में उपयोगी है?
बेंचमार्क एक नक्शा हैं, वास्तविक क्षेत्र नहीं। नीचे ऐसे कार्यभार दिए गए हैं जिनके लिए Carbon का डिज़ाइन उपयुक्त है।
बड़े पैमाने पर कोडिंग और माइग्रेशन
Carbon को ऐसे इंजीनियरिंग कार्यों के लिए बनाया गया है जिनमें कई एजेंटों के बीच सहयोग, नियमित डिबगिंग, बड़े कोडबेस का माइग्रेशन और एल्गोरिदम डिज़ाइन शामिल हैं। एकीकृत बजट यहाँ उपयोगी है: आप एक ही अनुरोध में रिपॉज़िटरी का मैप, संबंधित स्रोत फ़ाइलें, विफल टेस्ट का आउटपुट और माइग्रेशन की आवश्यकताएँ दे सकते हैं। इसके बाद कोड में बदलाव से पहले योजना माँग सकते हैं।
इस प्रकार के मॉडल के लिए उपयोगी प्रॉम्प्ट:
संलग्न रिपॉज़िटरी मैप और तीन सर्विस मॉड्यूल पढ़ें। सेशन इंटरफ़ेस को बदलने से प्रभावित होने वाले सभी कॉल साइट की पहचान करें, संगतता से जुड़े जोखिमों की सूची बनाएँ और माइग्रेशन का क्रम सुझाएँ। अभी कोड न लिखें। दी गई फ़ाइलों से जिन बातों की पुष्टि नहीं हो सकी, उन्हें चिह्नित करें।
पहले योजना माँगें। योजना की समीक्षा के बाद ही मॉडल को टेस्ट चलाने की अनुमति दें। कोड में हुए बदलावों की समीक्षा मनुष्य से कराएँ। अच्छी योजना बनाने वाला मॉडल भी ऐसा पैच तैयार कर सकता है जो कंपाइल तो हो जाए, लेकिन गलत व्यवहार करे।
रक्षात्मक साइबर सुरक्षा
सुरक्षा बेंचमार्क का प्रदर्शन — कमजोरियों की खोज में मजबूत, पैचिंग में अच्छा और शोषण में कमजोर — रक्षात्मक कार्यों के अनुरूप है: कोडबेस में सुरक्षा कमजोरियों की श्रेणियाँ खोजना, स्कैनर के परिणामों का विश्लेषण करना, पैच सुझाना और जोखिम को ऐसी भाषा में समझाना जिस पर समीक्षक कार्रवाई कर सके। Google का साइबर वेरिएंट इसी काम के लिए बनाया गया है। लेकिन इसका एक्सेस Fairwind Program के माध्यम से Allowlist पर आधारित है और इसके लिए अलग स्वीकृति आवश्यक है।
दो सावधानियाँ। पहली, सुरक्षा कार्यप्रवाह केवल उन सिस्टम पर चलाएँ जिनकी जाँच करने का आपको अधिकार है। दूसरी, किसी निष्कर्ष पर कार्रवाई से पहले उसकी पुष्टि करें। उच्च आत्मविश्वास के साथ सुरक्षा कमजोरी बताने वाला मॉडल भी गलत हो सकता है और गलत सकारात्मक परिणाम से इंजीनियरिंग समय बर्बाद होता है।
वैज्ञानिक और तकनीकी शोध
विज्ञान से जुड़ी रिपोर्ट की गई क्षमता विशिष्ट है: सुरक्षा लक्ष्यों को गणितीय प्रमेयों में बदलना और पेटाबेस-स्तर के सीक्वेंस आर्काइव में दूरस्थ Homologs खोजना। यदि आप किसी प्रयोगशाला या शोध समूह में काम करते हैं, तो उपयोगी तरीका यह है कि Carbon को स्पष्ट सीमाओं वाला प्रश्न, संबंधित साहित्य या सीक्वेंस और साक्ष्य तथा अनुमान को अलग रखने का निर्देश दें।
Homolog Retrieval में 40 गुना वृद्धि का दावा उल्लेखनीय है, लेकिन यह एक विशिष्ट पाइपलाइन में कम-Homolog प्रोटीन परिवारों से संबंधित है। इस पर आधारित कार्यप्रवाह बनाने से पहले अपनी टीम के विश्वसनीय बेंचमार्क पर इसका परीक्षण करें।
वित्त, कानूनी कार्य और महत्वपूर्ण दस्तावेज़ों की समीक्षा
ज्ञान-आधारित कार्यों में Carbon की रैंकिंग पेशेवर सेवाओं के लिए इसका सबसे मजबूत पक्ष है। ऐसे कार्यों में लेजर का मिलान, विचलन विश्लेषण, अदालती फैसलों और नियामक दस्तावेज़ों की समीक्षा तथा संदर्भों के साथ मेमो तैयार करना शामिल है। मॉडल इमेज और PDF पढ़ सकता है, इसलिए स्कैन किए गए दस्तावेज़ और चार्ट भी इनपुट के रूप में उपयोग किए जा सकते हैं।
लेकिन इससे समीक्षा की आवश्यकता समाप्त नहीं होती। स्रोत सामग्री दें, हर निष्कर्ष के पीछे मौजूद अंश का संदर्भ माँगें और उन संदर्भों की जाँच करें। दस लाख टोकन का कॉन्टेक्स्ट संभालने वाला मॉडल भी पेज 412 को गलत पढ़ सकता है।
टूल के साथ लंबे समय तक चलने वाले एजेंट
Carbon Function Calling, Structured Output, Code Execution, URL Context, Computer Use और कई Grounding विकल्पों का समर्थन करता है। इनमें Google Search, Google Maps और थर्ड-पार्टी सर्च प्रदाता शामिल हैं। यह एजेंटिक वीडियो समझने की सुविधा भी देता है, जो दस्तावेज़ के बजाय रिकॉर्डिंग मिलने पर उपयोगी है।
मॉडल का यह सबसे अधिक संसाधन माँगने वाला उपयोग है और इसमें टोकन खर्च होने का जोखिम भी सबसे अधिक है। एजेंट की गतिविधियों पर नज़र रखें: टूल कॉल लॉग करें, Iterations की सीमा तय करें और कार्रवाई से पहले एजेंट से सत्यापित जानकारी का सारांश माँगें। 1M टोकन का बजट महत्वाकांक्षी एजेंट बनाने की सुविधा देता है, लेकिन उन्हें सस्ता नहीं बनाता।
मल्टीमॉडल इनपुट और उनकी सीमाएँ
Carbon टेक्स्ट, इमेज, ऑडियो, वीडियो, PDF और Office दस्तावेज़ स्वीकार करता है तथा टेक्स्ट आउटपुट देता है। इसकी सीमाएँ पर्याप्त हैं, लेकिन निश्चित हैं। ये सीमाएँ समर्थित मीडिया फ़ॉर्मेट की सूची से अधिक महत्वपूर्ण हैं।
| इनपुट प्रकार | व्यावहारिक सीमा |
|---|---|
| ऑडियो | प्रति प्रॉम्प्ट लगभग 8.4 घंटे या अधिकतम 1M टोकन; अधिकतम 1,000 ऑडियो फ़ाइलें |
| वीडियो | ऑडियो के साथ लगभग 45 मिनट, बिना ऑडियो के लगभग 1 घंटा; प्रति प्रॉम्प्ट अधिकतम 10 वीडियो |
| इमेज और दस्तावेज़ | प्रति प्रॉम्प्ट कुल मिलाकर अधिकतम 3,000 |
| दस्तावेज़ | प्रति फ़ाइल अधिकतम 3,000 पेज |
| Office फ़ॉर्मेट | .docx, .doc, .pptx, .ppt, .xlsx, .xls |
| OpenDocument फ़ॉर्मेट | .odt, .odp, .ods |
| इनपुट आकार | GenerateContent API पर 500 MiB कंप्रेस्ड; Interactions API पर 256 MiB |
ऑडियो की सीमा सबसे उल्लेखनीय है। एक अनुरोध में आठ घंटे का ऑडियो स्वीकार करने की सुविधा मीटिंग पर निर्भर टीमों के कार्य करने का तरीका बदल सकती है। ट्रांसक्रिप्शन और छोटे हिस्सों में विभाजन के बजाय आप पूरे दिन की कॉल देकर मुख्य विषय, निर्णय और लंबित प्रश्न पूछ सकते हैं। इसकी कीमत टोकन में चुकानी होगी। ऑडियो टोकन पर इनपुट टोकन की दर लागू होती है, इसलिए पूरे दिन की रिकॉर्डिंग अपलोड करना निःशुल्क नहीं है।
वीडियो की सीमा सामान्य उपयोग के अधिक करीब है। ऑडियो के साथ 45 मिनट का वीडियो किसी लेक्चर, उत्पाद डेमो या रिकॉर्ड किए गए इंटरव्यू के लिए पर्याप्त है, पूरे सम्मेलन के लिए नहीं।
कुछ क्षमताएँ उपलब्ध नहीं हैं, इसलिए उनकी योजना बनाना आवश्यक है। Gemini Live API समर्थित नहीं है, इसलिए रियल-टाइम वॉइस उपलब्ध नहीं है। RAG Engine और Model Tuning भी समर्थित नहीं हैं। इस कारण Retrieval और Fine-Tuning का प्रबंधन आपके एप्लिकेशन स्तर पर करना होगा। Explicit Context Caching भी उपलब्ध नहीं है। केवल 4,096 टोकन की न्यूनतम सीमा वाली Implicit Caching समर्थित है। बार-बार लंबे प्रॉम्प्ट भेजने पर लागत की योजना बनाते समय इस सीमा को ध्यान में रखें।
Felo पर Gemini 4 Carbon API का उपयोग कैसे करें
Felo इस मॉडल के लिए Messages API को अनुशंसित इंटरफ़ेस बताता है। इसका Endpoint Anthropic-संगत Request Format स्वीकार करता है:
https://openapi.felo.ai/api/v1/messages
Model ID है gemini-4-carbon।
इसकी प्रक्रिया Felo के अन्य मॉडलों जैसी है:
- Felo API Key बनाएँ। Felo Console में Key बनाएँ और उसे
FELO_API_KEYके रूप में स्टोर करें। Key को कोड रिपॉज़िटरी में Commit न करें और Logs में Paste न करें। - पहले Playground में परीक्षण करें। Gemini 4 Carbon Playground में कोड लिखने से पहले प्रॉम्प्ट आज़माएँ।
- एक छोटा अनुरोध भेजें। छोटे प्रॉम्प्ट से शुरुआत करें और Response Format की पुष्टि करें।
- Streaming जोड़ें। Server-Sent Events के लिए
stream: trueसेट करें। यह सुविधा महत्वपूर्ण है, क्योंकि एक सेगमेंट में 65,536 टोकन तक हो सकते हैं। - प्रतिनिधि कार्य का परीक्षण करें। अपनी वास्तविक इनपुट मात्रा, वास्तविक मूल्यांकन मानदंड और कम से कम दो थिंकिंग स्तरों का उपयोग करके पाइपलाइन पर निर्णय लें।
एक न्यूनतम Python अनुरोध इस प्रकार है:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
इंटीग्रेशन से जुड़ी दो बातें ध्यान रखें। पहली, यह मॉडल तर्क क्षमता रखता है। बातचीत जारी रखते समय प्राप्त Reasoning Metadata को सुरक्षित रखें, अन्यथा मॉडल के लिए आवश्यक संदर्भ खो सकता है। दूसरी, max_tokens कुल आउटपुट के बजाय एक सेगमेंट की सीमा है। लंबे आउटपुट के लिए संख्या बढ़ाने पर निर्भर रहने के बजाय अपने SDK की Continuation सुविधा का उपयोग करें।
Felo उन मॉडलों के लिए OpenAI-संगत Chat Completions और Responses Endpoints का दस्तावेज़ भी उपलब्ध कराता है जो इनका समर्थन करते हैं। Carbon के लिए मॉडल पेज Messages API की अनुशंसा करता है। इसलिए OpenAI-आधारित Client में बदलाव करने से पहले मॉडल पेज पर समर्थित इंटरफ़ेस की पुष्टि करें।
Felo पर Gemini 4 Carbon की कीमत
Felo, Gemini 4 Carbon को पाँच Google प्रदाताओं के माध्यम से उपलब्ध कराता है। सभी रूट पर 50% की छूट सूचीबद्ध है। नीचे दी गई कीमतें प्रति 1 मिलियन टोकन हैं। प्रत्येक स्थान पर सामान्य और रियायती दर दोनों दिखाई गई हैं।
| रूट | इनपुट | आउटपुट | कैश रीड |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
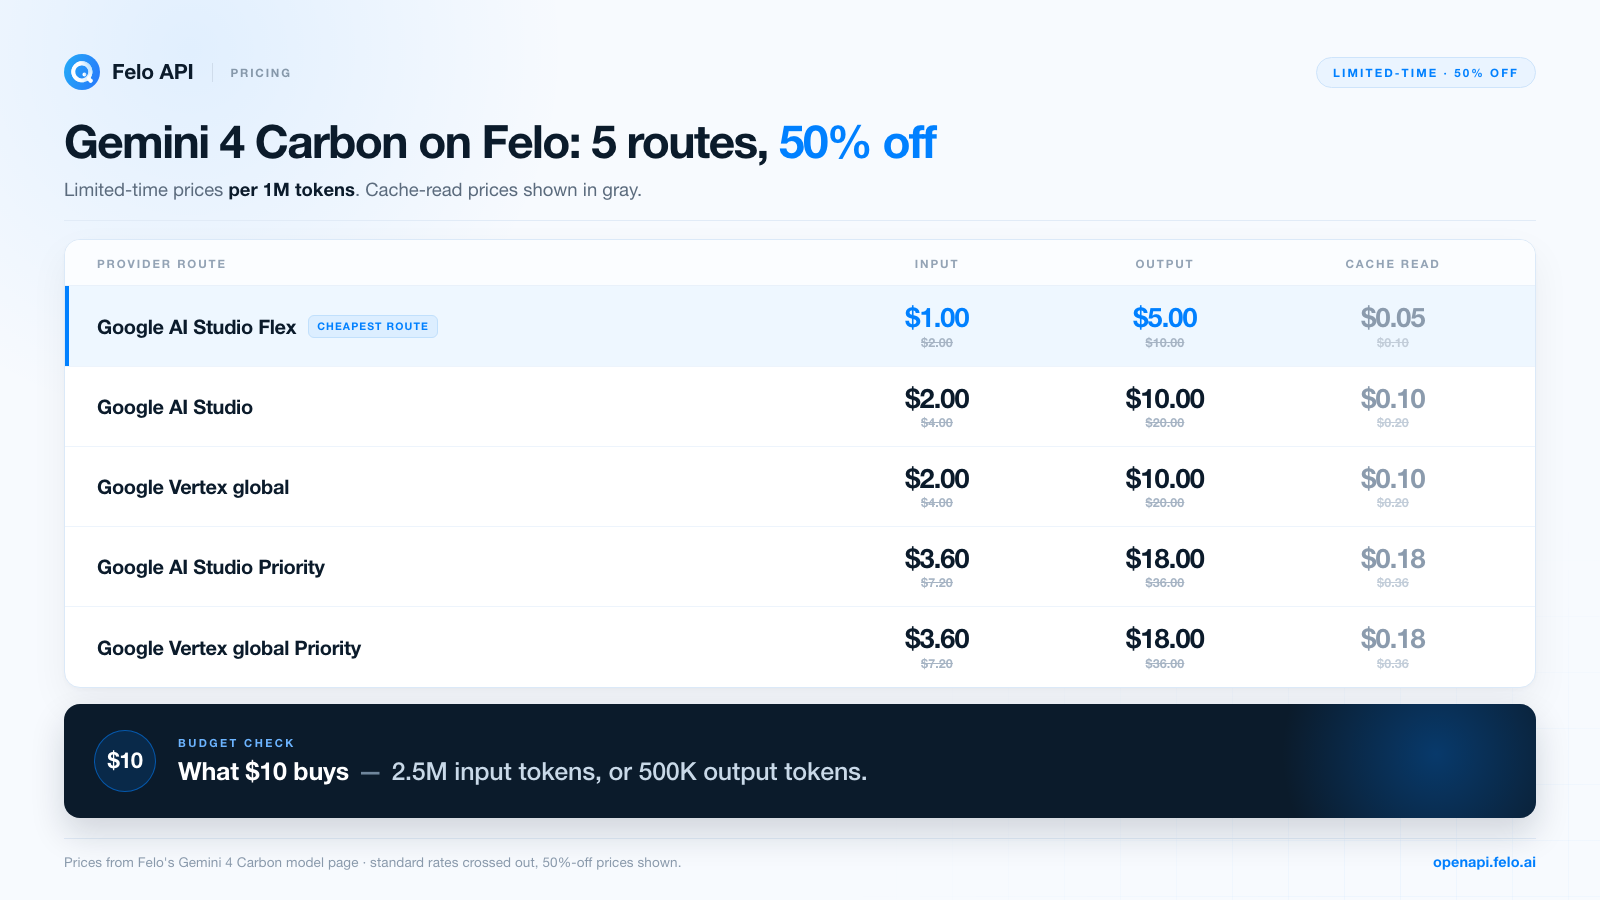
Felo का मूल्य निर्धारण पेज सामान्य दरों को "What $10 Buys" के रूप में प्रस्तुत करता है: लगभग 2.5 मिलियन इनपुट टोकन या 500,000 आउटपुट टोकन, छूट से पहले। Proof of Concept का आकार तय करने के लिए यह उपयोगी तरीका है। यदि किसी परीक्षण में 100,000 टोकन वाले दस्तावेज़ भेजे जाते हैं और 5,000 टोकन के उत्तर मिलते हैं, तो रियायती Flex रूट पर इसकी लागत लगभग $0.13 होगी — इनपुट के लिए $0.10 और आउटपुट के लिए $0.025। इस लागत पर निर्णय लेने से पहले दर्जनों परीक्षण किए जा सकते हैं।
निःशुल्क ट्रायल रियायती दरों से अलग ऑफ़र है। Felo के मॉडल पेज पर Gemini 4 Carbon के लिए सीमित अवधि का निःशुल्क ट्रायल दिखाया गया है। क्रेडिट खर्च करने की प्रतिबद्धता के बिना मॉडल का परीक्षण करने का यह सबसे सरल तरीका है। मॉडल पेज पर मौजूदा शर्तें देखें, क्योंकि ट्रायल की उपलब्धता और दरों पर छूट सीमित अवधि के लिए हैं और बदल सकती हैं।
इस मॉडल की लागत की योजना बनाते समय एक अतिरिक्त आदत आवश्यक है। थिंकिंग टोकन पर आउटपुट दर से शुल्क लगता है। इसलिए HIGH थिंकिंग वाला एजेंट रन दिखाई देने वाले उत्तर की तुलना में कई गुना महँगा हो सकता है। प्रत्येक कार्य के लिए Reasoning Tokens सहित टोकन उपयोग दर्ज करें और प्रति अनुरोध लागत के बजाय प्रति स्वीकृत परिणाम की लागत की तुलना करें।
सीमाएँ और उपयोग शुरू करने से पहले जाँचने योग्य बातें
Carbon एक Frontier मॉडल है जिसकी कुछ कमजोरियाँ दस्तावेज़ों में दर्ज हैं। प्रोडक्शन उपयोग की योजना बनाते समय इन बातों पर ध्यान दें:
- Hallucination। Google इसे एक ज्ञात सीमा मानता है। लंबा कॉन्टेक्स्ट जानकारी छूटने की संभावना घटाता है, लेकिन सही व्याख्या की गारंटी नहीं देता। संदर्भ देने और उनकी पुष्टि करने वाला कार्यप्रवाह आवश्यक है।
- Latency और Timeouts। Google कभी-कभी धीमी प्रतिक्रिया और टाइमआउट की समस्या का उल्लेख करता है। लंबे HIGH-थिंकिंग रन के लिए पर्याप्त टाइमआउट, Retry और Idempotent Task Handling की आवश्यकता है।
- अधिक टोकन उपयोग। यह मॉडल Argon की तुलना में अधिक थिंकिंग टोकन खर्च करता है, विशेषकर उच्च स्तरों पर। बजट उसी के अनुसार तय करें और सामान्य कार्यों के लिए थिंकिंग प्रयास सीमित रखें।
- मार्च 2026 का नॉलेज कटऑफ। इसके बाद की जानकारी के लिए Retrieval या वर्तमान स्रोत आवश्यक हैं। Carbon को इस तारीख के बाद की घटनाओं का ज्ञान नहीं है।
- निश्चित सैंपलिंग। Temperature, top-p और top-k में बदलाव नहीं किया जा सकता। यदि आपकी पाइपलाइन को निश्चित आउटपुट चाहिए, तो उस चरण के लिए कोई दूसरा मॉडल चुनें।
- Explicit Caching, Tuning, RAG Engine और Live API उपलब्ध नहीं हैं। इन सभी सुविधाओं से जुड़ा काम आपके एप्लिकेशन स्तर पर करना होगा।
- उपलब्धता की सीमाएँ। Google चुनिंदा क्षेत्रों में सत्यापित एंटरप्राइज़ ग्राहकों को Carbon उपलब्ध कराता है। Felo इसे Global, US और EU प्रदाताओं के माध्यम से उपलब्ध कराता है। अपने उपयोग के लिए लागू रूट और शर्तों की पुष्टि करें।
- सुरक्षा और एक्सेस नियम। साइबर वेरिएंट के लिए Allowlist आवश्यक है और सुरक्षा कार्यप्रवाह के लिए अधिकृत होना अनिवार्य है। मॉडल के सुरक्षा उपाय और प्रदाताओं की नीतियाँ भी लागू रहती हैं।
तो क्या आपको इसका उपयोग करना चाहिए?
Gemini 4 Carbon तब चुनें जब कार्य लंबा हो, साक्ष्य जटिल हों और गलत उत्तर की कीमत अधिक हो: माइग्रेशन योजना, सुरक्षा समीक्षा, शोध का संश्लेषण, वित्तीय या कानूनी विश्लेषण अथवा ऐसा एजेंट जिसे कार्रवाई से पहले जाँच करनी हो। इसके बेंचमार्क और एकीकृत बजट इसी प्रकार के कार्यों के लिए बनाए गए हैं।
इसे हर अनुरोध के लिए डिफ़ॉल्ट मॉडल न बनाएँ। बड़ी मात्रा में वर्गीकरण, छोटे डेटा निष्कर्षण, सामान्य सारांश और निश्चित सैंपलिंग की आवश्यकता वाले कार्यों के लिए सस्ते और तेज़ मॉडल बेहतर हैं। आपके गुणवत्ता मानदंड को पूरा करने वाला सबसे सस्ता मॉडल लगभग हमेशा सही विकल्प होता है। Carbon को आपके सबसे कठिन कार्यों में अपनी उपयोगिता साबित करनी चाहिए।
ईमानदार निष्कर्ष यह है: गहन कार्यों के लिए Carbon, Google का सबसे सक्षम मॉडल है। सुरक्षा, कानूनी कार्य, वित्त और लंबे कॉन्टेक्स्ट पर तर्क इसकी मापी गई खूबियाँ हैं। इसके साथ Latency और टोकन की वास्तविक लागत जुड़ी है। इसकी दर्ज सीमाओं के कारण सत्यापन अनिवार्य है। इसके आधार पर कोई कार्यप्रवाह बनाने से पहले अपने कार्यों पर इसका परीक्षण करें।
अक्सर पूछे जाने वाले प्रश्न
क्या Felo पर Gemini 4 Carbon का निःशुल्क ट्रायल उपलब्ध है?
हाँ। Felo ने Gemini 4 Carbon के लिए सीमित अवधि का निःशुल्क ट्रायल सूचीबद्ध किया है। ऑफ़र की अवधि में मॉडल की प्रदाता दरों पर भी छूट उपलब्ध है। शर्तें बदल सकती हैं, इसलिए वर्तमान उपलब्धता के लिए Gemini 4 Carbon मॉडल पेज देखें।
Gemini 4 Carbon और Gemini 4 Argon में क्या अंतर है?
Carbon, Argon पर आधारित है और इसे अधिक गहन तर्क के लिए अनुकूलित किया गया है। इसमें इनपुट, थिंकिंग, टूल कॉल और आउटपुट को कवर करने वाला 1,048,576 टोकन का एकीकृत बजट है। यह LOW, MEDIUM और HIGH थिंकिंग स्तरों का समर्थन करता है, अधिक थिंकिंग टोकन खर्च करता है और Office/OpenDocument फ़ाइलों के लिए समर्थन के साथ बेहतर सुरक्षा सुविधाएँ प्रदान करता है। लंबे दस्तावेज़ तैयार करने के लिए Argon उपयुक्त विकल्प है, जहाँ सत्यापन की गहराई से अधिक आउटपुट की लंबाई महत्वपूर्ण है।
Gemini 4 Carbon की कॉन्टेक्स्ट विंडो और अधिकतम आउटपुट कितना है?
एकीकृत बजट 1,048,576 टोकन है, जिसमें इनपुट और आउटपुट दोनों शामिल हैं। एक स्ट्रीमिंग सेगमेंट अधिकतम 65,536 आउटपुट टोकन तैयार कर सकता है। बिना स्ट्रीमिंग के यह सीमा 32,768 टोकन है। Long Decodes शेष बजट तक आउटपुट जारी रखते हैं। Felo अपने रूट पर अधिकतम 943.718K टोकन आउटपुट सूचीबद्ध करता है।
क्या Gemini 4 Carbon ऑडियो, वीडियो और Office फ़ाइलें पढ़ सकता है?
हाँ। यह टेक्स्ट, इमेज, ऑडियो, वीडियो, PDF और Office/OpenDocument फ़ाइलें स्वीकार करता है। इसकी सीमाएँ लगभग 8.4 घंटे का ऑडियो, लगभग 45–60 मिनट का वीडियो, कुल 3,000 इमेज और दस्तावेज़ तथा प्रति दस्तावेज़ 3,000 पेज हैं। आउटपुट केवल टेक्स्ट में मिलता है।
क्या Gemini 4 Carbon OpenAI-संगत API का समर्थन करता है?
Felo इस मॉडल के लिए Anthropic-संगत Messages API की अनुशंसा करता है। समर्थित मॉडलों के लिए OpenAI-संगत Chat Completions और Responses Endpoints के दस्तावेज़ भी उपलब्ध हैं। मौजूदा Client में बदलाव करने से पहले मॉडल पेज पर वर्तमान इंटरफ़ेस की पुष्टि करें।
Gemini 4 Carbon की कीमत कितनी है?
Felo पाँच Google रूट सूचीबद्ध करता है और सभी पर वर्तमान में 50% छूट है: AI Studio Flex में प्रति मिलियन टोकन $1 इनपुट और $5 आउटपुट, सामान्य AI Studio और Vertex रूट में $2 और $10 तथा Priority रूट में $3.60 और $18। Cache Read की शुरुआती कीमत प्रति मिलियन टोकन $0.05 है। वर्तमान दरों के लिए Felo का मूल्य निर्धारण पेज देखें।
Gemini 4 Carbon कब रिलीज़ हुआ था?
Google ने 28 अक्टूबर, 2026 को Gemini 4 Carbon की घोषणा की थी। शुरुआत में यह Fairwind Program के माध्यम से साइबर सुरक्षा क्षेत्र के चुनिंदा रक्षात्मक विशेषज्ञों के लिए उपलब्ध था। Google के एंटरप्राइज़ प्लेटफ़ॉर्म पर 10 नवंबर, 2026 से इसकी सामान्य उपलब्धता सूचीबद्ध है। Felo अब इस मॉडल को पाँच Google प्रदाताओं के माध्यम से उपलब्ध कराता है।
Felo पर Gemini 4 Carbon आज़माएँ
Carbon की क्षमता जाँचने का सबसे अच्छा तरीका ऐसा कार्य देना है जिसका उत्तर आपको पहले से पता हो। Gemini 4 Carbon Playground खोलें, कोई वास्तविक दस्तावेज़ या कोड नमूना डालें और एक ही प्रॉम्प्ट पर LOW तथा HIGH थिंकिंग के परिणामों की तुलना करें। यदि परिणाम आपकी अपेक्षाओं पर खरे उतरते हैं, तो API Key बनाएँ और परीक्षण को अपनी पाइपलाइन में शामिल करें।
वर्तमान ट्रायल शर्तों, प्रदाता रूट और सीमाओं की जानकारी के लिए Gemini 4 Carbon मॉडल पेज से शुरुआत करें। इसके बाद अपने सबसे कठिन वास्तविक कार्य के लिए सबसे छोटा संभव परीक्षण तैयार करें।
यह पोस्ट इन भाषाओं में भी उपलब्ध है: English, 简体中文, 日本語, 한국어, 繁體中文, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português।