GPT-6.1 सोल API: कम लागत पर नज़दीकी-अस्ट्रा प्रदर्शन
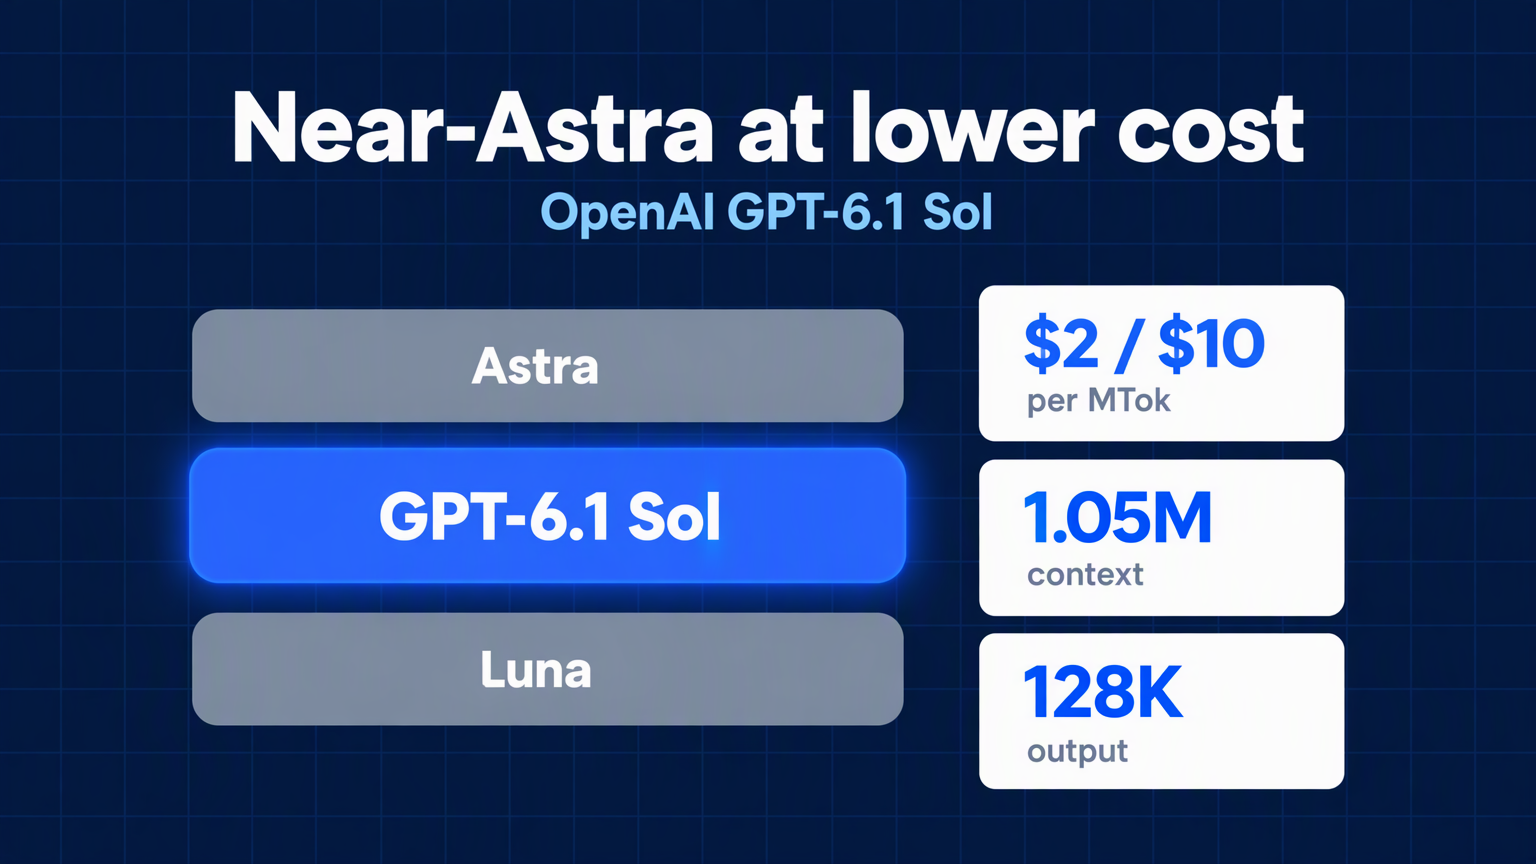
OpenAI GPT-6.1 सोल कोडिंग, कंप्यूटर उपयोग और पेशेवर कार्यों के लिए नज़दीकी-अस्ट्रा प्रदर्शन $2/$10 प्रति मिलियन टोकन पर 1.05M कॉन्टेक्स्ट विंडो के साथ लाता है।
OpenAI का नया सोल मॉडल सबसे बुद्धिमान मॉडल बनने की कोशिश नहीं करता। यह वह मॉडल बनना चाहता है जिसे आप पूरे दिन चला सकते हैं।
GPT-6.1 सोल, प्रमुख GPT-6 अस्ट्रा और हल्के GPT-6 लूना के बीच स्थित है। OpenAI के अपने मॉडल पेज पर इसे एक पंक्ति में बताया गया है: "कम लागत पर जटिल कार्यों के लिए नज़दीकी-अस्ट्रा प्रदर्शन।" एजेंटिक कोडिंग टूल, कंप्यूटर-यूज़ एजेंट और दस्तावेज़-प्रधान वर्कफ़्लो बनाने वाली टीमों के लिए यही संतुलन सबसे महत्वपूर्ण है।
यह गाइड बताता है कि GPT-6.1 सोल में क्या-क्या मिलता है, इसकी लागत क्या है, यह GPT-6 सोल और अस्ट्रा से कैसे अलग है, और इसे Felo API प्लेटफ़ॉर्म के माध्यम से कैसे कॉल करें।
GPT-6.1 सोल क्या है
GPT-6.1 सोल एक रीजनिंग मॉडल है जिसे जटिल कोडिंग, कंप्यूटर उपयोग और पेशेवर कार्यों के लिए बनाया गया है। OpenAI इसे GPT-6 परिवार में संतुलित विकल्प के रूप में प्रस्तुत करता है: लूना से अधिक सक्षम, अस्ट्रा से सस्ता, और इतना मजबूत कि कई प्रोडक्शन वर्कलोड्स को प्रमुख मॉडल की आवश्यकता नहीं होगी।
मॉडल पेज सीधे बताता है कि इसका उपयोग कैसे करें: अपने कार्यों पर सोल और अस्ट्रा की तुलना करें, फिर तय करें कि गुणवत्ता का अंतर कीमत के अंतर को सही ठहराता है या नहीं। यह व्यावहारिक मार्गदर्शन मॉडल के उद्देश्य को दर्शाता है। सोल लागत नियंत्रण का उपकरण है, न कि कोई बेंचमार्क ट्रॉफी।
Felo के मॉडल पेज पर भी यही स्थिति प्लेटफ़ॉर्म की ओर से स्पष्ट है। GPT-6.1 सोल "GPT-6 सोल का अपग्रेड है, फिर भी प्रमुख GPT-6 अस्ट्रा से नीचे स्थित है।" यह एजेंटिक कोडिंग, कंप्यूटर उपयोग, दस्तावेज़-प्रधान पेशेवर कार्य और मल्टी-स्टेप वर्कफ़्लो ऑटोमेशन संभालता है, इन कार्यों में अस्ट्रा-स्तरीय परिणामों के क़रीब पहुँचता है, वह भी बहुत कम लागत पर। GPT-6 सोल की तुलना में, Felo कम तथ्यात्मक त्रुटियाँ और स्पष्ट प्रतिबंधों के प्रति अधिक सटीकता नोट करता है।
GPT-6.1 सोल वह मॉडल है जिसे आप चुनते हैं जब कार्य कठिन, लंबा और दोहरावदार हो — और बिल अनुमानित रहना चाहिए।
GPT-6.1 सोल के स्पेसिफिकेशन एक नज़र में
OpenAI मॉडल पेज पर पूरी स्पेसिफिकेशन प्रकाशित करता है। यहाँ उसका संक्षिप्त रूप है।
| स्पेसिफिकेशन | GPT-6.1 सोल |
|---|---|
| मॉडल आईडी | gpt-6.1-sol |
| डिफ़ॉल्ट स्नैपशॉट | gpt-6.1-sol |
| कॉन्टेक्स्ट विंडो | 1,050,000 टोकन |
| अधिकतम इनपुट टोकन | 922,000 |
| अधिकतम आउटपुट टोकन | 128,000 |
| नॉलेज कटऑफ | 30 अप्रैल, 2026 |
| इनपुट मोडालिटी | टेक्स्ट, इमेज |
| आउटपुट मोडालिटी | टेक्स्ट |
| असमर्थित मोडालिटी | ऑडियो, वीडियो |
| रीजनिंग टोकन सपोर्ट | हाँ |
| रीजनिंग एफर्ट | low, medium (डिफ़ॉल्ट), high, xhigh, max |
| असमर्थित रीजनिंग एफर्ट | none, minimal |
| डेटा रेजिडेंसी | US और EU |
दो बातें मुख्य रूप से महत्वपूर्ण हैं।
पहली, रीजनिंग एफर्ट को बंद नहीं किया जा सकता। GPT-6.1 सोल none या minimal को सपोर्ट नहीं करता। यदि आप ऐसे मॉडल से माइग्रेट कर रहे हैं जो ये सेटिंग्स देता था, तो OpenAI low से शुरू करने और प्रतिनिधि कार्यों पर परिणामों की तुलना करने की सलाह देता है।
दूसरी, टूल कॉलिंग के लिए Responses API आवश्यक है। GPT-6.1 सोल टूल्स के बिना अनुरोधों के लिए चैट कंप्लीशन सपोर्ट करता है, लेकिन कोई भी वर्कफ़्लो जो फंक्शन कॉल करता है, फाइल खोजता है, वेब ब्राउज़ करता है या कंप्यूटर चलाता है, उसे Responses पर जाना होगा। यह केवल सोल की सीमा नहीं है — OpenAI पूरे प्लेटफ़ॉर्म को इसी दिशा में ले जा रहा है।
GPT-6.1 सोल की कीमत: $2/$10 में क्या मिलता है
OpenAI की GPT-6.1 सोल के लिए मानक कीमत $2 प्रति मिलियन इनपुट टोकन और $10 प्रति मिलियन आउटपुट टोकन है। पूरी टोकन तालिका में कैश प्राइसिंग भी शामिल है, जो लंबे समय तक चलने वाले एजेंट्स के लिए गणना बदल देती है।
| मेट्रिक | 1M टोकन पर कीमत |
|---|---|
| इनपुट | $2.00 |
| कैश्ड इनपुट | $0.10 |
| कैश राइट्स | $2.50 |
| आउटपुट | $10.00 |
इस तालिका के नीचे कुछ नियम लागू होते हैं:
- कैश्ड इनपुट अनकैश्ड रेट का 5% है। OpenAI GPT-6.1 सोल कैश रीड्स को 0.05x पर प्राइस करता है, जबकि अधिकांश GPT-5.6 और बाद के मॉडल्स के लिए यह 0.1x है। यह उन एजेंट्स के लिए बड़ा डिस्काउंट है जो हर बार एक बड़ा सिस्टम प्रॉम्प्ट या रिपॉजिटरी कॉन्टेक्स्ट दोहराते हैं।
- कैश राइट्स अनकैश्ड इनपुट रेट का 1.25x है। आप कैश में प्रीफ़िक्स लिखने के लिए $2.50 प्रति मिलियन टोकन देते हैं, फिर उसे वापस पढ़ने के लिए $0.10 प्रति मिलियन।
- लंबा कॉन्टेक्स्ट अधिक महंगा है। 272K इनपुट टोकन से ऊपर के प्रॉम्प्ट्स पूरे अनुरोध के लिए 2x इनपुट और कैश रेट तथा 1.5x आउटपुट पर बिल होते हैं। उस आकार में, इनपुट $4, कैश्ड इनपुट $0.20, कैश राइट्स $5, और आउटपुट $15 प्रति मिलियन टोकन हो जाता है।
- बैच और फ्लेक्स 50% सस्ते हैं। यदि आपका वर्कलोड एसिंक्रोनस प्रोसेसिंग सहन कर सकता है, तो प्रभावी दर $1 इनपुट और $5 आउटपुट प्रति मिलियन टोकन हो जाती है।
- फास्ट मोड स्टैंडर्ड से 2x महंगा है। आप कम लेटेंसी के लिए भुगतान करते हैं, अधिक बुद्धिमत्ता के लिए नहीं।
- क्षेत्रीय प्रोसेसिंग उपलब्ध होने पर 10% प्रीमियम जोड़ती है।
कैश-रीड डिस्काउंट सबसे महत्वपूर्ण है। एक कोडिंग एजेंट जो हर बार वही 100,000-टोकन रिपॉजिटरी कॉन्टेक्स्ट दोहराता है, वह $0.10 प्रति मिलियन कैश्ड टोकन देता है, जबकि ताज़ा इनपुट के लिए $2.00 प्रति मिलियन देना पड़ता। लंबे सत्र में यह अंतर तेज़ी से बढ़ता है।
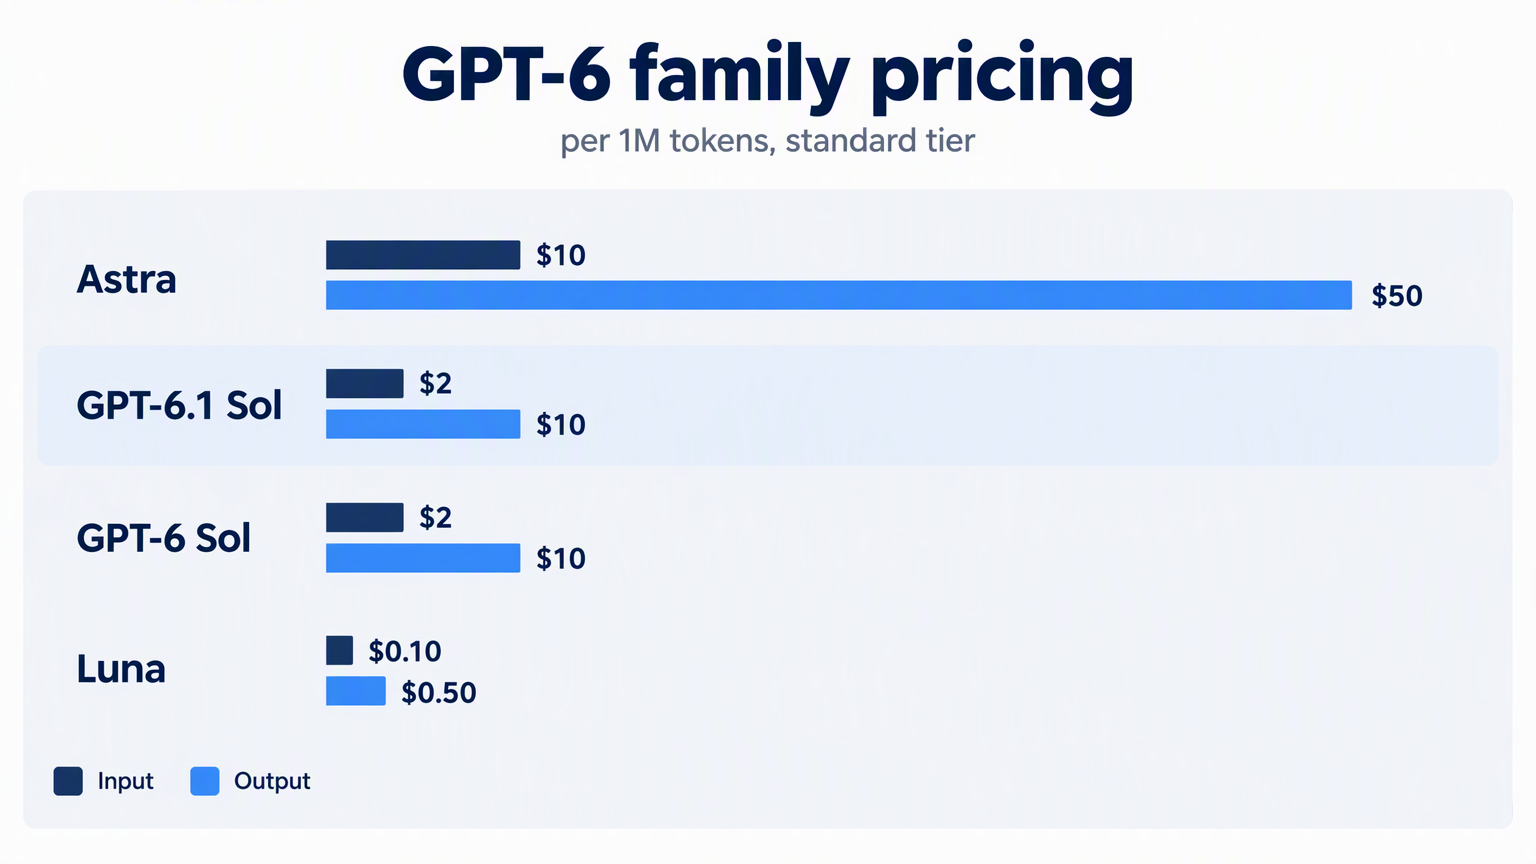
तुलना के लिए, GPT-6 अस्ट्रा $10 इनपुट और $50 आउटपुट प्रति मिलियन टोकन पर सूचीबद्ध है। GPT-6.1 सोल दोनों ओर से इसकी एक-पाँचवीं कीमत पर है। GPT-6 लूना और भी सस्ता है — $0.10 इनपुट और $0.50 आउटपुट — लेकिन वह सोल की नज़दीकी-अस्ट्रा क्षमता नहीं देता।
GPT-6 में नया क्या है जो सोल उपयोग कर सकता है
GPT-6.1 सोल GPT-6 प्लेटफ़ॉर्म की वे विशेषताएँ अपनाता है जो OpenAI ने अस्ट्रा जेनरेशन के साथ पेश की थीं। इनमें से कई एजेंटिक वर्कलोड्स के लिए खास मायने रखती हैं।
एसिंक्रोनस टूल कॉलिंग
सामान्यतः, एक फंक्शन कॉल मॉडल को तब तक रोक देता है जब तक आपका एप्लिकेशन परिणाम नहीं लौटाता। एसिंक्रोनस टूल कॉलिंग में, आप टूल डिफिनिशन में async: true सेट करते हैं और मॉडल काम जारी रखता है — रीजनिंग करता है, अन्य टूल्स कॉल करता है, या अनुरोध के स्वतंत्र हिस्सों का उत्तर देता है — जबकि आपका एप्लिकेशन बैकग्राउंड में धीमा कार्य चलाता है।
आपका एप्लिकेशन टूल को निष्पादित करता है और लंबित कार्य को प्रबंधित करता है। जब कार्य पूरा होता है, तो आप मूल call_id के साथ बाद के Responses अनुरोध में आउटपुट लौटाते हैं। OpenAI के दस्तावेज़ इसे धीमे लुकअप जल्दी शुरू करने और डेटा आने पर उत्तर में भरने का तरीका बताते हैं।
सोल के लिए, यह स्वाभाविक रूप से उपयुक्त है। एक कोडिंग एजेंट लंबा टेस्ट सूट शुरू कर सकता है, अन्य फाइलें देख सकता है, और परिणाम आने पर उन्हें शामिल कर सकता है।
मिड-टर्न स्टीयरिंग
मिड-टर्न स्टीयरिंग उपयोगकर्ता को मॉडल के काम करते समय सुधार या नई आवश्यकता भेजने देता है। Responses API के वेब सॉकेट कनेक्शन पर, सर्वर पूर्ण कार्य को संरक्षित करता है और अपडेट को कंटिन्यूएशन में शामिल करता है।
महत्वपूर्ण बात: स्टीयरिंग पहले से भेजे गए आउटपुट को नहीं बदलता, पहले की क्रियाओं को नहीं हटाता, या पहले से शुरू किए गए टूल्स को रद्द नहीं करता। यह अगले कार्य की दिशा बदलता है, पिछली नहीं। यदि स्टीयरिंग मूल उत्तर को बाधित करता है, तो वह उत्तर incomplete_details.reason: "steered" के साथ समाप्त होता है और नया उत्तर अपडेट ले जाता है।
बातचीत के दौरान रीजनिंग बदलना
आप बातचीत के दौरान configuration_update इनपुट आइटम जोड़कर रीजनिंग एफर्ट बढ़ा या घटा सकते हैं। अपडेटेड एफर्ट तब तक लागू रहता है जब तक कोई और अपडेट उसे ओवरराइड नहीं करता। OpenAI अनुरोध-स्तरीय reasoning.effort को अपरिवर्तित रखने की सलाह देता है ताकि प्रॉम्प्ट प्रीफ़िक्स कैशेबल रहे।
यह संयोजन — सस्ता कैश रीड और समायोज्य रीजनिंग — मिश्रित वर्कलोड्स के लिए सोल को किफायती बनाता है। रूटीन फॉलो-अप के लिए low का उपयोग करें, फिर कार्य कठिन होने पर xhigh पर स्विच करें, बिना बातचीत दोबारा लिखे।
मल्टी-एजेंट (बीटा)
मल्टी-एजेंट GPT-6.1 सोल और सभी GPT-5.6 मॉडल्स के साथ बीटा फीचर के रूप में उपलब्ध है। एक रूट एजेंट समानांतर में काम करने वाले सबएजेंट्स बना सकता है, प्रत्येक का अपना सीमित कॉन्टेक्स्ट होता है, फिर उनके परिणामों को अंतिम उत्तर में समाहित करता है।
OpenAI के दस्तावेज़ इसे उन कार्यों के लिए सुझाते हैं जो स्वतंत्र वर्कस्ट्रीम्स में विभाजित होते हैं: बड़े कोडबेस के अलग हिस्सों की खोज, प्रस्तावों की तुलना, स्रोतों की समानांतर रिसर्च, या एक साथ कई संभावित विफलता कारणों की जांच। डिफ़ॉल्ट max_concurrent_subagents 3 है।
ट्रेडऑफ़ टोकन उपयोग में है। अधिक एजेंट्स का अर्थ अधिक टोकन, इसलिए मल्टी-एजेंट तब फायदेमंद है जब समानांतर गति और केंद्रित कॉन्टेक्स्ट टोकन अर्थव्यवस्था से अधिक मायने रखते हैं।
संपीड़न और स्थायी रीजनिंग
लंबे समय तक चलने वाले एजेंट्स अंततः अपनी कॉन्टेक्स्ट विंडो भर देते हैं। संपीड़न कॉन्टेक्स्ट आकार घटाता है, लेकिन बाद के टर्न्स के लिए आवश्यक स्थिति बनाए रखता है। आप Responses अनुरोध में context_management के साथ compact_threshold सेट करके सर्वर-साइड संपीड़न सक्षम कर सकते हैं; जब रेंडर किए गए टोकन की गिनती सीमा पार करती है, सर्वर एक एन्क्रिप्टेड संपीड़न आइटम भेजता है।
GPT-6.1 सोल reasoning.context: "all_turns" भी सपोर्ट करता है, जिससे पिछले टर्न्स के संगत रीजनिंग आइटम्स अगले सैंपल में चलते हैं। स्थायी रीजनिंग अपारदर्शी रहती है — API कभी भी मॉडल का कच्चा रीजनिंग टेक्स्ट नहीं लौटाता — लेकिन यह मॉडल को लंबे सत्र में निरंतरता देती है।
वेब सॉकेट मोड
वेब सॉकेट मोड Responses API से एक स्थायी कनेक्शन बनाए रखता है और हर टर्न में केवल नए इनपुट आइटम भेजता है। OpenAI रिपोर्ट करता है कि 20 या अधिक टूल कॉल्स वाले रोलआउट्स में लगभग 40% तेज़ एंड-टू-एंड निष्पादन मिलता है। एजेंटिक कोडिंग और कंप्यूटर उपयोग केंद्रित मॉडल के लिए यह सीधा लेटेंसी लाभ है।
GPT-6.1 सोल बनाम GPT-6 सोल बनाम अस्ट्रा बनाम लूना
GPT-6 परिवार में अब चार स्तर हैं। इनमें से चुनना मुख्यतः इस पर निर्भर करता है कि आपको कितनी गुणवत्ता चाहिए और वर्कफ़्लो कितनी बार चलता है।
| मॉडल | स्थिति | 1M पर इनपुट / आउटपुट | सर्वोत्तम उपयोग |
|---|---|---|---|
| GPT-6 अस्ट्रा | उच्चतम बुद्धिमत्ता | $10 / $50 | मांग वाली रीजनिंग, कोडिंग, पेशेवर कार्य |
| GPT-6.1 सोल | कम लागत पर नज़दीकी-अस्ट्रा | $2 / $10 | जटिल कोडिंग, कंप्यूटर उपयोग, दस्तावेज़-प्रधान कार्य |
| GPT-6 सोल | पिछला सोल स्तर | $2 / $10 | अपग्रेड से पहले के मौजूदा सोल वर्कलोड्स |
| GPT-6 लूना | सबसे तेज़ और किफायती | $0.10 / $0.50 | केंद्रित, उच्च-वॉल्यूम कार्य |
GPT-6.1 सोल और GPT-6 सोल की कीमत समान है, लेकिन वे एक जैसे मॉडल नहीं हैं। Felo के पेज पर GPT-6.1 सोल को अपग्रेड बताया गया है जिसमें कम तथ्यात्मक त्रुटियाँ और स्पष्ट प्रतिबंधों के प्रति अधिक सटीकता है। कैश-रीड दर भी आधी है: $0.10 प्रति मिलियन टोकन, जबकि पहले $0.20 थी। यदि आप पहले से प्रोडक्शन में GPT-6 सोल चला रहे हैं, तो अपग्रेड से गुणवत्ता और कैशिंग दोनों में सुधार मिलता है, वह भी उसी सूची मूल्य पर।
OpenAI का मॉडल-चयन गाइड रीजनिंग एफर्ट को कार्य प्रकार से जोड़ता है:
- GPT-6.1 सोल मीडियम पर — जटिल तकनीकी कार्य और समन्वित डिलीवेरेबल्स जिन्हें आप संशोधित करेंगे।
- GPT-6.1 सोल एक्स्ट्रा हाई पर — परिष्कृत डिलीवेरेबल्स, जुड़े विज़ुअल सिस्टम्स, और विरोधाभासी साक्ष्य से बने निर्णय।
- अस्ट्रा लो पर — तथ्य और बारीकी बनाए रखने वाली संक्षिप्त लेखन और सामग्री अनुकूलन।
- अस्ट्रा मीडियम पर — महत्वाकांक्षी प्रोजेक्ट्स जिन्हें व्यापक कॉन्टेक्स्ट, विश्वसनीय इंटरैक्शन और पूर्ण परिणाम चाहिए।
- अस्ट्रा एक्स्ट्रा हाई पर — मांग वाली विश्लेषण और जटिल डिलीवेरेबल्स जिनकी सटीक आवश्यकताएँ हैं।
- लूना लो पर — सूक्ष्म संपादन, स्पष्ट समस्या समाधान, और सरल डेटा निष्कर्षण।
- लूना एक्स्ट्रा हाई पर — कई ऐप्स में वर्तमान कॉन्टेक्स्ट ढूँढना, कार्य प्राथमिकता देना, और स्पष्ट सीमाओं के साथ समस्याएँ हल करना।
OpenAI के Codex मार्गदर्शन का व्यावहारिक नियम: सोल का उपयोग दोहरावदार, लंबे समय तक चलने वाले कार्यों के लिए करें जब लागत मायने रखती है। अस्ट्रा को सबसे मांग वाले कार्यों के लिए रखें। लूना का उपयोग स्पष्ट, दोहरावदार कार्यों के लिए करें।
Felo API प्लेटफ़ॉर्म के माध्यम से GPT-6.1 सोल कैसे कॉल करें
Felo API प्लेटफ़ॉर्म GPT-6.1 सोल को संगत एंडपॉइंट्स के माध्यम से उपलब्ध कराता है, जिससे आप अपना मौजूदा SDK रख सकते हैं और केवल बेस URL बदल सकते हैं।
मॉडल यहाँ उपलब्ध है:
- चैट कंप्लीशन:
POST https://openapi.felo.ai/api/v1/chat/completions - Responses:
POST https://openapi.felo.ai/api/v1/responses - Messages (Anthropic-संगत):
POST https://openapi.felo.ai/api/v1/messages
चरण 1: API कुंजी प्राप्त करें
अपने Felo API प्लेटफ़ॉर्म खाते से कुंजी बनाएँ और उसे एक्सपोर्ट करें:
export FELO_API_KEY="YOUR_API_KEY"
चरण 2: अपनी पहली रिक्वेस्ट करें
curl https://openapi.felo.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "messages": [
      {"role": "user", "content": "Explain the tradeoff between reasoning effort and cost."}
    ]
  }'
चरण 3: संगत SDK का उपयोग करें
किसी भी OpenAI-संगत SDK को https://openapi.felo.ai/api/v1 पर पॉइंट करें। Claude-शैली क्लाइंट्स के लिए Anthropic-संगत बेस URL https://openapi.felo.ai/api का उपयोग करें।
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FELO_API_KEY,
  baseURL: "https://openapi.felo.ai/api/v1",
});

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  input: "Review this pull request for correctness, security, and missing tests.",
});

console.log(response.output_text);
चरण 4: आवश्यकता होने पर स्ट्रीमिंग सक्षम करें
stream: true जोड़ें ताकि मॉडल के काम करते समय सर्वर-सेंट इवेंट्स मिलें।
Felo के मॉडल पेज पर GPT-6.1 सोल की कीमत $2.00 प्रति मिलियन इनपुट टोकन और $10.00 प्रति मिलियन आउटपुट टोकन है, जिसमें लॉन्च कीमतें आधिकारिक प्रदाता API दरों से 50% तक कम हो सकती हैं। अंतिम लागत मॉडल, इनपुट/आउटपुट मिश्रण, कैश उपयोग और आपकी सक्रिय योजना पर निर्भर करती है। कैश रीड्स GPT-6 सोल की दर के आधे पर बिल होते हैं।
प्लेटफ़ॉर्म इस मॉडल के लिए रीजनिंग, टूल्स, JSON आउटपुट, स्ट्रीमिंग और विज़न भी सपोर्ट करता है, और कोड लिखने से पहले प्रॉम्प्ट्स टेस्ट करने के लिए एक Playground भी देता है।
GPT-6.1 सोल के सर्वोत्तम उपयोग केस
OpenAI का मार्गदर्शन उन जटिल प्रोजेक्ट्स की ओर इशारा करता है जहाँ लागत मायने रखती है। कुछ ठोस पैटर्न सामने आते हैं।
बड़े पैमाने पर एजेंटिक कोडिंग
एक कोडिंग एजेंट जो रिपॉजिटरी पढ़ता है, बदलाव सुझाता है, टेस्ट चलाता है और दोहराता है — यही वर्कलोड सोल के लिए बना है। 1.05M कॉन्टेक्स्ट विंडो बड़े कोडबेस को समेटती है, कैश-रीड डिस्काउंट रिपॉजिटरी कॉन्टेक्स्ट दोहराने पर लाभ देता है, और एसिंक्रोनस टूल कॉलिंग टेस्ट के दौरान एजेंट को उत्पादक बनाए रखती है।
OpenAI का Codex मार्गदर्शन लागत मायने रखने पर कोड और ऐप्स में दोहरावदार, लंबे समय तक चलने वाले कार्यों के लिए सोल की सिफारिश करता है, और सबसे मांग वाले कार्यों के लिए अस्ट्रा को सुरक्षित रखता है।
कंप्यूटर उपयोग और वर्कफ़्लो ऑटोमेशन
GPT-6.1 सोल Responses टूल्स के पूरे सेट को सपोर्ट करता है, जिनमें computer_use, hosted_shell, apply_patch, mcp, और tool_search शामिल हैं। इससे यह उन एजेंट्स के लिए उपयुक्त बनता है जो सॉफ़्टवेयर चलाते हैं, फॉर्म भरते हैं, सिस्टम्स के बीच डेटा स्थानांतरित करते हैं, या मल्टी-स्टेप बिज़नेस प्रोसेस ऑटोमेट करते हैं।
Felo के मॉडल पेज पर कंप्यूटर उपयोग और मल्टी-स्टेप वर्कफ़्लो ऑटोमेशन को प्रमुख उपयोग केस के रूप में सूचीबद्ध किया गया है।
दस्तावेज़-प्रधान पेशेवर कार्य
सोल टेक्स्ट और इमेज दोनों स्वीकार करता है, जिससे स्कैन किए गए दस्तावेज़, चार्ट, स्क्रीनशॉट और स्लाइड डेक कवर हो जाते हैं। OpenAI के मॉडल-चयन गाइड में दो उदाहरण दिए गए हैं: वित्तीय परिणामों से बोर्ड प्रेजेंटेशन बनाना, और उत्पाद ब्रीफ़ से वेबसाइट बनाना। दोनों में बड़े इनपुट, कई संशोधन, और गुणवत्ता मानक शामिल हैं जो "सर्वश्रेष्ठ संभव" से नीचे लेकिन "सस्ता और तेज़" से ऊपर होते हैं।
समानांतर वर्कस्ट्रीम्स के साथ रिसर्च और विश्लेषण
मल्टी-एजेंट बीटा सक्षम होने पर, सोल रिसर्च कार्य को स्वतंत्र वर्कस्ट्रीम्स में विभाजित कर सकता है, उन्हें एक साथ चला सकता है, और निष्कर्षों को समेट सकता है। विक्रेता प्रस्तावों की तुलना, तीन दृष्टिकोणों से पुल रिक्वेस्ट की समीक्षा, या कई विफलता परिकल्पनाओं की जांच — ये सभी उपयुक्त उदाहरण हैं।
उच्च-वॉल्यूम बैच प्रोसेसिंग
बैच और फ्लेक्स प्राइसिंग सोल की दर को $1 इनपुट और $5 आउटपुट प्रति मिलियन टोकन कर देती है। रातभर दस्तावेज़ प्रोसेसिंग, बल्क समरीकरण, या बड़े पैमाने पर निष्कर्षण जहाँ आउटपुट की समीक्षा होगी — वहाँ यह प्राइसिंग आर्थिक रूप से संभव बनाती है।
माइग्रेशन चेकलिस्ट: GPT-6 सोल से GPT-6.1 सोल पर जाना
OpenAI gpt-6-sol से gpt-6.1-sol पर स्विच करने से पहले अपनी माइग्रेशन गाइडेंस की समीक्षा करने की सलाह देता है। यहाँ उसका संक्षिप्त रूप है।
- मॉडल आईडी सेट करें।
modelकोgpt-6.1-solमें बदलें। - रीजनिंग एफर्ट ठीक करें। GPT-6.1 सोल
noneयाminimalसपोर्ट नहीं करता।noneकोlowसे बदलें औरminimalमाइग्रेशन की जाँचlowसे शुरू करें। - टूल कॉलिंग को Responses में ले जाएँ। चैट कंप्लीशन टूल्स के बिना अनुरोधों के लिए काम करता है। कोई भी फंक्शन कॉलिंग, वेब सर्च, फाइल सर्च, कंप्यूटर उपयोग या MCP वर्कफ़्लो के लिए Responses API चाहिए।
- असमर्थित पैरामीटर हटाएँ। जब रीजनिंग एफर्ट
noneनहीं है, तोtemperature,top_p, औरtop_logprobsहटा दें। चैट कंप्लीशन मेंlogprobsभी हटाएँ। Responses मेंmessage.output_text.logprobsकोincludeसे हटाएँ। - प्रॉम्प्ट कैशिंग कॉन्फ़िग अपडेट करें। यदि आप GPT-5.5 या पहले से माइग्रेट कर रहे हैं, तो
prompt_cache_retentionको"30m"सेट किए गएprompt_cache_options.ttlसे बदलें। - रीजनिंग बदलने के लिए
configuration_updateका उपयोग करें। यदि आपका ऐप टर्न्स के बीच एफर्ट बदलता है, तो अनुरोध-स्तरीयreasoning.effortबदलने के बजायconfiguration_updateआइटम्स का उपयोग करें, ताकि प्रॉम्प्ट प्रीफ़िक्स कैशेबल रहे। - डेटा रेजिडेंसी जाँचें। GPT-6.1 सोल US और EU डेटा रेजिडेंसी सपोर्ट करता है। फास्ट मोड EU डेटा रेजिडेंसी के साथ उपलब्ध नहीं है।
- अस्ट्रा के साथ परीक्षण करें। दोनों मॉडलों को प्रतिनिधि कार्यों पर चलाएँ और गुणवत्ता, लेटेंसी, और कुल लागत की तुलना करें — जिसमें रीजनिंग टोकन भी शामिल हैं, जो आउटपुट टोकन के रूप में बिल होते हैं।
सीमाएँ और उपलब्धता
GPT-6.1 सोल अस्ट्रा का सार्वभौमिक विकल्प नहीं है, और यह अभी हर जगह उपलब्ध नहीं है।
क्षमता सीमाएँ। OpenAI सोल को अस्ट्रा से नीचे रखता है। सबसे मांग वाली रीजनिंग और उच्चतम महत्व के डिलीवेरेबल्स के लिए अस्ट्रा अनुशंसित मॉडल बना रहता है। सोल जटिल कार्यों के लिए किफायती विकल्प है, अधिकतम गुणवत्ता के लिए नहीं।
कोई फाइन-ट्यूनिंग नहीं। GPT-6.1 सोल फाइन-ट्यूनिंग या प्रेडिक्टेड आउटपुट सपोर्ट नहीं करता। यह एम्बेडिंग्स, इमेज जेनरेशन, वीडियो, स्पीच, ट्रांसक्रिप्शन, ट्रांसलेशन या मॉडरेशन एंडपॉइंट्स भी सपोर्ट नहीं करता। यह टेक्स्ट-और-इमेज-इन, टेक्स्ट-आउट रीजनिंग मॉडल है।
कोई ऑडियो या वीडियो इनपुट नहीं। इनपुट मोडालिटी केवल टेक्स्ट और इमेज हैं।
रीजनिंग को अक्षम नहीं किया जा सकता। none और minimal एफर्ट असमर्थित हैं, इसलिए हर अनुरोध में रीजनिंग ओवरहेड रहता है।
रोलआउट अभी जारी है। OpenAI का लॉन्च रोलआउट Plus, Pro, Business, Enterprise, और Edu योजनाओं में Codex डेस्कटॉप और CLI पर, और ChatGPT Work वेब और मोबाइल पर शामिल करता है। Enterprise और Edu में, मॉडल डिफ़ॉल्ट रूप से बंद रहता है जब तक कोई प्रशासक इसे सक्षम नहीं करता। Free और Go योजनाएँ लॉन्च में शामिल नहीं हैं।
फास्ट मोड की सीमाएँ हैं। लॉन्च पर स्टैंडर्ड और फास्ट मोड उपलब्ध हैं, लेकिन फास्ट मोड स्टैंडर्ड से 2x महंगा है और EU डेटा रेजिडेंसी के साथ उपलब्ध नहीं है। GPT-6.1 सोल के लिए अल्ट्राफास्ट सपोर्ट बाद में आएगा।
रेट लिमिट्स लागू होते हैं। स्टैंडर्ड रेट लिमिट्स Tier 1 पर 500 RPM और 500,000 TPM से लेकर Tier 5 पर 15,000 RPM और 40,000,000 TPM तक हैं।
अक्सर पूछे जाने वाले प्रश्न
GPT-6.1 सोल क्या है?
GPT-6.1 सोल OpenAI का संतुलित GPT-6 मॉडल है, जो प्रमुख GPT-6 अस्ट्रा और हल्के GPT-6 लूना के बीच स्थित है। OpenAI इसे जटिल कोडिंग, कंप्यूटर उपयोग और पेशेवर कार्यों के लिए कम लागत पर नज़दीकी-अस्ट्रा प्रदर्शन देने वाला बताता है।
GPT-6.1 सोल की कीमत कितनी है?
OpenAI GPT-6.1 सोल को $2 प्रति मिलियन इनपुट टोकन और $10 प्रति मिलियन आउटपुट टोकन पर सूचीबद्ध करता है। कैश्ड इनपुट $0.10 प्रति मिलियन टोकन है, और कैश राइट्स $2.50 प्रति मिलियन टोकन। 272K इनपुट टोकन से ऊपर के प्रॉम्प्ट्स उच्च लॉन्ग-कॉन्टेक्स्ट दरों पर बिल होते हैं।
GPT-6.1 सोल की कॉन्टेक्स्ट विंडो क्या है?
GPT-6.1 सोल में 1,050,000-टोकन कॉन्टेक्स्ट विंडो, अधिकतम 922,000 इनपुट टोकन, और अधिकतम 128,000 आउटपुट टोकन हैं।
क्या GPT-6.1 सोल टूल कॉलिंग सपोर्ट करता है?
हाँ, लेकिन टूल कॉलिंग के लिए Responses API आवश्यक है। टूल्स के बिना अनुरोधों के लिए चैट कंप्लीशन सपोर्ट है।
क्या मैं GPT-6.1 सोल पर रीजनिंग अक्षम कर सकता हूँ?
नहीं। GPT-6.1 सोल low, medium, high, xhigh, और max रीजनिंग एफर्ट सपोर्ट करता है। यह none या minimal सपोर्ट नहीं करता।
GPT-6.1 सोल की तुलना GPT-6 सोल से कैसे है?
GPT-6.1 सोल GPT-6 सोल का अपग्रेड है जिसमें कम तथ्यात्मक त्रुटियाँ और स्पष्ट प्रतिबंधों के प्रति अधिक सटीकता है, जैसा कि Felo के मॉडल पेज पर बताया गया है। दोनों की प्रमुख टोकन प्राइसिंग समान है, लेकिन GPT-6.1 सोल कैश्ड इनपुट दर को $0.10 प्रति मिलियन टोकन कर देता है।
क्या GPT-6.1 सोल Felo API प्लेटफ़ॉर्म पर उपलब्ध है?
हाँ। Felo API प्लेटफ़ॉर्म GPT-6.1 सोल को चैट कंप्लीशन, Responses, और Anthropic-संगत Messages एंडपॉइंट्स के माध्यम से उपलब्ध कराता है। लॉन्च प्राइसिंग आधिकारिक प्रदाता API दरों से 50% तक कम हो सकती है, और कैश रीड्स GPT-6 सोल की दर के आधे पर बिल होते हैं।
निष्कर्ष
GPT-6.1 सोल OpenAI का व्यावहारिक समस्या का उत्तर है: सबसे अच्छा मॉडल अक्सर हर कार्य पर चलाने के लिए बहुत महंगा होता है, और सबसे सस्ता मॉडल अक्सर पर्याप्त अच्छा नहीं होता। सोल नज़दीकी-अस्ट्रा क्षमता, 1.05M कॉन्टेक्स्ट विंडो, 5% कैश-रीड दर, और अस्ट्रा की एक-पाँचवीं कीमत के साथ संतुलन बनाता है।
कोडिंग एजेंट्स, कंप्यूटर-यूज़ वर्कफ़्लो और दस्तावेज़-प्रधान ऑटोमेशन बनाने वाली टीमों के लिए, यह सबसे पहले परीक्षण करने योग्य मॉडल है। अपने कार्यों पर इसे अस्ट्रा से तुलना करें, रीजनिंग-टोकन उपयोग देखें, और लागत-गुणवत्ता संतुलन को निर्णय लेने दें।
आप GPT-6.1 सोल को Felo API प्लेटफ़ॉर्म Playground में आज़मा सकते हैं या सीधे Felo API कुंजी के साथ कॉल कर सकते हैं।
स्रोत
- GPT-6.1 Sol model page — OpenAI
- Using GPT-6 — OpenAI
- Model selection — OpenAI
- API pricing — OpenAI
- Codex and ChatGPT model availability — OpenAI
- Async tool calling — OpenAI
- Mid-turn steering — OpenAI
- Reasoning models — OpenAI
- Prompt caching — OpenAI
- Compaction — OpenAI
- Multi-agent — OpenAI
- WebSocket mode — OpenAI
- Fast mode — OpenAI
- Data residency — OpenAI
- GPT-6.1 Sol — Felo API Platform
यह पोस्ट इन भाषाओं में भी उपलब्ध है: English, 简体中文, 日本語, 한국어, 繁體中文, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português।