AI Diskriminatif: Model Keputusan, Contoh, dan Penggunaan

Pelajari cara AI diskriminatif dan model keputusan mengklasifikasikan, mengarahkan, dan memberi skor pada input, perbedaannya dengan AI generatif, serta penerapannya bagi pengembang.
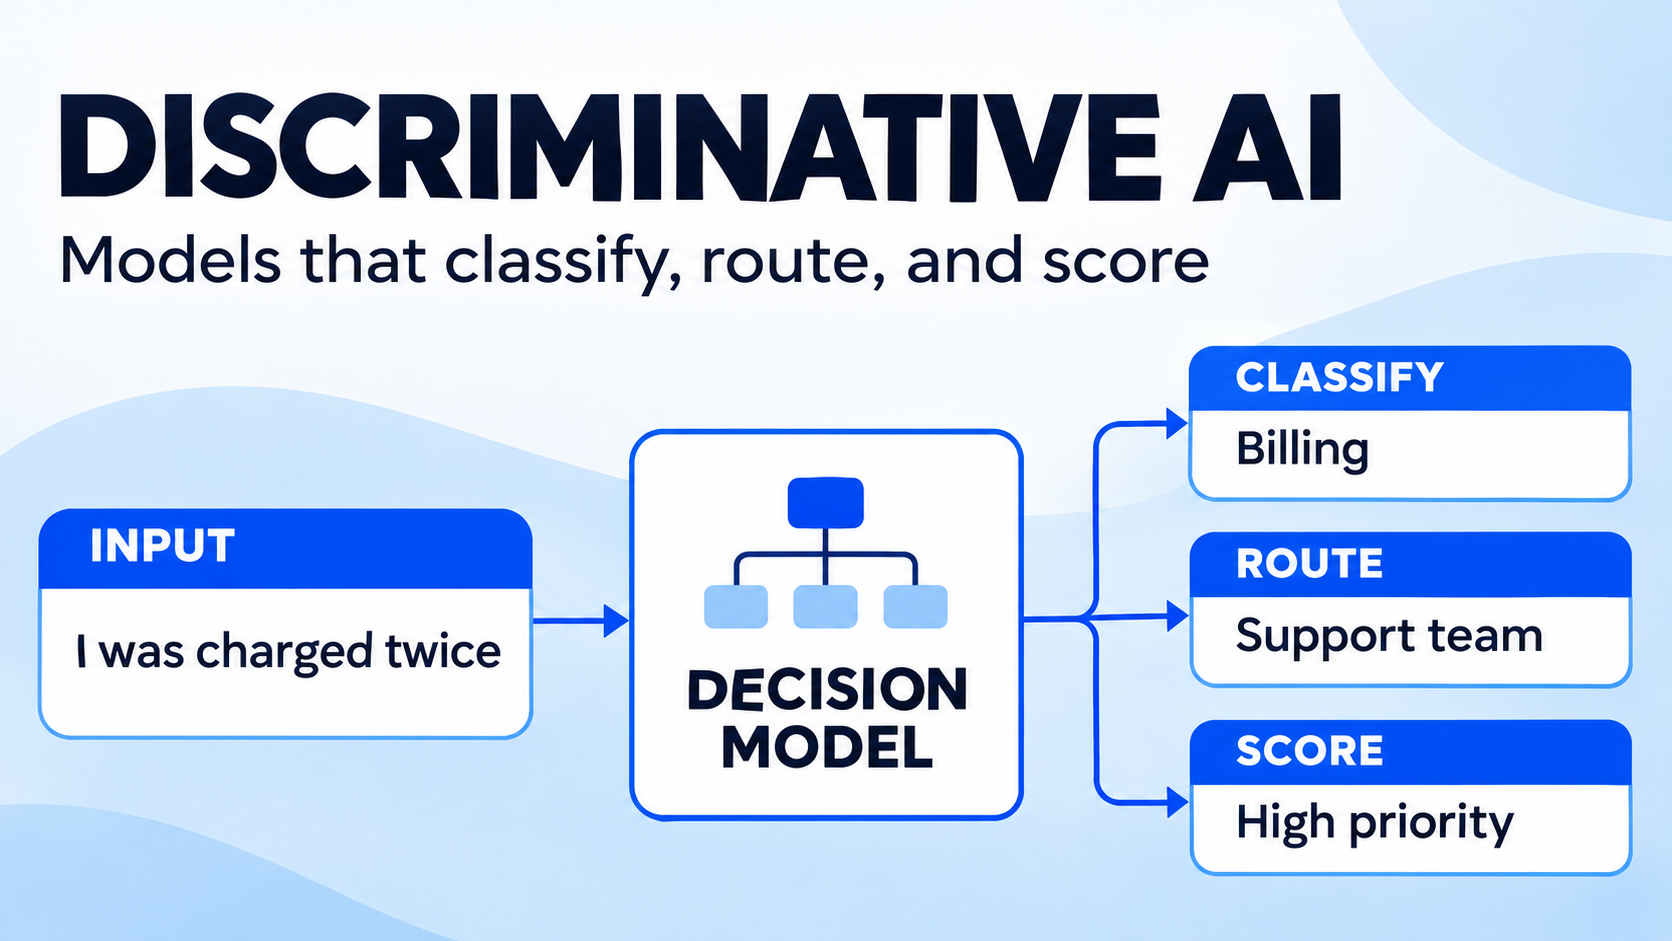
Sebuah permintaan dukungan masuk: “Saya ditagih dua kali dan membutuhkan pengembalian dana.” Aplikasi Anda belum tentu membutuhkan paragraf dari model AI. Langkah pertama yang mungkin diperlukan adalah sebuah keputusan: apakah tiket ini harus diteruskan ke bagian penagihan, dukungan teknis, atau penjualan?
AI diskriminatif (Discriminative AI) dirancang untuk memprediksi label, skor, atau target lain berdasarkan suatu input. Kelompok model keputusan yang lebih baru membawa konsep ini ke API pengembang: berikan konteks dan pertanyaan yang telah ditentukan kepada model, lalu model mengembalikan keputusan terstruktur atau probabilitas yang dapat digunakan oleh perangkat lunak. Panduan ini menjelaskan cara kerja model tersebut, posisinya di samping AI generatif, serta metode evaluasinya.
Apa itu AI diskriminatif?
AI diskriminatif memprediksi sesuatu tentang sebuah input. Filter spam memprediksi apakah sebuah email termasuk spam; pengklasifikasi menetapkan tiket dukungan ke suatu tim; model risiko memperkirakan kemungkinan hasil tertentu.
Dalam pembelajaran mesin, model diskriminatif umumnya mempelajari pemetaan dari input x ke target y, atau memperkirakan probabilitas bersyarat P(y | x). Target tersebut dapat berupa kelas, nilai numerik, atau output terstruktur lainnya. Regresi logistik, support vector machine, dan berbagai pengklasifikasi neural merupakan contoh pendekatan diskriminatif. Tidak semua model diskriminatif menghasilkan probabilitas, dan tidak semua skor numerik memiliki kalibrasi yang baik.
Gagasan dasarnya sudah ada sebelum kehadiran asisten AI masa kini. Hal baru adalah tersedianya API keputusan serbaguna yang menerima deskripsi tugas dan pilihan jawaban dalam bahasa alami. Dengan antarmuka yang sama, pengembang dapat menangani berbagai tugas klasifikasi atau pemberian skor.
Apa itu model keputusan AI?
Dalam lanskap API saat ini, model keputusan (decision model) umumnya merujuk pada model atau layanan yang dirancang untuk menjawab pertanyaan dengan batasan tertentu berdasarkan input yang diberikan. Alih-alih menyusun respons bebas, model menghasilkan hasil bertipe seperti:
- Probabilitas ya/tidak: Seberapa besar kemungkinan pesan ini berisi permintaan pengembalian dana?
- Pilihan: Departemen mana yang harus menerima tiket ini?
- Skor: Di posisi mana jawaban ini berada dalam rubrik kualitas yang telah ditentukan?
Sebagai contoh, model keputusan dapat menghasilkan label penagihan beserta perkiraan probabilitas untuk setiap departemen. Aplikasi Anda dapat menggunakan hasil tersebut untuk mengarahkan tiket, meminta informasi tambahan, atau mengirimkannya kepada peninjau manusia.
TypeSafe menyebut keluarga model Jev mereka sebagai model “System One”. Liquid AI menjelaskan model keputusan d1 sebagai model yang menerima teks dan gambar serta menghasilkan probabilitas tanpa membuat token output. Google Codelab tentang model diskriminatif menunjukkan penggunaan model keputusan bersama model generatif dalam sebuah aplikasi.
Kedua istilah ini saling berkaitan, tetapi tidak dapat dipertukarkan. Pemodelan diskriminatif merupakan konsep luas dalam pembelajaran mesin; model keputusan adalah produk atau antarmuka untuk menghasilkan keputusan dengan batasan tertentu. Model generatif juga dapat mengklasifikasikan teks melalui prompt, meskipun proses generasi dan format responsnya berbeda.
AI diskriminatif vs. AI generatif
| AI Diskriminatif | AI Generatif | |
|---|---|---|
| Pertanyaan umum | “Kategori mana yang sesuai dengan input ini?” | “Respons atau konten apa yang harus dihasilkan?” |
| Output umum | Label, prediksi, skor, atau probabilitas | Teks, kode, gambar, audio, atau konten hasil generasi lainnya |
| Contoh tugas | Mengarahkan tiket pelanggan | Menyusun draf respons kepada pelanggan |
| Keunggulan yang perlu diuji | Keputusan dengan batasan yang konsisten dan skor yang dapat digunakan | Sintesis fleksibel, penjelasan, dan pembuatan konten |
| Fokus evaluasi utama | Kesalahan klasifikasi, kalibrasi, dan ambang batas | Akurasi, kepatuhan terhadap instruksi, keamanan, dan kegunaan |
Batas antara keduanya bukan aturan yang menyatakan bahwa satu model hanya dapat menjalankan satu jenis tugas. LLM dapat menghasilkan label dalam format JSON, sedangkan sistem keputusan dapat menggunakan model generatif di dalam alur kerja yang lebih besar. Perbedaan praktisnya terletak pada fungsi yang dioptimalkan dan ditawarkan oleh setiap komponen. Respons API terstruktur saja tidak membuktikan bahwa probabilitasnya memiliki kalibrasi yang baik atau bahwa model dasarnya bersifat diskriminatif.
Perhatikan tiket pengembalian dana tadi. Model keputusan dapat mengidentifikasi masalah sebagai urusan penagihan dan memperkirakan tingkat urgensinya. Model generatif kemudian dapat menyusun balasan yang menunjukkan empati berdasarkan kebijakan pengembalian dana yang relevan. Aplikasi tetap harus memeriksa kebijakan, izin, dan persetujuan manusia yang diperlukan sebelum mengambil tindakan.
Cara kerja model keputusan dalam aplikasi
Skema yang digunakan berbeda menurut penyedia, tetapi permintaan keputusan umumnya memiliki tiga bagian:
- State (Keadaan): Informasi yang harus dinilai, seperti teks tiket atau gambar.
- Pertanyaan dan kriteria: Keputusan yang harus dibuat beserta deskripsi jawaban atau tingkat skor yang diizinkan.
- Respons bertipe: Label, skor, atau distribusi probabilitas yang dikembalikan untuk ditafsirkan oleh aplikasi.
Sebagai contoh:
State: "I was charged twice for my subscription."
Question: Which team should handle this request?
Options: billing, technical support, sales
Illustrative result: billing
Ini merupakan contoh konseptual, bukan respons API yang sebenarnya. Model juga dapat memberikan tingkat keyakinan atau probabilitas, bergantung pada endpoint yang digunakan. Ikuti dokumentasi model dan API terkait, alih-alih menganggap semua penyedia menggunakan format permintaan yang sama atau mendukung jenis input yang sama.
Apa arti skor probabilitas?
Prediksi probabilitas hanya berguna jika Anda memahami tingkat keandalannya. Jika sistem memberikan nilai 0.8 pada banyak prediksi serupa, sistem dengan kalibrasi yang baik seharusnya menghasilkan prediksi benar sekitar 80% dari seluruh kasus dalam kelompok tersebut. Satu skor 0.8 tidak menjamin bahwa keputusan individual benar.
Periksa kalibrasi menggunakan data Anda sendiri, terutama setelah mengganti model, label, bahasa, atau sumber input. Anda dapat menggunakan ambang batas untuk mengarahkan kasus dengan tingkat keyakinan rendah ke proses peninjauan. Namun, tentukan ambang tersebut berdasarkan biaya positif palsu dan negatif palsu. Antrean peninjauan penipuan dan rekomendasi konten yang tidak berbahaya membutuhkan aturan berbeda.
Contoh dan kasus penggunaan AI diskriminatif
Klasifikasi dan pengarahan tiket dukungan
Model keputusan dapat menetapkan pesan masuk ke bagian penagihan, dukungan teknis, atau pengelolaan akun. Tambahkan jalur “lainnya” atau “perlu ditinjau” untuk permintaan yang ambigu, lalu uji pesan yang memuat beberapa masalah. Evaluasi tingkat kesalahan untuk setiap kategori, bukan hanya akurasi keseluruhan. Model yang gagal mengenali keluhan penagihan mendesak dapat terlihat bagus pada kumpulan data yang didominasi pertanyaan rutin.
Moderasi konten
Alur kerja moderasi dapat menanyakan apakah suatu konten termasuk dalam kategori kebijakan yang telah ditentukan. Berikan kriteria dan contoh yang jelas kepada model, evaluasi kasus khusus, lalu arahkan kasus yang tidak pasti atau berdampak besar kepada peninjau terlatih. Skor keputusan merupakan masukan bagi proses kebijakan Anda, bukan bukti bahwa suatu konten melanggar aturan.
Pengarahan LLM dan agen
Sebelum memanggil LLM, aplikasi dapat mengklasifikasikan permintaan berdasarkan topik, kompleksitas, atau modalitas yang diperlukan. Komponen pengarah kemudian dapat memilih alur kerja atau meminta informasi tambahan. Uji proses pengarahan bersama sistem lanjutan: langkah awal yang murah tidak berguna jika sistem terus mengirim permintaan sulit ke jalur yang salah.
Penyaringan dokumen dan gambar
Model keputusan multimodal dapat mengklasifikasikan apakah suatu gambar atau dokumen termasuk dalam kategori yang telah ditentukan, seperti faktur, tanda terima, atau tangkapan layar dukungan. Pastikan endpoint yang dipilih mendukung format input dan pemrosesan gambar yang Anda butuhkan. Klasifikasi berbeda dari ekstraksi setiap kolom dalam dokumen. Periksa apakah model dan API pilihan Anda mendukung kedua tugas tersebut.
Penilaian berdasarkan rubrik
Model dapat menempatkan sebuah respons pada skala berurutan menggunakan deskripsi seperti “bukti utama tidak tersedia”, “didukung sebagian”, dan “didukung sepenuhnya”. Uji kesesuaian penilaian dengan peninjau dan konsistensi model dalam menilai jawaban serupa. Hindari menyajikan skor rubrik sebagai pengukuran objektif tanpa validasi.
Model keputusan yang tersedia dalam katalog model Felo
Katalog model Felo menyediakan filter output Decisions. Berdasarkan daftar per 2 November 2026, beberapa contohnya meliputi:
| Daftar Katalog | Penggunaan yang Dijelaskan | Input yang Ditampilkan dalam Katalog |
|---|---|---|
| TypeSafe Jev 1.14 | Pengarahan, klasifikasi, dan moderasi | Teks dan gambar; daftar tersebut menyebut dukungan gambar sebagai fitur eksperimental |
| LiquidAI d1.1 | Keputusan ya/tidak, pilihan, dan skor | Teks dan gambar |
| Baseten Joey 1 | Klasifikasi dan pengarahan | Teks dan gambar |
| Perplexity Decider Flash V1.2 | Klasifikasi, pengarahan, dan pemberian skor | Teks dan gambar |
Deskripsi tersebut mencerminkan informasi dalam katalog, bukan hasil pengujian performa independen atau rekomendasi bahwa satu model merupakan pilihan terbaik. Ketersediaan, dukungan fitur, batas konteks, dan harga dapat berubah. Periksa daftar dan dokumentasi endpoint terbaru sebelum membangun aplikasi, terutama untuk fitur eksperimental atau multimodal. Pencantuman sebuah model dalam katalog tidak membuktikan bahwa fitur API bawaan setiap penyedia tersedia melalui semua platform.
Cara mengevaluasi model keputusan AI
Mulailah dengan satu keputusan yang spesifik dan sekumpulan contoh representatif dengan label tepercaya. Sertakan kasus sulit, kategori minoritas, konteks yang tidak lengkap, serta contoh yang membutuhkan penanganan manusia. Kemudian, bandingkan model dengan baseline sederhana, pengklasifikasi yang sudah digunakan, atau LLM dengan output terstruktur.
Ukur lebih dari sekadar akurasi:
- Presisi dan recall: Kesalahan mana yang berdampak penting, dan seberapa sering kesalahan tersebut terjadi pada setiap kelas?
- Kalibrasi: Apakah probabilitas prediksi sesuai dengan hasil yang diamati pada kelompok kasus tertentu?
- Cakupan: Berapa proporsi permintaan yang dapat ditangani secara otomatis pada ambang batas pilihan Anda?
- Latensi dan keandalan: Apakah seluruh pemanggilan API memenuhi persyaratan produksi Anda?
- Biaya: Berapa biaya untuk setiap keputusan yang berguna, termasuk percobaan ulang, beberapa pertanyaan, pemrosesan gambar, dan peninjauan manusia?
- Ketahanan: Apakah performa tetap terjaga pada berbagai bahasa, format, contoh yang belum dikenal, dan perubahan lalu lintas?
Gunakan kumpulan data pengujian terpisah setelah menyempurnakan label dan ambang batas. Dalam lingkungan produksi, catat hasil jika sesuai, tinjau perbedaan penilaian, dan lakukan evaluasi ulang ketika versi model, kebijakan, atau distribusi input berubah. Untuk keputusan yang berdampak besar, rancang pengawasan manusia yang bermakna dan periksa persyaratan yang berlaku.
Pertanyaan yang sering diajukan
Apakah AI diskriminatif sama dengan model keputusan?
Tidak sepenuhnya. AI diskriminatif menggambarkan pendekatan luas untuk memprediksi target berdasarkan input. Model keputusan merupakan kategori produk yang lebih baru dan berfokus pada output dengan batasan tertentu, seperti pilihan, skor, dan probabilitas. Beberapa model keputusan menggunakan teknik diskriminatif, tetapi kedua istilah tersebut tidak memiliki arti yang sama.
Bisakah LLM mengklasifikasikan atau membuat keputusan?
Ya. LLM generatif dapat menerima prompt untuk mengklasifikasikan konten atau menghasilkan output terstruktur. Apakah model keputusan khusus memberikan performa yang lebih baik, lebih cepat, atau lebih murah bergantung pada tugas, model, penyedia, dan metode evaluasi. Uji keduanya menggunakan contoh dari data Anda sendiri.
Apakah probabilitas model keputusan selalu akurat?
Tidak. Model dapat menghasilkan probabilitas dengan kalibrasi buruk pada kumpulan data atau subkelompok tertentu. Ukur kalibrasi dan dampak kesalahan sebelum menggunakan ambang batas untuk mengotomatiskan alur kerja.
Kapan saya sebaiknya menggunakan AI generatif?
Gunakan model generatif ketika tugas membutuhkan penyusunan draf, penjelasan, sintesis, atau pembuatan konten terbuka. Dalam banyak aplikasi, model keputusan dan model generatif dapat bekerja bersama: satu mengarahkan atau mengklasifikasikan, sedangkan yang lain membuat respons.
AI diskriminatif memberi pengembang cara untuk memasukkan keputusan yang eksplisit dan terukur ke dalam alur kerja. Mulailah dengan satu tugas yang memiliki batasan jelas, uji kesalahan yang berdampak penting, lalu tentukan tingkat otomatisasi berdasarkan bukti yang tersedia.
Jelajahi model keputusan dalam katalog Felo →
Tulisan ini juga tersedia dalam English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.