
Gemini 4 Carbon di Felo API: Spesifikasi, Benchmark, Harga, dan Kasus Penggunaan

Gemini 4 Carbon di Felo API: anggaran terpadu 1 juta token, tingkat penalaran, batas multimodal, hasil benchmark resmi, harga aktual, dan cara menggunakannya.
Gemini 4 Carbon dari Google merupakan model yang dirancang untuk pekerjaan kompleks yang tidak dapat diselesaikan dalam satu proses singkat: migrasi basis kode yang melibatkan puluhan layanan, pencarian kerentanan yang harus menghasilkan patch fungsional, atau pertanyaan penelitian yang membutuhkan rangkaian bukti, bukan sekadar paragraf berisi pernyataan meyakinkan.
Model ini kini dapat digunakan melalui Felo API. Felo juga menawarkan uji coba gratis dalam periode terbatas dan potongan harga dari penyedia. Anda dapat membuka model, menguji prompt di playground, dan membuat API key melalui halaman Gemini 4 Carbon di Felo sebelum membaca panduan ini.
Artikel ini merupakan panduan praktis, bukan pengumuman peluncuran. Pembahasan mencakup identitas Carbon, perbedaannya dari Gemini 4 Argon, makna hasil benchmark yang dipublikasikan, cara kerja anggaran token yang tidak biasa, keunggulan dan kelemahan model, serta biaya penggunaannya di Felo.
Apa Itu Gemini 4 Carbon?
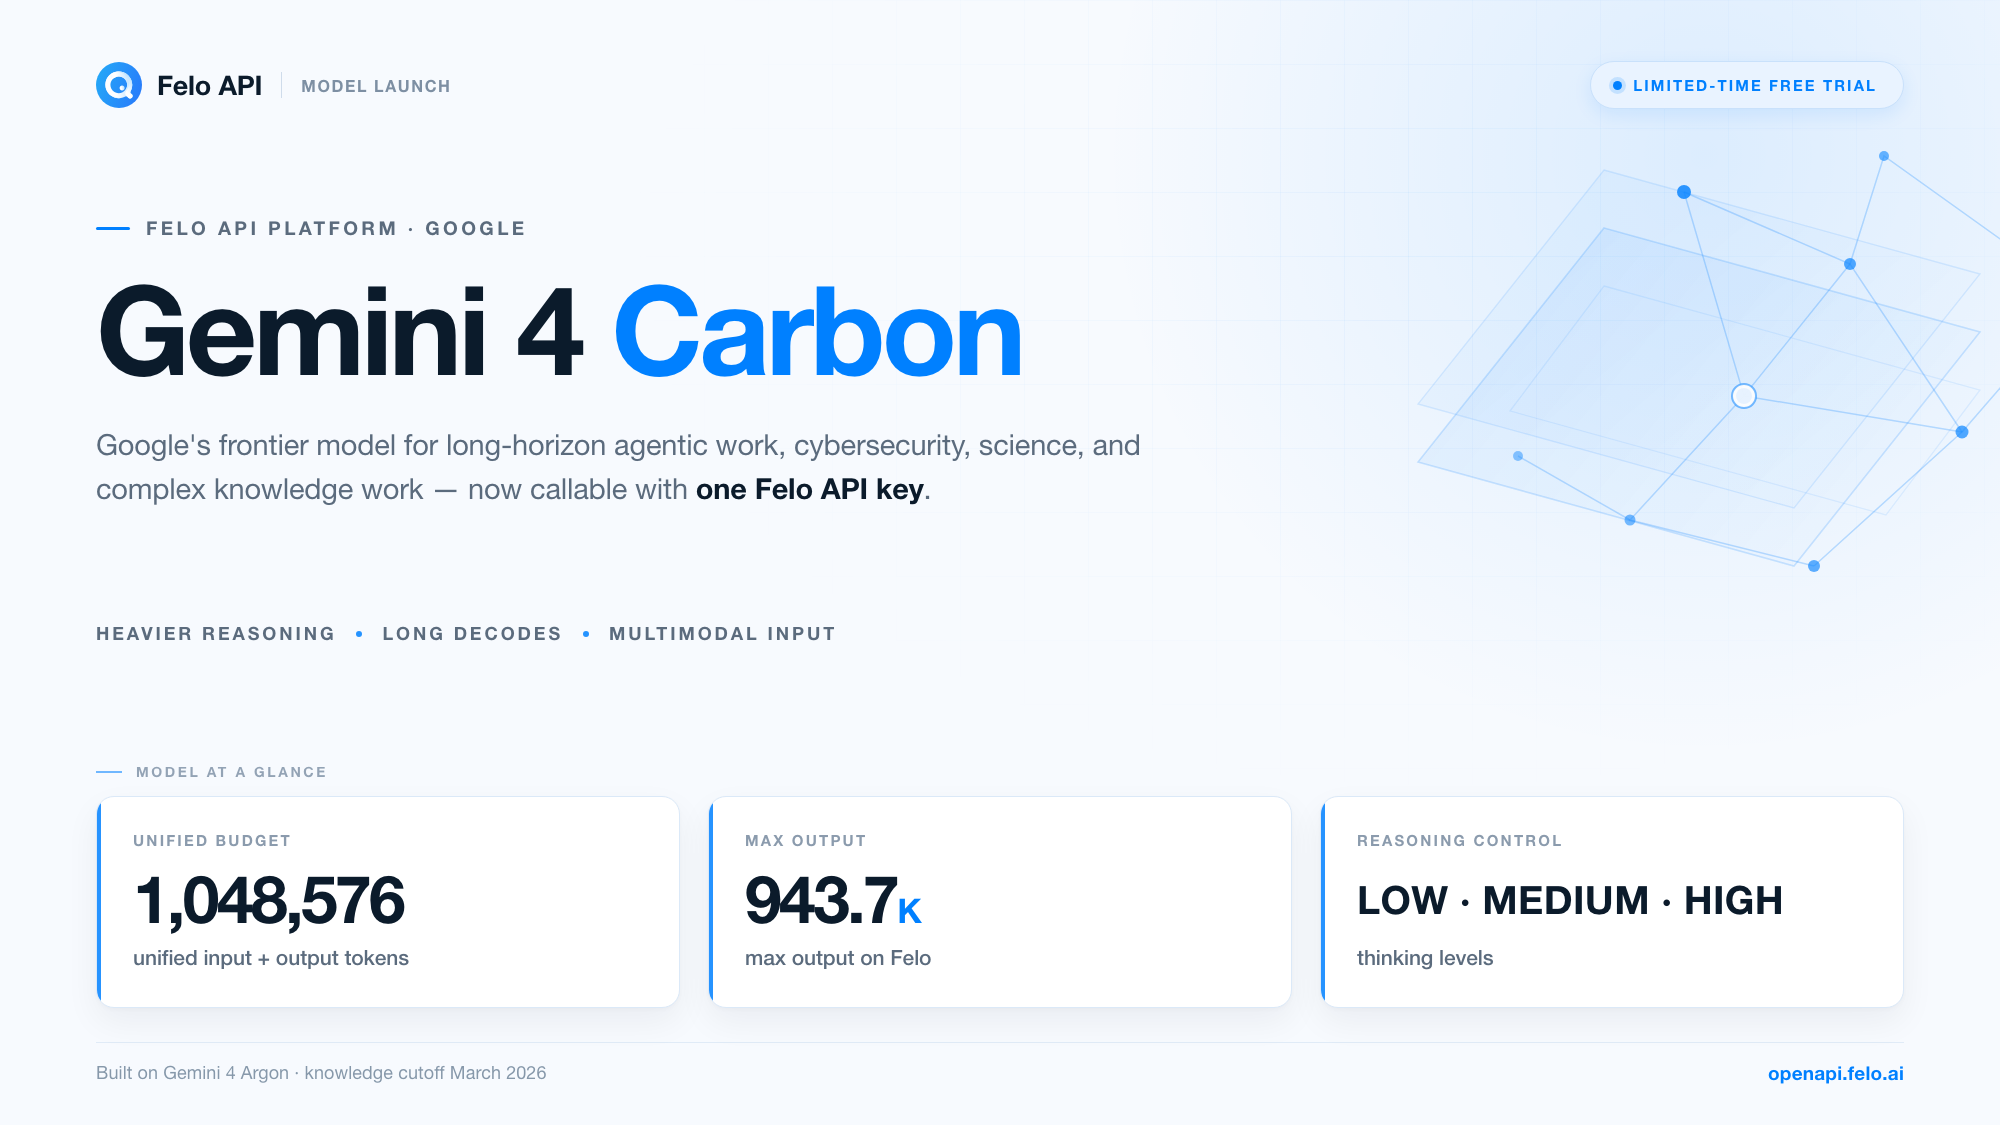
Gemini 4 Carbon merupakan model AI terdepan Google untuk pekerjaan agentic jangka panjang di bidang pemrograman, keuangan, hukum, keamanan siber, dan sains. Google mengumumkannya pada 28 Oktober 2026. Model ini dibangun di atas Gemini 4 Argon dan pertama kali dirilis kepada sejumlah pihak yang bergerak di bidang pertahanan keamanan siber melalui Fairwind Program. Dokumentasi platform enterprise Google kini mencantumkan model ini sebagai produk yang tersedia untuk umum, dengan tanggal rilis 10 November 2026.
Nama "Carbon" bukan penanda generasi baru. Nama tersebut menunjukkan titik operasi yang berbeda dalam keluarga Gemini 4. Argon dirancang untuk menghasilkan dokumen panjang dan koheren dalam satu alur, sedangkan Carbon mengalokasikan lebih banyak anggarannya untuk proses berpikir: mengeksplorasi hipotesis, menjalankan siklus verifikasi, dan mengoordinasikan pekerjaan bertahap. Google menyatakan bahwa Carbon menggunakan lebih banyak token penalaran daripada Argon untuk menghasilkan jawaban.
Pendekatan ini memiliki konsekuensi. Model membutuhkan waktu lebih lama untuk tugas kompleks, dapat mengalami timeout dalam kondisi tertentu, dan mengonsumsi lebih banyak token pada tingkat penalaran tinggi. Google mencantumkan keterbatasan tersebut dalam dokumentasinya. Alasan penggunaan Carbon tetap kuat: pekerjaan yang menjadi sasaran model ini — analisis keamanan, migrasi berskala besar, penalaran ilmiah, dan peninjauan dokumen berisiko tinggi — lebih membutuhkan kedalaman analisis daripada kecepatan.
Spesifikasi model secara ringkas
| Spesifikasi | Nilai |
|---|---|
| ID Model di Felo | gemini-4-carbon |
| Pengumuman | 28 Oktober 2026 |
| Dibangun di atas | Gemini 4 Argon |
| Konteks dan output | Satu anggaran terpadu sebesar 1,048,576 token untuk input dan output |
| Output maksimum yang tercantum di Felo | 943.718K token |
| Input | Teks, gambar, audio, video, PDF, serta file Office/OpenDocument |
| Output | Teks |
| Tingkat penalaran | LOW, MEDIUM (default), HIGH |
| Batas pengetahuan | Maret 2026 |
| Sampling | Temperature 1.0, top-p 0.95, top-k 64, tetap |
| Caching | Hanya implicit caching, minimum 4,096 token |
| Antarmuka Felo yang direkomendasikan | Messages API (kompatibel dengan Anthropic) |
| Akses | Pelanggan enterprise terverifikasi di wilayah tertentu; varian siber hanya tersedia melalui allowlist |
Dua detail dalam tabel tersebut perlu dibahas secara khusus karena memengaruhi cara Anda membangun aplikasi menggunakan model ini: anggaran token terpadu dan tingkat penalaran.
Perbedaan Gemini 4 Carbon dan Gemini 4 Argon
Carbon dan Argon berasal dari keluarga yang sama, memiliki batas pengetahuan yang sama, dan memiliki banyak kesamaan dalam hal posisi produk. Perbedaannya terletak pada cara model menggunakan kapasitasnya.
Anggaran input dan output terpadu. Argon umumnya dijelaskan sebagai model dengan jendela konteks 1,048,576 token dan batas output default terpisah sebesar 65,536 token. Pada Carbon, 1,048,576 token mencakup input, proses berpikir, pemanggilan alat, dan jawaban akhir. Semuanya menggunakan satu anggaran, bukan jendela konteks ditambah kuota output.
Penalaran lebih mendalam sebagai pengaturan default. Carbon mendukung tingkat penalaran LOW, MEDIUM, dan HIGH. MEDIUM menjadi pengaturan default pada gemini-4-carbon, sedangkan HIGH menjadi pengaturan default pada varian cyber-permissive. Model ini dirancang untuk menjalankan siklus verifikasi yang panjang. Karena itu, Google mencantumkan konsumsi token yang lebih tinggi sebagai keterbatasan yang diketahui, bukan sebagai bug.
Proses decoding panjang. Satu segmen pemrosesan menghasilkan hingga 65,536 token output saat streaming atau 32,768 token tanpa streaming. Anda dapat melampaui batas tersebut melalui long decodes: Google Gen AI SDK dan Agent Studio mengelola continuation token secara otomatis, atau Anda dapat menjalankan loop kelanjutan khusus. Batas teoretisnya adalah seluruh anggaran terpadu setelah dikurangi input.
Dukungan file lebih luas. Carbon menerima file Microsoft Office dan OpenDocument — .docx, .doc, .pptx, .ppt, .xlsx, .xls, .odt, .odp, .ods — melalui input langsung maupun penyimpanan cloud, selain PDF dan teks biasa. Fitur ini berguna ketika alur kerja Anda dimulai dari presentasi, spreadsheet, atau kontrak, bukan hasil ekspor teks.
Penyempurnaan keamanan dan varian siber terpisah. Google melaporkan bahwa peringatan misalignment dengan tingkat keparahan tinggi turun hampir 80% dalam lingkungan pemrograman langsung. Carbon juga mengungguli Argon sebesar 3.50 poin persentase dalam evaluasi keamanan konten multibahasa dan multimodal pada pengujian keamanan teks-ke-teks. Google juga menyediakan gemini-4-carbon-cyber-permissive, varian khusus pertahanan keamanan yang hanya tersedia melalui allowlist, menggunakan HIGH sebagai tingkat penalaran default, dan tidak mendukung penggunaan komputer.
Kemampuan khusus untuk sains. Google menyatakan bahwa model ini dapat menerjemahkan tujuan keamanan menjadi teorema matematika dan menemukan homolog jarak jauh secara mandiri dalam arsip urutan berskala petabase. Google melaporkan peningkatan rata-rata 40 kali lipat dalam pencarian homolog untuk keluarga protein dengan jumlah homolog rendah. Klaim tersebut mengacu pada tugas penelitian tertentu. Anda perlu mengujinya menggunakan data sendiri sebelum menganggapnya sebagai kemampuan umum.
Penjelasan Anggaran Token Terpadu
Sebagian besar halaman model mencantumkan dua angka: jendela konteks dan output maksimum. Carbon hanya memiliki satu angka utama dan aturan per segmen. Jika Anda masih merencanakan permintaan menggunakan metode lama, Anda dapat melebihkan kapasitas yang tersedia atau salah membaca tagihan.
Berikut pembagian anggaran yang sebenarnya:
- Input — prompt, dokumen terlampir, gambar, audio, frame video, dan percakapan sebelumnya.
- Thinking — token penalaran yang digunakan model sebelum memberikan jawaban. Pada tingkat HIGH, jumlahnya dapat mencapai angka besar.
- Tool calls — semua fungsi yang dipanggil model ketika fitur alat diaktifkan.
- Final answer — teks yang Anda terima.
Keempat komponen tersebut menggunakan anggaran yang sama, yaitu 1,048,576 token. Permintaan dengan input 900K token tidak menyisakan 1 juta token untuk output. Kapasitas yang tersisa hanya sekitar 148K token untuk proses berpikir, pemanggilan alat, dan jawaban gabungan, sebelum proses kelanjutan.
Batas per segmen merupakan aturan terpisah. Dalam permintaan streaming, satu segmen memiliki batas 65,536 token output. Tanpa streaming, batasnya 32,768 token. Long decodes memungkinkan proses berlanjut melewati batas segmen hingga anggaran terpadu habis. Jika integrasi Anda menganggap max_tokens sebagai jaminan total output, anggapan tersebut keliru: parameter ini membatasi satu segmen, sedangkan mekanisme kelanjutan SDK memungkinkan pembuatan dokumen panjang.
Halaman model Felo mencantumkan output maksimum sebesar 943.718K token. Angka tersebut merupakan batas output pada jalur Felo, bukan jendela konteks kedua dengan kapasitas lebih besar. Dalam sistem anggaran terpadu, kapasitas jawaban bergantung pada jumlah input yang Anda kirim.
Implikasi desainnya sederhana: tentukan ukuran output terlebih dahulu, lalu sesuaikan input dengan kapasitas yang tersisa. Untuk laporan panjang, sisihkan anggaran output dan penalaran, lalu pangkas materi sumber sesuai kebutuhan. Untuk analisis kumpulan dokumen besar, terima bahwa jawaban akan lebih pendek daripada input dan siapkan proses kelanjutan atau prompt bertahap.
Tingkat Penalaran: Sumber Kualitas Jawaban
Carbon menyediakan tiga tingkat penalaran: LOW, MEDIUM, dan HIGH. MEDIUM merupakan pengaturan default. Dokumentasi Google menyatakan bahwa thinking_budget dan thinking_level="MINIMAL" akan menghasilkan kesalahan validasi. Artinya, Anda tidak dapat meniadakan proses penalaran.
Perbedaan ketiga tingkat tersebut cukup besar. Pada LOW, model berperilaku seperti model percakapan AI terdepan dengan respons cepat: cocok untuk ekstraksi, klasifikasi, penulisan ulang, dan tinjauan kode rutin. Pada MEDIUM, model mulai menggunakan token untuk perencanaan dan pemeriksaan mandiri. Pada HIGH, model menjalankan siklus verifikasi lebih panjang. Pengaturan ini memiliki peluang terbesar untuk menemukan kesalahan tersembunyi, tetapi juga membutuhkan waktu dan biaya lebih besar.
Beberapa aturan praktis yang perlu diperhatikan:
- Sesuaikan tingkat penalaran dengan dampak kesalahan. Jika kesalahan mudah ditemukan dan diperbaiki, gunakan LOW. Jika kesalahan dapat masuk ke lingkungan produksi atau dokumen resmi, uji HIGH.
- Ukur token per hasil yang diterima, bukan token per permintaan. Penalaran tingkat tinggi dapat mengurangi percobaan ulang dan pekerjaan perbaikan. Namun, biaya juga dapat meningkat untuk tugas yang sebenarnya dapat diselesaikan model pada tingkat MEDIUM. Bandingkan seluruh proses.
- Jangan berasumsi bahwa pengaturan benchmark berlaku untuk kebutuhan Anda. Angka utama yang dipublikasikan Google tidak selalu menyebutkan tingkat penalaran yang digunakan. Uji tugas Anda sendiri pada dua tingkat sebelum menentukan pilihan.
Pengaturan sampling bersifat tetap pada temperature 1.0, top-p 0.95, dan top-k 64. Nilai khusus yang Anda masukkan akan diabaikan. Jika pipeline Anda bergantung pada determinisme dengan temperature rendah, Carbon bukan pilihan yang tepat untuk tahap tersebut. Gunakan Carbon untuk penilaian dan sintesis, lalu pertahankan tahap deterministik pada model yang mendukung kontrol sampling.
Hasil Publikasi Google: Benchmark dan Maknanya
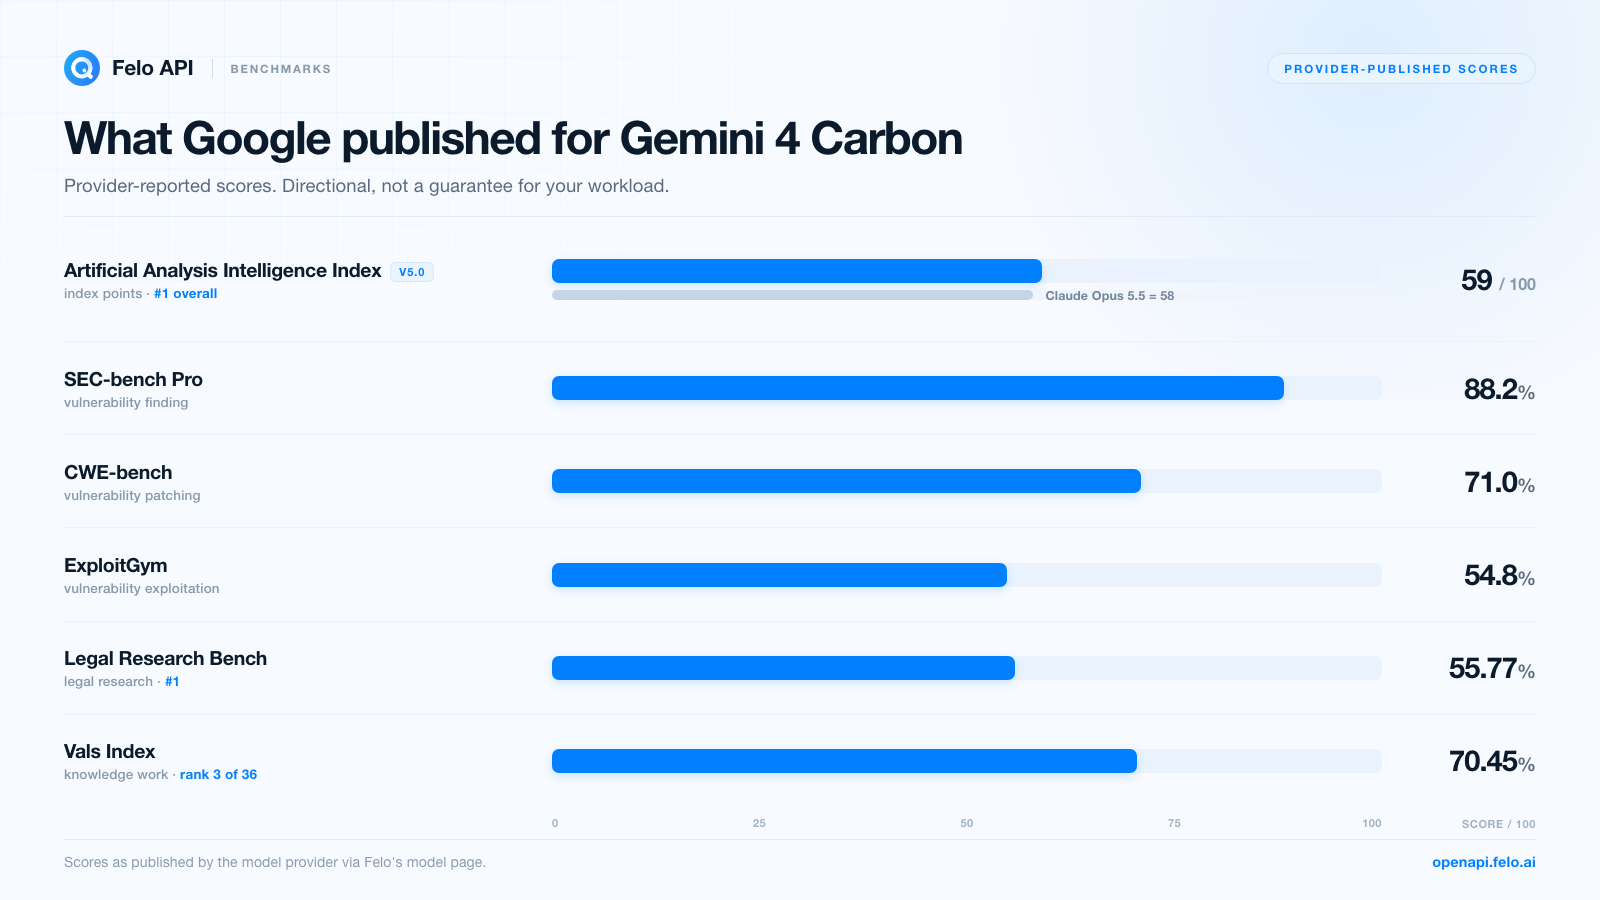
Halaman model Felo mengumpulkan hasil benchmark Carbon yang dipublikasikan oleh penyedia. Perbandingan di bawah ini menunjukkan arah performa: data berasal dari Google atau penyedia evaluasi, belum direplikasi secara independen untuk artikel ini, dan menggambarkan kondisi pengujian, bukan beban kerja Anda.
| Evaluasi | Aspek yang diukur | Gemini 4 Carbon | Konteks |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | Indeks penalaran gabungan | 59 | Posisi teratas; Claude Opus 5.5 mendapat 58 |
| SEC-bench Pro | Penemuan kerentanan | 88.2% | Keamanan, pemindaian defensif |
| CWE-bench | Perbaikan kerentanan | 71.0% | Keamanan, remediasi |
| ExploitGym | Eksploitasi kerentanan | 54.8% | Riset keamanan, lingkungan terkendali |
| Terminal-Bench 4.0 | Tingkat kecurangan yang berhasil | 0.0% | Ketahanan terhadap manipulasi reward, bukan kemampuan |
| Vals Index | Indeks gabungan pekerjaan berbasis pengetahuan | 70.45% | Peringkat 3 dari 36 model |
| Legal Research Bench | Riset hukum | 55.77% | Peringkat 1 |
| General Financial Intelligence | Tugas keuangan | #1 | Posisi teratas dari 23 konfigurasi model terdepan, menurut Balyasny Asset Management |
Baca tabel tersebut dengan cermat. Ada tiga hal yang menonjol.
Skor keamanan menggambarkan siklus kerja, bukan satu kemampuan tunggal. Menemukan kerentanan, menulis patch, dan mengeksploitasi kerentanan merupakan keterampilan yang berbeda. Angka publikasi Carbon paling kuat pada penemuan kerentanan (88.2% pada SEC-bench Pro), lebih rendah pada eksploitasi (54.8% pada ExploitGym), dan berada di tengah pada perbaikan (71.0% pada CWE-bench). Jika pekerjaan Anda berfokus pada pertahanan — pemindaian, triase, dan remediasi — profil ini sesuai. Jika Anda membutuhkan eksploitasi mandiri, angkanya lebih rendah dan aturan aksesnya lebih ketat.
Metrik tingkat kecurangan berkaitan dengan kepercayaan, bukan kecerdasan. "Successful cheating rate" pada Terminal-Bench 4.0 mengukur apakah model memanipulasi benchmark alih-alih menyelesaikan tugas. Hasil 0.0% merupakan klaim tentang ketahanan terhadap manipulasi reward. Hal ini penting ketika Anda membiarkan agen bekerja tanpa pengawasan. Angka tersebut bukan skor kemampuan dan tidak boleh dibandingkan dengan hasil persentase jawaban benar pada bagian lain tabel.
Peringkat pekerjaan berbasis pengetahuan paling relevan bagi sebagian besar tim. Peringkat 3 dari 36 pada Vals Index, posisi pertama pada Legal Research Bench, dan posisi teratas dalam perbandingan keuangan Balyasny menggambarkan jenis pekerjaan yang layak menggunakan model AI terdepan: membaca banyak materi, menyelaraskan bukti yang saling bertentangan, dan menghasilkan dokumen untuk ditinjau oleh tenaga profesional. Hasil tersebut juga sangat dipengaruhi desain prompt dan kualitas sumber. Angka-angka ini menjadi alasan untuk melakukan pengujian, bukan alasan untuk melewatkan pengujian.
Ada satu catatan tambahan: skor Artificial Analysis merupakan indeks gabungan. Keunggulan satu poin atas Claude Opus 5.5 masih berada dalam rentang yang memungkinkan perubahan urutan akibat perbedaan komposisi tugas. Pada tugas khusus yang Anda butuhkan, performa kedua model mungkin sangat berbeda, ke arah mana pun.
Kegunaan Gemini 4 Carbon dalam Praktik
Benchmark merupakan peta, bukan gambaran seluruh kondisi. Berikut jenis pekerjaan yang sesuai dengan desain Carbon.
Pekerjaan Kode dan Migrasi Berskala Besar
Carbon menyasar tugas rekayasa perangkat lunak yang membutuhkan kolaborasi multiagen, debugging rutin, migrasi basis kode besar, dan desain algoritma. Anggaran terpadu sangat membantu untuk pekerjaan ini: Anda dapat memasukkan peta repositori, file sumber yang relevan, hasil pengujian yang gagal, dan persyaratan migrasi dalam satu permintaan. Setelah itu, minta model menyusun rencana sebelum mengubah kode.
Contoh prompt yang sesuai dengan model ini:
Baca peta repositori terlampir dan tiga modul layanan. Identifikasi setiap titik pemanggilan yang terdampak oleh penggantian antarmuka sesi, buat daftar risiko kompatibilitas, dan usulkan urutan migrasi. Jangan menulis kode terlebih dahulu. Tandai setiap hal yang tidak dapat Anda verifikasi dari file yang diberikan.
Minta rencana terlebih dahulu. Berikan akses kepada model untuk menjalankan pengujian setelah Anda meninjau rencananya. Pertahankan peninjauan diff oleh manusia — model yang mampu menyusun rencana dengan baik masih dapat menghasilkan patch yang berhasil dikompilasi tetapi memiliki perilaku keliru.
Keamanan Siber Defensif
Profil benchmark keamanan — kuat dalam penemuan, baik dalam perbaikan, tetapi lebih lemah dalam eksploitasi — sesuai dengan pekerjaan defensif: memindai basis kode untuk menemukan kelas kerentanan, melakukan triase terhadap hasil pemindai, mengusulkan patch, dan menjelaskan risiko dalam bahasa yang dapat ditindaklanjuti oleh peninjau. Varian siber Google dirancang untuk kebutuhan ini, tetapi aksesnya dibatasi melalui Fairwind Program dan membutuhkan persetujuan terpisah.
Ada dua hal yang perlu diperhatikan. Pertama, jalankan alur kerja keamanan hanya pada sistem yang boleh Anda uji berdasarkan otorisasi. Kedua, verifikasi temuan sebelum mengambil tindakan: model yang melaporkan kerentanan dengan tingkat keyakinan tinggi masih dapat melakukan kesalahan, dan false positive dapat membuang waktu tim rekayasa.
Penelitian Ilmiah dan Teknis
Kemampuan sains yang dilaporkan memiliki cakupan khusus: menerjemahkan tujuan keamanan menjadi teorema matematika dan mencari homolog jarak jauh dalam arsip urutan berskala petabase. Jika Anda bekerja di laboratorium atau kelompok penelitian, pola penggunaan yang berguna adalah memberikan pertanyaan dengan ruang lingkup jelas, literatur atau urutan yang relevan, serta instruksi untuk memisahkan bukti dari inferensi.
Klaim peningkatan pencarian homolog hingga 40 kali lipat cukup menonjol, tetapi mengacu pada keluarga protein dengan jumlah homolog rendah dalam pipeline tertentu. Uji klaim tersebut menggunakan benchmark yang dipercaya tim Anda sebelum membangun alur kerja berdasarkan kemampuan ini.
Keuangan, Hukum, dan Peninjauan Dokumen Berisiko Tinggi
Peringkat Carbon dalam pekerjaan berbasis pengetahuan merupakan keunggulan utamanya untuk layanan profesional. Contoh pekerjaannya meliputi rekonsiliasi buku besar, analisis varians, peninjauan putusan pengadilan dan dokumen peraturan, serta penyusunan memo dengan kutipan sumber. Model dapat membaca gambar dan PDF, sehingga dokumen hasil pemindaian dan grafik dapat digunakan sebagai input.
Namun, model tidak menghilangkan kebutuhan peninjauan. Berikan kumpulan sumber, minta model mencantumkan kutipan untuk setiap kesimpulan, lalu periksa kutipan tersebut. Model yang mampu memproses satu juta token konteks masih dapat salah membaca halaman 412.
Agen Jangka Panjang dengan Alat
Carbon mendukung function calling, structured output, eksekusi kode, URL context, computer use, dan beberapa opsi grounding, termasuk Google Search, Google Maps, serta penyedia pencarian pihak ketiga. Model ini juga mendukung pemahaman video berbasis agen, yang berguna ketika input berupa rekaman, bukan dokumen.
Ini merupakan cara penggunaan model yang paling kompleks sekaligus cara termudah untuk menghabiskan token. Lengkapi agen dengan instrumentasi: catat pemanggilan alat, batasi jumlah iterasi, dan wajibkan agen merangkum hasil verifikasi sebelum mengambil tindakan. Anggaran 1 juta token memungkinkan pembuatan agen yang ambisius, tetapi bukan berarti biayanya rendah.
Input Multimodal dan Batasannya
Carbon menerima teks, gambar, audio, video, PDF, dan dokumen Office, serta menghasilkan teks. Batasnya cukup besar, tetapi memiliki ketentuan khusus yang lebih penting daripada sekadar daftar format.
| Jenis input | Batas praktis |
|---|---|
| Audio | Sekitar 8.4 jam per prompt atau hingga 1 juta token; maksimal 1,000 file audio |
| Video | Sekitar 45 menit dengan audio, sekitar 1 jam tanpa audio; maksimal 10 video per prompt |
| Gambar dan dokumen | Maksimal 3,000 file gabungan per prompt |
| Dokumen | Maksimal 3,000 halaman per file |
| Format Office | .docx, .doc, .pptx, .ppt, .xlsx, .xls |
| Format OpenDocument | .odt, .odp, .ods |
| Ukuran input | 500 MiB terkompresi pada GenerateContent API; 256 MiB pada Interactions API |
Batas audio menjadi keunggulan utama. Dukungan audio hingga delapan jam dalam satu permintaan mengubah cara tim yang sering mengadakan rapat bekerja: alih-alih melakukan transkripsi dan membagi rekaman menjadi beberapa bagian, Anda dapat memberikan rekaman panggilan selama satu hari penuh dan meminta rangkuman tema, keputusan, serta pertanyaan yang belum terjawab. Konsekuensinya adalah konsumsi token. Token audio dihitung sebagai token input, sehingga mengunggah rekaman satu hari penuh tetap membutuhkan biaya.
Batas video lebih mendekati kebutuhan kerja umum: 45 menit video dengan audio cukup untuk kuliah, demo produk, atau wawancara rekaman, tetapi tidak cukup untuk konferensi penuh.
Ada beberapa kesenjangan kemampuan yang perlu diperhitungkan. Gemini Live API tidak didukung, sehingga penggunaan suara secara real-time tidak tersedia. RAG Engine dan penyesuaian model juga tidak didukung, sehingga proses retrieval dan fine-tuning harus berada di lapisan aplikasi Anda. Explicit context caching juga tidak didukung — hanya implicit caching dengan minimum 4,096 token — sehingga perencanaan biaya untuk prompt panjang yang digunakan berulang kali perlu mempertimbangkan batas ini.
Cara Menggunakan Gemini 4 Carbon di Felo
Felo mencantumkan Messages API sebagai antarmuka yang direkomendasikan untuk model ini. Endpoint menerima format permintaan yang kompatibel dengan Anthropic melalui https://openapi.felo.ai/api/v1/messages, dengan ID model gemini-4-carbon.
Alur penggunaannya sama seperti model Felo lainnya:
- Buat Felo API key. API key dibuat melalui konsol Felo dan disimpan sebagai
FELO_API_KEY. Jangan memasukkan key ke repositori kode atau log. - Uji melalui playground terlebih dahulu. Gemini 4 Carbon playground memungkinkan Anda menguji prompt sebelum menulis kode.
- Kirim permintaan sederhana. Mulai dengan prompt singkat dan pastikan format respons sesuai kebutuhan.
- Tambahkan streaming. Atur
stream: trueuntuk server-sent events. Fitur ini penting karena satu segmen dapat mencapai 65,536 token. - Uji tugas yang mewakili kebutuhan sebenarnya. Gunakan ukuran input, kriteria evaluasi, dan minimal dua tingkat penalaran yang sesuai sebelum menerapkannya ke pipeline.
Contoh permintaan Python sederhana:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
Ada dua catatan integrasi. Pertama, model ini mendukung penalaran: pertahankan metadata penalaran yang dikembalikan saat melanjutkan percakapan, atau model dapat kehilangan konteks yang dibutuhkan. Kedua, max_tokens merupakan batas per segmen, bukan batas total. Untuk output panjang, gunakan mekanisme kelanjutan yang disediakan SDK alih-alih menaikkan angka tersebut tanpa pertimbangan.
Felo juga mendokumentasikan endpoint Chat Completions dan Responses yang kompatibel dengan OpenAI untuk model yang mendukungnya. Karena halaman model merekomendasikan Messages untuk Carbon, periksa antarmuka yang didukung melalui halaman model sebelum mengubah klien berbasis OpenAI.
Biaya Gemini 4 Carbon di Felo
Felo menyediakan lima jalur penyedia Google untuk Gemini 4 Carbon. Semua jalur saat ini tercantum dengan diskon 50%. Harga di bawah dihitung per 1 juta token, dengan tarif standar dan tarif diskon ditampilkan bersamaan.
| Jalur | Input | Output | Pembacaan Cache |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
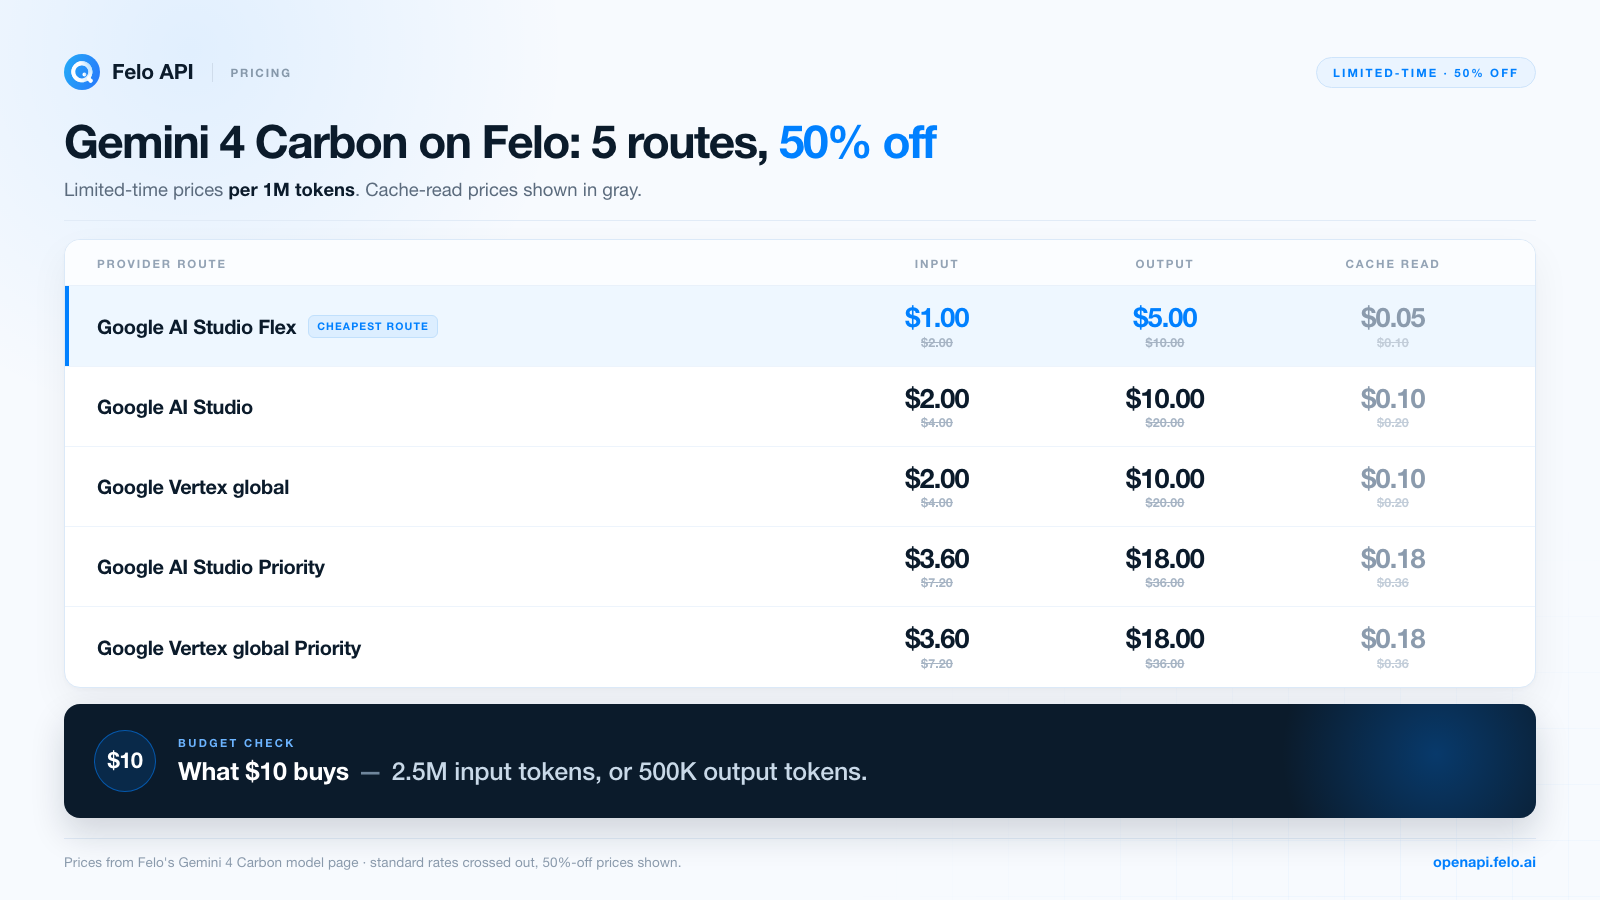
Halaman harga Felo menerjemahkan tarif standar ke dalam gambaran "apa yang bisa dibeli dengan $10": sekitar 2.5 juta token input atau 500,000 token output, sebelum diskon. Angka ini berguna untuk memperkirakan biaya proof of concept. Pengujian yang mengirim kumpulan dokumen berisi 100,000 token dan menerima jawaban 5,000 token membutuhkan biaya sekitar $0.13 melalui jalur Flex dengan tarif diskon — $0.10 untuk input dan $0.025 untuk output. Biaya ini memungkinkan puluhan pengujian sebelum Anda mengambil keputusan.
Uji coba gratis merupakan penawaran terpisah dari diskon tarif. Halaman model Felo menandai Gemini 4 Carbon dengan penawaran uji coba gratis dalam periode terbatas. Ini merupakan cara tercepat untuk menguji model tanpa menggunakan kredit berbayar. Periksa ketentuan terbaru di halaman model, karena ketersediaan uji coba dan diskon tarif memiliki batas waktu dan dapat berubah.
Perencanaan biaya untuk model ini membutuhkan satu kebiasaan tambahan. Token penalaran dikenakan tarif output, sehingga penggunaan agen dengan tingkat penalaran HIGH dapat menghabiskan biaya beberapa kali lipat dari perkiraan berdasarkan jawaban yang terlihat. Catat penggunaan token untuk setiap tugas, termasuk token penalaran, dan bandingkan biaya per hasil yang diterima, bukan biaya per permintaan.
Keterbatasan dan Hal yang Perlu Diverifikasi Sebelum Penggunaan
Carbon merupakan model AI terdepan dengan sejumlah kelemahan yang tercantum dalam dokumentasi. Berikut hal-hal yang perlu diperhatikan untuk perencanaan produksi:
- Halusinasi. Google mencantumkannya sebagai keterbatasan yang diketahui. Konteks panjang mengurangi kemungkinan informasi terlewat, tetapi tidak menjamin interpretasi yang benar. Alur kerja dengan kutipan dan verifikasi tetap diperlukan.
- Latensi dan timeout. Google mencatat adanya perlambatan dan masalah timeout dalam kondisi tertentu. Proses HIGH-thinking yang panjang membutuhkan timeout yang memadai, percobaan ulang, dan penanganan tugas yang idempoten.
- Konsumsi token lebih tinggi. Model menggunakan lebih banyak token penalaran daripada Argon, terutama pada tingkat yang lebih tinggi. Sesuaikan anggaran dan batasi tingkat penalaran untuk tugas rutin.
- Batas pengetahuan Maret 2026. Informasi setelah tanggal tersebut membutuhkan retrieval atau sumber terbaru. Carbon tidak mengetahui peristiwa setelah tanggal itu.
- Sampling tetap. Temperature, top-p, dan top-k tidak dapat diubah. Jika pipeline Anda membutuhkan output deterministik, gunakan model lain untuk tahap tersebut.
- Tidak mendukung explicit caching, tuning, RAG Engine, atau Live API. Setiap fitur tersebut membutuhkan penanganan di lapisan aplikasi Anda.
- Batas ketersediaan. Google menyediakan Carbon untuk pelanggan enterprise terverifikasi di wilayah tertentu. Felo menyalurkan model ini melalui penyedia global, AS, dan UE. Pastikan jalur dan ketentuan yang berlaku sesuai kebutuhan Anda.
- Aturan keamanan dan akses. Varian siber hanya tersedia melalui allowlist, dan alur kerja keamanan membutuhkan otorisasi. Perlindungan model dan kebijakan penyedia tetap berlaku.
Jadi, Apakah Anda Perlu Menggunakannya?
Gunakan Gemini 4 Carbon ketika tugas membutuhkan proses panjang, bukti yang kompleks, dan kesalahan memiliki konsekuensi besar: rencana migrasi, tinjauan keamanan, sintesis penelitian, analisis keuangan atau hukum, maupun agen yang harus melakukan investigasi sebelum bertindak. Profil benchmark dan anggaran terpadu model ini dirancang untuk jenis pekerjaan tersebut.
Jangan menjadikannya pilihan default untuk setiap permintaan. Klasifikasi bervolume tinggi, ekstraksi singkat, rangkuman sederhana, dan tugas yang membutuhkan sampling deterministik lebih cocok menggunakan model yang lebih murah dan cepat. Model termurah yang memenuhi standar kualitas Anda hampir selalu menjadi pilihan tepat. Carbon perlu membuktikan nilainya pada bagian pekerjaan Anda yang paling kompleks.
Kesimpulan yang objektif: Carbon merupakan model Google dengan kemampuan terbaik untuk pekerjaan yang membutuhkan analisis mendalam, memiliki keunggulan terukur dalam keamanan, hukum, keuangan, dan penalaran dengan konteks panjang, tetapi membutuhkan biaya lebih besar dalam hal latensi dan token. Model ini juga memiliki sejumlah keterbatasan terdokumentasi yang membuat verifikasi menjadi keharusan. Uji Carbon pada tugas Anda sendiri sebelum membangun sistem yang bergantung padanya.
Pertanyaan yang Sering Diajukan
Apakah Gemini 4 Carbon di Felo memiliki uji coba gratis?
Ya. Felo menawarkan uji coba gratis Gemini 4 Carbon dalam periode terbatas. Tarif dari penyedia model juga mendapat diskon selama penawaran berlangsung. Ketentuan dapat berubah. Periksa halaman model Gemini 4 Carbon untuk mengetahui ketersediaan terbaru.
Apa perbedaan Gemini 4 Carbon dan Gemini 4 Argon?
Carbon dibangun di atas Argon dan dirancang untuk penalaran yang lebih mendalam. Model ini menggunakan anggaran terpadu 1,048,576 token yang mencakup input, proses berpikir, pemanggilan alat, dan output; mendukung tingkat penalaran LOW, MEDIUM, dan HIGH; menggunakan lebih banyak token penalaran; serta menambahkan dukungan file Office/OpenDocument dan peningkatan pada aspek keamanan. Argon tetap menjadi pilihan untuk pembuatan konten panjang ketika panjang output lebih penting daripada kedalaman verifikasi.
Berapa ukuran jendela konteks dan output maksimum Gemini 4 Carbon?
Anggaran terpadu model ini sebesar 1,048,576 token untuk input dan output gabungan. Satu segmen streaming dapat menghasilkan hingga 65,536 token output, sedangkan tanpa streaming batasnya 32,768 token. Long decodes memungkinkan output berlanjut hingga anggaran yang tersisa habis. Felo mencantumkan output maksimum sebesar 943.718K token pada jalurnya.
Apakah Gemini 4 Carbon dapat membaca audio, video, dan file Office?
Ya. Model ini menerima teks, gambar, audio, video, PDF, dan file Office/OpenDocument. Batasnya mencakup sekitar 8.4 jam audio, sekitar 45–60 menit video, 3,000 gambar dan dokumen gabungan, serta 3,000 halaman per dokumen. Output hanya berupa teks.
Apakah Gemini 4 Carbon mendukung API yang kompatibel dengan OpenAI?
Felo merekomendasikan Messages API yang kompatibel dengan Anthropic untuk model ini. Felo juga mendokumentasikan endpoint Chat Completions dan Responses yang kompatibel dengan OpenAI untuk model yang mendukungnya. Pastikan antarmuka yang tersedia melalui halaman model sebelum mengubah klien yang sudah ada.
Berapa biaya Gemini 4 Carbon?
Felo mencantumkan lima jalur Google, semuanya mendapat diskon 50%: AI Studio Flex seharga $1 untuk input dan $5 untuk output per satu juta token, jalur standar AI Studio dan Vertex seharga $2 / $10, serta jalur Priority seharga $3.60 / $18. Biaya pembacaan cache mulai dari $0.05 per satu juta token. Lihat halaman harga Felo untuk tarif terbaru.
Kapan Gemini 4 Carbon dirilis?
Google mengumumkan Gemini 4 Carbon pada 28 Oktober 2026. Model ini pertama kali tersedia untuk sejumlah pihak yang bergerak di bidang pertahanan keamanan siber melalui Fairwind Program. Platform enterprise Google mencantumkan ketersediaan umum mulai 10 November 2026. Felo kini menyediakan model ini melalui lima penyedia Google.
Coba Gemini 4 Carbon di Felo
Cara terbaik untuk menilai Carbon adalah memberinya tugas yang jawabannya sudah Anda ketahui. Buka Gemini 4 Carbon playground, masukkan dokumen atau contoh kode nyata, lalu bandingkan tingkat penalaran LOW dan HIGH menggunakan prompt yang sama. Jika hasilnya memenuhi standar Anda, buat API key dan pindahkan pengujian ke pipeline sendiri.
Mulai dari halaman model Gemini 4 Carbon untuk melihat ketentuan uji coba, jalur penyedia, dan batas penggunaan terbaru. Setelah itu, bangun pengujian sekecil mungkin untuk tugas paling kompleks yang Anda hadapi.
Tulisan ini juga tersedia dalam English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.