API GPT-6.1 Sol: Performa Mendekati Astra dengan Biaya Lebih Rendah
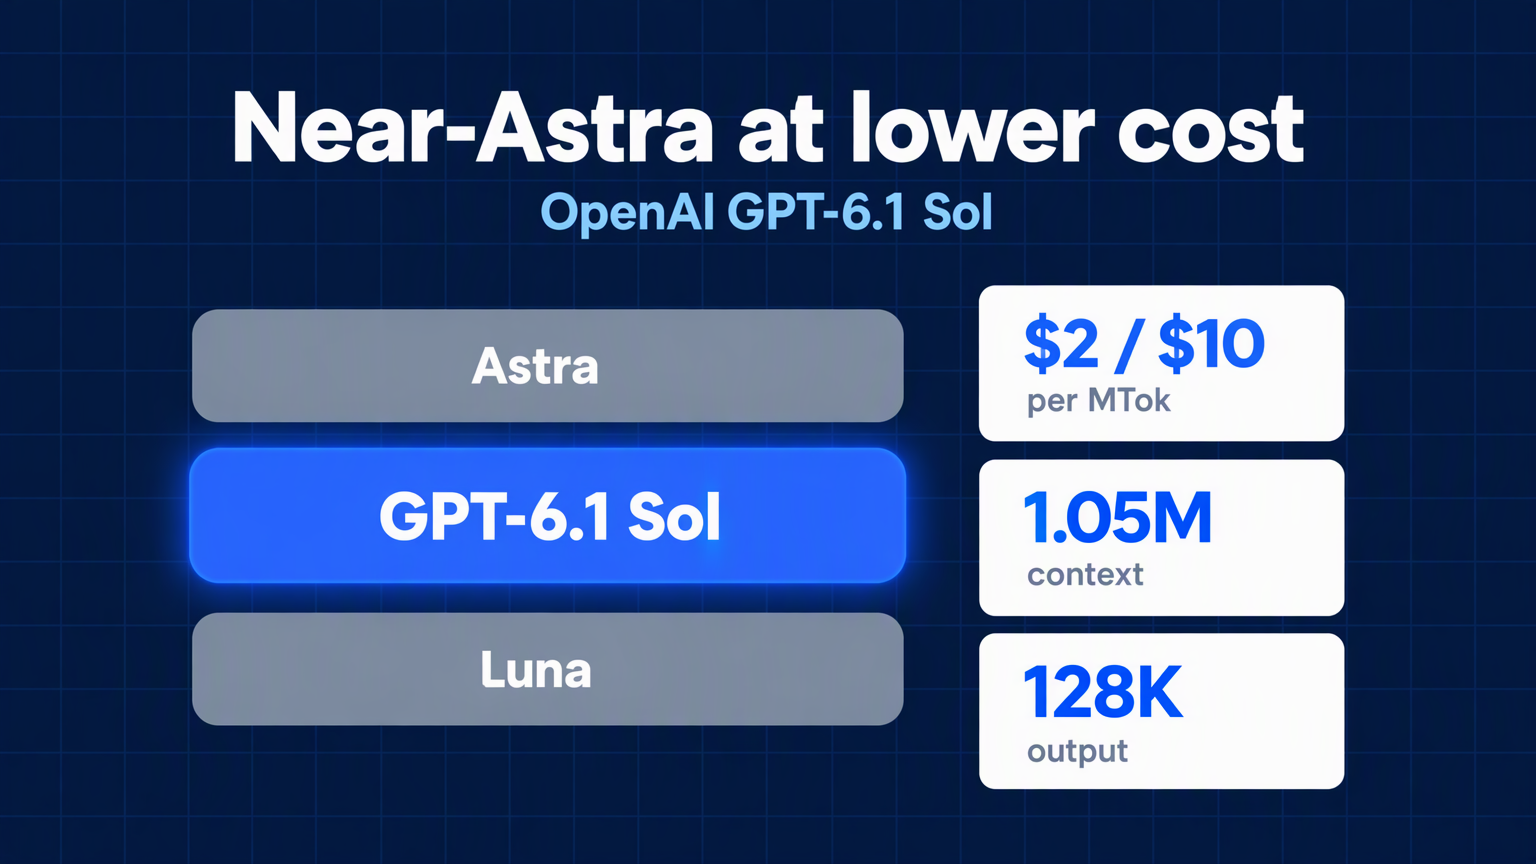
OpenAI GPT-6.1 Sol menghadirkan performa mendekati Astra untuk pemrograman, penggunaan komputer, dan pekerjaan profesional dengan harga $2/$10 per juta token serta jendela konteks 1,05M.
Model Sol terbaru dari OpenAI tidak berusaha menjadi model paling cerdas. Model ini berusaha menjadi model yang dapat digunakan sepanjang hari tanpa menguras anggaran.
GPT-6.1 Sol berada di antara GPT-6 Astra sebagai flagship dan GPT-6 Luna yang ringan. Halaman model OpenAI menggambarkannya dalam satu kalimat: "Performa mendekati Astra untuk pekerjaan kompleks dengan biaya lebih rendah." Untuk tim yang membangun alat pemrograman agentik, agen penggunaan komputer, dan alur kerja dokumen, kompromi ini menjadi inti dari model.
Panduan ini membahas fitur yang dibawa GPT-6.1 Sol, harga, perbedaannya dengan GPT-6 Sol dan Astra, serta cara memanggilnya melalui Felo API Platform.
Apa itu GPT-6.1 Sol
GPT-6.1 Sol merupakan model reasoning yang dirancang untuk pemrograman kompleks, penggunaan komputer, dan pekerjaan profesional. OpenAI menempatkannya sebagai pilihan seimbang dalam keluarga GPT-6: lebih mampu dari Luna, lebih murah dari Astra, dan cukup kuat sehingga banyak beban kerja produksi tidak membutuhkan flagship sama sekali.
Halaman model memberikan arahan penggunaan: bandingkan Sol dengan Astra pada tugas Anda sendiri, lalu tentukan apakah perbedaan kualitas sepadan dengan perbedaan harga. Arahan ini bersifat praktis dan mencerminkan tujuan model. Sol menjadi alat pengendali biaya, bukan trofi benchmark.
Halaman model Felo merangkum posisi yang sama dari sisi platform. GPT-6.1 Sol adalah "peningkatan dari GPT-6 Sol, tetap berada di bawah flagship GPT-6 Astra." Model ini menangani pemrograman agentik, penggunaan komputer, pekerjaan profesional berbasis dokumen, dan otomatisasi alur kerja multi-langkah, mendekati hasil Astra pada tugas-tugas tersebut dengan biaya jauh lebih rendah. Dibandingkan dengan GPT-6 Sol, Felo mencatat lebih sedikit kesalahan faktual dan kepatuhan yang lebih dekat terhadap batasan eksplisit.
GPT-6.1 Sol menjadi pilihan ketika tugas sulit, panjang, dan berulang — serta tagihan harus tetap terkontrol.
Spesifikasi GPT-6.1 Sol secara singkat
OpenAI menerbitkan spesifikasi lengkap di halaman model. Berikut ringkasannya.
| Spesifikasi | GPT-6.1 Sol |
|---|---|
| Model ID | gpt-6.1-sol |
| Default snapshot | gpt-6.1-sol |
| Context window | 1.050.000 token |
| Maximum input tokens | 922.000 |
| Maximum output tokens | 128.000 |
| Knowledge cutoff | 30 April 2026 |
| Input modalities | Teks, gambar |
| Output modalities | Teks |
| Unsupported modalities | Audio, video |
| Reasoning token support | Ya |
| Reasoning effort | low, medium (default), high, xhigh, max |
| Unsupported reasoning effort | none, minimal |
| Data residency | US dan EU |
Dua detail lebih penting daripada angka utama.
Pertama, reasoning effort tidak bisa dimatikan. GPT-6.1 Sol tidak mendukung none atau minimal. Jika migrasi dari model yang mengizinkan pengaturan tersebut, OpenAI menyarankan memulai dengan low dan membandingkan hasil pada tugas representatif.
Kedua, pemanggilan tool membutuhkan Responses API. GPT-6.1 Sol mendukung Chat Completions untuk permintaan tanpa tool, tetapi setiap alur kerja yang memanggil fungsi, mencari file, browsing web, atau mengendalikan komputer harus beralih ke Responses. Ini bukan keterbatasan khusus Sol — OpenAI memang mendorong seluruh platform ke arah ini.
Harga GPT-6.1 Sol: apa yang didapat dari $2/$10
Harga standar OpenAI untuk GPT-6.1 Sol adalah $2 per juta token input dan $10 per juta token output. Tabel token lengkap mencakup harga cache, yang mengubah perhitungan untuk agen yang berjalan lama.
| Metrik | Harga per 1M token |
|---|---|
| Input | $2.00 |
| Cached input | $0.10 |
| Cache writes | $2.50 |
| Output | $10.00 |
Beberapa aturan di bawah tabel tersebut:
- Cached input hanya 5% dari tarif biasa. OpenAI menetapkan harga cache read GPT-6.1 Sol sebesar 0.05x, dibandingkan 0.1x untuk sebagian besar model GPT-5.6 dan setelahnya. Diskon ini berarti untuk agen yang menggunakan prompt sistem atau konteks repository besar di setiap giliran.
- Cache write sebesar 1.25x tarif input biasa. Biaya $2.50 per juta token untuk menulis prefix ke cache, lalu $0.10 per juta untuk membacanya kembali.
- Konteks panjang lebih mahal. Prompt di atas 272K token input dikenakan tarif 2x input dan cache serta 1.5x output untuk seluruh permintaan. Pada ukuran ini, input menjadi $4, cached input $0.20, cache write $5, dan output $15 per juta token.
- Batch dan Flex 50% lebih murah. Jika beban kerja bisa diproses secara asinkron, tarif efektif turun menjadi $1 input dan $5 output per juta token.
- Fast mode 2x Standard. Biaya untuk latensi lebih rendah, bukan kecerdasan lebih tinggi.
- Pemrosesan regional menambah 10% di wilayah yang tersedia.
Diskon cache-read menjadi sorotan utama. Agen pemrograman yang menggunakan konteks repository 100.000 token di 20 giliran hanya membayar $0.10 per juta token cache, bukan $2.00 per juta token input baru. Dalam sesi panjang, perbedaan ini sangat terasa.
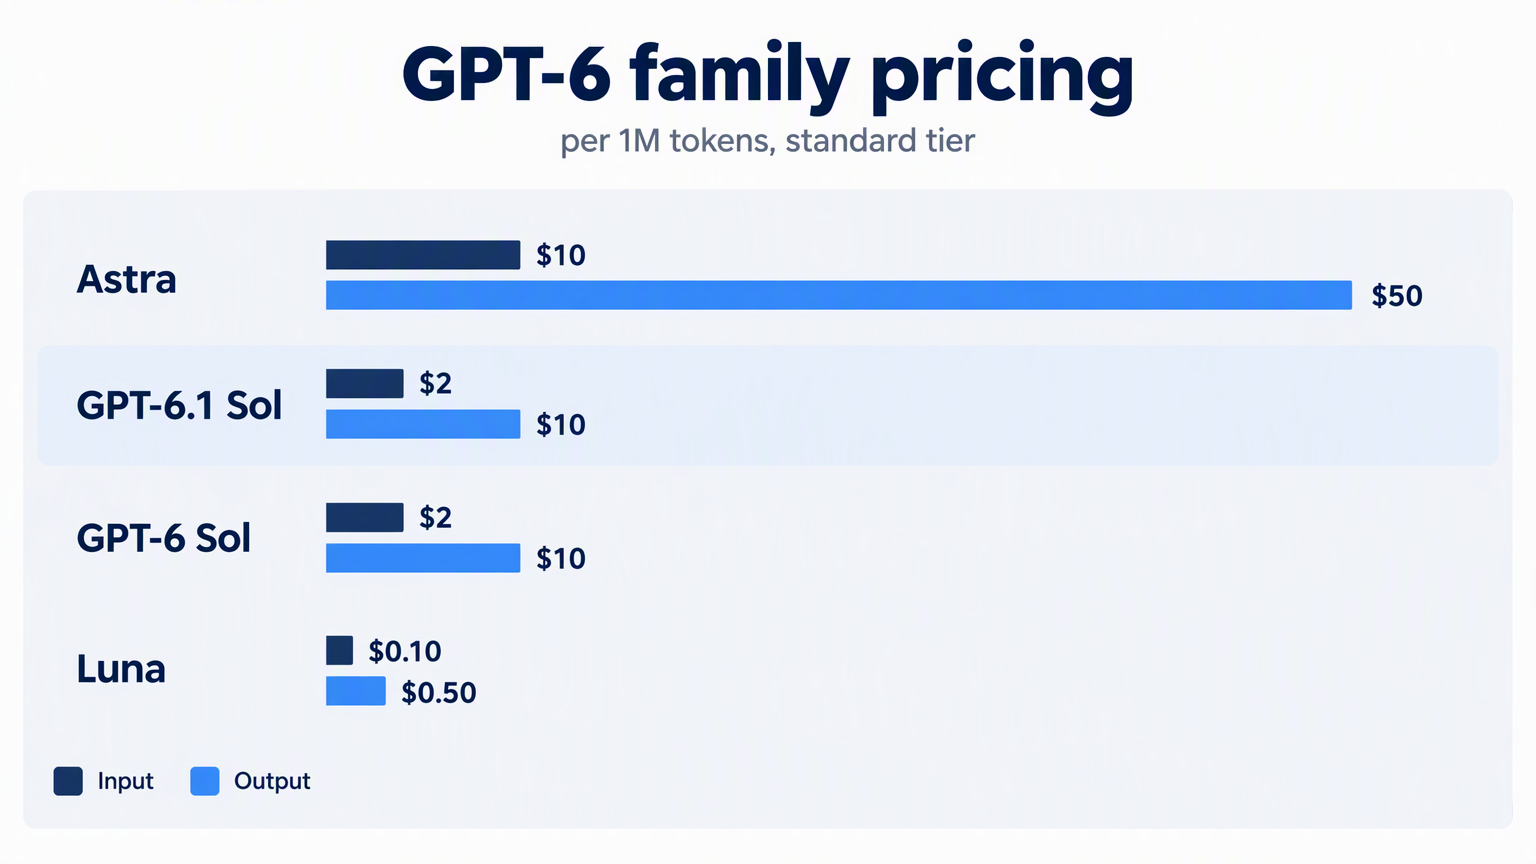
Sebagai perbandingan, GPT-6 Astra tercantum $10 input dan $50 output per juta token. GPT-6.1 Sol hanya seperlima harga di kedua sisi meter token. GPT-6 Luna lebih murah lagi dengan $0.10 input dan $0.50 output, tetapi kehilangan kemampuan mendekati Astra yang membuat Sol menarik.
Fitur baru di GPT-6 yang bisa digunakan Sol
GPT-6.1 Sol mewarisi fitur platform GPT-6 yang diperkenalkan OpenAI pada generasi Astra. Beberapa fitur sangat relevan untuk beban kerja agentik.
Pemanggilan tool asinkron
Biasanya, pemanggilan fungsi menghentikan model sampai aplikasi Anda mengembalikan hasil. Dengan pemanggilan tool asinkron, Anda menetapkan async: true pada definisi tool dan model tetap bekerja — melakukan reasoning, memanggil tool lain, atau menjawab bagian permintaan lain — sementara aplikasi menjalankan tugas lambat di latar belakang.
Aplikasi tetap menjalankan tool dan mengelola pekerjaan yang tertunda. Ketika tugas selesai, output dikembalikan dalam permintaan Responses berikutnya menggunakan call_id asli. Dokumentasi OpenAI menjelaskan ini sebagai cara memulai lookup lambat lebih awal dan melengkapi jawaban ketika data tiba.
Untuk Sol, fitur ini sangat cocok. Agen pemrograman bisa menjalankan suite tes panjang, tetap meninjau file lain, dan menggabungkan hasil tes saat sudah tersedia.
Mid-turn steering
Mid-turn steering memungkinkan pengguna mengirim koreksi atau persyaratan baru saat model masih bekerja. Melalui koneksi WebSocket ke Responses API, server mempertahankan pekerjaan yang sudah selesai dan menggabungkan pembaruan ke kelanjutan.
Catatan penting: steering tidak mengubah output yang sudah dikirim, tidak membatalkan aksi sebelumnya, atau membatalkan tool yang sudah berjalan. Steering mengubah arah kerja berikutnya, bukan yang sudah terjadi. Jika steering menginterupsi respons asli, respons tersebut berakhir dengan incomplete_details.reason: "steered" dan respons baru membawa pembaruan.
Mengubah reasoning di tengah percakapan
Reasoning effort bisa dinaikkan atau diturunkan selama percakapan dengan menambahkan item input configuration_update. Effort yang diperbarui berlaku sampai ada pembaruan lain. OpenAI menyarankan menjaga reasoning.effort di level permintaan agar prefix prompt tetap bisa di-cache.
Kombinasi ini — cache read murah dan reasoning yang bisa diatur — membuat Sol ekonomis untuk beban kerja campuran. Gunakan low untuk follow-up rutin, lalu beralih ke xhigh ketika tugas menjadi sulit, tanpa mengubah percakapan.
Multi-agent (beta)
Multi-agent tersedia sebagai fitur beta di GPT-6.1 Sol dan semua model GPT-5.6. Agen root bisa membuat subagent yang bekerja paralel, masing-masing dengan konteks terbatas, lalu mensintesis hasilnya ke jawaban akhir.
Dokumentasi OpenAI menyarankan fitur ini untuk tugas yang terbagi ke alur kerja independen: menjelajah bagian terpisah dari codebase besar, membandingkan proposal, meneliti sumber secara paralel, atau menyelidiki beberapa kemungkinan penyebab kegagalan sekaligus. Default max_concurrent_subagents adalah 3.
Konsekuensinya adalah penggunaan token. Lebih banyak agent berarti lebih banyak token, jadi multi-agent menguntungkan ketika kecepatan paralel dan konteks fokus lebih penting daripada ekonomi token.
Kompaksi dan reasoning yang dipersisten
Agen yang berjalan lama akhirnya memenuhi jendela konteks. Kompaksi mengurangi ukuran konteks sambil mempertahankan state yang dibutuhkan untuk giliran berikutnya. Kompaksi server-side bisa diaktifkan dengan context_management dan compact_threshold pada permintaan Responses; server mengeluarkan item kompaksi terenkripsi ketika jumlah token melewati threshold.
GPT-6.1 Sol juga mendukung reasoning.context: "all_turns", yang memungkinkan item reasoning kompatibel dari giliran sebelumnya terbawa ke sampel berikutnya. Reasoning yang dipersisten tetap opaque — API tidak pernah mengembalikan reasoning mentah model — tetapi memberi model kontinuitas sepanjang sesi panjang.
Mode WebSocket
Mode WebSocket mempertahankan koneksi ke Responses API dan hanya mengirim item input baru di setiap giliran. OpenAI melaporkan hingga 40% eksekusi end-to-end lebih cepat untuk rollout dengan 20 atau lebih pemanggilan tool. Untuk model yang berfokus pada pemrograman agentik dan penggunaan komputer, ini mengurangi latensi.
GPT-6.1 Sol vs GPT-6 Sol vs Astra vs Luna
Keluarga GPT-6 kini memiliki empat tingkatan. Pemilihan model bergantung pada kualitas yang dibutuhkan dan frekuensi workflow berjalan.
| Model | Positioning | Input / Output per 1M | Terbaik untuk |
|---|---|---|---|
| GPT-6 Astra | Kecerdasan tertinggi | $10 / $50 | Reasoning, pemrograman, dan pekerjaan profesional yang menuntut |
| GPT-6.1 Sol | Mendekati Astra dengan biaya lebih rendah | $2 / $10 | Pemrograman kompleks, penggunaan komputer, pekerjaan berbasis dokumen |
| GPT-6 Sol | Tingkat Sol sebelumnya | $2 / $10 | Beban kerja Sol sebelum upgrade |
| GPT-6 Luna | Tercepat dan paling hemat | $0.10 / $0.50 | Tugas fokus, volume tinggi |
GPT-6.1 Sol dan GPT-6 Sol memiliki harga utama yang sama, tetapi bukan model yang sama. Halaman Felo menggambarkan GPT-6.1 Sol sebagai upgrade dengan lebih sedikit kesalahan faktual dan kepatuhan lebih dekat terhadap batasan eksplisit. Tarif cache-read juga turun setengah: $0.10 per juta token dibanding $0.20. Jika sudah menjalankan GPT-6 Sol di produksi, upgrade meningkatkan kualitas dan ekonomi caching dengan harga yang sama.
Panduan pemilihan model OpenAI memetakan reasoning effort ke tipe tugas:
- GPT-6.1 Sol pada medium — pekerjaan teknis kompleks dan deliverable terkoordinasi yang akan direvisi.
- GPT-6.1 Sol pada extra high — deliverable matang, sistem visual terhubung, dan keputusan dari bukti yang saling bertentangan.
- Astra pada low — penulisan ringkas dan adaptasi konten yang menjaga fakta dan nuansa.
- Astra pada medium — proyek ambisius yang membutuhkan konteks luas, interaksi andal, dan hasil lengkap.
- Astra pada extra high — analisis menuntut dan deliverable kompleks dengan persyaratan ketat.
- Luna pada low — edit detail, pemecahan masalah terfokus, dan ekstraksi data sederhana.
- Luna pada extra high — menemukan konteks terkini di banyak aplikasi, memprioritaskan pekerjaan, dan menyelesaikan masalah dengan batasan jelas.
Aturan praktis dari panduan Codex OpenAI: gunakan Sol untuk pekerjaan berulang dan berjalan lama di kode, aplikasi, dan dokumen ketika biaya penting. Simpan Astra untuk pekerjaan paling menuntut. Gunakan Luna untuk tugas jelas dan berulang.
Cara memanggil GPT-6.1 Sol melalui Felo API Platform
Felo API Platform menyediakan GPT-6.1 Sol melalui endpoint kompatibel, sehingga SDK yang sudah ada tetap bisa digunakan dengan mengganti base URL.
Model tersedia di:
- Chat Completions:
POST https://openapi.felo.ai/api/v1/chat/completions - Responses:
POST https://openapi.felo.ai/api/v1/responses - Messages (kompatibel Anthropic):
POST https://openapi.felo.ai/api/v1/messages
Langkah 1: Dapatkan API key
Buat key dari akun Felo API Platform dan ekspor:
export FELO_API_KEY="YOUR_API_KEY"
Langkah 2: Kirim permintaan pertama
curl https://openapi.felo.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "messages": [
      {"role": "user", "content": "Explain the tradeoff between reasoning effort and cost."}
    ]
  }'
Langkah 3: Gunakan SDK kompatibel
Arahkan SDK OpenAI-kompatibel ke https://openapi.felo.ai/api/v1. Untuk klien gaya Claude, gunakan base URL kompatibel Anthropic https://openapi.felo.ai/api.
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FELO_API_KEY,
  baseURL: "https://openapi.felo.ai/api/v1",
});

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  input: "Review this pull request for correctness, security, and missing tests.",
});

console.log(response.output_text);
Langkah 4: Aktifkan streaming jika diperlukan
Tambahkan stream: true untuk menerima server-sent events selama model bekerja.
Halaman model Felo mencantumkan GPT-6.1 Sol dengan $2.00 per juta token input dan $10.00 per juta token output, dengan harga peluncuran yang bisa hingga 50% lebih rendah dari tarif API provider resmi. Biaya akhir bergantung pada model, campuran input/output, penggunaan cache, dan paket aktif. Cache read dikenakan setengah tarif GPT-6 Sol.
Platform juga mendukung reasoning, tools, output JSON, streaming, dan vision untuk model ini, serta menyediakan Playground untuk menguji prompt sebelum menulis kode.
Use case terbaik untuk GPT-6.1 Sol
Panduan OpenAI mengarahkan ke proyek kompleks dengan kebutuhan biaya. Beberapa pola nyata menonjol.
Pemrograman agentik skala besar
Agen pemrograman yang membaca repository, mengusulkan perubahan, menjalankan tes, dan beriterasi menjadi beban kerja utama Sol. Jendela konteks 1,05M menampung codebase besar, diskon cache-read menguntungkan penggunaan konteks repository, dan pemanggilan tool asinkron menjaga produktivitas agen selama tes berjalan.
Panduan Codex OpenAI merekomendasikan Sol untuk pekerjaan berulang dan berjalan lama di kode dan aplikasi ketika biaya penting, dan Astra untuk tugas paling menuntut.
Penggunaan komputer dan otomatisasi workflow
GPT-6.1 Sol mendukung seluruh set tool Responses, termasuk computer_use, hosted_shell, apply_patch, mcp, dan tool_search. Model ini cocok untuk agen yang mengoperasikan software, mengisi formulir, memindahkan data antar sistem, atau mengotomatisasi proses bisnis multi-langkah.
Halaman model Felo mencantumkan penggunaan komputer dan otomatisasi workflow multi-langkah sebagai use case utama.
Pekerjaan profesional berbasis dokumen
Sol menerima teks dan gambar, sehingga mencakup dokumen scan, grafik, screenshot, dan slide. Panduan pemilihan model OpenAI memberi dua contoh: membuat presentasi board dari hasil keuangan, dan membangun website dari brief produk. Keduanya melibatkan input besar, revisi berulang, dan standar kualitas di atas "murah dan cepat" namun di bawah "terbaik".
Riset dan analisis dengan alur kerja paralel
Dengan multi-agent beta, Sol bisa membagi tugas riset ke alur kerja independen, menjalankannya secara paralel, dan merekonsiliasi temuan. Membandingkan proposal vendor, meninjau pull request dari tiga sudut, atau menyelidiki beberapa hipotesis kegagalan cocok untuk fitur ini.
Pemrosesan batch volume tinggi
Harga Batch dan Flex menurunkan tarif Sol menjadi $1 input dan $5 output per juta token. Untuk pemrosesan dokumen malam hari, ringkasan massal, atau ekstraksi skala besar yang output-nya akan direview, harga ini membuat banyak hal menjadi layak secara ekonomi.
Checklist migrasi: pindah dari GPT-6 Sol ke GPT-6.1 Sol
OpenAI menyarankan meninjau panduan migrasi sebelum beralih dari gpt-6-sol ke gpt-6.1-sol. Berikut ringkasannya.
- Tetapkan model ID. Ubah
modelmenjadigpt-6.1-sol. - Perbaiki reasoning effort. GPT-6.1 Sol tidak mendukung
noneatauminimal. Gantinonedenganlowdan uji migrasiminimalmulai darilow. - Pindahkan pemanggilan tool ke Responses. Chat Completions hanya untuk permintaan tanpa tool. Pemanggilan fungsi, pencarian web, pencarian file, penggunaan komputer, atau workflow MCP membutuhkan Responses API.
- Hapus parameter yang tidak didukung. Jika reasoning effort bukan
none, hapustemperature,top_p, dantop_logprobs. Di Chat Completions, juga hapuslogprobs. Di Responses, hapusmessage.output_text.logprobsdariinclude. - Perbarui konfigurasi caching prompt. Jika migrasi dari GPT-5.5 atau sebelumnya, ganti
prompt_cache_retentiondenganprompt_cache_options.ttlbernilai"30m". - Gunakan
configuration_updateuntuk mengubah reasoning. Jika aplikasi mengubah effort antar giliran, gunakan itemconfiguration_updatedaripada mengubahreasoning.effortdi level permintaan, agar prefix prompt tetap bisa di-cache. - Cek data residency. GPT-6.1 Sol mendukung data residency US dan EU. Fast mode tidak tersedia dengan data residency EU.
- Uji dengan Astra. Jalankan kedua model pada tugas representatif dan bandingkan kualitas, latensi, dan total biaya — termasuk token reasoning yang dihitung sebagai token output.
Keterbatasan dan ketersediaan
GPT-6.1 Sol bukan pengganti universal Astra, dan belum tersedia di semua tempat.
Batas kemampuan. OpenAI menempatkan Sol di bawah Astra. Untuk reasoning paling menuntut dan deliverable paling penting, Astra tetap menjadi model yang direkomendasikan. Sol menjadi pilihan ekonomis untuk pekerjaan kompleks, bukan pilihan kualitas maksimum.
Tanpa fine-tuning. GPT-6.1 Sol tidak mendukung fine-tuning atau output prediksi. Model ini juga tidak mendukung embedding, pembuatan gambar, video, suara, transkripsi, terjemahan, atau endpoint moderasi. Model reasoning ini hanya menerima teks dan gambar, menghasilkan teks.
Tanpa input audio atau video. Modalitas input hanya teks dan gambar.
Reasoning tidak bisa dimatikan. Effort none dan minimal tidak didukung, sehingga setiap permintaan membawa overhead reasoning.
Rollout masih berjalan. Peluncuran OpenAI mencakup paket Plus, Pro, Business, Enterprise, dan Edu di Codex desktop dan CLI, serta ChatGPT Work di web dan mobile. Untuk Enterprise dan Edu, model tetap nonaktif sampai admin mengaktifkan. Paket Free dan Go tidak termasuk saat peluncuran.
Fast mode ada catatan. Standard dan Fast mode tersedia saat peluncuran, tetapi Fast mode 2x Standard dan tidak tersedia dengan data residency EU. Dukungan Ultrafast untuk GPT-6.1 Sol akan hadir kemudian.
Rate limit berlaku. Rate limit standar mulai dari 500 RPM dan 500.000 TPM di Tier 1 hingga 15.000 RPM dan 40.000.000 TPM di Tier 5.
FAQ
Apa itu GPT-6.1 Sol?
GPT-6.1 Sol adalah model GPT-6 seimbang dari OpenAI, berada di antara flagship GPT-6 Astra dan GPT-6 Luna yang ringan. OpenAI menggambarkannya sebagai model dengan performa mendekati Astra untuk pemrograman kompleks, penggunaan komputer, dan pekerjaan profesional dengan biaya lebih rendah.
Berapa harga GPT-6.1 Sol?
OpenAI mencantumkan GPT-6.1 Sol seharga $2 per juta token input dan $10 per juta token output. Cached input $0.10 per juta token, cache write $2.50 per juta token. Prompt di atas 272K token input dikenakan tarif long-context lebih tinggi.
Berapa jendela konteks GPT-6.1 Sol?
GPT-6.1 Sol memiliki jendela konteks 1.050.000 token, maksimum 922.000 token input, dan maksimum 128.000 token output.
Apakah GPT-6.1 Sol mendukung pemanggilan tool?
Ya, tetapi pemanggilan tool membutuhkan Responses API. Chat Completions hanya untuk permintaan tanpa tool.
Bisakah reasoning dimatikan di GPT-6.1 Sol?
Tidak. GPT-6.1 Sol mendukung reasoning effort low, medium, high, xhigh, dan max. Tidak mendukung none atau minimal.
Bagaimana perbandingan GPT-6.1 Sol dengan GPT-6 Sol?
GPT-6.1 Sol adalah upgrade dari GPT-6 Sol dengan lebih sedikit kesalahan faktual dan kepatuhan lebih dekat terhadap batasan eksplisit, menurut halaman model Felo. Keduanya memiliki harga token utama yang sama, tetapi GPT-6.1 Sol menurunkan tarif cached input menjadi $0.10 per juta token.
Apakah GPT-6.1 Sol tersedia di Felo API Platform?
Ya. Felo API Platform menyediakan GPT-6.1 Sol melalui endpoint Chat Completions, Responses, dan Messages kompatibel Anthropic. Harga peluncuran bisa hingga 50% lebih rendah dari tarif API provider resmi, dan cache read dikenakan setengah tarif GPT-6 Sol.
Kesimpulan
GPT-6.1 Sol menjadi jawaban OpenAI atas masalah praktis: model terbaik sering terlalu mahal untuk setiap tugas, dan model termurah sering tidak cukup baik. Sol menawarkan kemampuan mendekati Astra, jendela konteks 1,05M, tarif cache-read 5%, dan harga seperlima Astra.
Untuk tim yang membangun agen pemrograman, workflow penggunaan komputer, dan otomatisasi berbasis dokumen, model ini layak diuji pertama. Bandingkan dengan Astra pada tugas Anda sendiri, pantau penggunaan token reasoning, dan biarkan kompromi biaya-kualitas menentukan pilihan.
Anda dapat mencoba GPT-6.1 Sol di Felo API Platform Playground atau memanggilnya langsung dengan API key Felo.
Sumber
- Halaman model GPT-6.1 Sol — OpenAI
- Menggunakan GPT-6 — OpenAI
- Pemilihan model — OpenAI
- Harga API — OpenAI
- Ketersediaan model Codex dan ChatGPT — OpenAI
- Pemanggilan tool asinkron — OpenAI
- Mid-turn steering — OpenAI
- Model reasoning — OpenAI
- Prompt caching — OpenAI
- Kompaksi — OpenAI
- Multi-agent — OpenAI
- Mode WebSocket — OpenAI
- Fast mode — OpenAI
- Data residency — OpenAI
- GPT-6.1 Sol — Felo API Platform
Tulisan ini juga tersedia dalam English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.