
Gemini 4 Carbon su Felo API: specifiche, benchmark, prezzi e casi d'uso

Gemini 4 Carbon su Felo API: il budget unificato da 1 milione di token, i livelli di ragionamento, i limiti multimodali, i benchmark pubblicati, i prezzi reali e le modalità di utilizzo.
Gemini 4 Carbon di Google è il modello che l'azienda propone per attività che richiedono un lavoro approfondito e non si risolvono con un'analisi rapida: una migrazione di una base di codice che coinvolge decine di servizi, una ricerca di vulnerabilità che deve concludersi con una patch funzionante oppure una domanda di ricerca che richiede una catena di prove anziché un paragrafo di affermazioni convincenti.
Ora è accessibile tramite Felo API e Felo propone una prova gratuita a tempo limitato, insieme a tariffe scontate dei provider. Puoi aprire il modello, testare i prompt nel playground e creare una chiave dalla pagina Gemini 4 Carbon su Felo prima di leggere il resto di questa guida.
Questo articolo è una guida pratica, non un annuncio di lancio. Spiega che cos'è Carbon, in cosa differisce da Gemini 4 Argon, quali informazioni forniscono e quali non forniscono i benchmark pubblicati, come funziona il suo insolito budget di token, quali sono i suoi punti di forza, quali aspettative può deludere e quanto costa su Felo.
Che cos'è Gemini 4 Carbon
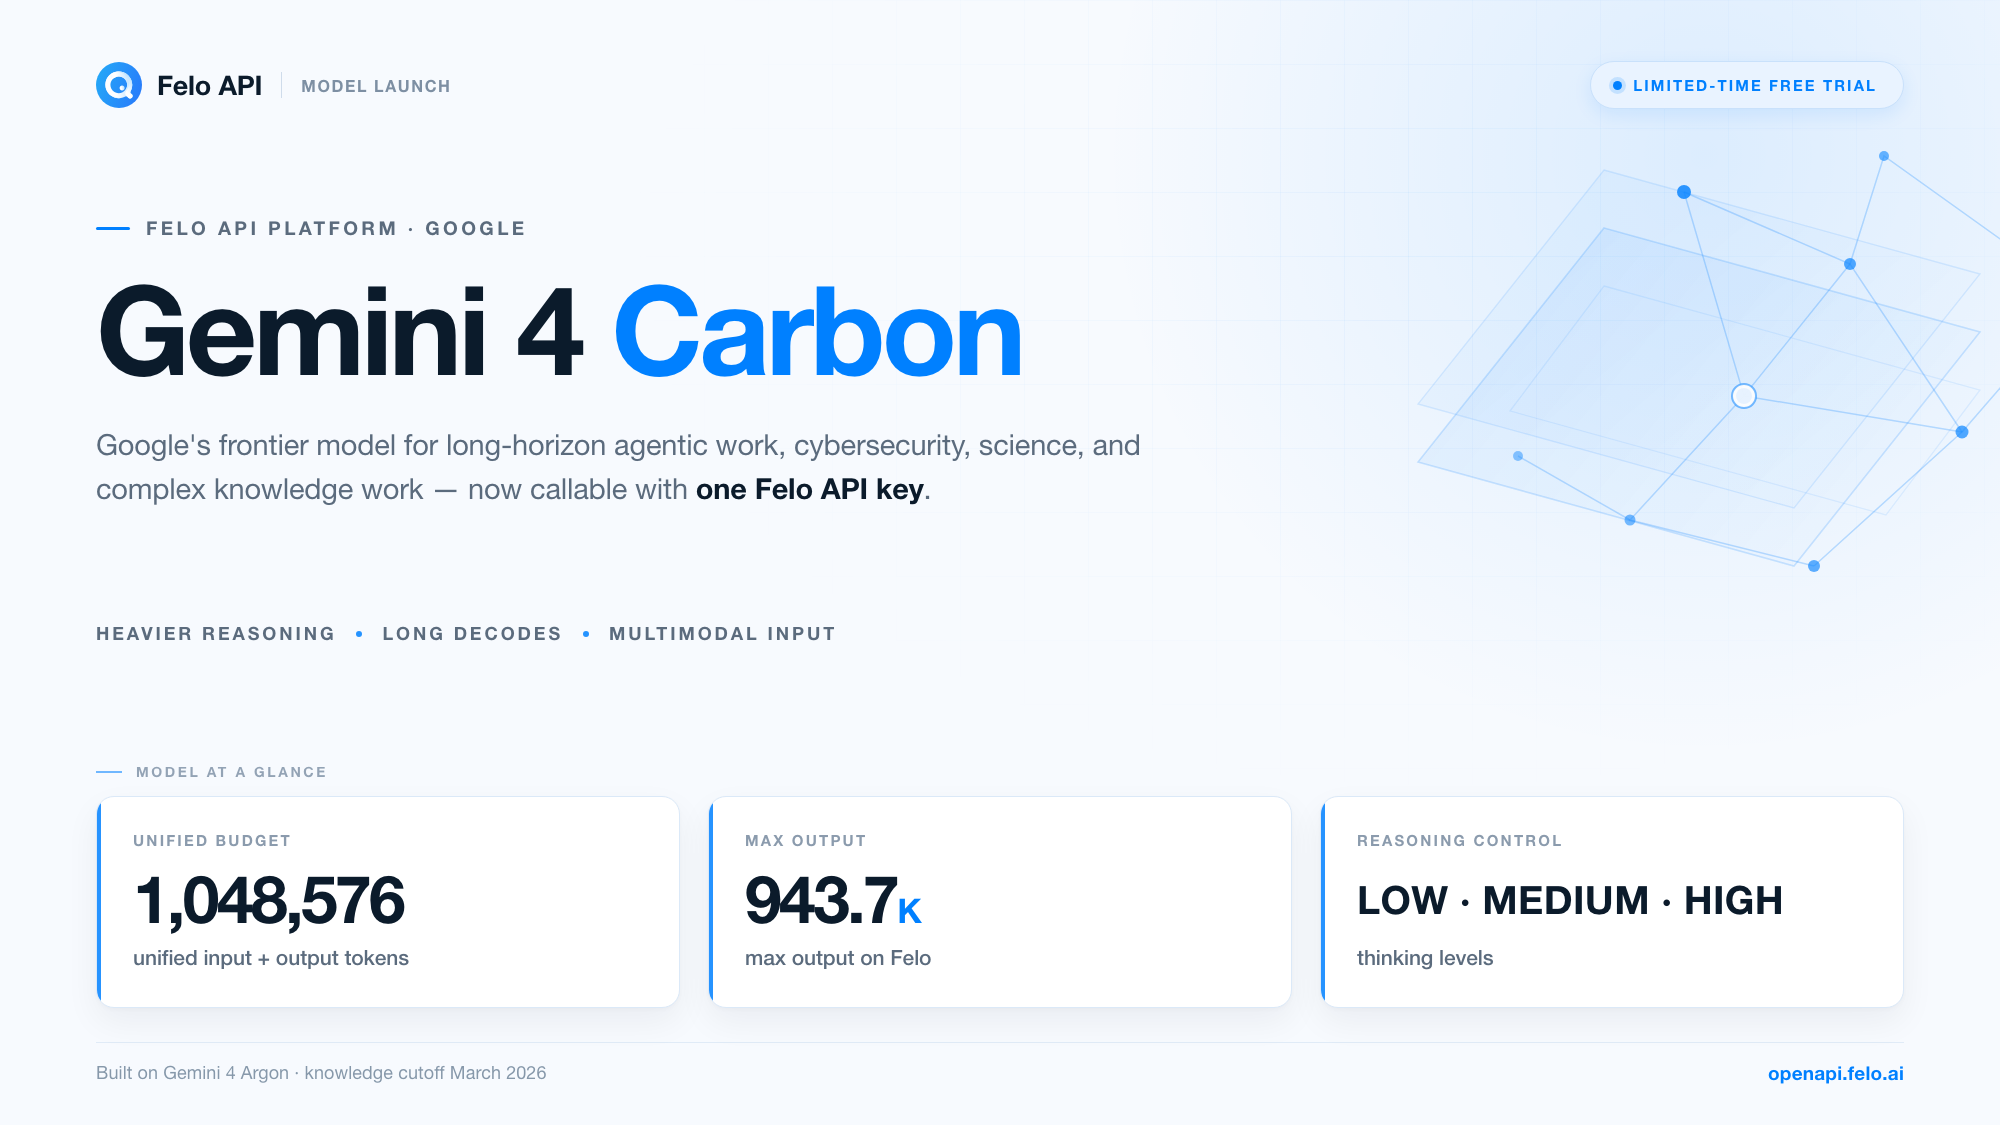
Gemini 4 Carbon è il modello frontier di Google per attività agentiche a lungo termine nei settori della programmazione, della finanza, del diritto, della sicurezza informatica e della scienza. Google lo ha annunciato il 28 ottobre 2026, lo ha sviluppato sulla base di Gemini 4 Argon e lo ha rilasciato in una fase iniziale a un gruppo selezionato di esperti di sicurezza informatica attraverso il programma Fairwind. La documentazione della piattaforma enterprise di Google indica ora il modello come disponibile per tutti, con data di rilascio fissata al 10 novembre 2026.
Il nome "Carbon" non indica una nuova generazione. Identifica un diverso punto operativo all'interno della famiglia Gemini 4. Argon era ottimizzato per produrre documenti lunghi e coerenti in un'unica sequenza, mentre Carbon destina una quota maggiore del proprio budget al ragionamento: esplorazione di ipotesi, cicli di verifica e coordinamento di attività articolate in più fasi. Google dichiara che Carbon utilizza più token di ragionamento rispetto ad Argon per arrivare alle proprie risposte.
Questo approccio comporta dei costi. Il modello è più lento nelle attività complesse, può raggiungere il timeout in alcune condizioni e consuma più token con i livelli di ragionamento elevati. Google dichiara queste limitazioni in modo esplicito. Il motivo per scegliere Carbon resta la natura delle attività a cui è destinato: analisi di sicurezza, migrazioni su larga scala, ragionamento scientifico e revisione di documenti ad alto rischio premiano la profondità più della velocità.
Specifiche del modello in sintesi
| Specifica | Valore |
|---|---|
| ID modello su Felo | gemini-4-carbon |
| Annuncio | 28 ottobre 2026 |
| Basato su | Gemini 4 Argon |
| Contesto e output | Un budget unificato di 1.048.576 token per input e output |
| Output massimo indicato su Felo | 943.718K token |
| Input | Testo, immagini, audio, video, PDF e file Office/OpenDocument |
| Output | Testo |
| Livelli di ragionamento | LOW, MEDIUM (predefinito), HIGH |
| Limite di conoscenza | Marzo 2026 |
| Campionamento | Temperature 1.0, top-p 0.95, top-k 64, valori fissi |
| Caching | Solo caching implicito, minimo di 4.096 token |
| Interfaccia Felo consigliata | Messages API (compatibile con Anthropic) |
| Accesso | Clienti enterprise verificati in regioni selezionate; variante cyber accessibile solo tramite allowlist |
Due dettagli della tabella meritano una sezione dedicata perché modificano il modo in cui si sviluppano le applicazioni basate sul modello: il budget unificato di token e i livelli di ragionamento.
Differenze tra Gemini 4 Carbon e Gemini 4 Argon
Carbon e Argon appartengono alla stessa famiglia, condividono il limite di conoscenza e gran parte del posizionamento. Le differenze riguardano il modo in cui il modello utilizza le proprie risorse.
Un budget unificato per input e output. Argon viene descritto come un modello con una finestra di contesto da 1.048.576 token e un limite di output predefinito separato di 65.536 token. I 1.048.576 token di Carbon comprendono input, ragionamento, chiamate agli strumenti e risposta finale. Si tratta di un unico budget, non di una finestra di contesto a cui si aggiunge una quota di output.
Ragionamento più approfondito come impostazione predefinita. Carbon supporta i livelli di ragionamento LOW, MEDIUM e HIGH. MEDIUM è il valore predefinito per gemini-4-carbon, mentre HIGH è il valore predefinito per la variante cyber-permissive. Il modello è progettato per eseguire cicli di verifica prolungati. Per questo Google indica il maggiore consumo di token come una limitazione nota, non come un bug.
Generazione prolungata. Un singolo segmento di generazione può produrre fino a 65.536 token di output durante lo streaming oppure 32.768 token senza streaming. Per superare questi limiti si utilizzano le generazioni prolungate: Google Gen AI SDK e Agent Studio gestiscono in modo automatico un token di continuazione, oppure puoi creare un ciclo di continuazione personalizzato. Il limite teorico corrisponde all'intero budget unificato meno i token di input.
Supporto più ampio ai file. Carbon accetta file Microsoft Office e OpenDocument — .docx, .doc, .pptx, .ppt, .xlsx, .xls, .odt, .odp, .ods — sia come allegati diretti sia da archivi cloud, oltre ai PDF e ai file di testo semplice. Questa caratteristica è importante quando il flusso di lavoro parte da una presentazione, un foglio di calcolo o un contratto anziché da un'esportazione di testo.
Ottimizzazione per la sicurezza e variante cyber separata. Google dichiara una riduzione di quasi l'80% degli avvisi di disallineamento ad alta gravità negli ambienti di programmazione reali. L'azienda afferma inoltre che Carbon supera Argon di 3,50 punti percentuali nelle valutazioni di sicurezza dei contenuti multilingue e multimodali da testo a testo. Esiste anche gemini-4-carbon-cyber-permissive, una variante accessibile solo tramite allowlist e destinata alla sicurezza difensiva, con livello di ragionamento HIGH predefinito e senza funzionalità di utilizzo del computer.
Funzionalità specifiche per la ricerca scientifica. Google afferma che il modello può tradurre obiettivi di sicurezza in teoremi matematici e individuare in autonomia omologhi remoti all'interno di archivi di sequenze su scala petabase. L'azienda segnala un aumento medio di 40 volte nel recupero di omologhi per famiglie proteiche con pochi omologhi. Si tratta di un'affermazione circoscritta a una specifica attività di ricerca: è il tipo di risultato da verificare sui propri dati anziché considerarlo una capacità generale.
Il budget unificato di token: spiegazione
La maggior parte delle pagine dei modelli indica due numeri: una finestra di contesto e un output massimo. Carbon ne indica uno solo, insieme a una regola per ogni segmento. Se pianifichi le richieste con il vecchio metodo, rischi di sovrastimare lo spazio disponibile o interpretare in modo errato i costi.
Ecco come viene suddiviso il budget:
- Input — il prompt, i documenti allegati, le immagini, l'audio, i fotogrammi video e la conversazione precedente.
- Ragionamento — i token che il modello utilizza per elaborare una risposta. Con HIGH, il consumo può essere elevato.
- Chiamate agli strumenti — tutte le operazioni avviate dal modello quando gli strumenti sono abilitati.
- Risposta finale — il testo che ricevi.
Tutte e quattro le componenti utilizzano gli stessi 1.048.576 token. Una richiesta con 900K token di input non lascia 1M di token per l'output. Rimangono circa 148K token per il ragionamento, gli strumenti e la risposta complessiva, prima di qualsiasi continuazione.
Il limite per segmento è separato. In una richiesta con streaming, un singolo segmento raggiunge un massimo di 65.536 token di output; senza streaming, il limite è di 32.768. Le generazioni prolungate consentono di superare il limite del segmento fino all'esaurimento del budget unificato. Se la tua integrazione interpreta max_tokens come una promessa sul volume totale dell'output, l'interpretazione è errata: il parametro limita un singolo segmento e la gestione delle continuazioni da parte dell'SDK permette di produrre un documento lungo.
La pagina del modello su Felo indica un output massimo di 943.718K token. Considera questo valore come il limite massimo di output sul percorso Felo, non come una seconda finestra di contesto più ampia. Con un budget unificato, lo spazio disponibile per la risposta dipende dal contenuto inviato.
La conseguenza per la progettazione è semplice: stabilisci prima la dimensione dell'output, poi adatta l'input allo spazio restante. Per una relazione lunga, riserva il budget necessario all'output e al ragionamento, quindi riduci il materiale di origine in base allo spazio disponibile. Per l'analisi di un grande insieme di documenti, considera che la risposta sarà più breve dell'input e pianifica continuazioni o prompt suddivisi in fasi.
Livelli di ragionamento: da dove deriva la qualità
Carbon offre tre livelli di ragionamento: LOW, MEDIUM e HIGH. MEDIUM è il valore predefinito. La documentazione di Google specifica che thinking_budget e thinking_level="MINIMAL" generano un errore di convalida. Non è quindi possibile azzerare il ragionamento.
La differenza pratica è significativa. Con LOW, il modello si comporta come un modello chat frontier orientato alla velocità: è adatto all'estrazione di informazioni, alla classificazione, alla riscrittura e alla revisione ordinaria del codice. Con MEDIUM, destina token alla pianificazione e all'autoverifica. Con HIGH, esegue cicli di verifica più lunghi. Questa impostazione offre maggiori possibilità di individuare errori sottili, ma comporta anche tempi di attesa e costi più elevati.
Alcune regole utili nella pratica:
- Scegli il livello in base al costo di una risposta errata. Se un errore è facile ed economico da individuare e correggere, usa LOW. Se un errore può arrivare in produzione o finire in un documento ufficiale, prova HIGH.
- Misura i token per risultato accettato, non i token per richiesta. Un livello di ragionamento superiore può ridurre i tentativi e il lavoro di correzione. Può anche moltiplicare i costi per attività che il modello avrebbe risolto con MEDIUM. Confronta l'intero processo.
- Non presumere che le impostazioni dei benchmark siano valide anche per il tuo caso. I principali risultati pubblicati da Google non indicano sempre il livello di ragionamento utilizzato. Prova le tue attività con due livelli prima di scegliere una configurazione definitiva.
I parametri di campionamento sono fissi: temperature 1.0, top-p 0.95 e top-k 64. I valori personalizzati vengono ignorati. Se la tua pipeline dipende dalla determinazione ottenuta con una temperatura bassa, Carbon non è il modello adatto a quella fase. Utilizzalo per valutazione e sintesi, e assegna le operazioni deterministiche a un modello che rispetta i controlli di campionamento.
I dati pubblicati da Google: benchmark e significato
La pagina del modello su Felo raccoglie i risultati dei benchmark pubblicati dal provider per Carbon. I confronti seguenti offrono indicazioni generali: provengono da Google o dai fornitori delle valutazioni, non sono stati replicati in modo indipendente per questo articolo e descrivono condizioni di test, non il tuo carico di lavoro.
| Valutazione | Cosa misura | Gemini 4 Carbon | Contesto |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | Indice composito di ragionamento | 59 | Primo posto; Claude Opus 5.5 a 58 |
| SEC-bench Pro | Individuazione delle vulnerabilità | 88.2% | Sicurezza, scansione difensiva |
| CWE-bench | Correzione delle vulnerabilità | 71.0% | Sicurezza, risoluzione |
| ExploitGym | Sfruttamento delle vulnerabilità | 54.8% | Ricerca sulla sicurezza, ambienti controllati |
| Terminal-Bench 4.0 | Tasso di successo degli imbrogli | 0.0% | Resistenza alla manipolazione dei premi, non capacità |
| Vals Index | Indice composito di lavoro basato sulla conoscenza | 70.45% | 3° posto su 36 modelli |
| Legal Research Bench | Ricerca giuridica | 55.77% | 1° posto |
| General Financial Intelligence | Attività finanziarie | #1 | Primo posto tra 23 configurazioni frontier, secondo Balyasny Asset Management |
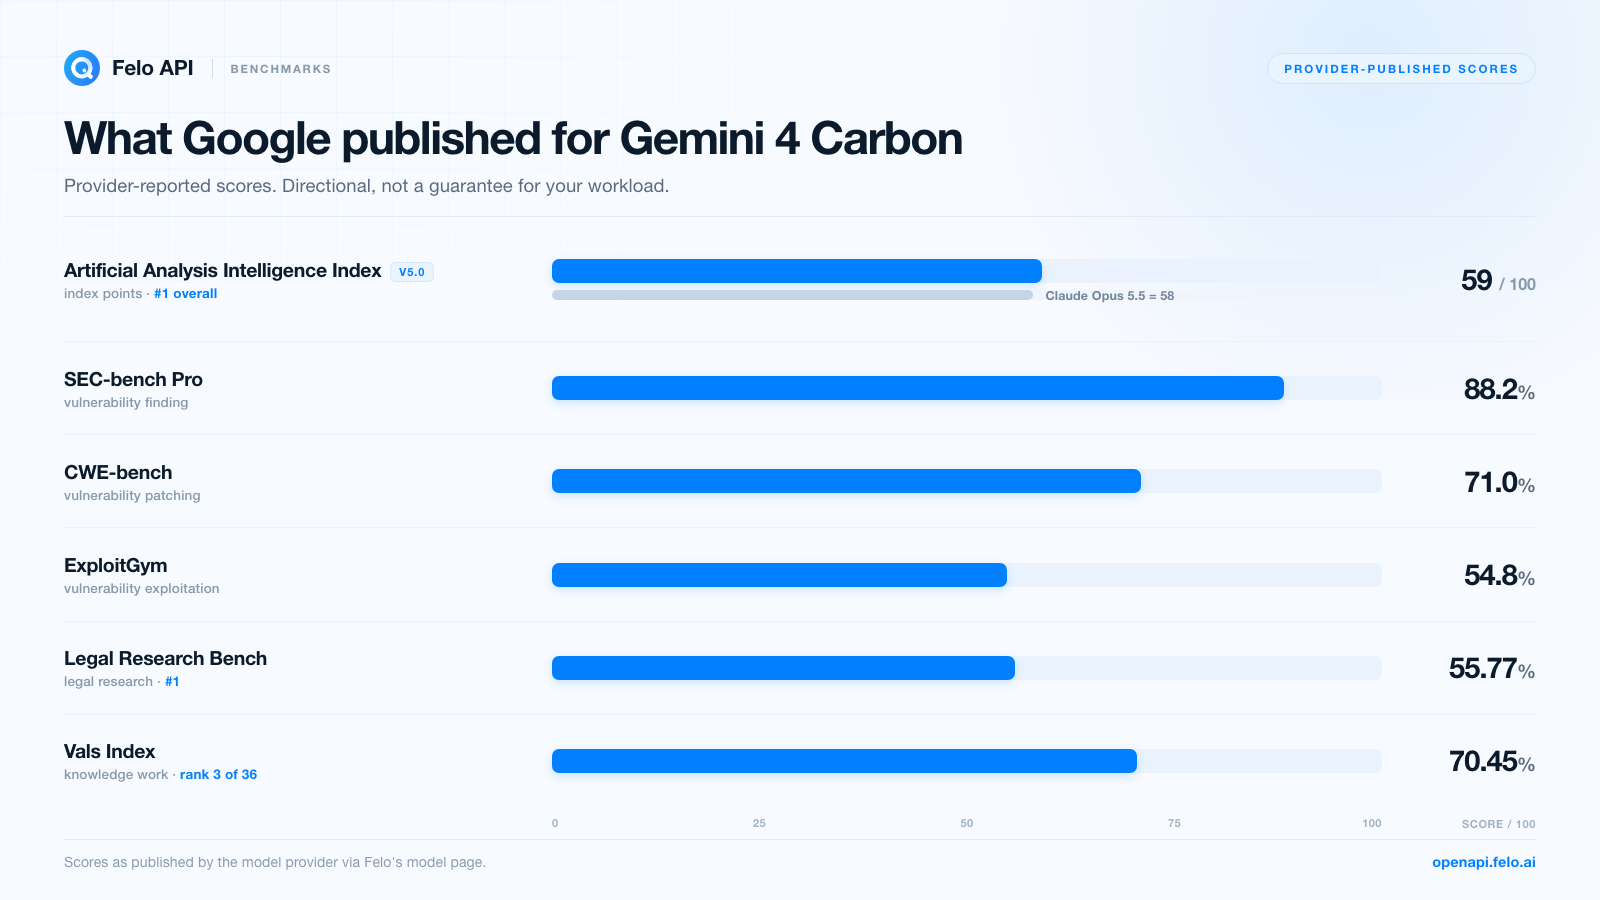
Una lettura attenta della tabella mette in evidenza tre aspetti.
I punteggi di sicurezza descrivono un ciclo completo, non una singola abilità. Individuare vulnerabilità, scrivere patch e sfruttare vulnerabilità sono competenze diverse. I risultati pubblicati di Carbon sono più alti nell'individuazione (88.2% su SEC-bench Pro) e più bassi nello sfruttamento (54.8% su ExploitGym), con la correzione in posizione intermedia (71.0% su CWE-bench). Se il tuo lavoro riguarda la sicurezza difensiva — scansione, classificazione delle priorità e risoluzione — questo profilo è adatto. Se hai bisogno di uno sfruttamento autonomo delle vulnerabilità, il punteggio è inferiore e le regole di accesso sono più restrittive.
La metrica del tasso di imbrogli riguarda l'affidabilità, non l'intelligenza. Il "successful cheating rate" di Terminal-Bench 4.0 misura la tendenza di un modello a manipolare un benchmark anziché risolvere l'attività. Un risultato dello 0.0% indica resistenza alla manipolazione dei premi, una caratteristica importante quando affidi a un agente attività senza supervisione. Non è un punteggio di capacità e non deve essere confrontato con i risultati percentuali di correttezza presenti nel resto della tabella.
Le classifiche del lavoro basato sulla conoscenza sono le più rilevanti per la maggior parte dei team. Il 3° posto su 36 nel Vals Index, il primo posto nel Legal Research Bench e il primato nel confronto finanziario di Balyasny descrivono il tipo di attività che giustifica il costo di un modello frontier: leggere grandi quantità di materiale, conciliare prove contrastanti e produrre documenti che un professionista possa esaminare. Questi risultati sono anche quelli più sensibili alla progettazione dei prompt e alla qualità delle fonti. Considerali quindi un motivo per eseguire test, non per evitarli.
Un'altra precisazione: il punteggio dell'Artificial Analysis Index è composito e un vantaggio di un punto su Claude Opus 5.5 rientra in un intervallo in cui una diversa combinazione di attività può invertire l'ordine. Sulle attività specifiche che ti interessano, i due modelli potrebbero avere prestazioni molto diverse, in entrambe le direzioni.
Dove Gemini 4 Carbon offre un'utilità concreta
I benchmark sono una mappa, non il territorio. Questi sono i carichi di lavoro in cui le scelte progettuali di Carbon corrispondono alle esigenze operative.
Programmazione su larga scala e migrazioni
Carbon è destinato ad attività ingegneristiche che richiedono collaborazione tra più agenti, debugging quotidiano, migrazioni di grandi basi di codice e progettazione di algoritmi. Il budget unificato è utile in questo contesto: puoi caricare la mappa di un repository, i file sorgente pertinenti, i risultati dei test non superati e i requisiti della migrazione in un'unica richiesta, quindi chiedere un piano prima di apportare modifiche al codice.
Un prompt adatto a questo tipo di modello:
Leggi la mappa del repository allegata e i tre moduli di servizio. Individua ogni punto del codice interessato dalla sostituzione dell'interfaccia di sessione, elenca i rischi di compatibilità e proponi un ordine di migrazione. Non scrivere ancora codice. Segnala ogni elemento che non puoi verificare dai file forniti.
Chiedi prima un piano. Consenti al modello di eseguire i test solo dopo aver esaminato il piano. Mantieni la revisione delle differenze sotto il controllo umano: un modello capace di pianificare bene può comunque produrre una patch che compila ma presenta comportamenti errati.
Sicurezza informatica difensiva
Il profilo dei benchmark di sicurezza — forte nell'individuazione, valido nella correzione e più debole nello sfruttamento — corrisponde alle attività difensive: scansione di una base di codice per individuare categorie di vulnerabilità, classificazione dei risultati degli scanner, proposta di patch e spiegazione dei rischi con indicazioni utili per chi deve effettuare una revisione. La variante cyber di Google è progettata per questo scopo, ma l'accesso è soggetto ad allowlist tramite il programma Fairwind e richiede un'approvazione separata.
Due precauzioni. Primo, esegui flussi di lavoro di sicurezza solo su sistemi per i quali possiedi l'autorizzazione ai test. Secondo, verifica i risultati prima di intervenire: un modello può segnalare una vulnerabilità con grande sicurezza e commettere comunque un errore. Un falso positivo comporta una perdita di tempo per il team di sviluppo.
Ricerca scientifica e tecnica
Le capacità scientifiche dichiarate riguardano attività specifiche: tradurre obiettivi di sicurezza in teoremi matematici e cercare omologhi remoti in archivi di sequenze su scala petabase. Se lavori in un laboratorio o in un gruppo di ricerca, un approccio utile consiste nel fornire a Carbon una domanda ben delimitata, la letteratura o le sequenze pertinenti e l'obbligo di distinguere le prove dalle inferenze.
L'affermazione relativa a un aumento di 40 volte nel recupero degli omologhi è notevole, ma riguarda famiglie proteiche con pochi omologhi all'interno di una pipeline specifica. Riproduci il risultato su un benchmark riconosciuto dal tuo team prima di costruire un flusso di lavoro basato su questa capacità.
Finanza, diritto e revisione di documenti ad alto rischio
Le classifiche di Carbon nel lavoro basato sulla conoscenza rappresentano il suo punto di forza commerciale per i servizi professionali. Le attività comprendono la riconciliazione dei registri contabili, l'analisi degli scostamenti, la revisione della giurisprudenza e dei documenti normativi, oltre alla produzione di relazioni con citazioni. Il modello legge immagini e PDF, quindi può elaborare documenti scansionati e grafici.
Questo non elimina la fase di revisione. Fornisci l'insieme delle fonti, chiedi di citare il passaggio a sostegno di ogni conclusione e controlla le citazioni. Un modello capace di gestire un milione di token di contesto può comunque interpretare in modo errato la pagina 412.
Agenti di lunga durata con strumenti
Carbon supporta chiamate a funzioni, output strutturato, esecuzione di codice, contesto URL, utilizzo del computer e diverse opzioni di grounding, tra cui Google Search, Google Maps e provider di ricerca di terze parti. Supporta anche la comprensione agentica dei video, una funzione utile quando l'input è una registrazione anziché un documento.
Questo è il metodo di utilizzo più impegnativo e quello con il maggior rischio di consumo di token. Aggiungi strumenti di monitoraggio all'agente: registra le chiamate agli strumenti, limita le iterazioni e richiedi un riepilogo delle verifiche eseguite prima di qualsiasi azione. Il budget da 1M rende possibili agenti ambiziosi, ma non li rende economici.
Input multimodali e relativi limiti
Carbon accetta testo, immagini, audio, video, PDF e documenti Office, e restituisce testo. I limiti sono ampi ma specifici e hanno un'importanza maggiore rispetto al semplice elenco delle modalità supportate.
| Tipo di input | Limite pratico |
|---|---|
| Audio | Circa 8,4 ore per prompt oppure fino a 1M di token; fino a 1.000 file audio |
| Video | Circa 45 minuti con audio, circa 1 ora senza audio; fino a 10 video per prompt |
| Immagini e documenti | Fino a 3.000 elementi complessivi per prompt |
| Documenti | Fino a 3.000 pagine per file |
| Formati Office | .docx, .doc, .pptx, .ppt, .xlsx, .xls |
| Formati OpenDocument | .odt, .odp, .ods |
| Dimensione input | 500 MiB compressi su GenerateContent API; 256 MiB su Interactions API |
Il limite audio è l'aspetto più interessante. Otto ore di audio in un'unica richiesta cambiano le possibilità operative di un team con molte riunioni: anziché trascrivere e suddividere le registrazioni in segmenti, puoi fornire un'intera giornata di chiamate e chiedere temi, decisioni e questioni aperte. Il costo è legato ai token e i token audio vengono fatturati come token di input. Il caricamento di un'intera giornata di registrazioni non è quindi gratuito.
Il limite video è più vicino a un utilizzo ordinario: 45 minuti di video con audio sono sufficienti per una lezione, una dimostrazione di prodotto o un'intervista registrata, ma non per un'intera conferenza.
Esistono alcune lacune funzionali da considerare. Gemini Live API non è supportata, quindi la voce in tempo reale non è disponibile. RAG Engine e la personalizzazione del modello non sono supportati, perciò il recupero delle informazioni e il fine-tuning devono essere gestiti dal livello applicativo. Non è supportato neppure il caching esplicito del contesto: è disponibile solo il caching implicito, con un minimo di 4.096 token. Questo aspetto incide sulla pianificazione dei costi per prompt lunghi ripetuti.
Come utilizzare Gemini 4 Carbon su Felo
Felo indica Messages API come interfaccia consigliata per questo modello. L'endpoint accetta una struttura di richiesta compatibile con Anthropic all'indirizzo https://openapi.felo.ai/api/v1/messages e l'ID del modello è gemini-4-carbon.
Il flusso è lo stesso previsto per qualsiasi altro modello Felo:
- Crea una chiave API Felo. Le chiavi si creano nella console Felo e si salvano come
FELO_API_KEY. Non inserire la chiave nel codice condiviso o nei log. - Esegui i test nel playground. Il playground Gemini 4 Carbon consente di provare i prompt prima di scrivere codice.
- Invia una richiesta breve. Inizia con un prompt semplice e verifica la struttura della risposta.
- Aggiungi lo streaming. Imposta
stream: trueper utilizzare gli eventi inviati dal server. Questa opzione è importante quando un singolo segmento può raggiungere 65.536 token. - Testa un'attività rappresentativa. Utilizza dimensioni di input reali, criteri di valutazione reali e almeno due livelli di ragionamento prima di adottare una pipeline definitiva.
Una richiesta Python minima ha questo aspetto:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
Due note sull'integrazione. Primo, questo modello supporta il ragionamento: conserva i metadati di ragionamento restituiti quando continui una conversazione, altrimenti potresti perdere il contesto richiesto dal modello. Secondo, max_tokens rappresenta un limite per segmento, non un limite totale. Per gli output lunghi, utilizza il meccanismo di continuazione esposto dal tuo SDK anziché aumentare il valore e affidarti a questo parametro.
Felo documenta anche gli endpoint Chat Completions e Responses compatibili con OpenAI per i modelli che li supportano. Poiché la pagina del modello consiglia Messages per Carbon, verifica l'interfaccia supportata sulla pagina del modello prima di riscrivere un client basato su OpenAI.
Quanto costa Gemini 4 Carbon su Felo
Felo instrada Gemini 4 Carbon attraverso cinque provider Google e tutti i percorsi sono indicati con uno sconto del 50%. I prezzi seguenti si riferiscono a 1 milione di token e mostrano sia la tariffa standard sia quella scontata.
| Percorso | Input | Output | Lettura cache |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
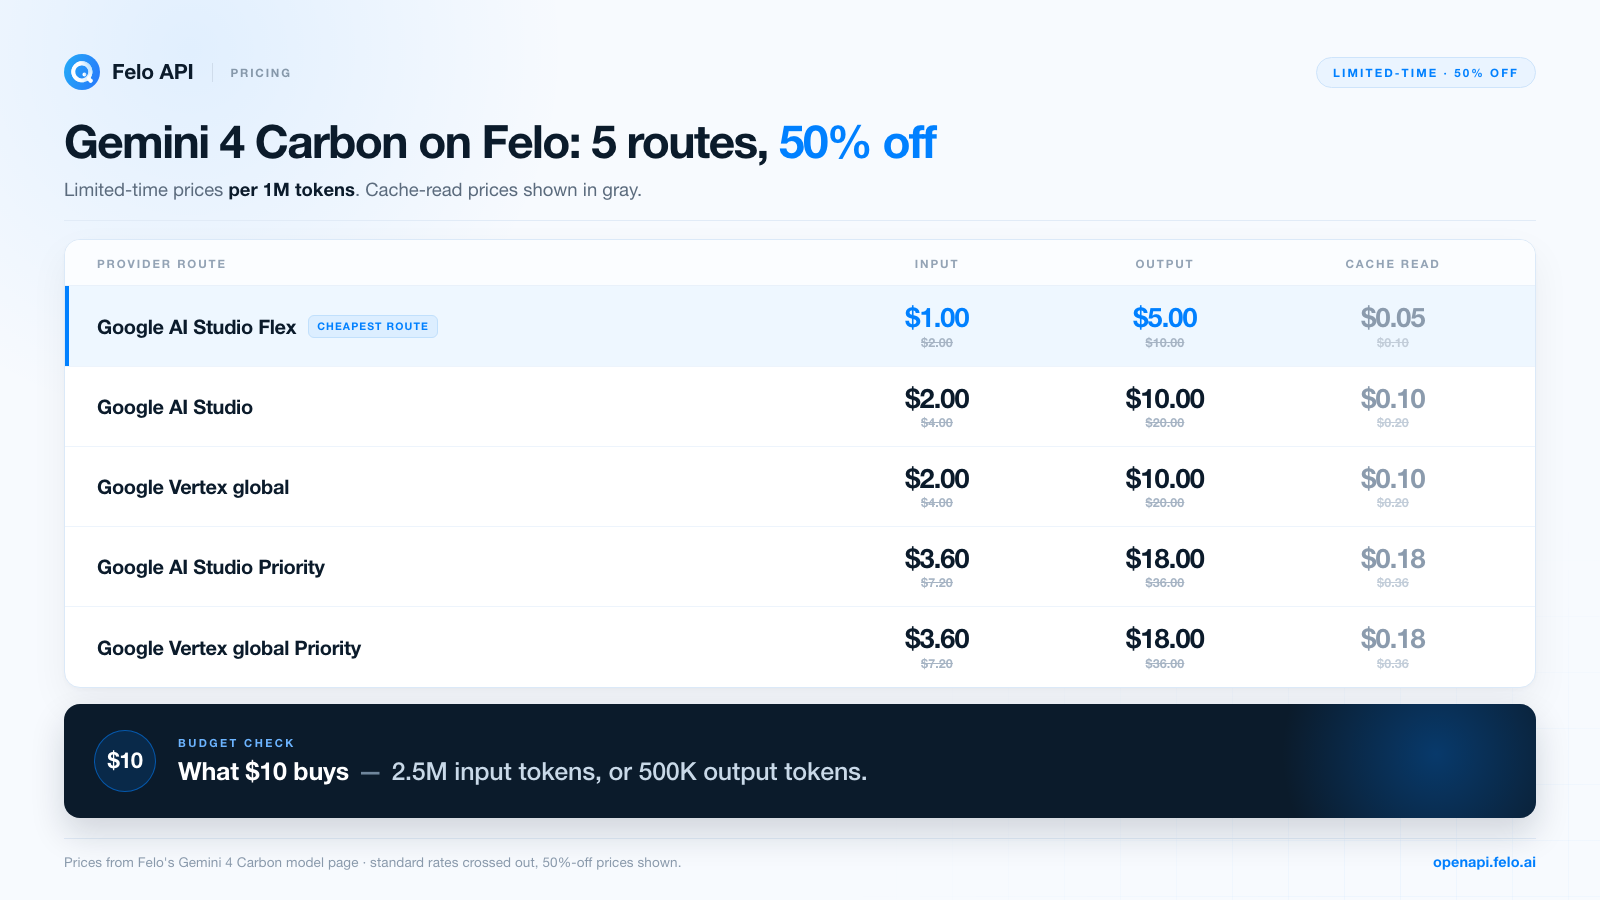
La pagina dei prezzi di Felo traduce le tariffe standard nella formula "cosa puoi acquistare con $10": circa 2,5 milioni di token di input oppure 500.000 token di output, prima degli sconti. È un riferimento utile per dimensionare una prova di concetto. Un test che invia gruppi di documenti da 100.000 token e riceve risposte da 5.000 token costa circa $0.13 sul percorso Flex con la tariffa scontata: $0.10 per l'input e $0.025 per l'output. Una cifra contenuta, che consente decine di prove prima di prendere una decisione.
La prova gratuita è un'offerta separata rispetto alle tariffe scontate. La pagina del modello Felo contrassegna Gemini 4 Carbon con una prova gratuita a tempo limitato. È il modo più rapido per testare il modello senza utilizzare crediti. Consulta le condizioni aggiornate sulla pagina del modello, poiché la disponibilità della prova e gli sconti sulle tariffe hanno una durata limitata e possono cambiare.
La pianificazione dei costi per questo modello richiede un'ulteriore abitudine. Poiché i token di ragionamento vengono fatturati alla tariffa di output, un'esecuzione di un agente con livello HIGH può costare diverse volte il valore suggerito dalla risposta visibile. Registra il consumo di token per ogni attività, compresi i token di ragionamento, e confronta il costo per risultato accettato anziché il costo per richiesta.
Limitazioni e aspetti da verificare prima dell'adozione
Carbon è un modello frontier con punti deboli documentati. Ecco quelli rilevanti per la pianificazione della produzione:
- Allucinazioni. Google le indica tra le limitazioni note. Un contesto lungo riduce il rischio di perdere informazioni, ma non garantisce un'interpretazione corretta. I flussi di lavoro basati su citazioni e verifiche restano necessari.
- Latenza e timeout. Google segnala occasionali rallentamenti e problemi di timeout. Le esecuzioni prolungate con ragionamento HIGH richiedono timeout generosi, tentativi ripetuti e gestione idempotente delle attività.
- Consumo elevato di token. Il modello utilizza più token di ragionamento rispetto ad Argon, soprattutto con i livelli elevati. Pianifica il budget e limita lo sforzo computazionale per le attività ordinarie.
- Limite di conoscenza: marzo 2026. Per qualsiasi informazione successiva servono sistemi di recupero o fonti aggiornate. Carbon non conosce gli eventi successivi a quella data.
- Campionamento fisso. Temperature, top-p e top-k non possono essere modificati. Se la tua pipeline richiede output deterministici, assegna quella fase a un altro modello.
- Assenza di caching esplicito, personalizzazione, RAG Engine e Live API. Ognuna di queste limitazioni trasferisce attività al livello applicativo.
- Vincoli di disponibilità. Google rende Carbon disponibile ai clienti enterprise verificati in alcune regioni; Felo lo instrada attraverso provider globali, statunitensi ed europei. Verifica il percorso e le condizioni applicabili al tuo caso d'uso.
- Regole di sicurezza e accesso. La variante cyber è soggetta ad allowlist e i flussi di lavoro di sicurezza richiedono un'autorizzazione. Restano valide le misure di protezione del modello e le politiche dei provider.
Quindi, dovresti utilizzarlo?
Scegli Gemini 4 Carbon quando l'attività è lunga, le prove sono complesse e una risposta errata comporta costi elevati: un piano di migrazione, una revisione di sicurezza, una sintesi di ricerca, un'analisi finanziaria o giuridica oppure un agente che deve svolgere un'indagine prima di agire. Il profilo dei benchmark e il budget unificato sono progettati per questo tipo di lavoro.
Non utilizzarlo come modello predefinito per ogni richiesta. Le attività di classificazione ad alto volume, le estrazioni brevi, i riepiloghi semplici e le operazioni che richiedono un campionamento deterministico sono più adatte a modelli meno costosi e più veloci. Il modello più economico che soddisfa i tuoi requisiti di qualità è quasi sempre la scelta corretta. Carbon deve dimostrare il proprio valore sulle attività più difficili del tuo carico di lavoro.
La conclusione più onesta è questa: Carbon è il modello più potente di Google per il lavoro approfondito, con punti di forza misurati nella sicurezza, nel diritto, nella finanza e nel ragionamento su contesti lunghi. Comporta costi reali in termini di latenza e token e presenta limitazioni documentate che rendono indispensabile la verifica. Testalo sulle tue attività prima di costruire un sistema basato su di esso.
Domande frequenti
Gemini 4 Carbon su Felo offre una prova gratuita?
Sì. Felo contrassegna Gemini 4 Carbon con una prova gratuita a tempo limitato e applica tariffe scontate dei provider per tutta la durata dell'offerta. Le condizioni possono cambiare, quindi consulta la pagina del modello Gemini 4 Carbon per verificare la disponibilità.
Qual è la differenza tra Gemini 4 Carbon e Gemini 4 Argon?
Carbon si basa su Argon ed è ottimizzato per un ragionamento più approfondito. Utilizza un budget unificato di 1.048.576 token che comprende input, ragionamento, chiamate agli strumenti e output; supporta i livelli di ragionamento LOW, MEDIUM e HIGH; consuma più token di ragionamento e aggiunge il supporto ai file Office/OpenDocument, insieme a misure di sicurezza più avanzate. Argon resta la scelta per la generazione di contenuti lunghi quando la lunghezza dell'output conta più della profondità delle verifiche.
Qual è la finestra di contesto e l'output massimo di Gemini 4 Carbon?
Il budget unificato è di 1.048.576 token e comprende input e output. Un singolo segmento con streaming può produrre fino a 65.536 token di output, oppure 32.768 senza streaming. Le generazioni prolungate consentono di estendere l'output fino all'esaurimento del budget restante. Felo indica un output massimo di 943.718K token sul proprio percorso.
Gemini 4 Carbon può leggere audio, video e file Office?
Sì. Accetta testo, immagini, audio, video, PDF e file Office/OpenDocument, con limiti di circa 8,4 ore di audio, circa 45–60 minuti di video, 3.000 immagini e documenti complessivi e 3.000 pagine per documento. L'output è composto solo da testo.
Gemini 4 Carbon supporta le API compatibili con OpenAI?
Felo consiglia la propria Messages API compatibile con Anthropic per questo modello e documenta anche gli endpoint Chat Completions e Responses compatibili con OpenAI per i modelli supportati. Verifica l'interfaccia disponibile sulla pagina del modello prima di riscrivere un client esistente.
Quanto costa Gemini 4 Carbon?
Felo indica cinque percorsi Google, tutti con uno sconto del 50%: AI Studio Flex a $1 per l'input e $5 per l'output per milione di token, AI Studio e Vertex standard a $2 / $10 e i percorsi Priority a $3.60 / $18. La lettura della cache parte da $0.05 per milione di token. Consulta la pagina dei prezzi di Felo per le tariffe in vigore.
Quando è stato rilasciato Gemini 4 Carbon?
Google ha annunciato Gemini 4 Carbon il 28 ottobre 2026, con un rilascio iniziale a un gruppo selezionato di esperti di sicurezza informatica attraverso il programma Fairwind. La piattaforma enterprise di Google indica il 10 novembre 2026 come data di disponibilità generale. Felo instrada ora il modello attraverso cinque provider Google.
Prova Gemini 4 Carbon su Felo
Il modo più rapido per valutare Carbon consiste nell'assegnargli un'attività di cui conosci già la risposta. Apri il playground Gemini 4 Carbon, inserisci un documento o un campione di codice reale e confronta i livelli di ragionamento LOW e HIGH con lo stesso prompt. Se il risultato soddisfa i tuoi requisiti, crea una chiave e trasferisci il test nella tua pipeline.
Inizia dalla pagina del modello Gemini 4 Carbon per consultare le condizioni della prova gratuita, i percorsi dei provider e i limiti in vigore. Poi crea il test più piccolo possibile attorno all'attività più difficile che devi affrontare.
Questo articolo è disponibile anche in English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, ไทย, Español, বাংলা and Português.