API GPT-6.1 Sol: Prestazioni quasi Astra a un costo inferiore
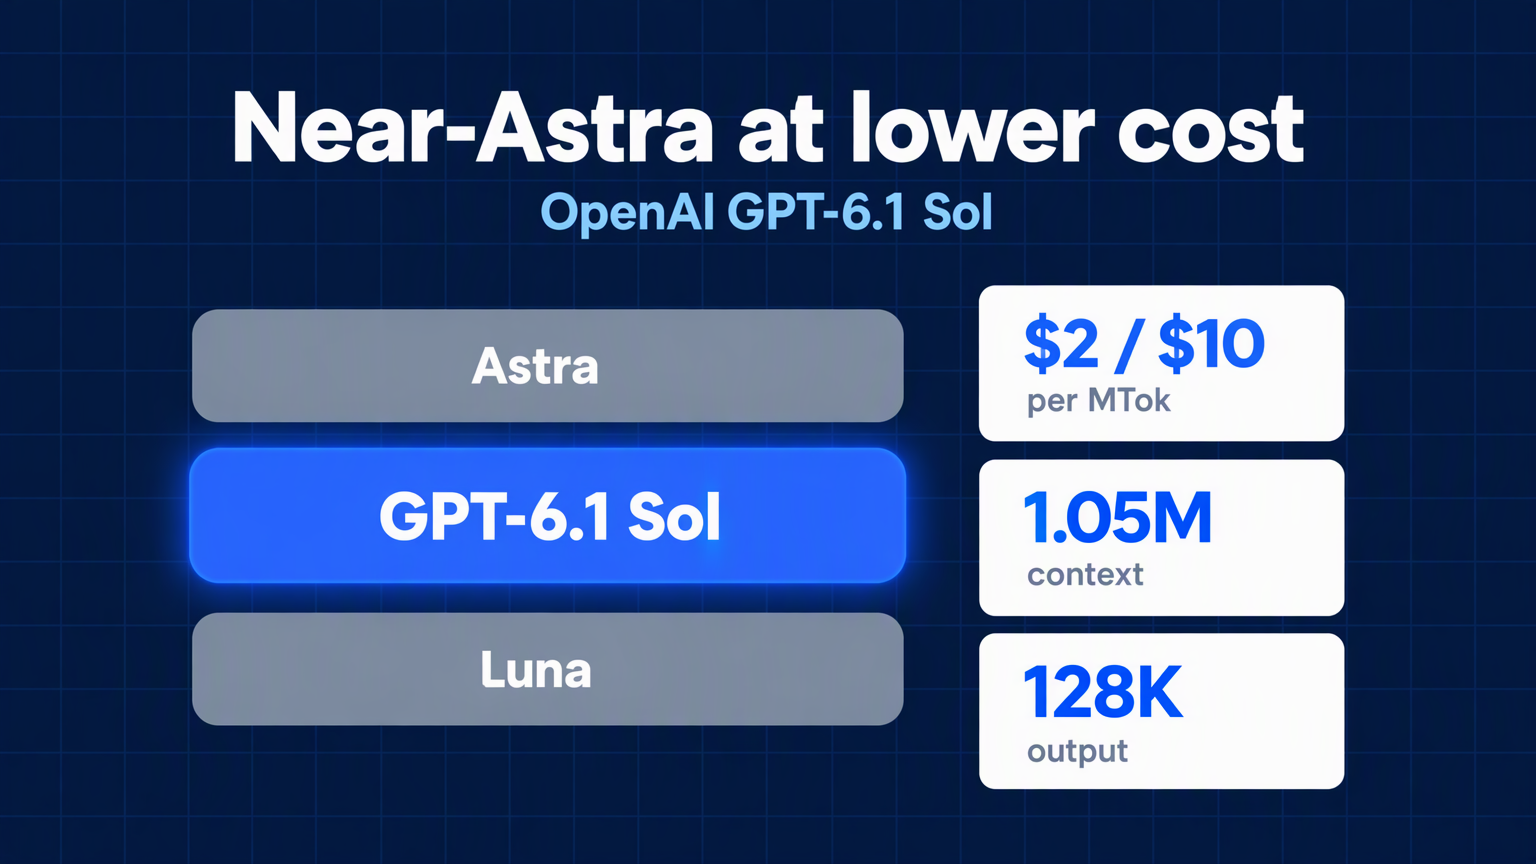
OpenAI GPT-6.1 Sol offre prestazioni quasi Astra per programmazione, uso del computer e lavoro professionale a $2/$10 per milione di token con una finestra di contesto da 1,05M.
Il nuovo modello Sol di OpenAI non punta a essere il più intelligente. Punta a essere quello che puoi permetterti di usare tutto il giorno.
GPT-6.1 Sol si posiziona tra il modello di punta GPT-6 Astra e il modello leggero GPT-6 Luna. La pagina ufficiale del modello lo descrive in una frase: "Prestazioni quasi Astra per lavori complessi a un costo inferiore." Per i team che costruiscono strumenti agentici per la programmazione, agenti per l’uso del computer e flussi di lavoro ricchi di documenti, questo compromesso rappresenta il punto centrale.
Questa guida mostra cosa offre GPT-6.1 Sol, quanto costa, come si differenzia da GPT-6 Sol e Astra, e come chiamarlo tramite la Felo API Platform.
Cos’è GPT-6.1 Sol
GPT-6.1 Sol è un modello di ragionamento progettato per programmazione complessa, uso del computer e lavoro professionale. OpenAI lo presenta come l’opzione equilibrata della famiglia GPT-6: più capace di Luna, meno costoso di Astra, e abbastanza forte da coprire molti carichi di lavoro senza bisogno del modello di punta.
La pagina del modello indica come usarlo: confronta Sol con Astra sulle tue attività, poi valuta se la differenza di qualità giustifica la differenza di prezzo. Questo consiglio risulta pratico e riflette lo scopo del modello. Sol serve per controllare i costi, non per vincere benchmark.
La pagina di Felo riassume la stessa posizione dal lato della piattaforma. GPT-6.1 Sol è "un aggiornamento di GPT-6 Sol, ancora sotto il modello di punta GPT-6 Astra." Gestisce programmazione agentica, uso del computer, lavoro professionale ricco di documenti e automazione di flussi di lavoro multi-step, avvicinandosi ai risultati di Astra su questi compiti a un costo molto più basso. Rispetto a GPT-6 Sol, Felo segnala meno errori fattuali e maggiore rispetto delle restrizioni esplicite.
GPT-6.1 Sol è il modello da scegliere quando il compito è difficile, lungo e ripetibile — e il costo deve restare prevedibile.
Specifiche GPT-6.1 Sol in breve
OpenAI pubblica la specifica completa sulla pagina del modello. Ecco la versione sintetica.
| Specifica | GPT-6.1 Sol |
|---|---|
| Model ID | gpt-6.1-sol |
| Snapshot predefinito | gpt-6.1-sol |
| Finestra di contesto | 1.050.000 token |
| Token input massimo | 922.000 |
| Token output massimo | 128.000 |
| Knowledge cutoff | 30 aprile 2026 |
| Modalità input | Testo, immagine |
| Modalità output | Testo |
| Modalità non supportate | Audio, video |
| Supporto token di ragionamento | Sì |
| Livello di ragionamento | low, medium (predefinito), high, xhigh, max |
| Livello di ragionamento non supportato | none, minimal |
| Residenza dati | USA e UE |
Due dettagli contano più dei numeri principali.
Primo, il ragionamento non può essere disattivato. GPT-6.1 Sol non supporta none o minimal. Se migri da un modello che permetteva queste impostazioni, OpenAI consiglia di partire da low e confrontare i risultati su attività rappresentative.
Secondo, la chiamata degli strumenti richiede l’API Responses. GPT-6.1 Sol supporta Chat Completions per richieste senza strumenti, ma ogni flusso che chiama funzioni, cerca file, naviga sul web o controlla un computer deve passare a Responses. Non è una limitazione esclusiva di Sol — è la direzione in cui OpenAI sta portando tutta la piattaforma.
Prezzi GPT-6.1 Sol: cosa compri con $2/$10
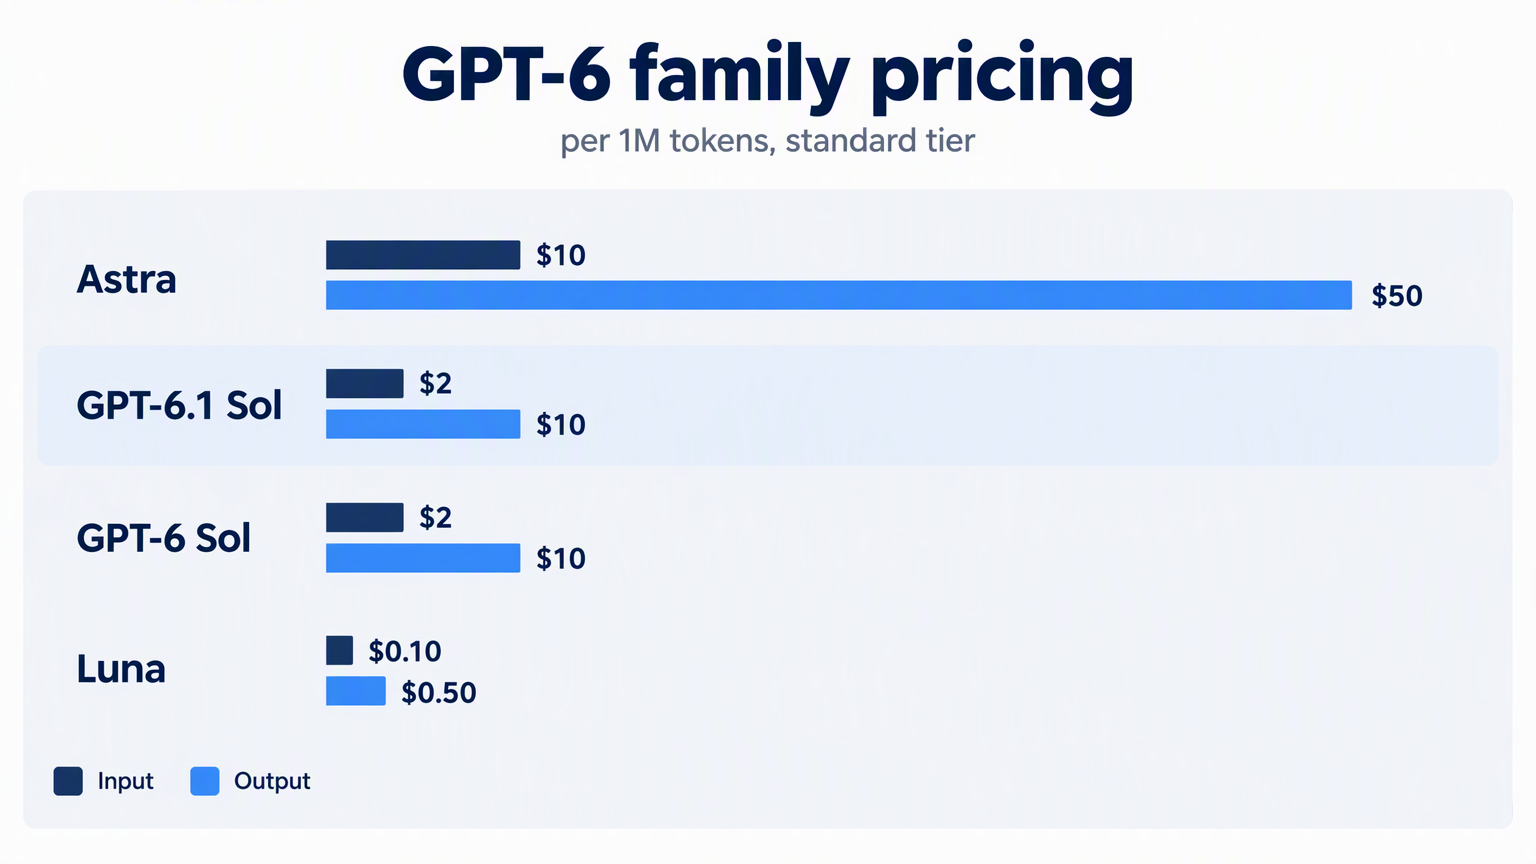
Il prezzo standard di OpenAI per GPT-6.1 Sol è $2 per milione di token input e $10 per milione di token output. La tabella completa include il prezzo della cache, che cambia il calcolo per agenti che lavorano a lungo.
| Metrica | Prezzo per 1M token |
|---|---|
| Input | $2.00 |
| Input in cache | $0.10 |
| Scrittura cache | $2.50 |
| Output | $10.00 |
Alcune regole si applicano sotto questa tabella:
- L’input in cache costa il 5% del prezzo normale. OpenAI fissa il prezzo delle letture cache di GPT-6.1 Sol a 0,05x, rispetto a 0,1x per la maggior parte dei modelli GPT-5.6 e successivi. Questo sconto risulta importante per agenti che riutilizzano un prompt di sistema o un contesto di repository ad ogni turno.
- Scrivere in cache costa 1,25x il prezzo dell’input non cache. Si paga $2.50 per milione di token per scrivere un prefisso in cache, poi $0.10 per milione per leggerlo.
- Contesto lungo costa di più. Prompt sopra 272K token input vengono fatturati a 2x input e cache, e 1,5x output per l’intera richiesta. A queste dimensioni, input diventa $4, input cache $0.20, scrittura cache $5 e output $15 per milione di token.
- Batch e Flex costano il 50% in meno. Se il carico di lavoro tollera elaborazione asincrona, il prezzo effettivo scende a $1 input e $5 output per milione di token.
- Fast mode costa il doppio di Standard. Si paga per la latenza minore, non per maggiore intelligenza.
- Elaborazione regionale aggiunge un 10% di sovrapprezzo dove disponibile.
Lo sconto sulle letture cache rappresenta il punto chiave. Un agente di programmazione che riutilizza lo stesso contesto repository da 100.000 token su venti turni paga $0.10 per milione di token cache invece di $2.00 per milione di token input fresco. Su una sessione lunga, la differenza cresce rapidamente.
Per confronto, GPT-6 Astra costa $10 input e $50 output per milione di token. GPT-6.1 Sol costa un quinto su entrambi i lati. GPT-6 Luna costa ancora meno a $0.10 input e $0.50 output, ma rinuncia alla capacità quasi Astra che rende Sol interessante.
Novità di GPT-6 che Sol può usare
GPT-6.1 Sol eredita le funzioni della piattaforma GPT-6 introdotte con Astra. Diverse risultano importanti per carichi di lavoro agentici.
Chiamata strumenti asincrona
Normalmente, una chiamata funzione mette in pausa il modello finché l’applicazione restituisce un risultato. Con la chiamata asincrona, si imposta async: true sulla definizione dello strumento e il modello continua — ragiona, chiama altri strumenti o risponde ad altre parti della richiesta — mentre l’applicazione esegue il lavoro lento in background.
L’applicazione esegue comunque lo strumento e gestisce il lavoro in sospeso. Quando il lavoro termina, si restituisce l’output in una richiesta Responses successiva usando il call_id originale. I documenti OpenAI descrivono questo metodo come un modo per avviare ricerche lente in anticipo e completare la risposta quando arrivano i dati.
Per Sol, questa funzione si adatta bene. Un agente di programmazione può avviare una suite di test lunga, continuare a revisionare altri file e integrare i risultati dei test quando arrivano.
Steering a metà turno
Lo steering a metà turno permette all’utente di inviare una correzione o un nuovo requisito mentre il modello sta ancora lavorando. Tramite una connessione WebSocket all’API Responses, il server conserva il lavoro completato e integra l’aggiornamento in una continuazione.
Il caveat importante: lo steering non riscrive output già inviato, non annulla azioni precedenti e non cancella strumenti già avviati. Cambia la direzione del lavoro successivo, non quello già svolto. Se lo steering interrompe la risposta originale, questa termina con incomplete_details.reason: "steered" e una nuova risposta porta l’aggiornamento.
Cambiare ragionamento durante la conversazione
Si può alzare o abbassare il livello di ragionamento durante una conversazione aggiungendo un elemento input configuration_update. Il livello aggiornato resta attivo finché un altro aggiornamento lo modifica. OpenAI consiglia di non cambiare il reasoning.effort a livello di richiesta, così il prefisso del prompt resta cacheabile.
Questa combinazione — letture cache economiche e ragionamento regolabile — rende Sol conveniente per carichi misti. Si usa low per follow-up di routine, poi si passa a xhigh quando il compito diventa difficile, senza riscrivere la conversazione.
Multi-agent (beta)
Multi-agent è disponibile come funzione beta con GPT-6.1 Sol e tutti i modelli GPT-5.6. Un agente root può avviare subagenti che lavorano in parallelo, ciascuno con un contesto limitato, poi sintetizzare i risultati in una risposta finale.
I documenti OpenAI la consigliano per compiti che si dividono in flussi indipendenti: esplorare parti separate di un grande codebase, confrontare proposte, ricercare fonti in parallelo o indagare diverse cause possibili di un errore. Il valore predefinito di max_concurrent_subagents è 3.
Il compromesso riguarda i token. Più agenti significa più token, quindi multi-agent conviene quando velocità parallela e contesto focalizzato contano più dell’economia dei token.
Compattazione e ragionamento persistente
Agenti che lavorano a lungo riempiono la finestra di contesto. La compattazione riduce la dimensione del contesto mantenendo lo stato necessario per i turni successivi. Si può abilitare la compattazione server-side impostando context_management con compact_threshold in una richiesta Responses; il server emette un elemento di compattazione criptato quando il conteggio token supera la soglia.
GPT-6.1 Sol supporta anche reasoning.context: "all_turns", che permette agli elementi di ragionamento compatibili dei turni precedenti di passare al campione successivo. Il ragionamento persistente resta opaco — l’API non restituisce mai il testo grezzo del modello — ma offre continuità su sessioni lunghe.
Modalità WebSocket
La modalità WebSocket mantiene una connessione persistente all’API Responses e invia solo nuovi elementi input ad ogni turno. OpenAI riporta fino al 40% di esecuzione end-to-end più veloce per rollout con 20 o più chiamate strumenti. Per un modello pensato per programmazione agentica e uso del computer, questo riduce la latenza.
GPT-6.1 Sol vs GPT-6 Sol vs Astra vs Luna
La famiglia GPT-6 ha ora quattro livelli. La scelta dipende dalla qualità richiesta e dalla frequenza del flusso di lavoro.
| Modello | Posizionamento | Input / Output per 1M | Ideale per |
|---|---|---|---|
| GPT-6 Astra | Intelligenza massima | $10 / $50 | Ragionamento, programmazione e lavoro professionale impegnativi |
| GPT-6.1 Sol | Quasi Astra a costo inferiore | $2 / $10 | Programmazione complessa, uso del computer, lavoro ricco di documenti |
| GPT-6 Sol | Livello Sol precedente | $2 / $10 | Carichi Sol esistenti prima dell’aggiornamento |
| GPT-6 Luna | Più veloce e conveniente | $0.10 / $0.50 | Compiti mirati e ad alto volume |
GPT-6.1 Sol e GPT-6 Sol hanno lo stesso prezzo principale, ma non sono lo stesso modello. La pagina di Felo descrive GPT-6.1 Sol come un upgrade con meno errori fattuali e maggiore rispetto delle restrizioni esplicite. Il prezzo delle letture cache è anche dimezzato: $0.10 per milione di token invece di $0.20. Se già usi GPT-6 Sol in produzione, l’upgrade migliora qualità e economia della cache allo stesso prezzo.
La guida di OpenAI per la selezione del modello mappa il livello di ragionamento al tipo di compito:
- GPT-6.1 Sol a medium — lavoro tecnico complesso e deliverable coordinati che prevedi di revisionare.
- GPT-6.1 Sol a extra high — deliverable curati, sistemi visivi collegati e decisioni basate su evidenze conflittuali.
- Astra a low — scrittura concisa e adattamento contenuti che preservano fatti e sfumature.
- Astra a medium — progetti ambiziosi che richiedono contesto ampio, interazioni affidabili e risultati completi.
- Astra a extra high — analisi impegnative e deliverable complessi con requisiti precisi.
- Luna a low — modifiche dettagliate, problem-solving ben delimitato e estrazione dati semplice.
- Luna a extra high — trovare contesto attuale tra più app, prioritizzare lavoro e risolvere problemi con vincoli chiari.
La regola pratica dalla guida Codex di OpenAI: usa Sol per lavoro ripetuto e lungo su codice, app e documenti quando conta il costo. Tieni Astra per i compiti più impegnativi. Usa Luna per compiti chiari e ripetibili.
Come chiamare GPT-6.1 Sol tramite Felo API Platform
Felo API Platform espone GPT-6.1 Sol tramite endpoint compatibili, così puoi mantenere il tuo SDK e cambiare solo la base URL.
Il modello è disponibile su:
- Chat Completions:
POST https://openapi.felo.ai/api/v1/chat/completions - Responses:
POST https://openapi.felo.ai/api/v1/responses - Messages (compatibile Anthropic):
POST https://openapi.felo.ai/api/v1/messages
Passo 1: Ottieni una chiave API
Crea una chiave dal tuo account Felo API Platform ed esportala:
export FELO_API_KEY="YOUR_API_KEY"
Passo 2: Invia la prima richiesta
curl https://openapi.felo.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "messages": [
      {"role": "user", "content": "Explain the tradeoff between reasoning effort and cost."}
    ]
  }'
Passo 3: Usa un SDK compatibile
Punta qualsiasi SDK compatibile OpenAI su https://openapi.felo.ai/api/v1. Per client stile Claude, usa la base URL compatibile Anthropic https://openapi.felo.ai/api.
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FELO_API_KEY,
  baseURL: "https://openapi.felo.ai/api/v1",
});

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  input: "Review this pull request for correctness, security, and missing tests.",
});

console.log(response.output_text);
Passo 4: Abilita lo streaming quando serve
Aggiungi stream: true per ricevere eventi server-sent mentre il modello lavora.
La pagina modello di Felo indica GPT-6.1 Sol a $2.00 per milione di token input e $10.00 per milione di token output, con prezzi di lancio che possono essere fino al 50% inferiori rispetto ai prezzi API ufficiali. Il costo finale dipende dal modello, mix input/output, uso della cache e piano attivo. Le letture cache vengono fatturate a metà del prezzo di GPT-6 Sol.
La piattaforma supporta anche ragionamento, strumenti, output JSON, streaming e visione per questo modello, e offre un Playground per testare prompt prima di scrivere codice.
Migliori casi d’uso per GPT-6.1 Sol
Le linee guida OpenAI puntano a progetti complessi dove conta il costo. Alcuni schemi concreti si distinguono.
Programmazione agentica su larga scala
Un agente di programmazione che legge un repository, propone modifiche, esegue test e itera rappresenta il carico ideale per Sol. La finestra di contesto da 1,05M contiene grandi codebase, lo sconto sulle letture cache premia il riuso del contesto repository, e la chiamata strumenti asincrona mantiene l’agente produttivo mentre i test girano.
La guida Codex di OpenAI consiglia Sol per lavoro ripetuto e lungo su codice e app quando conta il costo, e riserva Astra per i compiti più impegnativi.
Uso del computer e automazione workflow
GPT-6.1 Sol supporta tutti gli strumenti Responses, inclusi computer_use, hosted_shell, apply_patch, mcp e tool_search. Questo lo rende adatto per agenti che operano software, compilano moduli, trasferiscono dati tra sistemi o automatizzano processi aziendali multi-step.
La pagina modello di Felo indica uso del computer e automazione workflow multi-step come casi d’uso principali.
Lavoro professionale ricco di documenti
Sol accetta testo e immagini, coprendo documenti scannerizzati, grafici, screenshot e slide. La guida di selezione modello OpenAI offre due esempi: costruire una presentazione per il consiglio da risultati finanziari, e costruire un sito web da un brief prodotto. Entrambi richiedono input grandi, revisioni multiple e una qualità che supera "economico e veloce" ma non raggiunge "massimo possibile".
Ricerca e analisi con flussi paralleli
Con multi-agent beta attivo, Sol può dividere un compito di ricerca in flussi indipendenti, eseguirli in parallelo e riconciliare i risultati. Confrontare proposte fornitori, revisionare una pull request da tre prospettive o indagare diverse ipotesi di errore risultano adatti.
Elaborazione batch ad alto volume
Batch e Flex dimezzano il prezzo di Sol a $1 input e $5 output per milione di token. Per elaborazione documenti notturna, sintesi bulk o estrazione su larga scala dove l’output sarà revisionato, questo prezzo cambia ciò che risulta economicamente fattibile.
Checklist migrazione: passare da GPT-6 Sol a GPT-6.1 Sol
OpenAI consiglia di consultare la guida migrazione prima di passare da gpt-6-sol a gpt-6.1-sol. Ecco la versione breve.
- Imposta il model ID. Cambia
modelingpt-6.1-sol. - Correggi il livello di ragionamento. GPT-6.1 Sol non supporta
noneominimal. Sostituiscinoneconlowe testa la migrazione diminimalpartendo dalow. - Sposta la chiamata strumenti su Responses. Chat Completions funziona per richieste senza strumenti. Qualsiasi chiamata funzione, ricerca web, ricerca file, uso computer o workflow MCP richiede l’API Responses.
- Rimuovi parametri non supportati. Quando il livello di ragionamento non è
none, eliminatemperature,top_petop_logprobs. In Chat Completions, elimina anchelogprobs. In Responses, eliminamessage.output_text.logprobsdainclude. - Aggiorna la configurazione cache prompt. Se migri da GPT-5.5 o precedente, sostituisci
prompt_cache_retentionconprompt_cache_options.ttlimpostato su"30m". - Usa
configuration_updateper cambiare ragionamento. Se l’app regola il livello tra i turni, usa elementiconfiguration_updateinvece di cambiare ilreasoning.efforta livello di richiesta, così il prefisso prompt resta cacheabile. - Controlla la residenza dati. GPT-6.1 Sol supporta residenza dati USA e UE. Fast mode non è disponibile con residenza dati UE.
- Testa contro Astra. Esegui entrambi i modelli su compiti rappresentativi e confronta qualità, latenza e costo totale — inclusi i token di ragionamento, che vengono fatturati come token output.
Limitazioni e disponibilità
GPT-6.1 Sol non sostituisce Astra ovunque e non è disponibile dappertutto.
Limiti di capacità. OpenAI posiziona Sol sotto Astra. Per ragionamento più impegnativo e deliverable di massima importanza, Astra resta il modello consigliato. Sol risulta conveniente per lavoro complesso, non per qualità massima.
Nessun fine-tuning. GPT-6.1 Sol non supporta fine-tuning o output predetti. Non supporta embedding, generazione immagini, video, voce, trascrizione, traduzione o endpoint moderazione. È un modello ragionamento testo-e-immagine-in, testo-out.
Nessun input audio o video. Le modalità input sono solo testo e immagine.
Il ragionamento non può essere disattivato. Gli sforzi none e minimal non sono supportati, quindi ogni richiesta include overhead di ragionamento.
Rollout ancora in corso. Il rollout di OpenAI include piani Plus, Pro, Business, Enterprise ed Edu in Codex su desktop e CLI, e ChatGPT Work su web e mobile. Per Enterprise ed Edu, il modello resta disattivato finché un amministratore lo abilita. I piani Free e Go non sono inclusi al lancio.
Fast mode ha caveat. Standard e Fast mode sono disponibili al lancio, ma Fast mode costa il doppio di Standard e non è disponibile con residenza dati UE. Il supporto Ultrafast per GPT-6.1 Sol arriverà dopo.
Si applicano limiti di rate. I limiti standard vanno da 500 RPM e 500.000 TPM su Tier 1 a 15.000 RPM e 40.000.000 TPM su Tier 5.
FAQ
Cos’è GPT-6.1 Sol?
GPT-6.1 Sol è il modello GPT-6 equilibrato di OpenAI, posizionato tra il modello di punta GPT-6 Astra e il modello leggero GPT-6 Luna. OpenAI lo descrive come capace di offrire prestazioni quasi Astra per programmazione complessa, uso del computer e lavoro professionale a un costo inferiore.
Quanto costa GPT-6.1 Sol?
OpenAI indica GPT-6.1 Sol a $2 per milione di token input e $10 per milione di token output. L’input cache costa $0.10 per milione di token, la scrittura cache costa $2.50 per milione di token. Prompt sopra 272K token input vengono fatturati a tariffe long-context più alte.
Qual è la finestra di contesto di GPT-6.1 Sol?
GPT-6.1 Sol ha una finestra di contesto da 1.050.000 token, un massimo di 922.000 token input e un massimo di 128.000 token output.
GPT-6.1 Sol supporta la chiamata strumenti?
Sì, ma la chiamata strumenti richiede l’API Responses. Chat Completions è supportato per richieste senza strumenti.
Posso disattivare il ragionamento su GPT-6.1 Sol?
No. GPT-6.1 Sol supporta livelli di ragionamento low, medium, high, xhigh e max. Non supporta none o minimal.
Come si confronta GPT-6.1 Sol con GPT-6 Sol?
GPT-6.1 Sol rappresenta un upgrade di GPT-6 Sol con meno errori fattuali e maggiore rispetto delle restrizioni esplicite, secondo la pagina modello di Felo. Entrambi hanno lo stesso prezzo token principale, ma GPT-6.1 Sol dimezza il prezzo dell’input cache a $0.10 per milione di token.
GPT-6.1 Sol è disponibile su Felo API Platform?
Sì. Felo API Platform espone GPT-6.1 Sol tramite endpoint Chat Completions, Responses e Messages compatibili Anthropic. Il prezzo di lancio può essere fino al 50% inferiore rispetto ai prezzi API ufficiali, e le letture cache vengono fatturate a metà del prezzo di GPT-6 Sol.
Conclusioni
GPT-6.1 Sol risponde a un problema pratico: il modello migliore risulta spesso troppo costoso per ogni compito, e il modello più economico spesso non basta. Sol trova il compromesso con capacità quasi Astra, finestra di contesto da 1,05M, prezzo lettura cache al 5%, e un costo pari a un quinto di Astra.
Per team che costruiscono agenti di programmazione, workflow di uso computer e automazione ricca di documenti, risulta il modello da testare per primo. Confrontalo con Astra sulle tue attività, osserva l’uso dei token di ragionamento e lascia che il compromesso costo-qualità decida.
Puoi provare GPT-6.1 Sol nel Playground Felo API Platform o chiamarlo direttamente con una chiave API Felo.
Fonti
- Pagina modello GPT-6.1 Sol — OpenAI
- Usare GPT-6 — OpenAI
- Selezione modello — OpenAI
- Prezzi API — OpenAI
- Disponibilità modelli Codex e ChatGPT — OpenAI
- Chiamata strumenti asincrona — OpenAI
- Steering a metà turno — OpenAI
- Modelli di ragionamento — OpenAI
- Prompt caching — OpenAI
- Compattazione — OpenAI
- Multi-agent — OpenAI
- Modalità WebSocket — OpenAI
- Fast mode — OpenAI
- Residenza dati — OpenAI
- GPT-6.1 Sol — Felo API Platform
Questo articolo è disponibile anche in English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, ไทย, Español, বাংলা and Português.