2027年の最強AIアンサ―エンジン:14のオンライン検索ツール&17のエージェント検索API
データに基づく2027年版ガイド:人間向けオンラインAI検索ツール14種とClaude Code、Codex CLI、OpenClaw用検索API17種、計31の最強AIアンサ―エンジンを徹底比較。
2025年にAIアンサ―エンジンのまとめ記事を公開したとき、目的は明確だった。10件のウェブページを読んで、幻覚なしで要約できるツールを探すこと。2年経った今、「チャットボックスで質問に答える」だけでは足りない。2025年の初期人気ツール(Phindなど)は、市場の成熟とともに撤退や方向転換を選んだ。
2027年、検索は2つの明確な流れに分かれている。
一方では、人間のリサーチャーがオンラインAIアンサ―エンジンを使う。これらはウェブを要約するだけでなく、言語の壁を越え、査読論文を検証し、調査結果をスライドや共同レポートに変換する。もう一方では、自律型AIエージェント(Claude Code、Codex CLI、pi coding agent、OpenClaw、Hermes Agentなど)がインターネット検索の最大利用者となった。エージェントは煩雑なブラウザUIやCAPTCHAを扱えない。高速でトークン効率の良いJSON、全ページMarkdown抽出、MCP対応ツールエンドポイントが必要だ。
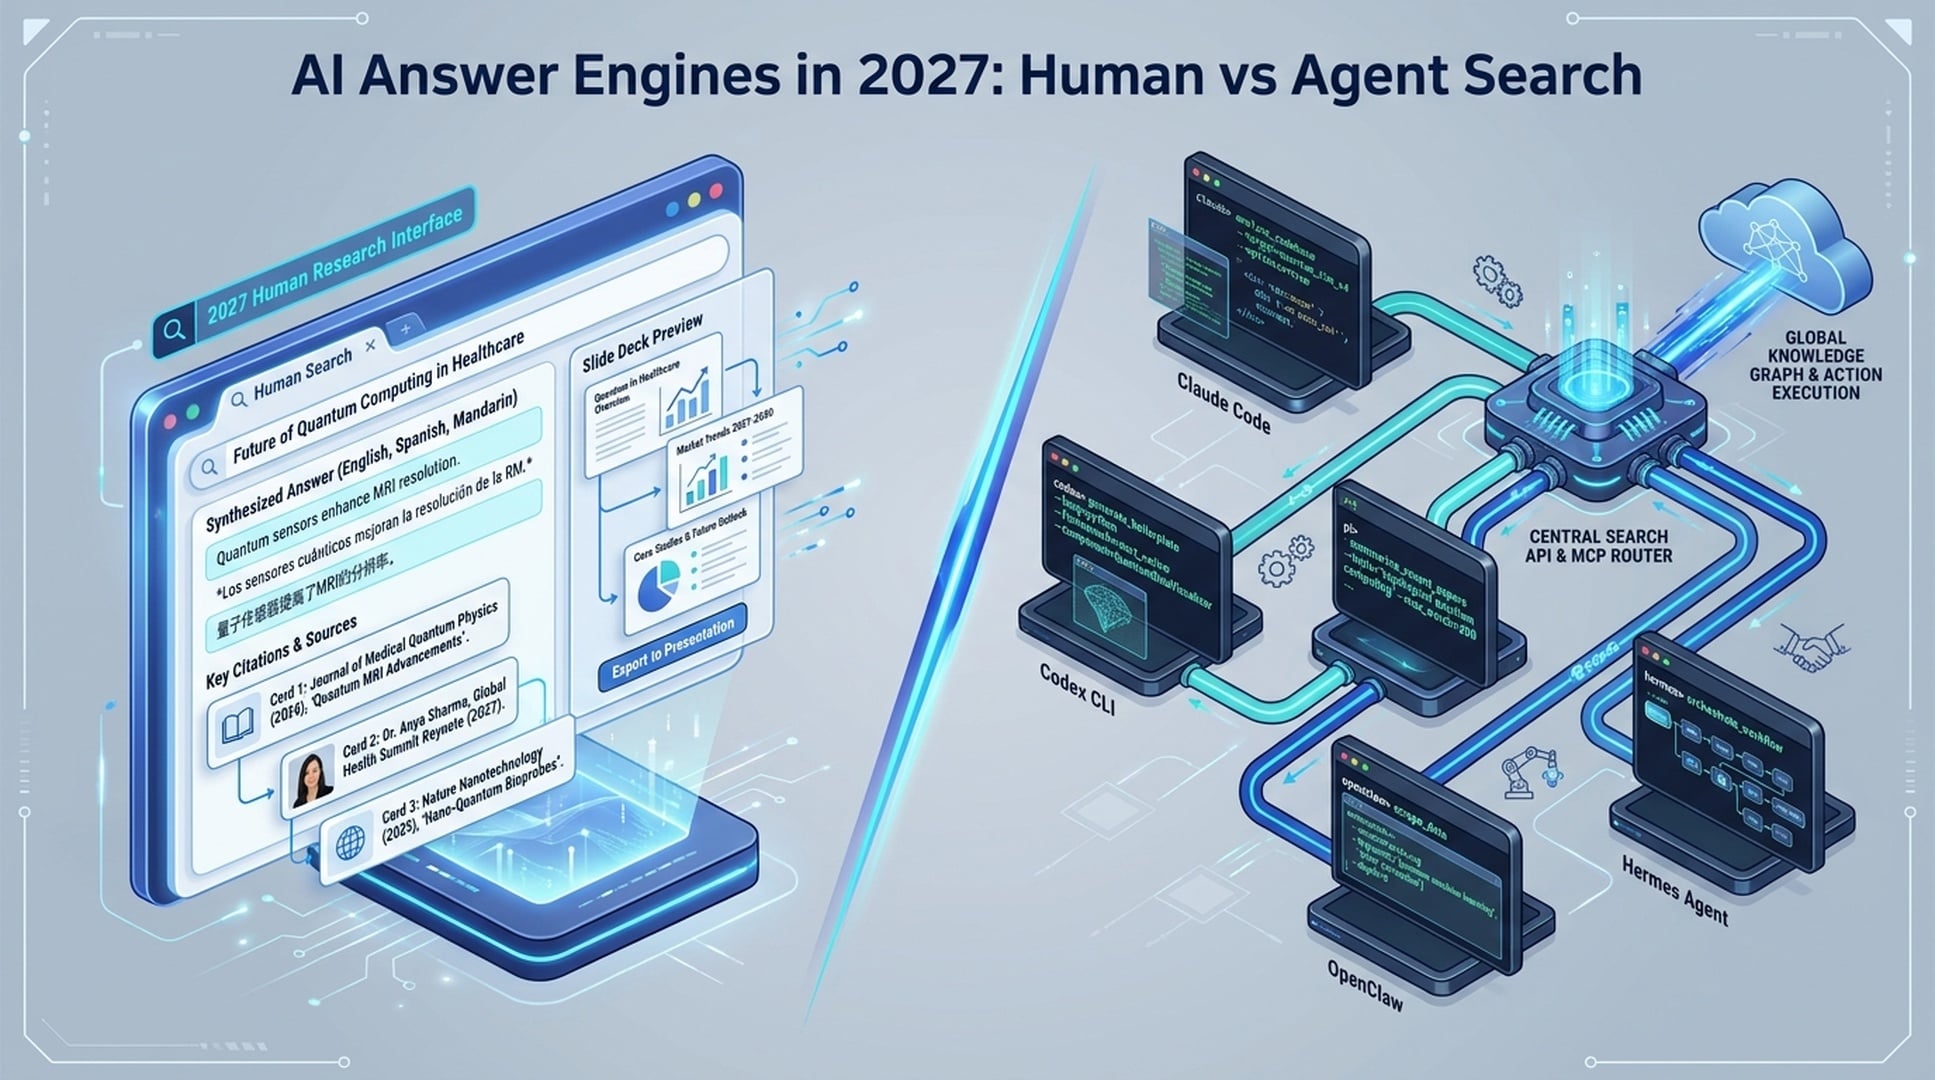
この2027年版ガイドが実際に人間と開発者が使っているものを反映するため、Ahrefsのオーガニック検索&ブランド需要データ(米国+グローバル)と、ライブのX(Twitter)開発者導入ベンチマークを組み合わせた。パート1では人間向けオンラインAIアンサ―エンジン14種を、パート2ではAIエージェント向け検索エンジンサービス&API17種を比較する。
パート1:人間向けオンラインAIアンサ―エンジン14選(ウェブ・学術・プライバシー)
キーボードに座って市場調査や医学・科学的主張の検証、ベンダー比較を行うなら、出典を明示し、ライブのコミュニティ議論を引き出し、生の事実から成果物まで導くアンサ―エンジンが必要だ。
1. Felo AI Search:多言語深堀りリサーチ&即時成果物化に最適
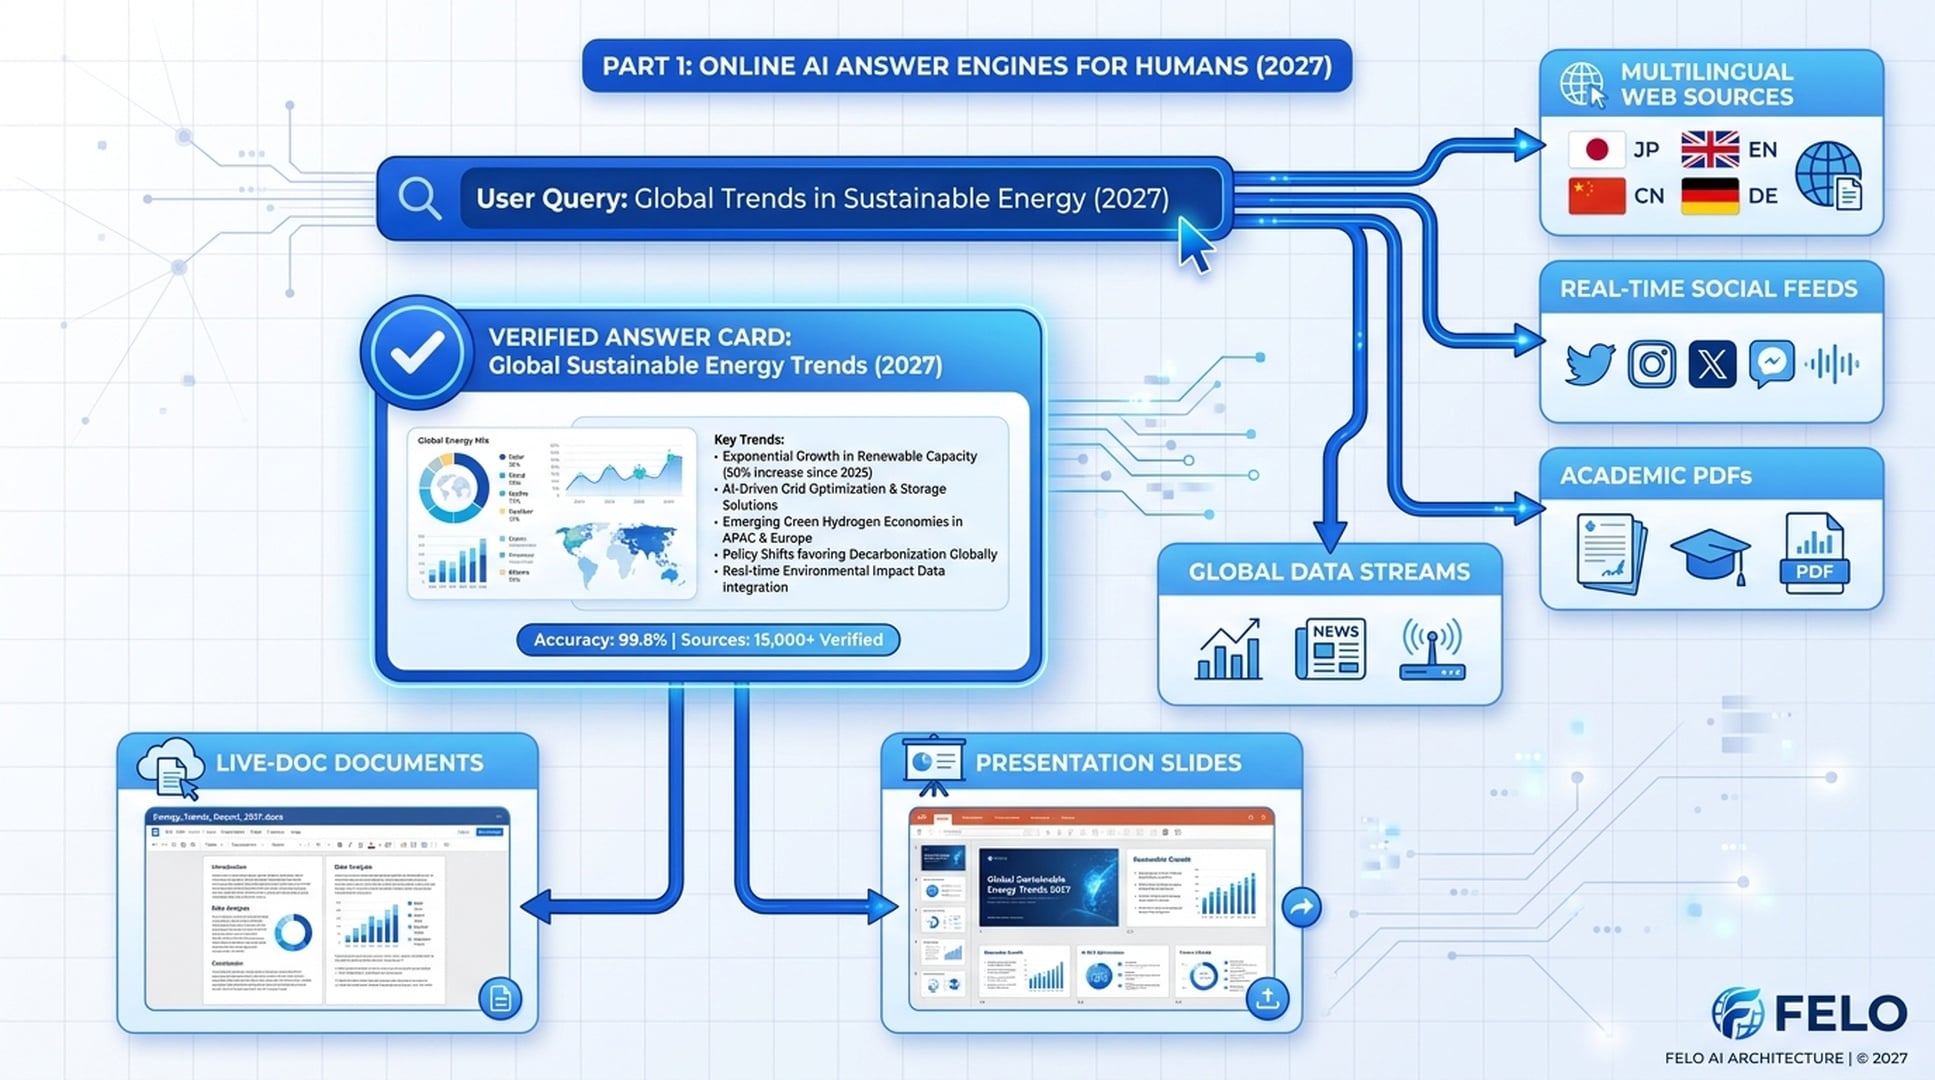
多くのAIアンサ―エンジンは英語だけのエコーチェンバーに閉じ込める。答えを得ても、Google DocsやPowerPointにコピペしないと実用的な作業ができない。東京発でグローバル展開する**Felo AI Search**は、両方の課題を一つのワークスペースで解決する。
母国語で質問すると、Feloのクロスランゲージ検索エンジンが日本語・英語・中国語・ドイツ語・韓国語など多数の言語の現地ソースを検索し、クリック可能な出典付きで母国語にまとめる。検索は最初のステップに過ぎない。FeloはFelo LiveDoc(共同AIドキュメントワークスペース)やFelo Slides(ワンクリックでプレゼン生成)と直結する。
主な特徴:
- クロスランゲージ深堀り検索: 一つの言語で質問し、世界中の現地語ソースから一次データや規制文書を引き出し、統一要約を読む。
- リアルタイムSNS・コミュニティ信号: Redditスレッド、X(Twitter)議論、YouTube字幕を伝統的ウェブページや学術PDFと並列でインデックス。
- 検索→成果物パイプライン: どんな調査スレッドもテーマ付きPowerPoint(Felo Slides)、マインドマップ、共有LiveDocレポートに変換できる。
- カスタムリサーチエージェント: Felo Agentで再利用可能な調査ワークフローを構築し、外部データをMCPサーバー経由で接続。
おすすめ対象: グローバルチーム、アナリスト、マーケター、学生。検証可能な答えをそのままプレゼンやドキュメントに変換したい人。
2. Perplexity AI:高速ファクトチェック&学術引用に最適
Perplexityは迅速で引用重視の検索の基準となっている。会話的な無駄を排除し、番号付き脚注、出典カード、素早い追跡質問を重視する。Pro SearchやDeep Researchモードでは複数ステップの検索を計画し、曖昧なプロンプトには補足質問を投げ、数十のソースから構造化ブリーフをまとめる。
主な特徴:
- インライン出典検証: すべての主張がクリック可能な出典カードに紐づき、元記事を即座に監査できる。
- フォーカスモード: 学術論文、SEC文書、Reddit議論、YouTube動画、WolframAlpha計算などに絞り込める。
- モデル柔軟性: 有料ユーザーはAnthropic、OpenAI、Perplexity独自Sonarモデルを切り替え可能。
おすすめ対象: ジャーナリスト、学術研究者、迅速な脚注付きファクトチェックが必要な人。
3. ChatGPT Search:会話型オールインワンアシスタント
OpenAIはリアルタイムウェブ検索をChatGPTのメインプロンプトバーに統合し、以前の「Bingでブラウズ」切り替えの煩わしさを解消した。ChatGPT Searchは、検索クエリが創造的・分析的セッションの中間ステップになる場面で活躍する。例えば、競合のライブ価格を取得し、そのままポジショニングメモやPython価格シミュレーションをCanvasで生成する場合など。
主な特徴:
- ゼロフリクション意図検出: 現在の出来事、ドキュメント更新、ライブ価格を尋ねると自動でウェブ検索を発動し、推論タスクでは会話モードを維持する。
- 深堀りリサーチエージェント: 5~20分かけて数百ページを自律的に閲覧し、アナリスト級レポートをまとめる。
- Canvas&コードインタープリタ統合: ライブ検索結果をPythonデータ可視化や並列ドキュメント編集に直接流し込む。
おすすめ対象: ChatGPTで執筆・コーディング・ブレインストーミングを日常的に行う知識労働者。
4. Google Gemini&Google AI Mode:Google Workspaceユーザー向け
Googleのアンサ―エンジン戦略は2軸で展開されている。従来検索内のGoogle AI Modeと、Googleのマルチモーダルモデル群による独立アプリGemini。従来の検索結果ページはオーガニックリンクと広告をバランスさせるが、AI ModeはGoogleの巨大リアルタイムインデックス、Google Mapsデータ、YouTube動画カタログを背景にした会話型キャンバスを提供する。
主な特徴:
- ネイティブWorkspace連携: ライブウェブ回答を自分のGmailスレッド、Google Docs、Drive PDF、Google Sheetsとクロスリファレンス。
- 圧倒的ローカル&コマースグラフ: リアルタイム店舗在庫、航空券価格、Google Mapsレビューを取得。
- マルチモーダル理解: 長尺動画、音声録音、500ページPDFをプロンプトに投入し、Googleのライブインデックスで主張を検証。
おすすめ対象: Google Workspace標準化チーム、ローカル・ショッピング・YouTubeデータ重視ユーザー。
5. Microsoft Copilot Search:企業向けM365環境に最適
Microsoft 365運用企業では、Microsoft CopilotがBingインデックスによる公開ウェブ検索とMicrosoft Graphによる社内知識を橋渡しする。外部アンサ―エンジンと社内イントラネットを切り替える必要がなく、Copilotは業界ニュースと社内SharePoint資料、Teamsチャット、Outlookメールを組み合わせて回答する。
主な特徴:
- 企業データ保護: 商用クエリは公開モデルの学習に使われず、社内権限はMicrosoft Graphで厳格に管理される。
- Officeアプリ内連携: Word、Excel、PowerPointにウェブ調査結果を直接取り込める。
おすすめ対象: Microsoft 365、SharePoint、Teamsに深く組み込まれた企業チーム。
6. Brave Search(Answer with AI):独立系プライバシーインデックス
月間1.94百万グローバル検索(Ahrefsでbrave search)を誇るBraveは、プライバシー重視検索の絶対王者。GoogleやBingの結果を裏で借りるメタ検索と違い、**Brave Search**は独自インデックス(300億ページ超)を運用。Answer with AIエンジンは即答、比較表、フォーラム洞察を合成し、ユーザーデータや追跡広告を一切収集しない。
おすすめ対象: Google・Microsoft二強外の独立検索インデックスを求めるプライバシー重視ユーザー。
7. Grok Search(xAI):リアルタイムX(Twitter)パルス&速報ニュース
月間8.03百万グローバル検索(米国だけで2.07百万)、Grok(xAI)は、クラウド障害や地政学的事件、オープンソースモデルリリースなど、5分前の出来事を追いたいユーザーが集まる場所。従来ウェブクローラーは速報に遅れるが、Grokはリアルタイム**X(Twitter)**ファイアホースとライブウェブ検索を直結し、開発者の感情やライブニュースを最速で把握できる。
おすすめ対象: 速報ニュース、暗号/市場感情、X上のリアルタイム開発者反応追跡。
8. Consensus:査読済み科学論文特化AIアンサ―エンジン
一般的なウェブアンサ―エンジンは、査読臨床試験とSEOブログ記事を混在させる。2億本超の学術論文を背景に、月間135,000グローバルブランド検索(Ahrefsでconsensus ai, DR 80)、Consensusは回答を公開科学文献に限定。独自のConsensus Meterが、科学コミュニティの合意(「Yes」「No」「Possibly」)を視覚的に示す。
おすすめ対象: 医師、臨床家、博士課程学生、科学ライター。査読引用のみ信頼する人。
9. Elicit:体系的文献レビュー&データ抽出表に最適
月間143,000グローバル検索(米国48,000、DR 76)、**Elicit**は単一質問型学術Q&Aより深く掘り下げる。研究質問を投げると、関連論文を見つけ、構造化抽出マトリックスを生成。PDFからサンプルサイズ、方法論、介入タイプ、主要結果を自動抽出し、ソート可能な表にまとめる。
おすすめ対象: R&Dチーム、バイオテックアナリスト、体系的文献レビューを行う学術者。
10. Liner AI:学生&学術ハイライト用リサーチコパイロット
月間14,000ブランド検索(Ahrefsでliner ai)、米国・アジアの大学で大規模導入。**Liner**は学術グレードAIアンサ―エンジンとウェブ/PDFハイライター、執筆ワークスペースを組み合わせる。Linerの回答内の各文は、出典論文やウェブページの該当ハイライト箇所に直リンクし、引用収集や参考文献作成が容易。
おすすめ対象: 大学生、大学院研究者、長文エッセイ執筆者。
11. Kagi Search:パワーユーザー&エンジニア向け広告なしプレミアム検索
Hacker Newsや開発者Xスレッドで**Kagi Search(DR 79、月間7,100検索)は熱狂的支持を得ている。理由はシンプル。月額課金で広告ゼロ、テレメトリゼロ、SEOスパムゼロ**。信頼ドメイン(GitHubやMDNなど)をピン留めし、コンテンツファームを完全ブロック、Quick AnswerAI合成やKagi Assistantを基盤モデル選択付きで発動できる。
おすすめ対象: カスタマイズ可能でスパムなしウェブインデックスを求めるソフトウェアエンジニア&パワー検索者。
12. iAsk.Ai:無料・大量質問&宿題回答エンジン
2025年初回まとめでも紹介した**iAsk.Ai**は2027年も巨大トラフィックを維持。月間216,000米国オーガニック訪問(Ahrefs, DR 70)、月間18,000ブランド検索。ログイン不要の高速インターフェースで、事実・学術・宿題質問を投げ、一般ウェブ検索・学術モード・即時ドキュメント要約を切り替えられる。
おすすめ対象: 学生やカジュアルユーザー。速くて無料、登録不要のアンサ―エンジンを求める人。
13. DuckDuckGo(Duck.ai&AI-Assisted Search):匿名日常検索
月間42,000グローバル検索(Ahrefsでduckduckgo ai、DuckDuckGo本体は数千万ユーザー)。DuckDuckGoはプライバシー重視ユーザーに2つのAI利用方法を提供。検索結果上部のAI-Assisted Search要約(いつでもオフ可能)、Duck.aiはOpenAI、Anthropic、Meta、Mistralのモデルと匿名チャット(IPアドレス除去)できる。
おすすめ対象: オプションAI回答とプライベートチャットをアカウント不要で使いたい日常ユーザー。
14. You.com(ARI&カスタムリサーチエージェント):企業金融&多段階リサーチ向け
月間25,000グローバルブランド検索(Ahrefsでyou.com, DR 79)、**You.com**は消費者向けメタ検索から企業リサーチプラットフォームへ進化。**ARI(Advanced Research & Insights)**エンジンで数百の一次ソースを同時に読み、金融サービス、コンサル、企業チームで活用。AIワークフロー用Web検索APIも提供。
おすすめ対象: カスタム・多ソースリサーチワークフローを構築する金融アナリスト&企業チーム。
クイック比較:オンラインAIアンサ―エンジン14選(2027年データ)
| # | エンジン | 主な強み | Ahrefs需要/フットプリント | 内蔵成果物 |
|---|---|---|---|---|
| 1 | Felo AI Search | クロスランゲージ深堀り+ワンクリックSlides&LiveDoc | DR 63・米国66.5Kオーガニック・多言語グローバル展開 | ✅ Felo Slides(PPT)、LiveDoc、マインドマップ |
| 2 | Perplexity AI | 高速脚注ファクトチェック&Pro Search | DR 91・グローバル3.08Mブランドボリューム | Pages(テキストレポート) |
| 3 | ChatGPT Search | 統合チャット・コーディング・深堀りリサーチ | 100M+アクティブユーザー・OpenAI検索ネイティブ | Canvas(テキスト&コード) |
| 4 | Google Gemini / AI Mode | Google Workspace+Maps・ショッピング・YouTube | グローバル174Kボリューム(google ai mode) | Google Docs/Slidesへエクスポート |
| 5 | Microsoft Copilot | 企業Microsoft 365 Graph+Bing | Windows&M365 Enterprise内蔵 | Word/Excel/PPTへエクスポート |
| 6 | Brave Search AI | 独立30B+ページインデックス&追跡ゼロ | グローバル1.94Mボリューム(brave search) | 回答カード&テーブル |
| 7 | Grok Search (xAI) | ライブX(Twitter)ファイアホース+速報 | グローバル8.03Mボリューム(grok) | スレッド&投稿合成 |
| 8 | Consensus | 査読科学合意メーター | DR 80・グローバル135Kボリューム(consensus ai) | 引用リスト&研究スナップショット |
| 9 | Elicit | 体系的文献レビュー&データ表 | DR 76・グローバル143Kボリューム(elicit) | 複数論文抽出マトリックス |
| 10 | Liner AI | パッセージ単位学術ハイライト&引用 | グローバル14Kボリューム(liner ai) | エッセイ&参考文献ドラフト |
| 11 | Kagi Search | 有料・広告ゼロ・エンジニア向けカスタマイズ | DR 79・グローバル7.1Kボリューム(kagi search) | クリーン要約&ドメインランキング |
| 12 | iAsk.Ai | 無料・高速Q&A&宿題回答 | DR 70・米国216Kオーガニックトラフィック | 即時テキスト要約 |
| 13 | DuckDuckGo AI | 匿名AIアシスト検索&Duck.ai | グローバル42Kボリューム(duckduckgo ai) | プライベート回答スニペット |
| 14 | You.com | 企業ARI深堀りリサーチ&カスタムエージェント | DR 79・グローバル25Kボリューム(you.com) | 深堀りリサーチレポート |
パート2:AIエージェント向け検索エンジンサービス&API17選(2027年)
ブラウザタブから自律エージェントに移ると、検索のルールは根本的に変わる。
現在人気のエージェントハーネス(Claude Code、Codex CLI、pi coding agent、OpenClaw、Hermes Agent)は、1タスクループ内で多数のツールコールを実行する。従来型スクレイパーの生HTMLをコーディングやリサーチエージェントに渡すと、ナビゲーションメニューやクッキーバナー、インラインJavaScriptでコンテキストウィンドウが溢れ、無駄なトークン消費でコストが膨らむ。
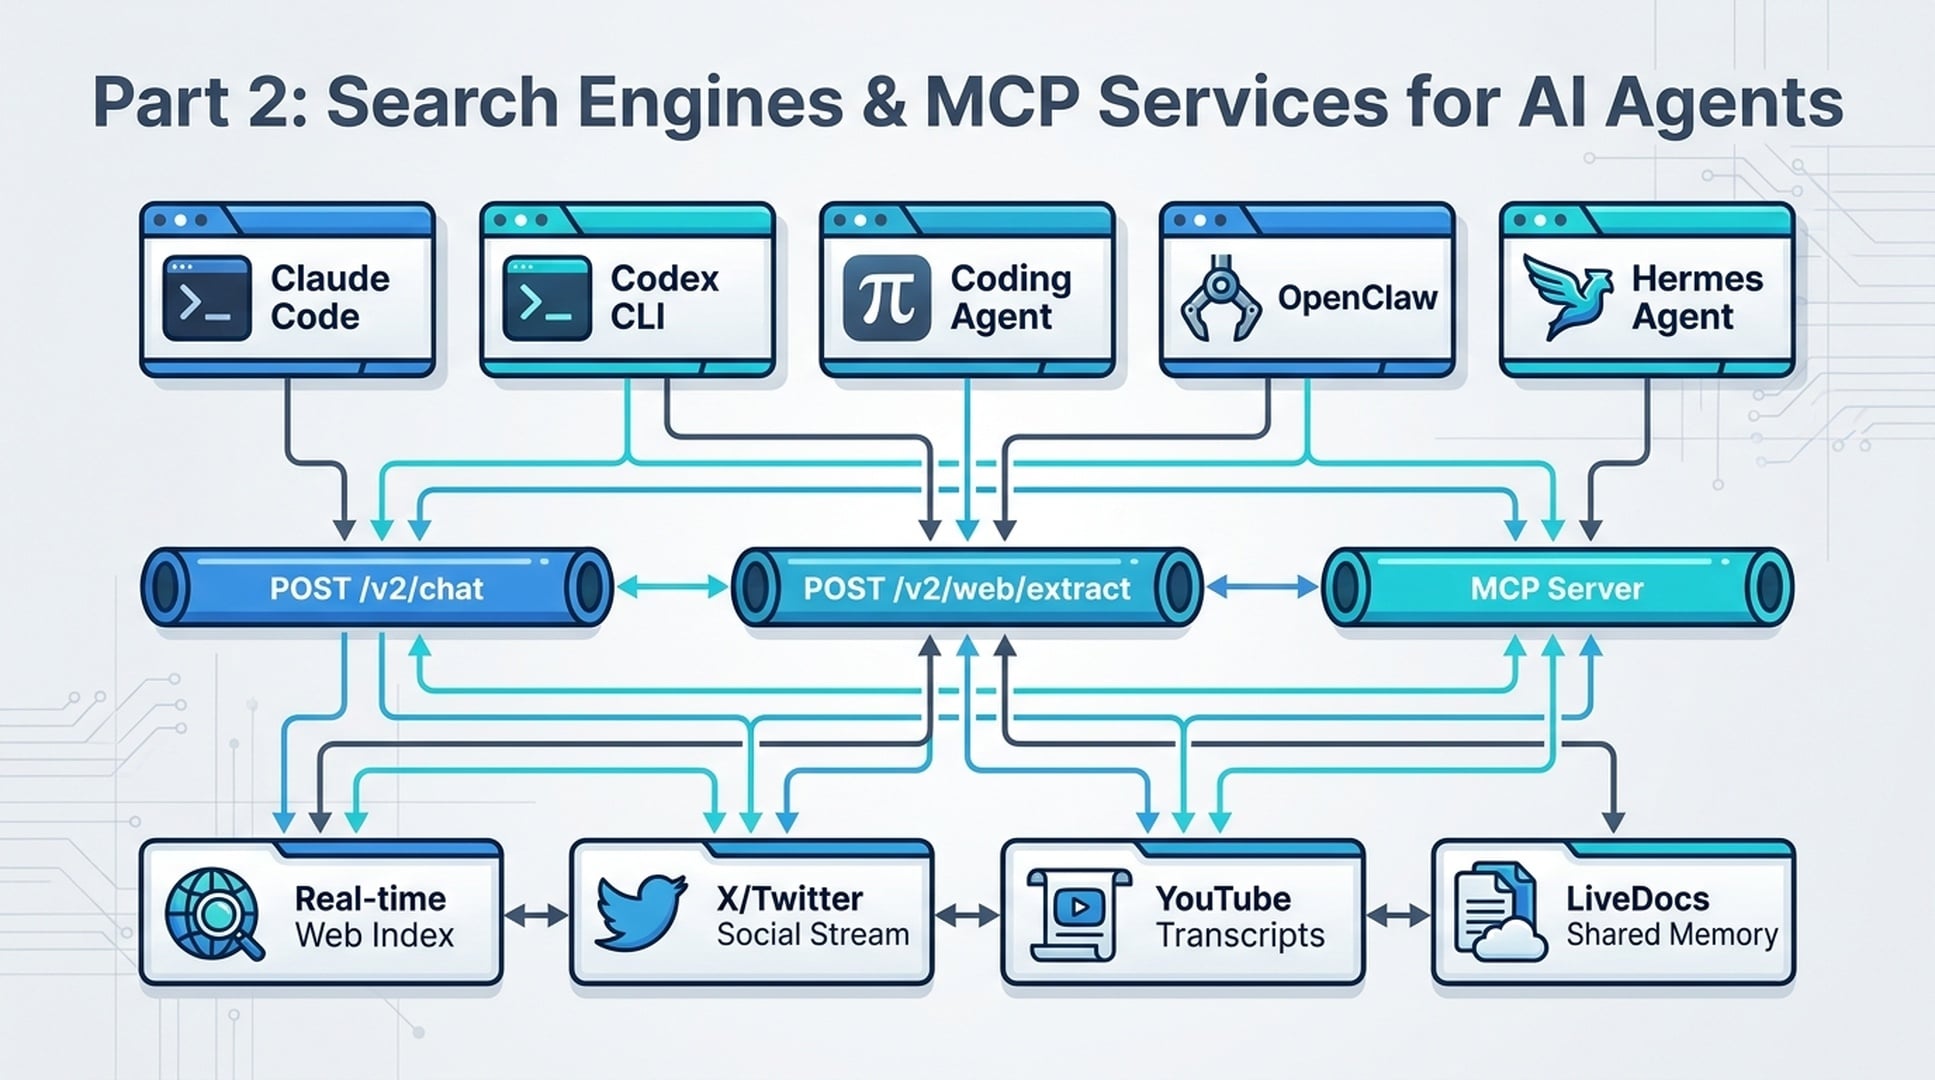
開発者が2027年に選ぶエージェント検索(X&Ahrefsデータ)
Ahrefs検索ボリュームとX(Twitter)ライブ開発者ベンチマークに基づき、2027年のエージェント検索は4つの明確なレイヤーに分かれる:
- 統合エージェントツール&成果物スタック(Felo OpenAPI、Anthropic Web Search API、OpenAI Web Search API):検索+Web取得+X/YouTube+LiveDocsメモリ+PPT/Page出力を1APIキーで完結。
- エージェントネイティブ検索&グラウンディングAPI(Tavily、Exa、Parallel Web Systems、Brave Search API、Perplexity Sonar、Linkup、DeepSeek Search & Fetch):LLM向けチャンク・ハイライト・グラウンディング回答を$0.75~$8/1,000コールで提供。
- Markdown抽出&エージェントクローラー(Firecrawl、Jina Reader、Crawl4AI):複雑なJS重文書サイトをクリーンMarkdown化。
- 生SERP&企業Webインフラ(SerpApi、Serper.dev、Apify、Bright Data):大量Google SERP JSON、プロキシ解除、MCPスクレイピングアクター。
2027年のAIエージェント向け検索エンジンサービス17選を、公式インターフェースと実際の開発者選択肢とともに紹介する。
1. Felo OpenAPI&MCP検索スタック:エージェント向け検索・抽出・SNS・成果物統合レイヤー
多くの検索APIは10件スニペットを返した時点で止まる。Felo OpenAPIは、Claude Code、Codex CLI、pi、OpenClaw、Hermes Agentなどのエージェントハーネス向けに設計。検索・読取・記憶・成果物生成を1APIキー&1ベースURLで完結。
Tavily検索、Jinaページ読取、Twitterスクレイパー、スライド生成を個別に組み合わせる必要がなく、Feloは多層エージェント検索&ツールスタックを提供:
- AI検索(
POST /v2/chat): 会話型リアルタイムアンサ―エンジンAPI。合成回答と最適化クエリ分析を返し、エージェント推論に即投入可能。 - Web取得/抽出(
POST /v2/web/extract): 任意URLからクリーン構造化コンテンツを抽出。一次ドキュメント検証時にコンテキスト肥大化を防ぐ。 - X(Twitter)検索(
POST /v2/x/tweet/search&/v2/x/user/tweets): ライブ開発者議論、製品ローンチ、社会感情を直接取得。 - YouTube字幕(
GET /v2/youtube/subtitling): 動画全トランスクリプトを取得し、カンファレンスやチュートリアルから洞察抽出。 - LiveDocsメモリ&成果物API(
POST /v2/ppts,/v2/mindmap,/v2/landing_page): 調査結果を共有セマンティックメモリ(LiveDocs)に保存し、PowerPointやランディングページ化。最先端LLM(Claude, GPT, Grok)もOpenAI/Anthropic互換エンドポイントで呼び出せる。
エージェント開発者が選ぶ理由:
- Claude Code、Codex CLI、OpenClaw、pi、Hermes Agent用セットアップガイド&スキル完備。
- 4~5個のAPIサブスクリプションを1つの統合キー(
openapi.felo.ai)で置き換え。
2. Anthropic Web Search API(Felo OpenAPI経由):Claudeグラウンディング引用検索
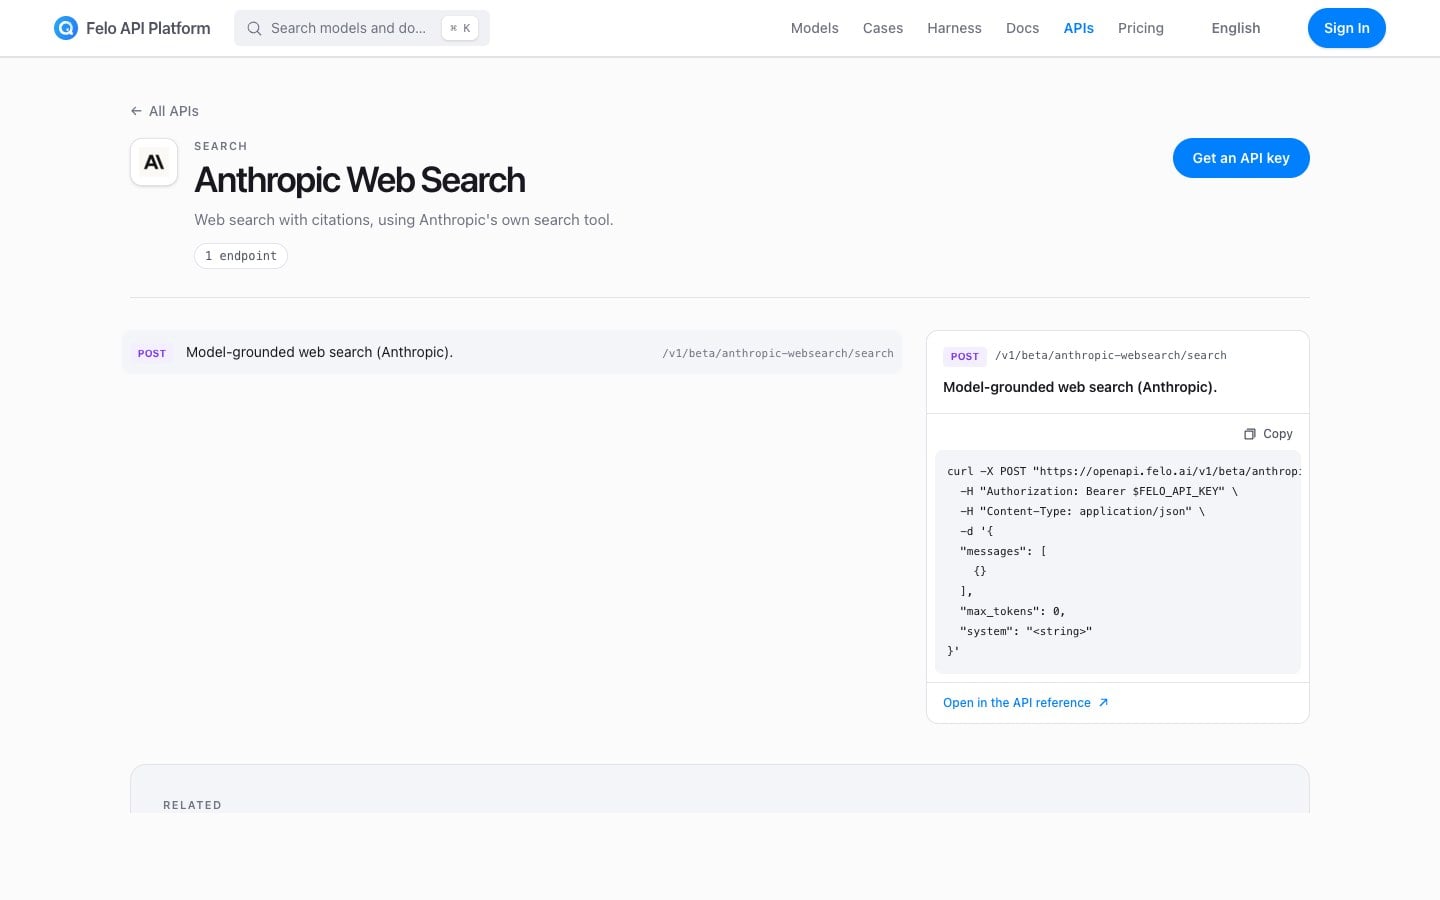
Claude Codeやpi、Anthropicツールループ構築開発者は、AnthropicのネイティブモデルグラウンディングWeb検索+インライン引用を求めるが、別途Anthropicアカウントや地域課金、ベンダーキー管理が煩雑。Anthropic Web Search on Felo OpenAPI(POST /v1/beta/anthropic-websearch/search)なら、既存の$FELO_API_KEYで直接Anthropic検索ツールを呼び出せる。
強み:
- ClaudeグラウンディングWeb検索+構造化引用を単一エンドポイント(
https://openapi.felo.ai/v1/beta/anthropic-websearch/search)で提供。 - ベンダーアカウント不要: 標準
messages、max_tokens、systemパラメータをFelo課金で利用。
制限: Claudeグラウンディング検索合成に特化。生ページ抽出やSNSフィードが必要な場合はFeloの/v2/web/extractや/v2/x/tweet/searchと組み合わせる。
3. OpenAI Web Search API(Felo OpenAPI経由):Codex&Responsesワークフロー向けOpenAIモデルグラウンディング検索
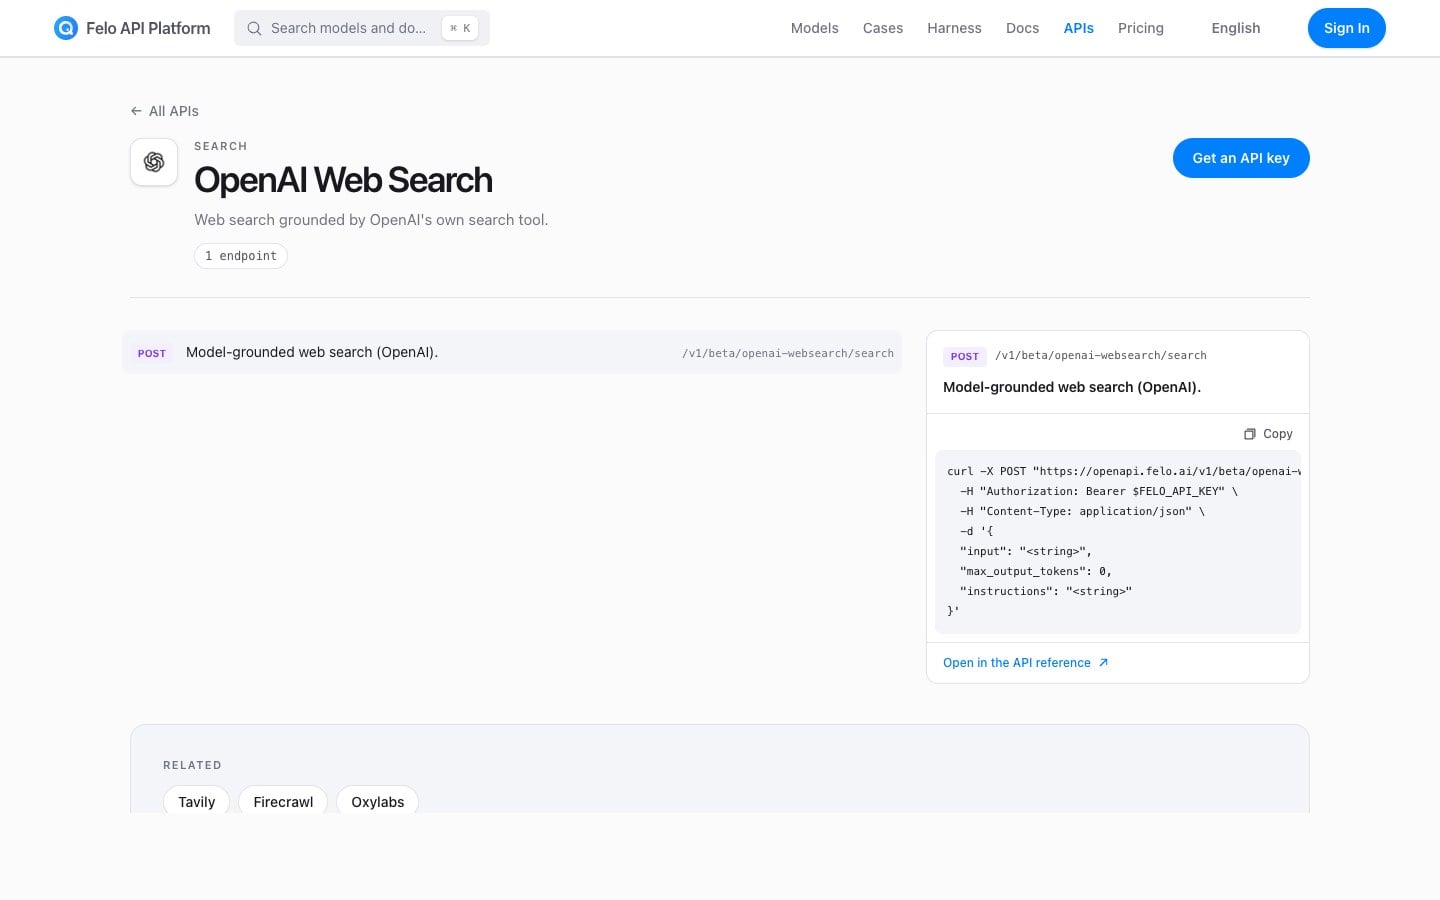
エージェントがOpenAIのResponses型スキーマ(input、instructions、max_output_tokens)やCodex CLIで動作する場合、OpenAI Web Search on Felo OpenAPI(POST /v1/beta/openai-websearch/search)でOpenAI検索ツールによるグラウンディング検索を直接利用できる。OpenAIベンダーアカウント不要。
強み:
- OpenAIネイティブ検索グラウンディングツール(
https://openapi.felo.ai/v1/beta/openai-websearch/search)利用。 - Codex CLIやマルチモデルエージェントでAnthropic/OpenAI両検索を1つの
$FELO_API_KEYで統合。
制限: モデルグラウンディング検索回答に特化。複数ページサイトクロールには不向き。
4. Tavily Search API:LangChain&LangGraph向けRAG検索特化
月間32,000グローバル検索(tavily, DR 79, Ahrefsで$4.50 CPC)、**Tavily**はLLMエージェント向けAPIの先駆け。LangChainやLangGraphテンプレートのデフォルト推奨。1APIコールで複数ソース検索、エージェントプロンプトと関連性スコア付与、簡潔チャンク+短答を返す。
強み:
- クリーンな
search&extractエンドポイント、検索深度調整(basic/advanced)。 - LangChain、LlamaIndex、CrewAIと深く統合。
制限: Web検索・抽出に特化。SNS/X検索、YouTube字幕抽出、永続ワークスペースメモリ、成果物生成は非対応。
5. Exa(旧Metaphor):技術発見向けニューラル&セマンティック検索
月間23,100米国オーガニック訪問、グローバル16,000ブランド検索(exa ai, DR 79)、**Exa**は意味とリンク構造によるニューラル検索を採用。X上でエージェント開発者は「初期段階RustベクトルDB」や「KVキャッシュ圧縮論文ベンチマーク」など、キーワード一致が効かない探索でExaを高評価。
強み:
- ニューラル検索+カテゴリフィルタ(論文、GitHubリポジトリ、企業ページ、ニュース、ツイート、人)。
- トークン効率の良いハイライトモード、pi coding agentやClaude Codeで広く使われるMCPサーバー。
制限: 完全一致ナビゲーションや多形式オフィス成果物ワークフローには不向き。
6. Parallel Web Systems(parallel.ai):深堀りリサーチエージェント向け高速検索&抽出
2026~2027年Xで最注目のエージェントインフラ(DR 77、米国月間18,000オーガニック訪問、グローバル6,800検索parallel web systems)、**Parallel**はAIエージェント専用にゼロから検索・抽出エンジンを構築。Xで共有された独立ベンチマークでは、精度・レイテンシ・コスト(約$1/1,000ページ読取)でパレート最適。専用Search、Extract、Deep Research Task API+公式Parallel MCPサーバーを提供。
強み:
- 人間キーワード検索ではなく宣言的エージェント目的に特化。
- サブ秒レイテンシでリアルタイム音声/チャットエージェント対応、非同期深堀りにもスケール。
制限: ウェブインテリジェンス特化。スライド/ドキュメント生成やマルチプロバイダーLLMチャットルーティングは非対応。
7. Brave Search API(LLM Context対応):大量エージェントクエリ向け独立ウェブインデックス
月間30,000グローバル検索(brave search api)、**Brave Search API**はGoogle/Bingレート制限なしで大量・偏りなしウェブ結果を求める開発者の定番。OpenClaw、pi coding agent、公式MCPサーバーリポジトリで一級プロバイダー。LLM Contextエンドポイントも提供。
強み:
- Brave独自30B+ページインデックス(1日100M+回更新)。
- 予測可能な価格(約$3~$5/1,000クエリ)、超低レイテンシ。
制限: 主にSERPスニペットとグラウンディングコンテキスト返却。複雑な全サイトクロールは専用リーダーツールが必要。
8. Firecrawl:エージェント向け管理型ウェブスクレイパー・クローラー・構造抽出
月間105,000グローバル検索(米国30,000、DR 80、Ahrefsで米国44.6Kオーガニック)、**Firecrawl**は、エージェントがドキュメントサイト全体(docs.example.com/*)をクロールし、動的JSをレンダリング、各サブページをクリーンMarkdownや構造JSON化する業界標準。2026年後半には270M+プロフィールPeople Dataエンドポイントも追加。
強み:
/search、/scrape、/crawl、スキーマ駆動/extract、Claude CodeやCursor用MCPツールも提供。- ヘッドレスブラウザレンダリング、アンチボットローテーション、PDF解析を自動処理。
制限: 複数ページクロールでクレジット消費増。YouTube字幕やスライド生成は別ツール必要。
9. Jina Reader API(r.jina.ai&s.jina.ai):セットアップ不要URL→Markdownパイプライン
Jina AI(DR 77、Ahrefsで$4.50 CPC)によるJina Readerは、開発者体験のシンプルさで有名。任意URLにhttps://r.jina.ai/を付けるとクリーンなLLM向けMarkdownを取得、検索クエリにhttps://s.jina.ai/を付けるとトップウェブ結果をMarkdown化。
強み:
- SDK不要。bash対応エージェントなら
curlやfetchで即利用。 - Jina独自ReaderLM小型言語モデルでHTML→Markdownクリーニング。
制限: 有料APIトークンなしだとレート制限。SNS/X検索や永続ワークスペースメモリは非対応。
10. Crawl4AI:AIエージェント向けオープンソース&セルフホスト型ウェブクローラー
月間17,000グローバル検索(crawl4ai)、GitHubスター50,000超。**Crawl4AI**はFirecrawlのオープンソース代替No.1。エンジニアチームがページ単位API課金ゼロやVPC内完結抽出を求める場合、DockerやPythonでローカル展開、Crawl4AI Cloud接続も可能。
強み:
- 100%オープンソース、セルフホスト、ヒューリスティックノイズ除去付きMarkdown出力(
fit_markdown)。 - 永続ブラウザセッション、カスタムJSフック、ローカルLLM抽出対応。
制限: セルフホストはPlaywrightブラウザ、メモリ、プロキシローテーション管理が必要。ターゲットがデータセンターIPをブロックする場合は注意。
11. Perplexity Sonar API:引用付きプローズ回答即導入
月間2,500検索(perplexity sonar)、**Perplexity Sonar API**は、エージェントが多段階検索・スクレイプループを組みたくない場合、OpenAI互換Chat Completionsコール1回で引用URL配列付きグラウンディング回答を返す最速選択肢。
強み:
- OpenAI SDK互換(
sonar、sonar-pro、sonar-deep-researchモデル)。 - 単一ターンQ&Aベンチマークで高い事実精度。
制限: トークンコスト+リクエスト検索料金が30+反復サブクエリで急増。生ページ抽出エンドポイントは非提供。
12. Linkup(linkup.so):検証可能な企業グラウンディング&プレミアム出版社データ
月間6,100グローバル検索(linkup, DR 65, Ahrefsで$6.00 CPC)、**Linkup**は欧米で急成長中のエージェント検索API。検証可能・コンプライアンス安全なグラウンディングに特化。高速Web検索・抽出エンドポイント(/search&/fetch)に加え、出版社・データプロバイダーと直接提携し、企業エージェントがライセンス済み事実にアクセス可能。
強み:
- SimpleQAベンチマークで高性能、低レイテンシ
standard&多段階deep検索モード。 - 公式MCPサーバー、LangChain、LlamaIndex、Claude Desktopと統合。
制限: オールインワン成果物ツールと比べるとクリエイティブ/出力エコシステムが小規模。
13. SerpApi:多エンジン構造化SERP JSON(Google、Scholar、Maps、News)
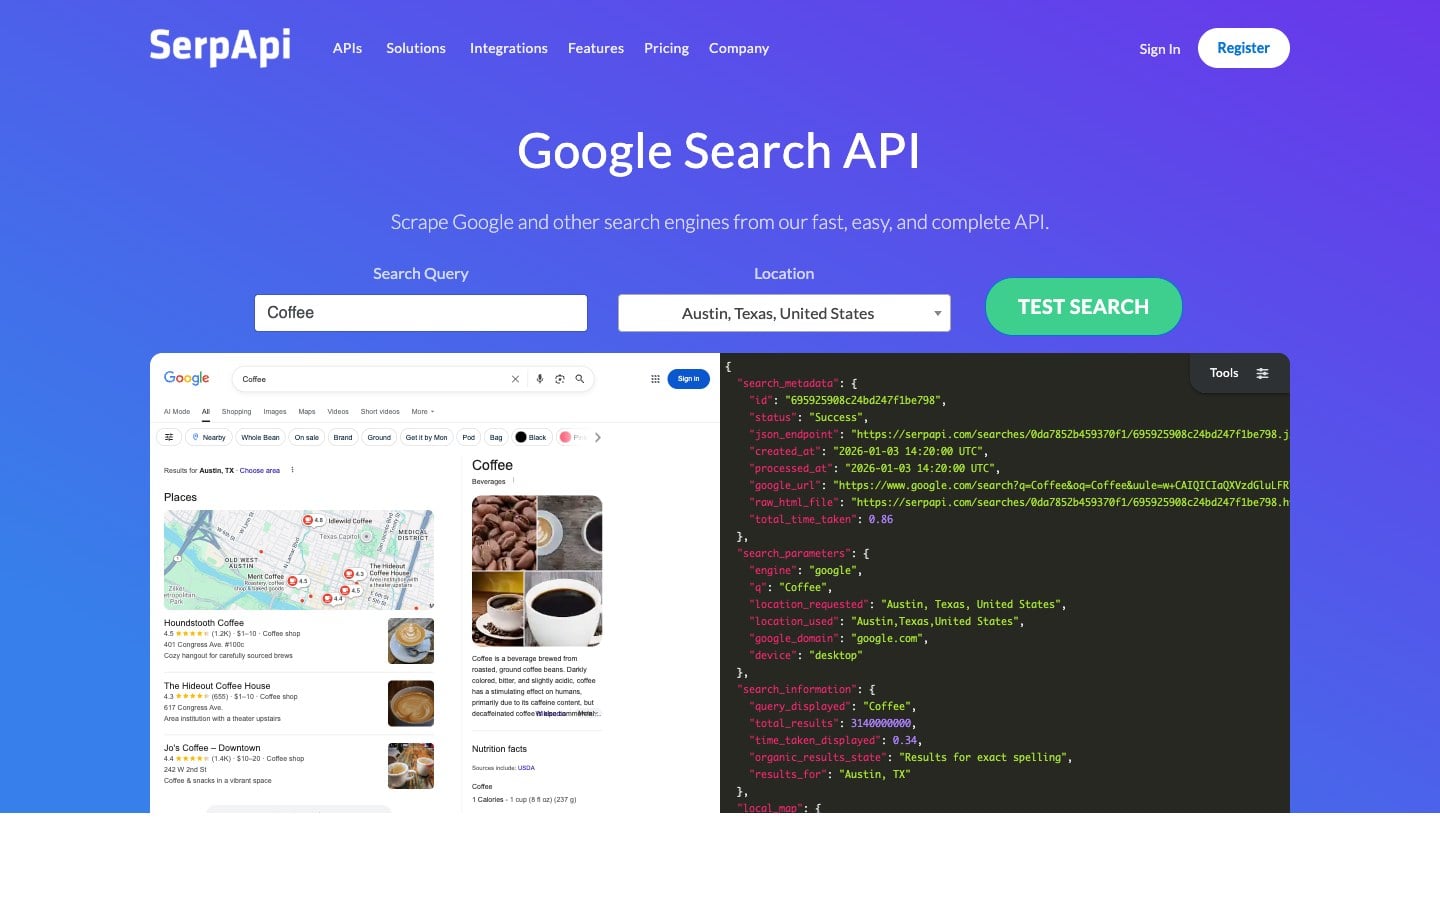
月間63,000グローバル検索(米国20,000)、米国34,700オーガニック訪問(DR 79)、**SerpApi**は検索スクレイピングの老舗。LLM向け設計ではないが、エージェントはGoogle Scholar、Google Patents、Google Flights、Google Mapsローカルパック、Google Shoppingなど専門Google垂直から構造化データ取得時に重用。
強み:
- 40+検索エンジン&専門垂直対応。CAPTCHA解決、都市単位ジオターゲティング保証。
- 企業コンプライアンス向け法的USシールド。
制限: 大規模時は高価(約$10~$15/1,000検索)、生SERP JSON大量返却でLLMコンテキスト投入前に後処理必須。
14. Serper(serper.dev):低コスト・高速生Google SERP API
月間11,000グローバル検索(serper, DR 74)、Serper.devはエージェントがリアルタイムGoogleオーガニック結果・ニュース・画像を1~2秒で取得したい時、$0.30~$1.00/1,000クエリで最安・最速の選択肢。SerpApiの価格の数分の一。
強み:
- 極めて速い応答(約1秒)、カスタムエージェントパイプラインへのリアルタイムGoogle SERPスニペット投入最安。
- pi coding agent、CrewAI、AutoGPTで標準対応。
制限: SERPメタデータ&短スニペットのみ返却。全ページ読取には抽出API(Felo /v2/web/extract、Firecrawl、Jinaなど)併用必須。
15. Apify(Actors&MCPサーバー):エージェント向け90,000+既製ウェブスクレイパー市場
月間273,000グローバル検索(米国50,000、DR 82、米国96.9Kオーガニック訪問)、ApifyはAIエージェントインフラへ急転換。ApifyのRAG Web Browserと公式Apify MCPサーバーで、AIエージェントは90,000超のクラウド「Actors」を動的呼び出し。Google検索、Instagram/TikTok/LinkedInプロフィールスクレイプ、Amazonレビュー抽出、ドキュメントMarkdownクロールなどが可能。
強み:
- サイト別スクレイパー(SNS、EC、地図、求人)を1MCPゲートウェイで提供。
制限: Actor起動時間やコンピュート単位課金は軽量REST検索コールより遅く複雑。
16. Bright Data(AI Web Access&SERP API):エージェント向け企業プロキシ&アンチボット解除
月間27,000グローバル検索(bright data, DR 79、米国31.7Kオーガニック訪問)、Bright Dataは多くのフォーチュン500AIチームの基盤Webアクセスレイヤー。エージェントが厳重なCloudflare/DataDomeファイアウォール保護ページを読む場合、Bright DataのWeb Unlocker、SERP API、Remote Browser for AI Agentsが1.5億超住宅IPネットワーク経由でクリーンMarkdown返却。
強み:
- 保護が厳しいEC、旅行、金融ポータルで最高成功率。エージェント用ホストMCPサーバーも提供。
制限: 企業向け課金・設定。主に開発者ドキュメント、ニュース、技術ブログ調査ならオーバースペック。
17. DeepSeek Search&Fetch API:コーディング&リサーチハーネス向け超低コストネイティブ検索
2026年10月、DeepSeekは公式Search&Fetch APIを公開。生ウェブ検索結果&クリーンページコンテンツを約$0.75/1,000コール(Claude Code、Codexユーザー向けプロモ無料枠あり)で提供。公開24時間以内にオープンソースメンテナがDeepSeek Search&FetchをHermes Agentやpiエコシステム拡張(web-deepseek)に直結。ExaやParallelの高速・低コスト代替として急速普及。
強み:
- 攻撃的価格($0.75/1Kコール)、コーディングエージェント向け検索&クリーンページ取得プリミティブ。
制限: 新興エコシステム。垂直特化エンドポイント(YouTube字幕抽出、Xユーザータイムライン、PPT/LiveDoc生成)は未対応。
マスター比較表:AIエージェント向け検索エンジンサービス17選(2027年)
| # | サービス | カテゴリ | AI回答 | 全ページ抽出 | X/YouTubeデータ | 成果物&メモリ | 価格/フットプリント |
|---|---|---|---|---|---|---|---|
| 1 | Felo OpenAPI | オールインワンエージェントスタック | ✅ /v2/chat | ✅ /v2/web/extract | ✅ X+YouTube | ✅ LiveDocs+PPT/マインドマップ | 統合キー(openapi.felo.ai) |
| 2 | Anthropic Web Search API | Claudeグラウンディング検索 | ✅(/v1/beta/anthropic-websearch/search) | Felo抽出経由 | ❌ | Felo OpenAPI経由 | Anthropicベンダーアカウント不要 |
| 3 | OpenAI Web Search API | OpenAIグラウンディング検索 | ✅(/v1/beta/openai-websearch/search) | Felo抽出経由 | ❌ | Felo OpenAPI経由 | OpenAIベンダーアカウント不要 |
| 4 | Tavily | エージェントRAG検索 | ✅ | ✅ | ❌ | ❌ | DR 79・グローバル32K・約$5~$8/1K |
| 5 | Exa | ニューラルセマンティック検索 | ✅ | ✅ | 部分(ツイート) | ❌ | DR 79・グローバル16K・約$5/1K |
| 6 | Parallel(parallel.ai) | 高速エージェントWebインフラ | ✅ | ✅ | ❌ | ❌ | DR 77・米国18Kオーガニック・約$1/1K |
| 7 | Brave Search API | 独立ウェブインデックス | ✅(LLM Context) | ❌ | ❌ | ❌ | グローバル30K・約$3~$5/1K |
| 8 | Firecrawl | 管理型クロール&抽出 | ❌ | ✅(深堀りクロール) | ❌ | ❌ | DR 80・グローバル105K |
| 9 | Jina Reader | URL→Markdown | ❌ | ✅(r.jina.ai) | ❌ | ❌ | DR 77・即時プレフィックスAPI |
| 10 | Crawl4AI | オープンソースクローラー | ❌ | ✅(セルフホスト) | ❌ | ❌ | グローバル17K・GitHubスター50K+ |
| 11 | Perplexity Sonar | 引用付きChat Completions | ✅(主力) | ❌ | ❌ | ❌ | グローバル2.5K・トークン+リクエスト課金 |
| 12 | Linkup(linkup.so) | 企業グラウンディング | ✅ | ✅ | ❌ | ❌ | DR 65・グローバル6.1K・€5/1K |
| 13 | SerpApi | 多垂直SERP JSON | ❌ | ❌ | YouTubeメタデータ | ❌ | DR 79・グローバル63K・約$10~$15/1K |
| 14 | Serper.dev | 高速生Google SERP | ❌ | ❌ | ❌ | ❌ | DR 74・グローバル11K・約$0.30~$1/1K |
| 15 | Apify | 90K+スクレイパーActors&MCP | Actors経由 | ✅ | ✅(Actors経由) | ❌ | DR 82・グローバル273K |
| 16 | Bright Data | 企業アンロッカー&SERP | ❌ | ✅(Markdown) | ✅(データセット) | ❌ | DR 79・グローバル27K |
| 17 | DeepSeek Search/Fetch | 低コスト検索&Fetch | ❌ | ✅ | ❌ | ❌ | 約$0.75/1Kコール・Claude/Codex対応 |
2027年人気AIエージェントの検索接続方法
ローカル端末やチームワークフローでAIエージェントを運用する場合、主要エージェントハーネスの検索サービス接続例を紹介。
1. Claude Code
Claude Codeはリポジトリ全体のコード推論、bash実行、ファイル編集に強みがあるが、内蔵ウェブツールはSNS信号や動画字幕、オフィス成果物には弱い。Felo OpenAPI(CLIスキルやMCPサーバー経由)接続で、ライブドキュメント検索(POST /v2/chat)、全ページ抽出(POST /v2/web/extract)、Xでライブラリ破壊的変更報告確認、アーキレビュー用スライド生成(POST /v2/ppts)が可能。
2. Codex CLI
OpenAIのCodex CLIはデフォルトでキャッシュ済みウェブスナップショットモード。標準では数時間前公開のドキュメントやCVEを見逃す。config.tomlやMCPサーバー、**FeloのCodex統合**でリアルタイムウェブ検索、URL抽出、低コストマルチモデルルーティングを1APIキーで実現。
3. pi Coding Agent
スピード・拡張性・クリーンコンテキスト管理重視のpi coding agentハーネスは検索を一級ツールとして扱う。piではネイティブweb_search&fetch_contentツール(Exa、Brave、Tavily、Firecrawl、Jinaなど複数プロバイダー並列クエリ対応)と、CLIスキルfelo-search(~/.agents/skills/felo-search/scripts/search.sh)、felo-x-searchを組み合わせ、piサブエージェントが並列調査・検証・コード生成をメインコンテキスト汚染なしで実行。
4. OpenClaw
OpenClawは自律型リサーチや多段階運用ワークフローで人気だが、外部APIなしでは永続メモリやライブSNSパルスがない。**Felo OpenAPI**接続でライブウェブ検索、X感情追跡、YouTube字幕抽出、LiveDocsセマンティックメモリを追加し、エージェントが前回調査を今日のセッションで記憶できる。
5. Hermes Agent&カスタムMCPハーネス
Hermes AgentやカスタムMCPクライアントでマルチエージェントパイプラインを編成するチームは、プロトコル一貫性を重視。Felo OpenAPIのREST&SuperAgent SSEエンドポイントと標準MCPサーバー(**mcpmeasure.com**などで発見可能)を組み合わせると、Hermesエージェントが検索→抽出→LiveDocsメモリ→PPT/ランディングページ生成を5ベンダー分の脆弱なグルーコードなしで連鎖可能。
クイック例:任意エージェントからFelo検索&Web抽出呼び出し
Felo OpenAPIはクリーンなRESTエンドポイント+Bearerトークン認証を採用。bashやHTTPツール対応エージェントなら数秒で呼び出せる。
# 1. リアルタイムAIアンサ―検索(POST /v2/chat)
curl -s -X POST "https://openapi.felo.ai/v2/chat" \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "Compare MCP server authentication changes in the 2026-2027 spec"
  }'

# 2. AnthropicモデルグラウンディングWeb検索(Anthropicベンダーアカウント不要)
curl -s -X POST "https://openapi.felo.ai/v1/beta/anthropic-websearch/search" \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "messages": [{"role": "user", "content": "Latest stable release of Claude Code and key MCP updates"}],
    "max_tokens": 1024
  }'

# 3. OpenAIモデルグラウンディングWeb検索(OpenAIベンダーアカウント不要)
curl -s -X POST "https://openapi.felo.ai/v1/beta/openai-websearch/search" \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "input": "Compare Codex CLI web search configuration options",
    "max_output_tokens": 1024
  }'

# 4. 特定URLからクリーンコンテンツ抽出(POST /v2/web/extract)
curl -s -X POST "https://openapi.felo.ai/v2/web/extract" \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "url": "https://modelcontextprotocol.io/specification"
  }'
エージェントは合成answer、query_analysis用語、抽出ページコンテンツを構造化JSONで受け取り、次の推論ステップやLiveDocs保存に即投入できる。
よくある質問(FAQ)
オンラインAIアンサ―エンジンとエージェント検索APIの違いは?
オンラインAIアンサ―エンジン(Felo AI Search、Perplexity、ChatGPT Searchなど)は人間向け。ビジュアルUI、クリック可能な出典カード、インタラクティブなドキュメントやスライド作成を提供する。エージェント検索API(Felo OpenAPI、Tavily、Exaなど)はClaude CodeやOpenClawなどソフトウェアエージェント向け。機械可読JSON、クリーンMarkdown抽出、UI負荷なし低レイテンシエンドポイントを返す。
2027年多言語リサーチに最適なAIアンサ―エンジンは?
Felo AI Searchがクロスランゲージリサーチでトップ。意図を日本語、中国語、韓国語、英語、欧州言語などターゲット言語の現地クエリに翻訳し、一次現地ソースを取得。希望言語で回答を合成する。
Claude Code、Codex CLI、pi、OpenClaw向け最適検索APIは?
ウェブ検索、全ページ抽出、X(Twitter)検索、YouTube字幕、共有メモリ(LiveDocs)、成果物生成(PPT、マインドマップ、ランディングページ)を1APIキーでカバーしたいならFelo OpenAPIが最も完全。生SERPスニペットだけならBrave Search API、セマンティックベクトル探索ならExaが専門特化で強い。
AIエージェントにGoogleを直接スクレイプさせてはいけない理由は?
生ウェブスクレイピングはCAPTCHA発動、サイトレイアウト変更時に壊れ、数万トークンのノイズHTML/JavaScriptをエージェントコンテキストに流し込む。エージェント検索APIは事前クリーニングMarkdownや合成回答をトークンコスト・レイテンシの数分の一で返す。
結論:人間用・エージェント用両方に最適エンジンを選ぶ
2025年、10件青リンクからAIアンサ―エンジンへの切り替えは超能力のようだった。2027年、最も賢いチームは両方のワークフローをアップグレードする。
- 日常リサーチには: Felo AI Searchで言語障壁を突破し、リアルタイムウェブ&SNS証拠を取得し、回答をLiveDocsやFelo Slidesにワンクリックで変換。
- AIエージェント(Claude Code、Codex CLI、pi、OpenClaw、Hermes Agent)には: **Felo OpenAPI**を接続し、ライブウェブ検索、全ページ読取、X/YouTube追跡、コンテキスト記憶、成果物生成を1APIキーで実現。
Felo AI Searchを無料で試す → | エージェント用Felo OpenAPI無料キー取得 →
この記事は次の言語でもお読みいただけます:English、简体中文、한국어、繁體中文、हिन्दी、Français、العربية、Русский、اردو、Bahasa Indonesia、Deutsch、Tiếng Việt、Türkçe、Italiano、ไทย、Español、বাংলা、Português。