識別型AI:意思決定モデル、事例、活用方法

識別型AIと意思決定モデルが入力を分類、振り分け、スコアリングする仕組み、生成AIとの違い、開発者による活用方法を解説します。
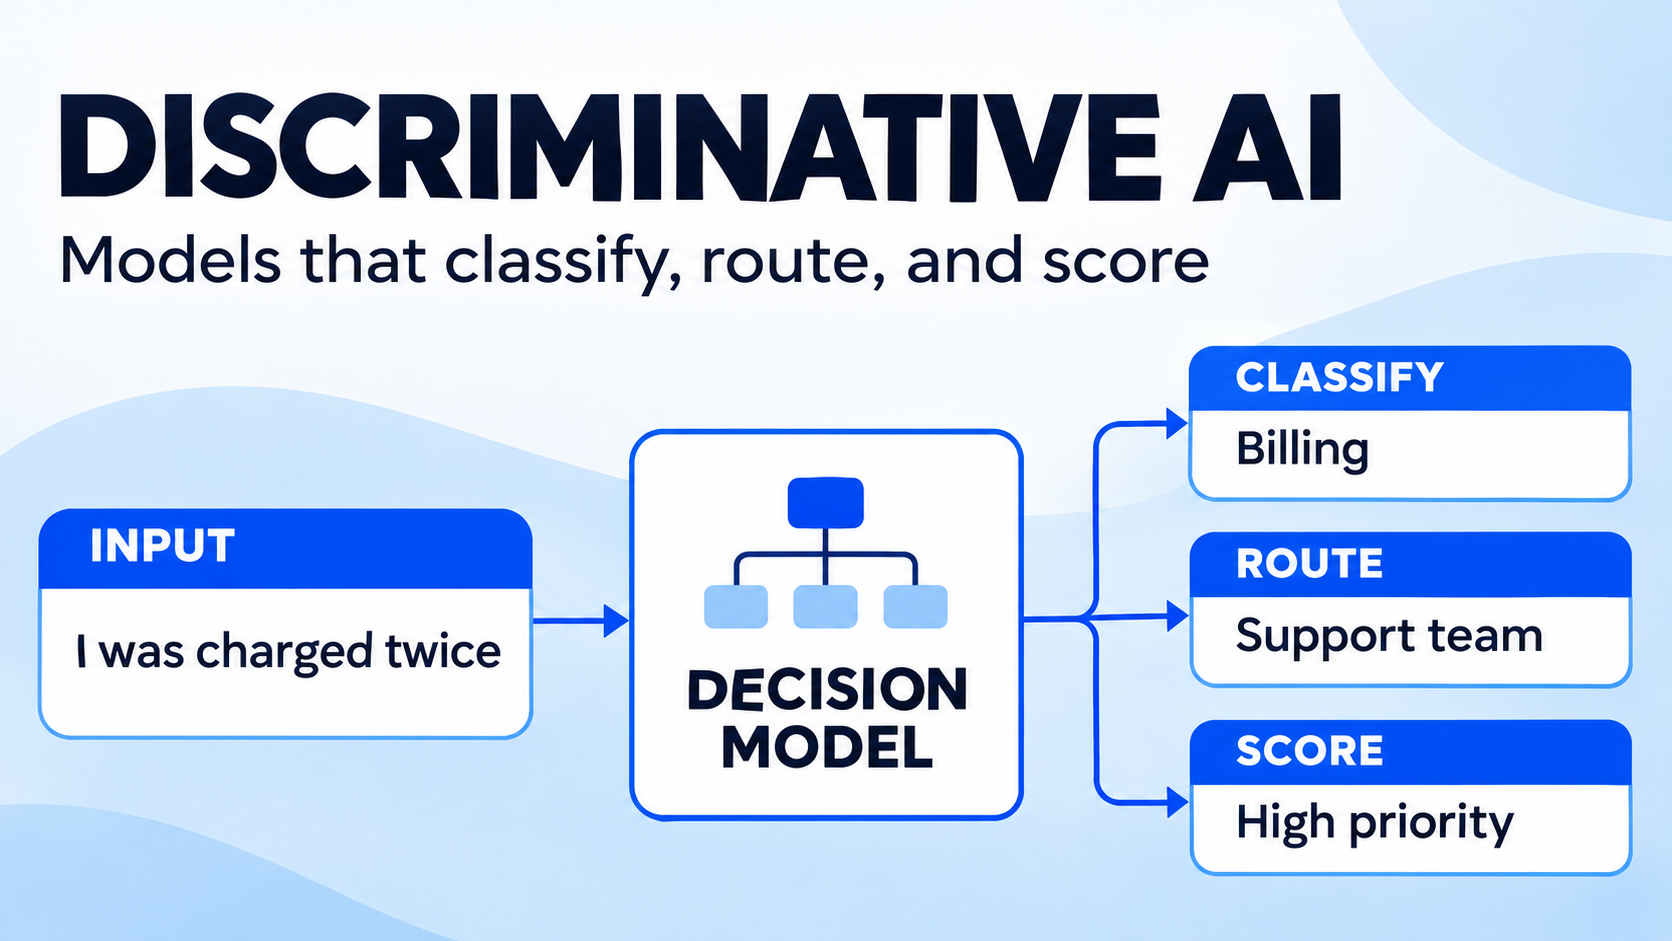
サポートへの問い合わせが届きました。「料金が二重に請求されたので、返金してほしい」。アプリケーションに必要なのは、AIモデルが生成する段落形式の文章とは限りません。まず必要なのは、この問い合わせを請求部門、テクニカルサポート、営業部門のどこに振り分けるべきかという判断かもしれません。
**識別型AI(Discriminative AI)**は、入力からラベル、スコア、その他の目標値を予測することを目的としています。新しい意思決定モデル群は、この考え方を開発者向けAPIに取り入れています。モデルにコンテキストと明確な質問を与えると、ソフトウェアで利用できる構造化された判断や確率が返されます。このガイドでは、これらのモデルの仕組み、生成AIとの使い分け、評価方法を解説します。
識別型AIとは?
識別型AIは、入力に関する特定の情報を予測します。スパムフィルターはメールが迷惑メールかどうかを予測し、分類器はサポートチケットを担当チームに割り当て、リスクモデルは特定の結果が発生する可能性を推定します。
機械学習では、識別モデルは一般に、入力 x から目標値 y への写像を学習するか、条件付き確率 P(y | x) を推定します。目標値には、クラス、数値、その他の構造化された出力が含まれます。ロジスティック回帰、サポートベクターマシン、多くのニューラル分類器が識別型アプローチの例です。すべての識別モデルが確率を返すわけではなく、数値スコアがすべて適切に較正されているわけでもありません。
この基本的な考え方は、現在のAIアシスタントが登場する以前から存在しています。新しい点は、タスクの説明や選択肢を自然言語で受け付ける汎用的な意思決定APIが利用できるようになったことです。これにより、開発者は同じインターフェースを多様な分類やスコアリングのタスクに適用できます。
AI意思決定モデルとは?
現在のAPI環境において、**意思決定モデル(Decision Model)**とは一般に、与えられた入力について範囲が限定された質問に回答するためのモデルやサービスを指します。自由形式の回答を作成する代わりに、次のような型付きの結果を返します。
- Yes/Noの確率: このメッセージに返金要求が含まれる可能性はどの程度か?
- 選択: このチケットを担当するべき部門はどこか?
- スコア: この回答は定義された品質評価基準のどの水準に該当するか?
たとえば、意思決定モデルは請求部門というラベルと、各部門に該当する確率の推定値を返します。アプリケーションはその結果を使ってチケットを振り分け、追加情報を求めるか、人間の担当者による確認に回すことができます。
TypeSafeは、Jevファミリーを「System One」モデルと呼んでいます。Liquid AIは、d1意思決定モデルについて、テキストと画像を受け取り、出力トークンを生成せずに確率を返すモデルと説明しています。識別モデルに関するGoogle Codelabでは、アプリケーション内で意思決定モデルを生成モデルと組み合わせる方法を紹介しています。
これらの用語には関連性がありますが、同じ意味ではありません。 識別型モデリングは機械学習の広範な概念であり、意思決定モデルは範囲を限定した判断を行うための製品またはインターフェースです。生成モデルもプロンプトを使ってテキストを分類できますが、その基盤となる生成プロセスと応答形式は異なります。
識別型AIと生成AIの違い
| 識別型AI | 生成AI | |
|---|---|---|
| 典型的な質問 | 「この入力に該当するカテゴリはどれか?」 | 「どのような回答やコンテンツを生成するべきか?」 |
| 一般的な出力 | ラベル、予測、スコア、確率 | テキスト、コード、画像、音声、その他の生成コンテンツ |
| タスクの例 | 顧客の問い合わせチケットを振り分ける | 顧客への返信文を作成する |
| 検証すべき強み | 一貫性のある範囲限定の判断と利用可能なスコア | 柔軟な統合、説明、コンテンツ作成 |
| 主な評価項目 | 分類エラー、較正、しきい値 | 正確性、指示への準拠、安全性、有用性 |
一方のモデルが特定のタスクしか実行できないという決まりがあるわけではありません。LLMはJSON形式のラベルを返すことができ、意思決定システムは大規模なワークフローの内部で生成モデルを利用できます。実務上の違いは、それぞれのコンポーネントが何を実行するよう最適化され、どのような機能として提供されているかです。構造化APIレスポンスが返されるという事実だけでは、確率が適切に較正されていることや、基盤モデルが識別型であることの証明にはなりません。
返金に関する問い合わせを例に考えてみましょう。意思決定モデルは問題を請求関連と判定し、緊急度を推定できます。その後、生成モデルが関連する返金ポリシーを使って、顧客に配慮した返信文を作成できます。アプリケーションが実際に処理を実行する前には、ポリシー、権限、必要な人間による承認を確認する必要があります。
アプリケーションにおける意思決定モデルの仕組み
正確なスキーマはプロバイダーによって異なりますが、一般的な意思決定リクエストには次の3つの要素が含まれます。
- 状態(State): チケットのテキストや画像など、評価対象となる情報。
- 質問と基準: 実行する判断と、許可された回答またはスコア水準の説明。
- 型付きレスポンス: アプリケーションが解釈するラベル、スコア、確率分布。
たとえば、次のようになります。
State: "I was charged twice for my subscription."
Question: Which team should handle this request?
Options: billing, technical support, sales
Illustrative result: billing
これは概念を示す例であり、実際のAPIレスポンスではありません。エンドポイントによっては、信頼度や確率も返されます。すべてのプロバイダーが同じリクエスト形式を採用している、または同じモダリティに対応していると想定せず、対象モデルとAPIのドキュメントを確認してください。
確率スコアの意味
予測確率を活用するには、その信頼性を理解する必要があります。システムが類似した予測の多くに0.8という値を割り当てる場合、適切に較正されたシステムでは、そのグループ全体で約80%の予測が正解となるはずです。単一の0.8というスコアは、個別の判断が正しいことを保証しません。
特にモデル、ラベル、言語、入力元を変更した後は、自社のデータを使って較正を確認してください。しきい値を設定して信頼度の低いケースを人間の確認に回すことはできますが、偽陽性と偽陰性のコストに基づいてしきい値を選ぶ必要があります。不正検知の審査キューと無害なコンテンツの推薦では、異なるルールが必要です。
識別型AIの事例とユースケース
サポートチケットの分類と振り分け
意思決定モデルは、受信したメッセージを請求、テクニカルサポート、アカウント管理などに分類できます。曖昧な問い合わせに備えて「その他」や「要確認」の経路を設け、複数の問題を含むメッセージもテストしてください。全体の正解率だけでなく、カテゴリ別のエラー率を評価することが重要です。定型的な質問が大半を占めるデータセットでは良好な結果を示すモデルでも、緊急性の高い請求トラブルを見逃す可能性があります。
コンテンツモデレーション
モデレーションのワークフローでは、コンテンツが定義済みのポリシーカテゴリに該当するかをモデルに質問できます。明確な基準と例を与え、境界事例を評価し、不確実性の高いケースや重大な影響を伴うケースを訓練済みの審査担当者に回します。意思決定スコアはポリシー適用プロセスの判断材料であり、コンテンツが規則に違反していることの証明ではありません。
LLMとエージェントのルーティング
LLMを呼び出す前に、アプリケーションでリクエストをトピック、複雑さ、必要なモダリティに基づいて分類できます。ルーティングコンポーネントは、その結果に応じてワークフローを選択するか、追加情報を要求します。下流のシステムも含めてルーティングをテストしてください。最初の処理コストが低くても、難しいリクエストを誤った経路に送り続けるなら有用ではありません。
文書と画像のトリアージ
マルチモーダル意思決定モデルは、画像や文書が請求書、領収書、サポート画面のスクリーンショットなど、事前定義されたカテゴリに属するかを分類できます。必要な入力形式と画像処理に対応しているか、対象エンドポイントを確認してください。分類と文書内のすべての項目の抽出は別のタスクです。選択したモデルとAPIが両方に対応しているかを確認してください。
評価基準に基づくスコアリング
モデルは、「重要な証拠が不足」「一部の根拠がある」「十分な根拠がある」といった説明を使い、回答を段階的な評価尺度に当てはめることができます。審査担当者がラベルに同意するか、類似した回答が一貫して評価されるかをテストしてください。検証を行わずに、評価基準に基づくスコアを客観的な測定値として提示することは避けてください。
Feloモデルカタログで利用できる意思決定モデル
Feloモデルカタログには、出力形式を絞り込むためのDecisionsフィルターがあります。2026年11月2日時点の掲載例は次のとおりです。
| カタログ掲載モデル | 説明されている用途 | カタログに表示されている入力 |
|---|---|---|
| TypeSafe Jev 1.14 | ルーティング、分類、モデレーション | テキストと画像。画像対応は実験的機能と記載 |
| LiquidAI d1.1 | Yes/No、選択、スコアによる判断 | テキストと画像 |
| Baseten Joey 1 | 分類とルーティング | テキストと画像 |
| Perplexity Decider Flash V1.2 | 分類、ルーティング、スコアリング | テキストと画像 |
これらの説明はカタログの掲載内容を反映したものであり、独立した性能テストの結果や、特定モデルが最適であるという推奨ではありません。利用可能性、機能対応、コンテキスト制限、料金は変更される可能性があります。開発に着手する前に、最新の掲載情報とエンドポイントのドキュメントを確認してください。特に実験的機能やマルチモーダル機能には注意が必要です。カタログにモデルが掲載されていても、各プロバイダーのネイティブAPI機能がすべてのプラットフォームで公開されているとは限りません。
AI意思決定モデルの評価方法
まず、範囲を限定した判断タスクと、信頼できるラベルが付いた代表的なサンプルを用意します。難しいケース、少数派のカテゴリ、コンテキストの欠落、人間が対応するべきケースを含めてください。その後、モデルを単純なベースライン、既存の分類器、または構造化出力を使用するLLMと比較します。
正解率だけでなく、次の指標も測定してください。
- 適合率と再現率: どのようなエラーが重要で、各クラスでどの程度発生するか?
- 較正: 予測確率は、ケースのグループごとの実際の結果と一致しているか?
- カバレッジ: 設定したしきい値で、リクエストの何割を自動処理できるか?
- レイテンシと信頼性: API呼び出し全体が本番環境の要件を満たすか?
- コスト: リトライ、複数の質問、画像処理、人間による審査を含め、有用な判断1件あたりのコストはいくらか?
- 堅牢性: 言語、形式、未知のサンプル、トラフィックの変化に対して性能を維持できるか?
ラベルとしきい値の調整後は、学習や調整に使用していないテストセットで評価してください。本番環境では、適切な範囲で結果を記録し、判断の不一致を確認し、モデルのバージョン、ポリシー、入力分布が変化した際に再評価します。重大な影響を伴う判断には、実質的な人間による監督体制を設計し、適用される要件を確認してください。
よくある質問
識別型AIと意思決定モデルは同じものですか?
厳密には異なります。識別型AIは、入力から目標値を予測する広範なアプローチを指します。意思決定モデルは、選択、スコア、確率などの範囲を限定した出力に焦点を当てる新しい製品カテゴリです。一部の意思決定モデルは識別型の技術を使用しますが、両者は同じものを表す用語ではありません。
LLMは分類や意思決定を実行できますか?
はい。生成型LLMにプロンプトを与えることで、コンテンツを分類したり、構造化された出力を返したりできます。専用の意思決定モデルの方が高性能、高速、低コストであるかどうかは、タスク、モデル、プロバイダー、評価方法によって異なります。自社のサンプルを使って両方をテストしてください。
意思決定モデルの確率は常に正確ですか?
いいえ。特定のデータセットやサブグループに対して、適切に較正されていない確率を出力するモデルもあります。しきい値を使ってワークフローを自動化する前に、較正と誤りがもたらす影響を測定してください。
生成AIを使うべきなのはどのような場合ですか?
文章の作成、説明、情報の統合、自由形式のコンテンツ生成が必要なタスクには生成モデルを使用してください。多くのアプリケーションでは、意思決定モデルと生成モデルを組み合わせて利用できます。一方がルーティングや分類を担当し、もう一方が回答を作成します。
識別型AIは、開発者が明確で測定可能な判断をワークフローに組み込むための手段です。まず範囲を限定した1つのタスクから始め、重要なエラーを検証し、得られた証拠に基づいて自動化の範囲を決定してください。
この記事は次の言語でもお読みいただけます:English、简体中文、한국어、繁體中文、हिन्दी、Français、العربية、Русский、اردو、Bahasa Indonesia、Deutsch、Tiếng Việt、Türkçe、Italiano、ไทย、Español、বাংলা、Português。