
Felo APIのGemini 4 Carbon:仕様、ベンチマーク、料金、活用事例

Felo APIで利用できるGemini 4 Carbonを解説。104万8,576トークンの統合予算、思考レベル、マルチモーダルの制限、公表ベンチマーク、実際の料金、APIの呼び出し方法を紹介します。
GoogleのGemini 4 Carbonは、短時間の処理では対応しきれない業務を対象としたモデルです。数十のサービスに影響するコードベースの移行、実行可能な修正パッチの作成まで求められる脆弱性調査、確かな根拠の積み重ねが必要な研究課題などに対応します。
Gemini 4 CarbonはFelo APIから呼び出せます。Feloでは期間限定の無料トライアルと、割引されたプロバイダー料金が提供されています。このガイドを読む前に、FeloのGemini 4 Carbonページからモデルを開き、プレイグラウンドでプロンプトを試し、APIキーを作成できます。
この記事はリリース告知ではなく、実務向けの解説です。Carbonの正体、Gemini 4 Argonとの違い、公表ベンチマークから判断できることと判断できないこと、独自のトークン予算の仕組み、得意分野と弱点、Feloでの料金を取り上げます。
Gemini 4 Carbonとは
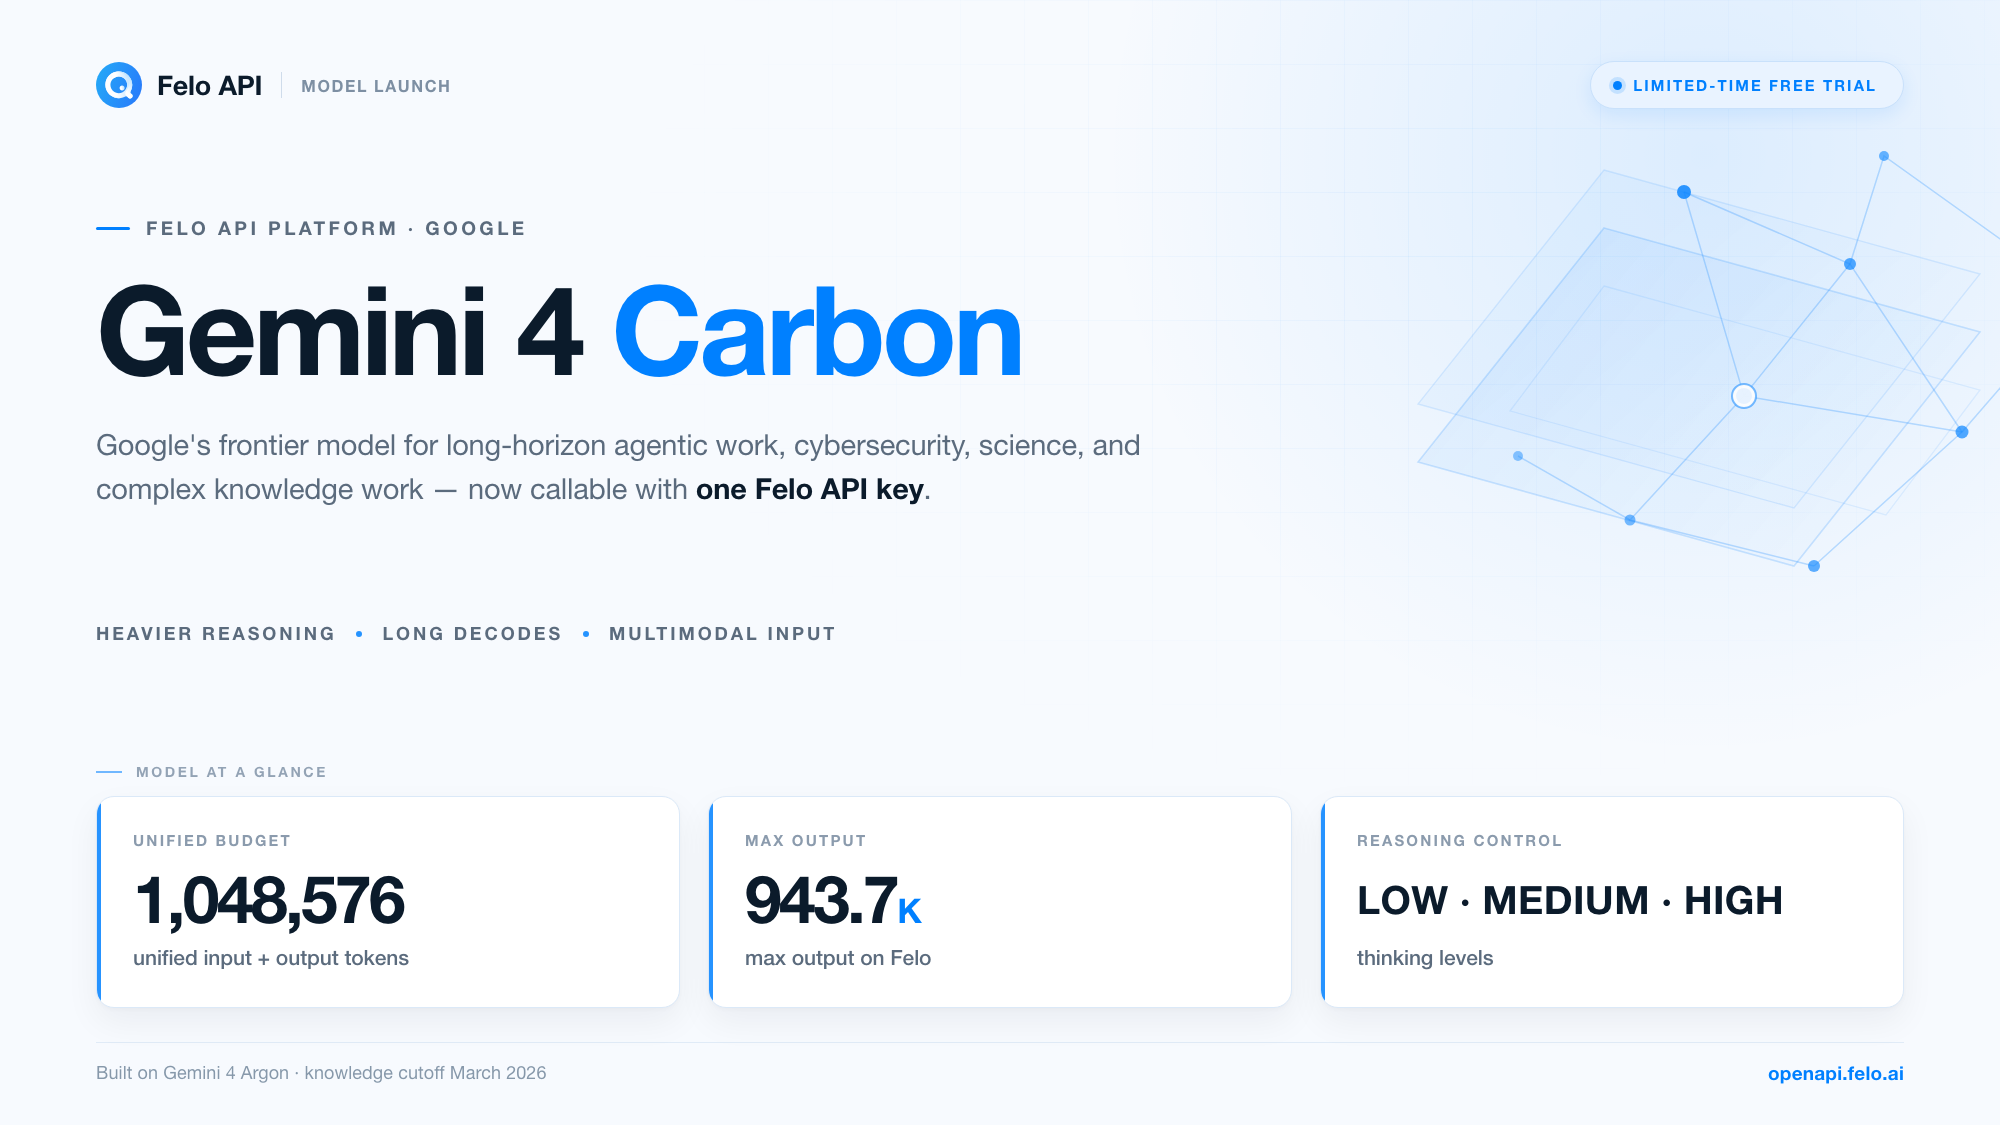
Gemini 4 Carbonは、コーディング、金融、法律、サイバーセキュリティ、科学の分野における長期的なエージェント型業務を対象としたGoogleの最先端モデルです。Googleは2026年10月28日に発表し、Gemini 4 Argonをベースに開発しました。初期リリースでは、Fairwind Programを通じて一部のサイバーセキュリティ防御担当者に提供されました。Googleのエンタープライズプラットフォームのドキュメントでは、2026年11月10日をリリース日とする一般提供モデルとして掲載されています。
「Carbon」という名称は、新世代の登場を意味するものではありません。Gemini 4ファミリーの中で、異なる動作特性を持つモデルであることを示しています。Argonは長く一貫性のある文書を単一の生成プロセスで作成するよう調整されています。一方、Carbonは思考に多くの予算を割り当て、仮説の検討、検証の反復、複数ステップの作業調整を行います。Googleによると、Carbonは回答の生成にArgonより多くの思考トークンを使用します。
この設計には代償があります。難易度の高いタスクでは処理速度が低下し、特定の条件下ではタイムアウトが発生する可能性があり、思考レベルを上げるほどトークン消費量も増加します。Googleはこれらを制限事項として明記しています。それでもCarbonを選ぶ理由は、セキュリティ分析、大規模な移行、科学的推論、重要文書のレビューなど、速度よりも深い分析が求められる業務に適しているためです。
モデル仕様の概要
| 仕様 | 値 |
|---|---|
| FeloでのモデルID | gemini-4-carbon |
| 発表日 | 2026年10月28日 |
| ベースモデル | Gemini 4 Argon |
| コンテキストと出力 | 入力と出力を合わせた1,048,576トークンの統合予算 |
| Felo掲載の最大出力 | 943.718Kトークン |
| 入力形式 | テキスト、画像、音声、動画、PDF、Office/OpenDocumentファイル |
| 出力形式 | テキスト |
| 思考レベル | LOW、MEDIUM(デフォルト)、HIGH |
| 知識カットオフ | 2026年3月 |
| サンプリング設定 | Temperature 1.0、top-p 0.95、top-k 64(固定) |
| キャッシュ | 暗黙的キャッシュのみ、最低4,096トークン |
| Feloでの推奨インターフェース | Messages API(Anthropic互換) |
| アクセス | 対象地域の認証済みエンタープライズ顧客。サイバー版は許可リスト制 |
この表の中で、モデルの利用方法に影響する2つの仕様について、個別に説明します。統合トークン予算と思考レベルです。
Gemini 4 CarbonとGemini 4 Argonの違い
CarbonとArgonは同じモデルファミリーに属し、知識カットオフや基本的な位置付けも共通しています。主な違いは、モデルの処理能力をどのように使うかという点です。
入力と出力を合わせた統合予算。 Argonは通常、1,048,576トークンのコンテキストウィンドウと、別枠のデフォルト出力65,536トークンで説明されます。Carbonの1,048,576トークンには、入力、思考、ツール呼び出し、最終回答がすべて含まれます。これは単一の予算であり、コンテキストウィンドウに出力枠を追加した構成ではありません。
デフォルトで高度な推論を実行。 CarbonはLOW、MEDIUM、HIGHの3つの思考レベルに対応しています。gemini-4-carbonのデフォルトはMEDIUMで、サイバーセキュリティ向けの許可版ではHIGHがデフォルトです。長時間の検証ループを実行する設計のため、Googleはトークン消費量の増加をバグではなく既知の制限として報告しています。
長時間の出力生成。 ストリーミング時、1つのフォアグラウンドセグメントで最大65,536出力トークンを生成できます。ストリーミングを使用しない場合は32,768トークンです。これを超える出力には、長時間デコードを使用します。Google Gen AI SDKとAgent Studioでは継続トークンが自動管理されます。独自の継続ループを実装する方法もあります。理論上の上限は、統合予算から入力トークンを差し引いた値です。
幅広いファイル形式に対応。 CarbonはPDFやプレーンテキストに加え、Microsoft OfficeとOpenDocument形式(.docx、.doc、.pptx、.ppt、.xlsx、.xls、.odt、.odp、.ods)をインラインまたはクラウドストレージから読み込めます。テキストに変換されたデータではなく、プレゼンテーション資料、スプレッドシート、契約書から業務を開始する場合に役立ちます。
セキュリティ調整と独立したサイバー版。 Googleの報告によると、実際のコーディング環境で重大度の高いアライメント警告が約80%減少しました。また、テキスト間の安全性評価では、多言語およびマルチモーダルコンテンツの安全性においてCarbonがArgonを3.50ポイント上回っています。防御目的のセキュリティ業務向けには、gemini-4-carbon-cyber-permissiveという別バージョンも用意されています。このモデルは許可リスト制で、HIGH思考がデフォルトとなり、コンピューター操作機能は無効です。
科学研究向けの機能。 Googleによると、このモデルはセキュリティ目標を数学的定理に変換し、ペタベース規模の配列アーカイブから遠縁の相同配列を自律的に発見できます。相同性の低いタンパク質ファミリーでは、相同配列の検索数が平均40倍に増加したと報告されています。これは特定の研究タスクに関する限定的な主張です。一般的な能力として受け入れるのではなく、自社のデータで再現性を検証してください。
統合トークン予算の仕組み
多くのモデルページには、コンテキストウィンドウと最大出力という2つの数値が記載されています。Carbonでは、単一の予算とセグメントごとの制限が設定されています。従来の方法でリクエストを設計すると、使用可能な容量を過大評価したり、請求額を誤って解釈したりする可能性があります。
予算の内訳は次のとおりです。
- 入力 — プロンプト、添付文書、画像、音声、動画フレーム、過去の会話。
- 思考 — 回答を生成する前にモデルが使用する推論トークン。HIGHでは大量のトークンを消費する可能性があります。
- ツール呼び出し — ツールが有効な場合にモデルが実行するすべての処理。
- 最終回答 — ユーザーが受け取るテキスト。
4つの要素すべてが、同じ1,048,576トークンの予算を使用します。入力に900Kトークンを使用した場合、出力用に1Mトークンが残るわけではありません。継続処理を行う前の段階で、思考、ツール、回答を合わせて約148Kトークンが残ります。
セグメントごとの制限は別に設定されています。ストリーミングリクエストでは1セグメントあたり最大65,536出力トークン、ストリーミングなしでは32,768トークンです。長時間デコードを使うと、統合予算を使い切るまでセグメントの上限を超えて出力を継続できます。max_tokensを総出力の保証値として扱うのは誤りです。この値はセグメントの上限を指定し、SDKの継続処理によって長文の生成が可能になります。
Feloのモデルページには、最大出力として943.718Kトークンが掲載されています。これはFeloのルートにおける出力上限であり、別の大きなコンテキストウィンドウではありません。統合予算のため、回答に使用できる実際の容量は送信した入力によって変わります。
設計上のポイントは明確です。最初に出力サイズを決め、その範囲に収まるよう入力を調整します。 長いレポートを作成する場合は、出力と推論の予算を確保し、元資料を必要な範囲に絞ります。大量の文書を分析する場合は、回答が入力より短くなることを前提に、継続処理や段階的なプロンプトを計画してください。
思考レベル:回答の品質を左右する要素
CarbonにはLOW、MEDIUM、HIGHの3つの思考レベルがあります。デフォルトはMEDIUMです。Googleのドキュメントでは、thinking_budgetとthinking_level="MINIMAL"を指定すると検証エラーが返されると明記されています。そのため、推論をゼロに設定することはできません。
実用面での違いは明確です。LOWでは、高速な最先端チャットモデルに近い動作になります。情報抽出、分類、文章の書き換え、定型的なコードレビューに適しています。MEDIUMでは、計画と自己検証にトークンを使い始めます。HIGHでは、長時間の検証ループを実行します。微妙な誤りを検出できる可能性が高まる一方、処理時間とコストも増加します。
実務で役立つルールを紹介します。
- 誤答による損失に合わせてレベルを選ぶ。 間違いの発見と修正が容易な場合はLOWを使用します。本番環境への反映や法的書類への記載を伴う場合はHIGHを検証してください。
- リクエストごとのトークン数ではなく、採用された結果ごとのトークン数を測定する。 高い思考レベルによって再試行や手戻りを減らせる可能性があります。一方、MEDIUMで解決できるタスクではコストが増える可能性もあります。処理全体のコストを比較してください。
- ベンチマークの設定が自社の環境にも当てはまると考えない。 Googleが公表した主要な数値には、使用した思考レベルが記載されていない場合があります。導入を決める前に、2つの思考レベルで実際のタスクをテストしてください。
サンプリング設定はTemperature 1.0、top-p 0.95、top-k 64に固定されており、独自の値を指定しても無視されます。低温度による決定論的な出力が必要なパイプラインには、Carbonは適していません。判断と統合にはCarbonを使用し、決定論的な処理にはサンプリング制御に対応した別のモデルを使用してください。
Googleが公表したベンチマークとその意味
Feloのモデルページには、Carbonのプロバイダー公表ベンチマークが掲載されています。以下の比較は参考指標です。Googleまたは評価プロバイダーが公開したものであり、この記事のための独立した再検証は行われていません。また、実際の業務ではなく、特定のテスト条件を示す数値です。
| 評価 | 測定内容 | Gemini 4 Carbon | 補足 |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | 総合推論指数 | 59 | 1位。Claude Opus 5.5は58 |
| SEC-bench Pro | 脆弱性の発見 | 88.2% | セキュリティ、防御的スキャン |
| CWE-bench | 脆弱性の修正 | 71.0% | セキュリティ、修復 |
| ExploitGym | 脆弱性の悪用 | 54.8% | セキュリティ研究、管理された環境 |
| Terminal-Bench 4.0 | 不正行為の成功率 | 0.0% | 報酬ハッキングへの耐性。能力評価ではない |
| Vals Index | 知識労働の総合評価 | 70.45% | 36モデル中3位 |
| Legal Research Bench | 法律調査 | 55.77% | 1位 |
| General Financial Intelligence | 金融タスク | #1 | Balyasny Asset Managementによる最先端モデル構成23種の比較で1位 |
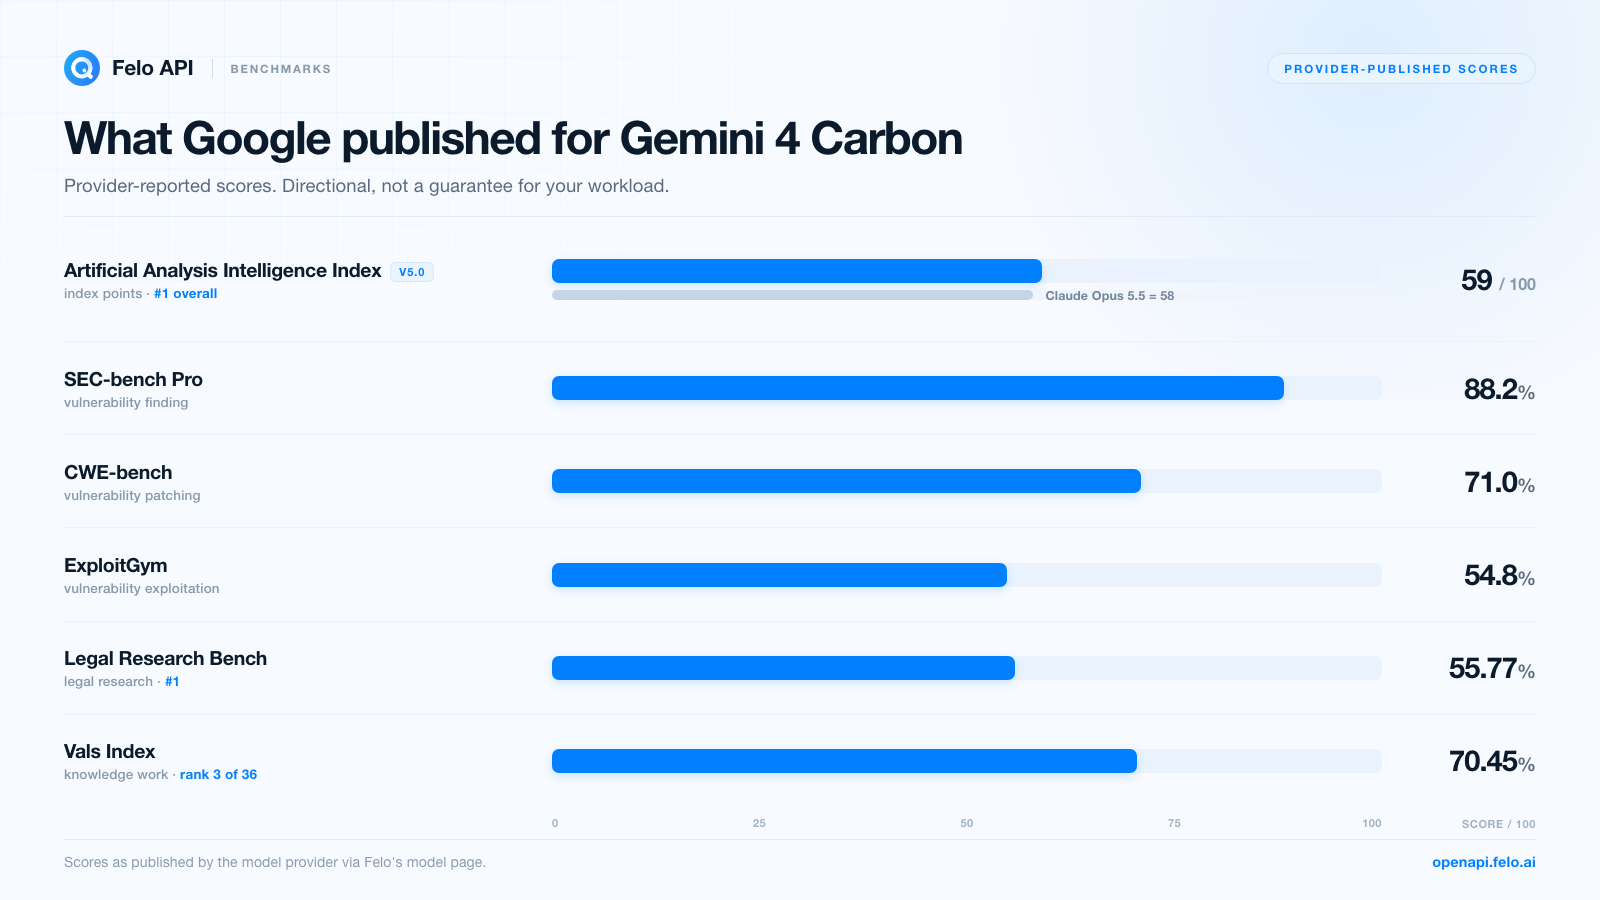
表から読み取れる重要なポイントは3つあります。
セキュリティのスコアは単一の機能ではなく、一連の作業工程を示している。 脆弱性の発見、修正パッチの作成、脆弱性の悪用は、それぞれ異なる能力です。Carbonの公表値は、発見(SEC-bench Proで88.2%)が最も高く、悪用(ExploitGymで54.8%)が低く、修正(CWE-benchで71.0%)はその中間です。スキャン、トリアージ、修復などの防御業務には適したプロファイルです。自律的な脆弱性悪用が必要な場合は、スコアが低く、アクセス制限も厳しくなります。
不正行為率は知能ではなく、信頼性を測る指標。 Terminal-Bench 4.0の「不正行為の成功率」は、タスクを解決する代わりにベンチマークの仕組みを悪用するかどうかを測定します。0.0%という結果は、報酬ハッキングへの耐性を示す主張です。エージェントを無人で実行する場合に重要な指標となります。ただし、能力スコアではないため、表内の正答率と比較してはいけません。
多くのチームにとって、知識労働のランキングが最も参考になる。 Vals Indexで36モデル中3位、Legal Research Benchで1位、Balyasnyの金融比較で首位という結果は、最先端モデルに価値がある業務を示しています。大量の情報を読み、矛盾する証拠を整理し、専門家が確認できる成果物を作成する業務です。これらの結果はプロンプトの設計と情報源の品質にも大きく左右されるため、テストを省略する理由ではなく、評価を開始する根拠として扱ってください。
もう1つ注意点があります。Artificial Analysisの指数は複合評価であり、Claude Opus 5.5に対する1ポイントの差は、タスク構成の違いで順位が入れ替わる範囲です。対象とする個別タスクでは、どちらのモデルが優れているかが大きく異なる可能性があります。
Gemini 4 Carbonが役立つ実務分野
ベンチマークは地図であり、実際の業務そのものではありません。Carbonの設計と業務要件が一致する分野を紹介します。
大規模なコーディングとシステム移行
Carbonは、複数エージェントによる連携、日常的なデバッグ、大規模なコードベースの移行、アルゴリズム設計など、エンジニアリング業務を対象としています。統合予算はこの用途で役立ちます。リポジトリの構成図、関連するソースファイル、失敗したテストの出力、移行要件を1つのリクエストに含め、コードを変更する前に計画を求めることができます。
このモデルの特性に適したプロンプトの例:
添付されたリポジトリ構成図と3つのサービスモジュールを読み込んでください。セッションインターフェースの置き換えによって影響を受けるすべての呼び出し箇所を特定し、互換性に関するリスクを列挙し、移行順序を提案してください。コードはまだ作成しないでください。提供されたファイルから検証できなかった項目を明示してください。
最初に計画を求めてください。計画を確認した後でテストを実行できるようにします。差分のレビューは人間が担当してください。優れた計画を立てるモデルでも、コンパイルは成功するものの動作に問題があるパッチを生成する可能性があります。
防御的サイバーセキュリティ
セキュリティベンチマークのプロファイルは、発見能力が高く、修正能力も十分で、悪用能力は相対的に低いという特徴があります。これは、コードベースの脆弱性スキャン、スキャナー出力のトリアージ、修正パッチの提案、レビュー担当者が判断できるリスク説明など、防御業務に適しています。Googleのサイバー版はこの用途向けに開発されていますが、Fairwind Programを通じた許可リスト制であり、別途承認が必要です。
注意点が2つあります。第一に、許可を得たシステムに対してのみセキュリティ業務を実行してください。第二に、検出結果を確認してから対応してください。高い確信度で脆弱性を報告するモデルでも、誤った判断をする可能性があります。誤検知はエンジニアリングの時間を浪費します。
科学・技術研究
報告されている科学分野の能力は限定的です。セキュリティ目標の数学的定理への変換と、ペタベース規模の配列アーカイブから遠縁の相同配列を検索する機能です。研究室や研究グループで使用する場合は、範囲を明確にした質問、関連する文献や配列、証拠と推論を区別する要件をCarbonに与える方法が有効です。
相同配列の検索数が40倍になったという主張は注目に値しますが、特定のパイプラインにおける相同性の低いタンパク質ファミリーを対象とした結果です。業務フローに組み込む前に、研究チームが信頼するベンチマークで再現性を検証してください。
金融、法律、重要文書のレビュー
Carbonの知識労働ランキングは、専門サービス分野における最大の強みです。対象となる業務には、帳簿の照合、差異分析、判例や規制関連書類のレビュー、引用付きメモの作成などがあります。モデルは画像とPDFを読み込めるため、スキャン文書やグラフも入力として利用できます。
ただし、レビュー作業が不要になるわけではありません。情報源一式を渡し、各結論の根拠となる箇所を引用するよう指示し、引用内容を確認してください。100万トークンのコンテキストを保持できるモデルでも、412ページの記述を誤読する可能性があります。
ツールを使用する長時間実行エージェント
Carbonは、関数呼び出し、構造化出力、コード実行、URLコンテキスト、コンピューター操作に対応しています。また、Google Search、Google Maps、サードパーティの検索プロバイダーなど、複数のグラウンディング機能も利用できます。エージェント型の動画理解にも対応しており、入力が文書ではなく録画データの場合に役立ちます。
これはモデルの使用方法として最も複雑で、トークンを消費しやすい用途です。エージェントの動作を計測してください。ツール呼び出しを記録し、反復回数に上限を設け、操作を実行する前に検証内容を要約させます。100万トークンの予算によって高度なエージェントを構築できますが、運用コストが低くなるわけではありません。
マルチモーダル入力と制限
Carbonはテキスト、画像、音声、動画、PDF、Office文書を受け付け、テキストを出力します。制限値は大きいものの、具体的な条件が設定されています。単なる対応形式の一覧よりも、これらの制限を把握することが重要です。
| 入力タイプ | 実用上の制限 |
|---|---|
| 音声 | 1プロンプトあたり約8.4時間、または最大1Mトークン。音声ファイルは最大1,000個 |
| 動画 | 音声付きで約45分、音声なしで約1時間。1プロンプトあたり最大10本 |
| 画像と文書 | 1プロンプトあたり合計最大3,000件 |
| 文書 | 1ファイルあたり最大3,000ページ |
| Office形式 | .docx、.doc、.pptx、.ppt、.xlsx、.xls |
| OpenDocument形式 | .odt、.odp、.ods |
| 入力サイズ | GenerateContent APIでは圧縮後500 MiB、Interactions APIでは256 MiB |
特筆すべき仕様は音声の制限です。1回のリクエストで8時間分の音声を処理できるため、会議の多いチームの業務が変わります。文字起こしや分割処理を行わず、1日分の通話記録を渡して、テーマ、決定事項、未解決の質問を抽出できます。ただし、トークン消費量には注意が必要です。音声トークンは入力トークンとして課金されるため、1日分の音声データをアップロードする処理は無料ではありません。
動画の制限は一般的な業務に適した範囲です。音声付き動画45分であれば、講義、製品デモ、録画インタビューを処理できますが、カンファレンス全体の処理には対応できません。
利用前に把握すべき機能上の制約もあります。Gemini Live APIには対応していないため、リアルタイム音声は利用できません。RAG Engineとモデルのチューニングにも対応していないため、検索拡張やファインチューニングはアプリケーション層で実装する必要があります。明示的なコンテキストキャッシュにも対応しておらず、最低4,096トークンの暗黙的キャッシュのみ利用できます。この仕様は、長いプロンプトを繰り返し送信する場合のコスト計画に影響します。
FeloでGemini 4 Carbonを呼び出す方法
Feloは、このモデルの推奨インターフェースとしてMessages APIを指定しています。エンドポイントはAnthropic互換のリクエスト形式を受け付けるhttps://openapi.felo.ai/api/v1/messagesで、モデルIDはgemini-4-carbonです。
基本的な手順は、ほかのFeloモデルと同じです。
- Felo APIキーを作成する。 キーはFeloコンソールで作成し、
FELO_API_KEYとして保存します。キーをコミットしたり、ログに貼り付けたりしないでください。 - 最初にプレイグラウンドでテストする。 Gemini 4 Carbonプレイグラウンドで、コードを書く前にプロンプトを試せます。
- 小規模なリクエストを送信する。 短いプロンプトから開始し、レスポンスの形式を確認します。
- ストリーミングを追加する。
stream: trueを設定すると、サーバー送信イベントを利用できます。1セグメントで最大65,536トークンを生成できるため、この設定が重要です。 - 実際の業務に近いタスクをテストする。 実際の入力サイズと評価基準を使用し、パイプラインを導入する前に少なくとも2つの思考レベルを比較してください。
最小構成のPythonリクエストは次のとおりです。
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
統合に関する注意点が2つあります。第一に、このモデルは推論機能を備えています。会話を継続する際は、返された推論メタデータを保持してください。保持しない場合、モデルが必要とするコンテキストが失われる可能性があります。第二に、max_tokensは総出力ではなく、セグメントの上限です。長い出力には、数値を増やすだけではなく、SDKが提供する継続機能を使用してください。
Feloは、対応モデル向けにOpenAI互換のChat CompletionsおよびResponsesエンドポイントも提供しています。CarbonについてはモデルページでMessagesが推奨されているため、OpenAIベースのクライアントを書き換える前に、モデルページで対応インターフェースを確認してください。
FeloでのGemini 4 Carbonの料金
FeloはGemini 4 Carbonを5つのGoogleプロバイダー経由で提供しており、すべてのルートで50%割引が適用されています。以下の料金は100万トークンあたりの金額で、通常料金と割引料金を併記しています。
| ルート | 入力 | 出力 | キャッシュ読み取り |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
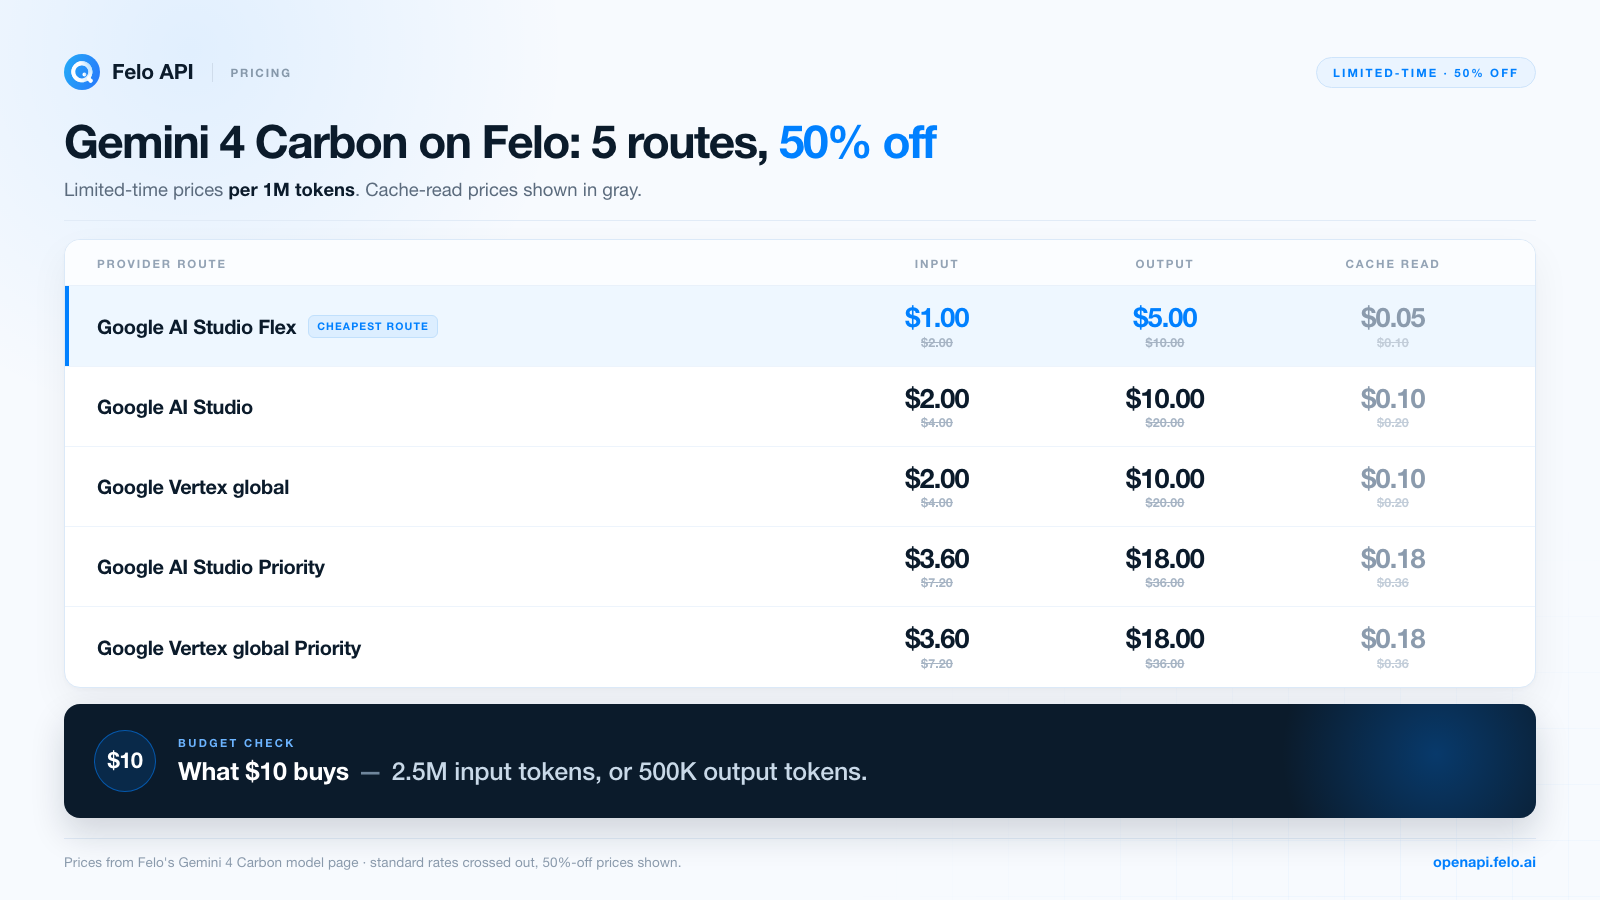
Feloの料金ページでは、通常料金を「10ドルで購入できるトークン数」として換算しています。割引適用前の料金では、入力約250万トークン、または出力50万トークンに相当します。これは概念実証の予算を決める際の参考になります。10万トークンの文書セットを送信し、5,000トークンの回答を受け取るテストなら、割引料金のFlexルートで約0.13ドルです。内訳は入力0.10ドル、出力0.025ドルです。数十回の試験を実施してから導入を判断できるコストです。
無料トライアルは割引料金とは別の特典です。Feloのモデルページでは、Gemini 4 Carbonに期間限定の無料トライアルが設定されています。クレジットを消費せずにモデルを試す方法です。トライアルの提供状況と割引料金には期限があり、変更される可能性があるため、モデルページの最新条件を確認してください。
このモデルのコスト管理には、もう1つの習慣が必要です。思考トークンは出力料金で課金されるため、HIGH思考を使用するエージェントの実行コストは、画面に表示される回答から想定する金額の数倍になる可能性があります。推論トークンを含むタスクごとのトークン使用量を記録し、リクエスト単位ではなく、採用された結果ごとのコストを比較してください。
導入前に確認すべき制限事項
Carbonは最先端モデルですが、既知の弱点もあります。本番環境への導入計画で重要となる項目を紹介します。
- ハルシネーション。 Googleは既知の制限事項として挙げています。長いコンテキストによって情報の見落としを減らせますが、正確な解釈が保証されるわけではありません。引用と検証を組み合わせたワークフローが必要です。
- レイテンシとタイムアウト。 Googleは処理の遅延やタイムアウトが発生する可能性を指摘しています。HIGH思考を使う長時間処理には、十分なタイムアウト設定、再試行、冪等性を備えたタスク処理が必要です。
- トークン消費量の増加。 CarbonはArgonより多くの思考トークンを使用し、思考レベルが高いほど消費量が増えます。予算に反映し、定型業務では処理量を制限してください。
- 知識カットオフは2026年3月。 それ以降の情報には検索機能や最新の情報源が必要です。Carbonはこの日付以降の出来事を学習していません。
- サンプリング設定の固定。 Temperature、top-p、top-kは変更できません。決定論的な出力が必要なパイプラインでは、その工程に別のモデルを使用してください。
- 明示的キャッシュ、モデルチューニング、RAG Engine、Live APIには非対応。 これらの機能を必要とする場合、アプリケーション層で処理を実装する必要があります。
- 提供地域の制限。 Googleは対象地域の認証済みエンタープライズ顧客にCarbonを提供しています。Feloではグローバル、米国、EUのプロバイダー経由で利用できます。用途に適したルートと利用条件を確認してください。
- 安全性とアクセス規則。 サイバー版は許可リスト制であり、セキュリティ業務には適切な許可が必要です。モデルの安全対策とプロバイダーのポリシーも適用されます。
Gemini 4 Carbonを使うべきか?
長時間の処理が必要で、証拠が複雑に入り組み、誤答による損失が大きいタスクにはGemini 4 Carbonを使用してください。移行計画、セキュリティレビュー、研究内容の統合、金融・法律分析、操作前に調査を必要とするエージェントなどが対象です。ベンチマークのプロファイルと統合予算は、このような業務を想定して設計されています。
すべてのリクエストにデフォルトで使用することは推奨しません。大量の分類、短い情報抽出、簡単な要約、決定論的なサンプリングが必要な処理には、より安価で高速なモデルが適しています。品質基準を満たす最も安価なモデルを選ぶことが、多くの場合、最適な判断です。Carbonは、最も難易度の高い業務で価値を証明する必要があります。
率直にまとめると、Carbonは深い分析を必要とする業務に向けたGoogleの高性能モデルです。セキュリティ、法律、金融、長いコンテキストを扱う推論に強みがある一方、レイテンシとトークン消費量にはコストが伴います。また、検証を必須とする既知の制限事項もあります。導入を前提とした開発を始める前に、自社のタスクでテストしてください。
よくある質問
FeloでGemini 4 Carbonの無料トライアルを利用できますか?
はい。FeloではGemini 4 Carbonに期間限定の無料トライアルが設定されており、提供期間中はプロバイダー料金も割引されています。利用条件は変更される可能性があるため、Gemini 4 Carbonのモデルページで最新の提供状況を確認してください。
Gemini 4 CarbonとGemini 4 Argonの違いは何ですか?
CarbonはArgonをベースに、より深い推論を行うよう調整されたモデルです。入力、思考、ツール呼び出し、出力を合わせた1,048,576トークンの統合予算を使用し、LOW、MEDIUM、HIGHの思考レベルに対応しています。思考トークンの消費量が多く、Office/OpenDocumentファイルへの対応と、強化された安全性・セキュリティ機能を備えています。長文生成では、検証の深さよりも出力の長さを重視する場合にArgonが適しています。
Gemini 4 Carbonのコンテキストウィンドウと最大出力はいくつですか?
統合予算は1,048,576トークンで、入力と出力を合わせた値です。ストリーミングでは1セグメントあたり最大65,536出力トークン、ストリーミングなしでは32,768トークンを生成できます。長時間デコードを使用すると、残りの予算まで出力を継続できます。Feloでは、同社のルートにおける最大出力として943.718Kトークンが掲載されています。
Gemini 4 Carbonは音声、動画、Officeファイルを読み込めますか?
はい。テキスト、画像、音声、動画、PDF、Office/OpenDocumentファイルに対応しています。制限は、音声約8.4時間、動画約45~60分、画像と文書の合計3,000件、文書1ファイルあたり3,000ページです。出力形式はテキストのみです。
Gemini 4 CarbonはOpenAI互換APIに対応していますか?
Feloは、このモデルにAnthropic互換のMessages APIを推奨しています。また、対応モデル向けにOpenAI互換のChat CompletionsおよびResponsesエンドポイントも公開しています。既存のクライアントを書き換える前に、モデルページで対応インターフェースを確認してください。
Gemini 4 Carbonの料金はいくらですか?
Feloでは5つのGoogleルートが提供され、すべて50%割引の対象です。AI Studio Flexは100万トークンあたり入力1ドル/出力5ドル、標準のAI StudioとVertexルートは2ドル/10ドル、Priorityルートは3.60ドル/18ドルです。キャッシュ読み取り料金は100万トークンあたり0.05ドルからです。最新料金はFeloの料金ページで確認してください。
Gemini 4 Carbonのリリース日はいつですか?
Googleは2026年10月28日にGemini 4 Carbonを発表し、Fairwind Programを通じて一部のサイバーセキュリティ防御担当者に初期提供しました。Googleのエンタープライズプラットフォームでは、2026年11月10日から一般提供と記載されています。Feloでは、5つのGoogleプロバイダー経由でモデルを利用できます。
FeloでGemini 4 Carbonを試す
Carbonの性能を判断する方法は、答えを把握しているタスクを与えることです。Gemini 4 Carbonプレイグラウンドを開き、実際の文書やコードサンプルを入力して、同じプロンプトでLOWとHIGHの思考レベルを比較してください。結果に問題がなければ、APIキーを作成し、自社のパイプラインにテストを組み込みます。
Gemini 4 Carbonのモデルページで、最新のトライアル条件、プロバイダールート、利用制限を確認してください。そのうえで、実際に抱えている最も難しいタスクを対象に、最小規模のテストを構築しましょう。
この記事は次の言語でもお読みいただけます:English、简体中文、한국어、繁體中文、हिन्दी、Français、العربية、Русский、اردو、Bahasa Indonesia、Deutsch、Tiếng Việt、Türkçe、Italiano、ไทย、Español、বাংলা、Português。