
FeloのGPT Image 2.6:GIFを動画ショットに変換する方法

FeloのGPT Image 2.6でループGIFを作成し、APIでアクションフレームを生成して、Klingで動画化する方法を解説します。コードと制限事項も紹介します。
動画モデルに「剣を振る騎士」と指示しても、生成される剣の振り方は曖昧なものになりがちです。刃の形はぼやけ、フレームごとに体の比率が変わり、カメラは誰も求めていない動きを加えてしまいます。
映画監督はブロッキングによって、この問題を解決します。キャラクターがどこに立つのか、何が最初に動くのか、動作がどこで終わるのかを決める手法です。FeloのGPT Image 2.6を使えば、ブラウザー上で1.8秒のループGIFとして、または画像APIを通じて3 × 3のフレームシートとして、その動作プランを作成できます。どちらも、動画モデルに照明、構図、音響を任せるための費用を支払った後で動作を決めるより、低コストです。
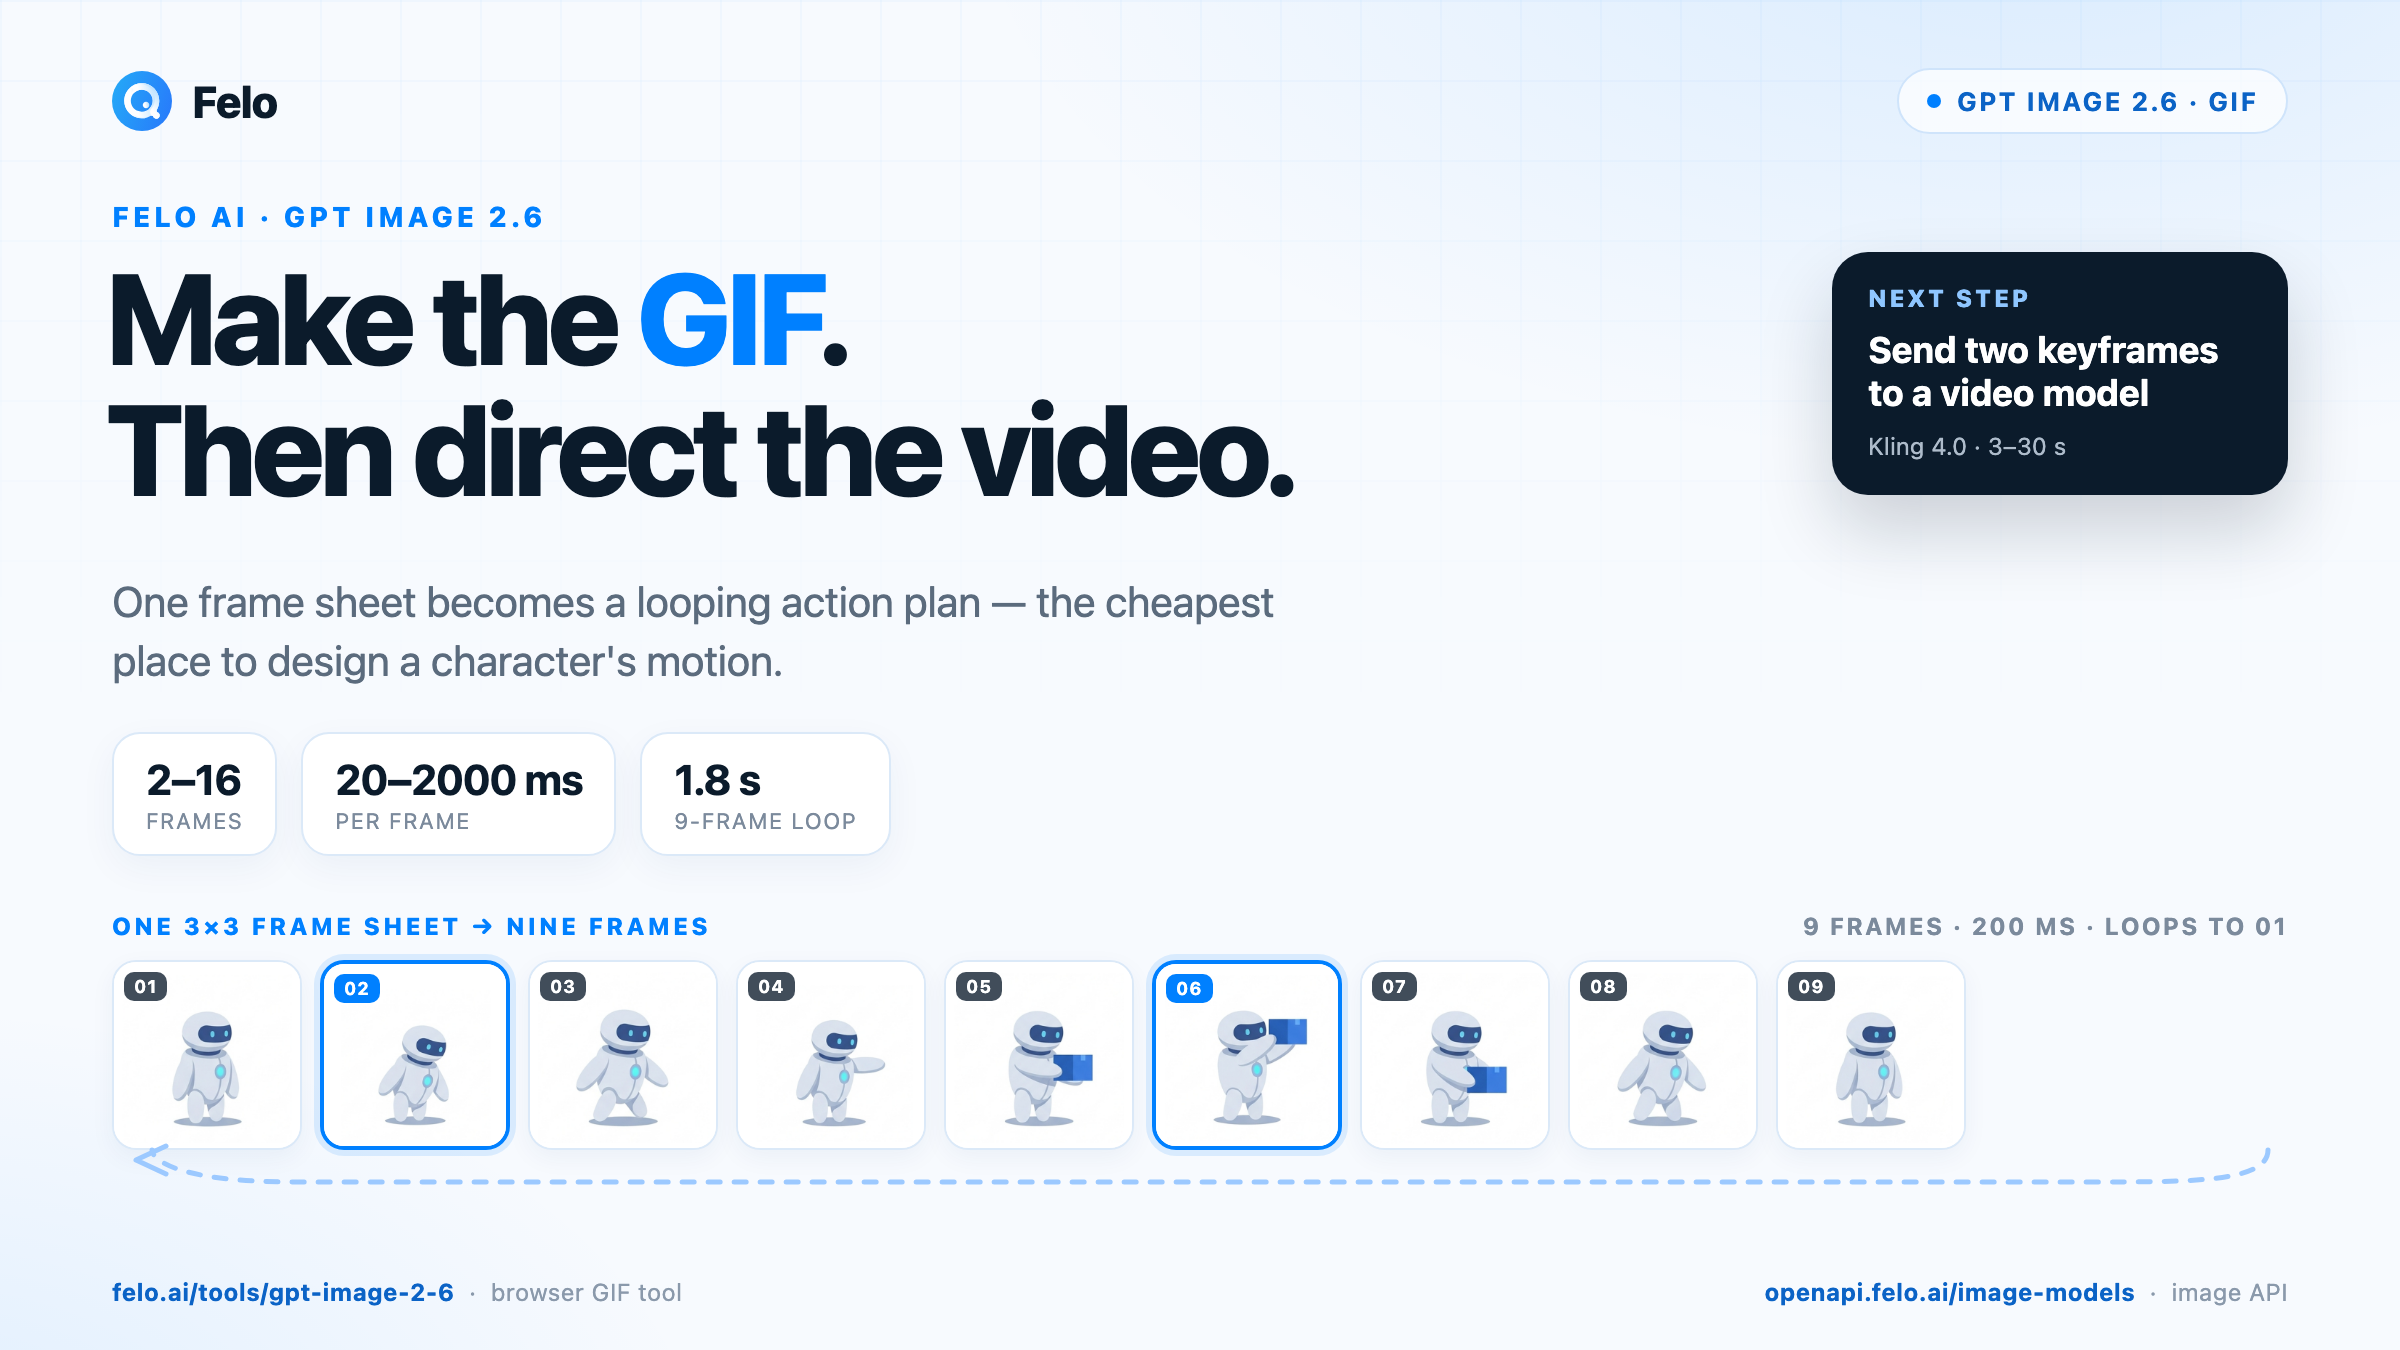
FeloでGPT Image 2.6を使う2つの方法
ブラウザーで使う:AI GIFジェネレーター
felo.ai/tools/gpt-image-2-6を開き、画像の内容を説明してモデルを選択します。入力ボックスのデフォルト設定はGPT Image 2.6 Flare、出力形式はPNGです。アニメーションを作成するには、設定を開いてGIFを選択します。プロンプトに「GIF」と入力するだけでは、出力形式は変更されません。
GIFの設定項目は、用途を絞った構成です。フレーム数は2~16、1フレームあたりの表示時間は20~2000ミリ秒、初期サイズは512 × 512です。Feloのデフォルト設定は9フレーム、各200ミリ秒で、1.8秒のループが生成されます。短い設定ですが、ジェスチャーが伝わるかを確認するには十分です。
参照画像のアップロード、編集指示、スケッチ機能による範囲指定にも対応しています。最初の動作テストでは、被写体を1つに絞り、背景をシンプルにして、動きを1つだけ指定しましょう。
出力例:200ミリ秒間隔の9フレームループ。ブラウザーツールはGIFを直接生成します。以下のエージェントワークフローでは、1枚の3 × 3シートから同じフレームを作成します。
APIで使う:エージェントやアプリ向け
同じ2つのモデルは、Feloの画像モデルカタログに、gpt-image-2.6-flareとgpt-image-2.6-sunburstというIDで掲載されています。1つのAPIキーで8つのプロバイダーが提供する18種類の画像モデルを利用できるため、エージェントはプロバイダーごとにアカウントを作成することなく、モデルの比較や切り替えができます。
| GPT Image 2.6 Flare | GPT Image 2.6 Sunburst | |
|---|---|---|
| 設計用途 | 高速なドラフト作成と頻繁な修正 | 詳細な画像と精密な編集 |
| モデルID | gpt-image-2.6-flare | gpt-image-2.6-sunburst |
| 入力 / 出力 | テキスト、画像 → 画像 | テキスト、画像 → 画像 |
| この用途での利点 | 動作アイデアの高速な検討 | パネル間のキャラクターの一貫性 |
| 掲載価格 | 入力トークン100万あたり$5、出力トークン100万あたり$30 | 入力トークン100万あたり$5、出力トークン100万あたり$30 |
料金は画像単位ではなくトークン単位です。そのため、解像度や参照画像の数によって費用が変わります。両モデルのページには期間限定の無料トライアルバッジが表示されています。本番環境での利用を計画する前に、現在の利用条件と料金を確認してください。
ブラウザーツールはGIFを出力しますが、画像APIが返すのは静止画像です。これらのモデルで使用できるoutput_formatの列挙値はpng、jpeg、webpです。そのため、エージェントは生成したフレームからGIFを作成します。具体的な方法は、以下のAPIセクションで説明します。
動画プロンプトよりGIFを最初のドラフトにする理由
動画モデルは補間エンジンです。2つの状態の間を埋める処理は得意ですが、どの状態が重要なのかを判断する処理は苦手です。テキストプロンプトでは、モデルが解釈する材料は1つの文章です。一方、9フレームのGIFでは、ポーズ、シルエット、タイミングについて9つの明確な指示を与えられます。
9フレームという制限によって、動作の選択も必要になります。1フレーム200ミリ秒では、曖昧な「ダイナミックなアクションシーン」を表現する余裕はありません。構え、振りかぶり、攻撃、振り抜き、元の姿勢への復帰という動作を指定する必要があります。動画プロンプトの質が低くなる主な理由は、こうした動作の選択が行われていないことです。
ループにはもう1つの制約があります。スムーズにループするGIFは、開始時のポーズに戻らなければなりません。この条件は、ショットの編集にも役立ちます。キャラクターの腕が別の位置で終わると、次のショットは異なる体の状態から始まってしまいます。
全体を数秒で確認できる点も利点です。シルエット、手、持ち物、最後のフレームと最初のフレームの接続部分を確認しましょう。動画の生成費用をかける前に、エージェントがフレームを比較したり、ビジョンモデルに変化の説明を求めたりできます。
Feloのツールページには、次の説明があります。「GIFは音声のないループです。音声、長いシーン、複数のショットが必要な場合は動画ツールを使用してください。」この説明がワークフローの出発点です。終着点ではありません。
ブラウザーで動作を作成する
キャラクターの動作を動画ショットにする前に設計するための、実践的なワークフローを紹介します。
1. 最初にキャラクターを固定する
アニメーションから始めてはいけません。まず、キャラクターの静止参照画像を生成します。正面向き、ニュートラルなポーズ、シンプルな背景を指定します。アニメーションを作成するときも、髪型、衣装の色、アクセサリー、武器、体の比率など、すべての詳細をプロンプトで同じに保ちます。別々の生成では一貫性が失われるため、説明を具体的にするほど、フレーム間でモデルが補う必要のある情報が減ります。
2. シーンではなくループとして動作を書く
有効な動作プロンプトは、次の4つの要素で構成されます。
- シーンを設定する。フレーム内に何があり、どこに立ち、どのような外見なのかを指定します。
- 1つの動きを指定する。何が、どの順番で動くのかを説明します。
- 変化させない要素を固定する。カメラ、足元、ロゴ、手などを指定します。
- 元の状態への復帰を指示する。開始時のポーズに戻る動作で終わらせます。
例:
からし色のジャケットを着た配達員が、淡い石畳の道路に立っている。横向き、全身、固定カメラ。体重を移動し、肩掛けバッグに手を入れ、小さな青い荷物を取り出して前方に差し出す。ジャケット、バッグ、カメラは動かさない。その後、荷物を下ろし、開始時のポーズに戻る。動作がスムーズにループするようにする。シンプルな背景、文字なし。
このプロンプトは意図的に単純な内容にしています。この用途では、単純さが重要です。明確な動作を1つ指定すれば、512 × 512、9フレームでも動きが伝わります。群衆、雨、カメラの移動は動画モデルに任せましょう。
3. 設定でGIFを選び、少ないフレーム数から始める
512 × 512、9フレーム、1フレームあたり200ミリ秒に設定して生成します。基本動作が伝わるまでは、フレーム数を増やさないでください。
ループが失敗した場合は、次の順番で修正します。まずフレーム数を減らして動作をシンプルにし、次にフレームの表示時間を長くし、その後、維持する必要のある詳細を追加します。
4. 中間部分だけでなく接続部分を確認する
ループを2回再生します。最後のフレームと最初のフレームの接続部分には、失敗の多くが現れます。肩の位置の急な変化、持ち物を持つ手の入れ替わり、背景のずれなどを確認してください。
その後、変更する変数を1つに絞ります。新しいポーズのアイデアには新しいプロンプトを使います。タイミングの調整にはフレーム数またはフレーム時間を変更します。両方を同時に変更すると、どの変更が効果をもたらしたのか判断できません。
GIFから動画へ:2つの引き渡し方法
Feloの動画APIは、アニメーションGIFを入力として受け付けません。静止画像または動画に対応しているため、引き渡しには変換工程が必要です。有効な方法は2つあります。もう1つの選択肢として、GIFを最終成果物にする方法もあります。
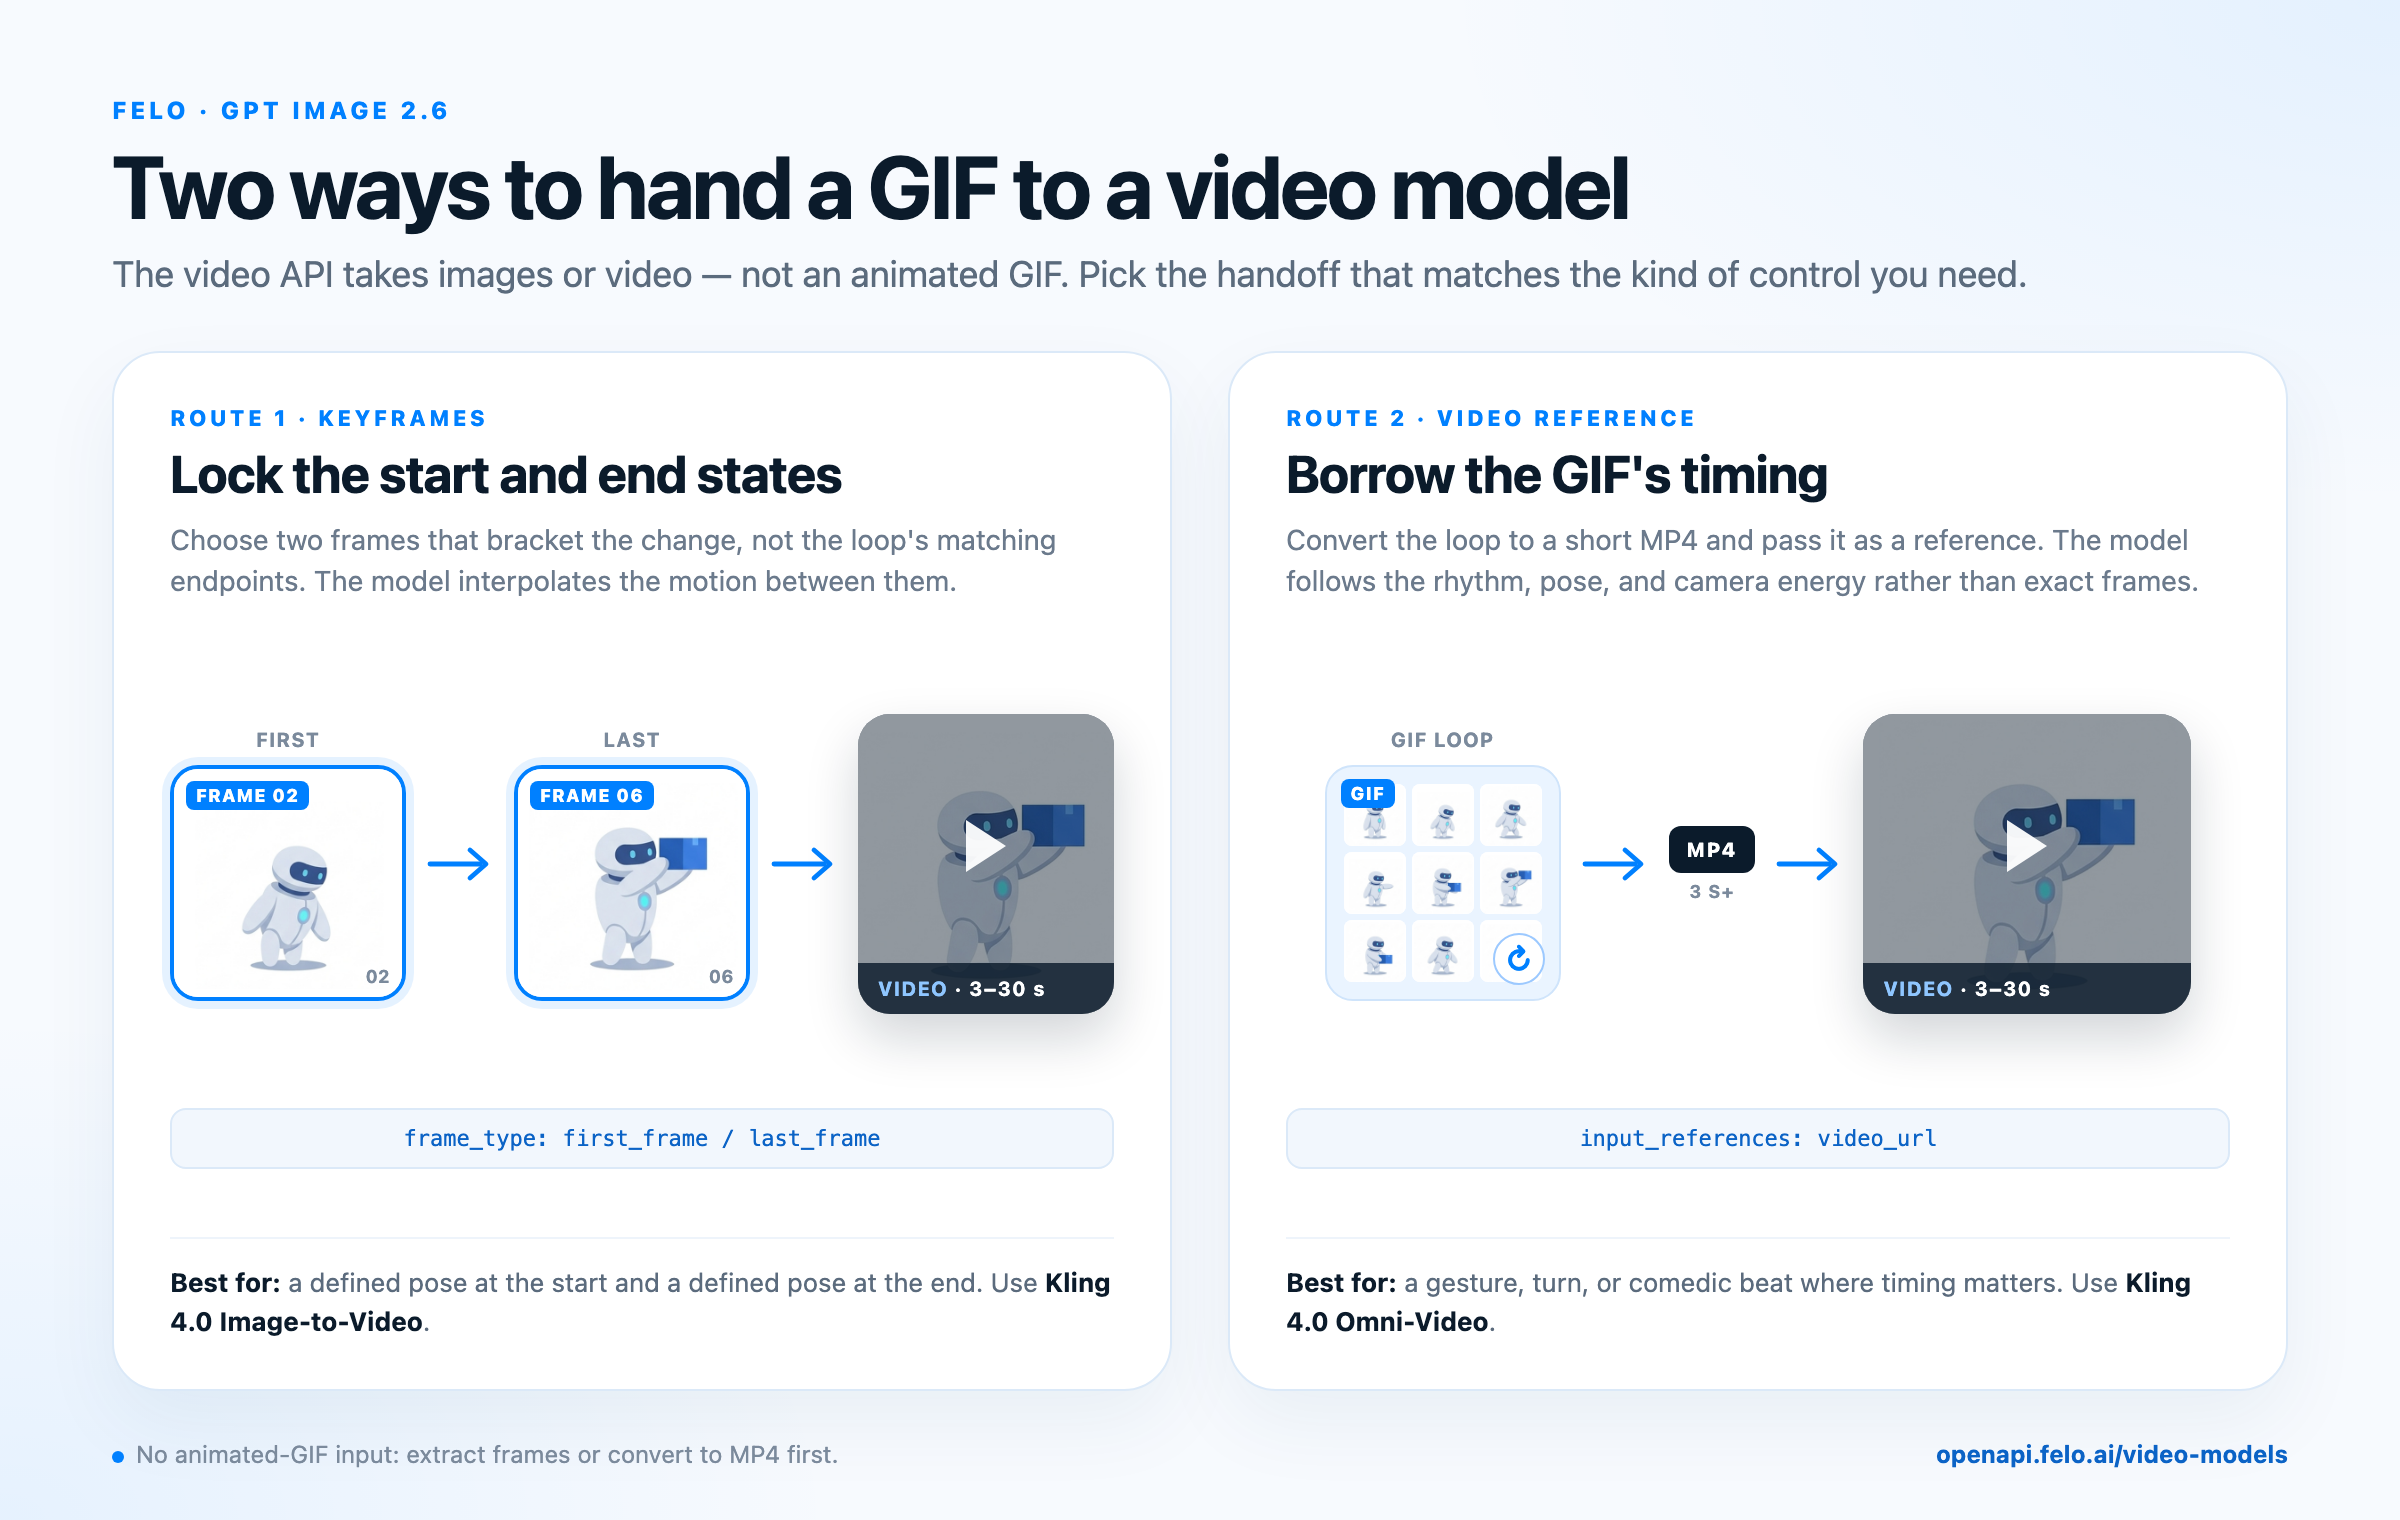
キーフレームは開始状態と終了状態を固定し、動画参照はGIFのタイミングを引き継ぎます。
方法1:開始と終了を明確にするキーフレーム
必要な変化を挟む2つのフレームを選択します。配達員の場合は、パネル2(体重移動)とパネル6(荷物を前方に差し出す状態)です。意図的に同じ状態にしてあるループの最初と最後のフレームではありません。frame_imagesとして送信し、frame_typeにはfirst_frameまたはlast_frameを設定します。
これにより、選択した開始状態と終了状態が固定されます。プロンプトでは、2枚の画像だけでは表現できないカメラの動き、照明、テンポを説明すれば十分です。
Kling 4.0 Image-to-Videoは、この用途に適しています。モデルのページには、対応パラメーターとしてframe_imagesが記載されており、ステレオ音声付きの3~30秒の動画クリップに対応しています。選択した2つのポーズを入力すると、モデルがその間の動きを補間します。
キーフレーム方式の短いプロンプト例:
同じ石畳の道路に立つ、同じからし色のジャケットを着た配達員が、肩掛けバッグに手を入れ、青い荷物を前方に差し出す。ゆっくりとした前進撮影、午後遅くの柔らかな光、浅い被写界深度。キャラクターの顔、服装、荷物は変更しない。自然な街の環境音。
動画モデルは、指定した2つのポーズの間の動きを補います。文章だけで動作全体を考案させる方法と比べて、モデルに任せる創作上の判断が少なくなります。
方法2:タイミングを引き継ぐ動画参照
動画のリズムをGIFに合わせたい場合は、ループを短いMP4に変換し、動画参照として渡します。動画APIのinput_referencesは、image_url参照に加えてvideo_urlエントリーを受け付けます。
ffmpeg -stream_loop 1 -i action.gif -t 3 -movflags +faststart -pix_fmt yuv420p action.mp4
Kling 4.0 Omni-Videoは、参照画像や動画を使った生成に対応するモデルです。モデルのページには、3~30秒の動画クリップを最大5本、合計30秒以内で入力できることに加え、画像参照を最大10枚使用できることが記載されています。これにより、動作スケッチとキャラクター画像を同じリクエストで送信できます。
タイミングが重要な場合は、この方法を選びます。3拍のジェスチャー、振り向き、コメディの間などが該当します。Omni-Videoが対応する動画参照は3~30秒です。書き出し前にGIFを3秒以上にループさせてください。250ミリ秒間隔の12フレームでも、この長さになります。
動画モデルが参照から引き継ぐのは、全体的なリズムとポーズです。フレーム単位で同じ映像を再現するわけではありません。特定の開始状態と終了状態が必要な場合は、キーフレームを使用してください。
GIFをそのまま使う方法
GIF自体が最終成果物になる場合もあります。ループステッカー、UIの状態表示、SNS投稿、ゲーム用スプライトには、動画モデルやサウンドトラックは必要ありません。FeloのGPT Image 2.6のモデル使用例には、ピクセルアートの水の剣のループ、人物の振り向きとウィンク、日本語のイベントバナーがあります。いずれも、少ないフレームで動作を伝える構成です。
GIF形式には明確な制約があります。1フレームあたり256色、音声なし、そしてサイズやフレーム数の増加に伴うファイルサイズの増大です。フラットな色とシンプルな背景は、色数の制限を目立たなくします。グラデーションや肌の色では、色の段差が発生する場合があります。
GPT Image 2.6 API:送信、ポーリング、取得
人間ならブラウザー上のGIF生成を見守ることができます。しかし、APIが明確なタスク仕様を提供しない限り、エージェントには同じことができません。FeloのAPIは、送信、ポーリング、取得という手順を提供しています。
画像エンドポイントは、Bearerキーを使用するPOST https://openapi.felo.ai/api/v1/images/generationsです。レスポンスは202とtask_idを返します。GET /api/v1/images/generations/{task_id}をポーリングし、statusがsucceededになるまで待ちます。その後、outputsから署名付きメディアURLを取得します。
リクエストボディでは、モデルID、プロンプト、quality、aspect_ratio、output_format、参照画像用のinput_referencesを指定できます。ローカルの参照画像が必要な場合は、最初にPOST /api/v1/filesでアップロードします。このエンドポイントはPNG、JPEG、GIF、WebP、MP4などの一般的な形式に対応し、最大100 MiBのファイルを受け付けます。レスポンスにはファイルレコードが含まれます。そのidをinput_referencesのfile_idとして渡します。
GIFが必要なエージェントには、1回の画像API呼び出しで動作全体をストーリーボードシートとして生成し、それをフレームに分割する方法が適しています。1回のリクエストで9つのポーズを指定し、決定的な処理で分割し、ローカルでGIFを組み立てます。動画生成にも同じフレームを使うため、同じ画像を2回生成する必要はありません。
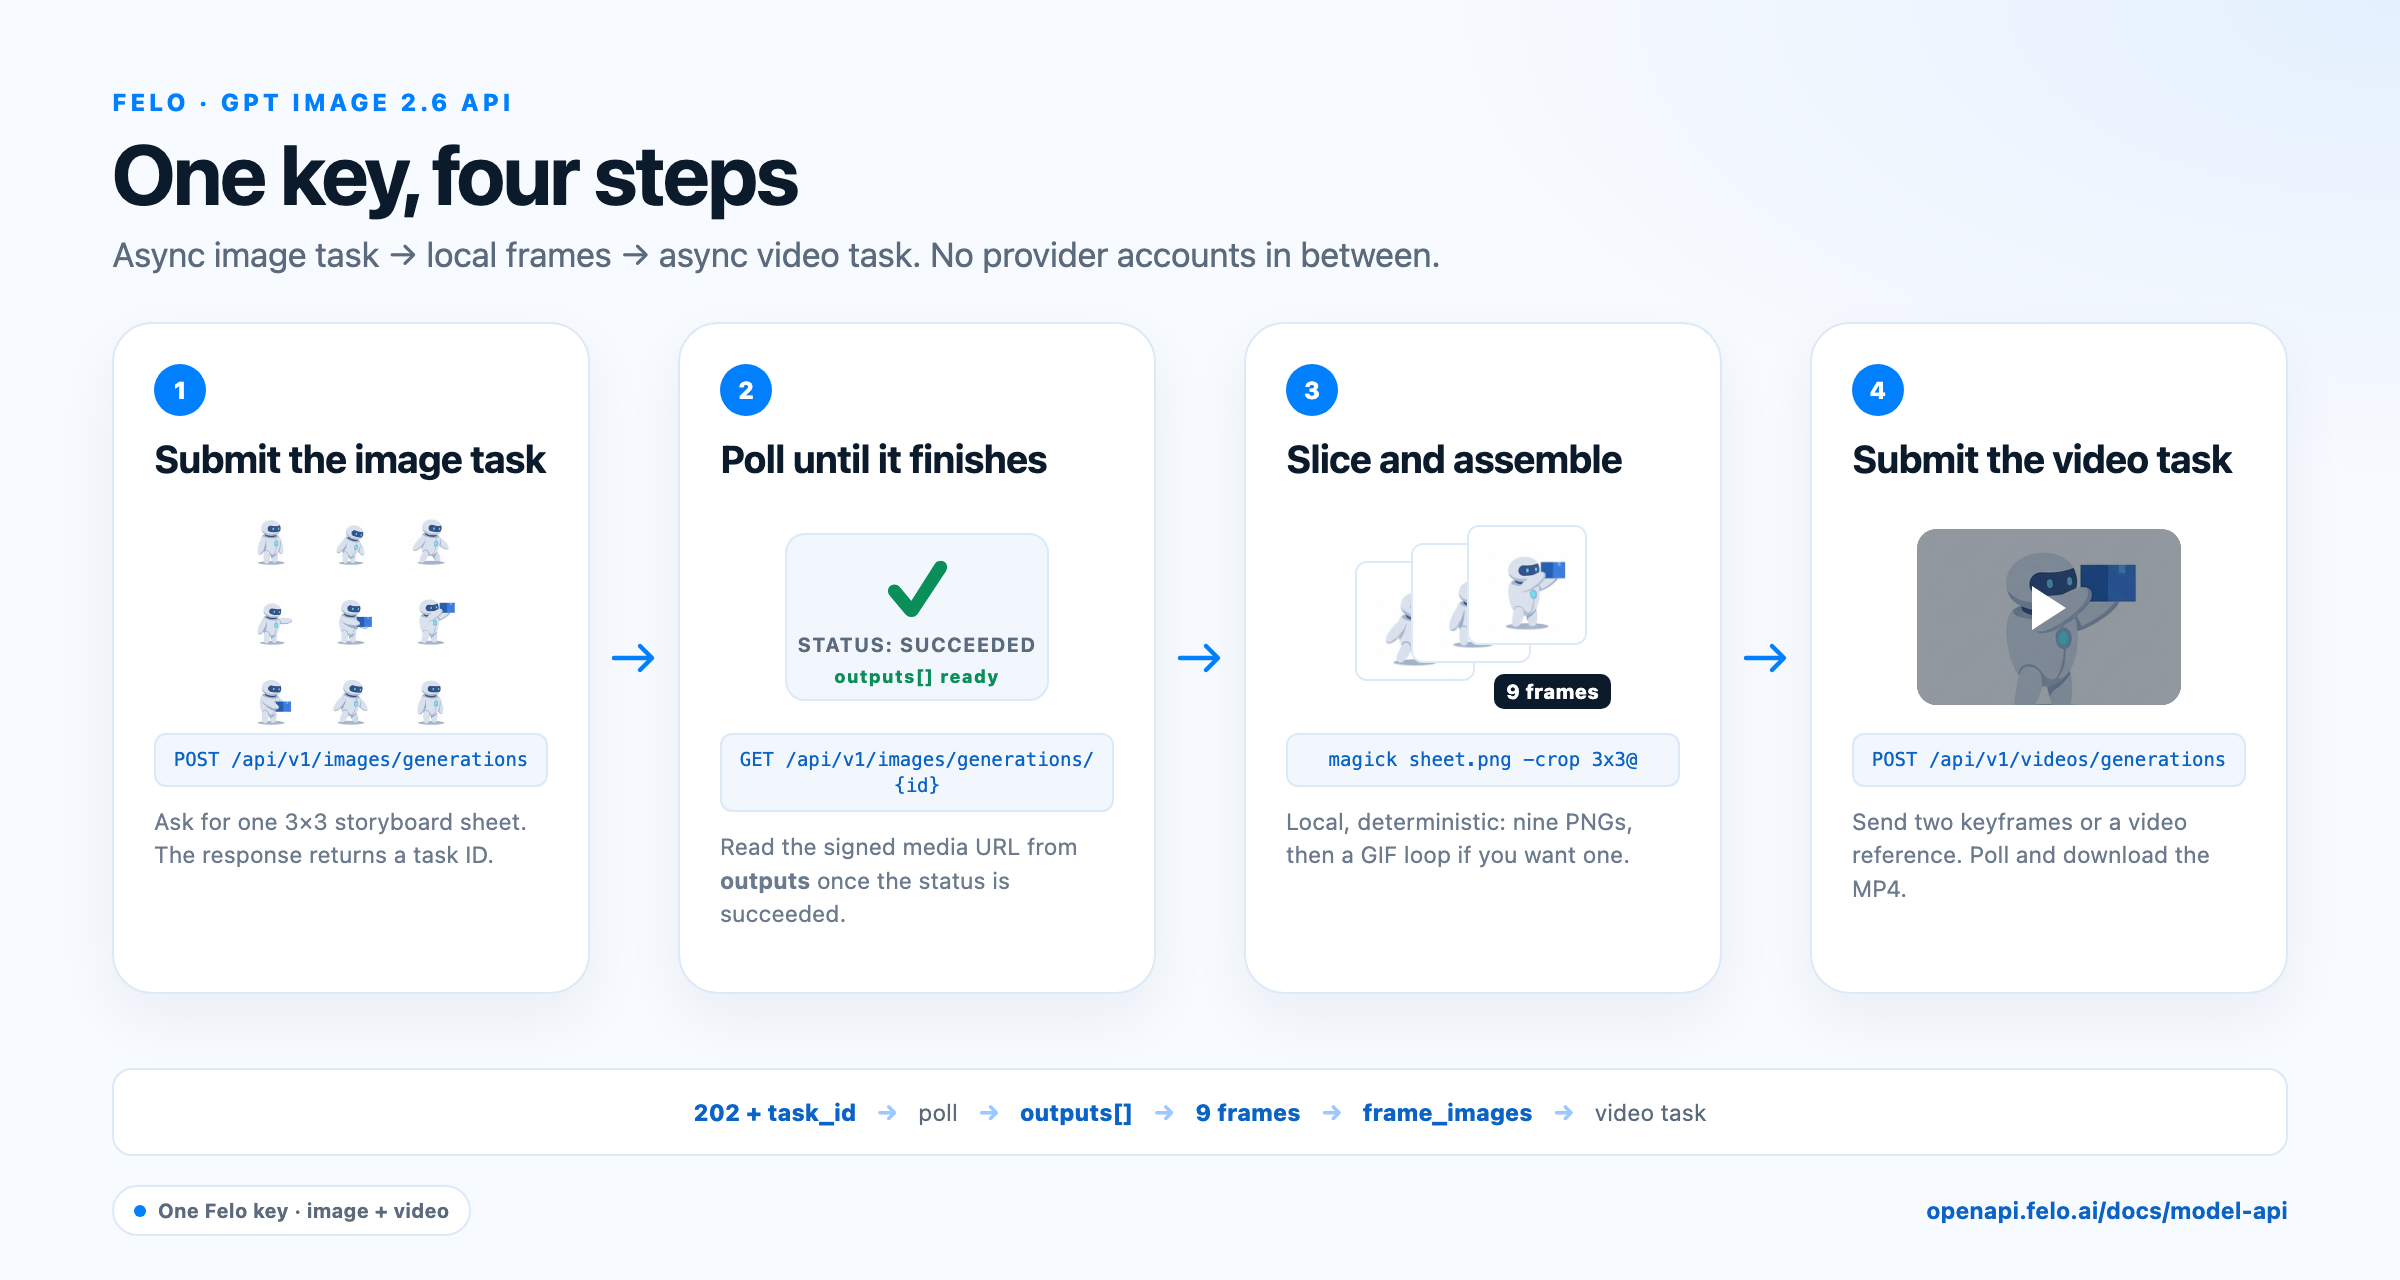
タスクの流れ:画像タスクを送信し、結果をポーリングで取得して、シートをローカルで分割し、フレームを使った動画タスクを送信します。
1回の呼び出しで9つのポーズを指定する
この処理に使うストーリーボードプロンプトの例:
白い無地の背景に配置した3 × 3のストーリーボードシート。9つの同じサイズの正方形パネルを隙間なく配置する。すべてのパネルに、からし色のジャケットを着た同じ配達員を描く。横向き、全身、体の比率、色、肩掛けバッグはすべて同一にする。パネル1:立っている。パネル2:体重を移動する。パネル3:バッグに手を入れる。パネル4:バッグを開ける。パネル5:青い荷物を取り出す。パネル6:荷物を前方に差し出す。パネル7:荷物を下ろす。パネル8:手を体の横に戻す。パネル9:パネル1と同じポーズ。フラットな照明、一定のスケール、文字なし、キャプションなし、パネル番号なし。
1Kサイズのシートをトリミングすると、各タイルは約340ピクセルになります。ブラウザーツールの512ピクセルのフレームより解像度が低くなります。利用するチャンネルで大きな正方形サイズを選択できる場合は、そのサイズを指定してください。分割する前にシートを確認します。パネルのサイズが不均一だったり、キャラクターの外見が変わったりした場合は、切り抜き後に修正するのではなく、レイアウト指示をシンプルにして再生成します。
送信、分割、組み立て
import os
import time
import requests

BASE = "https://openapi.felo.ai/api/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['FELO_API_KEY']}"}

def poll(path, timeout=900, interval=5):
    deadline = time.time() + timeout
    while time.time() < deadline:
        response = requests.get(f"{BASE}{path}", headers=HEADERS, timeout=30)
        response.raise_for_status()
        task = response.json()
        if task["status"] in {"succeeded", "failed", "interrupted"}:
            if task["status"] != "succeeded":
                raise RuntimeError(task.get("error", task["status"]))
            return task
        time.sleep(interval)
    raise TimeoutError(path)

STORYBOARD_PROMPT = (
    "A 3x3 storyboard sheet on plain white, nine equal square panels edge to edge, "
    "the same courier in a mustard jacket in every panel, side view, full body, "
    "identical proportions and colors: standing, shifting weight, reaching into a "
    "satchel, opening it, pulling out a blue parcel, holding it forward, lowering it, "
    "hand at side, standing again. Flat lighting, consistent scale, no text, no gutters."
)

response = requests.post(
    f"{BASE}/images/generations",
    headers=HEADERS,
    json={
        "model": "gpt-image-2.6-sunburst",
        "prompt": STORYBOARD_PROMPT,
        "aspect_ratio": "1:1",
        "quality": "medium",
    },
    timeout=60,
)
response.raise_for_status()

result = poll(f"/images/generations/{response.json()['task_id']}")
output = result["outputs"][0]
sheet_url = output["url"] if isinstance(output, dict) else output
with open("sheet.png", "wb") as file:
    file.write(requests.get(sheet_url, timeout=60).content)
次に、シートを分割し、ローカルでループGIFを組み立てます。
magick sheet.png -crop 3x3@ +repage -resize 512x512! frame-%02d.png
magick -delay 20 -loop 0 frame-*.png action.gif   # 20/100 s = 200 ms per frame
ImageMagick 6を使用している場合は、magickをconvertに置き換えます。プロンプトで隙間を作らないよう指定しているため、均等な切り抜きが可能です。
2つのキーフレームを動画モデルに送信する
def upload(path):
    with open(path, "rb") as file:
        response = requests.post(
            f"{BASE}/files", headers=HEADERS, files={"file": file}, timeout=60
        )
    response.raise_for_status()
    return response.json()["id"]

VIDEO_PROMPT = (
    "The same courier on the same stone street reaches into the satchel and holds "
    "out a blue parcel. Slow push-in, soft late-afternoon light, shallow depth of "
    "field. Keep the face, clothing, and parcel unchanged."
)

# Panels 2 and 6 bracket the change; the loop's matching endpoints do not.
first_id = upload("frame-01.png")
last_id = upload("frame-05.png")

video = requests.post(
    f"{BASE}/videos/generations",
    headers=HEADERS,
    json={
        "model": "kling-4.0/image-to-video",
        "prompt": VIDEO_PROMPT,
        "duration": 5,
        "resolution": "720p",
        "frame_images": [
            {"type": "image_url", "frame_type": "first_frame",
             "image_url": {"file_id": first_id}},
            {"type": "image_url", "frame_type": "last_frame",
             "image_url": {"file_id": last_id}},
        ],
    },
    timeout=60,
)
video.raise_for_status()
video_task = video.json()["task_id"]
動画タスクも同じ方法でポーリングし、署名付き出力URLから動画をダウンロードします。エンドポイントはPOST https://openapi.felo.ai/api/v1/videos/generationsです。画像タスクと同じく、タスクにはstatusとoutputsが含まれます。動画モデルの一覧は動画モデルページで確認できます。
エージェントに組み込む
エージェントは、少数の画像生成コストで複数の動作シートを生成し、それらを比較してから動画生成に費用をかけることができます。また、どのプロンプトがどのシートを生成したかを記録できます。人間がUIを操作するワークフローでは、この記録は困難です。
同じAPIキーでチャット、画像、動画モデルを利用できるため、ワークフロー全体を1つのエージェントに組み込めます。プランニングモデルが動作の各段階を記述し、画像APIがシートを生成し、ビジョンモデルが一貫性を確認し、動画APIがショットを完成させます。FeloはOpenAI互換およびAnthropic互換のベースURLに加え、Codex、Claude Code、DeepSeek Harness、OpenClaw、その他のエージェントクライアント向けのセットアップガイドを公開しています。既存のエージェントを再構築することなく、このプラットフォームに接続できます。
このワークフローで解決できないこと
GIFを最初に作成する方法は、動作設計の曖昧さを減らします。しかし、動画モデルをフレーム単位で正確に制御できるわけではありません。
- 動きにはずれが生じる。 動画モデルは補間を行うため、キーフレーム間で手の位置や衣服のしわが変わる場合があります。参照画像は役立ちますが、生成結果の確認が必要です。
- 短いものは短いまま。 2~16フレームで表現できるのはジェスチャーであり、シーンではありません。複数のジェスチャーを組み合わせてシーンを構成し、動画モデルにトランジションを任せます。
- フレーム内の文字は不安定。 フレーム間で文字が揺れる場合があります。タイトルはアニメーション内ではなく、デザインツールで追加します。
- モデル一覧は変わる。 トライアル条件と対応パラメーターは更新される情報です。本番環境にモデルIDを組み込む前に、モデルページまたはPlaygroundを確認してください。
FAQ
FeloのGPT Image 2.6でアニメーションGIFを生成できますか?
はい。ブラウザーツールで生成できます。GPT Image 2.6を選択し、設定を開いてGIFを選びます。設定では2~16フレーム、1フレームあたり20~2000ミリ秒に対応しています。初期サイズは512 × 512です。9フレーム、各200ミリ秒の設定で1.8秒のループが生成されます。
API経由でGPT Image 2.6を呼び出せますか?
はい。Felo API PlatformのPOST /api/v1/images/generationsで、モデルIDgpt-image-2.6-flareまたはgpt-image-2.6-sunburstを使用します。呼び出しにはFeloのAPIキーを使用するため、OpenAI、Google、Kuaishouのアカウントは必要ありません。API呼び出しは非同期です。タスクを送信し、ポーリングで状態を確認してから出力をダウンロードします。
画像APIはGIFファイルを返しますか?
現時点では対応していません。公開されている画像APIで、これらのモデルが対応する形式はpng、jpeg、webpです。それでもエージェントは、フレームシートまたは一連の静止画像を生成し、ImageMagickやffmpegでローカルに組み立てることでGIFを作成できます。動画生成の工程では個別のフレームが必要になるため、この方法は成果物の管理にも適しています。
FeloでGIFを動画に変換するにはどうすればよいですか?
GIFを動作プランとして使用し、2つの方法のいずれかで画像から動画へのAPIに渡します。変化を挟む2つのキーフレームを抽出してframe_imagesとして送信する方法、またはループをMP4に変換してvideo_url参照として渡す方法です。Feloの動画APIは、アニメーションGIFを直接受け付けません。
GPT Image 2.6でGIFを作成する費用はいくらですか?
両モデルともトークン単位の料金設定です。入力トークン100万あたり$5、出力トークン100万あたり$30です。そのため、解像度を上げたり参照画像を増やしたりすると費用も増えます。ブラウザーツールとAPIは、Feloの利用枠を使用します。現在の料金とトライアル条件はモデルページで確認してください。
ループから始める
AI動画の品質を高めるには、最初から動画を求めないことが有効です。確認できるサイズまで動作を小さくし、ループを作り、接続部分を修正してから、照明、カメラ、音声を追加できるモデルにフレームを渡します。
FeloのGPT Image 2.6を試して、ブラウザー上で最初のループを作成しましょう。エージェントにワークフローを組み込む準備ができたら、画像モデルAPIを確認し、APIキーを作成してリクエストを1回送信します。GIFは設計図です。動画はその演技です。
この記事は次の言語でもお読みいただけます:English、简体中文、한국어、繁體中文、हिन्दी、Français、العربية、Русский、اردو、Bahasa Indonesia、Deutsch、Tiếng Việt、Türkçe、Italiano、ไทย、Español、বাংলা、Português。