판별형 AI: 의사결정 모델, 사례 및 활용 분야

판별형 AI와 의사결정 모델이 입력을 분류하고, 전달하고, 점수를 산출하는 방식을 알아보세요. 생성형 AI와의 차이점 및 개발자를 위한 활용 분야도 살펴봅니다.
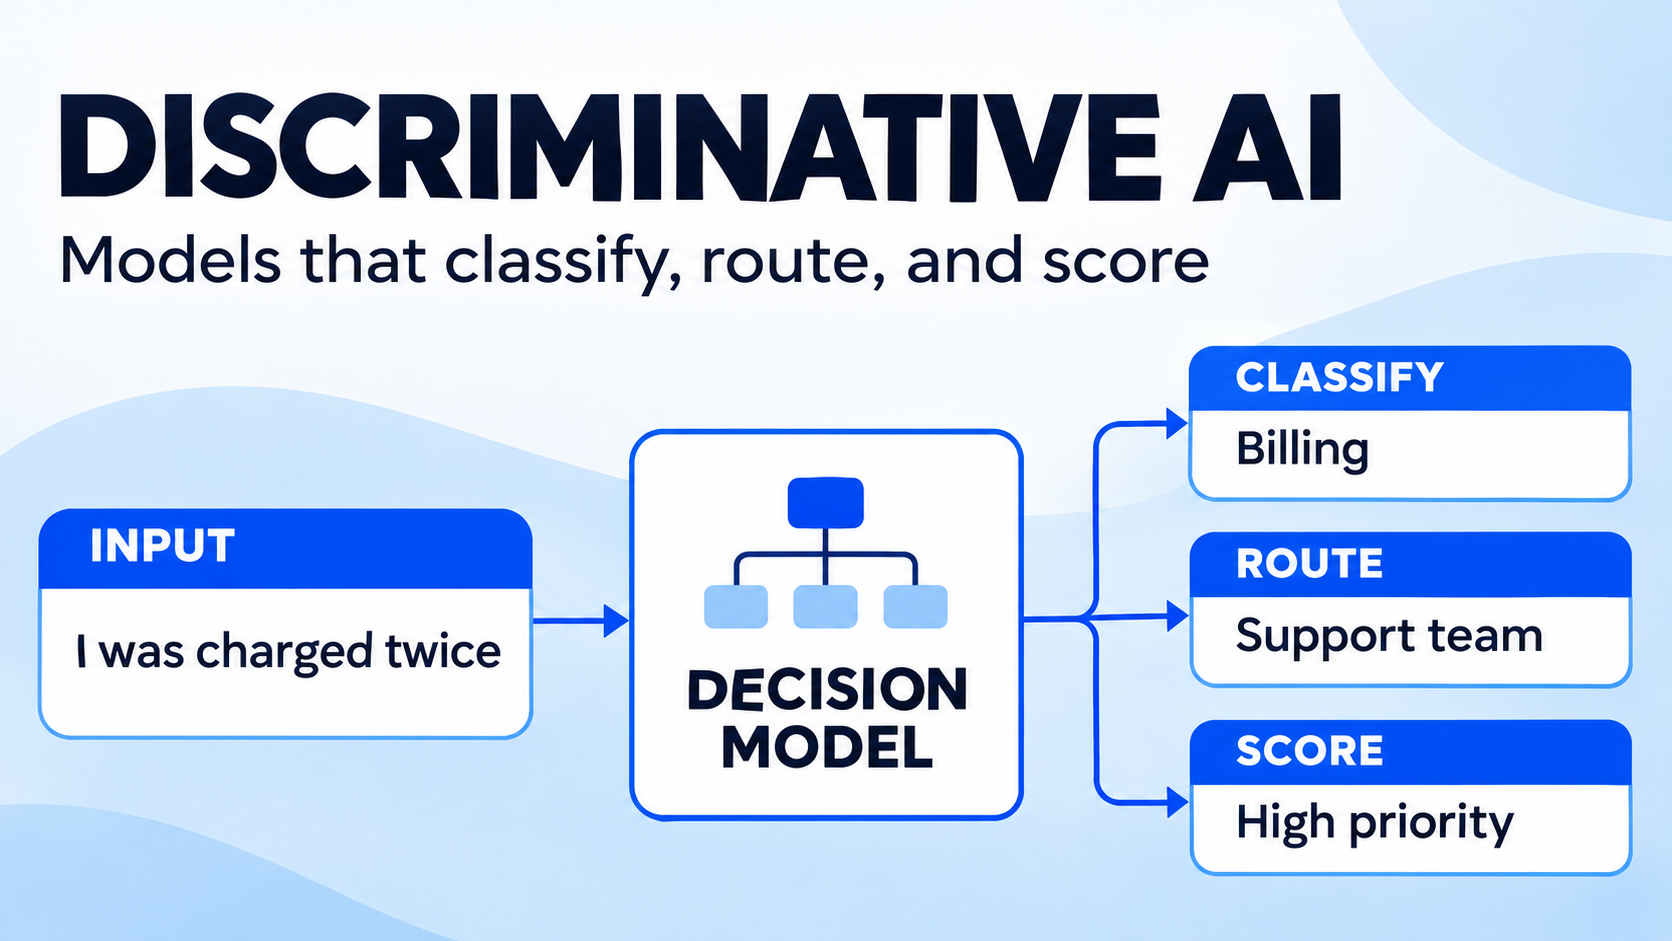
고객 지원 요청이 접수됩니다. "요금이 두 번 청구되었으니 환불이 필요합니다." 애플리케이션에 AI 모델이 작성한 문단이 필요한 것은 아닐 수 있습니다. 먼저 내려야 할 결정이 있을 수 있습니다. 이 문의를 결제팀, 기술 지원팀 또는 영업팀 중 어디로 전달해야 할까요?
**판별형 AI(Discriminative AI)**는 입력을 바탕으로 레이블, 점수 또는 기타 목표값을 예측하도록 설계되었습니다. 새로운 의사결정 모델 계열은 이러한 개념을 개발자 API에 적용합니다. 모델에 맥락과 명확한 질문을 제공하면 소프트웨어에서 활용할 수 있는 구조화된 결정이나 확률을 반환합니다. 이 가이드에서는 이러한 모델의 작동 방식, 생성형 AI와 함께 활용할 수 있는 분야, 모델 평가 방법을 설명합니다.
판별형 AI란 무엇인가요?
판별형 AI는 입력에 관한 특정 결과를 예측합니다. 스팸 필터는 이메일이 스팸인지 예측하고, 분류 모델은 고객 지원 문의를 담당 팀에 배정하며, 위험 평가 모델은 특정 결과가 발생할 가능성을 추정합니다.
머신러닝에서 판별형 모델은 일반적으로 입력 x를 목표값 y에 매핑하는 방법을 학습하거나 조건부 확률 **P(y | x)**를 추정합니다. 목표값은 클래스, 수치 또는 기타 구조화된 출력일 수 있습니다. 로지스틱 회귀, 서포트 벡터 머신, 다양한 신경망 분류 모델이 판별형 접근 방식의 사례입니다. 모든 판별형 모델이 확률을 반환하는 것은 아니며, 모든 수치 점수가 잘 보정된 것도 아닙니다.
이러한 기본 개념은 오늘날의 AI 어시스턴트보다 오래전부터 존재했습니다. 새롭게 등장한 것은 자연어로 작성된 작업 설명과 선택지를 받아 여러 분류 및 점수 산출 작업에 동일한 인터페이스를 적용할 수 있는 범용 의사결정 API입니다.
AI 의사결정 모델이란 무엇인가요?
현재 API 환경에서 **의사결정 모델(Decision Model)**은 제공된 입력에 관한 제한된 범위의 질문에 답하도록 설계된 모델 또는 서비스를 의미합니다. 자유 형식의 답변을 작성하는 대신 다음과 같은 유형화된 결과를 반환합니다.
- 예/아니요 확률: 이 메시지에 환불 요청이 포함되어 있을 가능성은 얼마인가요?
- 선택: 이 문의를 어느 부서에서 담당해야 하나요?
- 점수: 이 답변은 정의된 품질 평가 기준에서 어느 수준에 해당하나요?
예를 들어 의사결정 모델은 결제 관련 레이블과 각 부서에 대한 확률 추정치를 반환할 수 있습니다. 애플리케이션은 이러한 결과를 활용해 문의를 담당 부서로 전달하거나, 추가 정보를 요청하거나, 사람의 검토를 요청할 수 있습니다.
TypeSafe는 Jev 제품군을 "System One" 모델이라고 부릅니다. Liquid AI는 d1 의사결정 모델을 텍스트와 이미지를 입력받고 출력 토큰을 생성하지 않은 채 확률을 반환하는 모델로 설명합니다. 판별형 모델에 관한 Google Codelab은 애플리케이션에서 의사결정 모델을 생성형 모델과 함께 활용하는 방법을 보여줍니다.
두 용어는 관련이 있지만 서로 바꿔 사용할 수는 없습니다. 판별형 모델링은 광범위한 머신러닝 개념이며, 의사결정 모델은 제한된 범위의 의사결정을 위한 제품 또는 인터페이스입니다. 생성형 모델도 프롬프트를 통해 텍스트를 분류할 수 있지만, 내부 생성 프로세스와 응답 형식은 다릅니다.
판별형 AI와 생성형 AI 비교
| 판별형 AI | 생성형 AI | |
|---|---|---|
| 일반적인 질문 | "이 입력에 해당하는 카테고리는 무엇인가요?" | "어떤 응답이나 콘텐츠를 생성해야 하나요?" |
| 일반적인 출력 | 레이블, 예측값, 점수 또는 확률 | 텍스트, 코드, 이미지, 오디오 또는 기타 생성 콘텐츠 |
| 작업 사례 | 고객 문의를 담당 부서에 전달 | 고객에게 보낼 답변 작성 |
| 주요 강점 | 일관된 범위의 의사결정과 활용 가능한 점수 | 유연한 종합, 설명 및 콘텐츠 제작 |
| 주요 평가 항목 | 분류 오류, 확률 보정 및 임계값 | 정확성, 지시 이행, 안전성 및 유용성 |
하나의 모델이 한 가지 작업만 수행할 수 있다는 규칙은 없습니다. LLM은 JSON 형식의 레이블을 반환할 수 있으며, 의사결정 시스템은 더 큰 워크플로의 일부로 생성형 모델을 활용할 수 있습니다. 실질적인 차이는 각 구성 요소가 어떤 작업을 수행하도록 최적화되고 제공되는지에 있습니다. 구조화된 API 응답이 있다는 사실만으로 확률이 보정되었거나 내부 모델이 판별형 모델이라는 점이 입증되지는 않습니다.
환불 문의를 예로 들어보겠습니다. 의사결정 모델은 문제를 결제 관련 사안으로 식별하고 긴급도를 추정할 수 있습니다. 생성형 모델은 관련 환불 정책을 바탕으로 공감하는 어조의 답변을 작성할 수 있습니다. 애플리케이션은 조치를 실행하기 전에 정책, 권한 및 필수적인 사람의 승인 여부를 확인해야 합니다.
애플리케이션에서 의사결정 모델이 작동하는 방식
정확한 스키마는 제공업체마다 다르지만, 일반적인 의사결정 요청에는 세 가지 요소가 포함됩니다.
- 상태(State): 평가할 정보입니다. 문의 내용이나 이미지가 이에 해당합니다.
- 질문 및 기준: 내려야 할 결정과 허용된 답변 또는 점수 수준에 대한 설명입니다.
- 유형화된 응답: 애플리케이션이 해석할 수 있도록 반환되는 레이블, 점수 또는 확률 분포입니다.
예를 들어 다음과 같습니다.
State: "I was charged twice for my subscription."
Question: Which team should handle this request?
Options: billing, technical support, sales
Illustrative result: billing
이는 개념을 설명하기 위한 예시이며 실제 API 응답은 아닙니다. 엔드포인트에 따라 모델은 신뢰도 또는 확률을 함께 제공할 수도 있습니다. 모든 제공업체가 동일한 요청 형식을 사용하거나 같은 입력 유형을 지원한다고 가정하지 말고 해당 모델과 API의 문서를 확인하세요.
확률 점수는 무엇을 의미하나요?
예측 확률은 그 신뢰성을 이해할 때만 유용합니다. 시스템이 유사한 예측에 0.8이라는 값을 부여한다면, 확률 보정이 잘된 시스템은 해당 그룹에서 약 80%의 예측이 맞아야 합니다. 단일 예측에 부여된 0.8이라는 점수가 개별 결정의 정확성을 보장하지는 않습니다.
자체 데이터를 활용해 확률 보정을 확인하세요. 특히 모델, 레이블, 언어 또는 입력 출처를 변경한 경우에는 검증이 필요합니다. 신뢰도가 낮은 사례를 검토 대상으로 전달하기 위해 임계값을 설정할 수 있지만, 위양성과 위음성의 비용을 고려해 해당 임계값을 선택해야 합니다. 사기 검토 대기열과 무해한 콘텐츠 추천에는 서로 다른 기준이 필요합니다.
판별형 AI의 사례 및 활용 분야
고객 지원 문의 분류 및 전달
의사결정 모델은 접수된 메시지를 결제, 기술 지원 또는 계정 관리 부서에 배정할 수 있습니다. 모호한 요청과 여러 문제가 포함된 메시지를 처리할 수 있도록 '기타' 또는 '검토 필요' 경로를 추가하세요. 전체 정확도뿐 아니라 카테고리별 오류율도 평가해야 합니다. 일반적인 질문이 대부분인 데이터셋에서는 좋은 성능을 보이더라도 긴급한 결제 불만을 놓치는 모델일 수 있습니다.
콘텐츠 조정
콘텐츠 조정 워크플로에서는 콘텐츠가 정의된 정책 카테고리에 해당하는지 질문할 수 있습니다. 명확한 기준과 사례를 모델에 제공하고, 경계 사례를 평가하며, 불확실하거나 중요한 결과를 초래할 수 있는 사례는 숙련된 검토자에게 전달하세요. 의사결정 점수는 정책 적용 과정에서 참고하는 입력일 뿐, 콘텐츠가 규칙을 위반했다는 증거는 아닙니다.
LLM 및 에이전트 라우팅
LLM을 호출하기 전에 애플리케이션은 요청을 주제, 복잡성 또는 필요한 입력 유형에 따라 분류할 수 있습니다. 라우팅 구성 요소는 그 결과를 바탕으로 워크플로를 선택하거나 추가 정보를 요청할 수 있습니다. 다운스트림 시스템까지 포함해 라우팅을 테스트하세요. 첫 번째 단계의 비용이 낮더라도 어려운 요청을 잘못된 경로로 계속 전달한다면 실질적인 이점이 없습니다.
문서 및 이미지 분류
멀티모달 의사결정 모델은 송장, 영수증 또는 고객 지원 스크린샷과 같은 사전 정의된 카테고리에 이미지나 문서가 해당하는지 분류할 수 있습니다. 필요한 입력 형식과 이미지 처리 기능을 해당 엔드포인트가 지원하는지 확인하세요. 분류는 문서의 모든 필드를 추출하는 작업과 다릅니다. 선택한 모델과 API가 두 작업을 모두 지원하는지 확인해야 합니다.
평가 기준에 따른 점수 산출
모델은 "핵심 근거 누락", "부분적으로 뒷받침됨", "충분히 뒷받침됨"과 같은 설명을 사용해 답변을 순서형 척도에 배치할 수 있습니다. 검토자들이 해당 레이블에 동의하는지, 모델이 유사한 답변을 일관된 기준으로 평가하는지 테스트하세요. 검증 없이 평가 점수를 객관적인 측정값으로 제시하지 마세요.
Felo 모델 카탈로그에서 제공하는 의사결정 모델
Felo 모델 카탈로그에는 Decisions 출력 필터가 있습니다. 2026년 11월 2일 기준으로 등록된 모델의 사례는 다음과 같습니다.
| 카탈로그 모델 | 설명된 용도 | 카탈로그에 표시된 입력 |
|---|---|---|
| TypeSafe Jev 1.14 | 라우팅, 분류 및 콘텐츠 조정 | 텍스트 및 이미지. 이미지 지원은 실험 단계로 표시됨 |
| LiquidAI d1.1 | 예/아니요, 선택 및 점수 기반 의사결정 | 텍스트 및 이미지 |
| Baseten Joey 1 | 분류 및 라우팅 | 텍스트 및 이미지 |
| Perplexity Decider Flash V1.2 | 분류, 라우팅 및 점수 산출 | 텍스트 및 이미지 |
이 설명은 카탈로그에 등록된 정보를 반영하며, 독립적인 성능 테스트 결과나 특정 모델이 최고라는 추천을 의미하지 않습니다. 제공 여부, 기능 지원, 컨텍스트 제한 및 가격은 변경될 수 있습니다. 개발을 시작하기 전에 최신 등록 정보와 엔드포인트 문서를 확인하세요. 특히 실험 단계 또는 멀티모달 기능을 사용할 때는 주의가 필요합니다. 모델이 카탈로그에 등록되어 있다는 사실만으로 모든 플랫폼에서 해당 제공업체의 기본 API 기능을 사용할 수 있다는 의미는 아닙니다.
AI 의사결정 모델 평가 방법
범위가 제한된 하나의 의사결정 작업과 신뢰할 수 있는 레이블이 포함된 대표 사례 모음부터 시작하세요. 어려운 사례, 소수 카테고리, 맥락이 누락된 사례, 사람의 개입이 필요한 사례를 포함해야 합니다. 그런 다음 모델을 단순한 기준 모델, 기존 분류기 또는 구조화된 출력을 생성하는 LLM과 비교하세요.
정확도 외에도 다음 항목을 측정하세요.
- 정밀도와 재현율: 어떤 오류가 중요한가요? 각 클래스에서 오류는 얼마나 자주 발생하나요?
- 확률 보정: 사례 그룹별 예측 확률이 실제 결과와 일치하나요?
- 처리 범위: 선택한 임계값에서 자동 처리할 수 있는 요청의 비율은 얼마인가요?
- 지연 시간 및 안정성: 전체 API 호출이 프로덕션 요구사항을 충족하나요?
- 비용: 재시도, 여러 질문, 이미지 처리 및 사람의 검토 비용을 포함할 때 유효한 의사결정 한 건당 비용은 얼마인가요?
- 강건성: 언어, 형식, 낯선 사례 및 트래픽 변화에도 성능이 유지되나요?
레이블과 임계값을 조정한 후에는 별도로 분리한 테스트 세트를 사용하세요. 프로덕션 환경에서는 적절한 경우 결과를 기록하고, 의견이 일치하지 않는 사례를 검토하며, 모델 버전, 정책 또는 입력 분포가 변경될 때마다 성능을 재평가하세요. 중요한 결과를 초래하는 의사결정에는 실질적인 사람의 감독 체계를 마련하고 관련 요구사항을 확인해야 합니다.
자주 묻는 질문
판별형 AI는 의사결정 모델과 같은 개념인가요?
정확히 같지는 않습니다. 판별형 AI는 입력을 바탕으로 목표값을 예측하는 광범위한 접근 방식을 의미합니다. 의사결정 모델은 선택, 점수 및 확률과 같은 제한된 출력을 제공하는 데 중점을 둔 새로운 제품 카테고리입니다. 일부 의사결정 모델은 판별형 기법을 사용하지만 두 용어의 의미는 동일하지 않습니다.
LLM도 분류 또는 의사결정을 수행할 수 있나요?
네. 생성형 LLM은 콘텐츠를 분류하거나 구조화된 출력을 반환하도록 프롬프트를 설정할 수 있습니다. 전용 의사결정 모델이 더 나은 성능, 빠른 속도 또는 낮은 비용을 제공하는지는 작업, 모델, 제공업체 및 평가 방법에 따라 달라집니다. 자체 사례를 활용해 두 방식을 테스트하세요.
의사결정 모델의 확률은 항상 정확한가요?
아닙니다. 특정 데이터셋이나 하위 그룹에서 모델이 제공하는 확률은 제대로 보정되지 않을 수 있습니다. 워크플로 자동화에 임계값을 적용하기 전에 확률 보정과 오류가 초래하는 결과를 측정하세요.
생성형 AI는 언제 사용해야 하나요?
작성, 설명, 종합 또는 개방형 콘텐츠 생성이 필요한 작업에는 생성형 모델을 사용하세요. 많은 애플리케이션에서는 의사결정 모델과 생성형 모델을 함께 활용할 수 있습니다. 하나는 요청을 전달하거나 분류하고, 다른 하나는 응답을 생성합니다.
판별형 AI는 개발자가 명확하고 측정 가능한 의사결정을 워크플로에 적용할 수 있는 방법을 제공합니다. 범위가 제한된 하나의 작업부터 시작하고, 중요한 오류를 테스트한 다음, 검증 결과가 뒷받침하는 수준까지 자동화를 적용하세요.
이 글은 다음 언어로도 읽을 수 있습니다: English, 简体中文, 日本語, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা, Português.