
Felo API의 Gemini 4 Carbon: 사양, 벤치마크, 가격 및 활용 사례

Felo API의 Gemini 4 Carbon: 100만 토큰 통합 예산, 사고 수준, 멀티모달 입력 한도, 공개 벤치마크, 실제 가격 및 API 호출 방법을 알아봅니다.
Google의 Gemini 4 Carbon은 단시간에 끝낼 수 없는 복잡한 작업을 겨냥한 모델입니다. 수십 개의 서비스를 수정해야 하는 코드베이스 마이그레이션, 실제 작동하는 패치로 마무리해야 하는 취약점 탐지, 단순한 자신감 표현이 아닌 연속적인 증거가 필요한 연구 질문 등이 대표적인 사례입니다.
이제 Felo API를 통해 호출할 수 있으며, Felo는 기간 한정 무료 체험과 할인된 제공업체 요금을 함께 제공하고 있습니다. 이 가이드를 계속 읽기 전에 Felo의 Gemini 4 Carbon 페이지에서 모델을 열고, 플레이그라운드에서 프롬프트를 테스트하고, API 키를 생성할 수 있습니다.
이 글은 출시 소식이 아닌 실무 중심의 안내서입니다. Carbon의 실제 특성, Gemini 4 Argon과의 차이점, 공개 벤치마크가 보여주는 정보와 보여주지 못하는 정보, 독특한 토큰 예산의 작동 방식, 모델의 강점과 한계, 현재 Felo에서 적용되는 가격을 다룹니다.
Gemini 4 Carbon이란?
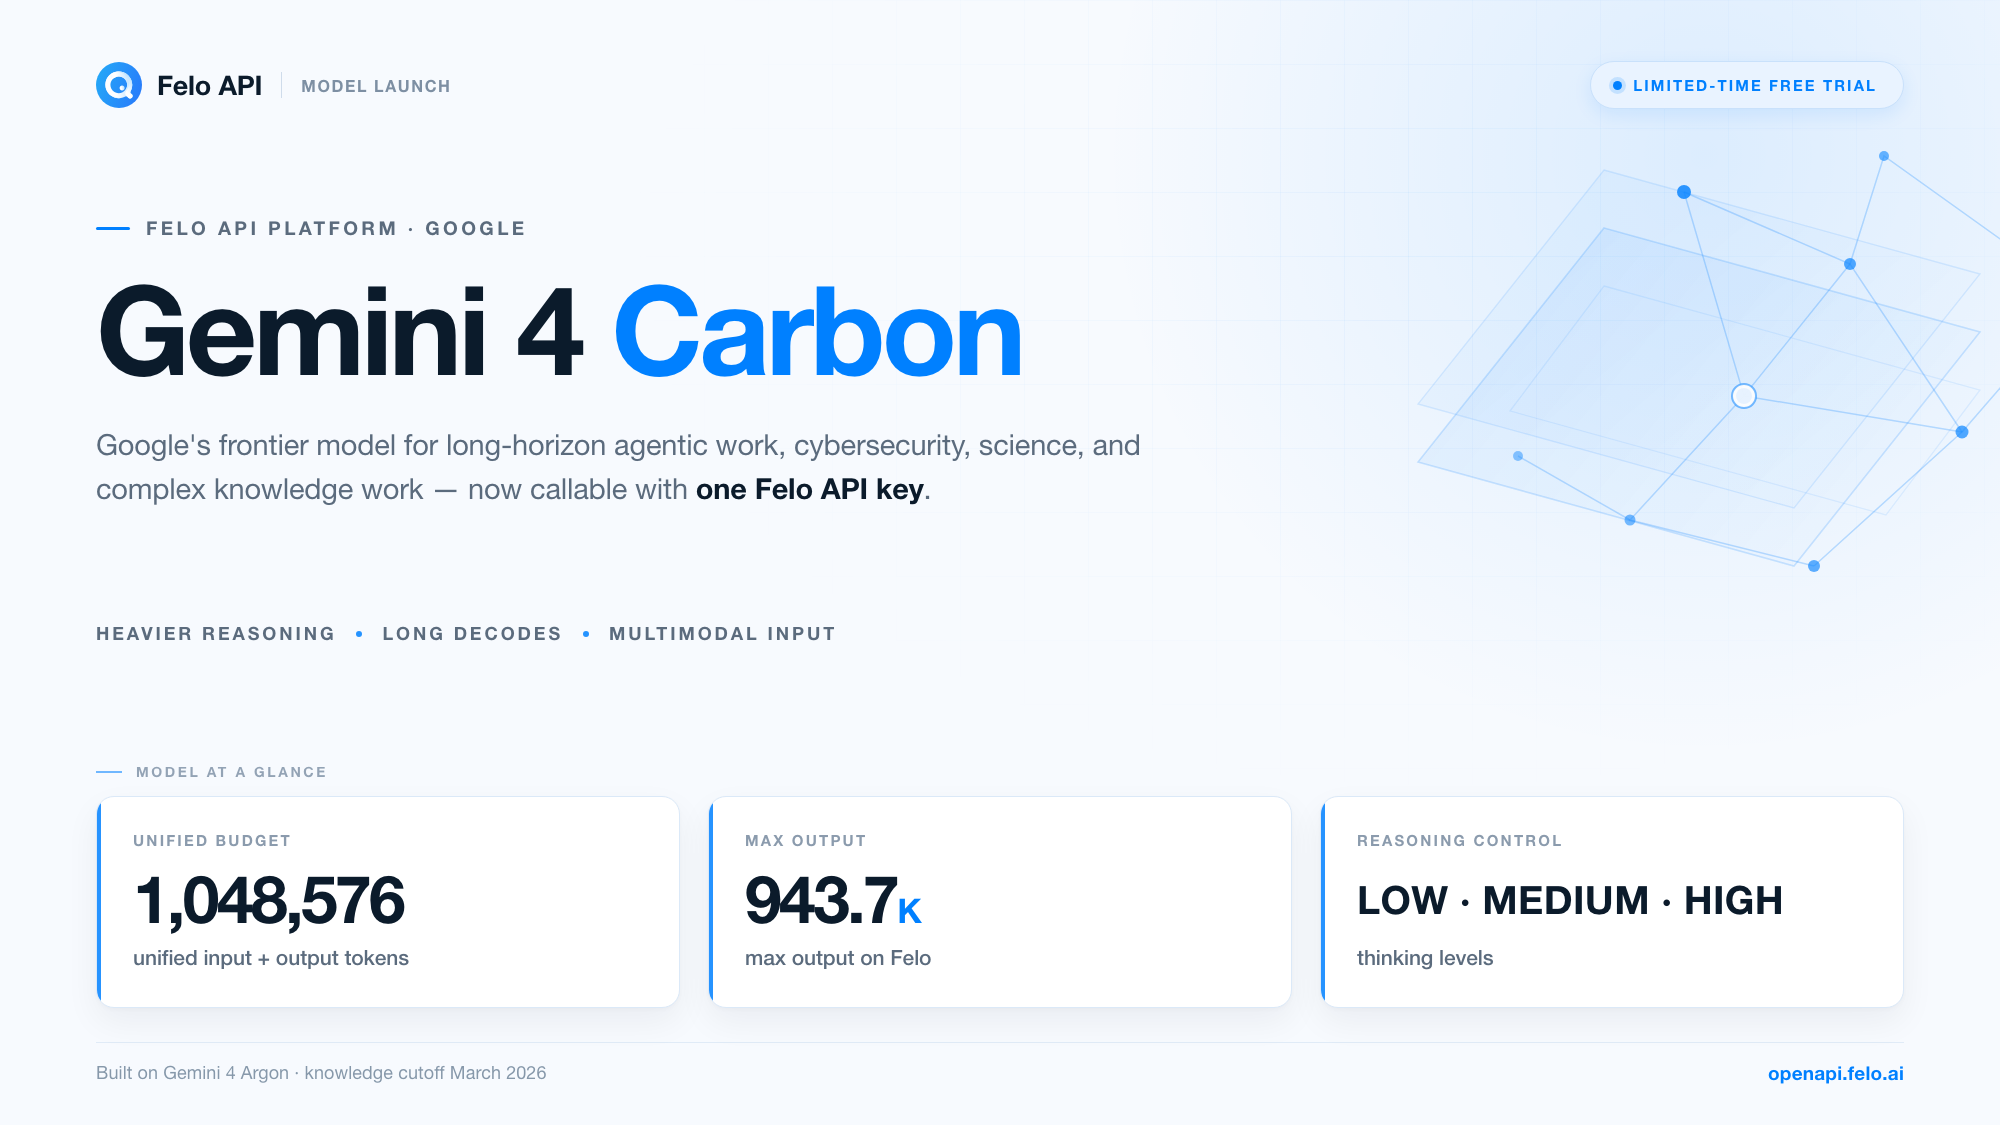
Gemini 4 Carbon은 코딩, 금융, 법률, 사이버 보안, 과학 분야의 장기적인 에이전트 작업을 위한 Google의 최첨단 모델입니다. Google은 2026년 10월 28일 이 모델을 발표했으며, Gemini 4 Argon을 기반으로 개발했습니다. 초기에는 Fairwind Program을 통해 일부 사이버 보안 방어 전문가에게만 공개했습니다. 현재 Google의 엔터프라이즈 플랫폼 문서에는 2026년 11월 10일을 정식 출시일로 명시하고 있습니다.
'Carbon'이라는 이름은 새로운 세대를 의미하지 않습니다. Gemini 4 제품군 안에서 모델의 작동 방향이 달라졌음을 나타냅니다. Argon이 하나의 작업 흐름에서 길고 일관성 있는 문서를 생성하도록 조정된 모델이라면, Carbon은 추론에 더 많은 예산을 사용합니다. 가설을 탐색하고, 검증 과정을 반복하며, 여러 단계의 작업을 조율합니다. Google에 따르면 Carbon은 답변을 도출하는 과정에서 Argon보다 더 많은 사고 토큰을 사용합니다.
이러한 설계에는 비용이 따릅니다. 어려운 작업에서 응답 속도가 느리고, 일부 조건에서는 시간 초과가 발생할 수 있으며, 사고 수준이 높을수록 더 많은 토큰을 소비합니다. Google도 이러한 한계를 명시하고 있습니다. 그럼에도 Carbon을 사용하는 이유는 보안 분석, 대규모 마이그레이션, 과학적 추론, 중요한 문서 검토처럼 속도보다 깊이 있는 분석이 중요한 작업을 겨냥하기 때문입니다.
모델 사양 한눈에 보기
| 사양 | 값 |
|---|---|
| Felo 모델 ID | gemini-4-carbon |
| 발표일 | 2026년 10월 28일 |
| 기반 모델 | Gemini 4 Argon |
| 컨텍스트 및 출력 | 입력과 출력을 합산한 1,048,576 토큰의 단일 통합 예산 |
| Felo에 표시된 최대 출력 | 943.718K 토큰 |
| 입력 | 텍스트, 이미지, 오디오, 비디오, PDF, Office/OpenDocument 파일 |
| 출력 | 텍스트 |
| 사고 수준 | LOW, MEDIUM(기본값), HIGH |
| 지식 기준일 | 2026년 3월 |
| 샘플링 | Temperature 1.0, top-p 0.95, top-k 64, 고정값 |
| 캐싱 | 암시적 캐싱만 지원, 최소 4,096토큰 |
| 권장 Felo 인터페이스 | Messages API(Anthropic 호환) |
| 액세스 | 일부 지역의 인증된 엔터프라이즈 고객, 사이버 보안 버전은 허용 목록 기반 |
이 표에서 두 가지 세부 사항은 모델을 활용하는 방식에 영향을 주므로 별도로 살펴볼 필요가 있습니다. 통합 토큰 예산과 사고 수준입니다.
Gemini 4 Carbon과 Gemini 4 Argon의 차이점
Carbon과 Argon은 동일한 제품군에 속하며, 지식 기준일과 주요 활용 분야도 상당 부분 겹칩니다. 차이는 모델이 처리 능력을 사용하는 방식에 있습니다.
입력과 출력을 합산하는 통합 예산. Argon은 일반적으로 1,048,576토큰의 컨텍스트 윈도우와 별도의 기본 출력 한도 65,536토큰을 제공하는 모델로 설명됩니다. Carbon의 1,048,576토큰은 입력, 사고, 도구 호출, 최종 답변을 모두 포함합니다. 컨텍스트 윈도우와 별도의 출력 할당량이 아니라 하나의 통합 예산입니다.
기본적으로 더 깊은 추론. Carbon은 LOW, MEDIUM, HIGH 사고 수준을 지원합니다. gemini-4-carbon의 기본값은 MEDIUM이며, 사이버 보안 허용 버전의 기본값은 HIGH입니다. 반복적인 검증 과정을 수행하도록 설계되었으며, Google은 높은 토큰 사용량을 버그가 아닌 알려진 제한 사항으로 보고합니다.
긴 출력 생성. 스트리밍을 사용할 경우 하나의 출력 세그먼트에서 최대 65,536개의 출력 토큰을 생성할 수 있으며, 스트리밍을 사용하지 않으면 최대 32,768개입니다. 이 한도를 넘으려면 긴 출력 생성 기능을 사용해야 합니다. Google Gen AI SDK와 Agent Studio는 연속 토큰을 자동으로 관리하며, 직접 연속 생성 루프를 구현할 수도 있습니다. 이론상 최대 출력은 입력 토큰을 제외한 통합 예산 전체입니다.
확장된 파일 지원. Carbon은 PDF와 일반 텍스트 외에도 Microsoft Office 및 OpenDocument 파일을 지원합니다. 지원 형식은 .docx, .doc, .pptx, .ppt, .xlsx, .xls, .odt, .odp, .ods이며, 인라인 입력이나 클라우드 스토리지에서 가져올 수 있습니다. 깔끔한 텍스트 파일이 아닌 프레젠테이션, 스프레드시트, 계약서에서 작업을 시작하는 워크플로에 유용합니다.
보안 최적화 및 별도의 사이버 보안 버전. Google에 따르면 실제 코딩 환경에서 심각도가 높은 정렬 오류 경고가 약 80% 감소했습니다. 텍스트 간 안전성 평가에서도 Carbon은 다국어 및 멀티모달 콘텐츠 안전성 측면에서 Argon보다 3.50%포인트 높은 성능을 보였습니다. 또한 방어적 보안 작업을 위한 허용 목록 전용 버전인 gemini-4-carbon-cyber-permissive도 있습니다. 이 버전은 기본 사고 수준이 HIGH이며 컴퓨터 사용 기능은 제외됩니다.
과학 분야에 특화된 기능. Google은 이 모델이 보안 목표를 수학적 정리로 변환하고, 페타베이스 규모의 서열 아카이브에서 원거리 상동체를 자율적으로 탐색할 수 있다고 설명합니다. 상동체가 적은 단백질 계열에서 상동체 검색 결과가 평균 40배 증가했다고 보고했습니다. 이는 특정 연구 작업에 관한 제한적인 주장입니다. 일반적인 기능으로 받아들이기보다 자체 데이터로 재현 여부를 검증해야 합니다.
통합 토큰 예산 이해하기
대부분의 모델 페이지에는 컨텍스트 윈도우와 최대 출력이라는 두 가지 수치가 표시됩니다. Carbon은 하나의 통합 수치와 세그먼트별 제한을 제공합니다. 기존 방식으로 요청을 설계하면 사용 가능한 공간을 과대평가하거나 비용 청구 방식을 잘못 이해할 수 있습니다.
실제 예산은 다음과 같이 구성됩니다.
- 입력(Input) — 프롬프트, 첨부 문서, 이미지, 오디오, 비디오 프레임, 이전 대화 내용
- 사고(Thinking) — 모델이 답변을 생성하기 전에 사용하는 추론 토큰. HIGH에서는 상당한 양을 소비할 수 있습니다.
- 도구 호출(Tool calls) — 도구가 활성화된 상태에서 모델이 호출하는 모든 기능
- 최종 답변(Final answer) — 사용자가 실제로 받는 텍스트
네 가지 항목 모두 동일한 1,048,576토큰을 사용합니다. 입력이 900K 토큰인 요청이라고 해서 출력에 1M 토큰을 사용할 수 있는 것은 아닙니다. 연속 생성을 시작하기 전까지 사고, 도구, 답변에 사용할 수 있는 토큰은 모두 합쳐 약 148K입니다.
세그먼트별 제한은 별도로 적용됩니다. 스트리밍 요청에서 하나의 세그먼트는 최대 65,536개의 출력 토큰을 생성하며, 스트리밍을 사용하지 않으면 최대 32,768개입니다. 긴 출력 생성 기능을 사용하면 통합 예산이 소진될 때까지 세그먼트 경계를 넘어 출력을 이어갈 수 있습니다. max_tokens를 전체 출력량에 대한 보장으로 해석해서는 안 됩니다. 이 값은 세그먼트의 한도를 설정하며, SDK의 연속 생성 기능이 긴 문서 생성을 가능하게 합니다.
Felo의 모델 페이지에는 최대 출력이 943.718K 토큰으로 표시되어 있습니다. 이를 Felo 경로에서 사용할 수 있는 출력 한도로 이해해야 하며, 더 큰 별도의 컨텍스트 윈도우로 해석해서는 안 됩니다. 통합 예산에서는 실제 답변에 사용할 수 있는 공간이 전송한 입력의 양에 따라 달라집니다.
설계 원칙은 간단합니다. 먼저 출력 크기를 정하고, 그에 맞춰 입력을 조정하세요. 긴 보고서를 작성한다면 출력과 사고에 필요한 예산을 확보하고 원본 자료의 양을 조절하세요. 대규모 문서 모음을 분석한다면 답변이 입력보다 짧아진다는 점을 고려하고, 연속 생성이나 단계별 프롬프트를 계획하세요.
사고 수준: 답변 품질을 결정하는 요소
Carbon은 LOW, MEDIUM, HIGH의 세 가지 사고 수준을 제공합니다. 기본값은 MEDIUM입니다. Google 문서에 따르면 thinking_budget과 thinking_level="MINIMAL"을 사용하면 유효성 검사 오류가 발생합니다. 따라서 추론을 완전히 0으로 설정할 수는 없습니다.
실제 차이는 분명합니다. LOW에서는 빠른 최첨단 대화형 모델에 가까운 방식으로 작동합니다. 정보 추출, 분류, 문장 재작성, 일반적인 코드 검토에 적합합니다. MEDIUM에서는 계획 수립과 자체 검증에 토큰을 사용하기 시작합니다. HIGH에서는 더 긴 검증 과정을 수행하므로 미묘한 오류를 찾아낼 가능성이 높습니다. 동시에 응답이 느려지고 비용이 증가할 가능성도 가장 높은 설정입니다.
실무에서 유용한 몇 가지 원칙은 다음과 같습니다.
- 오답의 비용에 맞춰 사고 수준을 선택하세요. 실수를 발견하고 수정하는 비용이 낮다면 LOW를 사용하세요. 오류가 실제 서비스에 배포되거나 공식 문서에 포함될 수 있다면 HIGH를 테스트하세요.
- 요청당 토큰이 아닌 승인된 결과당 토큰을 측정하세요. 높은 사고 수준은 재시도와 재작업을 줄일 수 있습니다. 반면 MEDIUM에서도 해결할 수 있는 작업의 비용을 늘릴 수 있습니다. 전체 작업 흐름을 비교하세요.
- 벤치마크 설정이 실제 사용 환경에도 적용된다고 가정하지 마세요. Google이 공개한 주요 수치에는 사용된 사고 수준이 항상 명시되어 있지 않습니다. 도입을 결정하기 전에 실제 작업을 두 가지 사고 수준에서 테스트하세요.
샘플링 설정은 temperature 1.0, top-p 0.95, top-k 64로 고정되어 있으며, 사용자 지정 값은 무시됩니다. 파이프라인에 낮은 temperature를 통한 결정론적 출력이 필요하다면 Carbon은 해당 단계에 적합하지 않습니다. 판단과 종합 작업에는 Carbon을 사용하고, 결정론적 단계는 샘플링 제어를 지원하는 다른 모델에 맡기세요.
Google이 공개한 벤치마크와 그 의미
Felo의 모델 페이지에는 Carbon에 대해 제공업체가 공개한 벤치마크 결과가 정리되어 있습니다. 아래 비교는 참고용 지표입니다. Google 또는 평가 제공업체가 발표한 결과이며, 이 글을 위해 독립적으로 재현한 결과는 아닙니다. 실제 업무가 아닌 특정 테스트 조건을 반영합니다.
| 평가 | 측정 항목 | Gemini 4 Carbon | 설명 |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | 종합 추론 지수 | 59 | 1위, Claude Opus 5.5는 58 |
| SEC-bench Pro | 취약점 탐지 | 88.2% | 보안, 방어적 스캔 |
| CWE-bench | 취약점 패치 | 71.0% | 보안, 취약점 수정 |
| ExploitGym | 취약점 악용 | 54.8% | 보안 연구, 통제된 환경 |
| Terminal-Bench 4.0 | 성공적인 부정행위 비율 | 0.0% | 보상 해킹 저항성 측정, 기능 성능 지표는 아님 |
| Vals Index | 지식 업무 종합 평가 | 70.45% | 모델 36개 중 3위 |
| Legal Research Bench | 법률 연구 | 55.77% | 1위 |
| General Financial Intelligence | 금융 작업 | #1 | Balyasny Asset Management 기준 최첨단 모델 설정 23개 중 1위 |
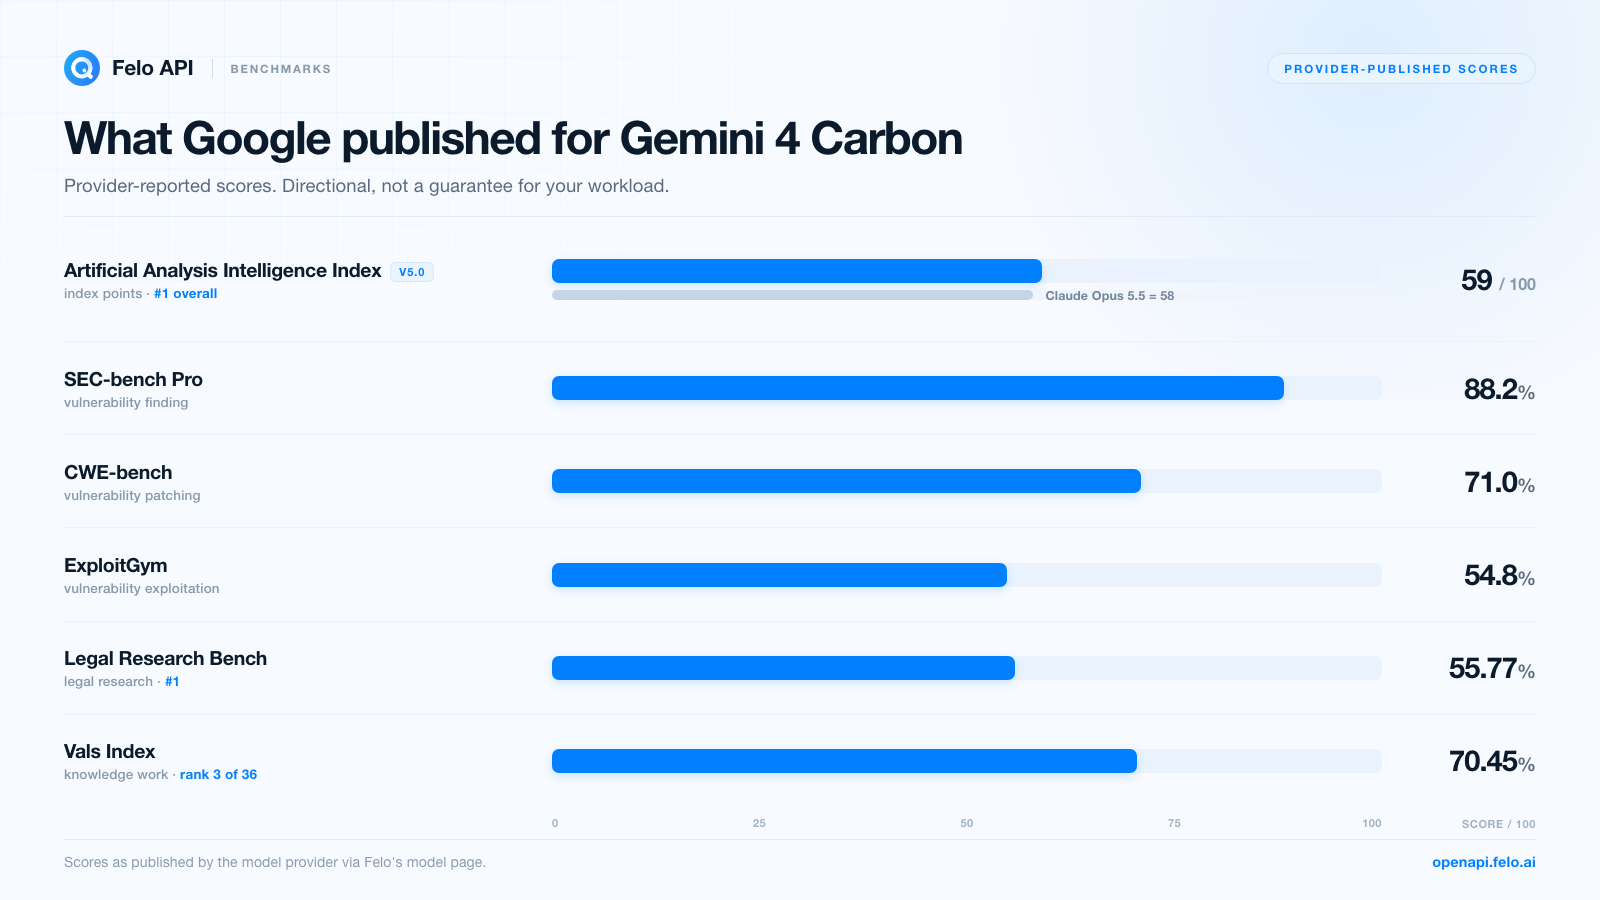
표를 자세히 살펴보면 세 가지 특징이 드러납니다.
보안 점수는 단일 기능이 아닌 전체 수명 주기를 보여줍니다. 취약점 탐지, 패치 작성, 취약점 악용은 서로 다른 기술입니다. Carbon은 취약점 탐지(SEC-bench Pro 88.2%)에서 가장 높은 점수를 기록했고, 취약점 악용(ExploitGym 54.8%)에서는 낮은 점수를 보였으며, 패치 작성(CWE-bench 71.0%)은 그 중간에 있습니다. 스캔, 분류, 수정과 같은 방어적 작업을 수행한다면 적합한 성능 프로필입니다. 자율적인 취약점 악용이 필요하다면 점수가 낮고 접근 규칙도 더 엄격하다는 점을 고려해야 합니다.
부정행위 비율은 지능이 아닌 신뢰성을 측정합니다. Terminal-Bench 4.0의 '성공적인 부정행위 비율'은 모델이 작업을 해결하는 대신 벤치마크의 허점을 이용하는지 측정합니다. 0.0%라는 결과는 보상 해킹에 대한 저항성을 나타내며, 에이전트를 무인으로 실행할 때 중요한 요소입니다. 이는 기능 성능 점수가 아니므로 표의 다른 정답률 기반 결과와 비교해서는 안 됩니다.
지식 업무 순위는 대부분의 팀에 가장 관련성이 높은 지표입니다. Vals Index에서 36개 모델 중 3위, Legal Research Bench에서 1위, Balyasny의 금융 비교 평가에서 최고 순위를 기록했습니다. 이러한 결과는 최첨단 모델의 도입 비용을 정당화할 수 있는 작업 유형을 보여줍니다. 많은 자료를 읽고, 상충하는 증거를 조정하고, 전문가가 검토할 수 있는 결과물을 만드는 작업입니다. 다만 이러한 결과는 프롬프트 설계와 자료의 품질에 큰 영향을 받습니다. 테스트를 생략할 근거가 아니라 자체 테스트를 진행할 이유로 받아들여야 합니다.
한 가지 더 고려할 사항이 있습니다. Artificial Analysis 지수는 종합 점수이며, Claude Opus 5.5와의 1점 차이는 작업 구성에 따라 순위가 바뀔 수 있는 수준입니다. 실제로 중요한 특정 작업에서는 두 모델의 성능 차이가 어느 한쪽으로 크게 벌어질 수 있습니다.
Gemini 4 Carbon의 실제 활용 분야
벤치마크는 지도이지 실제 현장 자체는 아닙니다. Carbon의 설계가 작업 요구 사항과 일치하는 분야는 다음과 같습니다.
대규모 코드 작업 및 마이그레이션
Carbon은 여러 에이전트의 협업, 일상적인 디버깅, 대규모 코드베이스 마이그레이션, 알고리즘 설계가 필요한 엔지니어링 작업을 겨냥합니다. 통합 예산은 이러한 작업에 유용합니다. 저장소 구조도, 관련 소스 파일, 실패한 테스트 결과, 마이그레이션 요구 사항을 하나의 요청에 포함한 뒤 코드 변경 전에 계획을 요청할 수 있습니다.
이러한 모델에 적합한 프롬프트 예시는 다음과 같습니다.
첨부된 저장소 구조도와 세 개의 서비스 모듈을 읽으세요. 세션 인터페이스를 교체할 때 영향을 받는 모든 호출 위치를 확인하고, 호환성 위험을 나열한 다음, 마이그레이션 순서를 제안하세요. 아직 코드는 작성하지 마세요. 제공된 파일만으로 검증할 수 없는 항목을 표시하세요.
먼저 계획을 요청하세요. 계획을 검토한 후에만 테스트를 실행할 수 있도록 모델에 권한을 부여하세요. 변경 사항 검토는 사람이 담당해야 합니다. 계획 수립 능력이 뛰어난 모델도 컴파일은 성공하지만 실제 동작이 잘못된 패치를 만들 수 있습니다.
방어적 사이버 보안
보안 벤치마크 프로필은 취약점 탐지 성능이 높고, 패치 성능이 양호하며, 취약점 악용 성능은 상대적으로 낮습니다. 이는 코드베이스의 취약점 유형 스캔, 스캐너 결과 분류, 패치 제안, 검토자가 조치를 취할 수 있는 형태의 위험 설명 등 방어적 작업에 적합합니다. Google의 사이버 보안 버전은 이러한 작업을 위해 개발되었지만 Fairwind Program을 통한 허용 목록 기반 접근 방식이며 별도 승인이 필요합니다.
두 가지 주의 사항이 있습니다. 첫째, 보안 워크플로는 테스트 권한이 있는 시스템에서만 실행하세요. 둘째, 조치를 취하기 전에 탐지 결과를 검증하세요. 모델이 높은 확신으로 취약점을 보고하더라도 틀릴 수 있으며, 오탐으로 인한 엔지니어링 시간 낭비가 발생할 수 있습니다.
과학 및 기술 연구
보고된 과학 분야 기능은 구체적입니다. 보안 목표를 수학적 정리로 변환하고, 페타베이스 규모의 서열 아카이브에서 원거리 상동체를 검색하는 기능입니다. 연구실이나 연구 그룹에서 활용한다면 범위가 명확한 질문, 관련 문헌이나 서열 데이터, 증거와 추론을 구분하라는 요구 사항을 Carbon에 제공하는 방식이 유용합니다.
상동체 검색 결과가 40배 증가했다는 주장은 주목할 만하지만, 특정 파이프라인에서 상동체가 적은 단백질 계열을 대상으로 한 결과입니다. 해당 워크플로를 구축하기 전에 연구팀이 신뢰하는 벤치마크에서 재현 여부를 확인하세요.
금융, 법률 및 중요한 문서 검토
지식 업무 순위는 Carbon의 가장 강력한 판매 요소입니다. 주요 활용 작업은 원장 대조, 차이 분석, 판례 및 규제 관련 제출 문서 검토, 인용 자료가 포함된 보고서 작성 등입니다. 모델은 이미지와 PDF를 읽을 수 있으므로 스캔 문서와 차트도 입력 자료로 사용할 수 있습니다.
다만 검토 과정을 없애주는 것은 아닙니다. 원본 자료를 제공하고, 각 결론의 근거가 되는 구절을 인용하도록 요청한 다음, 인용 내용이 정확한지 확인하세요. 컨텍스트를 백만 토큰까지 처리할 수 있는 모델도 412페이지를 잘못 읽을 수 있습니다.
도구를 사용하는 장기 실행 에이전트
Carbon은 함수 호출, 구조화된 출력, 코드 실행, URL 컨텍스트, 컴퓨터 사용, Google Search, Google Maps, 타사 검색 제공업체를 포함한 여러 근거 확보 옵션을 지원합니다. 문서가 아닌 녹화 영상이 입력 자료인 경우에 유용한 에이전트형 비디오 이해 기능도 제공합니다.
이 방식은 모델을 활용하는 가장 까다로운 방법이며 토큰을 소비하기도 쉽습니다. 에이전트의 실행을 기록하세요. 도구 호출을 로그로 남기고, 반복 횟수를 제한하며, 에이전트가 조치를 취하기 전에 검증한 내용을 요약하도록 요구하세요. 1M 토큰 예산은 복잡한 에이전트의 구현을 가능하게 하지만 비용을 낮춰주지는 않습니다.
멀티모달 입력과 제한 사항
Carbon은 텍스트, 이미지, 오디오, 비디오, PDF, Office 문서를 입력으로 받고 텍스트를 출력합니다. 입력 한도는 넉넉하지만 구체적인 제한이 있으며, 주요 지원 형식 목록보다 실제 작업에 더 중요한 정보입니다.
| 입력 유형 | 실질적인 한도 |
|---|---|
| 오디오 | 프롬프트당 약 8.4시간 또는 최대 1M 토큰, 오디오 파일 최대 1,000개 |
| 비디오 | 오디오 포함 약 45분, 오디오 제외 약 1시간, 프롬프트당 최대 10개 |
| 이미지 및 문서 | 프롬프트당 합산 최대 3,000개 |
| 문서 | 파일당 최대 3,000페이지 |
| Office 형식 | .docx, .doc, .pptx, .ppt, .xlsx, .xls |
| OpenDocument 형식 | .odt, .odp, .ods |
| 입력 크기 | GenerateContent API에서 압축 기준 500 MiB, Interactions API에서 256 MiB |
가장 눈에 띄는 기능은 오디오 입력 한도입니다. 하나의 요청에서 8시간 분량의 오디오를 처리할 수 있다는 점은 회의가 많은 팀의 업무 방식을 바꿀 수 있습니다. 음성을 텍스트로 변환하고 여러 부분으로 나누는 대신 하루 전체의 통화 녹음을 제공하고 주요 주제, 결정 사항, 미해결 질문을 요청할 수 있습니다. 단, 오디오 토큰도 입력 토큰과 동일한 방식으로 요금이 부과되므로 하루 분량의 녹음 파일을 무료로 처리할 수는 없습니다.
비디오 한도는 일반적인 업무에 적합한 수준입니다. 오디오가 포함된 45분 분량의 비디오는 강의, 제품 시연, 녹화 인터뷰에 적합하지만 전체 컨퍼런스 영상을 처리하기에는 부족합니다.
미리 계획해야 할 기능적 제약도 있습니다. Gemini Live API는 지원되지 않으므로 실시간 음성 기능을 사용할 수 없습니다. RAG Engine과 모델 튜닝도 지원되지 않으므로 검색 및 파인튜닝은 애플리케이션 계층에서 처리해야 합니다. 명시적 컨텍스트 캐싱도 지원되지 않으며, 최소 4,096토큰의 암시적 캐싱만 사용할 수 있습니다. 반복적인 장문 프롬프트의 비용 계획에 영향을 주는 요소입니다.
Felo에서 Gemini 4 Carbon API 호출하기
Felo는 이 모델에 Messages API를 권장합니다. 엔드포인트는 https://openapi.felo.ai/api/v1/messages이며, Anthropic 호환 요청 형식을 사용합니다. 모델 ID는 gemini-4-carbon입니다.
기본 절차는 다른 Felo 모델과 동일합니다.
- Felo API 키 생성. Felo 콘솔에서 키를 생성하고
FELO_API_KEY에 저장하세요. 키를 코드 저장소에 커밋하거나 로그에 붙여넣지 마세요. - 먼저 플레이그라운드에서 테스트. Gemini 4 Carbon 플레이그라운드에서 코드 작성 전에 프롬프트를 테스트할 수 있습니다.
- 소규모 요청 전송. 짧은 프롬프트로 시작해 응답 형식을 확인하세요.
- 스트리밍 추가. 서버 전송 이벤트를 사용하려면
stream: true를 설정하세요. 하나의 세그먼트가 최대 65,536토큰까지 생성할 수 있으므로 중요합니다. - 실제 작업을 반영한 테스트. 실제 입력 크기와 평가 기준을 사용하고, 파이프라인을 확정하기 전에 최소 두 가지 사고 수준을 테스트하세요.
최소한의 Python 요청 예시는 다음과 같습니다.
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
두 가지 통합 관련 사항이 있습니다. 첫째, 이 모델은 추론 기능을 지원합니다. 대화를 이어갈 때 반환된 추론 메타데이터를 유지해야 합니다. 그렇지 않으면 모델이 필요로 하는 컨텍스트가 손실될 수 있습니다. 둘째, max_tokens는 전체 출력 한도가 아닌 세그먼트 한도입니다. 긴 출력을 생성하려면 숫자를 늘리는 대신 SDK가 제공하는 연속 생성 기능을 사용하세요.
Felo는 지원 모델을 대상으로 OpenAI 호환 Chat Completions 및 Responses 엔드포인트도 문서화하고 있습니다. 다만 Carbon에는 Messages API를 권장하므로 OpenAI 기반 클라이언트를 수정하기 전에 모델 페이지에서 지원되는 인터페이스를 확인하세요.
Felo에서 Gemini 4 Carbon을 사용할 때의 비용
Felo는 Gemini 4 Carbon을 Google의 다섯 가지 제공업체 경로로 제공하며, 현재 모든 경로에 50% 할인이 적용됩니다. 아래 가격은 100만 토큰당 요금이며, 기본 요금과 할인 요금을 함께 표시했습니다.
| 경로 | 입력 | 출력 | 캐시 읽기 |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
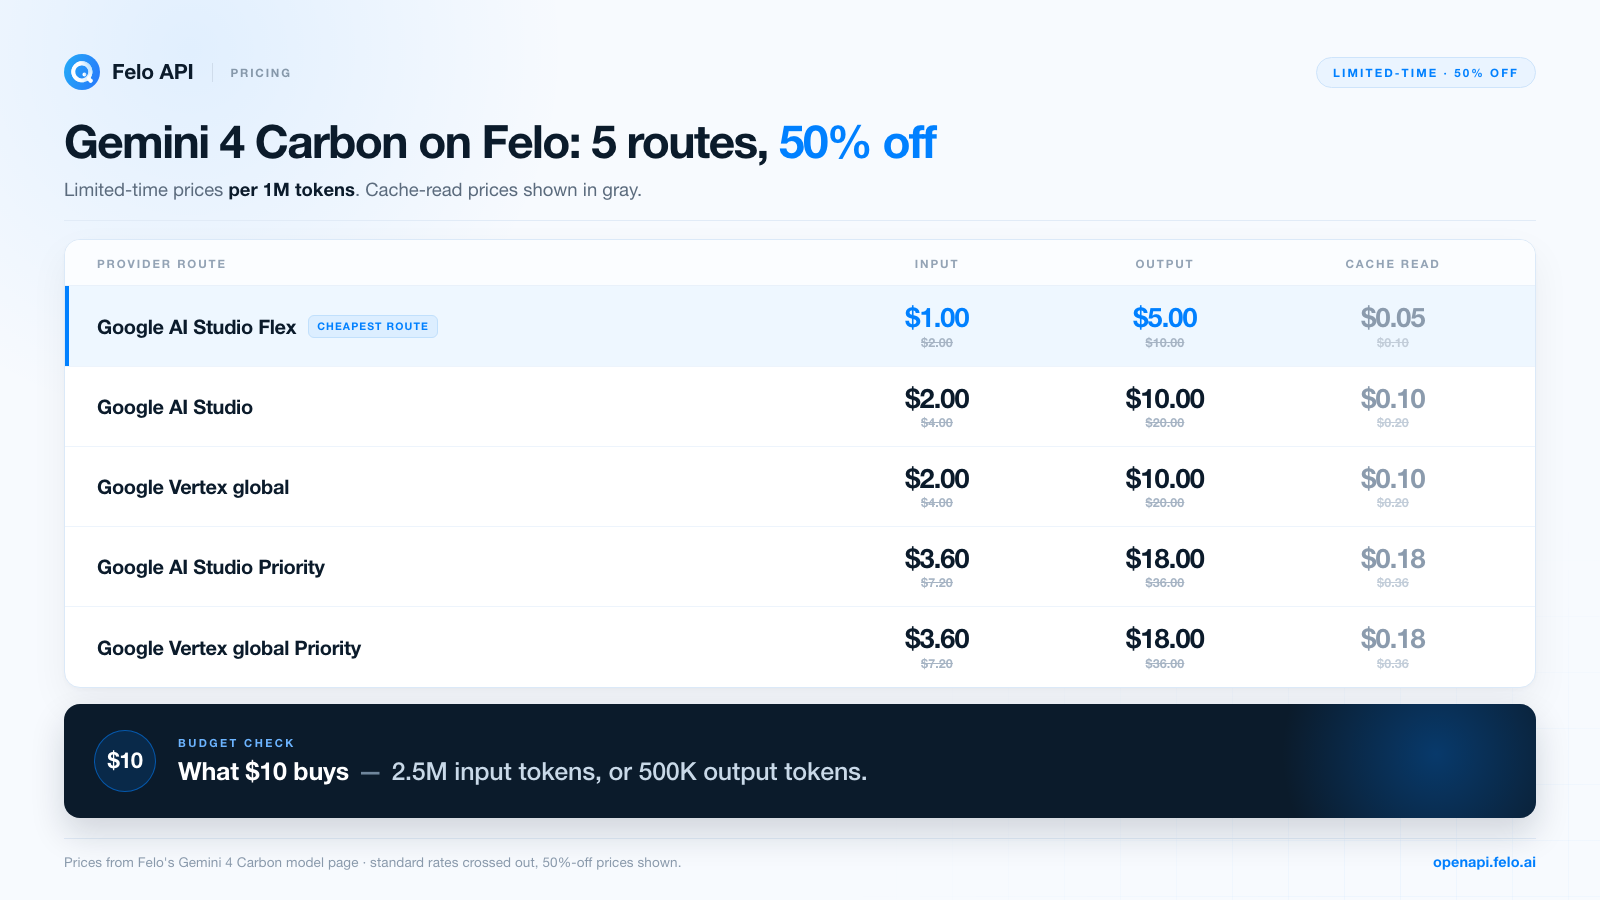
Felo의 가격 페이지는 기본 요금을 "$10으로 구매할 수 있는 양"으로 환산해 보여줍니다. 할인 적용 전 기준으로 입력 토큰 약 250만 개 또는 출력 토큰 50만 개에 해당합니다. 개념 검증 프로젝트의 규모를 정할 때 유용한 기준입니다. 100,000토큰 분량의 문서 묶음을 전송하고 5,000토큰의 답변을 받는 테스트는 할인 요금 기준 Flex 경로에서 약 $0.13의 비용이 발생합니다. 입력에 $0.10, 출력에 $0.025가 사용되므로 도입을 결정하기 전에 수십 차례 테스트를 진행할 수 있는 비용입니다.
무료 체험은 할인 요금과 별도의 혜택입니다. Felo의 모델 페이지에는 Gemini 4 Carbon에 기간 한정 무료 체험이 표시되어 있으며, 크레딧을 사용하지 않고 모델을 테스트할 수 있는 방법입니다. 체험 가능 여부와 할인 요금은 기간에 따라 변경될 수 있으므로 현재 모델 페이지의 이용 약관을 확인하세요.
이 모델의 비용을 계획할 때는 한 가지 습관이 더 필요합니다. 사고 토큰에도 출력 요금이 적용되므로 HIGH 사고 수준의 에이전트 실행 비용은 화면에 표시되는 답변만 보고 예상한 비용보다 몇 배 높을 수 있습니다. 추론 토큰을 포함해 작업별 토큰 사용량을 기록하고, 요청당 비용이 아닌 승인된 결과당 비용을 비교하세요.
도입 전에 확인해야 할 제한 사항
Carbon은 문서화된 약점을 가진 최첨단 모델입니다. 프로덕션 환경을 계획할 때 고려해야 할 사항은 다음과 같습니다.
- 환각. Google은 이를 알려진 제한 사항으로 명시하고 있습니다. 긴 컨텍스트는 정보 누락 가능성을 줄이지만 정확한 해석을 보장하지는 않습니다. 근거 인용과 검증 절차가 필요합니다.
- 지연 시간 및 시간 초과. Google은 간헐적인 응답 지연과 시간 초과 문제를 언급합니다. HIGH 사고 수준을 사용하는 장시간 작업에는 충분한 시간 제한, 재시도, 멱등성 작업 처리가 필요합니다.
- 높은 토큰 사용량. 모델은 Argon보다 더 많은 사고 토큰을 사용하며, 높은 사고 수준에서 그 차이가 커집니다. 예산을 이에 맞춰 설정하고 일반적인 작업에는 추론 수준을 제한하세요.
- 2026년 3월 지식 기준일. 그 이후의 정보는 검색 기능이나 최신 자료가 필요합니다. Carbon은 해당 날짜 이후의 사건을 알지 못합니다.
- 고정된 샘플링. Temperature, top-p, top-k를 조정할 수 없습니다. 파이프라인에 결정론적 출력이 필요하다면 해당 단계는 다른 모델에 맡기세요.
- 명시적 캐싱, 튜닝, RAG Engine, Live API 미지원. 이러한 기능이 필요한 작업은 애플리케이션 계층에서 구현해야 합니다.
- 사용 가능 지역 제한. Google은 일부 지역의 인증된 엔터프라이즈 고객에게 Carbon을 제공합니다. Felo는 글로벌, 미국, EU 제공업체 경로를 통해 모델을 제공합니다. 사용 사례에 적용되는 경로와 이용 약관을 확인하세요.
- 안전 및 접근 규칙. 사이버 보안 버전은 허용 목록 기반이며, 보안 워크플로에는 적절한 권한이 필요합니다. 모델의 안전장치와 제공업체 정책도 적용됩니다.
그렇다면 이 모델을 사용해야 할까?
작업이 길고, 증거가 복잡하며, 오답의 비용이 큰 경우 Gemini 4 Carbon을 사용하세요. 마이그레이션 계획, 보안 검토, 연구 자료 종합, 금융 또는 법률 분석, 조치를 취하기 전에 조사를 수행해야 하는 에이전트 등이 해당합니다. Carbon의 벤치마크 성능과 통합 예산은 이러한 작업을 위해 설계되었습니다.
모든 요청의 기본 모델로 사용해서는 안 됩니다. 대량 분류, 짧은 정보 추출, 간단한 요약, 결정론적 샘플링이 필요한 작업에는 더 저렴하고 빠른 모델이 적합합니다. 품질 기준을 충족하는 가장 저렴한 모델을 선택하는 것이 대부분의 경우 올바른 결정입니다. Carbon은 가장 어려운 작업에서 성능을 입증해야 합니다.
핵심을 정리하면 다음과 같습니다. Carbon은 심층 작업을 위한 Google의 고성능 모델입니다. 보안, 법률, 금융, 장문 컨텍스트 추론에서 검증된 강점을 보유하고 있지만, 지연 시간과 토큰 비용이 높으며 검증을 필수로 만드는 여러 제한 사항도 있습니다. 자체 작업에서 테스트한 후 도입 여부를 결정하세요.
자주 묻는 질문
Felo에서 Gemini 4 Carbon 무료 체험을 제공하나요?
네. Felo는 Gemini 4 Carbon에 기간 한정 무료 체험을 제공하며, 혜택이 유지되는 동안 모델 제공업체 요금에도 할인이 적용됩니다. 이용 약관은 변경될 수 있으므로 Gemini 4 Carbon 모델 페이지에서 현재 이용 가능 여부를 확인하세요.
Gemini 4 Carbon과 Gemini 4 Argon의 차이점은 무엇인가요?
Carbon은 Argon을 기반으로 개발되었으며 더 깊은 추론을 수행하도록 조정되었습니다. 입력, 사고, 도구 호출, 출력을 포함하는 1,048,576토큰의 통합 예산을 사용하고, LOW, MEDIUM, HIGH 사고 수준을 지원하며, 더 많은 사고 토큰을 소비합니다. 또한 Office/OpenDocument 파일 지원과 강화된 안전성 및 보안 기능을 제공합니다. Argon은 검증 깊이보다 출력 길이가 중요한 장문 생성 작업에 적합합니다.
Gemini 4 Carbon의 컨텍스트 윈도우와 최대 출력은 얼마인가요?
통합 예산은 입력과 출력을 합산해 1,048,576토큰입니다. 스트리밍을 사용하는 단일 세그먼트는 최대 65,536개의 출력 토큰을 생성할 수 있으며, 스트리밍을 사용하지 않으면 최대 32,768개입니다. 긴 출력 생성 기능을 사용하면 남은 예산까지 출력을 이어갈 수 있습니다. Felo는 자체 경로에서 최대 출력으로 943.718K 토큰을 표시하고 있습니다.
Gemini 4 Carbon은 오디오, 비디오, Office 파일을 읽을 수 있나요?
네. 텍스트, 이미지, 오디오, 비디오, PDF, Office/OpenDocument 파일을 입력으로 받을 수 있습니다. 오디오는 약 8.4시간, 비디오는 약 45~60분, 이미지와 문서는 합산 3,000개, 문서는 파일당 3,000페이지까지 지원합니다. 출력 형식은 텍스트만 지원합니다.
Gemini 4 Carbon은 OpenAI 호환 API를 지원하나요?
Felo는 이 모델에 Anthropic 호환 Messages API를 권장하며, 지원 모델을 위한 OpenAI 호환 Chat Completions 및 Responses 엔드포인트도 문서화하고 있습니다. 기존 클라이언트를 수정하기 전에 모델 페이지에서 현재 지원되는 인터페이스를 확인하세요.
Gemini 4 Carbon의 가격은 얼마인가요?
Felo는 Google의 다섯 가지 경로를 제공하며, 현재 모든 경로에 50% 할인이 적용됩니다. AI Studio Flex는 100만 토큰당 입력 $1 / 출력 $5, 일반 AI Studio 및 Vertex 경로는 $2 / $10, Priority 경로는 $3.60 / $18입니다. 캐시 읽기는 100만 토큰당 $0.05부터 시작합니다. 실시간 요금은 Felo 가격 페이지에서 확인하세요.
Gemini 4 Carbon은 언제 출시되었나요?
Google은 2026년 10월 28일 Gemini 4 Carbon을 발표했으며, 초기에는 Fairwind Program을 통해 일부 사이버 보안 방어 전문가에게 제공했습니다. Google의 엔터프라이즈 플랫폼에는 2026년 11월 10일부터 정식 사용이 가능하다고 명시되어 있습니다. 현재 Felo는 Google의 다섯 가지 제공업체 경로를 통해 모델을 제공합니다.
Felo에서 Gemini 4 Carbon 사용해 보기
Carbon의 성능을 판단하는 가장 빠른 방법은 이미 답을 알고 있는 작업을 맡기는 것입니다. Gemini 4 Carbon 플레이그라운드를 열고 실제 문서나 코드 샘플을 입력한 다음 동일한 프롬프트에서 LOW와 HIGH 사고 수준을 비교하세요. 결과가 기대에 부합한다면 API 키를 생성하고 자체 파이프라인에 테스트를 적용하세요.
현재 무료 체험 조건, 제공업체 경로, 사용 한도는 Gemini 4 Carbon 모델 페이지에서 확인하세요. 그런 다음 실제로 수행 중인 가장 어려운 작업을 대상으로 최소 규모의 테스트를 구축하세요.
이 글은 다음 언어로도 읽을 수 있습니다: English, 简体中文, 日本語, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা, Português.