
Felo의 GPT Image 2.6: GIF를 동영상 장면으로 변환하기

Felo의 GPT Image 2.6으로 반복 재생 GIF를 만들고, API로 동작 프레임을 구성한 다음 Kling으로 애니메이션을 제작하세요. 코드와 사용 제한도 포함되어 있습니다.
동영상 모델에 "검을 휘두르는 기사"를 요청하면, 대개 검을 휘두르는 동작이 모호한 형태로 표현됩니다. 검날은 흐릿하게 번지고, 프레임마다 신체 비율이 달라지며, 카메라는 요청하지 않은 움직임을 만들어 냅니다.
영화 감독은 블로킹(blocking)으로 이 문제를 해결합니다. 캐릭터가 어디에 서 있는지, 어떤 동작을 먼저 하는지, 움직임이 어디에서 끝나는지를 정하는 방식입니다. Felo의 GPT Image 2.6은 브라우저에서 1.8초 길이의 반복 재생 GIF로, 또는 이미지 API를 통해 3 × 3 프레임 시트로 이러한 동작 계획을 제공합니다. 두 방식 모두 동영상 모델에 조명, 구도, 음향을 맡긴 후 동작을 결정하는 것보다 비용이 적게 듭니다.
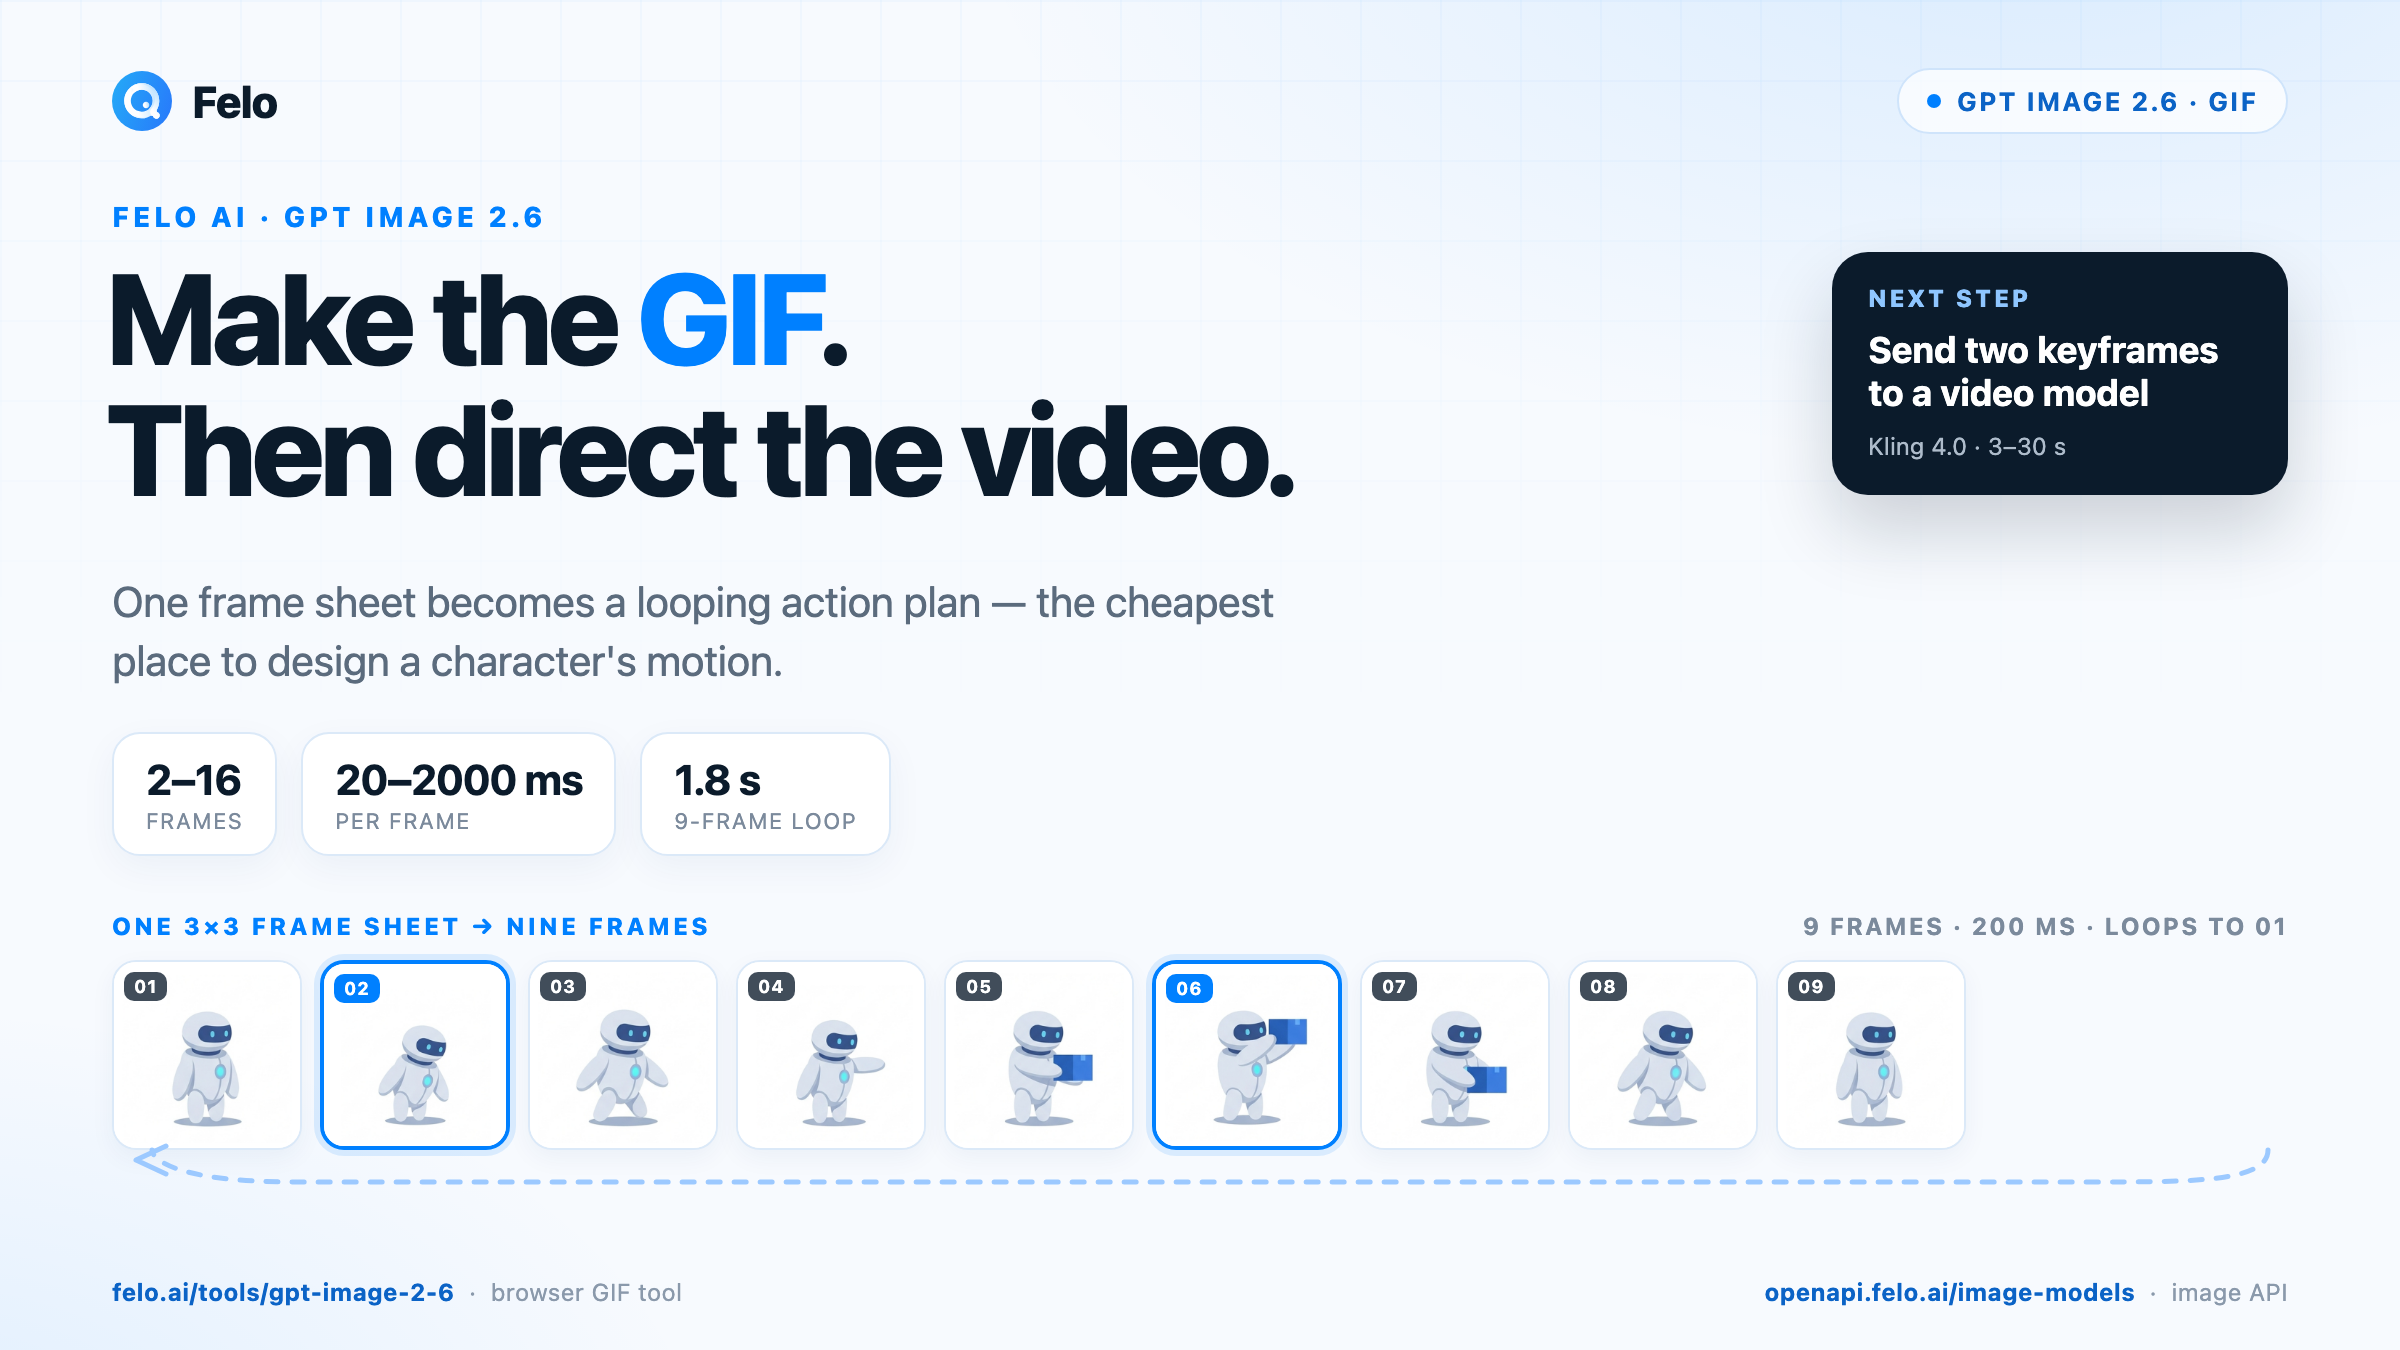
Felo에서 GPT Image 2.6을 사용하는 두 가지 방법
브라우저에서 사용하기: AI GIF 생성기
felo.ai/tools/gpt-image-2-6을 열고 이미지에 대한 설명을 입력한 다음 모델을 선택합니다. 입력창의 기본 모델은 GPT Image 2.6 Flare이며 출력 형식은 PNG입니다. 애니메이션을 만들려면 설정을 열고 GIF를 선택합니다. 프롬프트에 "GIF"라고 입력하는 것만으로는 출력 형식이 바뀌지 않습니다.
GIF 설정은 간결하게 구성되어 있습니다. 프레임 수는 216개, 프레임당 시간은 202000밀리초이며 기본 프레임 크기는 512 × 512입니다. Felo의 기본 설정은 200ms 간격의 9개 프레임으로, 1.8초 길이의 반복 재생 GIF를 생성합니다. 짧은 시간이며 실제로도 짧습니다. 하지만 동작이 제대로 전달되는지 확인하기에는 충분합니다.
참조 이미지를 업로드하고 편집을 요청하거나 스케치 도구로 특정 영역을 지정할 수도 있습니다. 첫 번째 동작 테스트에서는 하나의 피사체, 단순한 배경, 하나의 움직임을 사용하세요.
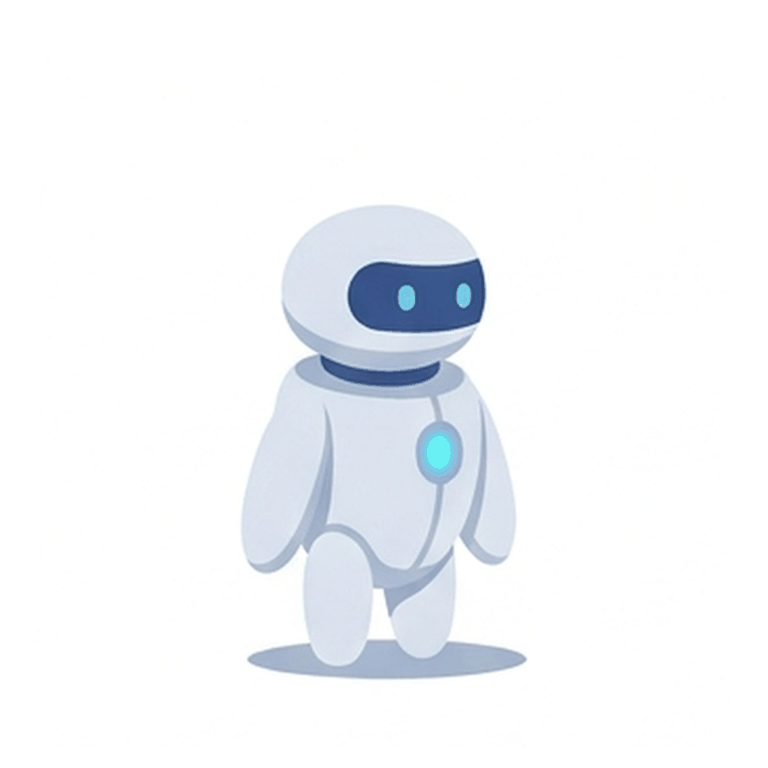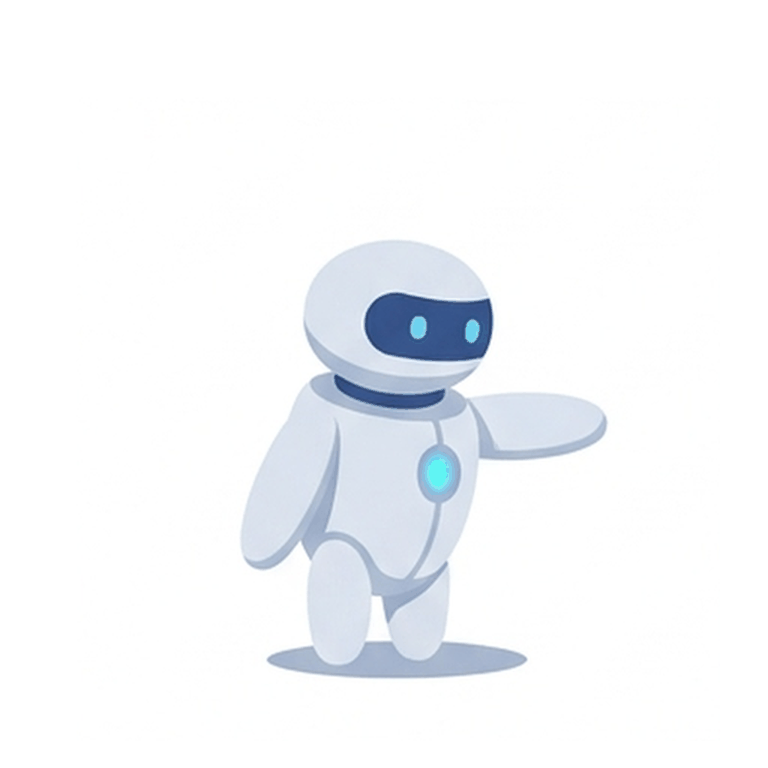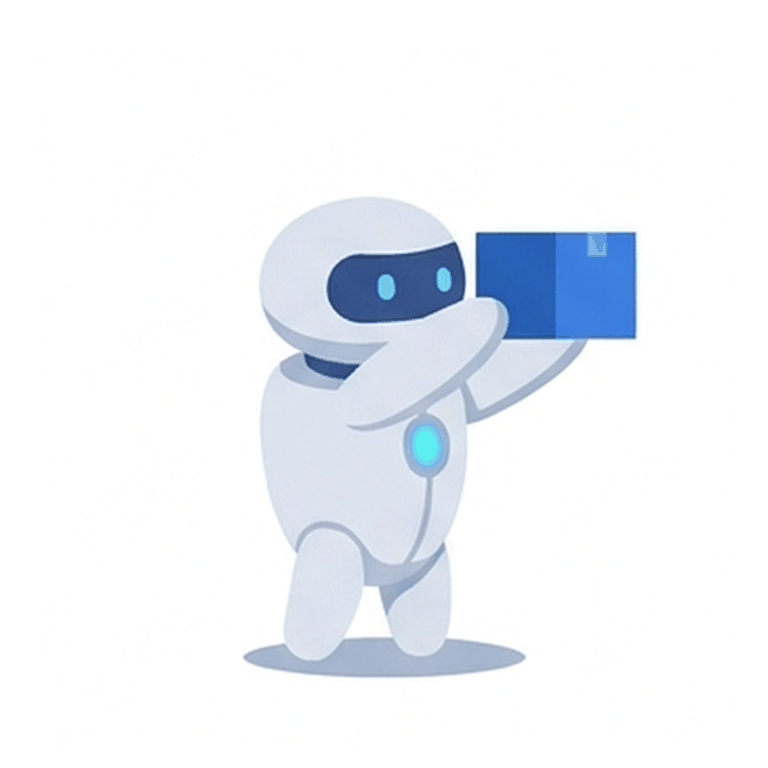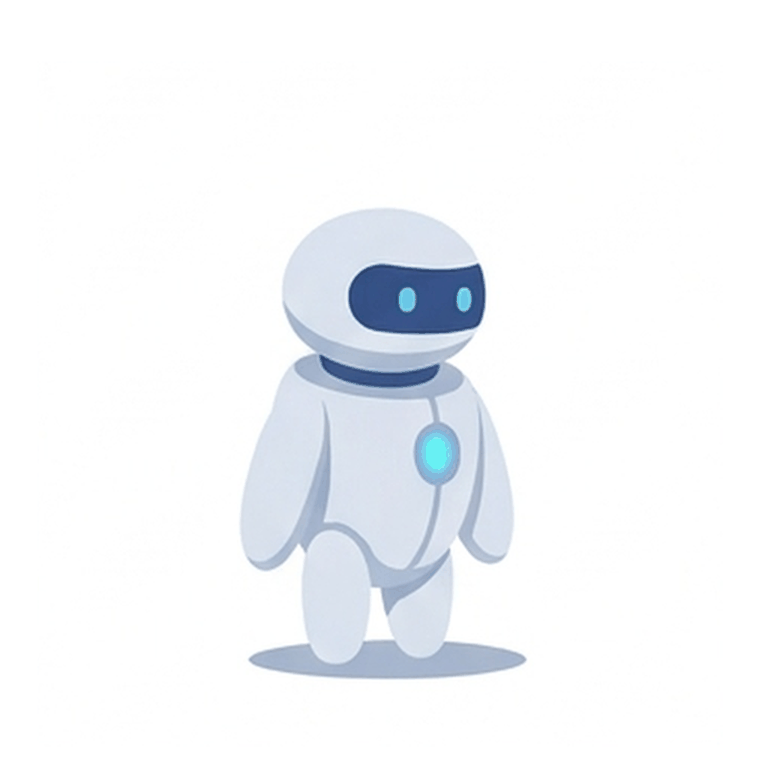
출력 결과를 보여 주는 일러스트레이션: 200ms 간격의 9프레임 루프입니다. 브라우저 도구는 GIF를 직접 생성하며, 아래의 에이전트 워크플로에서는 하나의 3 × 3 시트로 동일한 프레임을 구성합니다.
에이전트와 앱을 위한 API 사용
동일한 두 모델은 Felo의 이미지 모델 카탈로그에 gpt-image-2.6-flare와 gpt-image-2.6-sunburst라는 ID로 등록되어 있습니다. 하나의 API 키로 8개 제공업체의 이미지 모델 18개를 사용할 수 있으므로, 에이전트는 별도의 제공업체 계정을 만들지 않고도 모델을 비교하거나 전환할 수 있습니다.
| GPT Image 2.6 Flare | GPT Image 2.6 Sunburst | |
|---|---|---|
| 설계 목적 | 빠른 초안과 잦은 수정 | 세밀한 이미지와 정밀한 편집 |
| 모델 ID | gpt-image-2.6-flare | gpt-image-2.6-sunburst |
| 입력 / 출력 | 텍스트, 이미지 → 이미지 | 텍스트, 이미지 → 이미지 |
| 이 작업에 적합한 용도 | 동작 아이디어 탐색 | 여러 패널에 걸친 캐릭터 일관성 유지 |
| 표시된 가격 | 입력 토큰 1M개당 $5, 출력 토큰 1M개당 $30 | 입력 토큰 1M개당 $5, 출력 토큰 1M개당 $30 |
가격은 이미지당이 아니라 토큰당 책정되므로 해상도와 참조 이미지가 비용에 영향을 줍니다. 두 모델 페이지에는 기간 한정 무료 체험 배지가 표시되어 있습니다. 프로덕션 작업을 계획하기 전에 현재 이용 조건과 요금을 확인하세요.
브라우저에서는 GIF가 출력되지만 이미지 API는 정지 이미지를 반환합니다. 해당 모델의 output_format 열거형은 png, jpeg, webp이므로 에이전트가 생성된 프레임을 조합해 GIF를 만들어야 합니다. 아래 API 섹션에서 그 방법을 설명합니다.
동영상 프롬프트보다 GIF가 더 나은 첫 번째 초안인 이유
동영상 모델은 보간 엔진입니다. 두 상태 사이의 공간을 채우는 작업에는 능숙하지만, 어떤 상태가 중요한지 결정하는 작업에는 약합니다. 텍스트 프롬프트는 모델이 해석해야 할 문장 하나를 제공합니다. 9프레임 GIF는 포즈, 실루엣, 타이밍에 관한 명확한 결정 9개를 제공합니다.
9프레임이라는 제한은 선택을 요구합니다. 프레임당 200ms라면 모호한 "역동적인 액션 장면"을 표현할 여유가 없습니다. 준비 자세, 동작 준비, 공격, 후속 동작, 원래 자세로의 복귀처럼 구체적인 순서를 정해야 합니다. 동영상 프롬프트의 결과가 좋지 않은 이유는 대부분 이러한 결정을 내리지 않았기 때문입니다.
루프에는 또 하나의 제약이 있습니다. 자연스럽게 반복되는 GIF는 시작 포즈로 돌아와야 합니다. 이 조건은 장면 편집에도 도움이 됩니다. 캐릭터의 팔이 새로운 위치에서 끝나면 다음 장면은 이전과 다른 신체 자세에서 시작됩니다.
전체 결과를 몇 초 안에 검토할 수도 있습니다. 실루엣, 손, 소품, 마지막 프레임과 첫 프레임 사이의 연결을 확인하세요. 에이전트는 두 프레임을 비교하거나 비전 모델에 변경 사항을 설명하도록 요청할 수 있습니다. 이 모든 작업은 동영상 1초를 생성하는 비용을 지불하기 전에 수행할 수 있습니다.
Felo의 도구 페이지에는 다음과 같이 명시되어 있습니다. "GIF는 무음 반복 영상입니다. 사운드, 긴 장면 또는 여러 컷이 필요하면 동영상 도구를 사용하세요." 이 문장은 워크플로의 출발점이지, 최종 단계가 아닙니다.
브라우저에서 동작 구성하기
캐릭터의 동작을 동영상 장면으로 만들기 전에 설계하는 실용적인 루프를 살펴보겠습니다.
1. 먼저 캐릭터를 확정하세요
애니메이션부터 시작하지 마세요. 정면을 바라보는 캐릭터의 중립적인 자세와 단순한 배경을 갖춘 정지 참조 이미지를 생성하세요. 애니메이션을 만들 때는 헤어스타일, 의상 색상, 액세서리, 무기, 신체 비율 등 프롬프트의 모든 세부 사항을 동일하게 유지하세요. 별도의 생성 작업에서는 일관성이 달라질 수 있으므로 설명을 구체적으로 작성할수록 프레임 사이의 빈 부분을 모델이 임의로 채울 여지가 줄어듭니다.
2. 장면이 아닌 루프로 동작을 작성하세요
유용한 동작 프롬프트에는 네 가지 요소가 있습니다.
- 장면 설정. 프레임에 무엇이 있는지, 어디에 위치하는지, 어떤 모습인지 설명합니다.
- 하나의 움직임 지정. 무엇이 어떤 순서로 움직이는지 설명합니다.
- 유지할 요소 고정. 카메라, 발, 로고, 손 등 움직이지 않아야 할 요소를 지정합니다.
- 원래 자세로 복귀 요청. 시작 자세로 돌아오는 동작으로 끝냅니다.
예를 들면 다음과 같습니다.
겨자색 노란색 재킷을 입은 배달원이 밝은 석재 거리 위에 서 있다. 측면 시점, 전신 구도, 고정 카메라. 체중을 한쪽으로 옮기고, 가방에 손을 넣어 작은 파란색 소포를 꺼낸 다음 앞으로 내민다. 재킷과 가방, 카메라는 움직이지 않게 유지한다. 그런 다음 소포를 내리고 시작 자세로 돌아온다. 움직임이 부드러운 루프를 형성하도록 한다. 단순한 배경, 텍스트 없음.
이 프롬프트는 의도적으로 단순하게 작성되었습니다. 여기서는 단순함이 장점입니다. 명확한 동작 하나는 512 × 512 해상도와 9개 프레임으로도 전달됩니다. 군중, 비, 카메라 움직임은 동영상 모델을 사용할 때 추가하세요.
3. 설정에서 GIF를 선택하고 작은 규모로 시작하세요
512 × 512, 9프레임, 프레임당 200ms로 설정합니다. 생성 작업을 시작하세요. 기본 동작이 제대로 전달되기 전에는 프레임을 추가하지 마세요.
루프가 원하는 결과를 내지 못하면 다음 순서로 수정하세요. 먼저 프레임 수를 줄이고 동작을 단순하게 만듭니다. 다음으로 프레임 시간을 늘립니다. 마지막으로 유지해야 할 세부 사항을 추가합니다.
4. 중간 장면뿐 아니라 연결 부분을 검토하세요
루프를 두 번 재생해서 확인하세요. 마지막 프레임과 첫 프레임 사이의 연결 부분에서 대부분의 문제가 드러납니다. 어깨 위치가 갑자기 바뀌거나, 소품을 든 손이 바뀌거나, 배경이 이동하는 문제가 나타날 수 있습니다.
그런 다음 한 번에 하나의 변수만 변경하세요. 새로운 포즈 아이디어는 새로운 프롬프트로 테스트합니다. 타이밍 조정은 프레임 수나 프레임 시간을 변경해서 진행합니다. 두 가지를 함께 변경하면 어떤 수정이 효과가 있었는지 알 수 없습니다.
GIF에서 동영상으로: 두 가지 전달 방식
Felo의 동영상 API는 애니메이션 GIF 입력을 지원하지 않습니다. 정지 이미지나 동영상만 입력할 수 있으므로 전달 과정에 변환 단계가 필요합니다. 두 가지 방법이 있으며, GIF 자체를 최종 결과물로 사용하는 세 번째 방법도 있습니다.
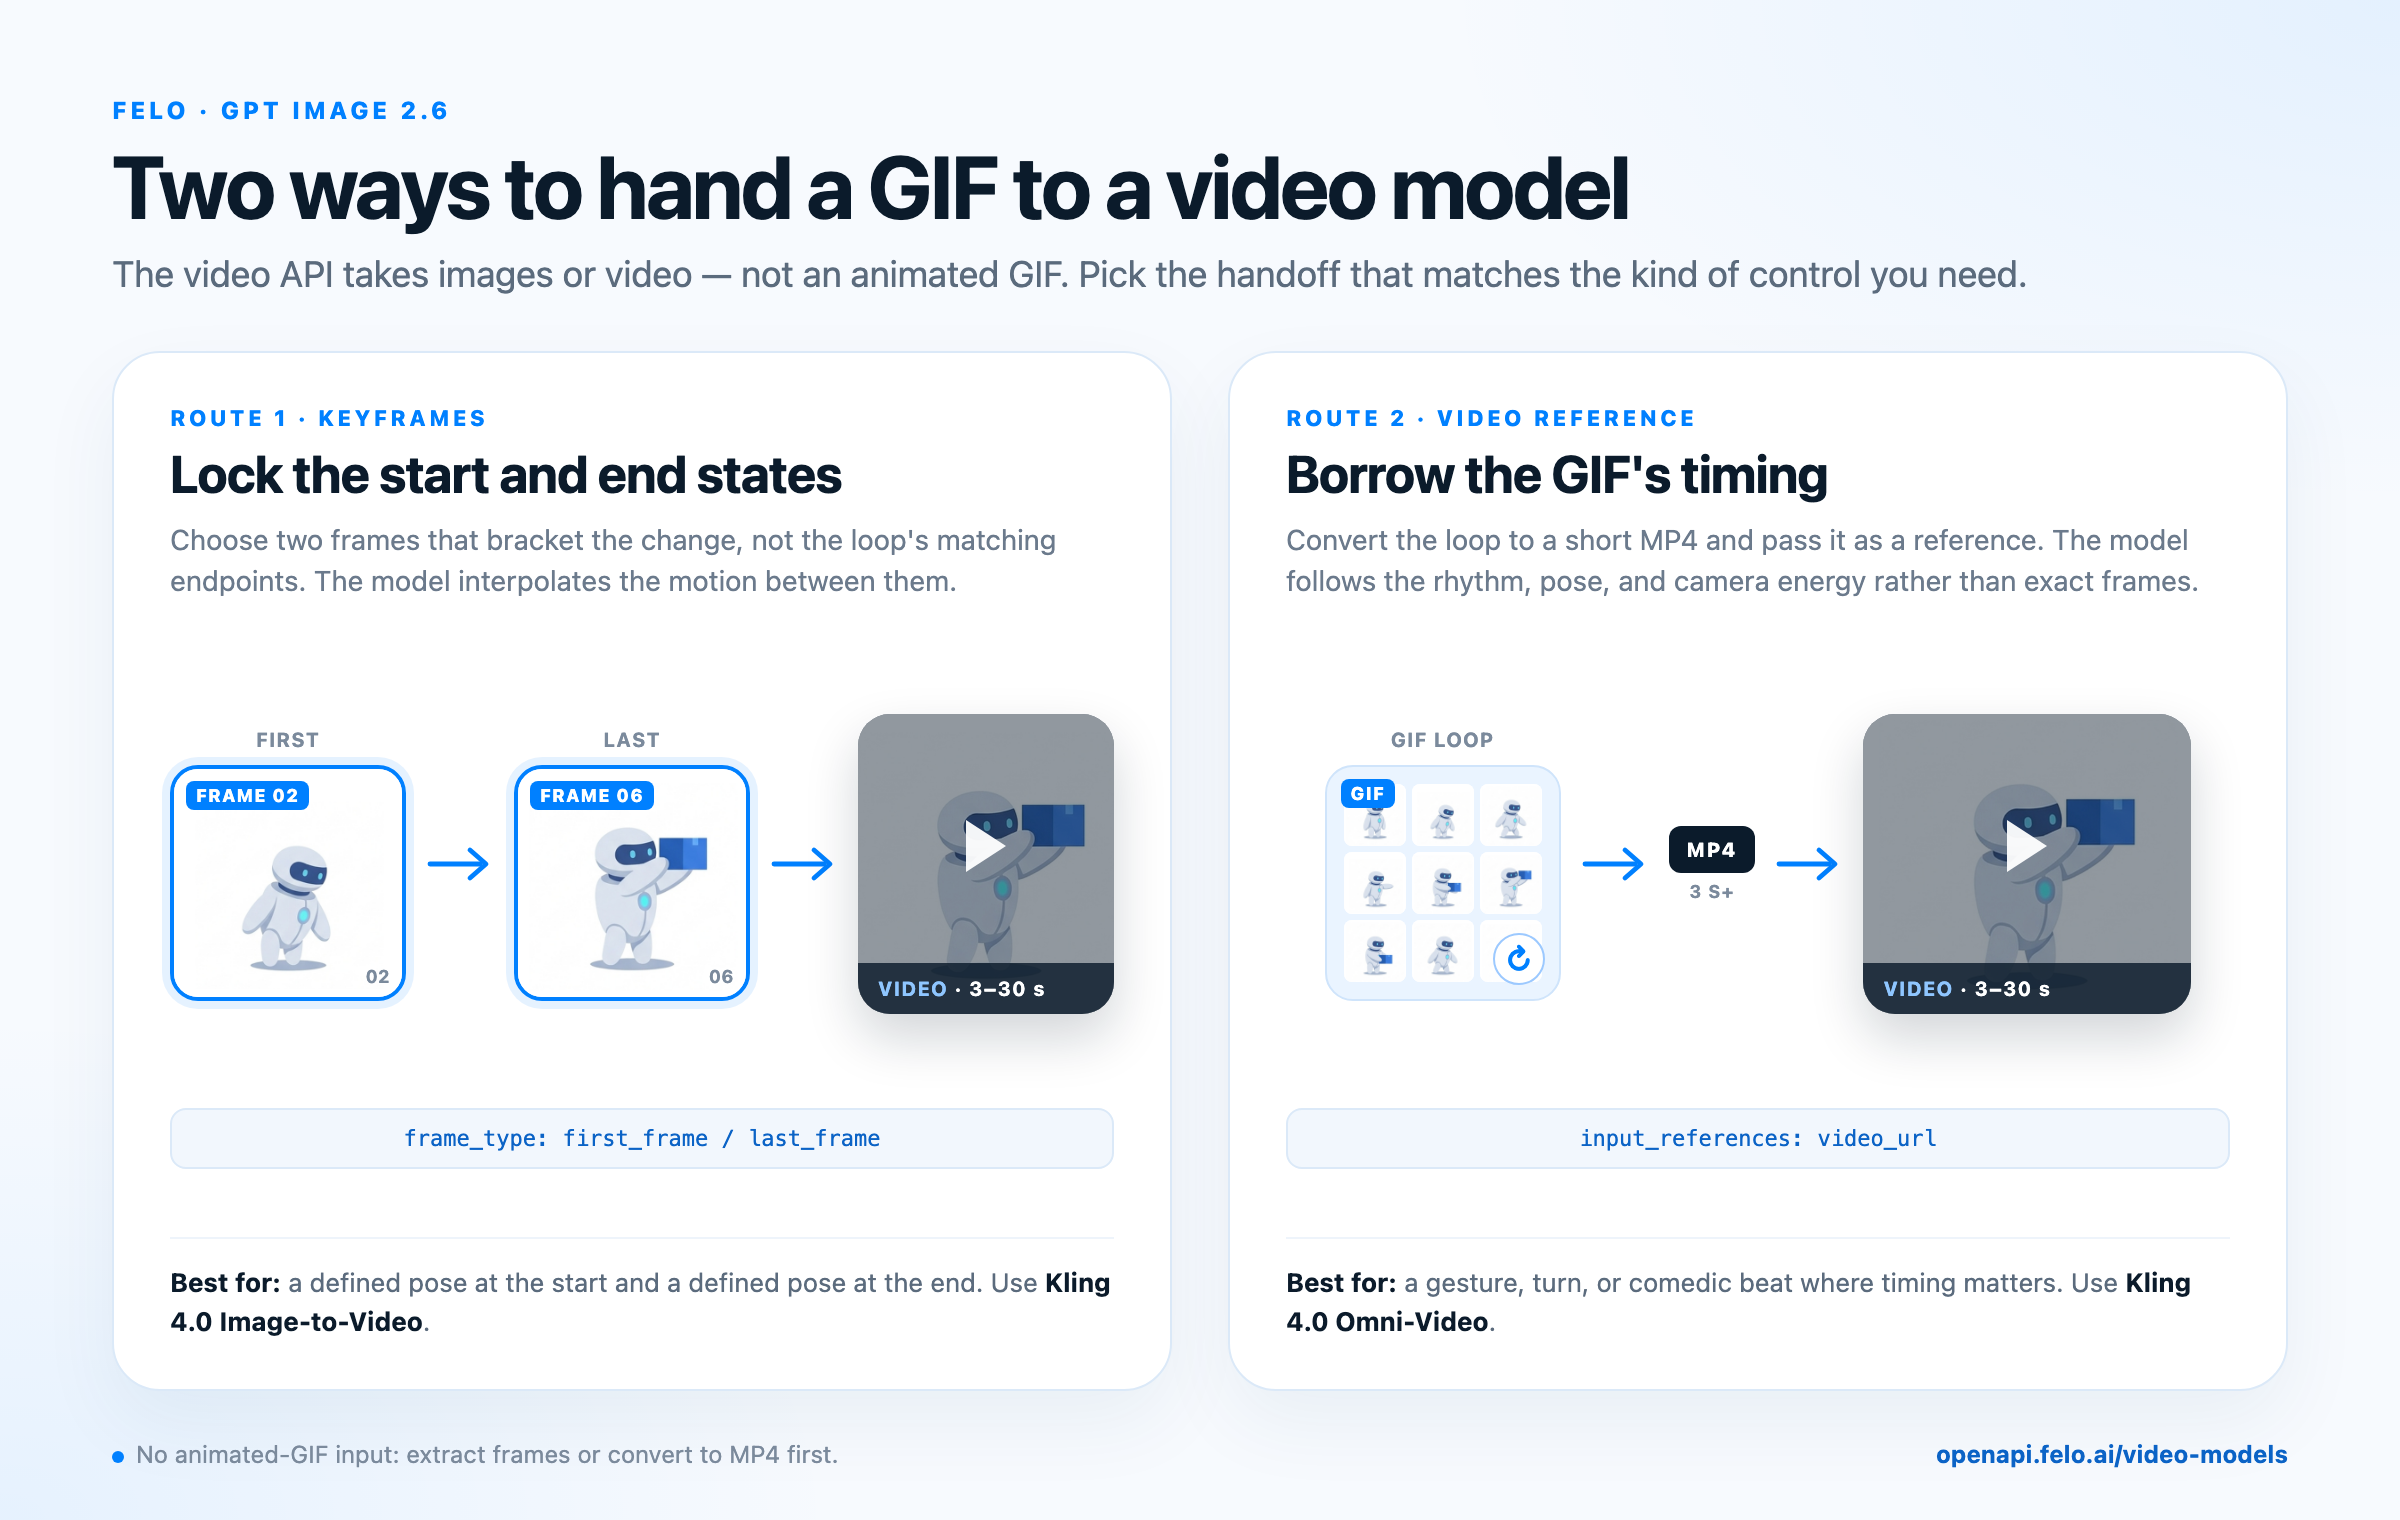
키프레임은 시작과 종료 상태를 고정하고, 동영상 참조는 GIF의 타이밍을 활용합니다.
방법 1: 키프레임으로 시작과 끝 상태 지정하기
원하는 변화의 시작과 끝을 보여 주는 두 프레임을 선택하세요. 배달원의 경우 루프의 첫 프레임과 마지막 프레임은 의도적으로 동일하므로, 패널 2(체중 이동)와 패널 6(소포를 앞으로 내민 자세)을 선택합니다. frame_images에 두 이미지를 전달하고 frame_type을 first_frame 또는 last_frame으로 설정합니다.
이렇게 하면 선택한 시작 상태와 종료 상태가 고정됩니다. 프롬프트에서는 두 이미지에 담기지 않은 카메라 움직임, 조명, 속도만 설명하면 됩니다.
Kling 4.0 Image-to-Video는 이 작업에 적합합니다. 모델 페이지에는 지원 매개변수로 frame_images가 등록되어 있으며, 스테레오 오디오가 포함된 3~30초 클립을 지원한다고 설명되어 있습니다. 선택한 두 포즈를 입력하면 모델이 두 포즈 사이의 움직임을 보간합니다.
키프레임 방식에 사용할 짧은 프롬프트는 다음과 같습니다.
동일한 겨자색 재킷을 입은 배달원이 동일한 석재 거리에서 가방에 손을 넣고 파란색 소포를 앞으로 내민다. 느린 카메라 줌인, 부드러운 늦은 오후의 빛, 얕은 피사계 심도. 캐릭터의 얼굴과 의상, 소포를 변경하지 않는다. 자연스러운 거리 주변 소리를 포함한다.
동영상 모델은 두 포즈 사이의 움직임을 채웁니다. 문장 하나만으로 전체 동작을 만들어 내도록 요청하는 것보다 창작 과정의 부담이 적습니다.
방법 2: 동영상 참조로 GIF의 타이밍 활용하기
동영상이 GIF의 리듬을 따르도록 하려면 루프를 짧은 MP4로 변환한 다음 동영상 참조로 전달하세요. 동영상 API의 input_references는 image_url 참조와 함께 video_url 항목을 지원합니다.
ffmpeg -stream_loop 1 -i action.gif -t 3 -movflags +faststart -pix_fmt yuv420p action.mp4
Kling 4.0 Omni-Video는 참조 기반 동영상 생성에 적합한 옵션입니다. 모델 페이지에는 최대 5개의 3~30초 동영상 클립을 지원하며, 전체 길이는 30초를 넘을 수 없다고 명시되어 있습니다. 최대 10개의 이미지 참조도 함께 사용할 수 있습니다. 따라서 하나의 요청에 동작 스케치와 캐릭터 이미지를 함께 전달할 수 있습니다.
타이밍이 핵심인 경우 이 방법을 사용하세요. 세 박자로 구성된 제스처, 회전 동작, 코믹한 멈춤 등이 해당합니다. Omni-Video는 3~30초 길이의 동영상 참조를 지원하므로 GIF를 내보내기 전에 최소 3초 길이로 반복 재생되도록 설정하세요. 250ms 간격의 12프레임도 3초를 만듭니다.
동영상 모델은 참조 영상의 전체적인 리듬과 포즈를 따르지만 프레임 단위로 복제하지는 않습니다. 시작과 종료 상태를 정확하게 지정해야 한다면 키프레임을 사용하세요.
GIF를 최종 결과물로 사용하기
때로는 GIF 자체가 최종 결과물입니다. 반복 재생 스티커, UI 상태 표시, 소셜 미디어 게시물, 게임 스프라이트에는 동영상 모델이나 사운드트랙이 필요하지 않습니다. Felo의 GPT Image 2.6 모델 활용 사례에는 픽셀 아트 스타일의 물검 루프, 초상화의 고개 돌리기와 윙크, 일본 이벤트 배너가 포함되어 있습니다. 세 가지 모두 짧고 명확한 움직임을 중심으로 구성되어 있습니다.
GIF 형식에는 명확한 제약이 있습니다. 프레임당 256색, 오디오 미지원, 크기와 프레임 수에 따른 빠른 파일 용량 증가가 대표적입니다. 단색과 단순한 배경은 색상 제한의 영향을 줄입니다. 그라데이션과 피부색 표현에서는 색상 띠 현상이 나타날 수 있습니다.
GPT Image 2.6 API: 제출, 상태 확인, 결과 수집
사람은 브라우저에서 GIF 생성 과정을 지켜볼 수 있습니다. 하지만 API가 명확한 작업 계약을 제공하지 않으면 에이전트는 이 작업을 수행할 수 없습니다. Felo의 API는 제출, 상태 확인, 결과 수집이라는 절차를 제공합니다.
이미지 엔드포인트는 POST https://openapi.felo.ai/api/v1/images/generations이며 Bearer 키를 사용합니다. 요청을 보내면 202와 task_id가 반환됩니다. GET /api/v1/images/generations/{task_id}를 호출해 status가 succeeded가 될 때까지 상태를 확인한 다음 outputs에서 서명된 미디어 URL을 가져옵니다.
요청 본문은 모델 ID, 프롬프트, quality, aspect_ratio, output_format, 참조 이미지를 위한 input_references를 지원합니다. 로컬 참조 이미지가 필요하면 먼저 POST /api/v1/files로 업로드하세요. 해당 엔드포인트는 PNG, JPEG, GIF, WebP, MP4 및 기타 일반적인 형식을 지원하며 최대 크기는 100 MiB입니다. 업로드 후 파일 레코드가 반환됩니다. 반환된 id를 input_references의 file_id로 전달합니다.
GIF가 필요한 에이전트에는 하나의 이미지 호출로 전체 동작을 스토리보드 시트로 생성한 다음 프레임을 분할하는 방법이 가장 적합합니다. 하나의 요청으로 9개의 포즈를 생성하고, 정해진 방식으로 프레임을 분할한 다음, 로컬에서 GIF를 조립합니다. 동영상 생성 단계에도 동일한 프레임이 필요하므로 중복 생성이 발생하지 않습니다.
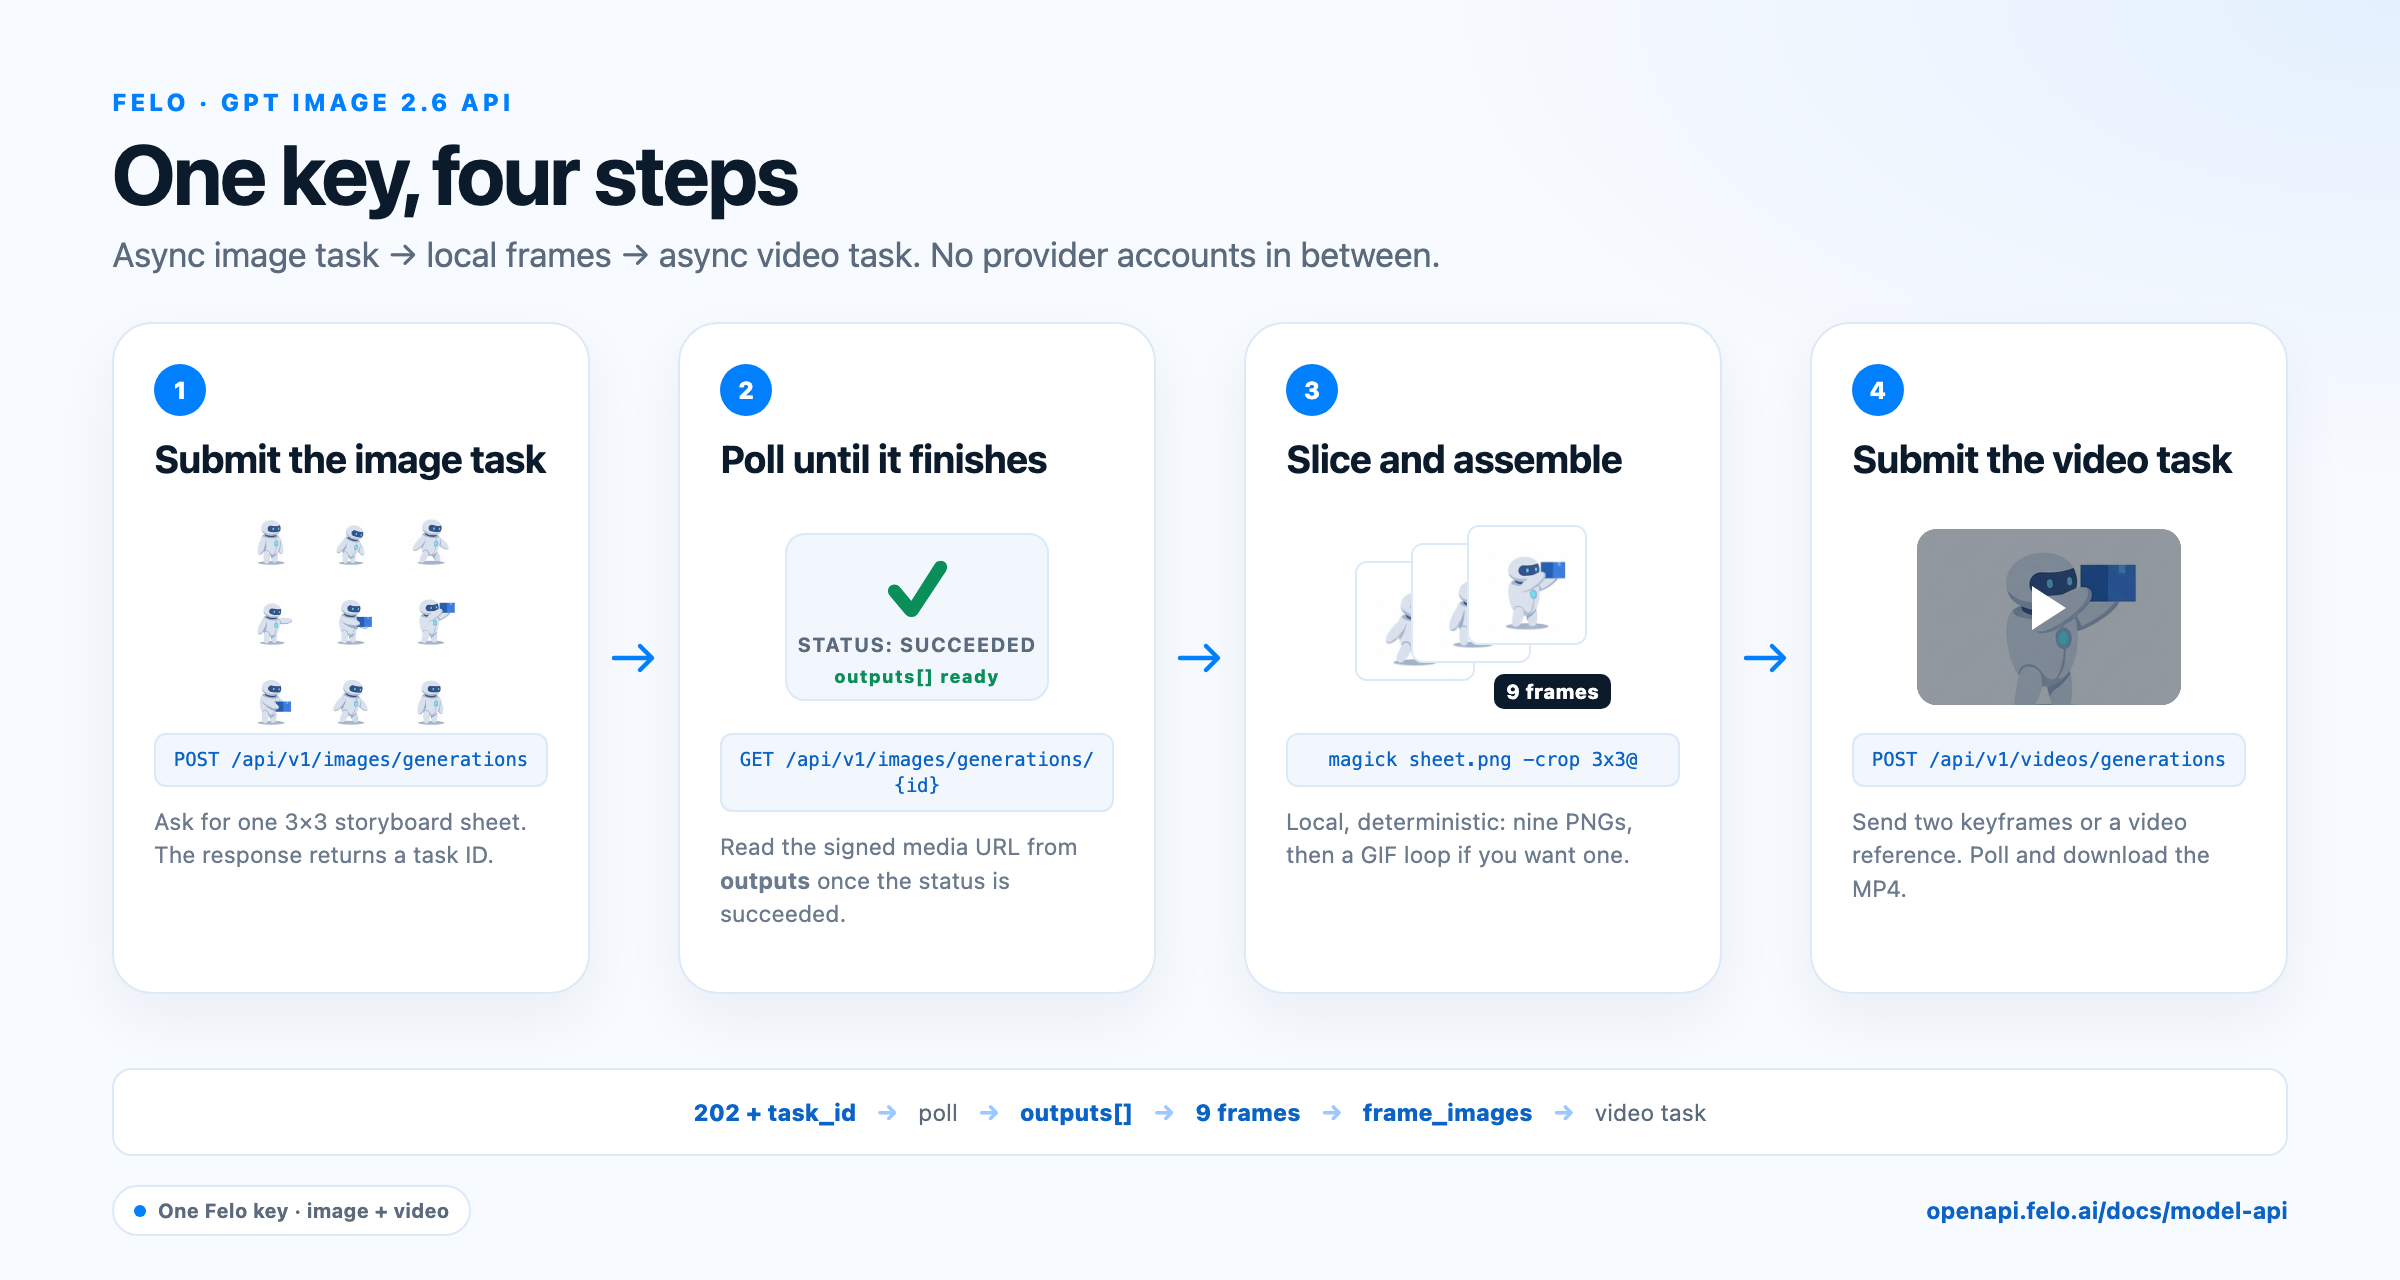
작업 순서: 이미지 작업 제출, 결과 상태 확인, 로컬에서 시트 분할, 프레임을 포함한 동영상 작업 제출.
한 번의 호출로 9개 포즈 요청하기
이 작업에 사용할 스토리보드 프롬프트는 다음과 같습니다.
단순한 흰색 배경에 3 × 3 스토리보드 시트를 배치한다. 9개의 동일한 정사각형 패널이 간격 없이 맞닿아 있다. 겨자색 노란색 재킷을 입은 동일한 배달원이 모든 패널에 등장한다. 측면 시점, 전신 구도, 동일한 신체 비율과 색상, 동일한 가방을 유지한다. 패널 1은 서 있는 자세, 패널 2는 체중을 이동하는 자세, 패널 3은 가방에 손을 넣는 자세, 패널 4는 가방을 여는 자세, 패널 5는 파란색 소포를 꺼내는 자세, 패널 6은 소포를 앞으로 내미는 자세, 패널 7은 소포를 내리는 자세, 패널 8은 손을 옆으로 되돌리는 자세, 패널 9는 패널 1과 동일한 자세로 구성한다. 평면 조명, 일정한 크기, 텍스트 없음, 캡션 없음, 패널 번호 없음.
1K 시트는 자르기 작업 후 약 340픽셀 크기의 타일을 생성합니다. 이는 브라우저에서 생성하는 512픽셀 프레임보다 선명도가 낮습니다. 사용 중인 채널에서 더 큰 크기를 지원한다면 더 큰 정사각형 이미지를 요청하세요. 분할하기 전에 시트를 확인하세요. 패널 크기가 고르지 않거나 캐릭터의 모습이 바뀌었다면 잘라낸 후 수정하려 하지 말고 더 단순한 레이아웃 지침으로 다시 생성하세요.
제출, 분할, 조립
import os
import time
import requests

BASE = "https://openapi.felo.ai/api/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['FELO_API_KEY']}"}

def poll(path, timeout=900, interval=5):
    deadline = time.time() + timeout
    while time.time() < deadline:
        response = requests.get(f"{BASE}{path}", headers=HEADERS, timeout=30)
        response.raise_for_status()
        task = response.json()
        if task["status"] in {"succeeded", "failed", "interrupted"}:
            if task["status"] != "succeeded":
                raise RuntimeError(task.get("error", task["status"]))
            return task
        time.sleep(interval)
    raise TimeoutError(path)

STORYBOARD_PROMPT = (
    "A 3x3 storyboard sheet on plain white, nine equal square panels edge to edge, "
    "the same courier in a mustard jacket in every panel, side view, full body, "
    "identical proportions and colors: standing, shifting weight, reaching into a "
    "satchel, opening it, pulling out a blue parcel, holding it forward, lowering it, "
    "hand at side, standing again. Flat lighting, consistent scale, no text, no gutters."
)

response = requests.post(
    f"{BASE}/images/generations",
    headers=HEADERS,
    json={
        "model": "gpt-image-2.6-sunburst",
        "prompt": STORYBOARD_PROMPT,
        "aspect_ratio": "1:1",
        "quality": "medium",
    },
    timeout=60,
)
response.raise_for_status()

result = poll(f"/images/generations/{response.json()['task_id']}")
output = result["outputs"][0]
sheet_url = output["url"] if isinstance(output, dict) else output
with open("sheet.png", "wb") as file:
    file.write(requests.get(sheet_url, timeout=60).content)
그런 다음 시트를 분할하고 로컬에서 루프를 조립합니다.
magick sheet.png -crop 3x3@ +repage -resize 512x512! frame-%02d.png
magick -delay 20 -loop 0 frame-*.png action.gif   # 20/100 s = 200 ms per frame
ImageMagick 6 사용자는 magick 대신 convert를 사용할 수 있습니다. 프롬프트에서 간격이 없는 패널을 요청했으므로 이미지 분할 영역은 균등합니다.
두 개의 키프레임을 동영상 모델에 전달하기
def upload(path):
    with open(path, "rb") as file:
        response = requests.post(
            f"{BASE}/files", headers=HEADERS, files={"file": file}, timeout=60
        )
    response.raise_for_status()
    return response.json()["id"]

VIDEO_PROMPT = (
    "The same courier on the same stone street reaches into the satchel and holds "
    "out a blue parcel. Slow push-in, soft late-afternoon light, shallow depth of "
    "field. Keep the face, clothing, and parcel unchanged."
)

# Panels 2 and 6 bracket the change; the loop's matching endpoints do not.
first_id = upload("frame-01.png")
last_id = upload("frame-05.png")

video = requests.post(
    f"{BASE}/videos/generations",
    headers=HEADERS,
    json={
        "model": "kling-4.0/image-to-video",
        "prompt": VIDEO_PROMPT,
        "duration": 5,
        "resolution": "720p",
        "frame_images": [
            {"type": "image_url", "frame_type": "first_frame",
             "image_url": {"file_id": first_id}},
            {"type": "image_url", "frame_type": "last_frame",
             "image_url": {"file_id": last_id}},
        ],
    },
    timeout=60,
)
video.raise_for_status()
video_task = video.json()["task_id"]
동영상 작업도 동일한 방식으로 상태를 확인한 다음 서명된 출력 URL에서 파일을 다운로드합니다. 엔드포인트는 POST https://openapi.felo.ai/api/v1/videos/generations입니다. 이미지 작업과 마찬가지로 작업에는 status와 outputs가 포함됩니다. 전체 동영상 API 목록은 동영상 모델 페이지에서 확인할 수 있습니다.
에이전트에 통합하기
에이전트는 소수의 이미지 생성 비용으로 여러 동작 시트를 만들고 비교한 다음 동영상 생성 비용을 지출할 수 있습니다. 어떤 프롬프트가 어떤 시트를 생성했는지도 기록할 수 있습니다. 사람이 UI를 클릭하며 작업하는 방식에서는 이러한 기록을 남기기 어렵습니다.
동일한 키로 채팅, 이미지, 동영상 모델을 사용할 수 있으므로 전체 워크플로를 하나의 에이전트에 통합할 수 있습니다. 계획 모델이 동작 단계를 작성하고, 이미지 호출이 시트를 렌더링하며, 비전 모델이 일관성을 검사하고, 동영상 호출이 장면을 완성합니다. Felo는 OpenAI 호환 및 Anthropic 호환 기본 URL과 Codex, Claude Code, DeepSeek Harness, OpenClaw 및 기타 에이전트 클라이언트를 위한 설정 가이드를 제공합니다. 따라서 기존 에이전트를 다시 구축하지 않고도 플랫폼에 연결할 수 있습니다.
이 파이프라인으로 해결할 수 없는 문제
GIF 우선 방식은 동작 설계의 모호함을 줄여 줍니다. 하지만 동영상 모델이 프레임 단위의 정확성을 보장하는 것은 아닙니다.
- 움직임의 변화가 발생합니다. 동영상 모델은 보간을 수행하므로 키프레임 사이에서 손의 위치나 옷 주름이 달라질 수 있습니다. 참조 이미지는 도움이 되지만 결과물을 검토해야 합니다.
- 짧은 영상에는 한계가 있습니다. 2~16개 프레임은 하나의 제스처이지 장면이 아닙니다. 여러 제스처로 장면을 구성하고 동영상 모델에 전환을 맡기세요.
- 프레임 내부의 텍스트는 불안정합니다. 글자는 프레임마다 흔들릴 수 있습니다. 애니메이션 안에 제목을 넣지 말고 디자인 도구에서 추가하세요.
- 모델 목록은 변경됩니다. 체험 조건과 지원 매개변수는 실시간으로 변경되는 정보이므로 프로덕션 환경에 모델 ID를 연결하기 전에 모델 페이지나 Playground를 확인하세요.
FAQ
Felo의 GPT Image 2.6으로 애니메이션 GIF를 생성할 수 있나요?
네. 브라우저 도구에서 가능합니다. GPT Image 2.6을 선택하고 설정을 열어 GIF를 선택하세요. 이 패널은 216개 프레임, 프레임당 202000ms, 기본 512 × 512 크기를 지원합니다. 200ms 간격의 9개 프레임을 사용하면 1.8초 길이의 루프가 생성됩니다.
API를 통해 GPT Image 2.6을 호출할 수 있나요?
네. Felo API 플랫폼에서 POST /api/v1/images/generations를 호출하고 gpt-image-2.6-flare 또는 gpt-image-2.6-sunburst 모델 ID를 사용하세요. Felo API 키 하나로 호출할 수 있으며 OpenAI, Google, Kuaishou 계정은 필요하지 않습니다. 호출은 비동기 방식으로 처리됩니다. 요청을 제출하고 작업 상태를 확인한 다음 출력을 다운로드하세요.
이미지 API는 GIF 파일을 반환하나요?
현재는 그렇지 않습니다. 공개 이미지 API에는 해당 모델의 출력 형식으로 png, jpeg, webp가 등록되어 있습니다. 에이전트는 프레임 시트나 정지 이미지 시퀀스를 생성한 다음 ImageMagick 또는 ffmpeg를 사용해 로컬에서 조립할 수 있습니다. 동영상 생성 단계에서도 개별 프레임이 필요하므로 이 방식이 더 적합한 결과물을 제공하는 경우가 많습니다.
Felo에서 GIF를 동영상으로 변환하려면 어떻게 해야 하나요?
GIF를 동작 계획으로 사용한 다음 두 가지 방법 중 하나로 이미지-동영상 API에 전달하세요. 변화의 시작과 끝을 보여 주는 두 개의 키프레임을 추출해 frame_images로 전송하거나, 루프를 MP4로 변환해 video_url 참조로 전달할 수 있습니다. Felo의 동영상 API는 애니메이션 GIF를 직접 지원하지 않습니다.
GPT Image 2.6 GIF의 비용은 얼마인가요?
두 모델의 가격은 토큰당 책정됩니다. 입력 토큰 1M개당 $5, 출력 토큰 1M개당 $30입니다. 따라서 해상도가 높거나 참조 이미지가 많으면 비용이 증가합니다. 브라우저 도구와 API는 Felo 사용량 한도를 공유합니다. 현재 요금과 체험 조건은 모델 페이지에서 확인하세요.
루프부터 시작하세요
AI 동영상의 품질을 높이는 확실한 방법은 처음부터 동영상 생성을 요청하지 않는 것입니다. 눈으로 확인할 수 있을 만큼 작은 동작을 만들고, 반복 재생하고, 연결 부분을 수정한 다음 조명, 카메라, 사운드를 추가할 수 있는 모델에 프레임을 전달하세요.
Felo의 GPT Image 2.6을 사용해 브라우저에서 첫 번째 루프를 만들어 보세요. 에이전트 내부에 워크플로를 통합할 준비가 되었다면 이미지 모델 API를 살펴보고 API 키를 생성한 다음 첫 번째 요청을 보내세요. GIF는 계획이고, 동영상은 공연입니다.
이 글은 다음 언어로도 읽을 수 있습니다: English, 简体中文, 日本語, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা, Português.