
Gemini 4 Carbon na Felo API: especificações, benchmarks, preços e casos de uso

Gemini 4 Carbon na Felo API: seu orçamento unificado de 1 milhão de tokens, níveis de raciocínio, limites multimodais, benchmarks publicados, preços reais e como fazer chamadas ao modelo.
O Gemini 4 Carbon, do Google, é um modelo voltado para tarefas que não podem ser resolvidas em uma única etapa rápida: uma migração de base de código que envolve dezenas de serviços, uma investigação de vulnerabilidades que precisa terminar com uma correção funcional ou uma questão de pesquisa que exige uma cadeia de evidências, em vez de um parágrafo repleto de afirmações confiantes.
O modelo está disponível na Felo API, que oferece um teste gratuito por tempo limitado e tarifas promocionais dos provedores. Você pode acessar o modelo, testar prompts no playground e criar uma chave na página do Gemini 4 Carbon na Felo antes de continuar a leitura deste guia.
Este artigo é um guia prático, não um anúncio de lançamento. Ele explica o que é o Carbon, como ele se diferencia do Gemini 4 Argon, o que os benchmarks publicados revelam e o que não revelam, como funciona seu orçamento incomum de tokens, quais são seus pontos fortes, onde pode decepcionar e quanto custa na Felo.
O que é o Gemini 4 Carbon
O Gemini 4 Carbon é o modelo de ponta do Google para trabalhos agênticos de longa duração em programação, finanças, direito, cibersegurança e ciência. O Google anunciou o modelo em 28 de outubro de 2026, desenvolveu-o com base no Gemini 4 Argon e fez o lançamento inicial para um grupo restrito de profissionais de defesa cibernética por meio do Fairwind Program. A documentação da plataforma empresarial do Google já apresenta o modelo como disponível para uso geral, com data de lançamento em 10 de novembro de 2026.
O nome "Carbon" não indica uma nova geração. Ele representa um ponto operacional diferente dentro da família Gemini 4. Enquanto o Argon foi ajustado para produzir documentos longos e coerentes em uma única trajetória, o Carbon dedica uma parcela maior de seu orçamento ao raciocínio: explorar hipóteses, executar ciclos de verificação e coordenar trabalhos com várias etapas. Segundo o Google, o Carbon utiliza mais tokens de raciocínio que o Argon para chegar às respostas.
Essa escolha tem um custo. O modelo é mais lento em tarefas complexas, pode atingir o tempo limite em determinadas condições e consome mais tokens nos níveis de raciocínio elevados. O Google apresenta essas limitações de forma explícita. Ainda assim, vale usar o Carbon porque as tarefas para as quais foi desenvolvido — análise de segurança, grandes migrações, raciocínio científico e revisão de documentos de alto risco — exigem profundidade acima de velocidade.
Especificações do modelo em resumo
| Especificação | Valor |
|---|---|
| ID do modelo na Felo | gemini-4-carbon |
| Anúncio | 28 de outubro de 2026 |
| Base de desenvolvimento | Gemini 4 Argon |
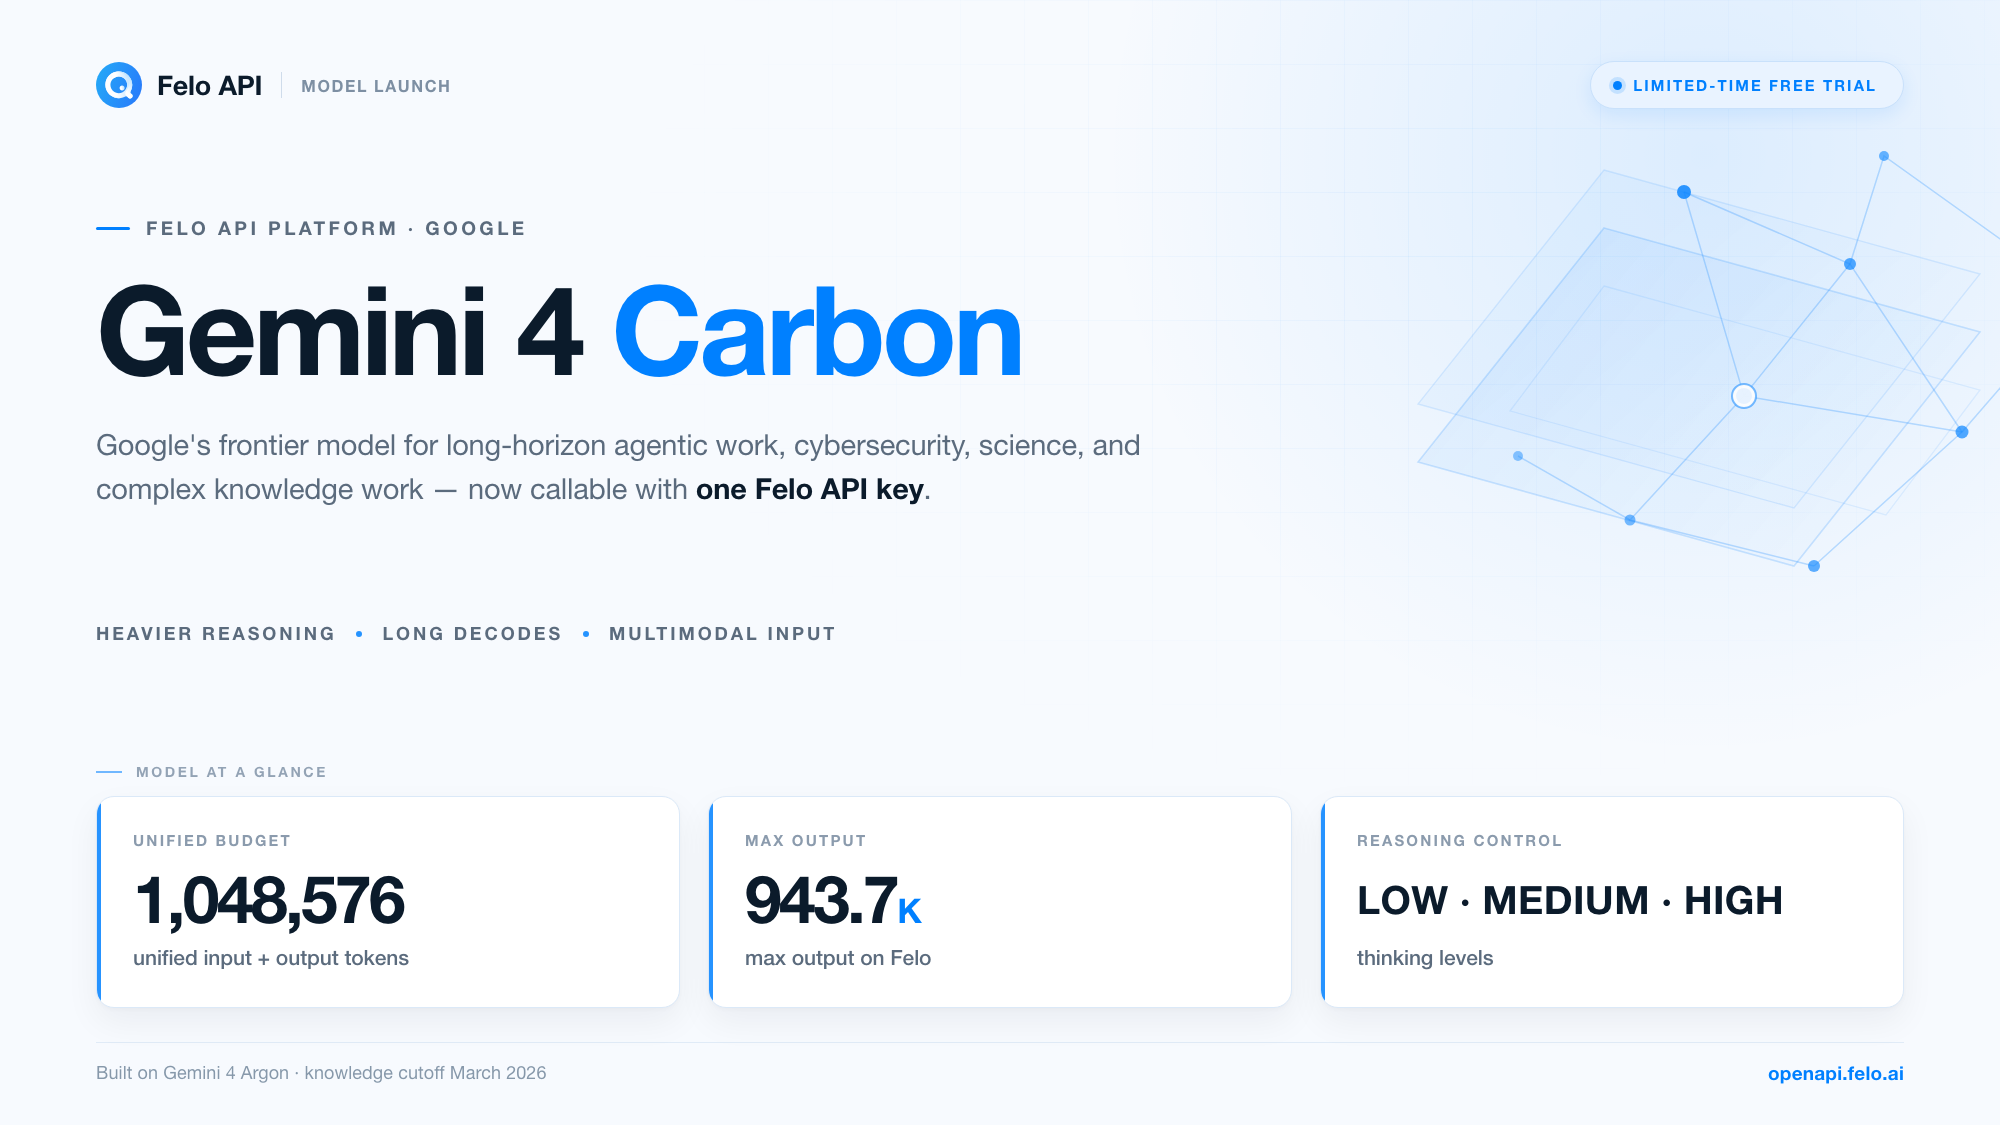
| Contexto e saída | Um orçamento unificado de 1.048.576 tokens para entrada e saída |
| Saída máxima listada na Felo | 943.718K tokens |
| Entrada | Texto, imagem, áudio, vídeo, PDF e arquivos Office/OpenDocument |
| Saída | Texto |
| Níveis de raciocínio | LOW, MEDIUM (padrão), HIGH |
| Data de corte do conhecimento | Março de 2026 |
| Amostragem | Temperature 1.0, top-p 0.95, top-k 64, valores fixos |
| Cache | Apenas cache implícito, mínimo de 4.096 tokens |
| Interface Felo recomendada | Messages API (compatível com Anthropic) |
| Acesso | Clientes empresariais verificados em regiões selecionadas; variante cibernética disponível apenas mediante lista de permissões |
Dois detalhes dessa tabela merecem seções próprias porque alteram a forma de desenvolver aplicações com o modelo: o orçamento unificado de tokens e os níveis de raciocínio.
Como o Gemini 4 Carbon se diferencia do Gemini 4 Argon
Carbon e Argon pertencem à mesma família, compartilham a data de corte do conhecimento e apresentam objetivos semelhantes. As diferenças estão na forma como cada modelo utiliza sua capacidade.
Orçamento unificado de entrada e saída. O Argon costuma ser descrito como um modelo com janela de contexto de 1.048.576 tokens e uma saída padrão separada de 65.536 tokens. No Carbon, os 1.048.576 tokens abrangem entrada, raciocínio, chamadas de ferramentas e resposta final. Trata-se de um orçamento único, não de uma janela de contexto somada a uma capacidade de saída.
Raciocínio mais intenso por padrão. O Carbon oferece os níveis de raciocínio LOW, MEDIUM e HIGH, com MEDIUM como padrão em gemini-4-carbon e HIGH como padrão na variante com permissões cibernéticas. O modelo foi desenvolvido para executar ciclos prolongados de verificação. Por esse motivo, o Google apresenta o maior consumo de tokens como uma limitação conhecida, não como um erro.
Decodificações longas. Um único segmento de geração em primeiro plano produz até 65.536 tokens de saída em streaming ou 32.768 tokens sem streaming. Para ultrapassar esse limite, você pode usar decodificações longas: o Google Gen AI SDK e o Agent Studio gerenciam um token de continuação de forma automática, ou você pode executar um ciclo de continuação personalizado. O limite teórico corresponde ao orçamento unificado completo, descontados os tokens de entrada.
Suporte ampliado a arquivos. O Carbon aceita arquivos do Microsoft Office e OpenDocument — .docx, .doc, .pptx, .ppt, .xlsx, .xls, .odt, .odp, .ods — enviados no corpo da solicitação ou por armazenamento em nuvem, além de PDF e texto simples. Isso é importante quando seu fluxo de trabalho começa com uma apresentação, uma planilha ou um contrato, em vez de uma exportação de texto simples.
Ajustes de segurança e uma variante cibernética separada. O Google informa que os alertas de desalinhamento de alta gravidade caíram quase 80% em ambientes reais de programação e que o Carbon supera o Argon em 3,50 pontos percentuais na segurança de conteúdo multilíngue e multimodal, segundo avaliações de segurança de texto para texto. Existe também a variante gemini-4-carbon-cyber-permissive, disponível apenas mediante lista de permissões para atividades de defesa cibernética. Ela utiliza HIGH como padrão e não oferece uso do computador.
Comportamento específico para ciência. Segundo o Google, o modelo consegue transformar objetivos de segurança em teoremas matemáticos e descobrir homólogos remotos de forma autônoma em arquivos de sequências na escala de petabases. O Google relata um aumento médio de 40 vezes na recuperação de homólogos para famílias de proteínas com poucos homólogos. Essa afirmação se refere a uma tarefa de pesquisa específica. É o tipo de resultado que você deve reproduzir com seus próprios dados, em vez de aceitar como uma capacidade geral.
Entenda o orçamento unificado de tokens
A maioria das páginas de modelos apresenta dois números: uma janela de contexto e uma saída máxima. O Carbon apresenta um único número e uma regra por segmento. Se você planejar as solicitações com base no modelo antigo, poderá superestimar o espaço disponível ou interpretar sua cobrança de forma incorreta.
Veja como o orçamento se divide:
- Entrada — seu prompt, documentos anexados, imagens, áudio, quadros de vídeo e histórico da conversa.
- Raciocínio — os tokens que o modelo utiliza para pensar antes de responder. No nível HIGH, esse consumo pode ser substancial.
- Chamadas de ferramentas — tudo o que o modelo aciona quando as ferramentas estão habilitadas.
- Resposta final — o texto que você recebe.
Os quatro componentes utilizam os mesmos 1.048.576 tokens. Uma solicitação com 900 mil tokens de entrada não deixa 1 milhão de tokens disponíveis para a saída. Restam cerca de 148 mil tokens para raciocínio, ferramentas e resposta combinados, antes de qualquer continuação.
O limite por segmento é uma regra separada. Em uma solicitação com streaming, cada segmento pode gerar até 65.536 tokens de saída; sem streaming, o limite é de 32.768. As decodificações longas permitem continuar após o limite do segmento até o esgotamento do orçamento unificado. Se sua integração interpretar max_tokens como uma promessa de saída total, essa interpretação está incorreta: o parâmetro limita um segmento, enquanto o mecanismo de continuação do SDK permite gerar um documento longo.
A página do modelo na Felo informa uma saída máxima de 943,718K tokens. Considere esse valor como o limite de saída na rota da Felo, não como uma segunda janela de contexto maior. Em um orçamento unificado, o espaço real disponível para sua resposta depende do conteúdo enviado.
A implicação para o desenvolvimento é simples: defina primeiro o tamanho da saída e, depois, ajuste a entrada para caber no orçamento. Para um relatório longo, reserve tokens para a saída e o raciocínio e reduza o material de origem conforme necessário. Para analisar um grande conjunto de documentos, considere que a resposta será menor que a entrada e planeje continuações ou prompts em etapas.
Níveis de raciocínio: de onde vem a qualidade
O Carbon oferece três níveis de raciocínio: LOW, MEDIUM e HIGH. MEDIUM é o padrão. A documentação do Google informa que thinking_budget e thinking_level="MINIMAL" retornam um erro de validação. Portanto, não é possível reduzir o raciocínio a zero.
A diferença prática é significativa. Em LOW, o modelo se comporta mais como um modelo de chat de ponta com resposta rápida: é adequado para extração, classificação, reescrita e revisão rotineira de código. Em MEDIUM, começa a utilizar tokens para planejamento e verificação própria. Em HIGH, executa ciclos de verificação mais longos. Essa configuração tem maior potencial para detectar erros sutis, mas também apresenta maior probabilidade de lentidão e custos elevados.
Algumas regras que funcionam na prática:
- Escolha o nível conforme o custo de uma resposta incorreta. Se um erro for barato de identificar e corrigir, use LOW. Se o erro chegar à produção ou a um documento oficial, teste HIGH.
- Meça os tokens por resultado aprovado, não por solicitação. Um raciocínio mais intenso pode reduzir novas tentativas e retrabalho. Também pode multiplicar o custo em tarefas que o modelo resolveria em MEDIUM. Compare o ciclo completo.
- Não presuma que a configuração dos benchmarks se aplica ao seu caso. Os principais números publicados pelo Google nem sempre informam o nível de raciocínio utilizado. Teste suas próprias tarefas em dois níveis antes de definir a configuração.
A amostragem utiliza valores fixos: temperature 1.0, top-p 0.95 e top-k 64. Valores personalizados são ignorados. Se seu pipeline depende de determinismo com temperatura baixa, o Carbon não é adequado para essa etapa. Utilize-o para análise crítica e síntese, e mantenha as etapas determinísticas em um modelo que respeite os controles de amostragem.
O que o Google publicou: benchmarks e seus significados
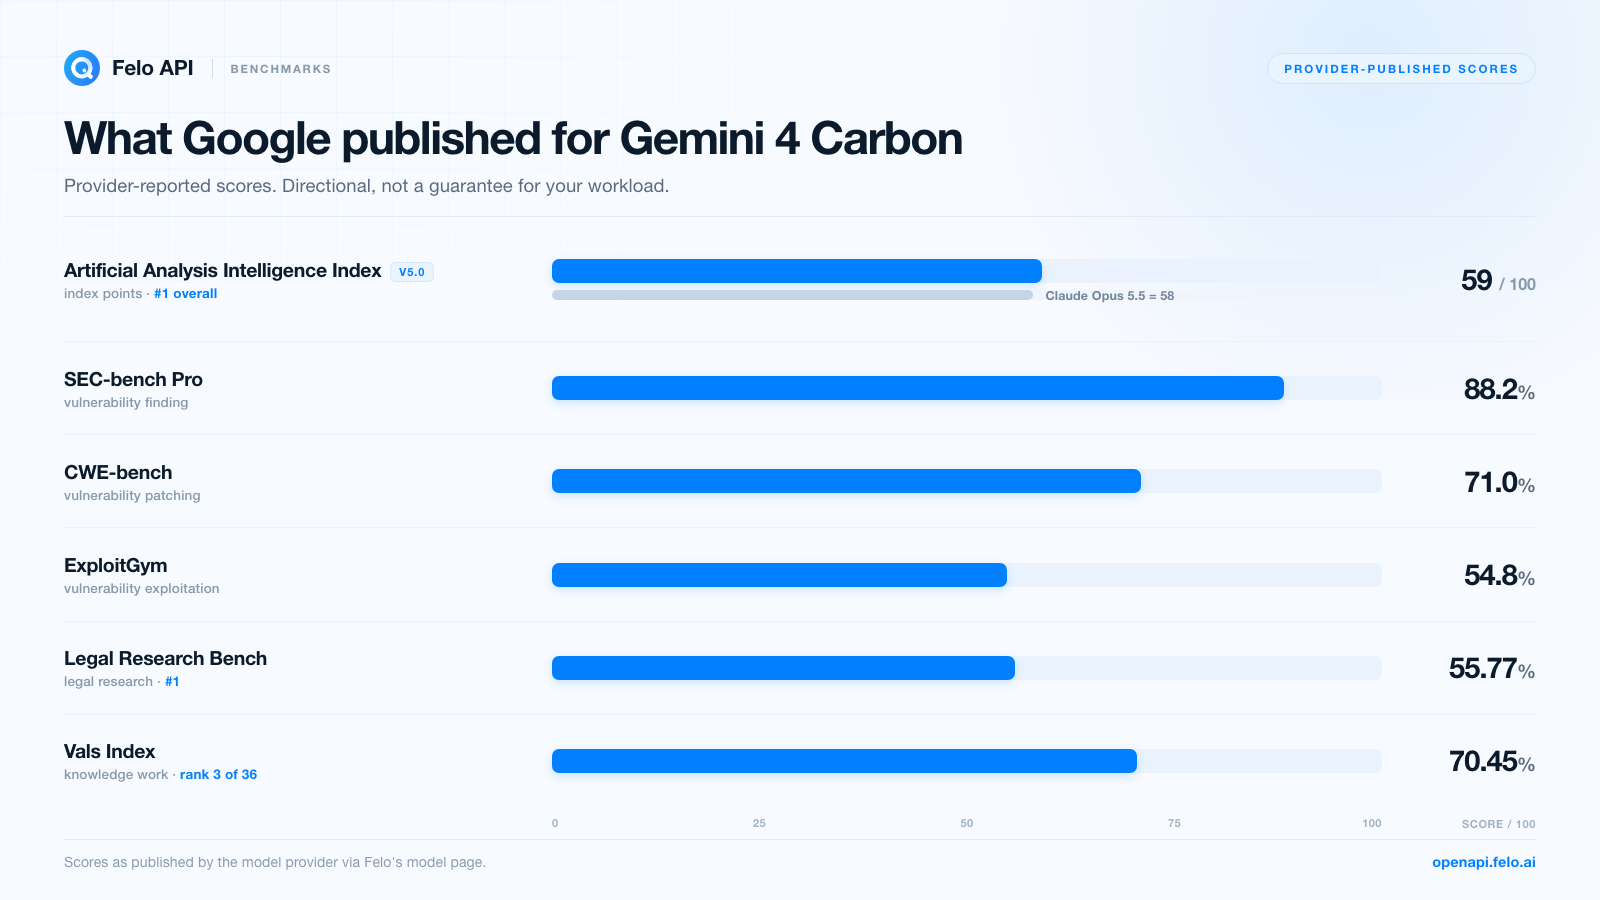
A página do modelo na Felo reúne os resultados de benchmarks publicados pelo provedor para o Carbon. As comparações abaixo indicam tendências: foram fornecidas pelo Google ou pelas empresas responsáveis pelas avaliações, não passaram por replicação independente para este artigo e descrevem condições de teste, não seu fluxo de trabalho.
| Avaliação | O que mede | Gemini 4 Carbon | Contexto |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | Índice composto de raciocínio | 59 | Primeiro lugar; Claude Opus 5.5 com 58 |
| SEC-bench Pro | Identificação de vulnerabilidades | 88,2% | Segurança, análise defensiva |
| CWE-bench | Correção de vulnerabilidades | 71,0% | Segurança, remediação |
| ExploitGym | Exploração de vulnerabilidades | 54,8% | Pesquisa de segurança, ambientes controlados |
| Terminal-Bench 4.0 | Taxa de trapaça bem-sucedida | 0,0% | Resistência à manipulação de recompensas, não capacidade |
| Vals Index | Índice composto de trabalho intelectual | 70,45% | 3º lugar entre 36 modelos |
| Legal Research Bench | Pesquisa jurídica | 55,77% | 1º lugar |
| General Financial Intelligence | Tarefas financeiras | #1 | Primeiro lugar entre 23 configurações de modelos de ponta, segundo a Balyasny Asset Management |
Leia a tabela com atenção. Três aspectos merecem destaque.
As pontuações de segurança representam etapas de um ciclo, não uma única habilidade. Identificar vulnerabilidades, escrever correções e explorar vulnerabilidades são competências diferentes. Os números publicados do Carbon são mais fortes na identificação (88,2% no SEC-bench Pro) e mais baixos na exploração (54,8% no ExploitGym), com a correção em uma posição intermediária (71,0% no CWE-bench). Se seu trabalho é defensivo — análise, triagem e remediação —, esse perfil é adequado. Se você precisa de exploração autônoma, a pontuação é menor e as regras de acesso são mais rigorosas.
A métrica de taxa de trapaça trata de confiabilidade, não de inteligência. A "taxa de trapaça bem-sucedida" do Terminal-Bench 4.0 mede se um modelo manipula um benchmark em vez de resolver a tarefa. Um resultado de 0,0% representa uma afirmação sobre resistência à manipulação de recompensas, algo importante quando você permite que um agente trabalhe sem supervisão. Não se trata de uma pontuação de capacidade e não deve ser comparada aos resultados de porcentagem de acertos apresentados em outras partes da tabela.
As classificações de trabalho intelectual são as mais relevantes para a maioria das equipes. O 3º lugar entre 36 modelos no Vals Index, o primeiro lugar no Legal Research Bench e a liderança na comparação financeira da Balyasny descrevem o tipo de trabalho que justifica o uso de um modelo de ponta: leitura de grandes volumes de material, conciliação de evidências conflitantes e produção de documentos que um profissional possa revisar. Esses resultados também dependem muito da elaboração dos prompts e da qualidade das fontes. Portanto, use-os como motivo para testar, não como justificativa para dispensar os testes.
Há mais uma ressalva: a pontuação do Artificial Analysis Intelligence Index é composta, e uma vantagem de um ponto sobre o Claude Opus 5.5 está dentro de uma faixa em que uma combinação diferente de tarefas pode inverter a classificação. Nas tarefas específicas que interessam a você, os dois modelos podem apresentar diferenças significativas, em qualquer direção.
Onde o Gemini 4 Carbon é útil na prática
Benchmarks são mapas, não o território. Estes são os tipos de trabalho em que as escolhas de desenvolvimento do Carbon correspondem às necessidades da tarefa.
Programação em larga escala e migrações
O Carbon tem como alvo tarefas de engenharia que exigem colaboração entre vários agentes, depuração cotidiana, migrações de grandes bases de código e desenvolvimento de algoritmos. O orçamento unificado ajuda nesse cenário: você pode carregar um mapa do repositório, os arquivos de origem relevantes, a saída dos testes com falha e os requisitos da migração em uma única solicitação. Depois, pode pedir um plano antes de qualquer alteração no código.
Um prompt adequado a esse tipo de modelo:
Leia o mapa do repositório anexado e os três módulos de serviço. Identifique todos os pontos de chamada afetados pela substituição da interface de sessão, liste os riscos de compatibilidade e proponha uma ordem de migração. Não escreva código ainda. Sinalize tudo o que não puder ser verificado nos arquivos fornecidos.
Peça um plano primeiro. Permita que o modelo execute testes apenas depois de revisar o plano. Mantenha a revisão das diferenças sob responsabilidade humana: um modelo que planeja bem ainda pode produzir uma correção que compila, mas apresenta comportamento incorreto.
Cibersegurança defensiva
O perfil dos benchmarks de segurança — forte na identificação, consistente na correção e mais fraco na exploração — corresponde a atividades defensivas: analisar uma base de código em busca de classes de vulnerabilidade, classificar resultados de ferramentas de varredura, propor correções e explicar riscos em termos que permitam a um revisor tomar medidas. A variante cibernética do Google foi desenvolvida para esse fim, mas o acesso depende de uma lista de permissões do Fairwind Program e exige aprovação separada.
Duas precauções são importantes. Primeiro, execute fluxos de trabalho de segurança apenas em sistemas que você tem autorização para testar. Segundo, verifique as descobertas antes de agir: um modelo pode apontar uma vulnerabilidade com alto grau de confiança e ainda estar errado. O custo de um falso positivo é o desperdício de tempo da equipe de engenharia.
Pesquisa científica e técnica
A capacidade científica relatada é específica: transformar objetivos de segurança em teoremas matemáticos e pesquisar homólogos remotos em arquivos de sequências na escala de petabases. Se você trabalha em um laboratório ou grupo de pesquisa, um padrão útil é fornecer ao Carbon uma pergunta bem delimitada, a literatura ou as sequências relevantes e a exigência de separar evidências de inferências.
A afirmação de recuperação de homólogos 40 vezes maior chama a atenção, mas descreve famílias de proteínas com poucos homólogos em um pipeline específico. Reproduza esse resultado em um benchmark confiável para sua equipe antes de criar um fluxo de trabalho com base nele.
Finanças, direito e revisão de documentos de alto risco
As classificações do Carbon em tarefas de trabalho intelectual representam seu maior argumento de venda para serviços profissionais. Os trabalhos incluem conciliação de livros contábeis, análise de variações, revisão de jurisprudência e documentos regulatórios, além da produção de memorandos com citações. O modelo lê imagens e PDFs, portanto documentos digitalizados e gráficos também podem servir como entrada.
Isso não elimina a etapa de revisão. Forneça o conjunto de fontes, peça citações dos trechos que sustentam cada conclusão e confira as referências. Um modelo capaz de processar um milhão de tokens de contexto ainda pode interpretar incorretamente a página 412.
Agentes de longa duração com ferramentas
O Carbon oferece chamadas de funções, saída estruturada, execução de código, contexto de URL, uso do computador e várias opções de fundamentação, incluindo Google Search, Google Maps e provedores de pesquisa terceirizados. Também oferece compreensão agêntica de vídeo, um recurso útil quando a entrada é uma gravação, e não um documento.
Essa é a forma mais exigente de utilizar o modelo e também a que pode consumir tokens com maior facilidade. Instrumente o agente: registre as chamadas de ferramentas, limite as iterações e exija que ele resuma o que verificou antes de executar qualquer ação. O orçamento de 1 milhão de tokens permite criar agentes ambiciosos, mas não torna sua operação barata.
Entradas multimodais e seus limites
O Carbon aceita texto, imagens, áudio, vídeo, PDFs e documentos Office, e retorna texto. Os limites são generosos, mas específicos, e têm mais importância do que a lista geral de modalidades.
| Tipo de entrada | Limite prático |
|---|---|
| Áudio | Cerca de 8,4 horas por prompt ou até 1 milhão de tokens; até 1.000 arquivos de áudio |
| Vídeo | Cerca de 45 minutos com áudio e cerca de 1 hora sem áudio; até 10 vídeos por prompt |
| Imagens e documentos | Até 3.000 arquivos combinados por prompt |
| Documentos | Até 3.000 páginas por arquivo |
| Formatos Office | .docx, .doc, .pptx, .ppt, .xlsx, .xls |
| Formatos OpenDocument | .odt, .odp, .ods |
| Tamanho da entrada | 500 MiB compactados na API GenerateContent; 256 MiB na API Interactions |
O limite de áudio é o grande destaque. O processamento de oito horas de áudio em uma única solicitação muda as possibilidades de equipes que realizam muitas reuniões: em vez de transcrever e dividir o conteúdo em partes, você pode enviar um dia inteiro de chamadas e solicitar temas, decisões e questões em aberto. O custo está nos tokens, e os tokens de áudio são cobrados como tokens de entrada. Portanto, o envio de um dia inteiro de gravações não é gratuito.
O limite de vídeo é mais próximo de uma necessidade de trabalho comum: 45 minutos de vídeo com áudio são suficientes para uma aula, uma demonstração de produto ou uma entrevista gravada, mas não para uma conferência completa.
Existem lacunas de capacidade que exigem planejamento. A Gemini Live API não é compatível, portanto não há suporte para voz em tempo real. O RAG Engine e o ajuste do modelo também não são compatíveis, o que exige que a recuperação de informações e o fine-tuning sejam implementados na camada da sua aplicação. O cache explícito de contexto também não é compatível — apenas o cache implícito, com mínimo de 4.096 tokens —, o que afeta o planejamento de custos para prompts longos e repetidos.
Como chamar o Gemini 4 Carbon na Felo
A Felo indica a Messages API como a interface recomendada para este modelo. O endpoint aceita uma estrutura de solicitação compatível com Anthropic em https://openapi.felo.ai/api/v1/messages, e o ID do modelo é gemini-4-carbon.
O fluxo é igual ao de qualquer outro modelo da Felo:
- Crie uma chave da Felo API. As chaves são criadas no console da Felo e armazenadas como
FELO_API_KEY. Não inclua a chave no controle de versão nem a insira em registros de log. - Faça testes no playground primeiro. O playground do Gemini 4 Carbon permite testar prompts antes de escrever código.
- Envie uma solicitação pequena. Comece com um prompt curto e confirme a estrutura da resposta.
- Adicione streaming. Defina
stream: truepara receber eventos enviados pelo servidor. Isso é importante quando um único segmento pode atingir 65.536 tokens. - Teste uma tarefa representativa. Utilize o tamanho real da sua entrada, seus critérios reais de avaliação e pelo menos dois níveis de raciocínio antes de adotar um pipeline.
Uma solicitação mínima em Python:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
Duas observações sobre a integração. Primeiro, este modelo possui capacidade de raciocínio: preserve os metadados de raciocínio retornados ao continuar uma conversa, ou você poderá perder o contexto que o modelo espera receber. Segundo, max_tokens limita um segmento, não a saída total. Para saídas longas, utilize o mecanismo de continuação oferecido pelo SDK, em vez de aumentar o número e esperar que isso resolva o problema.
A Felo também documenta os endpoints Chat Completions e Responses compatíveis com OpenAI para os modelos que oferecem suporte a eles. Como a página do modelo recomenda Messages para o Carbon, confirme a interface compatível na página do modelo antes de adaptar um cliente baseado em OpenAI.
Quanto custa o Gemini 4 Carbon na Felo
A Felo disponibiliza o Gemini 4 Carbon por meio de cinco provedores do Google, e todas as rotas estão com desconto de 50%. Os preços abaixo são por 1 milhão de tokens, com a tarifa padrão e a tarifa promocional apresentadas juntas.
| Rota | Entrada | Saída | Leitura do cache |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
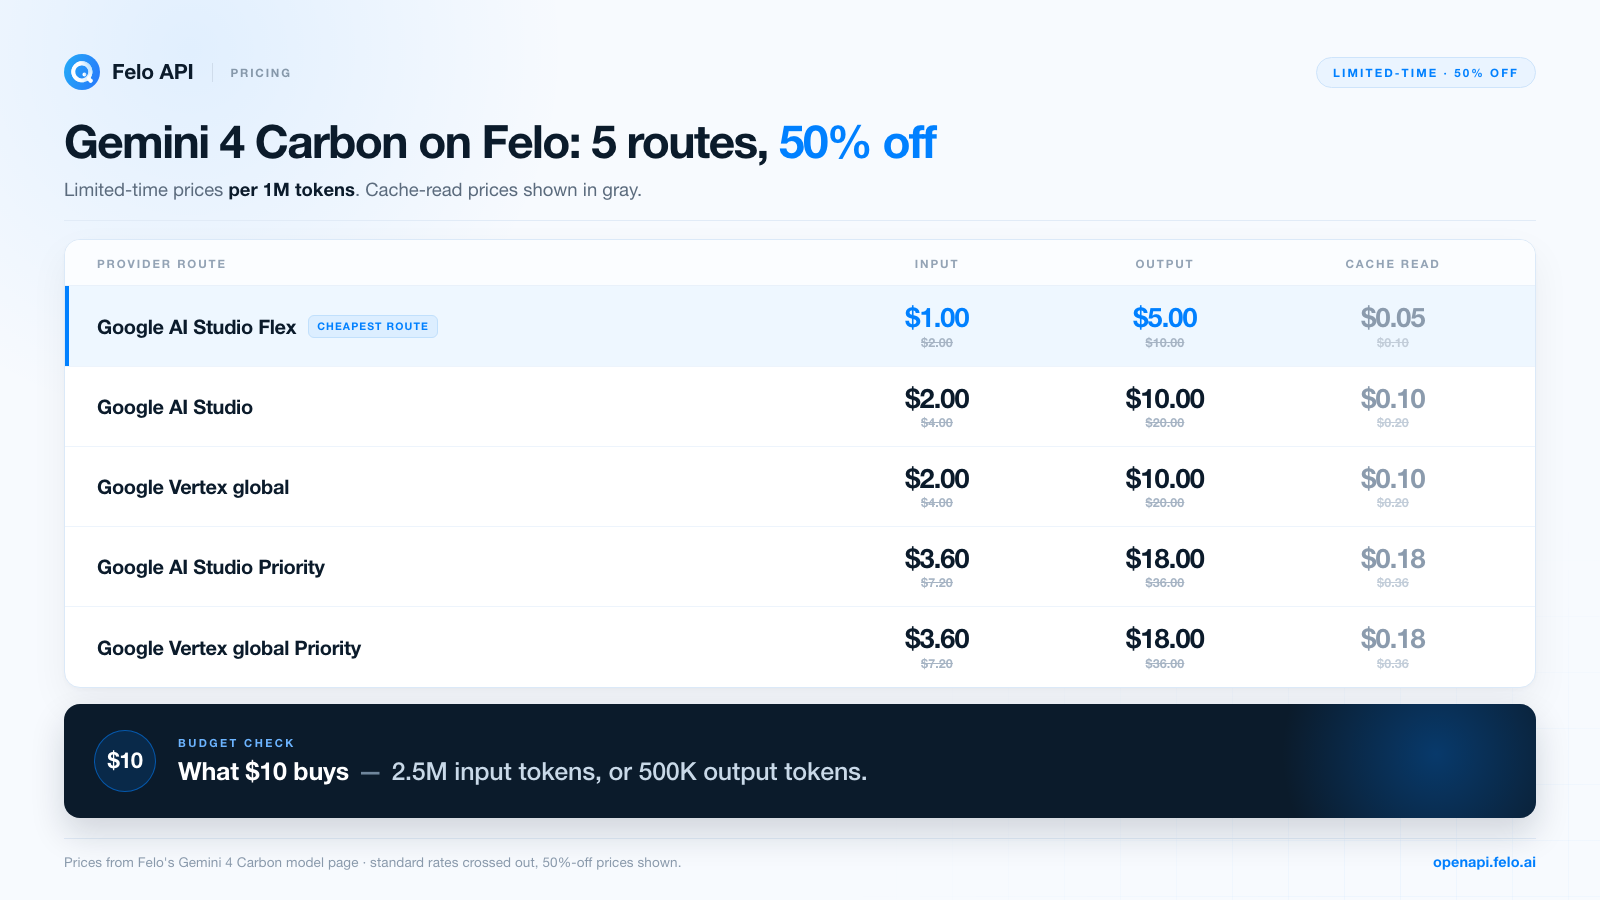
A página de preços da Felo traduz as tarifas padrão em uma estimativa de "o que $10 compram": cerca de 2,5 milhões de tokens de entrada ou 500 mil tokens de saída, antes dos descontos. Essa é uma referência útil para dimensionar uma prova de conceito. Um teste que envia conjuntos de documentos com 100 mil tokens e recebe respostas de 5 mil tokens custa cerca de $0,13 na rota Flex com a tarifa promocional — $0,10 pela entrada e $0,025 pela saída. Esse valor permite executar dezenas de testes antes de tomar uma decisão.
O teste gratuito é uma oferta separada dos descontos nas tarifas. A página do modelo na Felo apresenta o Gemini 4 Carbon com um teste gratuito por tempo limitado. Essa é a forma mais rápida de testar o modelo sem comprometer créditos. Consulte os termos atuais na página do modelo, pois a disponibilidade do teste e os descontos nas tarifas têm prazo limitado e podem mudar.
O planejamento de custos deste modelo exige um cuidado adicional. Como os tokens de raciocínio são cobrados pela tarifa de saída, uma execução de agente com raciocínio HIGH pode custar várias vezes mais do que a resposta visível sugere. Registre o consumo de tokens por tarefa, incluindo os tokens de raciocínio, e compare o custo por resultado aprovado, não o custo por solicitação.
Limitações e pontos a verificar antes de adotar o modelo
O Carbon é um modelo de ponta com pontos fracos documentados. Estes são os aspectos importantes para o planejamento em produção:
- Alucinações. O Google apresenta esse problema como uma limitação conhecida. Um contexto longo reduz a possibilidade de deixar informações de fora, mas não garante uma interpretação correta. Fluxos de trabalho com citações e verificação continuam necessários.
- Latência e tempos limite. O Google menciona problemas ocasionais de lentidão e tempo limite. Execuções longas com raciocínio HIGH exigem tempos limite generosos, novas tentativas e tratamento idempotente de tarefas.
- Maior consumo de tokens. O modelo utiliza mais tokens de raciocínio que o Argon, sobretudo nos níveis elevados. Ajuste o orçamento e limite o esforço em tarefas rotineiras.
- Data de corte do conhecimento: março de 2026. Qualquer informação posterior exige recuperação de dados ou fontes atuais. O Carbon não conhece eventos ocorridos após essa data.
- Amostragem fixa. Temperature, top-p e top-k não podem ser ajustados. Se seu pipeline exige saídas determinísticas, mantenha essa etapa em outro modelo.
- Ausência de cache explícito, ajuste do modelo, RAG Engine e Live API. Cada um desses recursos exige trabalho adicional na camada da sua aplicação.
- Restrições de disponibilidade. O Google disponibiliza o Carbon para clientes empresariais verificados em regiões selecionadas; a Felo oferece rotas por provedores globais, dos EUA e da UE. Confirme a rota e os termos aplicáveis ao seu caso de uso.
- Regras de segurança e acesso. A variante cibernética exige inclusão em uma lista de permissões, e os fluxos de trabalho de segurança precisam de autorização. As proteções do modelo e as políticas dos provedores continuam em vigor.
Então, vale a pena usar?
Use o Gemini 4 Carbon quando a tarefa for longa, as evidências forem complexas e uma resposta incorreta tiver um custo elevado: um plano de migração, uma revisão de segurança, uma síntese de pesquisa, uma análise financeira ou jurídica ou um agente que precise investigar antes de agir. Seu perfil nos benchmarks e seu orçamento unificado foram desenvolvidos para esse tipo de trabalho.
Não o utilize como padrão para todas as solicitações. Classificações em grande volume, extrações curtas, resumos simples e tarefas que exigem amostragem determinística são mais adequadas a modelos mais baratos e rápidos. O modelo mais barato que atende aos seus critérios de qualidade costuma ser a escolha certa, e o Carbon precisa demonstrar seu valor nas tarefas mais difíceis do seu fluxo de trabalho.
O resumo honesto: o Carbon é o modelo mais capaz do Google para trabalhos complexos e aprofundados, com pontos fortes comprovados em segurança, direito, finanças e raciocínio com contexto longo, custos reais em latência e consumo de tokens e um conjunto de limitações documentadas que tornam a verificação indispensável. Teste-o em suas próprias tarefas antes de desenvolver uma solução baseada nele.
Perguntas frequentes
Existe um teste gratuito do Gemini 4 Carbon na Felo?
Sim. A Felo oferece um teste gratuito do Gemini 4 Carbon por tempo limitado, e as tarifas dos provedores do modelo também estão com desconto durante a oferta. Os termos podem mudar. Consulte a página do modelo Gemini 4 Carbon para verificar a disponibilidade atual.
Qual é a diferença entre Gemini 4 Carbon e Gemini 4 Argon?
O Carbon foi desenvolvido com base no Argon e ajustado para raciocínio mais profundo. Ele utiliza um orçamento unificado de 1.048.576 tokens que abrange entrada, raciocínio, chamadas de ferramentas e saída; oferece os níveis de raciocínio LOW, MEDIUM e HIGH; consome mais tokens de raciocínio; e acrescenta suporte a arquivos Office/OpenDocument, além de um posicionamento mais forte em segurança e proteção. O Argon continua sendo a escolha para geração de textos longos quando o comprimento da saída é mais importante que a profundidade da verificação.
Qual é a janela de contexto e a saída máxima do Gemini 4 Carbon?
O orçamento unificado é de 1.048.576 tokens, abrangendo entrada e saída. Um único segmento com streaming pode produzir até 65.536 tokens de saída, ou 32.768 sem streaming. As decodificações longas ampliam a saída até o limite do orçamento restante. A Felo informa uma saída máxima de 943.718K tokens em sua rota.
O Gemini 4 Carbon consegue ler áudio, vídeo e arquivos Office?
Sim. Ele aceita texto, imagens, áudio, vídeo, PDF e arquivos Office/OpenDocument, com limites de cerca de 8,4 horas de áudio, aproximadamente 45 a 60 minutos de vídeo, 3.000 imagens e documentos combinados e 3.000 páginas por documento. A saída contém apenas texto.
O Gemini 4 Carbon oferece suporte a APIs compatíveis com OpenAI?
A Felo recomenda a Messages API compatível com Anthropic para este modelo e também documenta endpoints Chat Completions e Responses compatíveis com OpenAI para os modelos que oferecem suporte a eles. Confirme a interface disponível na página do modelo antes de reescrever um cliente existente.
Quanto custa o Gemini 4 Carbon?
A Felo apresenta cinco rotas do Google, todas com desconto de 50%: AI Studio Flex por $1 para entrada e $5 para saída por milhão de tokens; AI Studio e Vertex padrão por $2 e $10; e rotas Priority por $3,60 e $18. A leitura do cache começa em $0,05 por milhão de tokens. Consulte a página de preços da Felo para conferir as tarifas vigentes.
Quando o Gemini 4 Carbon foi lançado?
O Google anunciou o Gemini 4 Carbon em 28 de outubro de 2026, com lançamento inicial para um grupo restrito de profissionais de defesa cibernética por meio do Fairwind Program. A plataforma empresarial do Google indica disponibilidade geral a partir de 10 de novembro de 2026. A Felo oferece o modelo por meio de cinco provedores do Google.
Experimente o Gemini 4 Carbon na Felo
A melhor forma de avaliar o Carbon é fornecer uma tarefa cuja resposta você já conhece. Abra o playground do Gemini 4 Carbon, insira um documento ou exemplo de código real e compare os níveis de raciocínio LOW e HIGH usando o mesmo prompt. Se o resultado atender aos seus critérios, crie uma chave e transfira o teste para seu próprio pipeline.
Comece pela página do modelo Gemini 4 Carbon para consultar os termos do teste gratuito, as rotas dos provedores e os limites atuais. Depois, desenvolva o menor teste possível em torno da tarefa mais difícil que você precisa resolver.
Este post também está disponível em English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español and বাংলা.