API GPT-6.1 Sol: Desempenho próximo ao Astra com menor custo
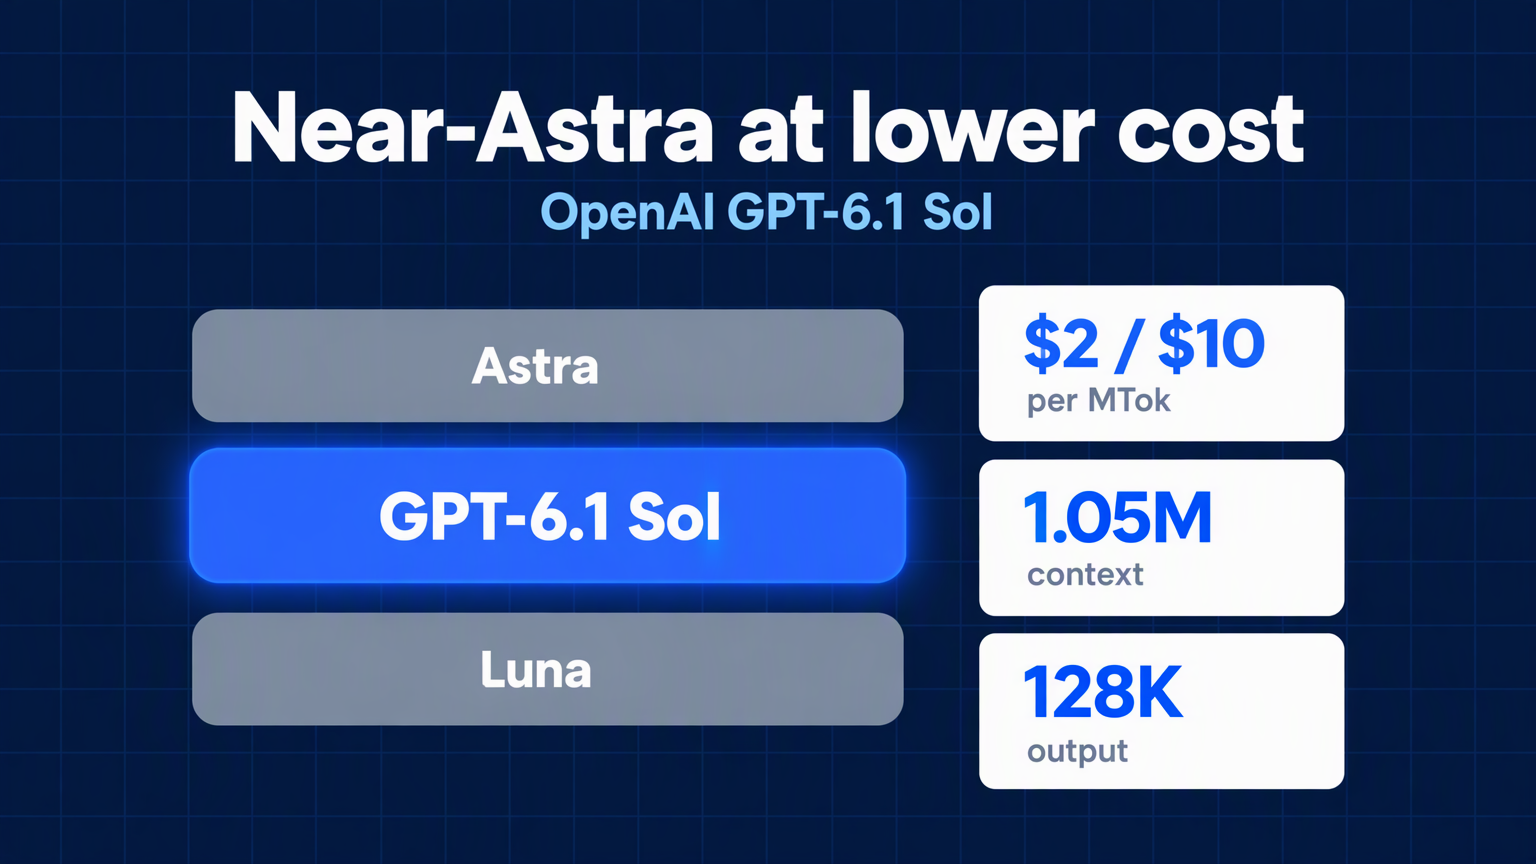
OpenAI GPT-6.1 Sol oferece desempenho quase igual ao Astra para programação, uso de computador e trabalho profissional por $2/$10 por milhão de tokens com uma janela de contexto de 1,05M.
O novo modelo Sol da OpenAI não busca ser o mais inteligente. Ele busca ser aquele que você pode usar o dia todo sem comprometer o orçamento.
GPT-6.1 Sol ocupa o espaço entre o GPT-6 Astra, modelo principal, e o GPT-6 Luna, modelo leve. A página do modelo da OpenAI resume em uma linha: "Desempenho próximo ao Astra para trabalhos complexos com menor custo." Para equipes que desenvolvem agentes de programação, automação de uso de computador e fluxos de trabalho com muitos documentos, esse equilíbrio define o propósito do modelo.
Este guia apresenta o que o GPT-6.1 Sol entrega, o custo, as diferenças em relação ao GPT-6 Sol e Astra, e como utilizá-lo pela Felo API Platform.
O que é o GPT-6.1 Sol
GPT-6.1 Sol é um modelo de raciocínio voltado para programação complexa, uso de computador e trabalho profissional. A OpenAI posiciona como opção equilibrada na família GPT-6: mais capaz que Luna, mais barato que Astra, e suficiente para que muitos fluxos de produção não precisem do modelo principal.
A página do modelo orienta o uso: compare Sol com Astra nas suas tarefas, depois decida se a diferença de qualidade justifica a diferença de preço. Essa orientação prática reflete o propósito do modelo. Sol serve como ferramenta de controle de custos, não como troféu de benchmarks.
A página da Felo resume a mesma posição do lado da plataforma. GPT-6.1 Sol é "um upgrade do GPT-6 Sol, ainda abaixo do GPT-6 Astra." Ele executa programação agente, uso de computador, trabalho profissional com muitos documentos e automação de fluxos de trabalho em múltiplos passos, alcançando resultados próximos ao Astra nessas tarefas com custo bem menor. Em relação ao GPT-6 Sol, a Felo destaca menos erros factuais e maior aderência a restrições explícitas.
GPT-6.1 Sol é o modelo para tarefas difíceis, longas e repetitivas — quando o custo precisa permanecer previsível.
Especificações do GPT-6.1 Sol
A OpenAI publica a especificação completa na página do modelo. Veja o resumo.
| Especificação | GPT-6.1 Sol |
|---|---|
| ID do modelo | gpt-6.1-sol |
| Snapshot padrão | gpt-6.1-sol |
| Janela de contexto | 1.050.000 tokens |
| Máximo de tokens de entrada | 922.000 |
| Máximo de tokens de saída | 128.000 |
| Corte de conhecimento | 30 de abril de 2026 |
| Modalidades de entrada | Texto, imagem |
| Modalidades de saída | Texto |
| Modalidades não suportadas | Áudio, vídeo |
| Suporte a tokens de raciocínio | Sim |
| Esforço de raciocínio | low, medium (padrão), high, xhigh, max |
| Esforço de raciocínio não suportado | none, minimal |
| Residência de dados | EUA e UE |
Dois detalhes importam mais que os números principais.
Primeiro, o esforço de raciocínio não pode ser desativado. GPT-6.1 Sol não suporta none ou minimal. Se você migra de um modelo que permitia esses ajustes, a OpenAI recomenda começar com low e comparar resultados em tarefas representativas.
Segundo, chamadas de ferramentas exigem o Responses API. GPT-6.1 Sol aceita Chat Completions para requisições sem ferramentas, mas qualquer fluxo que envolva funções, busca de arquivos, navegação web ou controle de computador precisa migrar para Responses. Essa restrição não é exclusiva do Sol — a OpenAI direciona toda a plataforma nesse sentido.
Preço do GPT-6.1 Sol: o que $2/$10 oferece
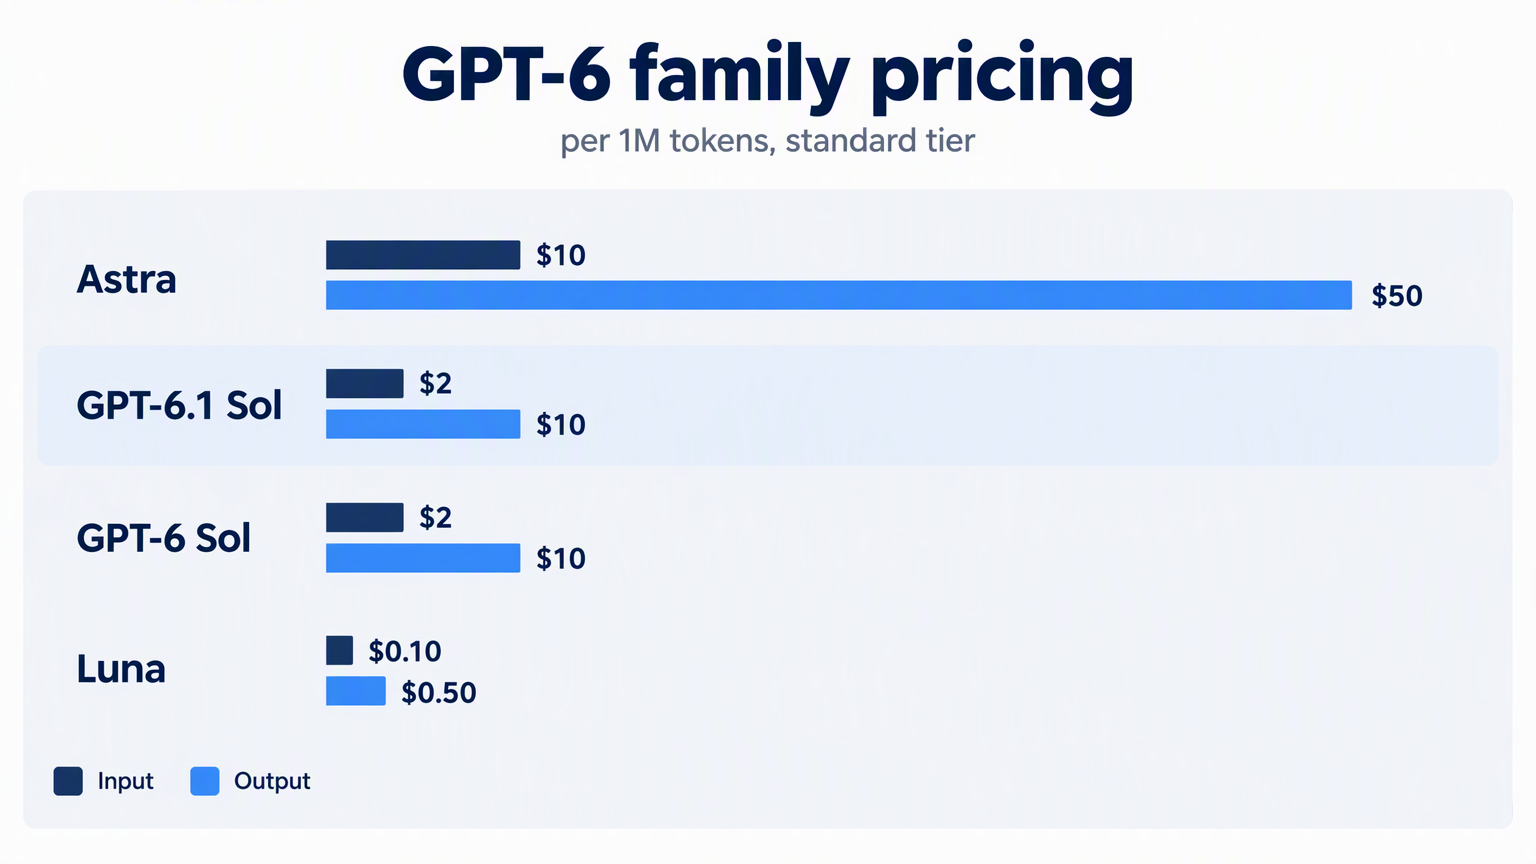
O preço padrão do GPT-6.1 Sol na OpenAI é $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída. A tabela completa inclui preços de cache, que alteram o cálculo para agentes de longa duração.
| Métrica | Preço por 1M tokens |
|---|---|
| Entrada | $2.00 |
| Entrada em cache | $0.10 |
| Escrita em cache | $2.50 |
| Saída | $10.00 |
Algumas regras complementam a tabela:
- Entrada em cache custa 5% do valor sem cache. A OpenAI precifica leituras de cache do GPT-6.1 Sol em 0,05x, comparado a 0,1x para modelos GPT-5.6 e posteriores. O desconto beneficia agentes que reutilizam prompts ou contexto de repositório em cada rodada.
- Escrita em cache custa 1,25x o valor da entrada sem cache. Você paga $2.50 por milhão de tokens para gravar um prefixo no cache, depois $0.10 por milhão para ler.
- Contexto longo custa mais. Prompts acima de 272K tokens de entrada são cobrados em 2x para entrada e cache, e 1,5x para saída em toda a requisição. Nessa faixa, entrada custa $4, entrada em cache $0.20, escrita em cache $5, e saída $15 por milhão de tokens.
- Batch e Flex são 50% mais baratos. Se o fluxo tolera processamento assíncrono, o valor cai para $1 de entrada e $5 de saída por milhão de tokens.
- Fast mode custa 2x o Standard. Você paga por menor latência, não por mais inteligência.
- Processamento regional adiciona 10% de acréscimo onde disponível.
O desconto de leitura em cache define o diferencial. Um agente de programação que reutiliza 100.000 tokens de contexto do repositório em vinte rodadas paga $0.10 por milhão de tokens em cache, em vez de $2.00 por milhão de tokens de entrada. Em sessões longas, essa diferença cresce rapidamente.
Para comparar, GPT-6 Astra custa $10 de entrada e $50 de saída por milhão de tokens. GPT-6.1 Sol custa um quinto do valor em ambos os lados. GPT-6 Luna é ainda mais barato, $0.10 de entrada e $0.50 de saída, mas perde a capacidade próxima ao Astra que torna Sol interessante.
Novidades do GPT-6 que Sol utiliza
GPT-6.1 Sol herda recursos da plataforma GPT-6 lançados com Astra. Vários deles impactam fluxos de trabalho com agentes.
Chamadas assíncronas de ferramentas
Normalmente, uma chamada de função pausa o modelo até sua aplicação retornar o resultado. Com chamadas assíncronas, você define async: true na ferramenta e o modelo continua — raciocina, chama outras ferramentas ou responde partes independentes — enquanto sua aplicação executa o trabalho em segundo plano.
Sua aplicação ainda executa a ferramenta e gerencia o trabalho pendente. Quando o trabalho termina, você retorna o resultado em uma requisição Responses posterior usando o call_id original. A documentação da OpenAI descreve como iniciar buscas lentas cedo e preencher a resposta quando o dado chega.
Para Sol, esse recurso se encaixa. Um agente de programação pode iniciar uma suíte de testes longa, revisar outros arquivos e incorporar os resultados quando disponíveis.
Direcionamento durante a execução
Direcionamento durante a execução permite ao usuário enviar uma correção ou nova exigência enquanto o modelo trabalha. Pela conexão WebSocket com o Responses API, o servidor preserva o trabalho já feito e incorpora a atualização na continuação.
Importante: direcionamento não reescreve saída já enviada, não desfaz ações anteriores nem cancela ferramentas já iniciadas. Ele altera o próximo passo, não o passado. Se o direcionamento interrompe a resposta original, ela termina com incomplete_details.reason: "steered" e uma nova resposta traz a atualização.
Alterar raciocínio durante a conversa
Você pode aumentar ou reduzir o esforço de raciocínio durante a conversa adicionando um item configuration_update na entrada. O novo esforço permanece até outra atualização. A OpenAI recomenda manter o reasoning.effort no nível da requisição para que o prefixo do prompt continue cacheável.
Essa combinação — leitura de cache barata e raciocínio ajustável — torna Sol econômico para fluxos mistos. Use low para tarefas rotineiras, depois mude para xhigh quando o desafio aumentar, sem reescrever a conversa.
Multi-agente (beta)
Multi-agente está disponível como beta no GPT-6.1 Sol e todos os modelos GPT-5.6. Um agente raiz pode criar subagentes que trabalham em paralelo, cada um com contexto limitado, depois sintetizar os resultados em uma resposta final.
A documentação da OpenAI recomenda para tarefas divididas em fluxos independentes: explorar partes de um código grande, comparar propostas, pesquisar fontes em paralelo ou investigar várias causas de falha ao mesmo tempo. O padrão max_concurrent_subagents é 3.
O custo é o uso de tokens. Mais agentes consomem mais tokens, então multi-agente compensa quando velocidade paralela e contexto focado importam mais que economia de tokens.
Compactação e raciocínio persistente
Agentes de longa duração acabam preenchendo a janela de contexto. Compactação reduz o tamanho do contexto mantendo o estado necessário para rodadas futuras. Você pode ativar compactação no servidor definindo context_management com compact_threshold em uma requisição Responses; o servidor emite um item de compactação criptografado quando o número de tokens renderizados ultrapassa o limite.
GPT-6.1 Sol também aceita reasoning.context: "all_turns", permitindo que itens de raciocínio compatíveis de rodadas anteriores sejam usados na próxima amostra. O raciocínio persistente permanece opaco — a API nunca retorna o texto bruto do modelo — mas garante continuidade ao longo da sessão.
Modo WebSocket
Modo WebSocket mantém conexão persistente com o Responses API e envia apenas novos itens de entrada a cada rodada. A OpenAI reporta até 40% de execução mais rápida para fluxos com 20 ou mais chamadas de ferramentas. Para um modelo voltado a programação agente e uso de computador, isso reduz a latência.
GPT-6.1 Sol vs GPT-6 Sol vs Astra vs Luna
A família GPT-6 agora tem quatro níveis. Escolher depende da qualidade necessária e da frequência de execução do fluxo.
| Modelo | Posicionamento | Entrada / Saída por 1M | Melhor para |
|---|---|---|---|
| GPT-6 Astra | Inteligência máxima | $10 / $50 | Raciocínio exigente, programação e trabalho profissional |
| GPT-6.1 Sol | Próximo ao Astra com menor custo | $2 / $10 | Programação complexa, uso de computador, trabalho com muitos documentos |
| GPT-6 Sol | Nível Sol anterior | $2 / $10 | Fluxos Sol existentes antes do upgrade |
| GPT-6 Luna | Mais rápido e econômico | $0.10 / $0.50 | Tarefas focadas e de alto volume |
GPT-6.1 Sol e GPT-6 Sol têm o mesmo preço principal, mas não são o mesmo modelo. A página da Felo descreve GPT-6.1 Sol como upgrade, com menos erros factuais e maior aderência a restrições explícitas. A taxa de leitura em cache também caiu pela metade: $0.10 por milhão de tokens em vez de $0.20. Se você já usa GPT-6 Sol em produção, o upgrade melhora qualidade e economia de cache pelo mesmo preço.
O guia de seleção da OpenAI relaciona esforço de raciocínio ao tipo de tarefa:
- GPT-6.1 Sol em médio — trabalho técnico complexo e entregáveis coordenados sujeitos a revisão.
- GPT-6.1 Sol em extra alto — entregáveis refinados, sistemas visuais conectados e decisões baseadas em evidências conflitantes.
- Astra em baixo — escrita concisa e adaptação de conteúdo preservando fatos e nuances.
- Astra em médio — projetos ambiciosos que exigem contexto amplo, interações confiáveis e resultados completos.
- Astra em extra alto — análise exigente e entregáveis complexos com requisitos rigorosos.
- Luna em baixo — edições detalhadas, resolução de problemas bem delimitados e extração simples de dados.
- Luna em extra alto — encontrar contexto atual em vários apps, priorizar tarefas e resolver problemas com restrições claras.
A regra prática do Codex: use Sol para trabalho repetido e de longa duração em código, apps e documentos quando o custo importa. Reserve Astra para tarefas mais exigentes. Use Luna para tarefas claras e repetíveis.
Como usar GPT-6.1 Sol pela Felo API Platform
A Felo API Platform disponibiliza GPT-6.1 Sol em endpoints compatíveis, permitindo manter seu SDK e apenas trocar a URL base.
O modelo está disponível em:
- Chat Completions:
POST https://openapi.felo.ai/api/v1/chat/completions - Responses:
POST https://openapi.felo.ai/api/v1/responses - Messages (compatível com Anthropic):
POST https://openapi.felo.ai/api/v1/messages
Passo 1: Obtenha uma chave de API
Crie uma chave na sua conta Felo API Platform e exporte:
export FELO_API_KEY="YOUR_API_KEY"
Passo 2: Faça sua primeira requisição
curl https://openapi.felo.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "messages": [
      {"role": "user", "content": "Explain the tradeoff between reasoning effort and cost."}
    ]
  }'
Passo 3: Use um SDK compatível
Direcione qualquer SDK compatível com OpenAI para https://openapi.felo.ai/api/v1. Para clientes estilo Claude, use a URL base compatível com Anthropic https://openapi.felo.ai/api.
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FELO_API_KEY,
  baseURL: "https://openapi.felo.ai/api/v1",
});

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  input: "Review this pull request for correctness, security, and missing tests.",
});

console.log(response.output_text);
Passo 4: Ative streaming quando necessário
Adicione stream: true para receber eventos enviados pelo servidor enquanto o modelo trabalha.
A página da Felo lista GPT-6.1 Sol a $2.00 por milhão de tokens de entrada e $10.00 por milhão de tokens de saída, com preço de lançamento até 50% menor que o valor oficial do provedor. O custo final depende do modelo, proporção entrada/saída, uso de cache e plano ativo. Leituras de cache são cobradas pela metade do valor do GPT-6 Sol.
A plataforma também suporta raciocínio, ferramentas, saída JSON, streaming e visão para este modelo, além de oferecer Playground para testar prompts antes de codificar.
Melhores casos de uso para GPT-6.1 Sol
A orientação da OpenAI destaca projetos complexos onde o custo importa. Alguns padrões se destacam.
Programação agente em escala
Um agente de programação que lê repositório, propõe mudanças, executa testes e itera define o perfil do Sol. A janela de contexto de 1,05M comporta grandes bases de código, o desconto de leitura em cache recompensa reutilização de contexto, e chamadas assíncronas mantêm o agente produtivo enquanto testes rodam.
A orientação do Codex recomenda Sol para trabalho repetido e de longa duração em código e apps quando o custo importa, reservando Astra para tarefas mais exigentes.
Uso de computador e automação de fluxos
GPT-6.1 Sol aceita todas as ferramentas do Responses, incluindo computer_use, hosted_shell, apply_patch, mcp e tool_search. Isso permite agentes que operam software, preenchem formulários, movem dados entre sistemas ou automatizam processos de negócios em múltiplos passos.
A página da Felo destaca uso de computador e automação de fluxos como principais casos de uso.
Trabalho profissional com muitos documentos
Sol aceita texto e imagens, abrangendo documentos escaneados, gráficos, capturas de tela e slides. O guia de seleção da OpenAI cita dois exemplos: montar apresentação de conselho a partir de resultados financeiros e criar site a partir de briefing de produto. Ambos envolvem entradas grandes, múltiplas revisões e exigência de qualidade acima de "barato e rápido".
Pesquisa e análise com fluxos paralelos
Com multi-agente beta, Sol pode dividir tarefas de pesquisa em fluxos independentes, executar em paralelo e reconciliar resultados. Comparar propostas de fornecedores, revisar pull request sob três perspectivas ou investigar várias hipóteses de falha se encaixam.
Processamento em lote de alto volume
Batch e Flex reduzem o preço do Sol para $1 de entrada e $5 de saída por milhão de tokens. Para processamento de documentos noturno, sumarização em massa ou extração em larga escala com revisão posterior, esse preço amplia o que é viável economicamente.
Checklist de migração: do GPT-6 Sol para GPT-6.1 Sol
A OpenAI recomenda revisar a orientação de migração antes de trocar de gpt-6-sol para gpt-6.1-sol. Veja o resumo.
- Defina o ID do modelo. Troque
modelparagpt-6.1-sol. - Corrija esforço de raciocínio. GPT-6.1 Sol não aceita
noneouminimal. Substituanoneporlowe teste migrações deminimalcomeçando emlow. - Migre chamadas de ferramentas para Responses. Chat Completions funciona para requisições sem ferramentas. Qualquer chamada de função, busca web, busca de arquivos, uso de computador ou fluxo MCP exige Responses API.
- Remova parâmetros não suportados. Quando o esforço de raciocínio não é
none, eliminetemperature,top_petop_logprobs. Em Chat Completions, também removalogprobs. Em Responses, eliminemessage.output_text.logprobsdeinclude. - Atualize configuração de cache de prompt. Se migra do GPT-5.5 ou anterior, troque
prompt_cache_retentionporprompt_cache_options.ttlcom valor"30m". - Use
configuration_updatepara alterar raciocínio. Se o app ajusta esforço entre rodadas, use itensconfiguration_updateem vez de alterarreasoning.effortna requisição, mantendo o prefixo cacheável. - Verifique residência de dados. GPT-6.1 Sol aceita residência nos EUA e UE. Fast mode não está disponível com residência de dados na UE.
- Teste contra Astra. Rode ambos os modelos em tarefas representativas e compare qualidade, latência e custo total — incluindo tokens de raciocínio, cobrados como tokens de saída.
Limitações e disponibilidade
GPT-6.1 Sol não substitui Astra universalmente e ainda não está disponível em todos os lugares.
Limites de capacidade. A OpenAI posiciona Sol abaixo de Astra. Para raciocínio mais exigente e entregáveis críticos, Astra permanece recomendado. Sol é opção econômica para trabalho complexo, não para máxima qualidade.
Sem fine-tuning. GPT-6.1 Sol não aceita fine-tuning nem saídas previstas. Também não suporta embeddings, geração de imagem, vídeo, voz, transcrição, tradução ou moderação. É modelo de raciocínio com entrada de texto e imagem, saída de texto.
Sem entrada de áudio ou vídeo. Modalidades de entrada são apenas texto e imagem.
Raciocínio não pode ser desativado. Os esforços none e minimal não são suportados, então toda requisição carrega sobrecarga de raciocínio.
Lançamento em andamento. O rollout inclui planos Plus, Pro, Business, Enterprise e Edu no Codex para desktop e CLI, e ChatGPT Work na web e mobile. Para Enterprise e Edu, o modelo permanece desativado até administrador liberar. Planos Free e Go não estão incluídos no lançamento.
Fast mode tem restrições. Standard e Fast estão disponíveis no lançamento, mas Fast custa 2x Standard e não funciona com residência de dados na UE. Ultrafast para GPT-6.1 Sol chegará depois.
Limites de taxa aplicados. Limites padrão vão de 500 RPM e 500.000 TPM no Tier 1 até 15.000 RPM e 40.000.000 TPM no Tier 5.
FAQ
O que é GPT-6.1 Sol?
GPT-6.1 Sol é o modelo equilibrado da OpenAI, entre o GPT-6 Astra principal e o GPT-6 Luna leve. A OpenAI descreve como entrega desempenho próximo ao Astra para programação complexa, uso de computador e trabalho profissional com menor custo.
Quanto custa GPT-6.1 Sol?
A OpenAI lista GPT-6.1 Sol a $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída. Entrada em cache custa $0.10 por milhão de tokens, escrita em cache custa $2.50 por milhão. Prompts acima de 272K tokens de entrada são cobrados com taxas maiores.
Qual a janela de contexto do GPT-6.1 Sol?
GPT-6.1 Sol tem janela de contexto de 1.050.000 tokens, máximo de 922.000 tokens de entrada e 128.000 tokens de saída.
GPT-6.1 Sol suporta chamadas de ferramentas?
Sim, mas chamadas de ferramentas exigem Responses API. Chat Completions funciona para requisições sem ferramentas.
Posso desativar raciocínio no GPT-6.1 Sol?
Não. GPT-6.1 Sol aceita esforços low, medium, high, xhigh e max. Não aceita none nem minimal.
Como GPT-6.1 Sol se compara ao GPT-6 Sol?
GPT-6.1 Sol é upgrade do GPT-6 Sol, com menos erros factuais e maior aderência a restrições explícitas, segundo a página da Felo. Ambos têm o mesmo preço principal, mas GPT-6.1 Sol reduz a taxa de entrada em cache para $0.10 por milhão de tokens.
GPT-6.1 Sol está disponível na Felo API Platform?
Sim. Felo API Platform disponibiliza GPT-6.1 Sol em Chat Completions, Responses e Messages compatíveis com Anthropic. O preço de lançamento pode ser até 50% menor que o valor oficial do provedor, e leituras de cache são cobradas pela metade do valor do GPT-6 Sol.
Conclusão
GPT-6.1 Sol responde a um problema prático: o melhor modelo custa demais para todas as tarefas, e o mais barato não entrega qualidade suficiente. Sol equilibra com capacidade próxima ao Astra, janela de contexto de 1,05M, taxa de leitura em cache de 5% e preço um quinto do Astra.
Para equipes que desenvolvem agentes de programação, fluxos de uso de computador e automação com muitos documentos, é o modelo a testar primeiro. Compare com Astra nas suas tarefas, observe o uso de tokens de raciocínio e deixe o equilíbrio custo-qualidade decidir.
Você pode testar GPT-6.1 Sol no Playground da Felo API Platform ou chamar diretamente com uma chave Felo API.
Fontes
- Página do modelo GPT-6.1 Sol — OpenAI
- Usando GPT-6 — OpenAI
- Seleção de modelos — OpenAI
- Preços da API — OpenAI
- Disponibilidade de modelos Codex e ChatGPT — OpenAI
- Chamadas assíncronas de ferramentas — OpenAI
- Direcionamento durante execução — OpenAI
- Modelos de raciocínio — OpenAI
- Cache de prompt — OpenAI
- Compactação — OpenAI
- Multi-agente — OpenAI
- Modo WebSocket — OpenAI
- Fast mode — OpenAI
- Residência de dados — OpenAI
- GPT-6.1 Sol — Felo API Platform
Este post também está disponível em English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español and বাংলা.