Лучшие AI-движки ответов в 2027 году: 14 онлайн-инструментов поиска и 17 API поиска для агентов
Гайд 2027 года с данными по 31 лучшему AI-движку ответов: 14 онлайн-инструментов поиска для людей и 17 API поиска для Claude Code, Codex CLI и OpenClaw.
Когда мы публиковали обзор AI-движков ответов в 2025 году, задача была простой: найти инструмент, который прочитает десять веб-страниц и сделает краткое резюме без галлюцинаций. Через два года "ответ на вопрос в чат-боксе" — только половина истории, а некоторые фавориты из списка 2025 года (например, Phind) уже свернули работу или сменили направление, когда рынок стал зрелым.
В 2027 году поиск разделился на два направления.
С одной стороны, человеческие исследователи используют онлайн AI-движки ответов, которые не только делают резюме веба, но и преодолевают языковые барьеры, проверяют рецензируемые статьи и превращают исследования в презентации или совместные отчеты. С другой стороны, автономные AI-агенты — инструменты вроде Claude Code, Codex CLI, pi coding agent, OpenClaw и Hermes Agent — стали главными потребителями поиска в интернете. Агентам не подходит перегруженный браузерный интерфейс или капчи; им нужны быстрые, токеноэффективные JSON, извлечение полного markdown и готовые к MCP endpoint'ы инструментов.
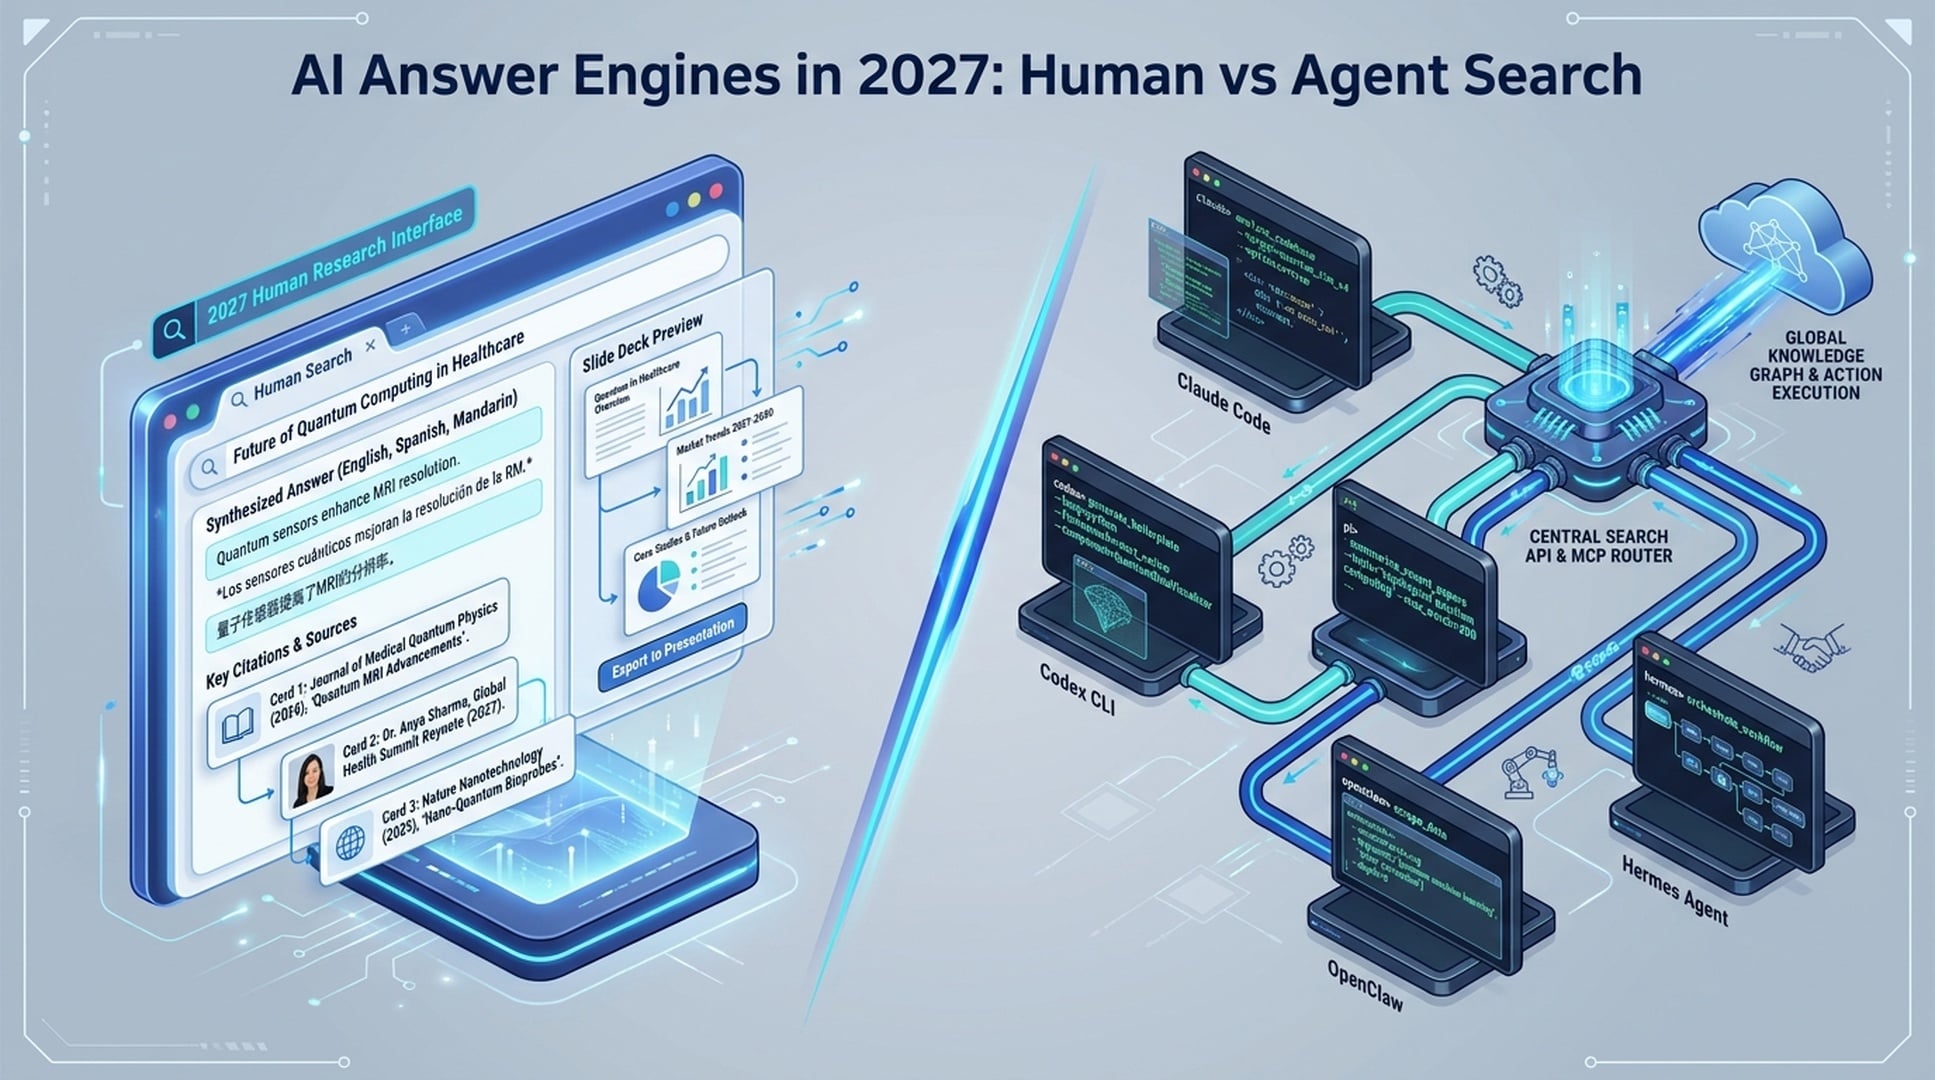
Чтобы этот гайд 2027 года отражал то, что реально используют люди и разработчики, мы объединили данные Ahrefs по органическому поиску и спросу на бренды (США + мир) с живыми бенчмарками внедрения среди разработчиков на X (Twitter). Часть 1 охватывает 14 лучших онлайн AI-движков ответов для людей, а Часть 2 сравнивает 17 лучших сервисов и API поиска, созданных для AI-агентов.
Часть 1: 14 лучших онлайн AI-движков ответов для людей (веб, академия и приватность)
Если вы сидите за клавиатурой, исследуете рынок, проверяете медицинские или научные утверждения или сравниваете поставщиков, вам нужен движок ответов, который цитирует источники, вытаскивает живые обсуждения из сообществ и помогает перейти от фактов к готовому результату.
1. Felo AI Search: лучший для многоязычных глубоких исследований и мгновенных результатов
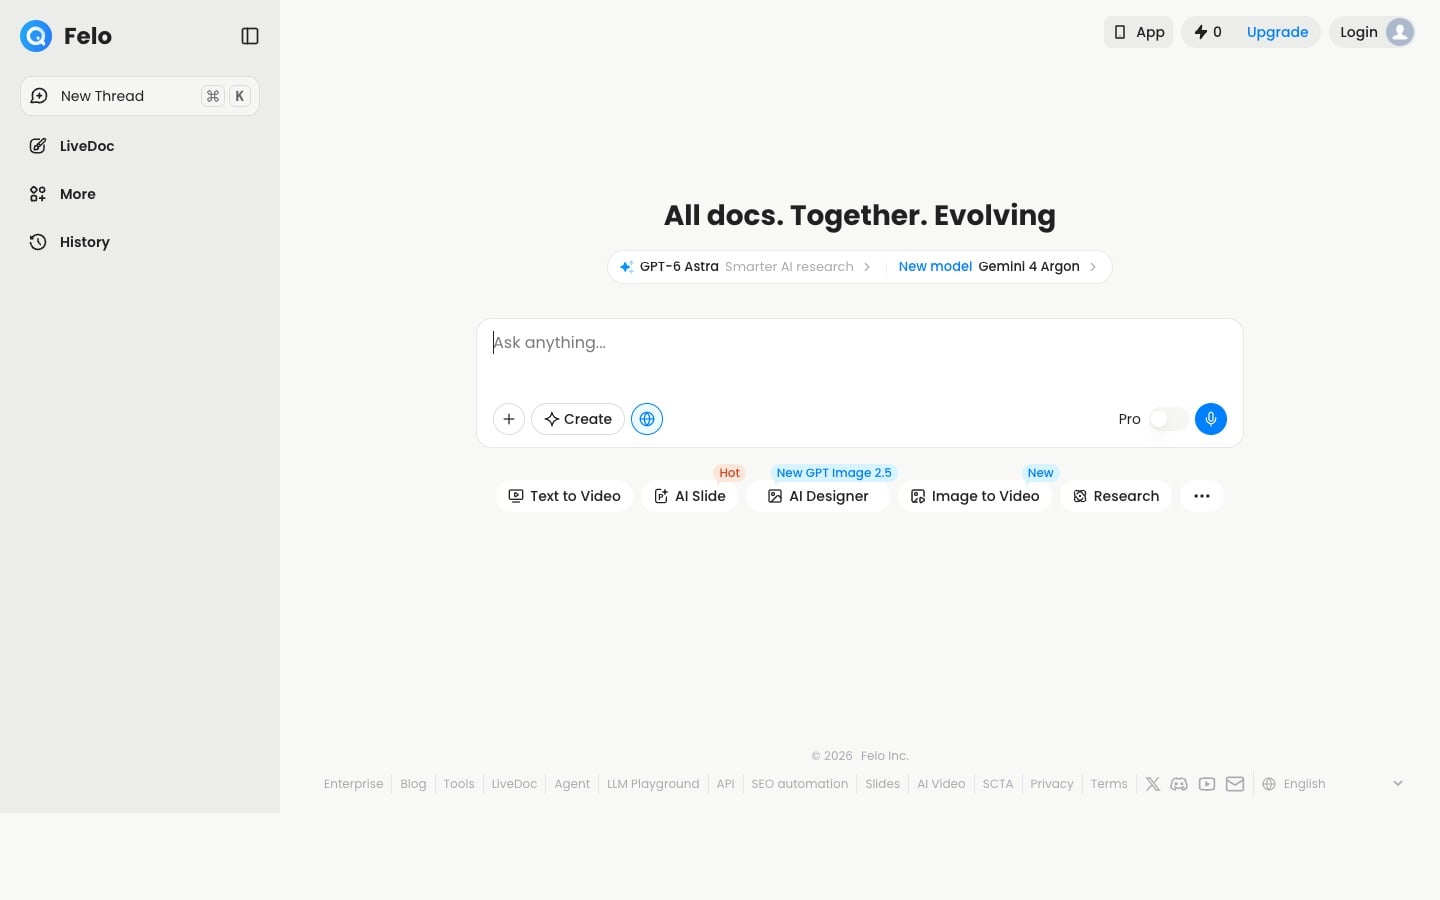
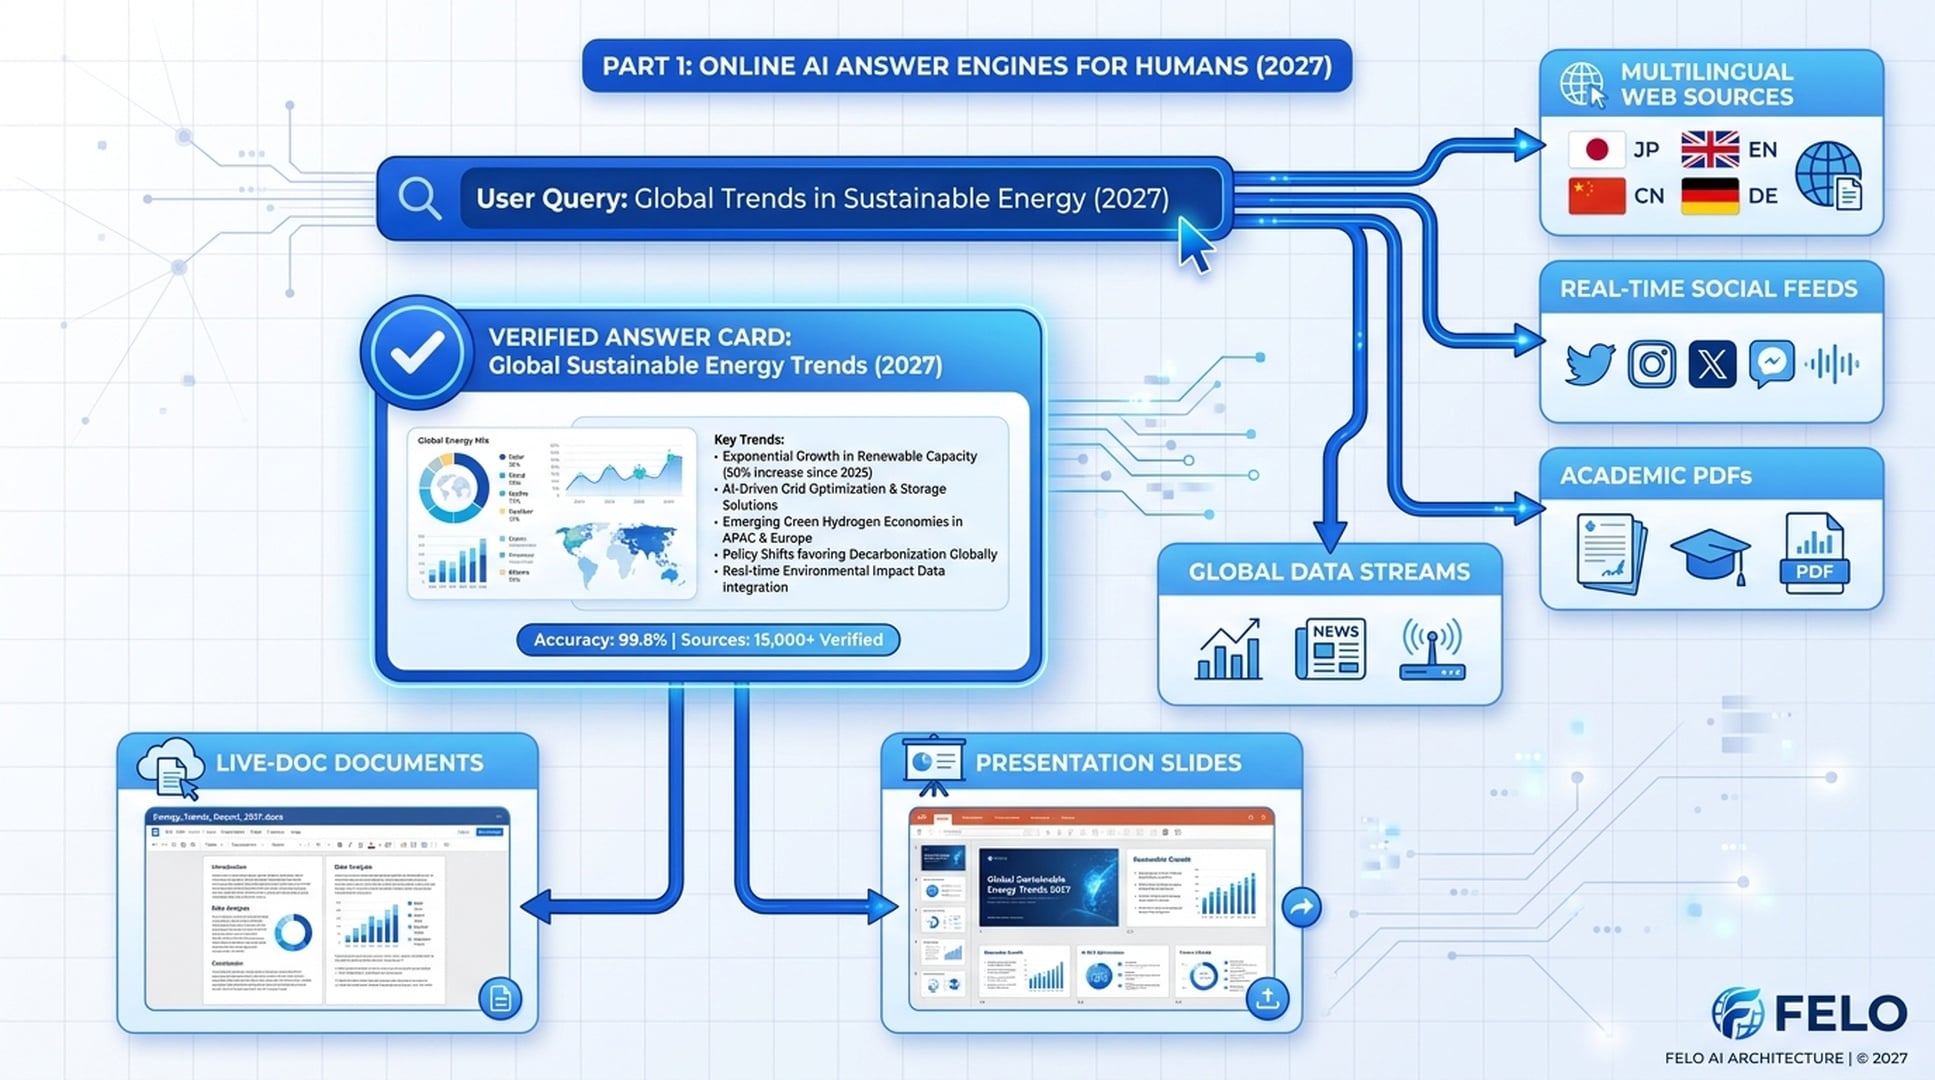
Большинство AI-движков ответов ограничивают вас англоязычной средой — и после ответа приходится копировать его в Google Docs или PowerPoint, чтобы сделать что-то полезное. Запущенный в Токио и используемый по всему миру, Felo AI Search решает обе задачи в одном рабочем пространстве.
Когда вы задаете вопрос на родном языке, движок поиска Felo ищет источники на японском, английском, китайском, немецком, корейском и десятках других языков, а затем синтезирует результаты обратно на ваш язык с кликабельными цитатами. Поиск — только первый шаг: Felo напрямую подключается к Felo LiveDoc (совместное AI-документное пространство) и Felo Slides (генерация презентаций в один клик).
Основные возможности:
- Глубокий многоязычный поиск: Запрос на одном языке, получение первичных данных и регуляторных документов из локальных источников по всему миру, единое резюме.
- Сигналы из соцсетей и сообществ в реальном времени: Индексация Reddit, X (Twitter), YouTube транскриптов наряду с обычными веб-страницами и академическими PDF.
- Поток от поиска к результату: Любую ветку исследования можно превратить в тематическую презентацию (Felo Slides), майндмап или общий отчет LiveDoc без перехода между страницами.
- Пользовательские исследовательские агенты: Построение повторяемых рабочих процессов с Felo Agent и подключение внешних данных через MCP-серверы.
Лучше всего подходит для: Глобальных команд, аналитиков, маркетологов и студентов, которым нужны проверяемые ответы, превращающиеся в презентации и документы.
2. Perplexity AI: лучший для быстрой проверки фактов и академических цитат
Perplexity остается эталоном для быстрого поиска с цитированием. Интерфейс убирает лишний разговор, оставляя пронумерованные сноски, карточки источников и быстрые уточняющие вопросы. В режимах Pro Search и Deep Research Perplexity строит многошаговые запросы, задает уточняющие вопросы при неясности, собирает структурированные обзоры из десятков источников.
Основные возможности:
- Проверка источников в ответе: Каждое утверждение связано с кликабельной карточкой цитаты для быстрой проверки оригинала.
- Режимы фокуса: Фильтрация поиска по академическим статьям, SEC-документам, обсуждениям Reddit, видео YouTube или расчетам WolframAlpha.
- Гибкость моделей: Платные пользователи переключают модели Anthropic, OpenAI и собственные Sonar.
Лучше всего подходит для: Журналистов, академических исследователей и тех, кому нужна быстрая проверка фактов с сносками.
3. ChatGPT Search: лучший универсальный разговорный помощник
OpenAI встроил поиск по вебу прямо в основную строку ChatGPT, убрав неудобный переключатель "browse with Bing" прошлых лет. ChatGPT Search помогает, когда ваш запрос — промежуточный шаг в творческой или аналитической сессии: например, получение цен конкурентов и сразу написание мемо или Python-симуляции цен в Canvas.
Основные возможности:
- Автоматическое определение намерения: Запускает поиск по вебу при вопросах о текущих событиях, обновлениях документации или ценах, оставаясь в разговорном режиме для задач рассуждения.
- Глубокий исследовательский агент: Автономно просматривает сотни страниц за 5–20 минут, собирая аналитический отчет.
- Интеграция Canvas и Code Interpreter: Передача результатов поиска в Python-визуализации данных или совместное редактирование документов.
Лучше всего подходит для: Обычных работников знаний, которые используют ChatGPT для письма, кодирования и мозгового штурма.
4. Google Gemini и Google AI Mode: лучший для пользователей Google Workspace
Стратегия Google по движкам ответов работает на двух фронтах: Google AI Mode внутри классического поиска и отдельное приложение Gemini на базе мультимодальных моделей Google. Классическая страница результатов Google балансирует органические ссылки и рекламу, а AI Mode дает пользователю разговорное пространство с поддержкой огромного индекса Google, данных Google Maps и полного каталога YouTube.
Основные возможности:
- Глубокая интеграция с Workspace: Сравнение ответов из веба с вашими письмами Gmail, документами Google Docs, PDF из Drive и таблицами Google Sheets.
- Локальный и коммерческий граф: Получение данных о наличии товаров, ценах на авиабилеты и отзывов Google Maps, которые сложно получить из сторонних индексов.
- Мультимодальное понимание: Загрузка длинного видео, аудиозаписи или PDF на 500 страниц с проверкой утверждений по живому индексу Google.
Лучше всего подходит для: Команд, работающих в Google Workspace и пользователей, которым нужны локальные, торговые и YouTube-данные.
5. Microsoft Copilot Search: лучший для корпоративных сред M365
Для организаций на Microsoft 365 Microsoft Copilot объединяет публичный веб-поиск (через Bing) и внутренние корпоративные знания (через Microsoft Graph). Copilot отвечает на вопросы, используя новости отрасли и внутренние материалы SharePoint, чаты Teams и письма Outlook.
Основные возможности:
- Защита корпоративных данных: Коммерческие запросы не используются для обучения публичных моделей, внутренние права строго соблюдаются через Microsoft Graph.
- Встроенная интеграция с Office: Перенос результатов веб-исследования прямо в Word, Excel или PowerPoint без выхода из Office.
Лучше всего подходит для: Корпоративных команд, глубоко интегрированных с Microsoft 365, SharePoint и Teams.
6. Brave Search (Answer with AI): лучший независимый индекс для приватности
С почти 1,94 млн глобальных поисков в месяц (brave search по данным Ahrefs), Brave — лидер приватного поиска. В отличие от мета-поисковых инструментов, которые скрыто используют Google или Bing, Brave Search работает на собственном независимом индексе из 30+ млрд страниц. Его движок Answer with AI создает мгновенные ответы, таблицы сравнения и инсайты из форумов без профилирования пользователя и рекламы с трекингом.
Лучше всего подходит для: Пользователей, ориентированных на приватность и независимый индекс вне дуополии Google и Microsoft.
7. Grok Search (xAI): лучший для реального времени X (Twitter) и новостей
С более 8,03 млн глобальных поисков в месяц (2,07 млн в США), Grok от xAI используется, когда облачный сбой, геополитическое событие или релиз open-source модели произошли только что. Обычные веб-краулеры отстают от событий, а Grok напрямую подключается к потоку X (Twitter) и живому веб-поиску, обеспечивая быстрый мониторинг настроений разработчиков и новостей.
Лучше всего подходит для: Отслеживания новостей, настроений рынка/крипто и реакций разработчиков в реальном времени на X.
8. Consensus: лучший AI-движок ответов для рецензируемых научных статей
Обычные веб-движки смешивают рецензируемые клинические исследования с случайными SEO-блогами. С поддержкой 200 млн научных статей и 135 тыс. глобальных поисков бренда в месяц (consensus ai, DR 80), Consensus ограничивает ответы только опубликованной научной литературой. Фирменный Consensus Meter визуально показывает, согласна ли научная среда ("Да", "Нет" или "Возможно") по медицинским, экономическим или психологическим вопросам.
Лучше всего подходит для: Врачей, клиницистов, аспирантов и научных авторов, которым нужны только рецензируемые цитаты.
9. Elicit: лучший для систематических обзоров литературы и таблиц данных
С 143 тыс. глобальных поисков в месяц (48 тыс. в США, DR 76), Elicit идет дальше обычного академического Q&A. При исследовательском вопросе Elicit находит релевантные статьи и строит структурированную матрицу извлечения — автоматически вытаскивает размеры выборки, методологию, типы вмешательств и ключевые выводы из десятков PDF в сортируемую таблицу.
Лучше всего подходит для: R&D-команд, биотехнологических аналитиков и академиков, проводящих формальные обзоры литературы.
10. Liner AI: лучший копилот для студентов и академической разметки
С 14 тыс. поисков бренда в месяц (liner ai) и широкой популярностью в университетах США и Азии, Liner объединяет AI-движок ответов академического уровня с веб/PDF-выделителем и рабочим пространством для письма. Каждое предложение в ответе Liner связано с выделенным фрагментом в исходной статье или веб-странице, что облегчает сбор цитат и создание библиографии.
Лучше всего подходит для: Студентов, аспирантов и авторов длинных эссе.
11. Kagi Search: лучший премиальный поиск без рекламы для инженеров и опытных пользователей
На Hacker News и среди разработчиков X Kagi Search (DR 79, 7,1 тыс. поисков бренда в месяц) получил культовый статус благодаря простой бизнес-модели: вы платите подписку, а Kagi не показывает рекламу, не собирает телеметрию и не допускает SEO-спам. Пользователи закрепляют доверенные домены (например, GitHub или MDN), блокируют контент-фермы и запускают AI-ответы или Kagi Assistant с контролем над моделями.
Лучше всего подходит для: Инженеров и опытных поисковиков, готовых платить за настраиваемый, чистый веб-индекс.
12. iAsk.Ai: лучший бесплатный движок ответов для вопросов и домашней работы
Упомянутый в нашем обзоре 2025 года, iAsk.Ai остается мощным трафиковым ресурсом в 2027 году — 216 тыс. органических визитов в США в месяц по Ahrefs (DR 70) и 18 тыс. поисков бренда в месяц. Быстрый интерфейс без регистрации позволяет задавать фактические, академические или домашние вопросы и переключаться между общим поиском, академическим режимом и мгновенным резюме документов.
Лучше всего подходит для: Студентов и обычных пользователей, которым нужен быстрый, бесплатный движок ответов без регистрации.
13. DuckDuckGo (Duck.ai и AI-Assisted Search): лучший анонимный поиск на каждый день
С 42 тыс. глобальных поисков в месяц по duckduckgo ai (помимо миллионов основных пользователей), DuckDuckGo дает приватным пользователям два варианта AI: AI-Assisted Search — резюме прямо в результатах поиска (можно отключить), и Duck.ai — анонимный прокси для общения с моделями OpenAI, Anthropic, Meta и Mistral с удалением IP-адресов.
Лучше всего подходит для: Обычных пользователей, которым нужны опциональные AI-ответы и приватный чат без аккаунта.
14. You.com (ARI и пользовательские агенты): лучший для корпоративных финансов и многошаговых исследований
Завершая часть 1 с 25 тыс. глобальных поисков бренда в месяц (you.com, DR 79), You.com превратился из потребительского мета-поиска в серьезную корпоративную платформу исследований. Движок ARI (Advanced Research & Insights) читает сотни первичных источников одновременно и активно используется финансовыми компаниями, консалтингом и корпоративными командами, а также предоставляет API веб-поиска для AI-рабочих процессов.
Лучше всего подходит для: Финансовых аналитиков и корпоративных команд, строящих пользовательские многоисточниковые исследования.
Быстрое сравнение: топ-14 онлайн AI-движков ответов (данные 2027)
| # | Движок | Основная сила | Спрос / footprint Ahrefs | Встроенные результаты |
|---|---|---|---|---|
| 1 | Felo AI Search | Глубокий многоязычный поиск + Slides и LiveDoc в один клик | DR 63 · 66,5K US org traffic · Глобальный охват | ✅ Felo Slides (PPT), LiveDoc, Mindmap |
| 2 | Perplexity AI | Быстрая проверка фактов с сносками и Pro Search | DR 91 · 3,08M глобальный объем бренда | Pages (текстовые отчеты) |
| 3 | ChatGPT Search | Единый чат, код и Deep Research | 100M+ активных пользователей · Встроенный OpenAI search | Canvas (текст и код) |
| 4 | Google Gemini / AI Mode | Google Workspace + Maps, Shopping и YouTube | 174K глобальный объем (google ai mode) | Экспорт в Google Docs/Slides |
| 5 | Microsoft Copilot | Корпоративный Microsoft 365 Graph + Bing | Встроен в Windows и M365 Enterprise | Экспорт в Word/Excel/PPT |
| 6 | Brave Search AI | Независимый индекс 30B+ страниц и отсутствие трекинга | 1,94M глобальный объем (brave search) | Карточки ответов и таблицы |
| 7 | Grok Search (xAI) | Поток X (Twitter) + новости | 8,03M глобальный объем (grok) | Синтез тредов и постов |
| 8 | Consensus | Рецензируемый научный консенсус | DR 80 · 135K глобальный объем (consensus ai) | Списки цитат и снимки исследований |
| 9 | Elicit | Систематические обзоры и таблицы данных | DR 76 · 143K глобальный объем (elicit) | Матрица извлечения из нескольких статей |
| 10 | Liner AI | Академическая разметка и цитаты | 14K глобальный объем (liner ai) | Черновики эссе и библиографии |
| 11 | Kagi Search | Платный, без рекламы, настраиваемый индекс для инженеров | DR 79 · 7,1K глобальный объем (kagi search) | Чистые резюме и ранжирование доменов |
| 12 | iAsk.Ai | Бесплатный, быстрый Q&A и ответы на домашку | DR 70 · 216K US org traffic | Мгновенные текстовые резюме |
| 13 | DuckDuckGo AI | Анонимный AI-поиск и Duck.ai | 42K глобальный объем (duckduckgo ai) | Приватные фрагменты ответов |
| 14 | You.com | Корпоративный ARI глубокий поиск и агенты | DR 79 · 25K глобальный объем (you.com) | Глубокие отчеты исследований |
Часть 2: 17 лучших сервисов и API поиска для AI-агентов (2027)
Когда вы переходите от браузера к автономному агенту, правила поиска меняются полностью.
Самые популярные агентные платформы — Claude Code, Codex CLI, pi coding agent, OpenClaw и Hermes Agent — выполняют десятки вызовов инструментов в одном цикле задачи. Если агенту дать сырой HTML с обычного скрапера, он перегрузит контекст навигационными меню, баннерами cookies и inline JavaScript, а также потратит лишние токены.
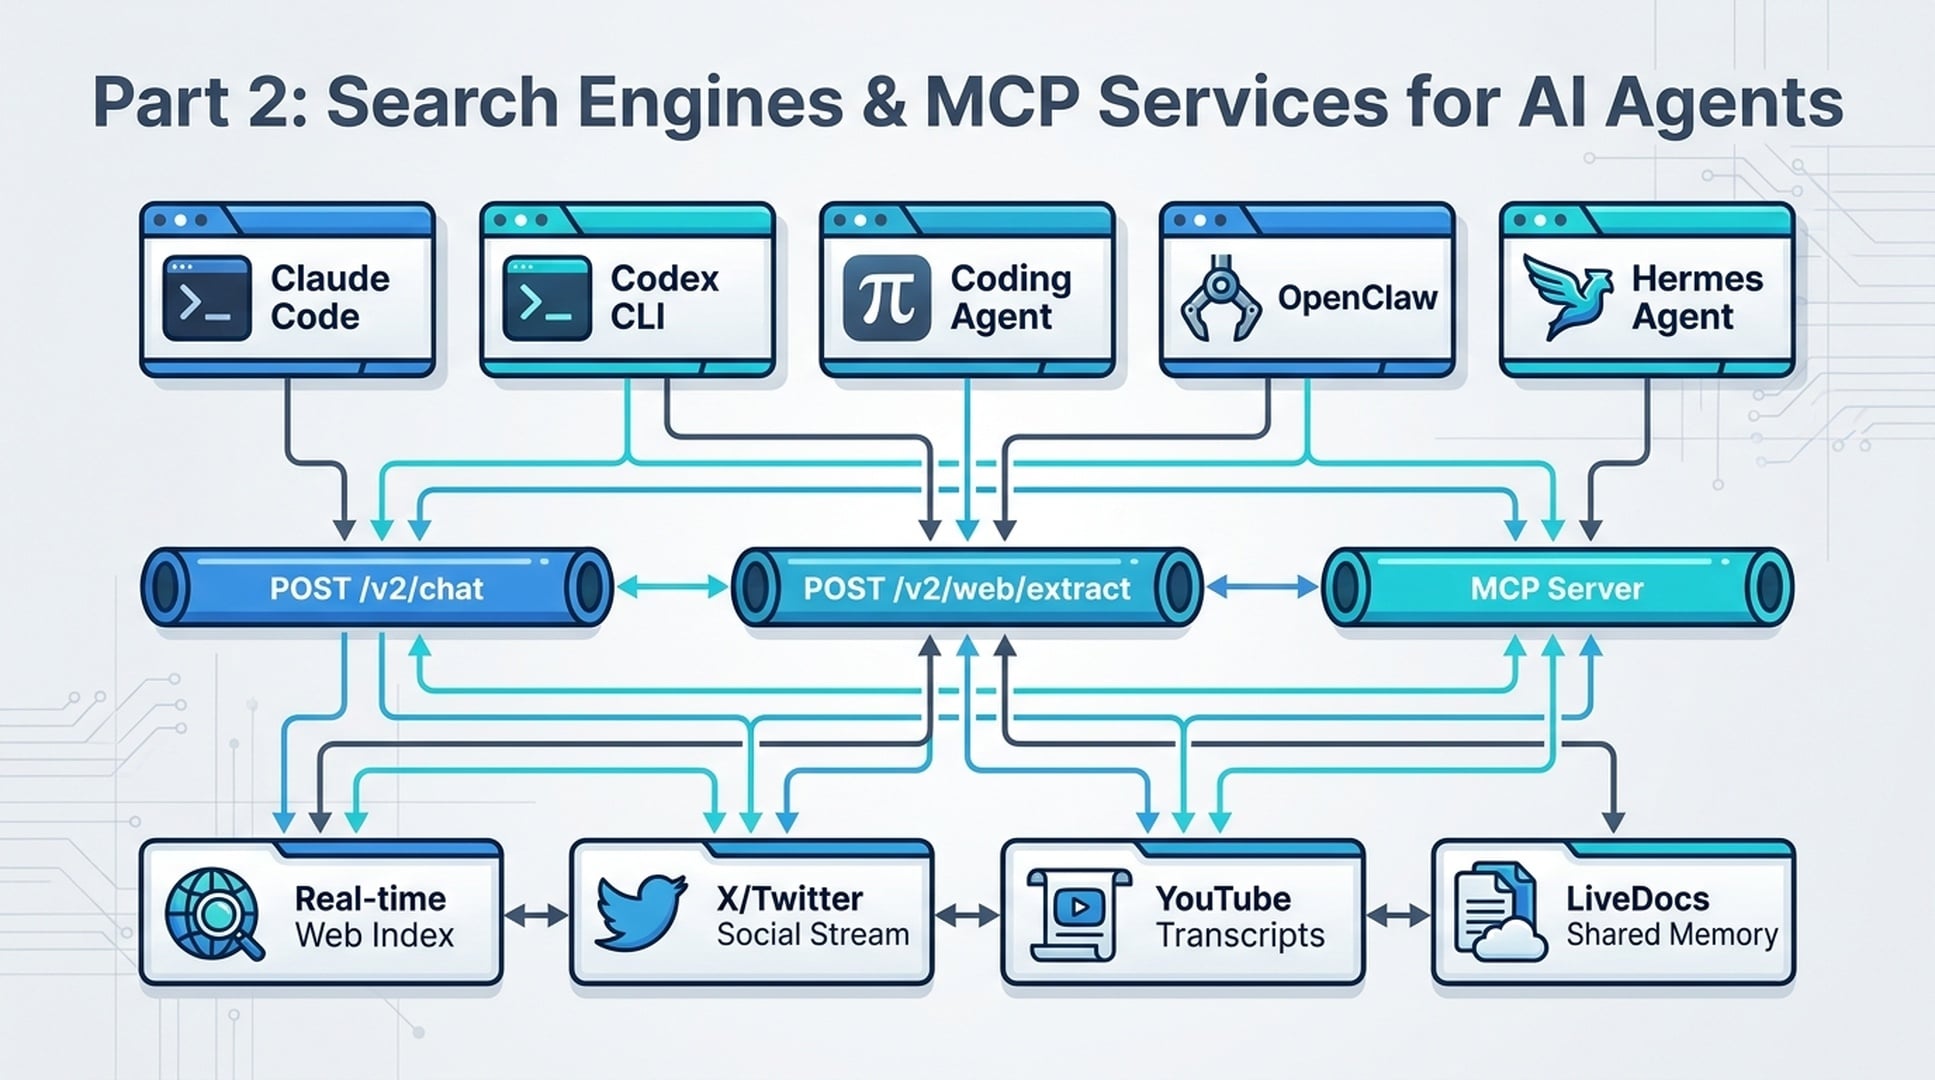
Как разработчики выбирают поиск для агентов в 2027 году (данные X и Ahrefs)
По данным Ahrefs и живым бенчмаркам на X (Twitter), ландшафт поиска для агентов в 2027 году делится на четыре слоя:
- Единые стеки инструментов и результатов для агентов (Felo OpenAPI, плюс прямой доступ к Anthropic Web Search API и OpenAI Web Search API): поиск + web fetch + X/YouTube + память LiveDocs + вывод PPT/Page под одним API-ключом.
- Нативные API поиска и grounding для агентов (Tavily, Exa, Parallel Web Systems, Brave Search API, Perplexity Sonar, Linkup, DeepSeek Search & Fetch): специально для LLM — возвращают готовые chunk'и, highlights или grounded-ответы по цене $0,75–$8 за 1000 вызовов.
- Извлечение Markdown и агентные краулеры (Firecrawl, Jina Reader, Crawl4AI): превращают сложные JS-сайты в чистый Markdown.
- Raw SERP и корпоративная инфраструктура веба (SerpApi, Serper.dev, Apify, Bright Data): масштабный Google SERP JSON, обход прокси и готовые MCP-акторы для скрапинга.
Вот 17 лучших сервисов поиска для AI-агентов в 2027 году с официальными интерфейсами и реальными компромиссами для разработчиков.
1. Felo OpenAPI и стек MCP Search: лучший единый слой поиска, извлечения, соцсетей и результатов для агентов
Большинство API поиска заканчивают работу после выдачи десяти snippet'ов. Felo OpenAPI создан специально для платформ вроде Claude Code, Codex CLI, pi, OpenClaw и Hermes Agent, которым нужно искать, читать, запоминать и создавать результаты под одним API-ключом и одним base URL.
Вместо сборки Tavily для поиска, Jina для чтения страниц, отдельного Twitter-скрапера и генератора слайдов, Felo предоставляет многоуровневый стек поиска и инструментов:
- AI Search (
POST /v2/chat): API движка ответов в реальном времени, возвращает синтезированные ответы и оптимизированный анализ запроса для рассуждения агента. - Web Fetch / Extraction (
POST /v2/web/extract): Извлекает чистый, структурированный контент с любого URL, чтобы агент мог проверить первичную документацию без перегрузки контекста. - X (Twitter) Search (
POST /v2/x/tweet/searchи/v2/x/user/tweets): Позволяет агентам искать живые обсуждения разработчиков, релизы продуктов и соцнастроения напрямую. - YouTube Subtitles (
GET /v2/youtube/subtitling): Получает полные транскрипты видео для извлечения инсайтов из конференций, туториалов и демонстраций без просмотра. - LiveDocs Memory и Output API (
POST /v2/ppts,/v2/mindmap,/v2/landing_page): Агенты сохраняют результаты исследований в общей семантической памяти (LiveDocs) и превращают их в готовые презентации или лендинги, плюс вызывают frontier LLM (Claude, GPT, Grok) через совместимые endpoint'ы OpenAI и Anthropic.
Почему разработчики выбирают Felo:
- Специализированные гайды и навыки для Claude Code, Codex CLI, OpenClaw, pi и Hermes Agent.
- Заменяет 4–5 отдельных подписок на API одним ключом (
openapi.felo.ai).
2. Anthropic Web Search API (через Felo OpenAPI): лучший поиск с grounding для Claude без отдельного аккаунта
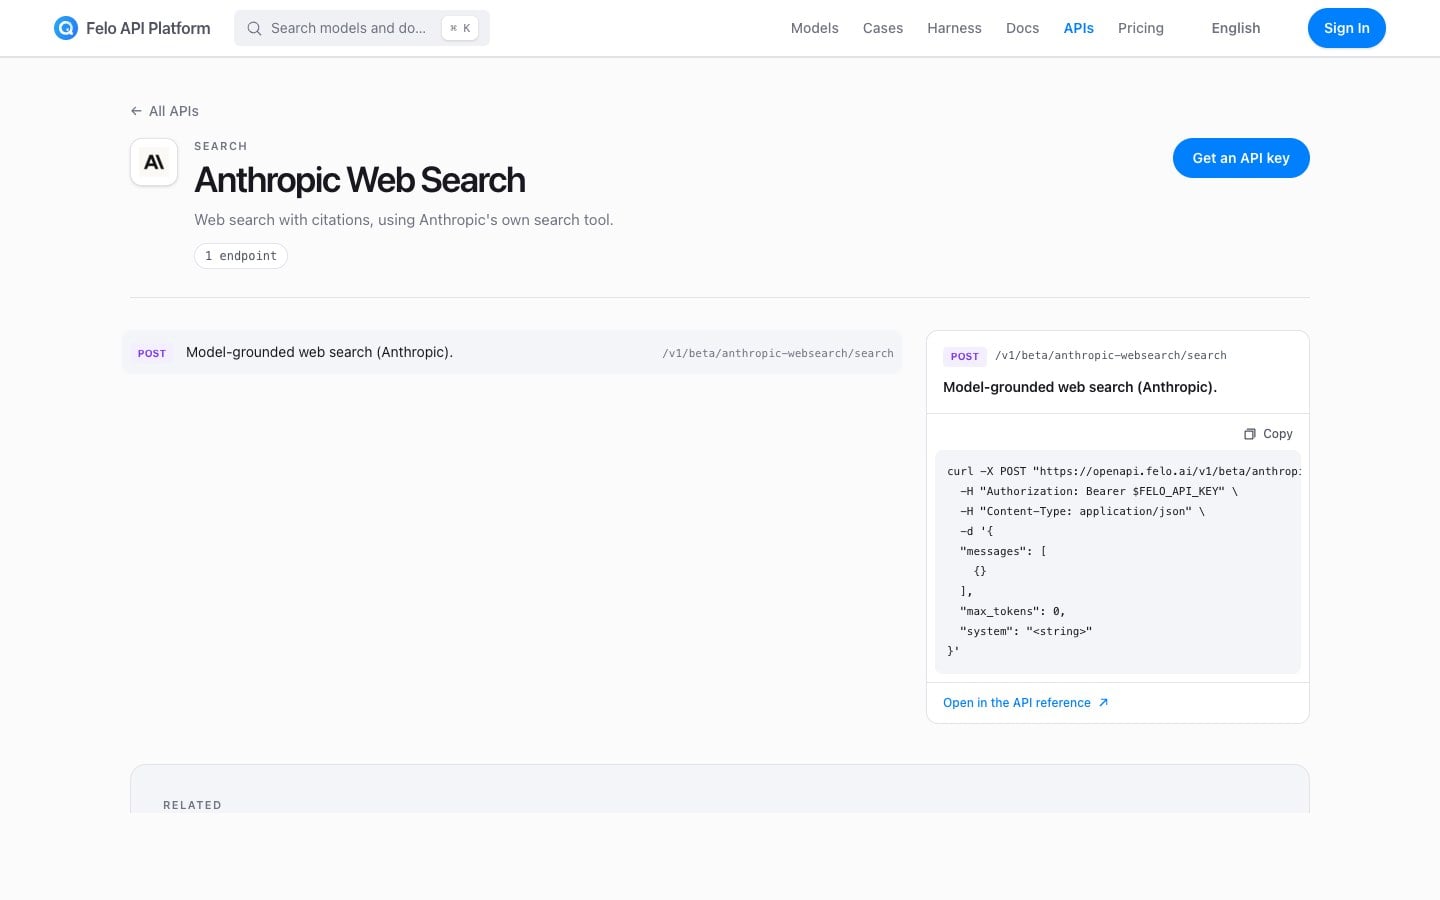
Многие разработчики на Claude Code, pi или кастомных Anthropic-циклах хотят нативный web search с grounding и цитатами от Anthropic — без отдельного аккаунта, лимитов и региональных биллингов. Через Anthropic Web Search на Felo OpenAPI (POST /v1/beta/anthropic-websearch/search) агент вызывает поиск Anthropic напрямую с вашим $FELO_API_KEY.
Сильные стороны:
- Нативный поиск с grounding для Claude и структурированными цитатами через единый endpoint (
https://openapi.felo.ai/v1/beta/anthropic-websearch/search). - Без отдельного аккаунта: стандартные параметры
messages,max_tokens,systemпод единым биллингом Felo.
Ограничения: Фокус только на синтезе поиска с grounding для Claude; используйте вместе с Felo /v2/web/extract или /v2/x/tweet/search для полного скрапинга или соцсетей.
3. OpenAI Web Search API (через Felo OpenAPI): лучший поиск с grounding для OpenAI-моделей в Codex и Responses
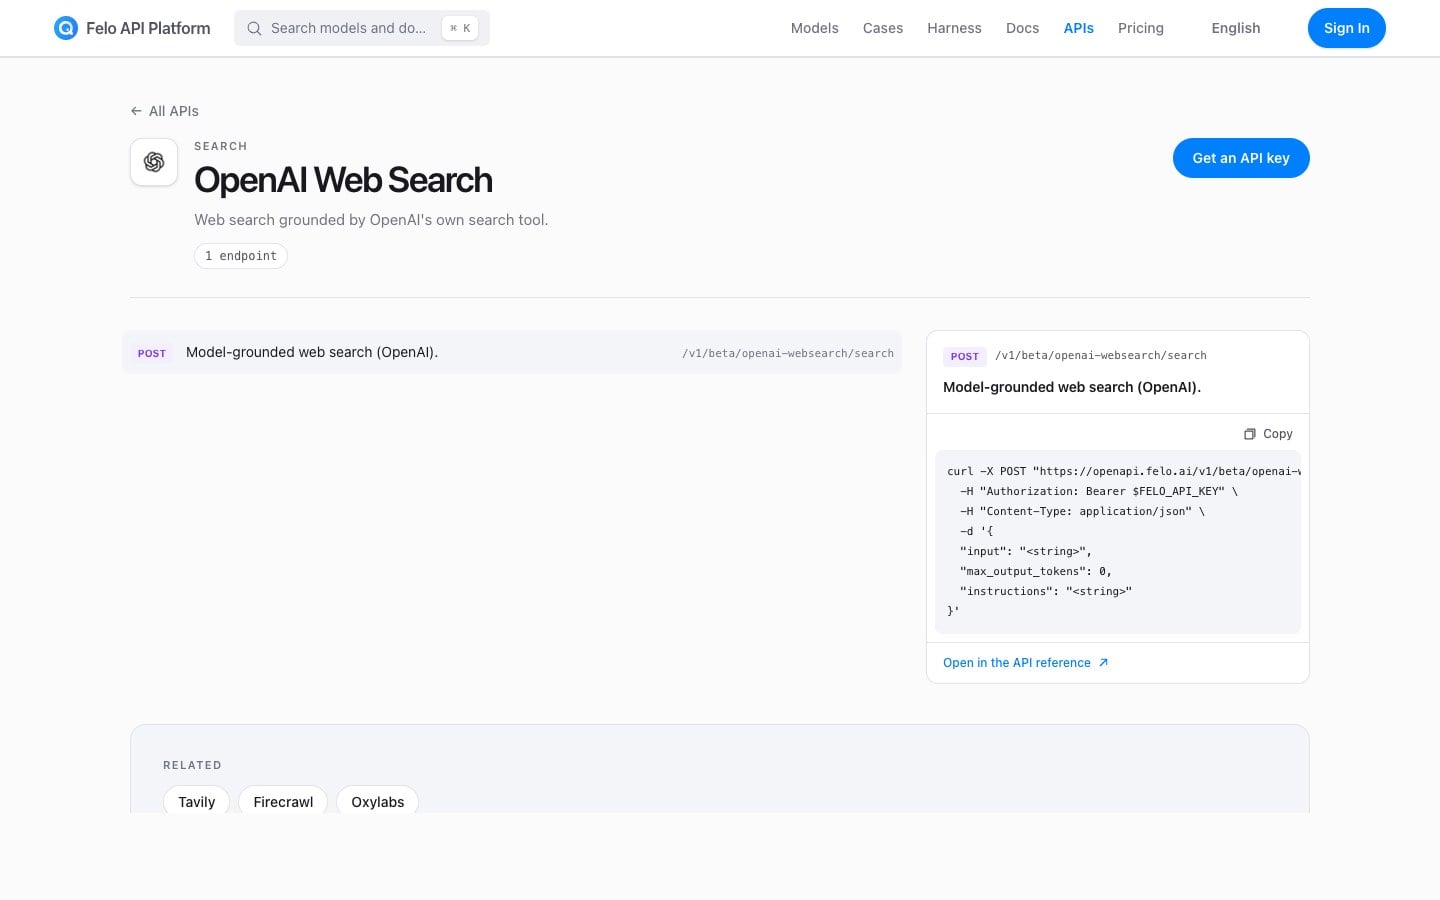
Если агент использует схему Responses OpenAI (input, instructions, max_output_tokens) или работает в Codex CLI, OpenAI Web Search на Felo OpenAPI (POST /v1/beta/openai-websearch/search) дает прямой доступ к поиску с grounding от OpenAI — без отдельного аккаунта OpenAI.
Сильные стороны:
- Использует нативный инструмент grounding поиска OpenAI через
https://openapi.felo.ai/v1/beta/openai-websearch/search. - Идеально для команд на Codex CLI или гибридных multi-model агентов, которым нужны оба поиска — Anthropic и OpenAI — под одним
$FELO_API_KEY.
Ограничения: Предназначен для ответов с grounding, не для многостраничного краулинга.
4. Tavily Search API: лучший специализированный RAG-поиск для LangChain и LangGraph
С 32 тыс. глобальных поисков в месяц (tavily, DR 79, $4,50 CPC по Ahrefs), Tavily — один из первых API, созданных специально для LLM-агентов, а не SEO-аналитиков. Одна API-команда ищет по нескольким источникам, оценивает релевантность к prompt'у агента и возвращает concise chunk'и контента плюс короткий ответ.
Сильные стороны:
- Чистые endpoint'ы
searchиextractс настройкой глубины поиска (basicvs.advanced). - Глубокие интеграции с LangChain, LlamaIndex и CrewAI.
Ограничения: Только поиск и извлечение; нет нативного поиска по соцсетям/X, извлечения YouTube транскриптов, памяти workspace или генерации результатов.
5. Exa (ранее Metaphor): лучший нейронный и семантический поиск для технических исследований
С 23,1 тыс. органических визитов в США и 16 тыс. глобальных поисков бренда (exa ai, DR 79), Exa использует нейронные эмбеддинги для поиска по смыслу и структуре ссылок, а не только по ключевым словам. На X разработчики ставят Exa на первое место, когда агенту нужно найти "open-source Rust vector database" или "академические бенчмарки по KV-cache compression", где точный keyword не работает.
Сильные стороны:
- Нейронный поиск + фильтры по категориям (статьи, GitHub, компании, новости, твиты, люди).
- Токеноэффективный режим highlights и MCP-сервер, используемый в pi coding agent и Claude Code.
Ограничения: Меньше подходит для точных навигационных запросов или офисных рабочих процессов.
6. Parallel Web Systems (parallel.ai): лучший быстрый поиск и извлечение для глубоких исследовательских агентов
Один из самых заметных прорывов инфраструктуры агентов на X в 2026–2027 (DR 77, 18 тыс. органических визитов в США, 6,8 тыс. глобальных поисков по parallel web systems), Parallel построил движок поиска и извлечения специально для AI-агентов. В независимых бенчмарках Parallel достигает оптимума по точности, задержке и цене (~$1 за 1000 страниц), предлагая Search, Extract и Deep Research Task API плюс MCP-сервер.
Сильные стороны:
- Спроектирован вокруг декларативных целей агента, а не legacy keyword-запросов.
- Субсекундная задержка для голосовых/чат-агентов, масштабирование до многошаговых асинхронных исследований.
Ограничения: Только web intelligence — нет генерации слайдов/документов или multi-provider LLM chat routing.
7. Brave Search API (с LLM Context): лучший независимый веб-индекс для массовых агентных запросов
С 30 тыс. глобальных поисков в месяц по brave search api, Brave Search API — выбор разработчиков, которым нужны сырые, непредвзятые результаты без лимитов Google/Bing. Встроенный провайдер в OpenClaw, pi coding agent и MCP-серверах, теперь с endpoint'ом LLM Context для grounding моделей.
Сильные стороны:
- Индекс Brave — 30B+ страниц (100M+ обновлений в день).
- Предсказуемая цена (~$3–$5 за 1000 запросов) и низкая задержка.
Ограничения: Возвращает SERP snippet'ы и grounding context; для сложного краулинга нужен отдельный reader tool.
8. Firecrawl: лучший управляемый веб-скрапер, краулер и структурный extractor для агентов
С 105 тыс. глобальных поисков в месяц (30 тыс. в США, DR 80, 44,6K US org traffic по Ahrefs), Firecrawl — стандарт индустрии, когда агенту нужно краулить весь сайт документации (docs.example.com/*), рендерить динамический JS и конвертировать страницы в чистый Markdown или JSON. В 2026 году Firecrawl добавил endpoint People Data с 270M+ профилей для sales и рекрутинговых агентов.
Сильные стороны:
/search,/scrape,/crawlи schema-driven/extract, плюс MCP-инструменты для Claude Code и Cursor.- Автоматически обрабатывает headless-браузеры, антибот-обход и парсинг PDF.
Ограничения: Расход кредитов растет при многостраничном крауле; для YouTube транскриптов или генерации слайдов нужны отдельные инструменты.
9. Jina Reader API (r.jina.ai и s.jina.ai): лучший pipeline URL-to-Markdown без настройки
На базе Jina AI (DR 77, $4,50 CPC), Jina Reader стал популярен среди разработчиков агентов благодаря простоте: добавьте https://r.jina.ai/ к любому URL — получите чистый Markdown, или https://s.jina.ai/ к поисковому запросу — получите топовые результаты в Markdown.
Сильные стороны:
- Не требует SDK — работает через обычный
curlилиfetchв любом bash-агенте. - Поддержка специализированных моделей ReaderLM для очистки HTML в Markdown.
Ограничения: Лимиты без платных токенов; нет поиска по соцсетям/X или памяти workspace.
10. Crawl4AI: лучший open-source и self-hosted веб-краулер для AI-агентов
С 17 тыс. глобальных поисков в месяц (crawl4ai) и более 50 тыс. звезд на GitHub, Crawl4AI — главный open-source конкурент Firecrawl. Когда инженерные команды хотят нулевые счета за API или полный контроль в своем VPC, они разворачивают Crawl4AI локально через Docker/Python или подключаются к Crawl4AI Cloud.
Сильные стороны:
- 100% open-source, self-hosted, выводит чистый Markdown с удалением шума (
fit_markdown). - Поддержка браузерных сессий, кастомных JS-хуков и локального извлечения LLM.
Ограничения: Самостоятельное хостинг требует управления Playwright-браузерами, памятью и прокси при блокировке IP.
11. Perplexity Sonar API: лучший для быстрых ответов с цитатами
С 2,5 тыс. поисков в месяц по perplexity sonar, Perplexity Sonar API — самый быстрый вариант, когда агенту не нужен многошаговый loop поиска и скрапинга, а нужен один OpenAI-совместимый вызов Chat Completions с массивом URL цитат.
Сильные стороны:
- Совместимость с OpenAI SDK (
sonar,sonar-pro,sonar-deep-researchмодели). - Высокая точность на single-turn Q&A.
Ограничения: Стоимость токенов и запросов быстро растет при 30+ итерациях; нет endpoint'а для извлечения страниц.
12. Linkup (linkup.so): лучший для проверяемого grounding и премиальных данных
С 6,1 тыс. глобальных поисков в месяц (linkup, DR 65, $6,00 CPC по Ahrefs), Linkup — быстро растущий европейский и американский API поиска для агентов с акцентом на проверяемый, безопасный grounding. Помимо быстрых endpoint'ов поиска и извлечения (/search и /fetch), Linkup напрямую сотрудничает с премиальными издателями и поставщиками данных для доступа к лицензированным фактам.
Сильные стороны:
- Высокая производительность на SimpleQA с низкой задержкой (
standardи многошаговыйdeepsearch). - Официальный MCP-сервер и интеграции с LangChain, LlamaIndex и Claude Desktop.
Ограничения: Меньше инструментов для креатива/вывода по сравнению с комплексными workspace для агентов.
13. SerpApi: лучший для структурированного SERP JSON (Google, Scholar, Maps, News)
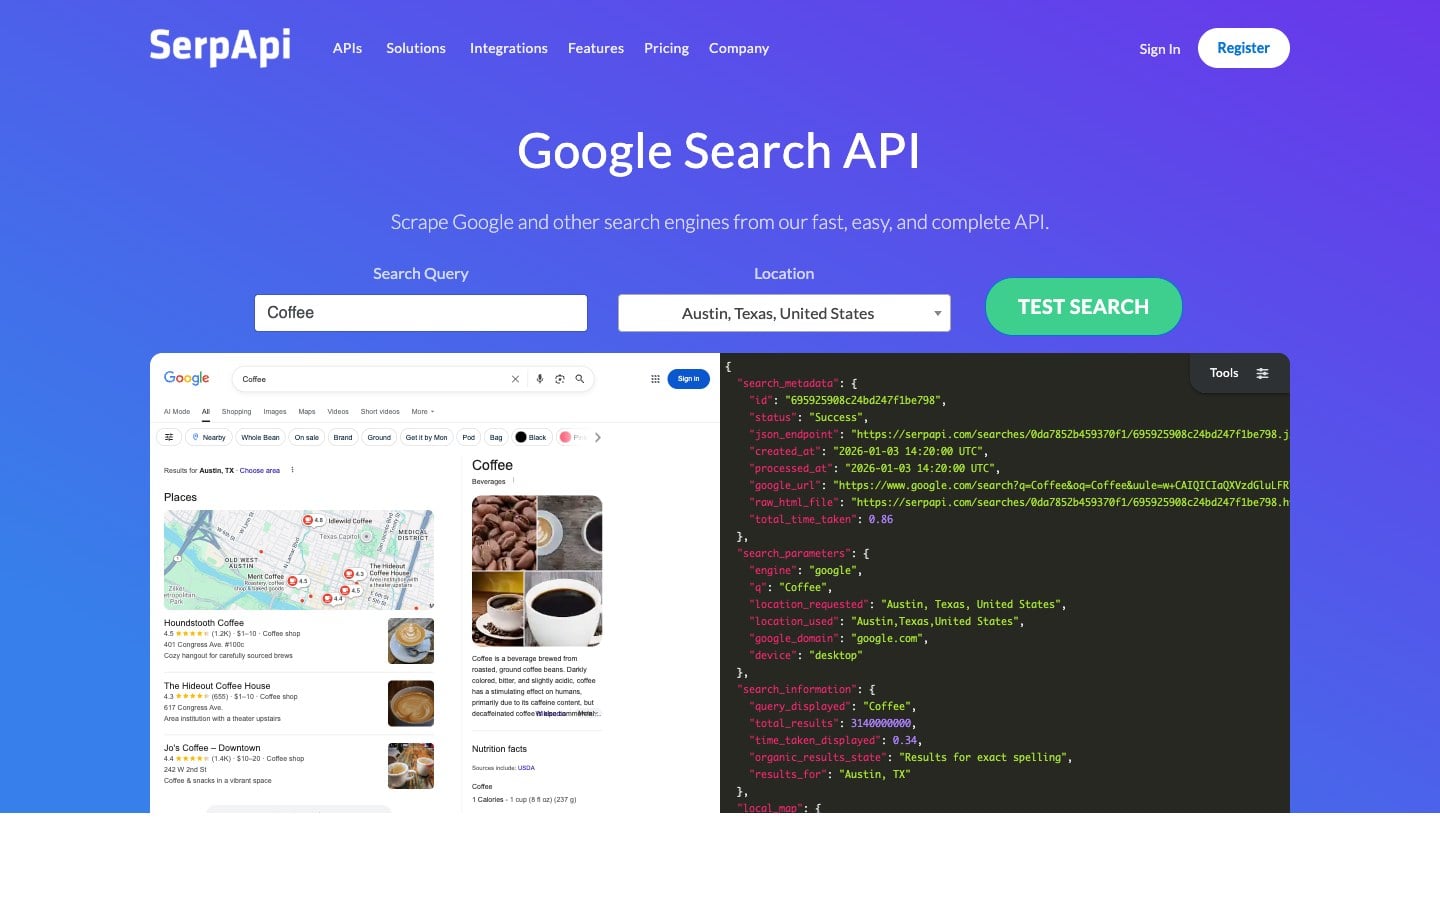
С 63 тыс. глобальных поисков в месяц (20 тыс. в США) и 34,7 тыс. органических визитов в США (DR 79), SerpApi — проверенный ветеран скрапинга поиска. Хотя изначально не для LLM, агенты используют SerpApi для получения структурированных данных из специализированных вертикалей Google — Scholar, Patents, Flights, Maps, Shopping.
Сильные стороны:
- 40+ поисковых движков и вертикалей с гарантированным обходом капчи и геотаргетингом до города.
- Legal US shield protection для compliance-команд.
Ограничения: Дорого (~$10–$15 за 1000 поисков) и возвращает большой сырой SERP JSON, требующий постобработки для LLM.
14. Serper (serper.dev): лучший недорогой и быстрый API Google SERP
С 11 тыс. глобальных поисков в месяц (serper, DR 74), Serper.dev — фаворит разработчиков на X, когда агенту нужен сырой Google organic, новости или изображения за 1–2 секунды по цене $0,30–$1,00 за 1000 запросов — намного дешевле SerpApi.
Сильные стороны:
- Очень быстрый (~1s) и самый экономичный способ получить SERP snippet'ы Google в агентные pipeline.
- Встроенная поддержка в pi coding agent, CrewAI и AutoGPT.
Ограничения: Только SERP metadata и короткие snippet'ы — для чтения страниц нужен API извлечения (Felo /v2/web/extract, Firecrawl или Jina).
15. Apify (Actors и MCP Server): лучший маркетплейс 90 тыс. готовых скрапер-акторов для агентов
С огромным 273 тыс. глобальных поисков в месяц (50 тыс. в США, DR 82, 96,9K US org traffic), Apify активно развивает инфраструктуру для AI-агентов. Через RAG Web Browser и MCP-сервер агент может динамически вызывать 90 тыс. cloud-акторов для поиска Google, скрапинга Instagram/TikTok/LinkedIn, извлечения отзывов Amazon или краулинга документации в Markdown.
Сильные стороны:
- Каталог уникальных скрапер-акторов (соцсети, e-commerce, карты, job boards) через единый MCP-gateway.
Ограничения: Время запуска акторов и сложная цена по compute-unit'ам медленнее и сложнее, чем легкий REST-вызов поиска.
16. Bright Data (AI Web Access и SERP API): лучший корпоративный прокси и антибот для агентов
С 27 тыс. глобальных поисков в месяц (bright data, DR 79, 31,7K US org traffic), Bright Data обеспечивает слой доступа к вебу для многих AI-команд Fortune-500. Когда агенту нужно читать страницы за строгими Cloudflare/DataDome, Web Unlocker, SERP API и Remote Browser для агентов используют сеть из 150M+ residential IP и возвращают чистый Markdown.
Сильные стороны:
- Высший успех на защищенных e-commerce, travel и финансовых порталах, плюс MCP-сервер для агентов.
Ограничения: Корпоративный биллинг и настройка; избыточно, если агент работает с документацией, новостями и техблогами.
17. DeepSeek Search & Fetch API: лучший сверхдешевый нативный поиск для кодирующих и исследовательских harness'ов
В октябре 2026 года DeepSeek встряхнул экосистему агентных инструментов на X, выпустив Search & Fetch API — выдача результатов поиска и очищенного контента по цене $0,75 за 1000 вызовов (с промо-бесплатными тарифами для Claude Code и Codex). За сутки open-source разработчики интегрировали DeepSeek Search & Fetch в Hermes Agent и расширения pi (web-deepseek) как быстрый и дешевый аналог Exa и Parallel.
Сильные стороны:
- Агрессивная цена ($0,75 / 1K вызовов) с поиском и извлечением страниц для кодирующих агентов.
Ограничения: Новая экосистема с меньшим количеством вертикальных endpoint'ов (нет нативного извлечения YouTube транскриптов, X user timeline, генерации PPT/LiveDoc).
Сводная таблица: 17 сервисов поиска для AI-агентов (2027)
| # | Сервис | Категория | AI-ответ | Извлечение страниц | X / YouTube данные | Результаты и память | Цена / footprint |
|---|---|---|---|---|---|---|---|
| 1 | Felo OpenAPI | Единый стек для агентов | ✅ /v2/chat | ✅ /v2/web/extract | ✅ X + YouTube | ✅ LiveDocs + PPT/Mindmap | Единый ключ (openapi.felo.ai) |
| 2 | Anthropic Web Search API | Claude-grounded поиск | ✅ (/v1/beta/anthropic-websearch/search) | Через Felo Extract | ❌ | Через Felo OpenAPI | Без аккаунта Anthropic |
| 3 | OpenAI Web Search API | OpenAI-grounded поиск | ✅ (/v1/beta/openai-websearch/search) | Через Felo Extract | ❌ | Через Felo OpenAPI | Без аккаунта OpenAI |
| 4 | Tavily | RAG-поиск для агентов | ✅ | ✅ | ❌ | ❌ | DR 79 · 32K глобальный объем · ~$5–$8/1K |
| 5 | Exa | Нейронный семантический поиск | ✅ | ✅ | Частично (твиты) | ❌ | DR 79 · 16K глобальный объем · ~$5/1K |
| 6 | Parallel (parallel.ai) | Быстрая инфраструктура | ✅ | ✅ | ❌ | ❌ | DR 77 · 18K US org traffic · ~$1/1K |
| 7 | Brave Search API | Независимый веб-индекс | ✅ (LLM Context) | ❌ | ❌ | ❌ | 30K глобальный объем · ~$3–$5/1K |
| 8 | Firecrawl | Управляемый краул и извлечение | ❌ | ✅ (Deep crawl) | ❌ | ❌ | DR 80 · 105K глобальный объем |
| 9 | Jina Reader | URL-to-Markdown | ❌ | ✅ (r.jina.ai) | ❌ | ❌ | DR 77 · Instant prefix API |
| 10 | Crawl4AI | Open-source краулер | ❌ | ✅ (Self-hosted) | ❌ | ❌ | 17K глобальный объем · 50K+ GitHub stars |
| 11 | Perplexity Sonar | Chat с цитатами | ✅ (Core focus) | ❌ | ❌ | ❌ | 2,5K глобальный объем · Token + request fee |
| 12 | Linkup (linkup.so) | Корпоративный grounding | ✅ | ✅ | ❌ | ❌ | DR 65 · 6,1K глобальный объем · €5/1K |
| 13 | SerpApi | Мульти-вертикальный SERP JSON | ❌ | ❌ | YouTube metadata | ❌ | DR 79 · 63K глобальный объем · ~$10–$15/1K |
| 14 | Serper.dev | Быстрый сырой Google SERP | ❌ | ❌ | ❌ | ❌ | DR 74 · 11K глобальный объем · ~$0,30–$1/1K |
| 15 | Apify | 90K+ Actors и MCP | Через Actors | ✅ | ✅ (Через Actors) | ❌ | DR 82 · 273K глобальный объем |
| 16 | Bright Data | Корпоративный unlocker и SERP | ❌ | ✅ (Markdown) | ✅ (Datasets) | ❌ | DR 79 · 27K глобальный объем |
| 17 | DeepSeek Search/Fetch | Дешевый поиск и fetch | ❌ | ✅ | ❌ | ❌ | ~$0,75/1K вызовов · Claude/Codex ready |
Как популярные AI-агенты подключаются к поиску в 2027 году
Если вы запускаете AI-агента локально или внедряете командный workflow, вот как ведущие harness'ы подключаются к сервисам поиска:
1. Claude Code
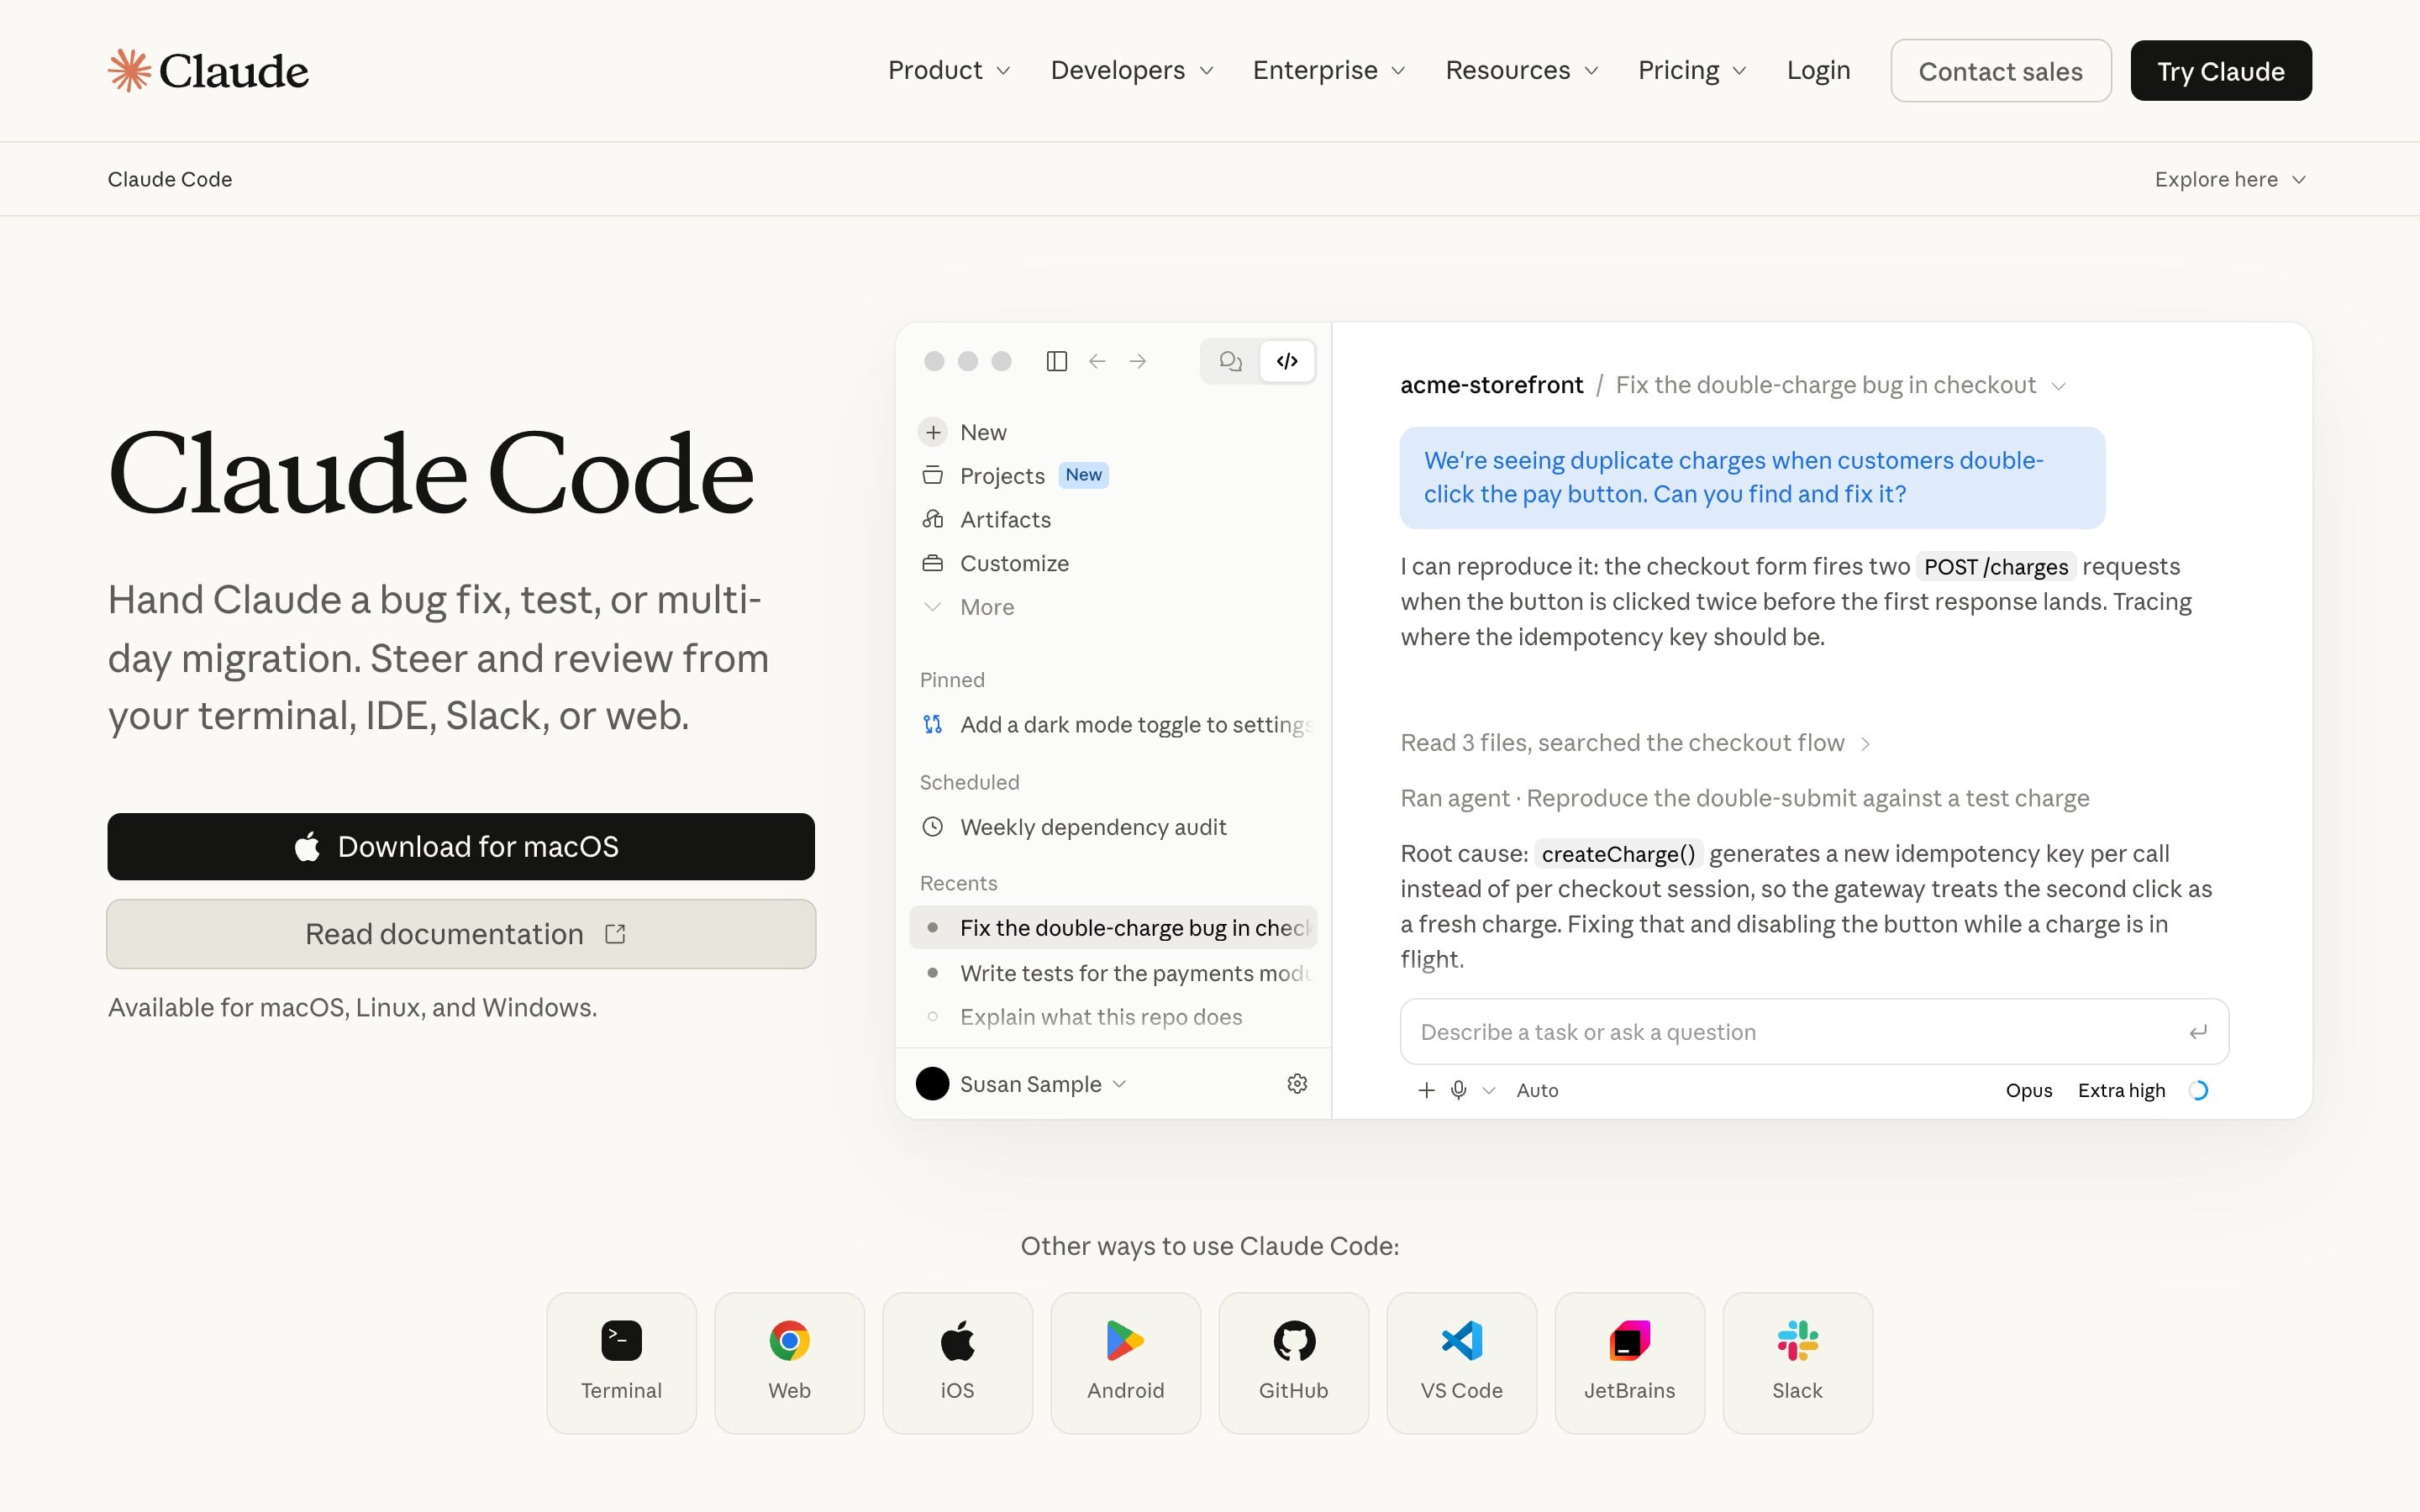
Claude Code хорошо работает с кодом, bash и файлами, но встроенные web-инструменты ограничены для соцсетей, видео или офисных результатов. Подключив Claude Code к Felo OpenAPI (через CLI-скиллы или MCP-серверы), Claude Code ищет живую документацию (POST /v2/chat), извлекает страницы (POST /v2/web/extract), проверяет X на отчеты о breaking-change, генерирует архитектурный обзор в слайдах (POST /v2/ppts).
2. Codex CLI
Codex CLI от OpenAI использует кэшированный web snapshot, из-за чего поиск может пропустить свежую документацию или CVE. Разработчики расширяют Codex через config.toml, MCP-серверы или интеграцию Felo для Codex, получая живой веб-поиск, извлечение URL и дешевый multi-model routing под одним API-ключом.
3. pi Coding Agent
pi coding agent создан для скорости, расширяемости и чистого контекста, рассматривает поиск как основной инструмент. В pi разработчики комбинируют нативные инструменты web_search и fetch_content (многопровайдерные параллельные запросы через Exa, Brave, Tavily, Firecrawl, Jina) с CLI-навыками вроде felo-search (~/.agents/skills/felo-search/scripts/search.sh) и felo-x-search — pi subagents исследуют, проверяют и пишут код параллельно, не загрязняя основной контекст.
4. OpenClaw
OpenClaw популярен для автономных исследований и многошаговых workflow, но без внешних API нет памяти или живого соцпульса. Подключение OpenClaw к Felo OpenAPI дает живой веб-поиск, отслеживание X, извлечение YouTube транскриптов и память LiveDocs для сохранения исследований.
5. Hermes Agent и кастомные MCP-harness'ы
Для команд, оркестрирующих multi-agent pipeline в Hermes Agent или кастомных MCP-клиентах, важна протокольная консистентность. Использование REST и SuperAgent SSE endpoint'ов Felo OpenAPI вместе со стандартными MCP-серверами (например, mcpmeasure.com) позволяет Hermes-агентам цеплять поиск → извлечение → память LiveDocs → генерацию PPT/Landing Page без хрупкого glue-кода для разных вендоров.
Пример: вызов поиска Felo и извлечения веба из любого агента
Felo OpenAPI использует чистые REST endpoint'ы с Bearer-токеном, любой агент с bash или HTTP может вызвать его за секунды:
# 1. AI-поиск ответов в реальном времени (POST /v2/chat)
curl -s -X POST "https://openapi.felo.ai/v2/chat" \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "Compare MCP server authentication changes in the 2026-2027 spec"
  }'

# 2. Web search с grounding для Anthropic (без отдельного аккаунта Anthropic)
curl -s -X POST "https://openapi.felo.ai/v1/beta/anthropic-websearch/search" \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "messages": [{"role": "user", "content": "Latest stable release of Claude Code and key MCP updates"}],
    "max_tokens": 1024
  }'

# 3. Web search с grounding для OpenAI (без отдельного аккаунта OpenAI)
curl -s -X POST "https://openapi.felo.ai/v1/beta/openai-websearch/search" \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "input": "Compare Codex CLI web search configuration options",
    "max_output_tokens": 1024
  }'

# 4. Извлечение чистого контента с URL (POST /v2/web/extract)
curl -s -X POST "https://openapi.felo.ai/v2/web/extract" \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "url": "https://modelcontextprotocol.io/specification"
  }'
Агент получает структурированный JSON с синтезированным answer, терминами query_analysis и извлеченным контентом страницы — готово для следующего шага рассуждения или сохранения в LiveDocs.
Часто задаваемые вопросы (FAQ)
В чем разница между онлайн AI-движком ответов и API поиска для агентов?
Онлайн AI-движок ответов (например, Felo AI Search, Perplexity или ChatGPT Search) создан для людей — визуальный интерфейс, кликабельные источники, создание документов или слайдов. API поиска для агентов (например, Felo OpenAPI, Tavily или Exa) предназначен для программных агентов вроде Claude Code или OpenClaw — возвращает machine-readable JSON, чистый Markdown и быстрые endpoint'ы без UI.
Какой AI-движок ответов лучший для многоязычных исследований в 2027 году?
Felo AI Search лидирует в многоязычных исследованиях. Он переводит ваш запрос в нативные запросы на целевых языках (японский, китайский, корейский, английский, европейские), извлекает локальные источники и синтезирует ответ на ваш язык.
Какой лучший API поиска для Claude Code, Codex CLI, pi и OpenClaw?
Если нужен единый API-ключ для веб-поиска, извлечения страниц, поиска X (Twitter), транскриптов YouTube, общей памяти (LiveDocs) и генерации результатов (PPT, майндмап, лендинг), Felo OpenAPI — самый полный вариант. Если нужны только независимые SERP snippet'ы — Brave Search API; для семантического поиска — Exa.
Почему не стоит просто скрапить Google напрямую агентом?
Скрапинг веба вызывает капчи, ломается при изменении сайтов и загружает тысячи токенов шумного HTML/JS в контекст агента. Специализированные API поиска для агентов возвращают очищенный Markdown и синтезированные ответы с меньшими затратами токенов и задержкой.
Заключение: выберите правильный движок для людей — и для ваших агентов
В 2025 году переход от десяти синих ссылок к AI-движку ответов ощущался как суперсила. В 2027 году самые умные команды обновляют оба направления:
- Для собственных исследований: используйте Felo AI Search для преодоления языковых барьеров, получения живых веб- и соцдоказательств и превращения ответов в LiveDocs и Felo Slides одним кликом.
- Для ваших AI-агентов (Claude Code, Codex CLI, pi, OpenClaw, Hermes Agent): подключайте Felo OpenAPI — агенты ищут живой веб, читают страницы, отслеживают X и YouTube, запоминают контекст и создают результаты — все через один API-ключ.
Попробуйте Felo AI Search бесплатно → | Получите бесплатный ключ Felo OpenAPI для агентов →
Эта статья также доступна на следующих языках: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.