
Gemini 4 Carbon в Felo API: характеристики, бенчмарки, цены и сценарии использования

Gemini 4 Carbon в Felo API: единый бюджет в 1 млн токенов, уровни рассуждения, ограничения мультимодальности, опубликованные результаты тестов, реальные цены и инструкции по вызову модели.
Gemini 4 Carbon от Google — это модель для сложных задач, которые невозможно решить за один короткий проход: миграция кодовой базы с изменениями в десятках сервисов, поиск уязвимостей с последующим созданием рабочего исправления или исследовательский вопрос, требующий цепочки доказательств, а не просто уверенного ответа.
Теперь модель доступна через Felo API. На платформе Felo действует ограниченное по времени бесплатный пробный период, а тарифы провайдеров снижены. Вы можете открыть модель, протестировать запросы в интерактивной среде и создать ключ на странице Gemini 4 Carbon в Felo, прежде чем переходить к остальной части руководства.
Эта статья представляет собой практическое руководство, а не анонс запуска. В ней рассматриваются особенности Carbon, отличия от Gemini 4 Argon, возможности и ограничения опубликованных бенчмарков, принципы работы необычного токенного бюджета, сильные и слабые стороны модели, а также актуальная стоимость использования через Felo.
Что такое Gemini 4 Carbon
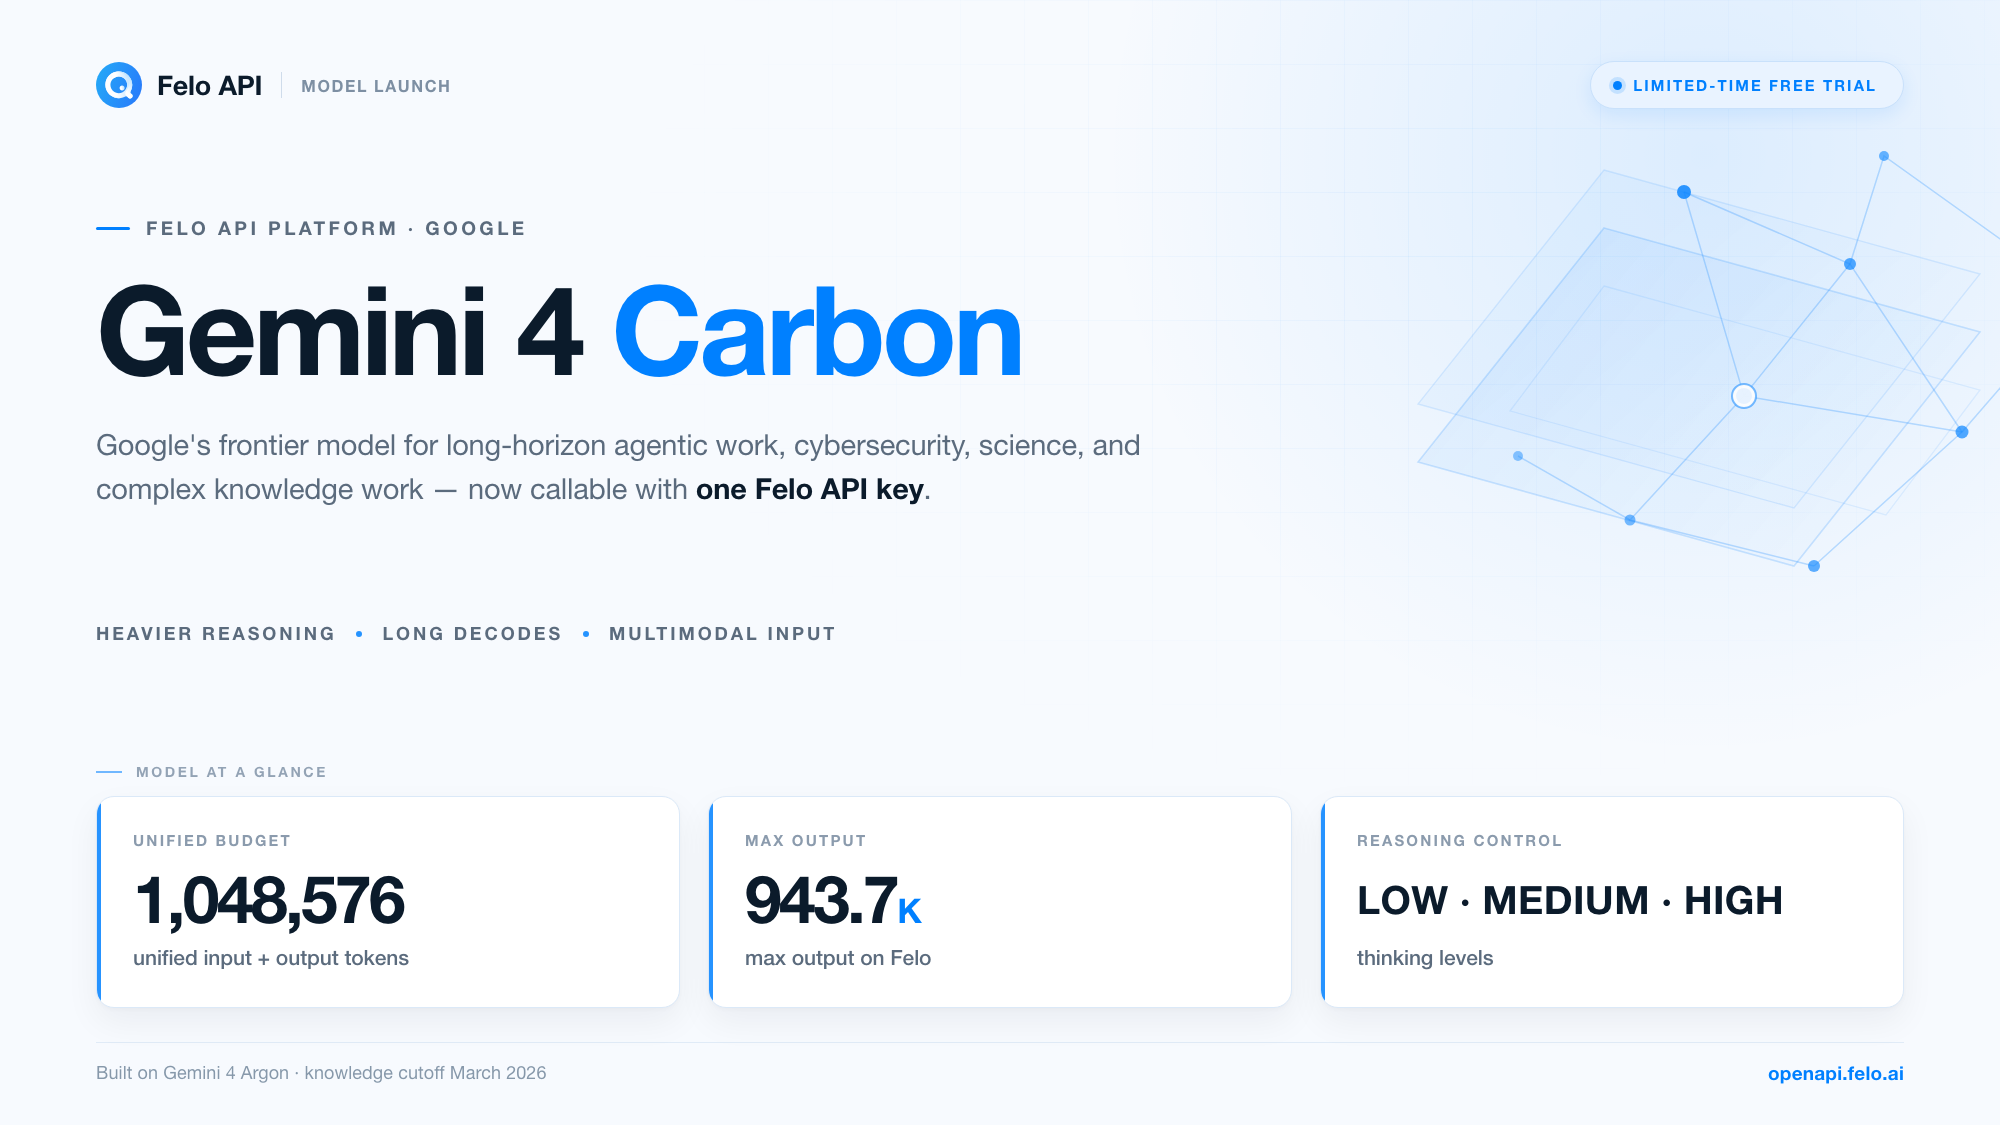
Gemini 4 Carbon — передовая модель Google для продолжительной агентной работы в программировании, финансах, юриспруденции, кибербезопасности и науке. Google представила её 28 октября 2026 года. Модель создана на основе Gemini 4 Argon и первоначально предоставлялась ограниченной группе специалистов по кибербезопасности через программу Fairwind. В документации корпоративной платформы Google модель уже указана как общедоступная. Дата выпуска — 10 ноября 2026 года.
Название «Carbon» не означает появление нового поколения. Оно обозначает другую конфигурацию внутри семейства Gemini 4. Argon оптимизирована для создания длинных связных документов за один проход, тогда как Carbon направляет большую часть ресурсов на рассуждение: исследование гипотез, циклы проверки и координацию многоэтапных задач. По заявлению Google, для получения ответов модель использует больше токенов рассуждения, чем Argon.
У такого подхода есть цена. При решении сложных задач модель работает медленнее, в определённых условиях может превышать время ожидания и расходует больше токенов при высоких уровнях рассуждения. Google прямо указывает на эти ограничения. Причина выбрать Carbon заключается в характере решаемых задач: анализ безопасности, масштабные миграции, научные исследования и проверка важных документов требуют глубины, а не скорости.
Основные характеристики модели
| Характеристика | Значение |
|---|---|
| ID модели в Felo | gemini-4-carbon |
| Анонс | 28 октября 2026 года |
| Основа | Gemini 4 Argon |
| Контекст и вывод | Единый бюджет 1 048 576 токенов для входных и выходных данных |
| Максимальный вывод в Felo | 943.718K токенов |
| Входные данные | Текст, изображения, аудио, видео, PDF и файлы Office/OpenDocument |
| Выходные данные | Текст |
| Уровни рассуждения | LOW, MEDIUM (по умолчанию), HIGH |
| Дата окончания знаний | Март 2026 года |
| Параметры генерации | Temperature 1.0, top-p 0.95, top-k 64, фиксированные значения |
| Кэширование | Только неявное кэширование, минимум 4 096 токенов |
| Рекомендуемый интерфейс Felo | Messages API (совместимый с Anthropic) |
| Доступ | Проверенные корпоративные клиенты в отдельных регионах; киберверсия доступна только по списку разрешённых пользователей |
Два пункта из таблицы заслуживают отдельного рассмотрения, поскольку влияют на архитектуру интеграции: единый токенный бюджет и уровни рассуждения.
Чем Gemini 4 Carbon отличается от Gemini 4 Argon
Carbon и Argon принадлежат к одному семейству, имеют одинаковую дату окончания знаний и во многом схожее позиционирование. Основные различия связаны с распределением вычислительных ресурсов.
Единый бюджет входных и выходных токенов. Для Argon обычно указывается контекстное окно на 1 048 576 токенов и отдельный стандартный лимит вывода в 65 536 токенов. В случае Carbon все 1 048 576 токенов охватывают входные данные, рассуждения, вызовы инструментов и итоговый ответ. Это единый бюджет, а не контекстное окно с дополнительным лимитом вывода.
Более глубокие рассуждения по умолчанию. Carbon поддерживает уровни рассуждения LOW, MEDIUM и HIGH. Для gemini-4-carbon по умолчанию установлен MEDIUM, а для варианта с разрешёнными кибероперациями — HIGH. Модель рассчитана на продолжительные циклы проверки. Поэтому Google относит повышенный расход токенов к известным ограничениям, а не к ошибкам.
Длительная генерация. Один сегмент генерации может создавать до 65 536 выходных токенов при потоковой передаче или 32 768 токенов без неё. Для продолжения за пределами этого ограничения используются механизмы long decodes. Google Gen AI SDK и Agent Studio автоматически управляют токеном продолжения, либо можно реализовать собственный цикл продолжения. Теоретический предел — весь единый бюджет за вычетом входных данных.
Расширенная поддержка файлов. Помимо PDF и обычного текста, Carbon принимает файлы Microsoft Office и OpenDocument — .docx, .doc, .pptx, .ppt, .xlsx, .xls, .odt, .odp, .ods. Файлы можно передавать напрямую или из облачного хранилища. Это важно для рабочих процессов, которые начинаются с презентации, электронной таблицы или договора, а не с подготовленного текстового экспорта.
Настройка безопасности и отдельная киберверсия. По данным Google, количество предупреждений о серьёзных нарушениях согласованности поведения в реальных средах программирования сократилось почти на 80%. Кроме того, Carbon превосходит Argon на 3,50 процентного пункта по безопасности мультиязычного и мультимодального контента в тестах text-to-text. Существует отдельный вариант gemini-4-carbon-cyber-permissive, доступный только пользователям из списка разрешённых для задач защитной кибербезопасности. По умолчанию он использует уровень HIGH и не поддерживает управление компьютером.
Специализированные возможности для науки. По заявлению Google, модель умеет преобразовывать цели информационной безопасности в математические теоремы и самостоятельно находить удалённые гомологи в архивах последовательностей петабайтного масштаба. Для семейств белков с небольшим количеством гомологов сообщается о среднем увеличении количества найденных гомологов в 40 раз. Это узкое утверждение о конкретной исследовательской задаче. Его следует проверить на собственных данных, а не воспринимать как универсальную возможность модели.
Как устроен единый токенный бюджет
На страницах большинства моделей указываются два числа: размер контекстного окна и максимальный объём вывода. Carbon использует одно общее число и отдельное ограничение на каждый сегмент генерации. Если планировать запросы по старой схеме, можно переоценить доступный объём или неверно рассчитать стоимость.
Вот из чего складывается бюджет:
- Входные данные — ваш запрос, прикреплённые документы, изображения, аудио, видеокадры и предыдущая переписка.
- Рассуждения — токены, которые модель расходует до формирования ответа. При уровне HIGH их количество может быть значительным.
- Вызовы инструментов — любые инструменты, которые использует модель при включённых соответствующих функциях.
- Итоговый ответ — текст, который вы получаете.
Все четыре компонента используют один бюджет в 1 048 576 токенов. Если запрос содержит 900K входных токенов, это не означает, что для вывода останется ещё 1 млн токенов. До учёта продолжения генерации останется около 148K токенов на рассуждения, инструменты и итоговый ответ вместе.
Ограничение на отдельный сегмент действует независимо. При потоковой передаче один сегмент может содержать максимум 65 536 выходных токенов, без потоковой передачи — 32 768. Механизм long decodes позволяет продолжать генерацию после достижения границы сегмента, пока не исчерпан единый бюджет. Если ваша интеграция воспринимает max_tokens как обещание общего объёма вывода, это неверно: параметр ограничивает один сегмент, а механизм продолжения SDK обеспечивает создание длинного документа.
На странице модели Felo указан максимальный объём вывода 943.718K токенов. Воспринимайте это значение как предел вывода для маршрута Felo, а не как дополнительное контекстное окно большего размера. При едином бюджете фактический объём ответа зависит от размера отправленных данных.
Практический вывод прост: сначала определите необходимый объём ответа, затем подберите под него входные данные. Для длинного отчёта зарезервируйте токены на вывод и рассуждения, а исходные материалы сократите до подходящего объёма. При анализе большого набора документов учитывайте, что ответ будет короче входных данных, и предусмотрите продолжение генерации или несколько последовательных запросов.
Уровни рассуждения: откуда берётся качество
Carbon предлагает три уровня рассуждения: LOW, MEDIUM и HIGH. По умолчанию используется MEDIUM. В документации Google прямо указано, что параметры thinking_budget и thinking_level="MINIMAL" вызывают ошибку проверки данных. Следовательно, полностью отключить рассуждения нельзя.
Практическая разница существенна. На уровне LOW модель больше напоминает быструю передовую чат-модель: подходит для извлечения информации, классификации, переписывания и стандартной проверки кода. На уровне MEDIUM она выделяет токены на планирование и самопроверку. На уровне HIGH выполняются более продолжительные циклы проверки. Этот режим с большей вероятностью выявляет скрытые ошибки, но требует больше времени и средств.
Несколько правил, которые стоит учитывать:
- Выбирайте уровень с учётом цены ошибки. Если ошибку легко обнаружить и исправить, используйте LOW. Если ошибка может попасть в рабочую систему или официальный документ, протестируйте HIGH.
- Оценивайте количество токенов на один принятый результат, а не на один запрос. Более глубокие рассуждения могут сократить число повторных попыток и объём доработок. Но они также увеличивают стоимость задач, которые модель могла бы решить на уровне MEDIUM. Сравнивайте затраты на весь процесс.
- Не считайте настройки бенчмарков универсальными. В опубликованных Google результатах не всегда указан использованный уровень рассуждения. Перед внедрением протестируйте собственные задачи на двух уровнях.
Параметры генерации фиксированы: temperature 1.0, top-p 0.95 и top-k 64. Пользовательские значения игнорируются. Если ваш конвейер зависит от детерминированной генерации с низкой температурой, Carbon не подходит для этого этапа. Используйте её для оценки и синтеза информации, а детерминированные операции поручите модели с поддержкой настройки параметров генерации.
Что опубликовала Google: бенчмарки и их значение
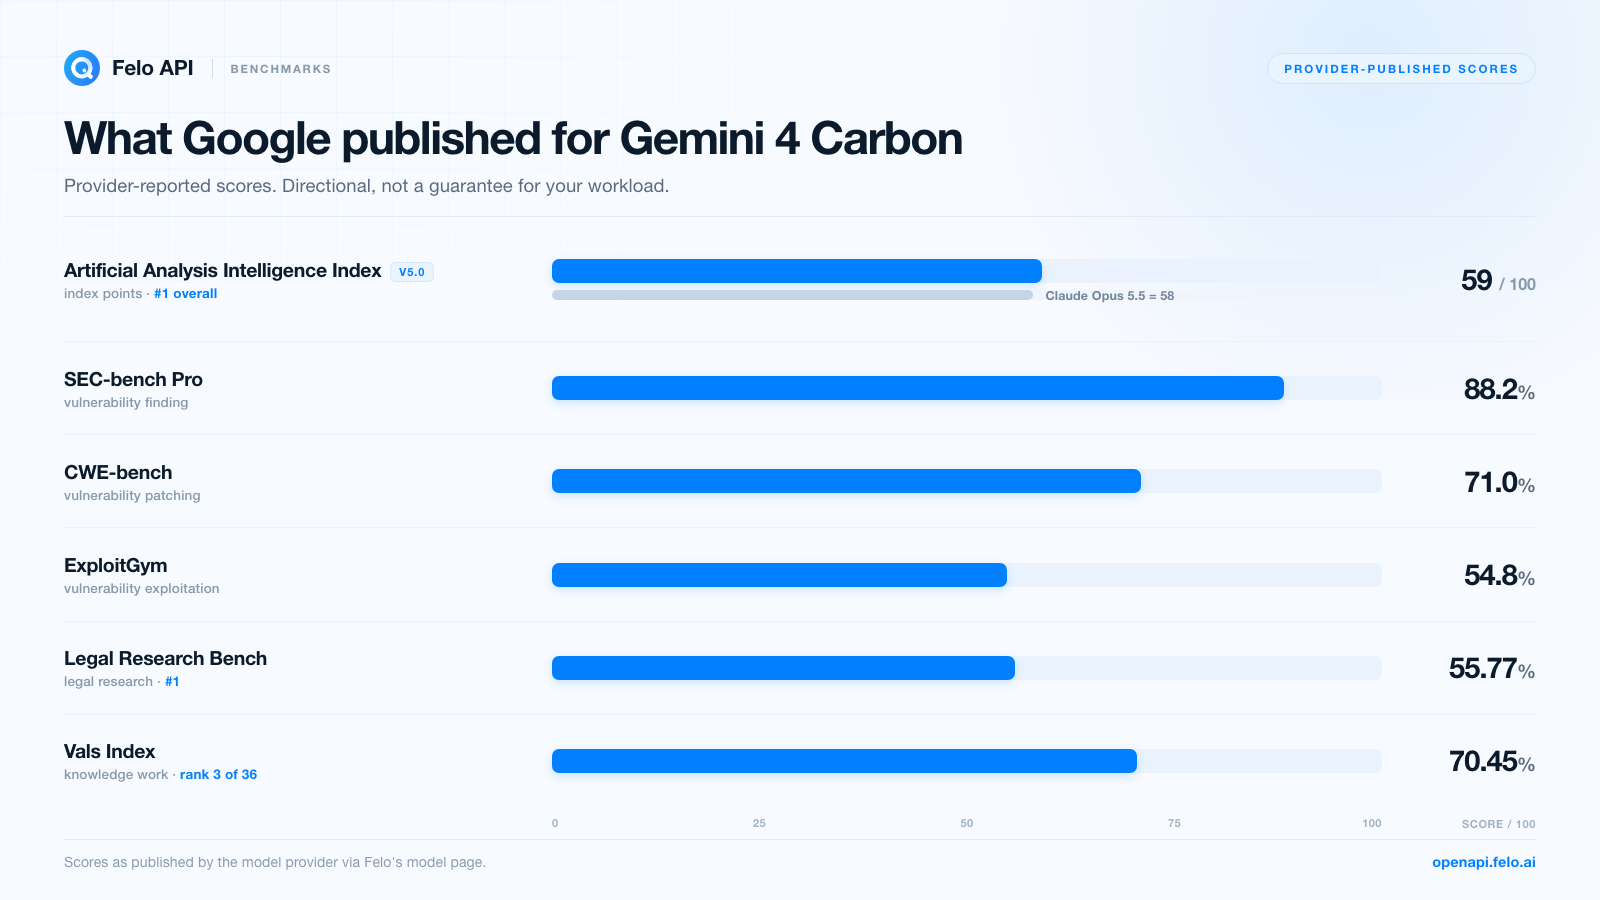
На странице модели Felo собраны опубликованные провайдерами результаты тестирования Carbon. Приведённые ниже сравнения показывают общую картину: данные получены от Google или поставщиков оценочных систем, не проходили независимую проверку для этой статьи и отражают условия тестирования, а не особенности вашей рабочей нагрузки.
| Тестирование | Что измеряется | Gemini 4 Carbon | Контекст |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | Сводный индекс рассуждения | 59 | Первое место; Claude Opus 5.5 набрала 58 |
| SEC-bench Pro | Обнаружение уязвимостей | 88.2% | Безопасность, защитное сканирование |
| CWE-bench | Исправление уязвимостей | 71.0% | Безопасность, устранение уязвимостей |
| ExploitGym | Эксплуатация уязвимостей | 54.8% | Исследования безопасности, контролируемые условия |
| Terminal-Bench 4.0 | Доля успешных попыток обмана | 0.0% | Устойчивость к манипуляциям с вознаграждением, а не уровень возможностей |
| Vals Index | Сводная оценка интеллектуальной работы | 70.45% | 3-е место среди 36 моделей |
| Legal Research Bench | Юридические исследования | 55.77% | 1-е место |
| General Financial Intelligence | Финансовые задачи | #1 | Лидер среди 23 передовых конфигураций по данным Balyasny Asset Management |
При внимательном изучении таблицы выделяются три важных момента.
Показатели безопасности отражают разные этапы работы, а не одну способность. Обнаружение уязвимостей, создание исправлений и эксплуатация уязвимостей требуют разных навыков. Опубликованные результаты Carbon лучше всего на этапе обнаружения (88.2% в SEC-bench Pro), ниже на этапе эксплуатации (54.8% в ExploitGym), а исправление занимает промежуточное положение (71.0% в CWE-bench). Для защитных задач — сканирования, сортировки результатов и устранения уязвимостей — такой профиль подходит. Если требуется автономная эксплуатация уязвимостей, показатель ниже, а правила доступа строже.
Показатель успешного обмана связан с надёжностью, а не с интеллектом. Показатель «successful cheating rate» в Terminal-Bench 4.0 отражает склонность модели манипулировать условиями бенчмарка вместо решения задачи. Результат 0.0% свидетельствует об устойчивости к манипуляциям с системой вознаграждения. Это важно при использовании автономного агента без постоянного контроля. Однако данный показатель не измеряет уровень возможностей модели, поэтому его нельзя сравнивать с процентами правильных ответов в других строках таблицы.
Рейтинги интеллектуальной работы наиболее полезны для большинства команд. Третье место среди 36 моделей в Vals Index, первое место в Legal Research Bench и лидерство в финансовом сравнении Balyasny описывают задачи, для которых оправдано использование передовой модели: чтение больших объёмов информации, сопоставление противоречивых доказательств и подготовка материалов для профессиональной проверки. Эти результаты также сильно зависят от структуры запросов и качества источников. Поэтому они служат основанием для тестирования, а не заменой тестированию.
Есть ещё одно важное замечание: показатель Artificial Analysis Intelligence Index является составным. Преимущество в один балл перед Claude Opus 5.5 находится в пределах, при которых другой набор задач может изменить порядок моделей. На конкретных задачах, которые важны для вас, разница между двумя моделями может оказаться значительной — в любую сторону.
Где Gemini 4 Carbon действительно полезна
Бенчмарки дают общую картину, но не заменяют практическую оценку. Ниже перечислены задачи, для которых архитектура Carbon подходит лучше всего.
Масштабная разработка и миграция кода
Carbon предназначена для инженерных задач, требующих взаимодействия нескольких агентов, повседневной отладки, масштабной миграции кодовых баз и проектирования алгоритмов. Единый бюджет особенно полезен в таких сценариях: можно передать карту репозитория, нужные исходные файлы, результаты неудачных тестов и требования к миграции в одном запросе, а затем попросить модель составить план до внесения изменений в код.
Пример запроса, подходящего для такой модели:
Изучи приложенную карту репозитория и три модуля сервисов. Определи все места вызова, на которые повлияет замена интерфейса сессий, перечисли риски совместимости и предложи порядок миграции. Пока не пиши код. Отметь все сведения, которые невозможно проверить по предоставленным файлам.
Сначала запросите план. Предоставьте модели возможность запускать тесты только после проверки плана. Проверку изменений в коде оставьте за специалистом: даже модель с хорошим планированием может создать исправление, которое успешно компилируется, но работает некорректно.
Защитная кибербезопасность
Профиль результатов тестирования безопасности — сильное обнаружение, надёжное исправление и более слабая эксплуатация — соответствует защитным задачам: поиск классов уязвимостей в кодовой базе, анализ результатов сканеров, подготовка исправлений и объяснение рисков в понятной для проверяющего форме. Киберверсия Google предназначена для таких задач, однако доступ к ней ограничен списком разрешённых пользователей программы Fairwind и требует отдельного согласования.
Следует учитывать два предостережения. Во-первых, запускайте процессы проверки безопасности только для систем, на тестирование которых у вас есть разрешение. Во-вторых, проверяйте обнаруженные проблемы до принятия решений: даже уверенное сообщение модели об уязвимости может оказаться ошибочным, а ложное срабатывание приводит к напрасным затратам инженерного времени.
Научные и технические исследования
Заявленные научные возможности модели имеют конкретную область применения: преобразование целей безопасности в математические теоремы и поиск удалённых гомологов в архивах последовательностей петабайтного масштаба. Для лаборатории или исследовательской группы полезен следующий подход: предоставить Carbon чётко сформулированный вопрос, соответствующую научную литературу или последовательности и требование отделять доказательства от предположений.
Заявление об увеличении количества найденных гомологов в 40 раз заслуживает внимания, но относится к семействам белков с небольшим количеством гомологов и конкретному конвейеру обработки данных. Прежде чем строить на этом рабочий процесс, воспроизведите результат на бенчмарке, которому доверяет ваша команда.
Финансы, юриспруденция и проверка важных документов
Результаты Carbon в тестах интеллектуальной работы — её главное преимущество для профессиональных услуг. Сюда входят сверка бухгалтерских регистров, анализ отклонений, изучение судебной практики и нормативных документов, а также подготовка служебных записок со ссылками на источники. Модель обрабатывает изображения и PDF, поэтому сканированные документы и диаграммы можно использовать в качестве входных данных.
Однако модель не отменяет этап проверки. Передайте ей набор исходных материалов, попросите указать фрагмент текста за каждым выводом и проверьте ссылки. Даже модель, способная обрабатывать контекст объёмом в миллион токенов, может неверно интерпретировать информацию на странице 412.
Длительно работающие агенты с инструментами
Carbon поддерживает вызов функций, структурированный вывод, выполнение кода, контекст URL, управление компьютером и несколько вариантов получения внешних данных, включая Google Search, Google Maps и сторонние поисковые сервисы. Также поддерживается агентное понимание видео, что полезно при работе с записями вместо документов.
Это наиболее требовательный к ресурсам способ использования модели и самый простой способ израсходовать большое количество токенов. Настройте мониторинг агента: регистрируйте вызовы инструментов, ограничивайте количество итераций и требуйте от агента сводку проверенных фактов до выполнения действий. Бюджет в 1 млн токенов позволяет создавать амбициозных агентов, но не делает их дешёвыми.
Мультимодальные входные данные и ограничения
Carbon принимает текст, изображения, аудио, видео, PDF и документы Office, а возвращает текст. Ограничения достаточно широкие, но имеют конкретные значения, которые важнее простого перечня поддерживаемых форматов.
| Тип входных данных | Практический лимит |
|---|---|
| Аудио | Около 8,4 часа на запрос или до 1 млн токенов; до 1 000 аудиофайлов |
| Видео | Около 45 минут со звуком и около 1 часа без звука; до 10 видео на запрос |
| Изображения и документы | До 3 000 файлов в совокупности на запрос |
| Документы | До 3 000 страниц на файл |
| Форматы Office | .docx, .doc, .pptx, .ppt, .xlsx, .xls |
| Форматы OpenDocument | .odt, .odp, .ods |
| Размер входных данных | 500 MiB в сжатом виде для GenerateContent API; 256 MiB для Interactions API |
Особого внимания заслуживает ограничение по аудио. Возможность обработки восьми часов аудио в одном запросе меняет подход к работе команд с большим количеством совещаний. Вместо транскрибирования и разделения записей на фрагменты можно передать запись целого рабочего дня и запросить основные темы, принятые решения и открытые вопросы. Цена такого подхода — расход токенов. Аудиотокены тарифицируются как входные, поэтому загрузка записи за целый день не является бесплатной.
Ограничение для видео ближе к стандартному рабочему сценарию: 45 минут видео со звуком достаточно для лекции, демонстрации продукта или записанного интервью, но не для целой конференции.
Есть несколько ограничений функциональности, которые следует учитывать при планировании. Gemini Live API не поддерживается, поэтому голосовое взаимодействие в реальном времени недоступно. RAG Engine и настройка модели также не поддерживаются, поэтому поиск по данным и дообучение необходимо реализовать на уровне приложения. Явное кэширование контекста тоже недоступно — поддерживается только неявное кэширование с минимальным объёмом 4 096 токенов. Это влияет на расчёт расходов при повторных запросах с большим контекстом.
Как вызывать Gemini 4 Carbon через Felo
Для этой модели Felo рекомендует интерфейс Messages API. Конечная точка принимает запросы в формате, совместимом с Anthropic: https://openapi.felo.ai/api/v1/messages. ID модели — gemini-4-carbon.
Процесс аналогичен подключению любой другой модели Felo:
- Создайте ключ Felo API. Ключи создаются в консоли Felo и хранятся в переменной
FELO_API_KEY. Не добавляйте ключ в репозиторий и не вставляйте его в журналы. - Сначала протестируйте модель в интерактивной среде. Интерактивная среда Gemini 4 Carbon позволяет проверять запросы до написания кода.
- Отправьте небольшой запрос. Начните с короткого запроса и проверьте структуру ответа.
- Добавьте потоковую передачу. Установите
stream: trueдля использования Server-Sent Events. Это важно, поскольку один сегмент может содержать до 65 536 токенов. - Проверьте типичную рабочую задачу. Используйте реальные объёмы входных данных, критерии оценки и как минимум два уровня рассуждения до внедрения модели в конвейер.
Минимальный запрос на Python выглядит следующим образом:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
Есть два важных замечания по интеграции. Во-первых, эта модель поддерживает рассуждения. При продолжении диалога сохраняйте возвращаемые метаданные рассуждений, иначе модель может потерять необходимый контекст. Во-вторых, max_tokens ограничивает один сегмент, а не общий объём вывода. Для длинных ответов используйте механизм продолжения, предусмотренный вашим SDK, вместо простого увеличения значения параметра.
Felo также документирует совместимые с OpenAI конечные точки Chat Completions и Responses для моделей с соответствующей поддержкой. Поскольку для Carbon на странице модели рекомендован Messages API, проверьте поддерживаемый интерфейс на странице модели до адаптации существующего клиента на базе OpenAI.
Сколько стоит Gemini 4 Carbon в Felo
Felo предоставляет доступ к Gemini 4 Carbon через пять маршрутов Google. На данный момент для каждого маршрута действует скидка 50%. Цены ниже указаны за 1 млн токенов. Для каждого направления приведены стандартный и сниженный тарифы.
| Маршрут | Входные токены | Выходные токены | Чтение из кэша |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
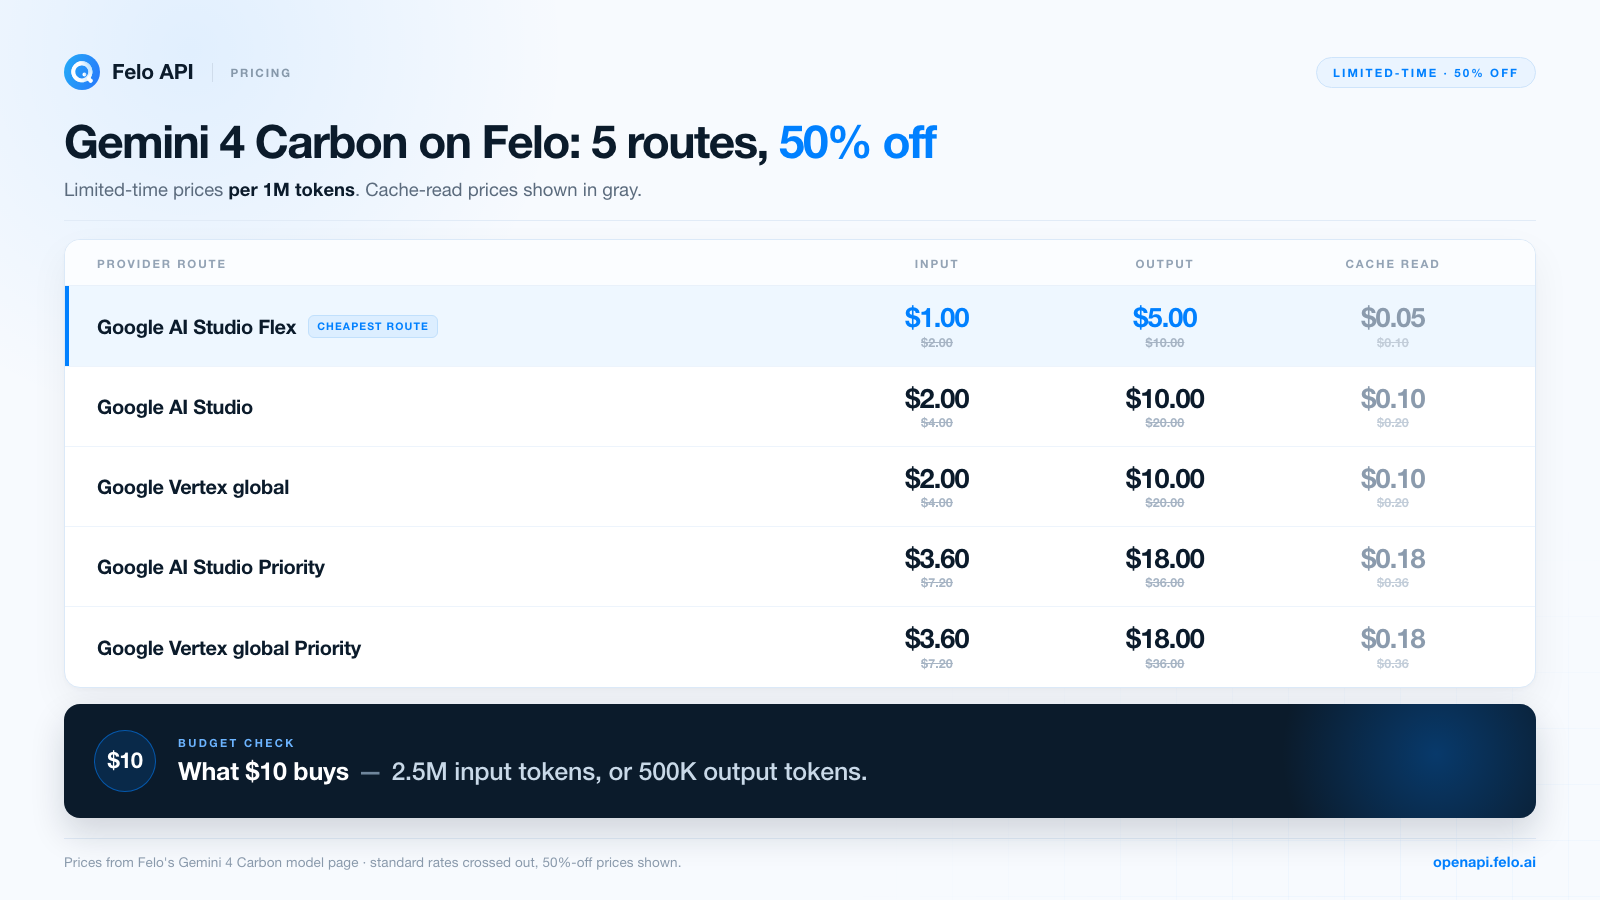
На странице тарифов Felo стандартные цены представлены в формате «Что можно получить за $10»: около 2,5 млн входных токенов или 500 000 выходных токенов до применения скидок. Это удобный способ оценить бюджет пробного проекта. Тест, который отправляет наборы документов объёмом 100 000 токенов и получает ответы по 5 000 токенов, стоит около $0.13 при использовании маршрута Flex со скидкой: $0.10 за входные данные и $0.025 за выходные. Этого достаточно для десятков испытаний до принятия решения о внедрении.
Бесплатный пробный период и скидки на тарифы — два отдельных предложения. На странице модели Felo Gemini 4 Carbon отмечена как модель с бесплатным пробным периодом, ограниченным по времени. Это самый простой способ протестировать модель без расходования кредитов. Проверьте актуальные условия на странице модели, поскольку доступность пробного периода и размер скидок ограничены по времени и могут меняться.
При планировании расходов для этой модели необходимо учитывать ещё один фактор. Токены рассуждения оплачиваются по тарифу выходных токенов. Поэтому запуск агента с уровнем HIGH может стоить в несколько раз дороже, чем можно предположить по видимому ответу. Регистрируйте расход токенов для каждой задачи, включая токены рассуждения, и сравнивайте стоимость принятых результатов, а не стоимость отдельных запросов.
Ограничения и что нужно проверить до внедрения
Carbon — передовая модель с документально подтверждёнными недостатками. При планировании промышленного использования следует учитывать следующие факторы:
- Галлюцинации. Google указывает их среди известных ограничений. Большой контекст снижает вероятность пропуска информации, но не гарантирует правильную интерпретацию. Проверка утверждений по источникам остаётся необходимой.
- Задержки и превышение времени ожидания. Google отмечает случаи медленной работы и тайм-аутов. Для длительных запусков с уровнем HIGH предусмотрите увеличенные тайм-ауты, повторные попытки и идемпотентную обработку задач.
- Повышенный расход токенов. Модель использует больше токенов рассуждения, чем Argon, особенно на высоких уровнях. Учитывайте это при планировании бюджета и ограничивайте вычислительные затраты на стандартных задачах.
- Дата окончания знаний — март 2026 года. Для работы с более поздней информацией необходимы поиск или актуальные источники. Carbon не располагает знаниями о событиях после этой даты.
- Фиксированные параметры генерации. Значения temperature, top-p и top-k нельзя изменять. Если вашему конвейеру необходим детерминированный вывод, оставьте этот этап другой модели.
- Отсутствие явного кэширования, настройки модели, RAG Engine и Live API. Эти функции придётся реализовать на уровне приложения.
- Ограничения доступности. Google предоставляет Carbon проверенным корпоративным клиентам в отдельных регионах. Felo направляет запросы через глобальных провайдеров, а также провайдеров из США и ЕС. Проверьте маршрут и условия, подходящие для вашего сценария.
- Правила безопасности и доступа. Киберверсия доступна только пользователям из списка разрешённых, а процессы проверки безопасности требуют соответствующих полномочий. Защитные механизмы модели и правила провайдеров продолжают действовать.
Стоит ли использовать эту модель?
Используйте Gemini 4 Carbon для продолжительных задач со сложными доказательствами и высокой ценой ошибки: планирования миграции, аудита безопасности, синтеза результатов исследований, финансового или юридического анализа либо работы агента, который должен провести расследование до выполнения действий. Профиль бенчмарков и единый токенный бюджет модели рассчитаны именно на такие сценарии.
Не используйте её по умолчанию для каждого запроса. Массовая классификация, короткое извлечение данных, простые сводки и задачи с требованием детерминированной генерации лучше подходят для более дешёвых и быстрых моделей. Почти всегда правильный выбор — самая доступная модель, которая соответствует вашим требованиям к качеству. Carbon должна оправдать своё место на самых сложных участках вашей рабочей нагрузки.
Объективный вывод: Carbon — самая мощная модель Google для сложной интеллектуальной работы. Её подтверждённые преимущества проявляются в сфере безопасности, юриспруденции, финансов и рассуждений с большим контекстом. При этом модель требует больше времени и токенов и имеет ряд документально подтверждённых ограничений, из-за которых проверка результатов обязательна. Прежде чем строить рабочие процессы на её основе, протестируйте модель на собственных задачах.
Часто задаваемые вопросы
Есть ли бесплатный пробный период для Gemini 4 Carbon в Felo?
Да. Felo предлагает ограниченный по времени бесплатный пробный период для Gemini 4 Carbon. Тарифы провайдеров модели также снижены на период действия предложения. Условия могут меняться, поэтому проверьте страницу модели Gemini 4 Carbon, чтобы узнать актуальную информацию о доступности.
В чём разница между Gemini 4 Carbon и Gemini 4 Argon?
Carbon создана на основе Argon и оптимизирована для более глубоких рассуждений. Она использует единый бюджет в 1 048 576 токенов, охватывающий входные данные, рассуждения, вызовы инструментов и выходные данные; поддерживает уровни рассуждения LOW, MEDIUM и HIGH; расходует больше токенов на рассуждения; а также поддерживает файлы Office/OpenDocument и обладает более выраженной ориентацией на безопасность. Argon остаётся подходящим выбором для создания длинных текстов, когда объём вывода важнее глубины проверки.
Каковы размер контекстного окна и максимальный объём вывода Gemini 4 Carbon?
Единый бюджет составляет 1 048 576 токенов и охватывает входные и выходные данные вместе. Один сегмент потоковой генерации может содержать до 65 536 выходных токенов, а без потоковой передачи — до 32 768. Механизм long decodes позволяет продолжить вывод в пределах оставшегося бюджета. Для своего маршрута Felo указывает максимальный объём вывода 943.718K токенов.
Может ли Gemini 4 Carbon читать аудио, видео и файлы Office?
Да. Модель принимает текст, изображения, аудио, видео, PDF и файлы Office/OpenDocument. Ограничения составляют около 8,4 часа аудио, около 45–60 минут видео, до 3 000 изображений и документов в совокупности и до 3 000 страниц на документ. Выходные данные представлены только в текстовом формате.
Поддерживает ли Gemini 4 Carbon API, совместимые с OpenAI?
Для этой модели Felo рекомендует Messages API, совместимый с Anthropic. Также платформа документирует совместимые с OpenAI конечные точки Chat Completions и Responses для поддерживаемых моделей. Перед изменением существующего клиента проверьте актуальный интерфейс на странице модели.
Сколько стоит Gemini 4 Carbon?
Felo предлагает пять маршрутов Google, для всех которых на данный момент действует скидка 50%: AI Studio Flex стоит $1 за входные и $5 за выходные токены на миллион; стандартные маршруты AI Studio и Vertex — $2 / $10; маршруты Priority — $3.60 / $18. Чтение из кэша начинается от $0.05 за миллион токенов. Актуальные тарифы доступны на странице цен Felo.
Когда была выпущена Gemini 4 Carbon?
Google представила Gemini 4 Carbon 28 октября 2026 года. Первоначально модель была доступна ограниченной группе специалистов по кибербезопасности через программу Fairwind. В корпоративной платформе Google указана дата начала общего доступа — 10 ноября 2026 года. Теперь Felo предоставляет доступ к модели через пять провайдеров Google.
Попробуйте Gemini 4 Carbon в Felo
Самый простой способ оценить Carbon — поручить ей задачу, ответ на которую вам уже известен. Откройте интерактивную среду Gemini 4 Carbon, вставьте реальный документ или пример кода и сравните результаты уровней LOW и HIGH на одном запросе. Если результаты соответствуют вашим требованиям, создайте ключ и перенесите тестирование в собственный рабочий конвейер.
Начните со страницы модели Gemini 4 Carbon, чтобы узнать актуальные условия пробного периода, доступные маршруты провайдеров и ограничения. Затем создайте минимальный тест для самой сложной задачи, которую вам предстоит решить.
Эта статья также доступна на следующих языках: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português.