Discriminative AI: โมเดลการตัดสินใจ ตัวอย่าง และการใช้งาน

เรียนรู้ว่า Discriminative AI และโมเดลการตัดสินใจใช้จำแนก จัดเส้นทาง และให้คะแนนข้อมูลนำเข้าอย่างไร แตกต่างจาก Generative AI ในด้านใด และนักพัฒนาสามารถนำไปใช้ในงานประเภทใดได้บ้าง
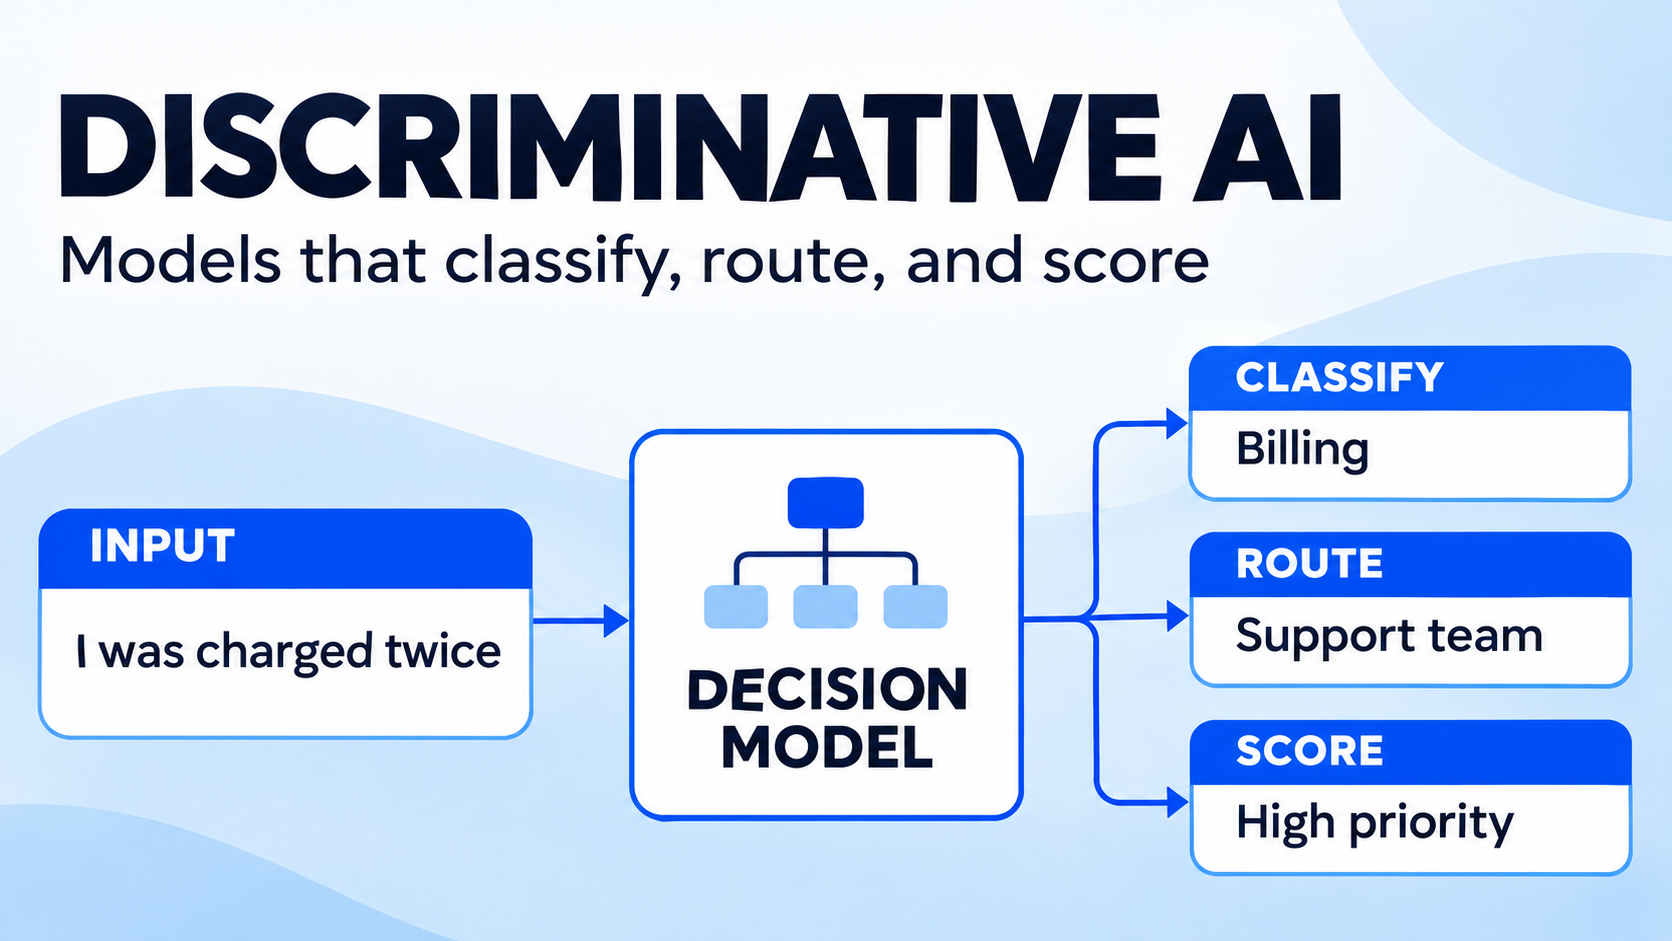
มีคำขอความช่วยเหลือเข้ามา: “ฉันถูกเรียกเก็บเงินสองครั้งและต้องการขอเงินคืน” แอปพลิเคชันของคุณอาจไม่จำเป็นต้องให้โมเดล AI สร้างข้อความตอบกลับเป็นย่อหน้า สิ่งแรกที่ระบบอาจต้องทำคือการตัดสินใจว่า ควรส่งคำร้องนี้ไปยังฝ่ายเรียกเก็บเงิน ฝ่ายสนับสนุนด้านเทคนิค หรือฝ่ายขาย
Discriminative AI ได้รับการออกแบบมาเพื่อคาดการณ์ป้ายกำกับ คะแนน หรือผลลัพธ์เป้าหมายอื่นจากข้อมูลนำเข้า โมเดลการตัดสินใจกลุ่มใหม่ได้นำแนวคิดนี้มาสู่ API สำหรับนักพัฒนา โดยส่งบริบทและคำถามที่กำหนดไว้ให้โมเดล จากนั้นโมเดลจะส่งผลการตัดสินใจหรือค่าความน่าจะเป็นในรูปแบบที่มีโครงสร้าง ซึ่งซอฟต์แวร์สามารถนำไปใช้งานได้ คู่มือนี้จะอธิบายหลักการทำงานของโมเดลเหล่านี้ ตำแหน่งการใช้งานเมื่อทำงานร่วมกับ Generative AI และวิธีประเมินประสิทธิภาพ
Discriminative AI คืออะไร?
Discriminative AI ใช้คาดการณ์คุณสมบัติบางอย่างจากข้อมูลนำเข้า ตัวกรองสแปมจะคาดการณ์ว่าอีเมลเป็นสแปมหรือไม่ โมเดลจำแนกประเภทจะกำหนดทีมที่รับผิดชอบคำร้องขอความช่วยเหลือ ส่วนโมเดลประเมินความเสี่ยงจะคำนวณความเป็นไปได้ของผลลัพธ์ที่กำหนดไว้
ในแมชชีนเลิร์นนิง โมเดลแบบ Discriminative มักเรียนรู้การจับคู่จากข้อมูลนำเข้า x ไปยังผลลัพธ์เป้าหมาย y หรือประเมินความน่าจะเป็นแบบมีเงื่อนไข P(y | x) ผลลัพธ์เป้าหมายอาจเป็นประเภทข้อมูล ค่าตัวเลข หรือผลลัพธ์รูปแบบมีโครงสร้างประเภทอื่น ตัวอย่างของแนวทาง Discriminative ได้แก่ Logistic Regression, Support Vector Machines และ Neural Classifiers หลายประเภท ทั้งนี้ โมเดล Discriminative ไม่ใช่ทุกตัวที่ส่งค่าความน่าจะเป็น และคะแนนตัวเลขก็ไม่ได้ผ่านการปรับเทียบที่เหมาะสมทุกกรณี
แนวคิดพื้นฐานนี้มีมาก่อนยุคผู้ช่วย AI ในปัจจุบัน สิ่งใหม่คือการมี API สำหรับการตัดสินใจแบบอเนกประสงค์ ซึ่งรองรับคำอธิบายงานและตัวเลือกคำตอบในภาษาธรรมชาติ นักพัฒนาจึงสามารถใช้ส่วนติดต่อแบบเดียวกันกับงานจำแนกประเภทหรือประเมินคะแนนได้หลายรูปแบบ
AI Decision Model คืออะไร?
ในระบบนิเวศ API ปัจจุบัน Decision Model โดยทั่วไปหมายถึงโมเดลหรือบริการที่ออกแบบมาเพื่อตอบคำถามที่มีขอบเขตชัดเจนจากข้อมูลนำเข้าที่กำหนดให้ แทนการสร้างคำตอบแบบอิสระ โมเดลจะส่งผลลัพธ์ตามประเภทข้อมูล เช่น
- ความน่าจะเป็นแบบใช่/ไม่ใช่: ข้อความนี้มีแนวโน้มเป็นคำขอคืนเงินมากน้อยเพียงใด?
- ตัวเลือก: ควรส่งคำร้องนี้ไปยังแผนกใด?
- คะแนน: คำตอบนี้อยู่ในระดับใดตามเกณฑ์ประเมินคุณภาพที่กำหนดไว้?
ตัวอย่างเช่น Decision Model อาจส่งป้ายกำกับว่าเป็นเรื่องการเรียกเก็บเงิน พร้อมค่าประมาณความน่าจะเป็นของแต่ละแผนก แอปพลิเคชันของคุณสามารถใช้ผลลัพธ์เหล่านี้เพื่อส่งคำร้องไปยังแผนกที่เกี่ยวข้อง ขอข้อมูลเพิ่มเติม หรือส่งต่อให้เจ้าหน้าที่ตรวจสอบ
TypeSafe เรียกโมเดลในตระกูล Jev ว่าโมเดล “System One” ส่วน Liquid AI อธิบาย d1 decision model ว่าเป็นโมเดลที่รับข้อมูลข้อความและรูปภาพ พร้อมส่งค่าความน่าจะเป็นกลับมาโดยไม่สร้าง Output Tokens ส่วน Google Codelab เกี่ยวกับ Discriminative Models แสดงตัวอย่างการใช้ Decision Model ร่วมกับ Generative Model ภายในแอปพลิเคชัน
คำศัพท์เหล่านี้มีความเกี่ยวข้องกัน แต่ไม่สามารถใช้แทนกันได้ Discriminative Modeling เป็นแนวคิดกว้างในสาขาแมชชีนเลิร์นนิง ส่วน Decision Model เป็นผลิตภัณฑ์หรือส่วนติดต่อสำหรับการตัดสินใจที่มีขอบเขตชัดเจน Generative Model ก็สามารถจำแนกข้อความผ่านคำสั่ง Prompt ได้เช่นกัน แม้ว่ากระบวนการสร้างผลลัพธ์และรูปแบบการตอบกลับภายในจะแตกต่างกัน
Discriminative AI กับ Generative AI
| Discriminative AI | Generative AI | |
|---|---|---|
| คำถามที่พบบ่อย | “ข้อมูลนำเข้านี้ตรงกับหมวดหมู่ใด?” | “ควรสร้างคำตอบหรือเนื้อหาอะไร?” |
| ผลลัพธ์ที่พบได้ทั่วไป | ป้ายกำกับ การคาดการณ์ คะแนน หรือความน่าจะเป็น | ข้อความ โค้ด รูปภาพ เสียง หรือเนื้อหาที่สร้างขึ้น |
| ตัวอย่างงาน | จัดเส้นทางคำร้องของลูกค้า | ร่างข้อความตอบกลับลูกค้า |
| จุดแข็งที่ควรประเมิน | การตัดสินใจตามขอบเขตที่กำหนด ความสม่ำเสมอ และคะแนนที่นำไปใช้งานได้ | การสังเคราะห์ข้อมูล คำอธิบาย และการสร้างเนื้อหาที่ยืดหยุ่น |
| ประเด็นหลักในการประเมิน | ข้อผิดพลาดในการจำแนก การปรับเทียบ และเกณฑ์การตัดสิน | ความถูกต้อง การทำตามคำสั่ง ความปลอดภัย และประโยชน์ในการใช้งาน |
ขอบเขตระหว่างโมเดลทั้งสองไม่ได้หมายความว่าโมเดลหนึ่งสามารถทำงานได้เพียงประเภทเดียว LLM สามารถส่งป้ายกำกับในรูปแบบ JSON ได้ และระบบการตัดสินใจก็สามารถใช้ Generative Model เป็นส่วนหนึ่งของเวิร์กโฟลว์ขนาดใหญ่ได้ ความแตกต่างในทางปฏิบัติอยู่ที่เป้าหมายการปรับแต่งและหน้าที่ของแต่ละองค์ประกอบ การตอบกลับผ่าน API ในรูปแบบที่มีโครงสร้างเพียงอย่างเดียว ไม่ได้ยืนยันว่าค่าความน่าจะเป็นผ่านการปรับเทียบ หรือโมเดลพื้นฐานเป็นโมเดลแบบ Discriminative
ลองพิจารณาคำร้องขอคืนเงินข้างต้น Decision Model สามารถระบุปัญหาว่าเกี่ยวข้องกับการเรียกเก็บเงินและประเมินระดับความเร่งด่วน ส่วน Generative Model สามารถร่างข้อความตอบกลับด้วยน้ำเสียงที่เข้าใจลูกค้า โดยอ้างอิงนโยบายการคืนเงินที่เกี่ยวข้อง อย่างไรก็ตาม แอปพลิเคชันยังต้องตรวจสอบนโยบาย สิทธิ์การใช้งาน และข้อกำหนดด้านการอนุมัติจากเจ้าหน้าที่ก่อนดำเนินการ
Decision Model ทำงานในแอปพลิเคชันอย่างไร
โครงสร้างข้อมูลจะแตกต่างกันตามผู้ให้บริการ แต่คำขอสำหรับการตัดสินใจทั่วไปประกอบด้วยข้อมูลสามส่วน:
- State: ข้อมูลที่ต้องการประเมิน เช่น ข้อความในคำร้องหรือรูปภาพ
- Question and Criteria: การตัดสินใจที่ต้องการ พร้อมคำอธิบายคำตอบที่อนุญาตหรือระดับคะแนน
- Typed Response: ป้ายกำกับ คะแนน หรือการกระจายความน่าจะเป็นที่ส่งกลับมาให้แอปพลิเคชันนำไปประมวลผล
ตัวอย่าง:
State: "I was charged twice for my subscription."
Question: Which team should handle this request?
Options: billing, technical support, sales
Illustrative result: billing
นี่เป็นตัวอย่างเชิงแนวคิด ไม่ใช่การตอบกลับจาก API จริง โมเดลอาจส่งค่าความเชื่อมั่นหรือค่าความน่าจะเป็นเพิ่มเติม ทั้งนี้ขึ้นอยู่กับ Endpoint โปรดอ้างอิงเอกสารของโมเดลและ API ที่ใช้งาน แทนการสันนิษฐานว่าผู้ให้บริการทุกรายใช้รูปแบบคำขอเดียวกันหรือรองรับข้อมูลทุกประเภท
คะแนนความน่าจะเป็นหมายถึงอะไร?
ค่าความน่าจะเป็นจากการคาดการณ์จะมีประโยชน์เมื่อคุณเข้าใจความน่าเชื่อถือของค่านั้น หากระบบกำหนดค่า 0.8 ให้กับการคาดการณ์ที่มีลักษณะคล้ายกันจำนวนมาก ระบบที่ผ่านการปรับเทียบที่ดีควรมีความถูกต้องประมาณ 80% เมื่อประเมินผลจากกลุ่มข้อมูลดังกล่าว คะแนน 0.8 เพียงค่าเดียวไม่ได้รับประกันว่าการตัดสินใจรายกรณีจะถูกต้อง
ตรวจสอบการปรับเทียบกับข้อมูลของคุณเอง โดยเฉพาะหลังเปลี่ยนโมเดล ป้ายกำกับ ภาษา หรือแหล่งข้อมูลนำเข้า คุณสามารถใช้เกณฑ์คะแนนเพื่อส่งกรณีที่มีความเชื่อมั่นต่ำไปตรวจสอบ แต่ควรกำหนดเกณฑ์ตามต้นทุนของผลบวกลวงและผลลบลวง คิวตรวจสอบการฉ้อโกงกับระบบแนะนำเนื้อหาที่ไม่มีความเสี่ยงต้องใช้กฎคนละชุด
ตัวอย่างและกรณีการใช้งาน Discriminative AI
การจำแนกและจัดเส้นทางคำร้องขอความช่วยเหลือ
Decision Model สามารถกำหนดหมวดหมู่ข้อความที่เข้ามาเป็นฝ่ายเรียกเก็บเงิน ฝ่ายสนับสนุนด้านเทคนิค หรือฝ่ายจัดการบัญชี เพิ่มเส้นทาง “อื่น ๆ” หรือ “ต้องตรวจสอบ” สำหรับคำร้องที่มีความคลุมเครือ และทดสอบข้อความที่มีหลายปัญหาอยู่ในคำร้องเดียว ประเมินอัตราข้อผิดพลาดแยกตามหมวดหมู่ ไม่ใช่ดูเฉพาะความแม่นยำโดยรวม เพราะโมเดลที่พลาดคำร้องเกี่ยวกับการเรียกเก็บเงินที่เร่งด่วนอาจยังมีคะแนนดีเมื่อชุดข้อมูลส่วนใหญ่เป็นคำถามทั่วไป
การกลั่นกรองเนื้อหา
เวิร์กโฟลว์การกลั่นกรองสามารถใช้คำถามว่าเนื้อหาอยู่ในหมวดหมู่นโยบายที่กำหนดไว้หรือไม่ ระบุเกณฑ์และตัวอย่างให้โมเดลเข้าใจ ประเมินกรณีที่มีความซับซ้อน และส่งกรณีที่ไม่แน่ชัดหรือมีผลกระทบสูงให้ผู้ตรวจสอบที่ผ่านการฝึกอบรม คะแนนการตัดสินใจเป็นเพียงข้อมูลประกอบกระบวนการกำหนดนโยบาย ไม่ใช่หลักฐานยืนยันว่าเนื้อหาละเมิดกฎ
การจัดเส้นทาง LLM และ Agent
ก่อนเรียกใช้ LLM แอปพลิเคชันสามารถจำแนกคำขอตามหัวข้อ ความซับซ้อน หรือประเภทข้อมูลที่ต้องใช้ จากนั้นองค์ประกอบสำหรับจัดเส้นทางจะเลือกเวิร์กโฟลว์หรือขอข้อมูลเพิ่มเติม ทดสอบระบบจัดเส้นทางร่วมกับระบบปลายทางด้วย เพราะขั้นตอนแรกที่มีต้นทุนต่ำจะไม่มีประโยชน์ หากส่งคำขอที่ซับซ้อนไปยังเส้นทางที่ไม่ถูกต้องเป็นประจำ
การคัดแยกเอกสารและรูปภาพ
Multimodal Decision Model อาจจำแนกว่ารูปภาพหรือเอกสารอยู่ในหมวดหมู่ที่กำหนดไว้หรือไม่ เช่น ใบแจ้งหนี้ ใบเสร็จ หรือภาพหน้าจอคำร้องขอความช่วยเหลือ ตรวจสอบว่า Endpoint ที่เลือก รองรับรูปแบบข้อมูลนำเข้าและการประมวลผลรูปภาพตามความต้องการของคุณหรือไม่ การจำแนกประเภทแตกต่างจากการดึงข้อมูลทุกช่องในเอกสาร โปรดตรวจสอบว่าโมเดลและ API ที่เลือกสามารถรองรับทั้งสองงานหรือไม่
การให้คะแนนตามเกณฑ์
โมเดลสามารถจัดคำตอบให้อยู่ในระดับคะแนนตามลำดับ โดยใช้คำอธิบาย เช่น “ขาดหลักฐานสำคัญ” “มีหลักฐานรองรับบางส่วน” และ “มีหลักฐานรองรับครบถ้วน” ทดสอบว่าผู้ตรวจสอบเห็นด้วยกับป้ายกำกับหรือไม่ และโมเดลให้ผลลัพธ์ที่สอดคล้องกันสำหรับคำตอบที่มีลักษณะคล้ายกันหรือไม่ หลีกเลี่ยงการนำเสนอคะแนนตามเกณฑ์ในฐานะค่าที่เป็นกลางและปราศจากอคติ หากยังไม่มีการตรวจสอบความถูกต้อง
Decision Model ที่มีในแค็ตตาล็อกโมเดล Felo
แค็ตตาล็อกโมเดล Felo มีตัวกรองผลลัพธ์ Decisions ตามรายการ ณ วันที่ 2 พฤศจิกายน 2026 ตัวอย่างโมเดลประกอบด้วย:
| รายการในแค็ตตาล็อก | การใช้งานตามคำอธิบาย | ข้อมูลนำเข้าที่แสดงในแค็ตตาล็อก |
|---|---|---|
| TypeSafe Jev 1.14 | การจัดเส้นทาง การจำแนกประเภท และการกลั่นกรองเนื้อหา | ข้อความและรูปภาพ โดยรายการระบุว่าการรองรับรูปภาพยังอยู่ในขั้นทดลอง |
| LiquidAI d1.1 | การตัดสินใจแบบใช่/ไม่ใช่ ตัวเลือก และคะแนน | ข้อความและรูปภาพ |
| Baseten Joey 1 | การจำแนกประเภทและการจัดเส้นทาง | ข้อความและรูปภาพ |
| Perplexity Decider Flash V1.2 | การจำแนกประเภท การจัดเส้นทาง และการให้คะแนน | ข้อความและรูปภาพ |
คำอธิบายเหล่านี้อ้างอิงข้อมูลในแค็ตตาล็อก ไม่ใช่ผลทดสอบประสิทธิภาพจากหน่วยงานอิสระหรือคำแนะนำว่าโมเดลใดดีที่สุด ความพร้อมใช้งาน การรองรับฟีเจอร์ ขีดจำกัด Context และราคาอาจเปลี่ยนแปลงได้ ตรวจสอบรายการและเอกสาร Endpoint ฉบับปัจจุบันก่อนพัฒนาระบบ โดยเฉพาะฟีเจอร์ทดลองหรือฟีเจอร์ Multimodal การมีชื่อโมเดลในรายการไม่ได้ยืนยันว่าฟีเจอร์ Native API ของผู้ให้บริการทุกรายจะเปิดให้ใช้งานผ่านทุกแพลตฟอร์ม
วิธีประเมิน AI Decision Model
เริ่มจากการกำหนดการตัดสินใจหนึ่งงานที่มีขอบเขตชัดเจน พร้อมตัวอย่างที่เป็นตัวแทนของการใช้งานจริงและมีป้ายกำกับที่เชื่อถือได้ รวมกรณีที่มีความยาก หมวดหมู่ที่พบได้น้อย ข้อมูลบริบทที่ขาดหาย และตัวอย่างที่ต้องส่งต่อให้เจ้าหน้าที่ จากนั้นเปรียบเทียบโมเดลกับระบบพื้นฐานที่เรียบง่าย ตัวจำแนกประเภทที่ใช้อยู่ หรือ LLM ที่ส่งผลลัพธ์แบบมีโครงสร้าง
ประเมินผลมากกว่าค่าความแม่นยำ:
- Precision และ Recall: ข้อผิดพลาดประเภทใดมีผลกระทบ และเกิดขึ้นบ่อยเพียงใดในแต่ละคลาส?
- Calibration: ค่าความน่าจะเป็นจากการคาดการณ์ตรงกับผลลัพธ์ที่เกิดขึ้นจริงในแต่ละกลุ่มข้อมูลหรือไม่?
- Coverage: คำขอกี่เปอร์เซ็นต์ที่ระบบสามารถจัดการอัตโนมัติได้ตามเกณฑ์คะแนนที่เลือก?
- Latency และ Reliability: การเรียกใช้ API แบบครบกระบวนการผ่านข้อกำหนดสำหรับระบบ Production หรือไม่?
- Cost: ต้นทุนต่อการตัดสินใจที่มีประโยชน์เป็นเท่าใด รวมถึงการเรียกซ้ำ คำถามหลายรายการ การประมวลผลรูปภาพ และการตรวจสอบโดยเจ้าหน้าที่?
- Robustness: ประสิทธิภาพยังคงอยู่ในระดับเดิมหรือไม่ เมื่อเปลี่ยนภาษา รูปแบบข้อมูล ใช้ตัวอย่างที่ไม่คุ้นเคย หรือมีปริมาณการใช้งานที่เปลี่ยนแปลง?
ใช้ชุดทดสอบที่แยกจากข้อมูลฝึกหลังปรับแต่งป้ายกำกับและเกณฑ์คะแนน ในระบบ Production ให้บันทึกผลลัพธ์เมื่อเหมาะสม ตรวจสอบกรณีที่ผลการตัดสินใจไม่ตรงกัน และประเมินระบบอีกครั้งเมื่อมีการเปลี่ยนเวอร์ชันโมเดล นโยบาย หรือการกระจายตัวของข้อมูลนำเข้า สำหรับการตัดสินใจที่มีผลกระทบสูง ควรออกแบบการกำกับดูแลโดยมนุษย์และตรวจสอบข้อกำหนดที่เกี่ยวข้อง
คำถามที่พบบ่อย
Discriminative AI เหมือนกับ Decision Model หรือไม่?
ไม่เหมือนกันทั้งหมด Discriminative AI อธิบายแนวทางกว้าง ๆ สำหรับการคาดการณ์ผลลัพธ์เป้าหมายจากข้อมูลนำเข้า ส่วน Decision Model เป็นผลิตภัณฑ์ประเภทใหม่ที่เน้นผลลัพธ์ภายใต้ขอบเขตที่กำหนด เช่น ตัวเลือก คะแนน และค่าความน่าจะเป็น Decision Model บางประเภทใช้เทคนิค Discriminative แต่คำศัพท์ทั้งสองไม่ได้มีความหมายเหมือนกัน
LLM สามารถจำแนกประเภทหรือตัดสินใจได้หรือไม่?
ได้ Generative LLM สามารถรับคำสั่ง Prompt เพื่อจำแนกเนื้อหาหรือส่งผลลัพธ์ในรูปแบบที่มีโครงสร้างได้ ส่วน Decision Model เฉพาะทางจะมีประสิทธิภาพดีกว่า รวดเร็วกว่า หรือมีต้นทุนต่ำกว่าหรือไม่นั้น ขึ้นอยู่กับงาน โมเดล ผู้ให้บริการ และวิธีประเมินผล ทดสอบทั้งสองแนวทางกับตัวอย่างข้อมูลของคุณเอง
ค่าความน่าจะเป็นจาก Decision Model ถูกต้องเสมอหรือไม่?
ไม่เสมอไป โมเดลอาจสร้างค่าความน่าจะเป็นที่ผ่านการปรับเทียบไม่ดีสำหรับชุดข้อมูลหรือกลุ่มย่อยบางประเภท วัดผลการปรับเทียบและผลกระทบจากข้อผิดพลาดก่อนใช้เกณฑ์คะแนนเพื่อทำงานอัตโนมัติ
ควรใช้ Generative AI ในกรณีใด?
ใช้ Generative Model เมื่องานต้องการการร่างข้อความ การอธิบาย การสังเคราะห์ข้อมูล หรือการสร้างเนื้อหาแบบปลายเปิด สำหรับแอปพลิเคชันหลายประเภท Decision Model และ Generative Model สามารถทำงานร่วมกันได้ โดยโมเดลหนึ่งทำหน้าที่จัดเส้นทางหรือจำแนกประเภท ส่วนอีกโมเดลทำหน้าที่สร้างคำตอบ
Discriminative AI ช่วยให้นักพัฒนานำการตัดสินใจที่กำหนดไว้อย่างชัดเจนและวัดผลได้เข้าสู่เวิร์กโฟลว์ เริ่มจากงานหนึ่งประเภทที่มีขอบเขตชัดเจน ทดสอบข้อผิดพลาดที่มีผลกระทบ และกำหนดระดับการทำงานอัตโนมัติตามหลักฐานที่มี
สำรวจ Decision Model ในแค็ตตาล็อก Felo →
บทความนี้มีให้อ่านในภาษาต่อไปนี้ด้วย: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, Español, বাংলা and Português