
Gemini 4 Carbon บน Felo API: ข้อมูลจำเพาะ ผลการทดสอบ ราคา และกรณีการใช้งาน

Gemini 4 Carbon บน Felo API: ทำความรู้จักงบประมาณโทเค็นรวม 1M ระดับการคิด ขีดจำกัดอินพุตหลายรูปแบบ ผลการทดสอบที่เผยแพร่ ราคาจริง และวิธีเรียกใช้งาน
Gemini 4 Carbon ของ Google คือโมเดลที่บริษัทพัฒนาขึ้นสำหรับงานที่ไม่สามารถจัดการให้เสร็จด้วยการประมวลผลเพียงรอบสั้น ๆ ไม่ว่าจะเป็นการย้ายระบบในฐานโค้ดที่เกี่ยวข้องกับบริการหลายสิบรายการ การค้นหาช่องโหว่ที่ต้องจบด้วยแพตช์ที่ใช้งานได้จริง หรือโจทย์วิจัยที่ต้องอาศัยหลักฐานเชื่อมโยงกันเป็นลำดับ แทนคำตอบที่มีเพียงความมั่นใจในถ้อยคำ
ขณะนี้สามารถเรียกใช้งานโมเดลนี้ผ่าน Felo API ได้แล้ว โดย Felo มีข้อเสนอทดลองใช้งานฟรีในช่วงเวลาจำกัด พร้อมราคาจากผู้ให้บริการที่ลดลง คุณสามารถเปิดหน้าโมเดล ทดลองพรอมป์ต์ใน Playground และสร้างคีย์ API ได้จาก หน้า Gemini 4 Carbon บน Felo ก่อนอ่านรายละเอียดในคู่มือนี้
บทความนี้เป็นคู่มือการใช้งาน ไม่ใช่ข่าวประกาศเปิดตัว เนื้อหาครอบคลุมตัวตนและความสามารถของ Carbon ความแตกต่างจาก Gemini 4 Argon ความหมายและข้อจำกัดของผลการทดสอบที่เผยแพร่ พฤติกรรมของงบประมาณโทเค็นที่มีรูปแบบเฉพาะ จุดแข็ง จุดที่อาจไม่ตอบโจทย์ และค่าใช้จ่ายในการใช้งานผ่าน Felo ณ เวลานี้
Gemini 4 Carbon คืออะไร
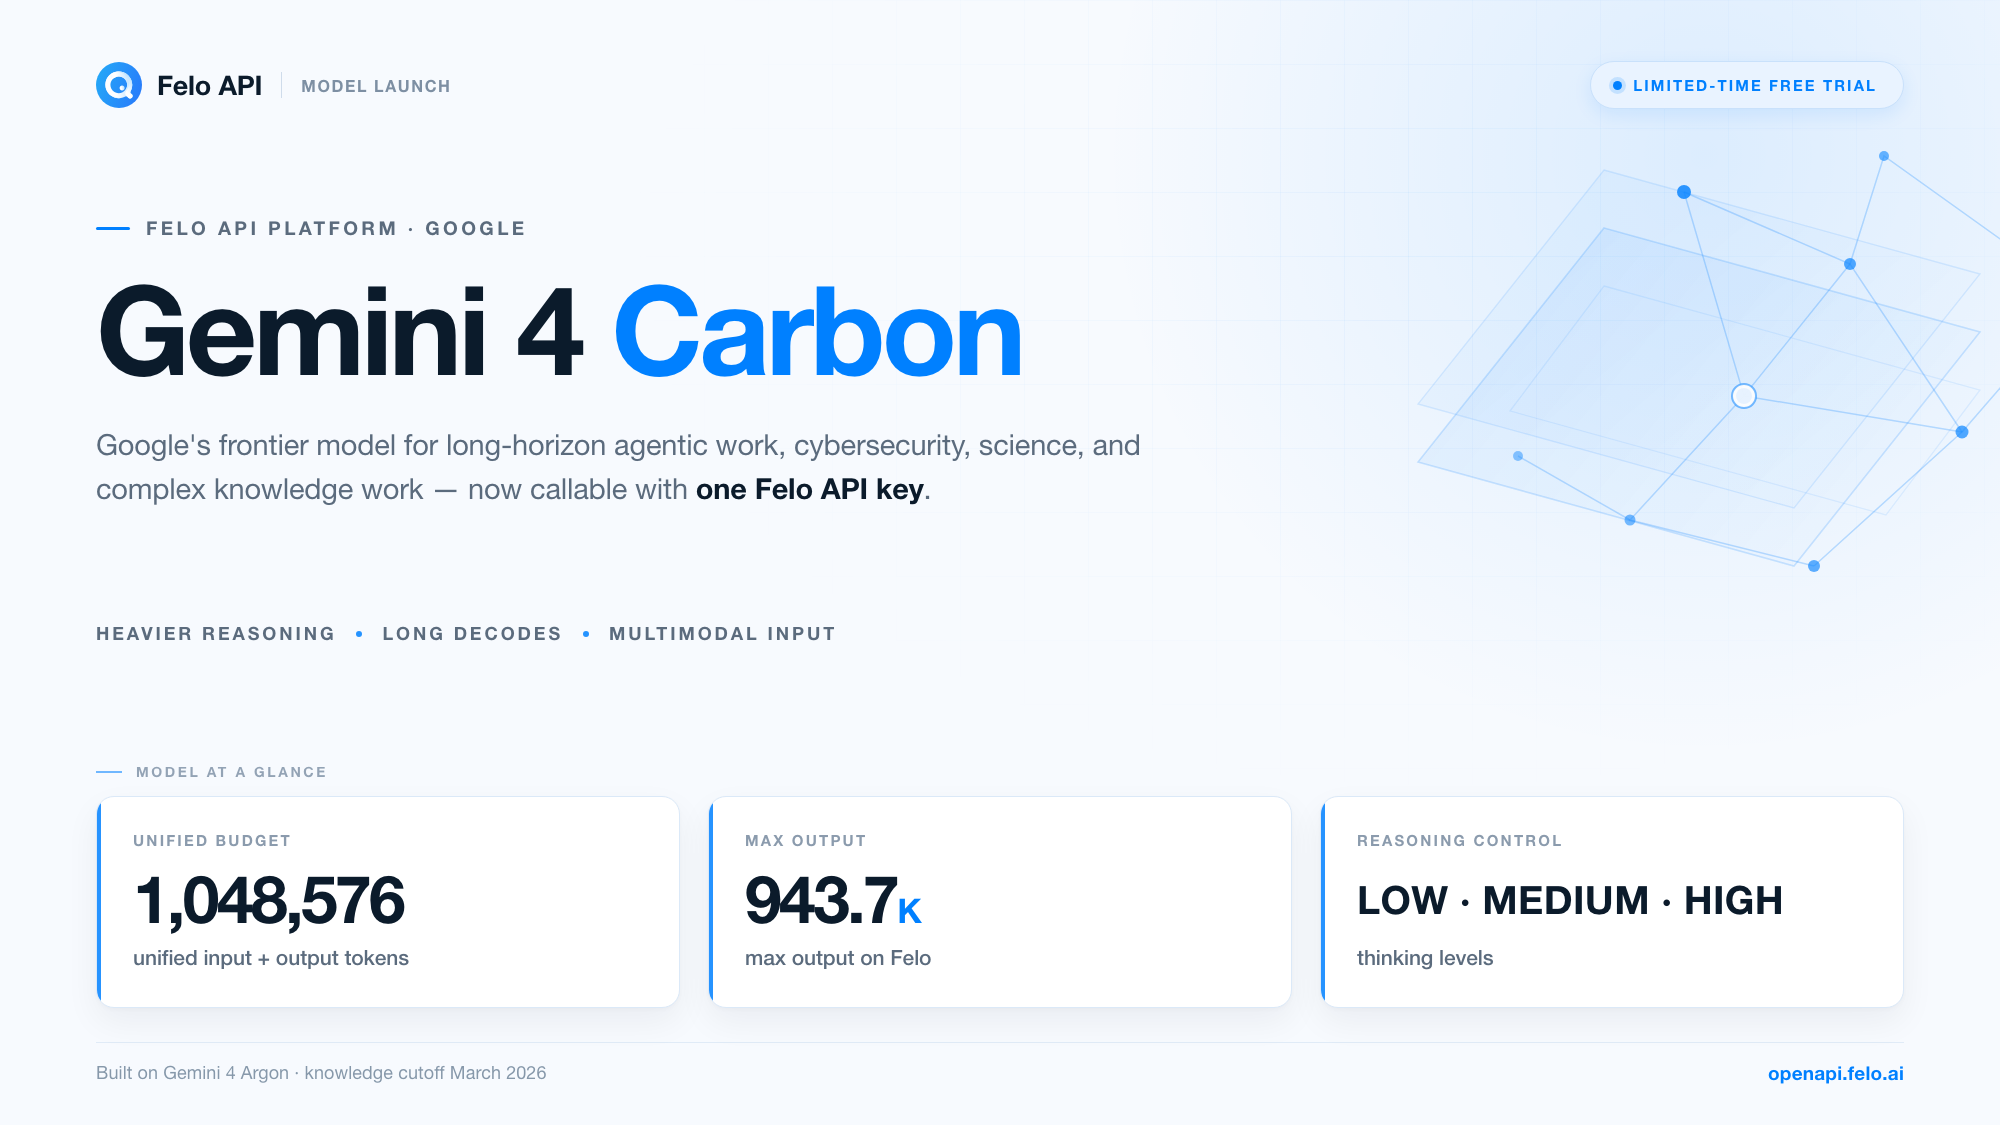
Gemini 4 Carbon คือโมเดลระดับแนวหน้าของ Google สำหรับงานแบบ Agentic ที่ต้องใช้ระยะเวลาการทำงานยาว ครอบคลุมการเขียนโค้ด การเงิน กฎหมาย ความปลอดภัยทางไซเบอร์ และวิทยาศาสตร์ Google ประกาศเปิดตัวโมเดลนี้เมื่อวันที่ 28 ตุลาคม 2026 โดยพัฒนาต่อยอดจาก Gemini 4 Argon และเปิดให้กลุ่มผู้เชี่ยวชาญด้านการป้องกันภัยไซเบอร์บางส่วนใช้งานเป็นกลุ่มแรกผ่านโครงการ Fairwind Program เอกสารแพลตฟอร์มสำหรับองค์กรของ Google ระบุว่าโมเดลนี้เข้าสู่สถานะพร้อมใช้งานทั่วไปแล้ว โดยมีกำหนดเผยแพร่วันที่ 10 พฤศจิกายน 2026
ชื่อ "Carbon" ไม่ได้หมายถึงโมเดลรุ่นใหม่ แต่สื่อถึงจุดเน้นด้านการทำงานที่แตกต่างภายในตระกูล Gemini 4 ขณะที่ Argon ได้รับการปรับแต่งเพื่อสร้างเอกสารขนาดยาวที่มีความต่อเนื่องภายใต้กระบวนการสร้างชุดเดียว Carbon จัดสรรงบประมาณให้กับการคิดมากขึ้น ทั้งการสำรวจสมมติฐาน การตรวจสอบซ้ำ และการประสานงานของงานหลายขั้นตอน Google ระบุว่า Carbon ใช้โทเค็นสำหรับการคิดมากกว่า Argon เพื่อสร้างคำตอบ
แนวทางนี้มีต้นทุน โมเดลใช้เวลามากขึ้นกับงานที่ซับซ้อน อาจเกิด Timeout ภายใต้เงื่อนไขบางประการ และใช้โทเค็นเพิ่มขึ้นเมื่อเลือกระดับการคิดที่สูงขึ้น Google ระบุข้อจำกัดเหล่านี้ไว้ชัดเจน เหตุผลที่ยังควรเลือก Carbon คือ งานเป้าหมายของโมเดลนี้ เช่น การวิเคราะห์ความปลอดภัย การย้ายระบบขนาดใหญ่ การให้เหตุผลทางวิทยาศาสตร์ และการตรวจสอบเอกสารที่มีความสำคัญสูง ล้วนให้ความสำคัญกับความลึกของการวิเคราะห์มากกว่าความเร็ว
ข้อมูลจำเพาะของโมเดลโดยสรุป
| ข้อมูลจำเพาะ | ค่า |
|---|---|
| Model ID บน Felo | gemini-4-carbon |
| วันประกาศเปิดตัว | 28 ตุลาคม 2026 |
| พัฒนาต่อยอดจาก | Gemini 4 Argon |
| Context และ Output | งบประมาณรวม 1,048,576 โทเค็น ครอบคลุมทั้งอินพุตและเอาต์พุต |
| เอาต์พุตสูงสุดที่ Felo ระบุ | 943.718K โทเค็น |
| อินพุต | ข้อความ รูปภาพ เสียง วิดีโอ PDF และไฟล์ Office/OpenDocument |
| เอาต์พุต | ข้อความ |
| ระดับการคิด | LOW, MEDIUM (ค่าเริ่มต้น), HIGH |
| ข้อมูลความรู้ล่าสุด | มีนาคม 2026 |
| Sampling | Temperature 1.0, top-p 0.95, top-k 64 (ค่าคงที่) |
| Caching | รองรับเฉพาะ Implicit Caching โดยมีขั้นต่ำ 4,096 โทเค็น |
| ช่องทาง Felo ที่แนะนำ | Messages API (รองรับรูปแบบ Anthropic) |
| การเข้าถึง | ลูกค้าองค์กรที่ผ่านการยืนยันในบางภูมิภาค ส่วนรุ่น Cyber ใช้งานได้เฉพาะผู้ที่อยู่ใน Allowlist |
ข้อมูลสองรายการในตารางนี้ควรได้รับคำอธิบายแยกต่างหาก เพราะส่งผลต่อการออกแบบระบบที่เรียกใช้งานโมเดล ได้แก่ งบประมาณโทเค็นแบบรวมและระดับการคิด
Gemini 4 Carbon แตกต่างจาก Gemini 4 Argon อย่างไร
Carbon และ Argon อยู่ในตระกูลเดียวกัน มีวันสิ้นสุดข้อมูลความรู้เดียวกัน และมีแนวทางการใช้งานหลายส่วนที่ใกล้เคียงกัน ความแตกต่างอยู่ที่วิธีจัดสรรความสามารถในการประมวลผล
งบประมาณอินพุตและเอาต์พุตแบบรวม โดยทั่วไป Argon มี Context Window ขนาด 1,048,576 โทเค็น และกำหนดเอาต์พุตเริ่มต้นแยกต่างหากที่ 65,536 โทเค็น ส่วน Carbon ใช้โทเค็น 1,048,576 รายการร่วมกันสำหรับอินพุต การคิด การเรียกใช้เครื่องมือ และคำตอบสุดท้าย นี่คืองบประมาณชุดเดียว ไม่ใช่ Context Window ที่บวกกับโควตาเอาต์พุตอีกชุดหนึ่ง
การให้เหตุผลที่เข้มข้นขึ้นตั้งแต่ค่าเริ่มต้น Carbon รองรับระดับการคิด LOW, MEDIUM และ HIGH โดย gemini-4-carbon ใช้ MEDIUM เป็นค่าเริ่มต้น ส่วนรุ่น Cyber-permissive ใช้ HIGH เป็นค่าเริ่มต้น โมเดลได้รับการออกแบบให้ทำงานผ่านวงจรตรวจสอบหลายรอบ ซึ่งเป็นเหตุผลที่ Google ระบุการใช้โทเค็นที่สูงขึ้นเป็นข้อจำกัดที่ทราบแล้ว ไม่ใช่ข้อผิดพลาดของระบบ
การสร้างเอาต์พุตแบบแบ่งช่วงระยะยาว (Long Decodes) การสร้างเอาต์พุตหนึ่งช่วงในโหมด Streaming รองรับสูงสุด 65,536 โทเค็น หรือ 32,768 โทเค็นเมื่อไม่ใช้ Streaming คุณสามารถสร้างเอาต์พุตต่อจากขีดจำกัดของแต่ละช่วงด้วย Long Decodes โดย Google Gen AI SDK และ Agent Studio จะจัดการ Continuation Token ให้อัตโนมัติ หรือคุณสามารถสร้างลูปสำหรับการสร้างเนื้อหาต่อเองได้ ขีดจำกัดทางทฤษฎีคือขนาดงบประมาณรวมทั้งหมดหลังหักอินพุต
รองรับไฟล์ได้หลากหลายขึ้น Carbon รองรับไฟล์ Microsoft Office และ OpenDocument ได้แก่ .docx, .doc, .pptx, .ppt, .xlsx, .xls, .odt, .odp, .ods ทั้งการส่งไฟล์ในคำขอและการอ่านจาก Cloud Storage นอกเหนือจาก PDF และข้อความธรรมดา ความสามารถนี้มีความสำคัญกับเวิร์กโฟลว์ที่เริ่มต้นจากสไลด์นำเสนอ สเปรดชีต หรือสัญญา แทนไฟล์ข้อความที่ผ่านการแปลงมาแล้ว
การปรับแต่งด้านความปลอดภัยและรุ่น Cyber แยกต่างหาก Google รายงานว่าการแจ้งเตือนความไม่สอดคล้องที่มีความรุนแรงสูงในสภาพแวดล้อมการเขียนโค้ดจริงลดลงเกือบ 80% และ Carbon ทำคะแนนด้านความปลอดภัยของเนื้อหาหลายภาษาและหลายรูปแบบสูงกว่า Argon อยู่ 3.50 จุดเปอร์เซ็นต์ ในการประเมินความปลอดภัยแบบข้อความต่อข้อความ นอกจากนี้ยังมี gemini-4-carbon-cyber-permissive ซึ่งเป็นรุ่นสำหรับงานป้องกันภัยไซเบอร์ที่จำกัดการเข้าถึงผ่าน Allowlist ใช้ HIGH เป็นค่าเริ่มต้น และตัดความสามารถในการใช้งานคอมพิวเตอร์ออก
ความสามารถเฉพาะด้านวิทยาศาสตร์ Google ระบุว่าโมเดลสามารถแปลงเป้าหมายด้านความปลอดภัยเป็นทฤษฎีบททางคณิตศาสตร์ และค้นพบ Homologs ที่อยู่ห่างไกลในคลังข้อมูลลำดับชีวภาพระดับ Petabase ได้ด้วยตนเอง โดยรายงานว่าการค้นคืน Homologs สำหรับกลุ่มโปรตีนที่มี Homologs น้อยเพิ่มขึ้นเฉลี่ย 40 เท่า ข้อกล่าวอ้างนี้จำกัดอยู่ในงานวิจัยเฉพาะด้าน คุณควรทดสอบซ้ำด้วยข้อมูลของตนเอง แทนการถือว่าเป็นความสามารถทั่วไปของโมเดล
อธิบายงบประมาณโทเค็นแบบรวม
หน้าแนะนำโมเดลส่วนใหญ่แสดงตัวเลขสองค่า ได้แก่ Context Window และเอาต์พุตสูงสุด แต่ Carbon แสดงตัวเลขเพียงค่าเดียว พร้อมข้อกำหนดแยกตามช่วงการสร้างเอาต์พุต หากคุณวางแผนคำขอด้วยแนวคิดแบบเดิม อาจประเมินพื้นที่ที่เหลือผิดพลาด หรืออ่านค่าใช้จ่ายไม่ตรงกับการใช้งานจริง
งบประมาณนี้แบ่งออกเป็นส่วนต่าง ๆ ดังนี้
- Input (อินพุต) — พรอมป์ต์ เอกสารแนบ รูปภาพ เสียง เฟรมวิดีโอ และบทสนทนาก่อนหน้า
- Thinking (การคิด) — โทเค็นสำหรับการให้เหตุผลที่โมเดลใช้ก่อนตอบคำถาม โดยเฉพาะระดับ HIGH อาจใช้โทเค็นจำนวนมาก
- Tool Calls (การเรียกใช้เครื่องมือ) — ทุกการเรียกใช้เครื่องมือที่โมเดลดำเนินการเมื่อเปิดใช้งานเครื่องมือ
- Final Answer (คำตอบสุดท้าย) — ข้อความคำตอบที่คุณได้รับ
ทั้งสี่ส่วนใช้โทเค็นจากงบประมาณรวม 1,048,576 รายการร่วมกัน คำขอที่มีอินพุต 900K โทเค็นไม่ได้เหลือพื้นที่เอาต์พุต 1M โทเค็น แต่จะเหลือประมาณ 148K โทเค็นสำหรับการคิด การเรียกใช้เครื่องมือ และคำตอบรวมกัน ก่อนการสร้างเนื้อหาต่อ
ขีดจำกัดต่อช่วงเป็นข้อกำหนดอีกส่วนหนึ่ง คำขอแบบ Streaming สร้างเอาต์พุตได้สูงสุด 65,536 โทเค็นต่อช่วง ส่วนคำขอที่ไม่ใช้ Streaming จำกัดที่ 32,768 โทเค็น Long Decodes ช่วยสร้างเนื้อหาต่อหลังข้ามขีดจำกัดของแต่ละช่วง จนกว่างบประมาณรวมจะหมด หากระบบเชื่อมต่อของคุณตีความ max_tokens ว่าเป็นการรับประกันปริมาณเอาต์พุตทั้งหมด ความเข้าใจนั้นไม่ถูกต้อง เพราะค่านี้กำหนดขีดจำกัดต่อช่วง ส่วนการจัดการ Continuation ของ SDK จะทำให้สามารถสร้างเอกสารขนาดยาวได้
หน้าโมเดลของ Felo ระบุเอาต์พุตสูงสุดที่ 943.718K โทเค็น ควรมองตัวเลขนี้เป็นขีดจำกัดเอาต์พุตของเส้นทาง Felo ไม่ใช่ Context Window ชุดที่สองซึ่งมีขนาดใหญ่กว่า ภายใต้งบประมาณแบบรวม พื้นที่ที่เหลือสำหรับคำตอบขึ้นอยู่กับปริมาณข้อมูลที่คุณส่งเข้าไป
แนวทางการออกแบบจึงเรียบง่าย: กำหนดขนาดเอาต์พุตก่อน แล้วจัดสรรพื้นที่ให้อินพุตตามขนาดที่เหลือ สำหรับรายงานขนาดยาว ให้สำรองงบประมาณสำหรับเอาต์พุตและการคิด จากนั้นลดขนาดข้อมูลต้นทางให้เหมาะสม สำหรับการวิเคราะห์เอกสารจำนวนมาก ให้ยอมรับว่าคำตอบจะสั้นกว่าอินพุต และวางแผนการสร้างเนื้อหาต่อหรือแบ่งพรอมป์ต์เป็นหลายขั้นตอน
ระดับการคิด: ที่มาของคุณภาพคำตอบ
Carbon มีระดับการคิดสามระดับ ได้แก่ LOW, MEDIUM และ HIGH โดย MEDIUM เป็นค่าเริ่มต้น เอกสารของ Google ระบุชัดเจนว่า thinking_budget และ thinking_level="MINIMAL" จะส่งผลให้เกิดข้อผิดพลาดในการตรวจสอบความถูกต้อง ดังนั้นจึงไม่สามารถลดการให้เหตุผลลงเหลือศูนย์ได้
ความแตกต่างในการใช้งานมีความชัดเจน ที่ระดับ LOW โมเดลทำงานคล้ายโมเดลแชตระดับแนวหน้าที่เน้นความเร็ว เหมาะกับการดึงข้อมูล การจัดประเภท การเขียนข้อความใหม่ และการตรวจสอบโค้ดทั่วไป ระดับ MEDIUM เพิ่มการใช้โทเค็นสำหรับการวางแผนและตรวจสอบคำตอบด้วยตนเอง ส่วน HIGH ใช้วงจรตรวจสอบที่ยาวขึ้น มีโอกาสตรวจพบข้อผิดพลาดที่ซับซ้อนได้มากที่สุด แต่ก็มีโอกาสใช้เวลานานและมีค่าใช้จ่ายสูงที่สุดเช่นกัน
แนวทางที่ควรใช้ในการทำงานมีดังนี้
- เลือกระดับตามต้นทุนของคำตอบที่ผิดพลาด หากข้อผิดพลาดตรวจพบและแก้ไขได้ด้วยต้นทุนต่ำ ให้ใช้ LOW หากข้อผิดพลาดอาจหลุดเข้าสู่ระบบ Production หรือเอกสารที่ต้องยื่นอย่างเป็นทางการ ให้ทดสอบด้วย HIGH
- วัดจำนวนโทเค็นต่อผลลัพธ์ที่ผ่านการยอมรับ ไม่ใช่ต่อคำขอ การคิดระดับสูงอาจลดจำนวนครั้งในการลองใหม่และแก้ไขงาน แต่ก็อาจเพิ่มต้นทุนหลายเท่าสำหรับงานที่ MEDIUM สามารถจัดการได้อยู่แล้ว ควรเปรียบเทียบต้นทุนของกระบวนการทั้งหมด
- อย่าสมมติว่าระดับการคิดในการทดสอบ Benchmark ตรงกับการใช้งานของคุณ ตัวเลขหลักที่ Google เผยแพร่ไม่ได้ระบุระดับการคิดที่ใช้ในทุกกรณี ควรทดสอบงานของคุณเองด้วยระดับการคิดอย่างน้อยสองระดับก่อนตัดสินใจใช้งาน
ค่า Sampling ถูกกำหนดไว้ที่ temperature 1.0, top-p 0.95 และ top-k 64 โดยไม่รองรับการเปลี่ยนค่า หาก Pipeline ของคุณต้องอาศัยผลลัพธ์ที่มีความแน่นอนจากค่า Temperature ต่ำ Carbon ไม่ใช่โมเดลที่เหมาะกับขั้นตอนนั้น ใช้ Carbon สำหรับการตัดสินใจและสังเคราะห์ข้อมูล ส่วนขั้นตอนที่ต้องการผลลัพธ์แบบกำหนดแน่นอนควรใช้โมเดลที่รองรับการควบคุม Sampling
ผลการทดสอบที่ Google เผยแพร่และความหมายของตัวเลข
หน้าโมเดลของ Felo รวบรวมผลการทดสอบ Benchmark ของ Carbon ที่เผยแพร่โดยผู้ให้บริการ ตารางด้านล่างแสดงแนวโน้มของประสิทธิภาพ โดยข้อมูลมาจาก Google หรือผู้ให้บริการการประเมินผล ไม่ใช่ผลการทดสอบซ้ำโดยอิสระสำหรับบทความนี้ และเป็นข้อมูลที่อธิบายเงื่อนไขการทดสอบ ไม่ใช่ผลลัพธ์ที่รับประกันสำหรับงานของคุณ
| การประเมิน | สิ่งที่วัด | Gemini 4 Carbon | บริบท |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | ดัชนีการให้เหตุผลแบบผสม | 59 | อันดับ 1; Claude Opus 5.5 ได้ 58 |
| SEC-bench Pro | การค้นหาช่องโหว่ | 88.2% | ความปลอดภัย การสแกนเชิงป้องกัน |
| CWE-bench | การแก้ไขแพตช์ช่องโหว่ | 71.0% | ความปลอดภัย การแก้ไขปัญหา |
| ExploitGym | การใช้ประโยชน์จากช่องโหว่ | 54.8% | งานวิจัยด้านความปลอดภัย ภายใต้เงื่อนไขควบคุม |
| Terminal-Bench 4.0 | อัตราการโกงที่สำเร็จ | 0.0% | ความต้านทานต่อการแสวงหาประโยชน์จากระบบรางวัล ไม่ใช่ความสามารถของโมเดล |
| Vals Index | คะแนนรวมด้านงานความรู้ | 70.45% | อันดับ 3 จาก 36 โมเดล |
| Legal Research Bench | งานวิจัยด้านกฎหมาย | 55.77% | อันดับ 1 |
| General Financial Intelligence | งานด้านการเงิน | #1 | อันดับสูงสุดจากการเปรียบเทียบ 23 การกำหนดค่าของโมเดลระดับแนวหน้า ตามข้อมูลของ Balyasny Asset Management |
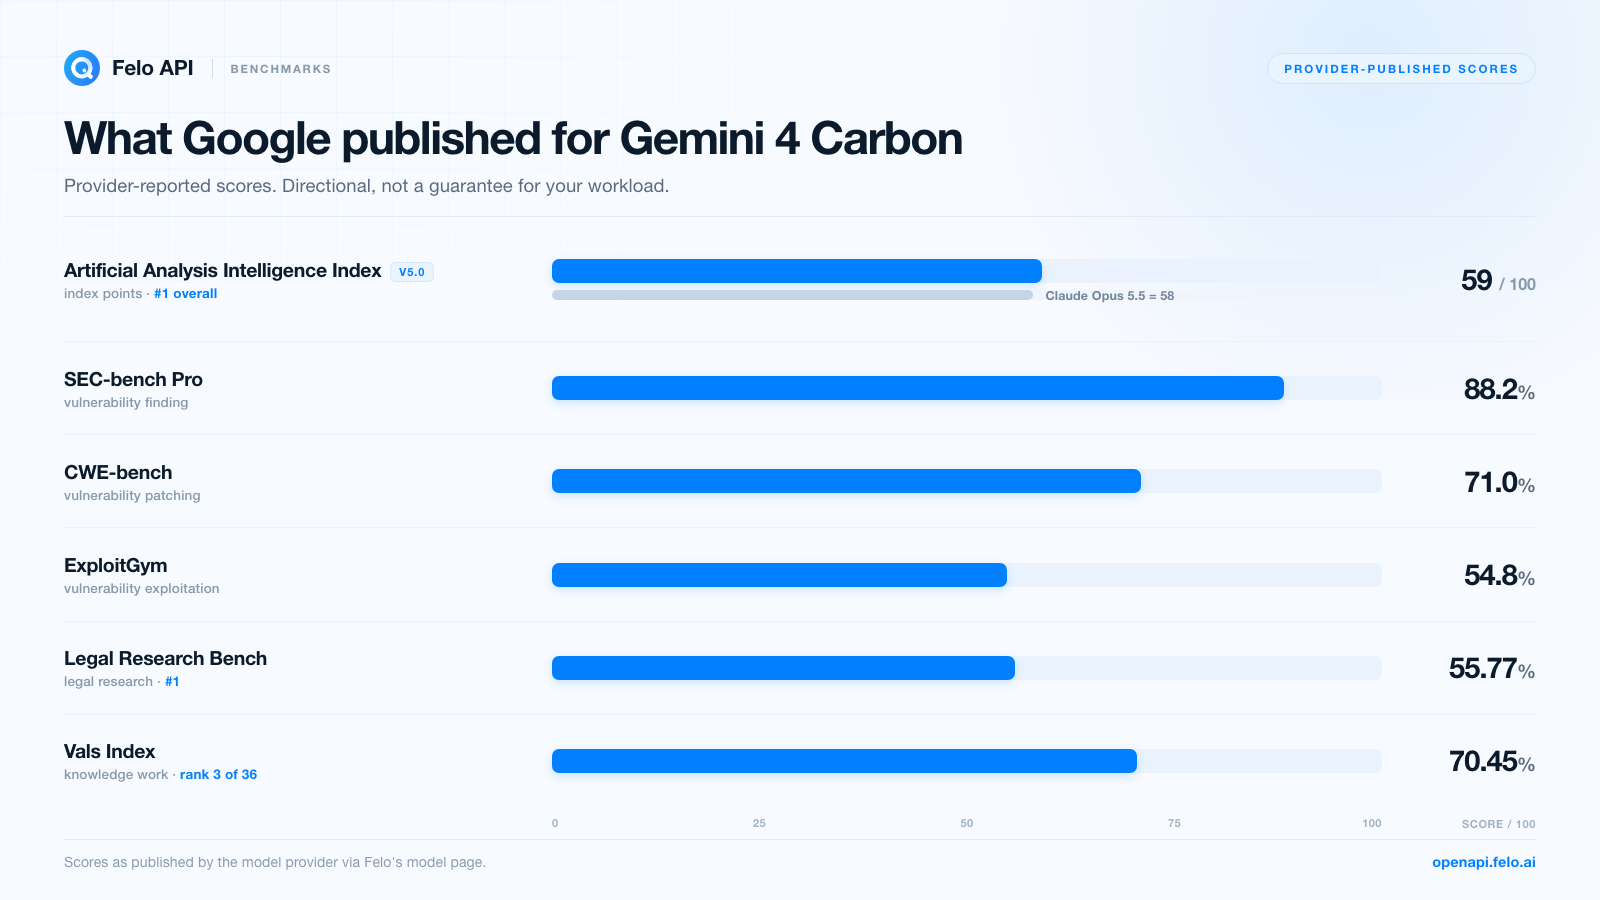
เมื่อพิจารณาตารางอย่างละเอียด จะเห็นประเด็นสำคัญสามข้อ
คะแนนด้านความปลอดภัยสะท้อนวงจรการทำงาน ไม่ใช่ความสามารถเพียงด้านเดียว การค้นหาช่องโหว่ การเขียนแพตช์ และการใช้ประโยชน์จากช่องโหว่เป็นทักษะคนละประเภท ตัวเลขที่เผยแพร่ของ Carbon แสดงจุดแข็งสูงสุดด้านการค้นหา (88.2% บน SEC-bench Pro) และคะแนนที่ต่ำกว่าด้านการใช้ประโยชน์จากช่องโหว่ (54.8% บน ExploitGym) ส่วนการแก้ไขแพตช์อยู่ระหว่างกลาง (71.0% บน CWE-bench) หากงานของคุณเน้นการป้องกัน เช่น การสแกน การคัดกรอง และการแก้ไขช่องโหว่ โปรไฟล์นี้ถือว่าตรงกับความต้องการ แต่หากต้องการให้โมเดลใช้ประโยชน์จากช่องโหว่ด้วยตนเอง คะแนนด้านนี้ต่ำกว่าและมีกฎการเข้าถึงที่เข้มงวดกว่า
ตัวชี้วัดอัตราการโกงเกี่ยวข้องกับความน่าเชื่อถือ ไม่ใช่ความฉลาด ค่า "successful cheating rate" ของ Terminal-Bench 4.0 ใช้วัดว่าโมเดลหาทางเอาเปรียบ Benchmark แทนการแก้โจทย์หรือไม่ ผลลัพธ์ 0.0% เป็นข้อกล่าวอ้างเกี่ยวกับความต้านทานต่อการแสวงหาประโยชน์จากระบบรางวัล ซึ่งมีความสำคัญเมื่อปล่อยให้ Agent ทำงานโดยไม่มีผู้ควบคุม ตัวเลขนี้ไม่ใช่คะแนนความสามารถ และไม่ควรนำไปเปรียบเทียบกับผลการทดสอบความถูกต้องแบบเปอร์เซ็นต์ในแถวอื่นของตาราง
อันดับด้านงานความรู้มีความเกี่ยวข้องกับทีมส่วนใหญ่ที่สุด อันดับ 3 จาก 36 ใน Vals Index อันดับ 1 ใน Legal Research Bench และอันดับสูงสุดในการเปรียบเทียบโมเดลด้านการเงินของ Balyasny สะท้อนงานที่สร้างความคุ้มค่าให้กับโมเดลระดับแนวหน้า ได้แก่ การอ่านข้อมูลจำนวนมาก การประสานหลักฐานที่ขัดแย้งกัน และการสร้างผลงานที่ผู้เชี่ยวชาญสามารถตรวจสอบได้ ผลลัพธ์เหล่านี้ยังขึ้นอยู่กับการออกแบบพรอมป์ต์และคุณภาพของแหล่งข้อมูล จึงควรมองเป็นเหตุผลให้เริ่มทดสอบ ไม่ใช่เหตุผลให้ละเว้นการทดสอบ
ข้อควรระวังอีกประการคือ คะแนน Artificial Analysis เป็นคะแนนรวม และความได้เปรียบหนึ่งคะแนนเหนือ Claude Opus 5.5 ยังอยู่ในช่วงที่สัดส่วนของงานทดสอบที่แตกต่างกันอาจเปลี่ยนลำดับได้ สำหรับงานเฉพาะที่คุณสนใจ โมเดลทั้งสองอาจมีผลลัพธ์ที่แตกต่างกันมาก ไม่ว่าจะเป็นฝ่ายใดที่ทำได้ดีกว่า
Gemini 4 Carbon เหมาะกับงานประเภทใด
Benchmark เป็นแผนที่ ไม่ใช่พื้นที่จริง ต่อไปนี้คืองานที่แนวทางการออกแบบของ Carbon สอดคล้องกับความต้องการในการทำงาน
งานเขียนโค้ดและการย้ายระบบขนาดใหญ่
Carbon มุ่งเป้าไปที่งานวิศวกรรมที่ต้องอาศัยการทำงานร่วมกันของ Agent หลายตัว การดีบักประจำวัน การย้ายระบบในฐานโค้ดขนาดใหญ่ และการออกแบบอัลกอริทึม งบประมาณแบบรวมมีประโยชน์กับงานเหล่านี้ คุณสามารถส่งแผนผัง Repository ไฟล์ซอร์สโค้ดที่เกี่ยวข้อง ผลลัพธ์ของการทดสอบที่ล้มเหลว และข้อกำหนดการย้ายระบบในคำขอเดียว จากนั้นขอแผนการดำเนินงานก่อนแก้ไขโค้ด
ตัวอย่างพรอมป์ต์ที่เหมาะกับโมเดลลักษณะนี้:
อ่านแผนผัง Repository และโมดูลบริการทั้งสามไฟล์ที่แนบมา ระบุจุดเรียกใช้งานทั้งหมดที่ได้รับผลกระทบจากการเปลี่ยน Session Interface แจกแจงความเสี่ยงด้านความเข้ากันได้ และเสนอขั้นตอนการย้ายระบบตามลำดับ ห้ามเขียนโค้ดในขั้นตอนนี้ ระบุประเด็นที่ไม่สามารถตรวจสอบจากไฟล์ที่ให้มาได้
เริ่มจากการขอแผนก่อน อนุญาตให้โมเดลเรียกใช้การทดสอบหลังจากคุณตรวจสอบแผนแล้ว และให้มนุษย์ตรวจสอบ Diff ทุกครั้ง แม้โมเดลจะวางแผนได้ดี ก็ยังอาจสร้างแพตช์ที่คอมไพล์ผ่านแต่ทำงานผิดพลาดได้
ความปลอดภัยทางไซเบอร์เชิงป้องกัน
โปรไฟล์ Benchmark ด้านความปลอดภัย ซึ่งมีคะแนนสูงด้านการค้นหาช่องโหว่ คะแนนดีด้านการแก้ไขแพตช์ และคะแนนต่ำกว่าด้านการใช้ประโยชน์จากช่องโหว่ สอดคล้องกับงานเชิงป้องกัน เช่น การสแกนฐานโค้ดเพื่อค้นหาช่องโหว่แต่ละประเภท การคัดกรองผลลัพธ์จากเครื่องมือสแกน การเสนอแพตช์ และการอธิบายความเสี่ยงด้วยภาษาที่ผู้ตรวจสอบนำไปดำเนินการได้ รุ่น Cyber ของ Google ถูกพัฒนาขึ้นเพื่อจุดประสงค์นี้ แต่การเข้าถึงจำกัดผ่าน Allowlist ของ Fairwind Program และต้องได้รับอนุมัติแยกต่างหาก
มีข้อควรระวังสองประการ ประการแรก ใช้เวิร์กโฟลว์ด้านความปลอดภัยกับระบบที่คุณได้รับอนุญาตให้ทดสอบเท่านั้น ประการที่สอง ตรวจสอบผลการค้นพบก่อนดำเนินการ แม้โมเดลจะรายงานช่องโหว่ด้วยความมั่นใจสูง ก็ยังอาจเป็นข้อมูลผิดพลาด และผลบวกลวงอาจทำให้ทีมวิศวกรรมเสียเวลา
งานวิจัยทางวิทยาศาสตร์และเทคนิค
ความสามารถด้านวิทยาศาสตร์ที่มีรายงานนั้นมีขอบเขตเฉพาะ ได้แก่ การแปลงเป้าหมายด้านความปลอดภัยเป็นทฤษฎีบททางคณิตศาสตร์ และการค้นหา Homologs ที่อยู่ห่างไกลในคลังข้อมูลลำดับชีวภาพระดับ Petabase หากคุณทำงานในห้องปฏิบัติการหรือกลุ่มวิจัย รูปแบบการใช้งานที่เหมาะสมคือกำหนดคำถามให้ Carbon มีขอบเขตชัดเจน พร้อมส่งเอกสารวิชาการหรือลำดับข้อมูลที่เกี่ยวข้อง และกำหนดให้แยกหลักฐานออกจากข้ออนุมาน
ข้อกล่าวอ้างเรื่องการเพิ่มประสิทธิภาพการค้นคืน Homologs ถึง 40 เท่าถือว่าน่าสนใจ แต่เป็นผลจาก Pipeline เฉพาะสำหรับกลุ่มโปรตีนที่มี Homologs น้อย ควรทดสอบซ้ำด้วย Benchmark ที่ทีมของคุณเชื่อถือก่อนสร้างเวิร์กโฟลว์บนพื้นฐานของความสามารถนี้
งานการเงิน กฎหมาย และการตรวจสอบเอกสารที่มีความสำคัญสูง
อันดับด้านงานความรู้ของ Carbon เป็นจุดขายที่แข็งแกร่งที่สุดสำหรับธุรกิจบริการระดับมืออาชีพ ลักษณะงานประกอบด้วยการกระทบยอดบัญชี การวิเคราะห์ความแปรปรวน การตรวจสอบคำพิพากษาและเอกสารยื่นต่อหน่วยงานกำกับดูแล รวมถึงการจัดทำบันทึกพร้อมเอกสารอ้างอิง โมเดลรองรับการอ่านรูปภาพและ PDF จึงสามารถใช้งานเอกสารสแกนและแผนภูมิเป็นอินพุตได้
อย่างไรก็ตาม ความสามารถเหล่านี้ไม่ได้ทำให้ขั้นตอนการตรวจสอบหมดความจำเป็น ส่งชุดเอกสารต้นทางให้โมเดล ขอให้อ้างอิงข้อความที่รองรับข้อสรุปแต่ละข้อ และตรวจสอบแหล่งอ้างอิงทุกครั้ง แม้โมเดลจะรองรับ Context ได้ถึงหนึ่งล้านโทเค็น ก็ยังอาจอ่านข้อมูลในหน้า 412 ผิดได้
Agent ที่ทำงานต่อเนื่องและใช้เครื่องมือ
Carbon รองรับ Function Calling, Structured Output, การเรียกใช้โค้ด, URL Context, Computer Use และตัวเลือก Grounding หลายประเภท รวมถึง Google Search, Google Maps และผู้ให้บริการค้นหาจากบุคคลที่สาม นอกจากนี้ยังรองรับการทำความเข้าใจวิดีโอแบบ Agentic ซึ่งมีประโยชน์เมื่ออินพุตเป็นไฟล์บันทึกวิดีโอแทนเอกสาร
นี่คือรูปแบบการใช้งานที่ต้องการทรัพยากรมากที่สุด และเป็นวิธีที่ทำให้สิ้นเปลืองโทเค็นได้ง่ายที่สุด ควรติดตั้งระบบตรวจสอบ Agent โดยบันทึกการเรียกใช้เครื่องมือ จำกัดจำนวนรอบการทำงาน และกำหนดให้ Agent สรุปสิ่งที่ตรวจสอบแล้วก่อนดำเนินการ งบประมาณ 1M ทำให้สามารถสร้าง Agent ที่มีความซับซ้อนได้ แต่ไม่ได้ทำให้ต้นทุนต่ำลง
อินพุตหลายรูปแบบและข้อจำกัด
Carbon รองรับข้อความ รูปภาพ เสียง วิดีโอ PDF และเอกสาร Office โดยส่งผลลัพธ์เป็นข้อความ ขีดจำกัดมีขนาดใหญ่แต่ระบุไว้อย่างชัดเจน ซึ่งมีความสำคัญมากกว่ารายการประเภทอินพุตบนหน้าประชาสัมพันธ์
| ประเภทอินพุต | ขีดจำกัดในการใช้งาน |
|---|---|
| เสียง | ประมาณ 8.4 ชั่วโมงต่อพรอมป์ต์ หรือสูงสุด 1M โทเค็น รองรับไฟล์เสียงสูงสุด 1,000 ไฟล์ |
| วิดีโอ | ประมาณ 45 นาทีเมื่อมีเสียง และประมาณ 1 ชั่วโมงเมื่อไม่มีเสียง รองรับสูงสุด 10 วิดีโอต่อพรอมป์ต์ |
| รูปภาพและเอกสาร | รวมกันสูงสุด 3,000 รายการต่อพรอมป์ต์ |
| เอกสาร | สูงสุด 3,000 หน้าต่อไฟล์ |
| รูปแบบ Office | .docx, .doc, .pptx, .ppt, .xlsx, .xls |
| รูปแบบ OpenDocument | .odt, .odp, .ods |
| ขนาดอินพุต | 500 MiB หลังการบีบอัดบน GenerateContent API และ 256 MiB บน Interactions API |
ขีดจำกัดด้านเสียงเป็นจุดเด่นสำคัญ การส่งเสียงนานแปดชั่วโมงในคำขอเดียวเปลี่ยนรูปแบบการทำงานของทีมที่มีการประชุมจำนวนมาก จากการถอดเสียงและแบ่งไฟล์เป็นส่วนย่อย คุณสามารถส่งไฟล์บันทึกการสนทนาตลอดทั้งวัน แล้วขอให้สรุปประเด็นหลัก การตัดสินใจ และคำถามที่ยังไม่มีคำตอบได้ ต้นทุนคือจำนวนโทเค็น โดยโทเค็นเสียงคิดค่าบริการในอัตราเดียวกับโทเค็นอินพุต ดังนั้นการอัปโหลดเสียงตลอดทั้งวันจึงไม่ใช่บริการฟรี
ขีดจำกัดของวิดีโอใกล้เคียงกับการใช้งานทั่วไปมากกว่า วิดีโอพร้อมเสียง 45 นาทีเพียงพอสำหรับการบรรยาย การสาธิตผลิตภัณฑ์ หรือการสัมภาษณ์ที่บันทึกไว้ แต่ไม่เพียงพอสำหรับการประชุมขนาดใหญ่ตลอดทั้งงาน
ยังมีช่องว่างด้านความสามารถที่ต้องวางแผนรองรับ Gemini Live API ไม่ได้รับการสนับสนุน จึงไม่สามารถใช้เสียงแบบเรียลไทม์ได้ RAG Engine และการปรับแต่งโมเดลก็ไม่รองรับเช่นกัน ทำให้ระบบ Retrieval และ Fine-tuning ต้องทำงานในชั้น Application นอกจากนี้ยังไม่รองรับ Explicit Context Caching โดยรองรับเฉพาะ Implicit Caching ที่มีขั้นต่ำ 4,096 โทเค็น ซึ่งส่งผลต่อการวางแผนต้นทุนเมื่อส่งพรอมป์ต์ขนาดยาวซ้ำ
วิธีเรียกใช้งาน Gemini 4 Carbon บน Felo
Felo แนะนำ Messages API เป็นช่องทางสำหรับเรียกใช้งานโมเดลนี้ Endpoint รองรับรูปแบบคำขอที่เข้ากันได้กับ Anthropic ที่ https://openapi.felo.ai/api/v1/messages และ Model ID คือ gemini-4-carbon
ขั้นตอนการใช้งานเหมือนกับโมเดลอื่นบน Felo:
- สร้าง Felo API Key สร้างคีย์ใน Felo Console และจัดเก็บไว้ในตัวแปร
FELO_API_KEYห้าม Commit คีย์ลง Repository หรือวางคีย์ไว้ใน Log - ทดสอบใน Playground ก่อน Gemini 4 Carbon Playground ช่วยให้คุณทดลองพรอมป์ต์ก่อนเริ่มเขียนโค้ด
- ส่งคำขอขนาดเล็ก เริ่มจากพรอมป์ต์สั้น ๆ และตรวจสอบรูปแบบการตอบกลับ
- เพิ่ม Streaming กำหนด
stream: trueสำหรับ Server-Sent Events ซึ่งมีความสำคัญเมื่อเอาต์พุตหนึ่งช่วงอาจมีขนาดถึง 65,536 โทเค็น - ทดสอบด้วยงานที่เป็นตัวแทนของการใช้งานจริง ใช้ขนาดอินพุต เกณฑ์การประเมิน และระดับการคิดอย่างน้อยสองระดับตามงานจริงก่อนนำไปใช้ใน Pipeline
ตัวอย่างคำขอ Python ขั้นต่ำ:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
มีข้อควรทราบสองประการในการเชื่อมต่อระบบ ประการแรก โมเดลนี้รองรับการให้เหตุผล ควรเก็บรักษาข้อมูลเมตาของการให้เหตุผลที่ได้รับกลับมาเมื่อต้องดำเนินบทสนทนาต่อ มิฉะนั้นโมเดลอาจสูญเสียบริบทที่ต้องใช้ ประการที่สอง max_tokens เป็นขีดจำกัดต่อช่วง ไม่ใช่ขีดจำกัดเอาต์พุตทั้งหมด สำหรับเอาต์พุตขนาดยาว ให้ใช้กลไก Continuation ที่ SDK รองรับ แทนการเพิ่มตัวเลขและคาดหวังว่าโมเดลจะสร้างเอกสารได้ตามต้องการ
Felo ยังมีเอกสารเกี่ยวกับ Chat Completions และ Responses Endpoint ที่รองรับรูปแบบ OpenAI สำหรับโมเดลที่ใช้งานร่วมกันได้ เนื่องจากหน้าโมเดลแนะนำ Messages API สำหรับ Carbon ควรตรวจสอบช่องทางที่รองรับจาก หน้าโมเดล ก่อนปรับแก้ไคลเอนต์ที่ใช้ OpenAI
Gemini 4 Carbon มีค่าใช้จ่ายเท่าไรบน Felo
Felo ให้บริการ Gemini 4 Carbon ผ่านผู้ให้บริการ Google ห้าราย โดยทุกเส้นทางแสดงส่วนลด 50% ในขณะนี้ ราคาด้านล่างคิดต่อโทเค็นหนึ่งล้านรายการ พร้อมแสดงราคามาตรฐานและราคาหลังส่วนลด
| เส้นทาง | อินพุต | เอาต์พุต | Cache Read |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
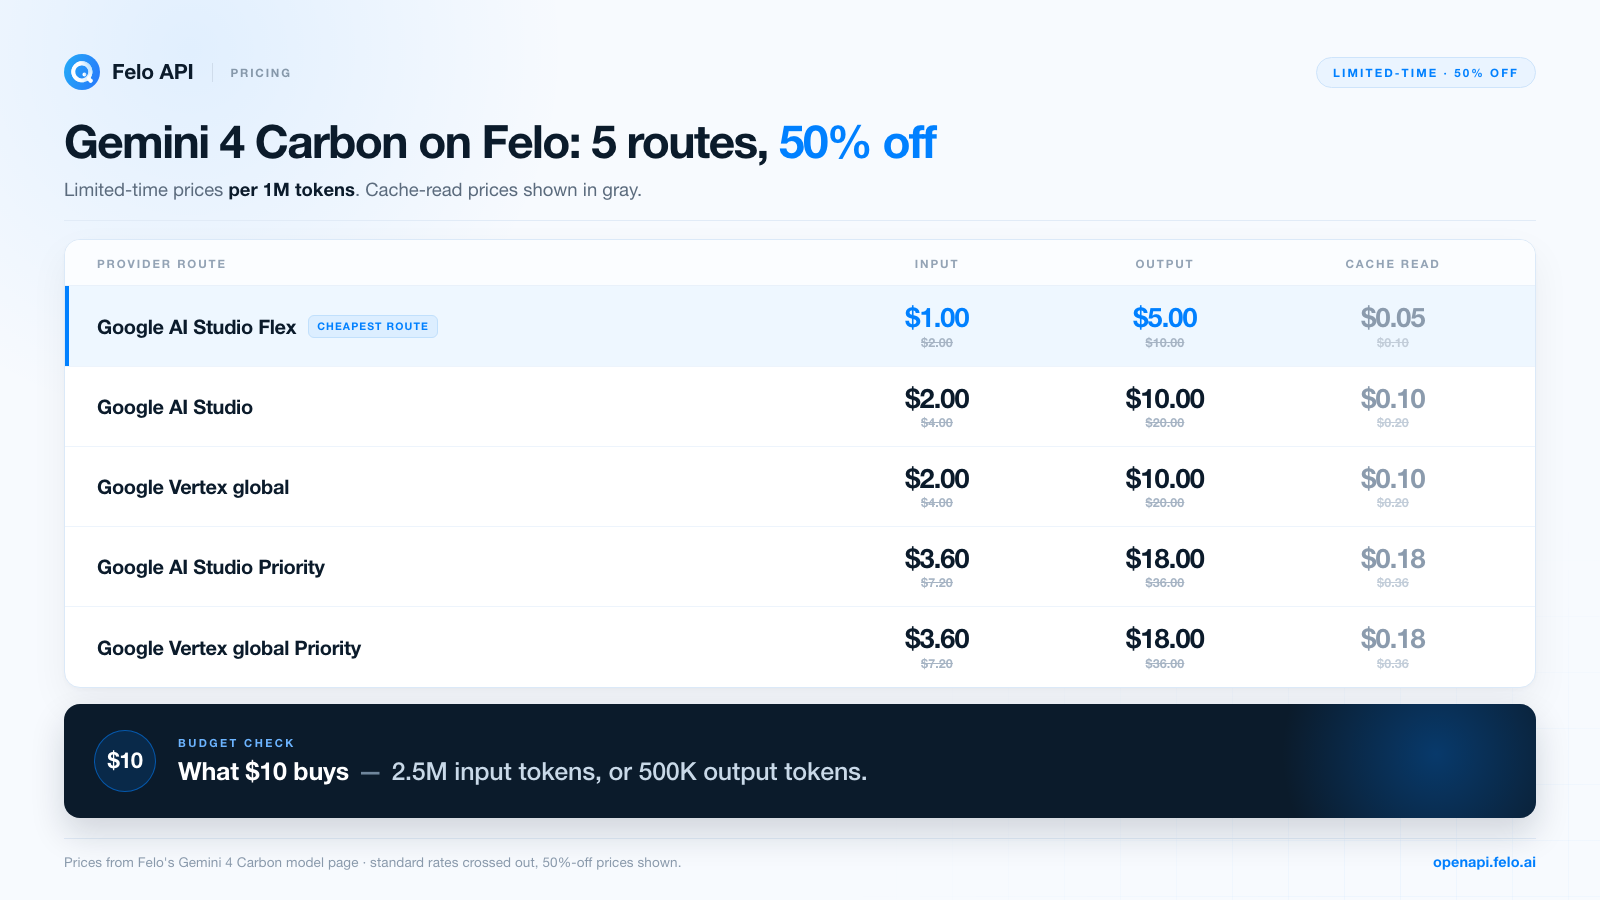
หน้าราคาของ Felo แปลงอัตรามาตรฐานเป็นตัวอย่าง "เงิน $10 ซื้ออะไรได้บ้าง" โดยคิดเป็นอินพุตประมาณ 2.5 ล้านโทเค็น หรือเอาต์พุต 500,000 โทเค็น ก่อนหักส่วนลด ตัวเลขนี้มีประโยชน์สำหรับการประเมินขนาดโครงการทดลอง หากการทดสอบส่งชุดเอกสารที่มีขนาด 100,000 โทเค็น และได้รับคำตอบ 5,000 โทเค็น จะมีค่าใช้จ่ายประมาณ $0.13 บนเส้นทาง Flex หลังหักส่วนลด แบ่งเป็น $0.10 สำหรับอินพุต และ $0.025 สำหรับเอาต์พุต ซึ่งเป็นต้นทุนที่ต่ำพอสำหรับการทดลองหลายสิบครั้งก่อนตัดสินใจ
การทดลองใช้งานฟรีเป็นข้อเสนอแยกจากส่วนลดราคา หน้าโมเดลของ Felo แสดง Gemini 4 Carbon พร้อมข้อเสนอทดลองใช้งานฟรีในช่วงเวลาจำกัด ซึ่งเป็นช่องทางทดสอบโมเดลโดยไม่ต้องใช้เครดิตได้เร็วที่สุด ตรวจสอบ เงื่อนไขปัจจุบันบนหน้าโมเดล เนื่องจากระยะเวลาทดลองใช้งานและส่วนลดราคาเป็นข้อเสนอที่มีระยะเวลาจำกัดและอาจเปลี่ยนแปลงได้
การวางแผนค่าใช้จ่ายสำหรับโมเดลนี้ต้องเพิ่มแนวปฏิบัติอีกหนึ่งข้อ เนื่องจากโทเค็นสำหรับการคิดคิดค่าบริการในอัตราเดียวกับเอาต์พุต การทำงานของ Agent ที่ใช้ระดับ HIGH อาจมีค่าใช้จ่ายสูงกว่าที่คำตอบซึ่งแสดงบนหน้าจอบ่งบอกหลายเท่า ควรบันทึกปริมาณโทเค็นของแต่ละงาน รวมถึงโทเค็นสำหรับการให้เหตุผล และเปรียบเทียบต้นทุนต่อผลลัพธ์ที่ผ่านการยอมรับแทนต้นทุนต่อคำขอ
ข้อจำกัดและสิ่งที่ควรตรวจสอบก่อนตัดสินใจใช้งาน
Carbon เป็นโมเดลระดับแนวหน้าที่มีข้อจำกัดที่ระบุไว้ในเอกสาร ข้อจำกัดที่มีความสำคัญต่อการวางแผนระบบ Production ได้แก่
- Hallucination (การสร้างข้อมูลที่ไม่มีอยู่จริง) Google ระบุว่านี่เป็นข้อจำกัดที่ทราบแล้ว Context ขนาดยาวช่วยลดโอกาสที่โมเดลจะพลาดข้อมูล แต่ไม่ได้รับประกันการตีความที่ถูกต้อง เวิร์กโฟลว์ที่ต้องอ้างอิงและตรวจสอบหลักฐานยังคงเป็นสิ่งจำเป็น
- Latency และ Timeout Google ระบุว่าอาจเกิดความล่าช้าและปัญหา Timeout เป็นบางครั้ง การทำงานระดับ HIGH ที่ใช้เวลานานต้องกำหนด Timeout ให้เพียงพอ รองรับการลองใหม่ และจัดการงานแบบ Idempotent
- การใช้โทเค็นที่สูงขึ้น โมเดลใช้โทเค็นสำหรับการคิดมากกว่า Argon โดยเฉพาะในระดับการคิดที่สูงขึ้น ควรจัดสรรงบประมาณให้เหมาะสมและจำกัดความพยายามสำหรับงานทั่วไป
- ข้อมูลความรู้สิ้นสุดที่เดือนมีนาคม 2026 ข้อมูลที่ใหม่กว่านั้นต้องอาศัย Retrieval หรือแหล่งข้อมูลปัจจุบัน Carbon ไม่มีข้อมูลเกี่ยวกับเหตุการณ์หลังวันที่ดังกล่าว
- Sampling แบบค่าคงที่ ไม่สามารถปรับ Temperature, top-p และ top-k ได้ หาก Pipeline ต้องการเอาต์พุตที่มีความแน่นอน ควรใช้โมเดลอื่นในขั้นตอนนั้น
- ไม่รองรับ Explicit Caching, Tuning, RAG Engine หรือ Live API ความสามารถเหล่านี้ต้องย้ายไปจัดการในชั้น Application
- ข้อจำกัดด้านความพร้อมใช้งาน Google เปิดให้ลูกค้าองค์กรที่ผ่านการยืนยันใช้งานในบางภูมิภาค ส่วน Felo ให้บริการผ่านผู้ให้บริการในระดับ Global, US และ EU ควรตรวจสอบเส้นทางและเงื่อนไขที่ใช้กับกรณีการใช้งานของคุณ
- กฎด้านความปลอดภัยและการเข้าถึง รุ่น Cyber จำกัดการใช้งานผ่าน Allowlist และเวิร์กโฟลว์ด้านความปลอดภัยต้องได้รับอนุญาต มาตรการป้องกันของโมเดลและนโยบายของผู้ให้บริการยังคงมีผลบังคับใช้
สรุป: คุณควรเลือกใช้หรือไม่
เลือก Gemini 4 Carbon เมื่องานมีขนาดใหญ่ หลักฐานมีความซับซ้อน และคำตอบที่ผิดพลาดมีต้นทุนสูง เช่น แผนการย้ายระบบ การตรวจสอบความปลอดภัย การสังเคราะห์งานวิจัย การวิเคราะห์การเงินหรือกฎหมาย หรือ Agent ที่ต้องสืบค้นข้อมูลก่อนดำเนินการ โปรไฟล์ Benchmark และงบประมาณแบบรวมของโมเดลได้รับการออกแบบมาสำหรับงานลักษณะนี้
อย่าใช้โมเดลนี้เป็นค่าเริ่มต้นสำหรับทุกคำขอ งานจัดประเภทข้อมูลปริมาณมาก การดึงข้อมูลสั้น ๆ การสรุปเนื้อหาทั่วไป และงานที่ต้องการ Sampling แบบกำหนดแน่นอน เหมาะกับโมเดลที่มีราคาถูกกว่าและตอบสนองเร็วกว่า โมเดลที่มีต้นทุนต่ำที่สุดและผ่านเกณฑ์คุณภาพของคุณมักเป็นตัวเลือกที่เหมาะสมที่สุด ส่วน Carbon ควรได้รับเลือกสำหรับงานส่วนที่ยากที่สุดในระบบของคุณ
สรุปตามข้อเท็จจริง: Carbon คือโมเดลที่มีความสามารถสูงที่สุดของ Google สำหรับงานเชิงลึก มีจุดแข็งที่ผ่านการวัดผลในด้านความปลอดภัย กฎหมาย การเงิน และการให้เหตุผลด้วยบริบทยาว แต่มีต้นทุนด้านเวลาและจำนวนโทเค็น รวมถึงข้อจำกัดที่ระบุไว้ชัดเจน ซึ่งทำให้การตรวจสอบผลลัพธ์เป็นสิ่งที่ขาดไม่ได้ ควรทดสอบกับงานของคุณเองก่อนสร้างระบบโดยอาศัยโมเดลนี้
คำถามที่พบบ่อย
Gemini 4 Carbon บน Felo มีให้ทดลองใช้งานฟรีหรือไม่
มี Felo แสดงข้อเสนอทดลองใช้งาน Gemini 4 Carbon ฟรีในช่วงเวลาจำกัด และอัตราค่าบริการจากผู้ให้บริการของโมเดลยังได้รับส่วนลดในช่วงที่ข้อเสนอมีผล เงื่อนไขอาจเปลี่ยนแปลงได้ โปรดตรวจสอบ หน้าโมเดล Gemini 4 Carbon เพื่อดูสถานะและรายละเอียดล่าสุด
Gemini 4 Carbon แตกต่างจาก Gemini 4 Argon อย่างไร
Carbon พัฒนาต่อยอดจาก Argon และได้รับการปรับแต่งเพื่อการให้เหตุผลที่ลึกซึ้งขึ้น ใช้งบประมาณรวม 1,048,576 โทเค็น ครอบคลุมอินพุต การคิด การเรียกใช้เครื่องมือ และเอาต์พุต รองรับระดับการคิด LOW, MEDIUM และ HIGH ใช้โทเค็นสำหรับการคิดมากขึ้น เพิ่มการรองรับไฟล์ Office/OpenDocument และมีจุดเน้นด้านความปลอดภัยที่แข็งแกร่งขึ้น ส่วน Argon ยังคงเหมาะกับการสร้างเนื้อหาขนาดยาวที่ความยาวของเอาต์พุตมีความสำคัญมากกว่าความลึกของการตรวจสอบ
Context Window และเอาต์พุตสูงสุดของ Gemini 4 Carbon มีขนาดเท่าไร
งบประมาณรวมมีขนาด 1,048,576 โทเค็น ครอบคลุมทั้งอินพุตและเอาต์พุต การสร้างเอาต์พุตหนึ่งช่วงแบบ Streaming รองรับสูงสุด 65,536 โทเค็น หรือ 32,768 โทเค็นเมื่อไม่ใช้ Streaming และ Long Decodes ช่วยสร้างเอาต์พุตต่อได้จนถึงขีดจำกัดของงบประมาณที่เหลือ Felo ระบุเอาต์พุตสูงสุดบนเส้นทางของตนที่ 943.718K โทเค็น
Gemini 4 Carbon อ่านไฟล์เสียง วิดีโอ และ Office ได้หรือไม่
ได้ โมเดลรองรับข้อความ รูปภาพ เสียง วิดีโอ PDF และไฟล์ Office/OpenDocument โดยมีขีดจำกัดเสียงประมาณ 8.4 ชั่วโมง วิดีโอประมาณ 45–60 นาที รูปภาพและเอกสารรวมกัน 3,000 รายการ และเอกสารสูงสุด 3,000 หน้าต่อไฟล์ เอาต์พุตรองรับเฉพาะข้อความ
Gemini 4 Carbon รองรับ API ที่เข้ากันได้กับ OpenAI หรือไม่
Felo แนะนำ Messages API ที่เข้ากันได้กับ Anthropic สำหรับโมเดลนี้ และยังมีเอกสารเกี่ยวกับ Chat Completions และ Responses Endpoint ที่เข้ากันได้กับ OpenAI สำหรับโมเดลที่รองรับ ควรตรวจสอบช่องทางที่ใช้งานได้จากหน้าโมเดลก่อนปรับแก้ไคลเอนต์เดิม
Gemini 4 Carbon มีค่าใช้จ่ายเท่าไร
Felo แสดงเส้นทาง Google ห้ารายการ ซึ่งทั้งหมดได้รับส่วนลด 50% ในขณะนี้ ได้แก่ AI Studio Flex ราคาอินพุต $1 / เอาต์พุต $5 ต่อหนึ่งล้านโทเค็น เส้นทาง AI Studio และ Vertex มาตรฐานราคา $2 / $10 และเส้นทาง Priority ราคา $3.60 / $18 ส่วน Cache Read เริ่มต้นที่ $0.05 ต่อหนึ่งล้านโทเค็น ดู หน้าราคาของ Felo สำหรับอัตราค่าบริการปัจจุบัน
Gemini 4 Carbon เปิดตัวเมื่อใด
Google ประกาศเปิดตัว Gemini 4 Carbon เมื่อวันที่ 28 ตุลาคม 2026 โดยเปิดให้ผู้เชี่ยวชาญด้านการป้องกันภัยไซเบอร์บางส่วนใช้งานเป็นกลุ่มแรกผ่าน Fairwind Program แพลตฟอร์มสำหรับองค์กรของ Google ระบุว่าเริ่มเปิดให้ใช้งานทั่วไปตั้งแต่วันที่ 10 พฤศจิกายน 2026 ปัจจุบัน Felo ให้บริการโมเดลนี้ผ่านผู้ให้บริการ Google ห้าราย
ทดลองใช้ Gemini 4 Carbon บน Felo
วิธีประเมิน Carbon ที่ตรงที่สุดคือมอบหมายงานที่คุณทราบคำตอบอยู่แล้วให้โมเดล เปิด Gemini 4 Carbon Playground วางเอกสารหรือชุดโค้ดจากงานจริง แล้วเปรียบเทียบระดับการคิด LOW และ HIGH ด้วยพรอมป์ต์เดียวกัน หากผลลัพธ์ผ่านเกณฑ์ ให้สร้างคีย์ API และนำการทดสอบเข้าสู่ Pipeline ของคุณ
เริ่มจาก หน้าโมเดล Gemini 4 Carbon เพื่อดูเงื่อนไขการทดลองใช้งาน เส้นทางผู้ให้บริการ และขีดจำกัดล่าสุด จากนั้นสร้างการทดสอบขนาดเล็กที่สุดสำหรับงานที่ยากที่สุดซึ่งคุณต้องจัดการ
บทความนี้มีให้อ่านในภาษาต่อไปนี้ด้วย: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, Español, বাংলা and Português