GPT-6 Astra บน Felo OpenAPI: หน้าต่างบริบท 1.05M และเครื่องมือ Agent

Felo OpenAPI เพิ่ม GPT-6 Astra พร้อมหน้าต่างบริบท 1.05M, ผลลัพธ์สูงสุด 128K และรองรับ Chat Completions, Responses และ Messages endpoint
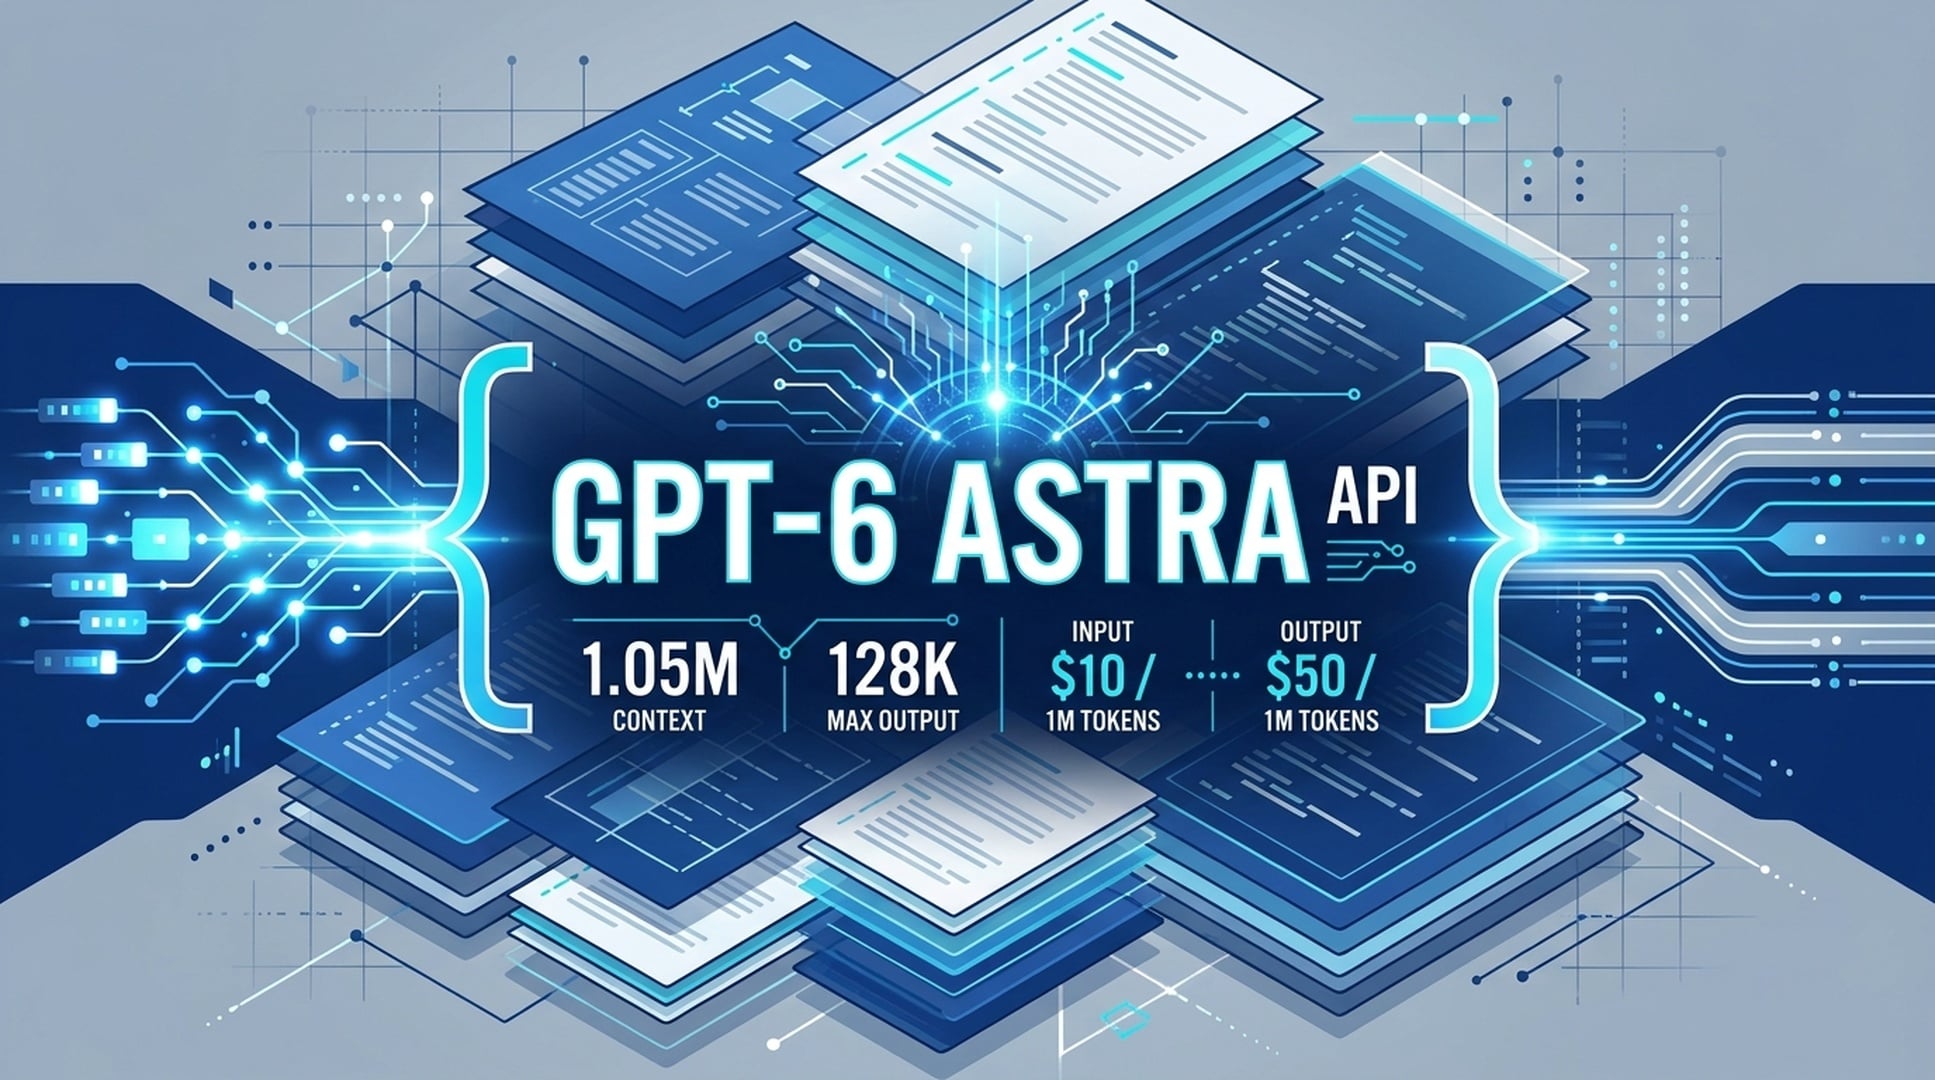
เอกสารยาว โค้ดซับซ้อน และกระบวนการหลายขั้นตอนของ agent ทำให้ทีมต้องแบ่งการเรียกโมเดล Felo OpenAPI ให้ GPT-6 Astra เพื่อให้โมเดลเดียวจัดการงานเหล่านี้ผ่าน API ที่รองรับ
ทดลองใช้ GPT-6 Astra: https://openapi.felo.ai/models/openai/gpt-6-astra
GPT-6 Astra สร้างมาเพื่ออะไร
GPT-6 Astra เป็นระดับสูงสุดของ GPT-6 บน Felo API Platform OpenAI อธิบายว่าโมเดลนี้มีความสามารถสูงสุดสำหรับการให้เหตุผลที่ซับซ้อน การเขียนโค้ด การใช้งานคอมพิวเตอร์ งานวิจัย และการสร้างเอกสาร หน้าโมเดลของ Felo ระบุความสามารถ Reasoning, Tools, JSON, Streaming และ Vision
ใช้ model ID gpt-6-astra หน้าต่างบริบท 1,050,000 tokens และผลลัพธ์สูงสุด 128,000 tokens OpenAI ระบุ cutoff ความรู้ 30 เมษายน 2026 ความจุนี้ให้คำขอใส่ข้อกำหนด สรุปโค้ด ฐานข้อมูลเครื่องมือ และประวัติสนทนาในบริบทเดียว
OpenAI ระบุการตั้งค่าความพยายามในการให้เหตุผล 5 ระดับ: low, medium, high, xhigh, และ max เลือกค่าที่ตรงกับเป้าหมายคุณภาพ งบประมาณเวลา และต้นทุนคำขอ
ประกาศของ OpenAI ระบุว่า GPT-6 Astra เริ่มให้บริการกับองค์กรใน Trusted Access Program โดย Plus, Pro, Business และ Enterprise จะเข้าถึงได้ในวันถัดไป Felo OpenAPI ให้เส้นทางโมเดลสำหรับนักพัฒนาที่ต้องการ API ผ่านแพลตฟอร์ม
สามโปรโตคอล โมเดลเดียว
Felo API Platform เปิดรับคำขอผ่านสามพื้นผิวที่รองรับ:
- Chat Completions:
POST https://openapi.felo.ai/api/v1/chat/completions - Responses:
POST https://openapi.felo.ai/api/v1/responses - Messages:
POST https://openapi.felo.ai/api/v1/messages
แอปที่ใช้ client ที่รองรับ OpenAI สามารถคงโครงสร้างคำขอและเปลี่ยนค่า model เป็น gpt-6-astra client แบบ Claude ใช้พื้นผิว Messages ที่รองรับ Anthropic หน้าโมเดลระบุกรณีใช้งาน Claude Code, Codex, LLM API และ agent client อื่น
ราคาเหมาะกับงบประมาณ
หน้าโมเดล Felo ปัจจุบันระบุอัตรานี้:
| รายการ | อัตรา |
|---|---|
| Input | $10.00 ต่อ 1M tokens |
| Output | $50.00 ต่อ 1M tokens |
หน้าระบุว่าราคาเปิดตัวอาจต่ำกว่าราคา API ของผู้ให้บริการถึง 50% ต้นทุนสุดท้ายขึ้นกับโมเดล สัดส่วน input/output การใช้ cache และแผนที่ใช้งาน หน้า Felo ปัจจุบันระบุ $10.00 / 1M input tokens และ $50.00 / 1M output tokens การประมาณต้นทุนรวมทุกตัวแปร อัตราหลักไม่ใช่ยอดบิลทั้งหมด
เอกสารโมเดลของ OpenAI ระบุอัตรามาตรฐาน $10.00 ต่อ 1M input tokens, $1.00 ต่อ 1M cached input tokens, และ $50.00 ต่อ 1M output tokens การเขียน cache ใช้อัตรา input ที่ไม่ได้ cache 1.25x คำขอเกิน 272K input tokens ใช้อัตรา input และ cache 2x และ output 1.5x สำหรับคำขอเต็ม Batch และ Flex ใช้ 50% ของอัตรามาตรฐาน Fast mode ใช้ 2x ของอัตราที่เกี่ยวข้อง นี่คืออัตราอ้างอิงของ OpenAI ไม่ใช่ราคาที่แทนแผน Felo ข้างต้น
| แหล่งราคา | Input | Cached input | Output |
|---|---|---|---|
| หน้าโมเดล Felo | $10.00 / 1M | หน้าระบุอัตรา cached-input และ cache-write | $50.00 / 1M |
| คู่มือโมเดล OpenAI | $10.00 / 1M | $1.00 / 1M | $50.00 / 1M |
ขอครั้งแรกใน 5 ขั้นตอน
1. สร้าง API key
สร้าง key ในบัญชี Felo API Platform และตั้งเป็น environment variable:
export FELO_API_KEY="YOUR_API_KEY"
2. ตั้ง endpoint
สำหรับ Chat Completions ใช้:
https://openapi.felo.ai/api/v1/chat/completions
3. ตั้ง model ID
ส่ง "model": "gpt-6-astra" พร้อม array messages คำขอ cURL นี้ทดสอบเส้นทาง:
curl https://openapi.felo.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-astra",
    "messages": [{"role": "user", "content": "Explain this API error."}]
  }'
4. เพิ่มเครื่องมือหรือผลลัพธ์แบบโครงสร้าง
พารามิเตอร์ที่รองรับ ได้แก่ tools, tool_choice, และ response_format การรองรับแต่ละตัวควบคุมขึ้นกับโปรโตคอลและเส้นทางโมเดลที่เลือก GPT-6 Astra รองรับ reasoning เมื่อโปรโตคอลและเส้นทางเปิดเผยการควบคุม reasoning ให้เก็บ metadata reasoning ที่คืนเมื่อสนทนาต่อ
OpenAI ระบุเครื่องมือ Responses API สำหรับ GPT-6 Astra ได้แก่ web search, file search, image generation, code interpreter, hosted shell, apply patch, skills, computer use, MCP และ tool search ใช้ endpoint Responses เมื่อ workflow ต้องใช้เครื่องมือเหล่านี้ Felo เปิดเผยพื้นผิวและเครื่องมือที่เปิดใช้งานขึ้นกับเส้นทางที่ใช้งาน
5. เปิด streaming
ตั้งค่า stream เป็น true เพื่อรับ server-sent events:
{
  "model": "gpt-6-astra",
  "stream": true,
  "messages": [{"role": "user", "content": "Summarize this log."}]
}
เช็กลิสต์ก่อนใช้งาน
- ประมาณต้นทุน input เทียบกับหน้าต่างบริบท 1.05M
- ตั้งค่า
max_tokensเพื่อควบคุมผลลัพธ์ให้อยู่ในงบโครงการ - บันทึกข้อมูล input, output, cache และแผนสำหรับแต่ละคำขอที่ประมาณ
- ทดสอบ prompt ใน Playground ก่อนเชื่อมต่อแอปหรือ agent client
- เก็บตัวอย่าง regression สำหรับเครื่องมือ ผลลัพธ์ JSON และ streaming
- ตั้งค่า
reasoning_effortให้อยู่ในระดับที่รองรับและบันทึกพร้อมข้อมูล latency และต้นทุน - ใช้กฎราคาของ OpenAI เพื่อเปรียบเทียบ ใช้แผนและเส้นทาง Felo สำหรับประมาณยอดที่ต้องจ่าย
เริ่มต้นที่หน้าโมเดล
GPT-6 Astra รวม reasoning, coding, การวิเคราะห์บริบทยาว และงาน agent ไว้ในโมเดลเดียว Felo OpenAPI ให้ทีมย้ายผ่าน Chat Completions, Responses และ Messages client ที่มีอยู่ยังคงใช้งานได้เมื่อพื้นผิวคำขอเปลี่ยนตามงาน
เปิด หน้าโมเดล GPT-6 Astra เพื่อดูพารามิเตอร์ ตัวอย่างโค้ด และ Playground
แหล่งข้อมูล: หน้าโมเดล GPT-6 Astra บน Felo API Platform, ประกาศ GPT-6 Astra ของ OpenAI, และ คู่มือโมเดล GPT-6 Astra ของ OpenAI (เข้าถึง 2026-09-04) ตรวจสอบราคาของ Felo อีกครั้งเมื่อ 2026-09-04