
GPT Image 2.6 บน Felo: เปลี่ยน GIF ให้เป็นช็อตวิดีโอ

GPT Image 2.6 บน Felo: สร้าง GIF แบบวนซ้ำ สร้างเฟรมแอ็กชันด้วย API แล้วนำไปสร้างภาพเคลื่อนไหวด้วย Kling พร้อมตัวอย่างโค้ดและข้อจำกัด
เมื่อขอให้โมเดลวิดีโอสร้างภาพ "อัศวินกำลังเหวี่ยงดาบ" ผลลัพธ์ที่ได้มักเป็นการเหวี่ยงดาบในความหมายกว้าง ๆ ใบมีดเบลอเป็นคราบ สัดส่วนร่างกายเปลี่ยนไประหว่างเฟรม และกล้องสร้างการเคลื่อนไหวที่ไม่มีใครร้องขอ
ผู้กำกับแก้ปัญหานี้ด้วยการจัดวางฉากและการเคลื่อนไหว (Blocking) ซึ่งกำหนดว่าตัวละครยืนอยู่ตรงไหน อะไรเคลื่อนไหวก่อน และการเคลื่อนไหวสิ้นสุดที่จุดใด GPT Image 2.6 บน Felo ช่วยสร้างแผนการเคลื่อนไหวในรูปแบบ GIF วนซ้ำความยาว 1.8 วินาทีผ่านเบราว์เซอร์ หรือสร้างเป็นชีตเฟรมขนาด 3 × 3 ผ่าน Image API ทั้งสองวิธีมีค่าใช้จ่ายต่ำกว่าการให้โมเดลวิดีโอสร้างแสง จัดองค์ประกอบภาพ และใส่เสียงประกอบ ก่อนที่คุณจะตัดสินใจเกี่ยวกับแอ็กชันเสียอีก
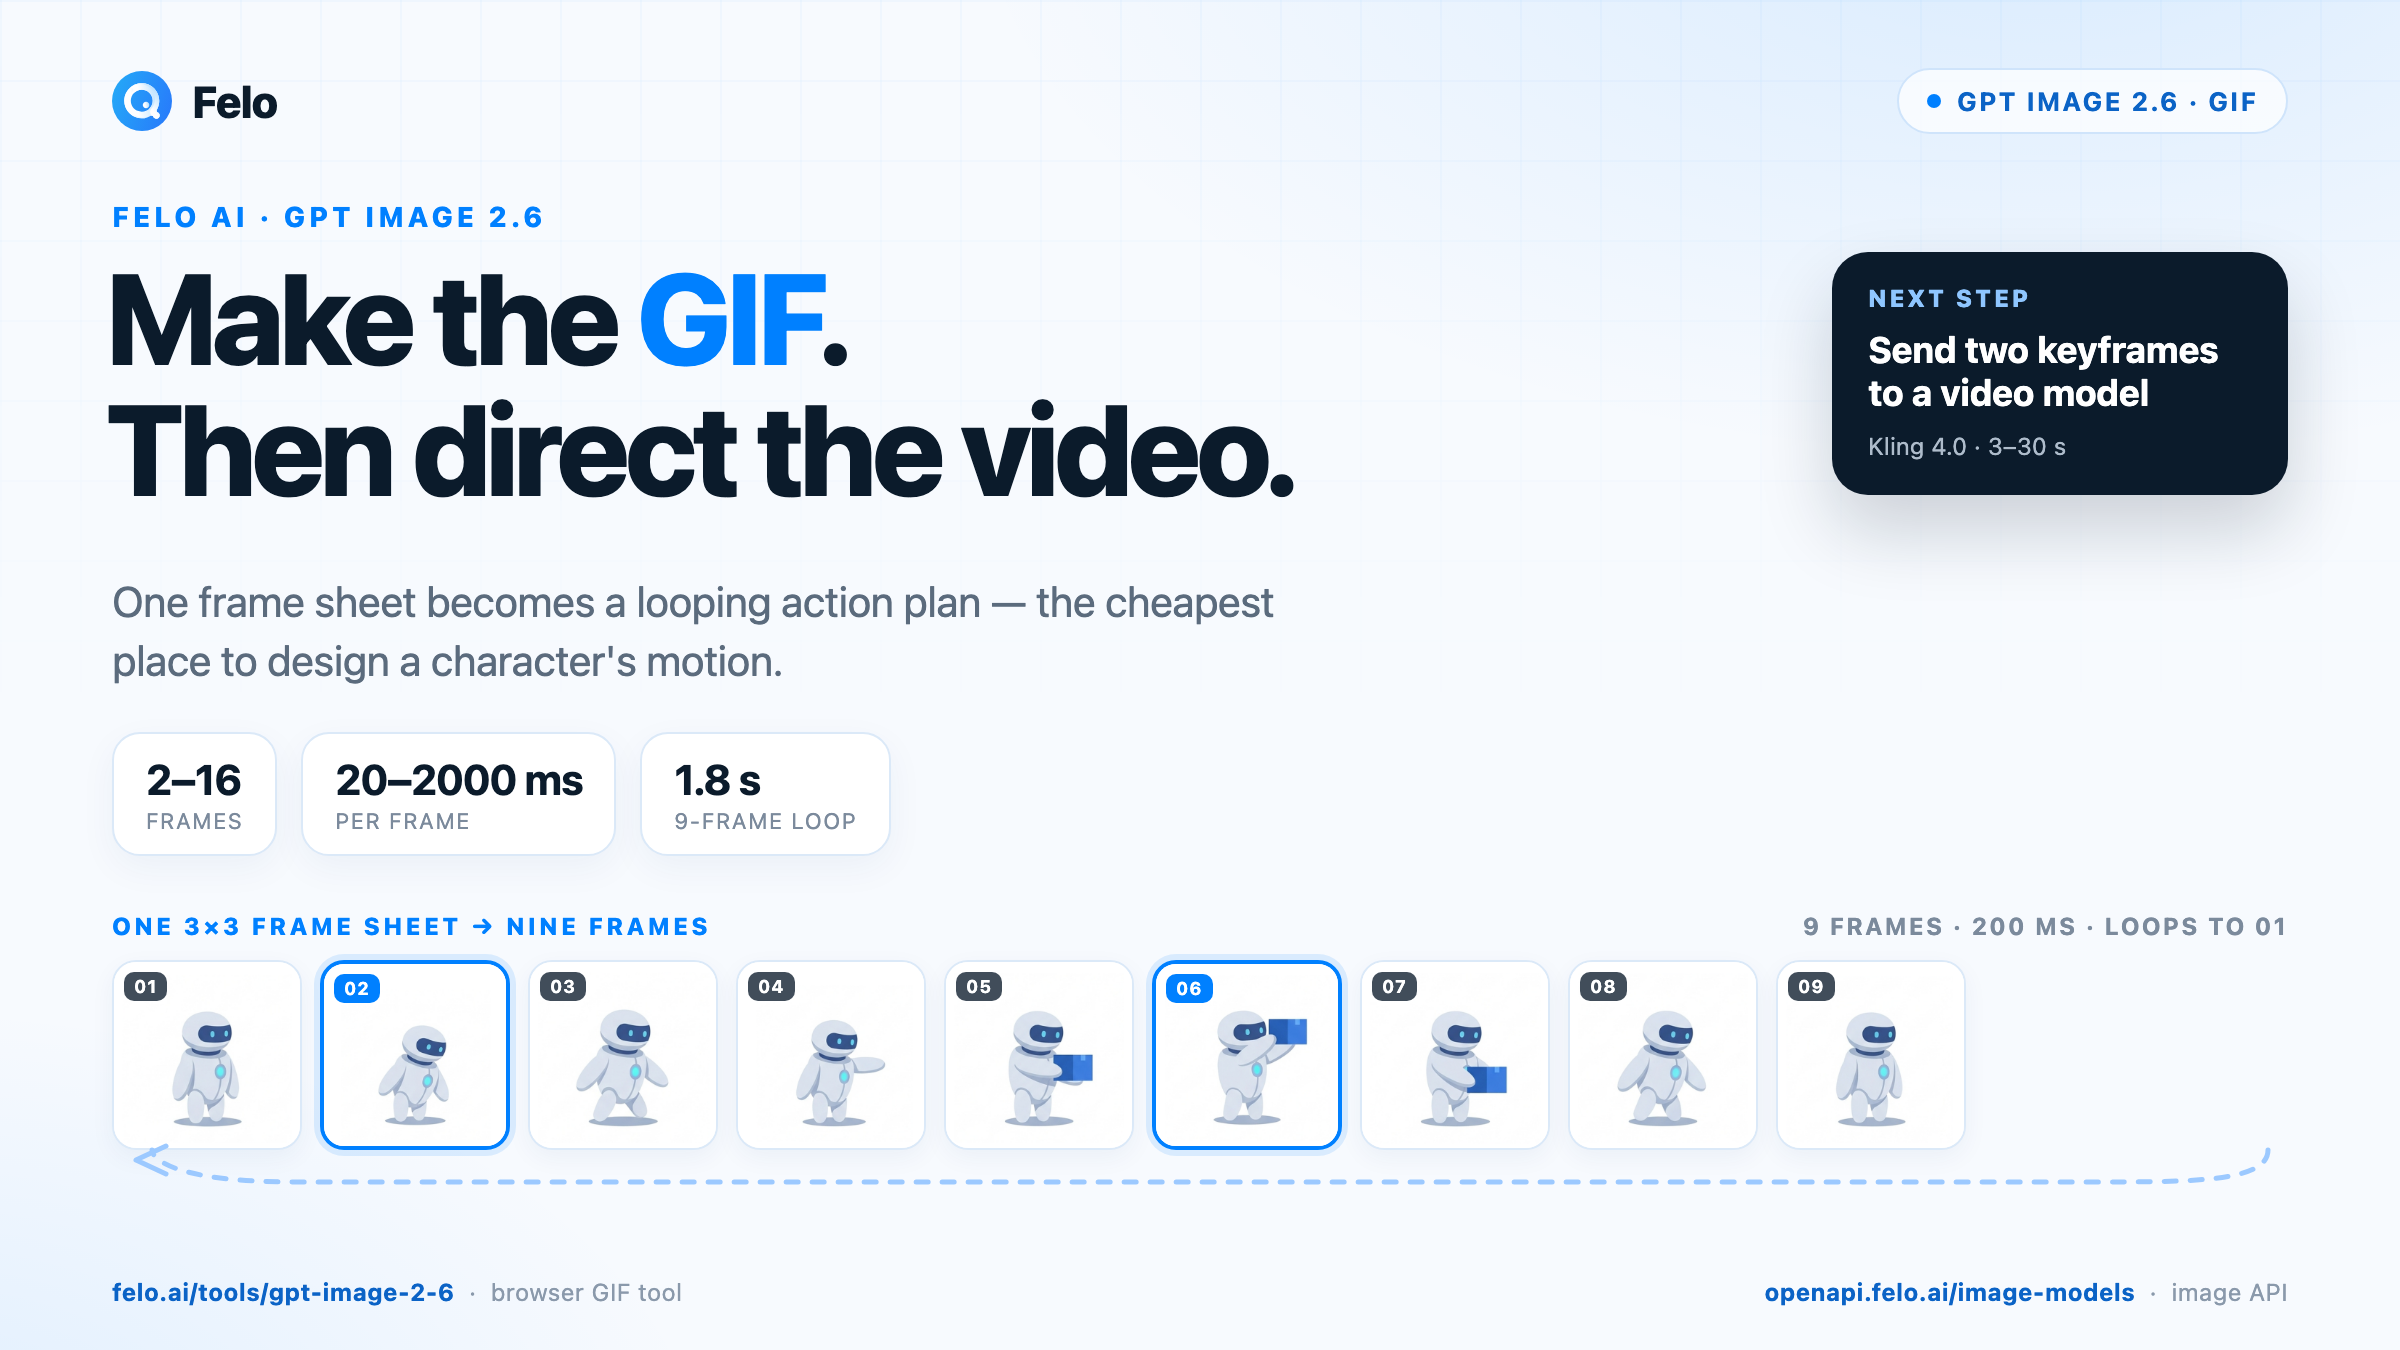
สองวิธีใช้งาน GPT Image 2.6 บน Felo
ใช้งานผ่านเบราว์เซอร์: เครื่องมือสร้าง GIF ด้วย AI
เปิด felo.ai/tools/gpt-image-2-6 อธิบายภาพที่ต้องการ และเลือกรุ่นโมเดล ช่องป้อนข้อมูลตั้งค่าเริ่มต้นเป็น GPT Image 2.6 Flare และรูปแบบไฟล์ PNG หากต้องการสร้างภาพเคลื่อนไหว ให้เปิดการตั้งค่าและเลือก GIF การพิมพ์คำว่า "GIF" ในพรอมต์เพียงอย่างเดียวไม่เปลี่ยนรูปแบบไฟล์ผลลัพธ์
การควบคุม GIF ถูกกำหนดขอบเขตไว้ดังนี้: จำนวน 2 ถึง 16 เฟรม ระยะเวลา 20 ถึง 2000 มิลลิวินาทีต่อเฟรม และขนาดเฟรมเริ่มต้น 512 × 512 พิกเซล Felo ตั้งค่าเริ่มต้นเป็น 9 เฟรม เฟรมละ 200 มิลลิวินาที ซึ่งสร้าง GIF วนซ้ำความยาว 1.8 วินาที ระยะเวลานี้อาจดูสั้น และก็สั้นจริง แต่เพียงพอสำหรับตรวจสอบว่าท่าทางสื่อความหมายได้หรือไม่
คุณสามารถอัปโหลดภาพอ้างอิง ขอให้แก้ไขภาพ หรือใช้เครื่องมือร่างเพื่อกำหนดพื้นที่ที่ต้องการแก้ไข สำหรับการทดสอบแอ็กชันครั้งแรก ให้ใช้ตัวแบบเพียงหนึ่งตัว ฉากหลังเรียบ และการเคลื่อนไหวหนึ่งรูปแบบ
ภาพประกอบผลลัพธ์: GIF วนซ้ำ 9 เฟรม เฟรมละ 200 มิลลิวินาที เครื่องมือบนเบราว์เซอร์สร้างไฟล์ GIF โดยตรง ส่วนเวิร์กโฟลว์สำหรับเอเจนต์ด้านล่างจะสร้างเฟรมชุดเดียวกันจากชีตภาพขนาด 3 × 3 หนึ่งชุด
ใช้งานผ่าน API สำหรับเอเจนต์และแอปพลิเคชัน
โมเดลทั้งสองรุ่นอยู่ใน แคตตาล็อกภาพของ Felo ภายใต้ ID gpt-image-2.6-flare และ gpt-image-2.6-sunburst คีย์เดียวรองรับโมเดลภาพ 18 รุ่นจากผู้ให้บริการ 8 ราย เอเจนต์จึงสามารถเปรียบเทียบหรือเปลี่ยนโมเดลได้โดยไม่ต้องเปิดบัญชีแยกกับผู้ให้บริการแต่ละราย
| GPT Image 2.6 Flare | GPT Image 2.6 Sunburst | |
|---|---|---|
| ออกแบบมาเพื่อ | สร้างภาพร่างและแก้ไขหลายรอบ | สร้างภาพที่มีรายละเอียดและแก้ไขอย่างแม่นยำ |
| Model ID | gpt-image-2.6-flare | gpt-image-2.6-sunburst |
| อินพุต / เอาต์พุต | ข้อความ, รูปภาพ → รูปภาพ | ข้อความ, รูปภาพ → รูปภาพ |
| ประโยชน์สำหรับงานนี้ | สำรวจแนวคิดแอ็กชัน | รักษาความสม่ำเสมอของตัวละครในแต่ละช่องภาพ |
| ราคาที่ระบุ | $5 / 1M input tokens, $30 / 1M output tokens | $5 / 1M input tokens, $30 / 1M output tokens |
คิดราคาตามจำนวนโทเค็น ไม่ใช่ต่อภาพ ดังนั้นความละเอียดและภาพอ้างอิงจึงส่งผลต่อค่าใช้จ่าย หน้าข้อมูลของโมเดลทั้งสองแสดงป้ายทดลองใช้งานฟรีในช่วงเวลาจำกัด โปรดตรวจสอบข้อกำหนดและอัตราค่าบริการปัจจุบันก่อนวางแผนใช้งานจริง
เครื่องมือบนเบราว์เซอร์ส่งออกไฟล์ GIF ส่วน Image API ส่งคืนภาพนิ่ง ค่า output_format ของโมเดลเหล่านี้รองรับ png, jpeg หรือ webp ดังนั้นเอเจนต์จึงต้องสร้าง GIF จากเฟรมที่สร้างขึ้น ส่วน API ด้านล่างจะแสดงรูปแบบการทำงานนี้
ทำไม GIF จึงเป็นภาพร่างแรกที่ดีกว่าพรอมต์วิดีโอ
โมเดลวิดีโอทำงานด้วยการประมาณค่าระหว่างเฟรม (Interpolation) จุดแข็งของโมเดลเหล่านี้คือการเติมช่วงระหว่างสถานะสองสถานะ แต่การตัดสินใจว่าสถานะใดมีความสำคัญยังเป็นข้อจำกัด พรอมต์ข้อความให้ประโยคเดียวแก่โมเดลเพื่อตีความ ส่วน GIF เก้าเฟรมให้ข้อมูลการตัดสินใจเก้าจุดเกี่ยวกับท่าทาง รูปทรงเงา และจังหวะเวลา
ข้อจำกัดด้านจำนวนเก้าเฟรมยังบังคับให้ต้องเลือกสิ่งที่สำคัญ ที่ระยะเวลา 200 มิลลิวินาทีต่อเฟรม ไม่มีพื้นที่สำหรับคำอธิบายกว้าง ๆ อย่าง "ฉากแอ็กชันที่เต็มไปด้วยพลัง" คุณต้องระบุลำดับ เช่น ท่าเตรียมพร้อม การง้างแขน การโจมตี การเคลื่อนไหวต่อเนื่องหลังโจมตี และการกลับสู่ท่าเริ่มต้น พรอมต์วิดีโอที่อ่อนแอมักเกิดจากการไม่เคยตัดสินใจเรื่องลำดับการเคลื่อนไหวเหล่านี้
การวนซ้ำเพิ่มข้อจำกัดอีกประการ GIF ที่วนซ้ำได้อย่างราบรื่นต้องกลับสู่ท่าเริ่มต้น ซึ่งเป็นคุณสมบัติที่ช่วยให้ตัดต่อช็อตได้ง่าย หากแขนของตัวละครจบลงในตำแหน่งใหม่ ช็อตถัดไปก็จะเริ่มจากตำแหน่งร่างกายที่แตกต่างกัน
คุณสามารถตรวจสอบผลงานทั้งหมดได้ภายในไม่กี่วินาที ตรวจสอบรูปทรงเงา มือ อุปกรณ์ประกอบฉาก และรอยต่อระหว่างเฟรมสุดท้ายกับเฟรมแรก เอเจนต์สามารถเปรียบเทียบเฟรมหรือขอให้โมเดลด้านการมองเห็นอธิบายความเปลี่ยนแปลง ทั้งหมดนี้เกิดขึ้นก่อนจ่ายเงินเพื่อสร้างวิดีโอแม้แต่หนึ่งวินาที
หน้าเครื่องมือของ Felo ระบุไว้อย่างชัดเจนว่า "GIF เป็นภาพเคลื่อนไหววนซ้ำที่ไม่มีเสียง ใช้เครื่องมือวิดีโอเมื่อต้องการเสียง ฉากที่ยาว หรือหลายช็อต" ประโยคนี้เป็นจุดเริ่มต้นของเวิร์กโฟลว์นี้ ไม่ใช่จุดสิ้นสุด
สร้างแอ็กชันผ่านเบราว์เซอร์
ต่อไปนี้เป็นขั้นตอนสำหรับออกแบบการเคลื่อนไหวของตัวละครก่อนนำไปสร้างเป็นช็อตวิดีโอ
1. กำหนดลักษณะตัวละครให้คงที่ก่อน
อย่าเริ่มจากแอนิเมชัน สร้างภาพอ้างอิงของตัวละครในท่ายืนมองด้านหน้า ท่าทางเป็นกลาง และฉากหลังเรียบก่อน จากนั้นรักษารายละเอียดทุกอย่างในพรอมต์ให้เหมือนเดิมเมื่อสร้างภาพเคลื่อนไหว เช่น ทรงผม สีชุด เครื่องประดับ อาวุธ และสัดส่วนร่างกาย ความสม่ำเสมออาจเปลี่ยนไปเมื่อสร้างภาพแยกกัน ดังนั้นคำอธิบายที่มีรายละเอียดจะช่วยลดสิ่งที่โมเดลต้องคิดขึ้นเองระหว่างเฟรม
2. เขียนแอ็กชันให้เป็นลำดับวนซ้ำ ไม่ใช่ฉากหนึ่งฉาก
พรอมต์สำหรับแอ็กชันที่มีประสิทธิภาพประกอบด้วยสี่ส่วน:
- กำหนดฉาก มีอะไรอยู่ในเฟรม ตัวละครยืนอยู่ตรงไหน และมีลักษณะอย่างไร
- ระบุการเคลื่อนไหวหนึ่งรูปแบบ อะไรเคลื่อนไหว และเคลื่อนไหวตามลำดับใด
- กำหนดสิ่งที่ต้องคงที่ เช่น กล้อง เท้า โลโก้ และมือ
- ระบุการกลับสู่จุดเริ่มต้น จบด้วยการเคลื่อนไหวกลับไปยังท่าเริ่มต้น
ตัวอย่าง:
ผู้ส่งพัสดุสวมแจ็กเก็ตสีเหลืองมัสตาร์ดยืนอยู่บนถนนหินสีอ่อน มุมมองด้านข้าง เห็นร่างกายเต็มตัว กล้องอยู่กับที่ ตัวละครถ่ายน้ำหนักตัว เอื้อมมือเข้าไปในกระเป๋าสะพาย หยิบพัสดุสีน้ำเงินขนาดเล็กออกมา และยื่นพัสดุไปด้านหน้า รักษาแจ็กเก็ต กระเป๋าสะพาย และกล้องให้อยู่กับที่ จากนั้นลดพัสดุลงและกลับสู่ท่าเริ่มต้น ทำให้การเคลื่อนไหววนซ้ำได้อย่างราบรื่น ฉากหลังเรียบ ไม่มีข้อความ
พรอมต์นี้ตั้งใจให้เรียบง่าย ความเรียบง่ายเป็นข้อดีสำหรับงานนี้: แอ็กชันหนึ่งรูปแบบที่ชัดเจนสามารถสื่อความหมายได้ในขนาด 512 × 512 พิกเซล ด้วยเก้าเฟรม เก็บฉากที่มีฝูงชน ฝน และการเคลื่อนกล้องไว้สำหรับโมเดลวิดีโอ
3. เลือก GIF ในการตั้งค่าและเริ่มจากขนาดเล็ก
กำหนดขนาด 512 × 512 พิกเซล จำนวน 9 เฟรม และระยะเวลา 200 มิลลิวินาทีต่อเฟรม จากนั้นสร้างภาพ อย่าเพิ่มจำนวนเฟรมจนกว่าแอ็กชันพื้นฐานจะสื่อความหมายได้
เมื่อ GIF วนซ้ำไม่เป็นไปตามต้องการ ให้แก้ไขตามลำดับดังนี้: ลดจำนวนเฟรมและทำให้แอ็กชันเรียบง่ายก่อน จากนั้นเพิ่มระยะเวลาต่อเฟรม แล้วจึงเพิ่มรายละเอียดที่ต้องรักษาไว้
4. ตรวจสอบรอยต่อ ไม่ใช่แค่เฟรมตรงกลาง
ดู GIF วนซ้ำสองรอบ รอยต่อระหว่างเฟรมสุดท้ายกับเฟรมแรกเป็นจุดที่มักพบข้อผิดพลาด เช่น ไหล่กระโดดเปลี่ยนตำแหน่ง อุปกรณ์ประกอบฉากเปลี่ยนมือ หรือฉากหลังขยับ
จากนั้นเปลี่ยนตัวแปรทีละรายการ แนวคิดท่าทางใหม่หมายถึงพรอมต์ใหม่ การปรับจังหวะเวลาหมายถึงการเปลี่ยนจำนวนเฟรมหรือระยะเวลาต่อเฟรม การเปลี่ยนทั้งสองอย่างพร้อมกันทำให้ระบุไม่ได้ว่าสิ่งใดช่วยปรับปรุงผลลัพธ์
จาก GIF สู่ Video: สองวิธีส่งต่องาน
Video API ของ Felo ไม่รองรับอินพุต GIF แบบเคลื่อนไหว แต่รองรับภาพนิ่งหรือวิดีโอ ดังนั้นการส่งต่องานจึงต้องผ่านขั้นตอนการแปลงไฟล์หนึ่งขั้นตอน มีสองวิธีที่เหมาะกับงานนี้ และยังมีอีกวิธีหนึ่งที่ใช้ GIF เป็นไฟล์ส่งมอบขั้นสุดท้าย
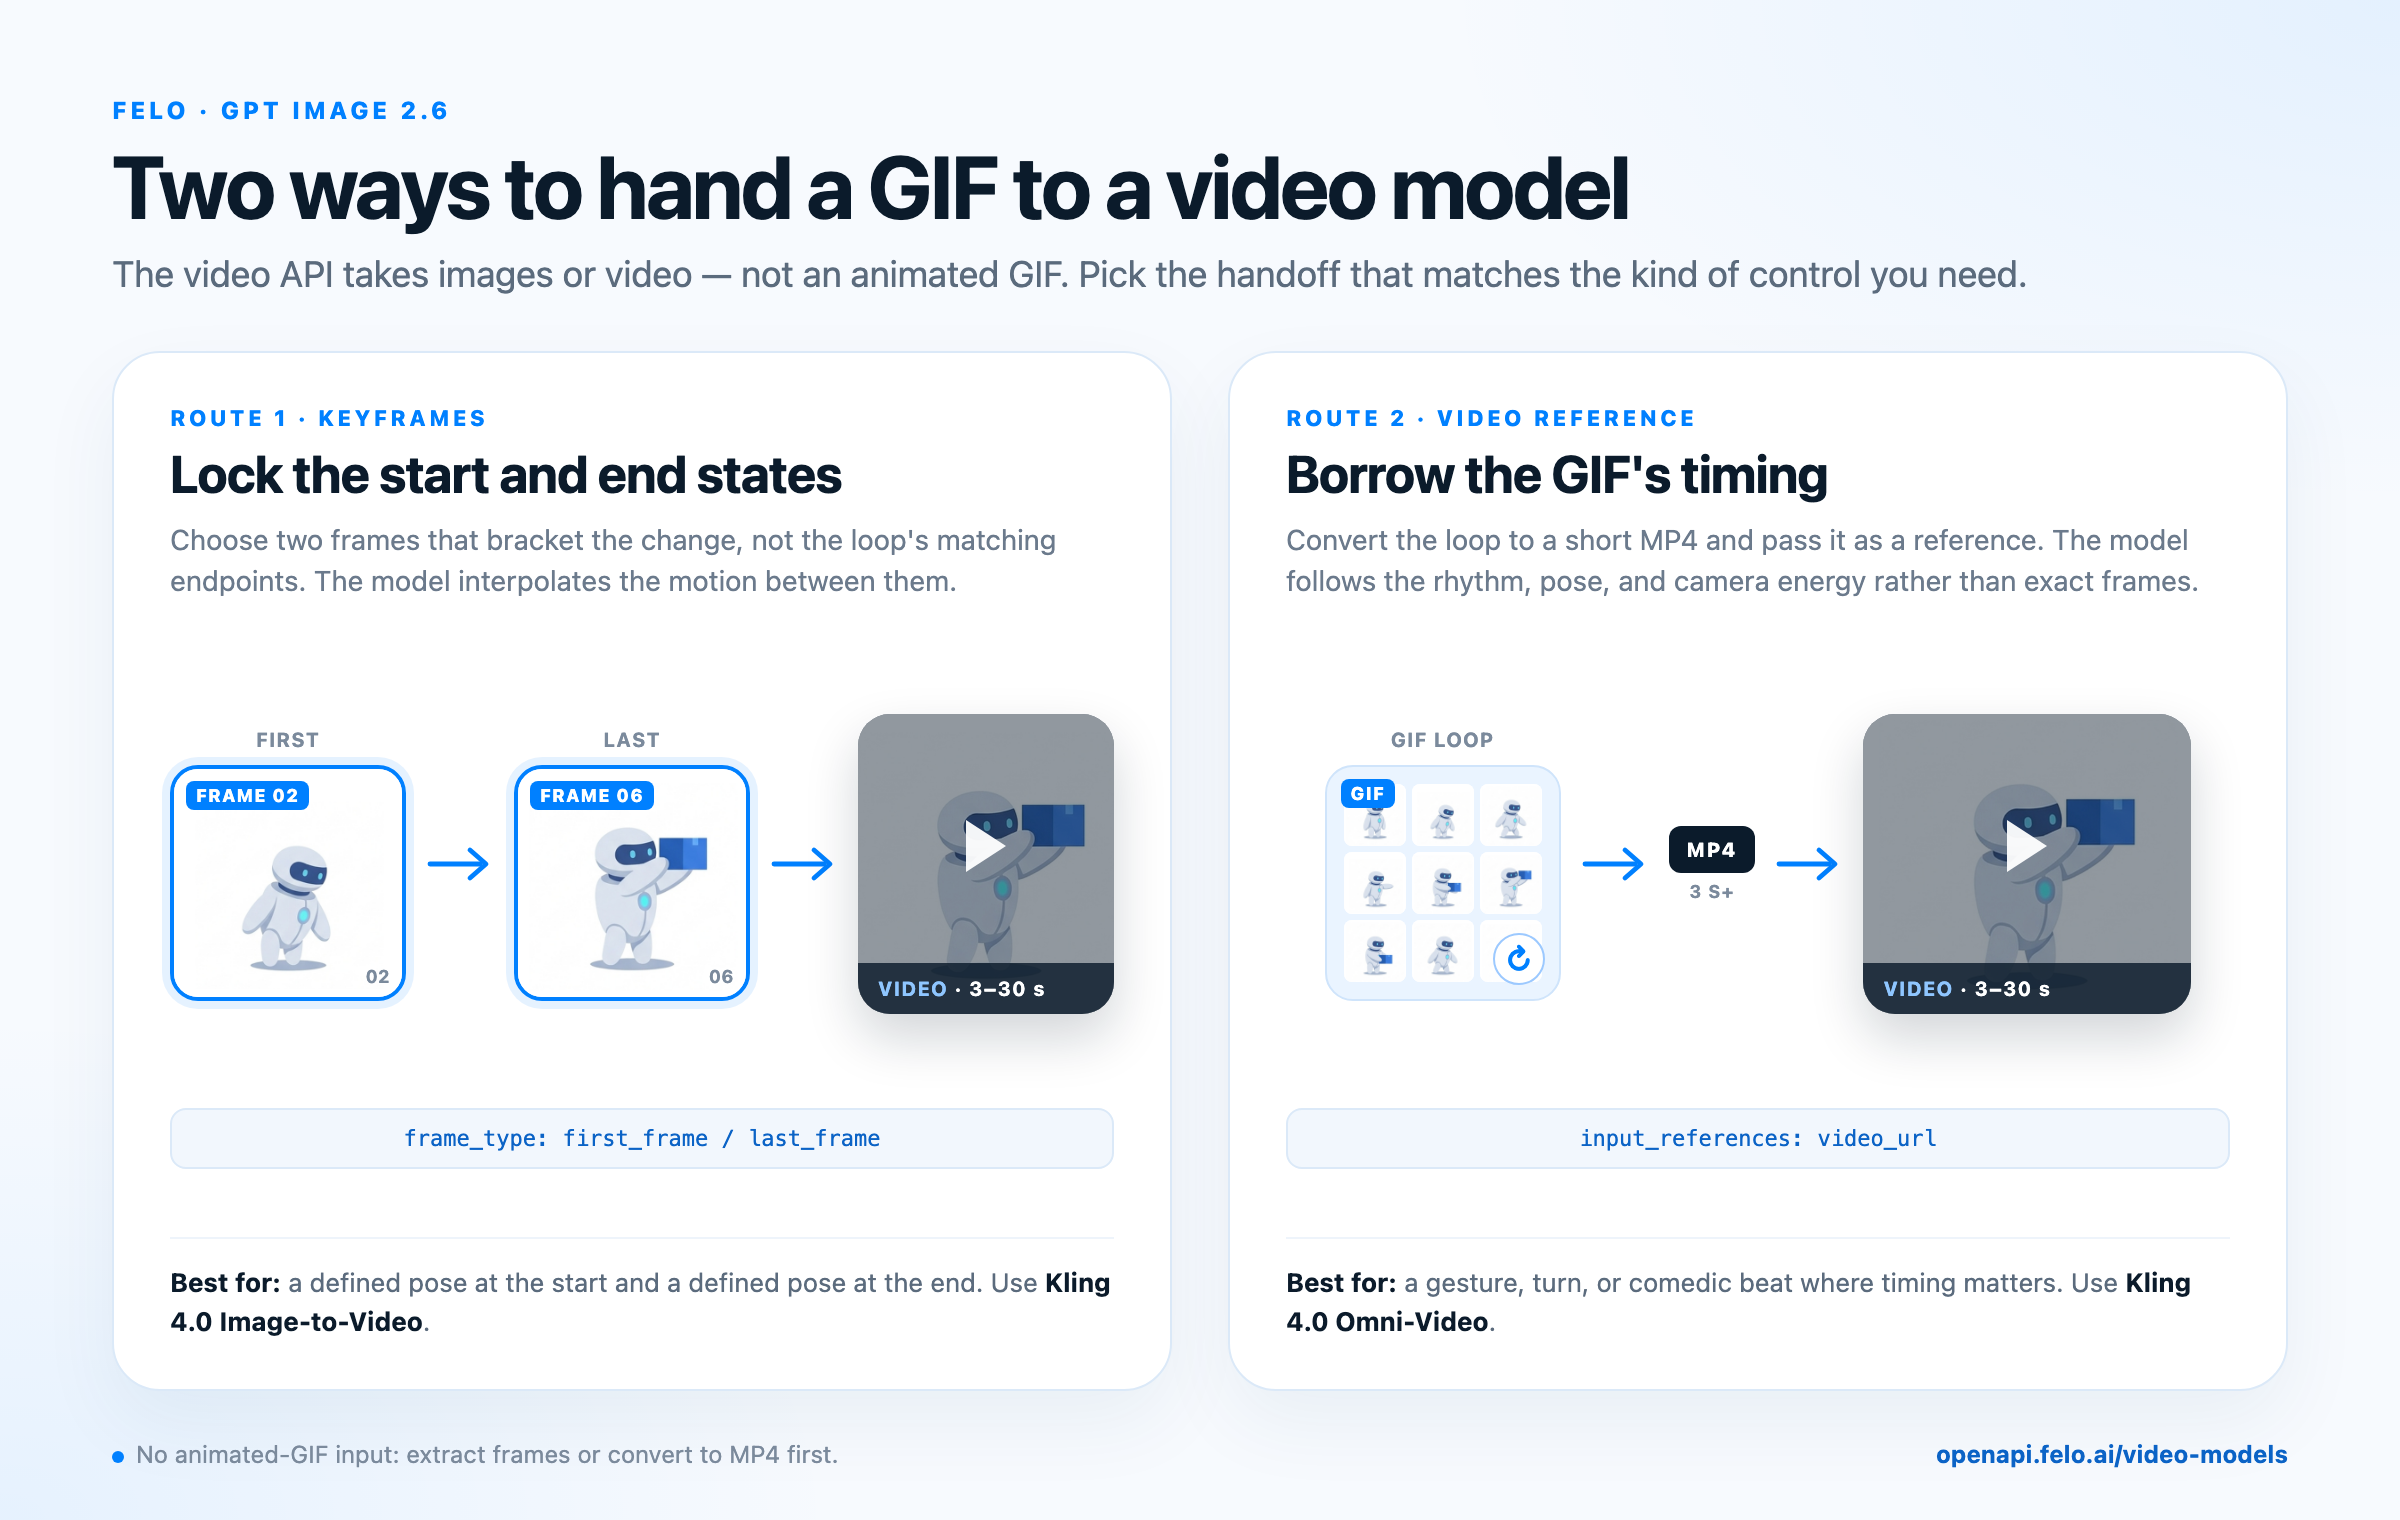
การใช้คีย์เฟรมเป็นการกำหนดสถานะเริ่มต้นและสิ้นสุด ส่วนการใช้วิดีโออ้างอิงเป็นการนำจังหวะเวลาของ GIF มาใช้
วิธีที่ 1: Keyframes สำหรับกำหนดจุดเริ่มต้นและจุดสิ้นสุด
เลือกสองเฟรมที่ครอบคลุมการเปลี่ยนแปลงที่คุณต้องการ สำหรับตัวละครผู้ส่งพัสดุ ให้เลือกภาพช่องที่ 2 (การถ่ายน้ำหนักตัว) และช่องที่ 6 (การยื่นพัสดุออกไป) แทนที่จะใช้เฟรมแรกและเฟรมสุดท้ายของ GIF ซึ่งตั้งใจให้เหมือนกัน ส่งภาพทั้งสองเป็น frame_images โดยกำหนด frame_type เป็น first_frame หรือ last_frame
วิธีนี้กำหนดสถานะเริ่มต้นและสิ้นสุดตามที่คุณเลือก พรอมต์จึงต้องอธิบายเฉพาะสิ่งที่ภาพทั้งสองไม่สามารถแสดงได้ ได้แก่ การเคลื่อนกล้อง แสง และจังหวะการเคลื่อนไหว
Kling 4.0 Image-to-Video เหมาะกับงานประเภทนี้ หน้าข้อมูลโมเดลระบุว่า frame_images เป็นหนึ่งในพารามิเตอร์ที่รองรับ และสามารถสร้างคลิปความยาว 3 ถึง 30 วินาทีพร้อมเสียงสเตอริโอ ส่งท่าทางสองภาพที่เลือกไว้ แล้วโมเดลจะสร้างการเคลื่อนไหวระหว่างภาพทั้งสอง
ตัวอย่างพรอมต์สั้นสำหรับวิธี Keyframe:
ผู้ส่งพัสดุคนเดิมสวมแจ็กเก็ตสีมัสตาร์ดตัวเดิม อยู่บนถนนหินเส้นเดิม เอื้อมมือเข้าไปในกระเป๋าสะพายและยื่นพัสดุสีน้ำเงินออกมา กล้องค่อย ๆ เคลื่อนเข้า แสงยามบ่ายนุ่มนวล ระยะชัดลึกตื้น รักษาใบหน้า เสื้อผ้า และพัสดุของตัวละครให้เหมือนเดิม เพิ่มเสียงบรรยากาศตามธรรมชาติของถนน
โมเดลวิดีโอจะสร้างการเคลื่อนไหวระหว่างท่าทางสองภาพของคุณ ซึ่งเป็นการสร้างสรรค์ที่ต้องใช้การคาดเดาน้อยกว่าการขอให้โมเดลคิดแอ็กชันทั้งหมดจากประโยคเดียว
วิธีที่ 2: Video Reference สำหรับนำจังหวะเวลามาใช้
หากต้องการให้วิดีโอมีจังหวะเหมือน GIF ให้แปลง GIF เป็นไฟล์ MP4 ความยาวสั้น แล้วส่งเป็นวิดีโออ้างอิง ใน Video API พารามิเตอร์ input_references รองรับรายการ video_url ควบคู่กับการอ้างอิง image_url
ffmpeg -stream_loop 1 -i action.gif -t 3 -movflags +faststart -pix_fmt yuv420p action.mp4
Kling 4.0 Omni-Video เป็นตัวเลือกสำหรับงานที่ใช้วิดีโออ้างอิง หน้าข้อมูลระบุว่ารองรับคลิปวิดีโอสูงสุด 5 คลิป ความยาวคลิปละ 3 ถึง 30 วินาที โดยความยาวรวมต้องไม่เกิน 30 วินาที และยังรองรับภาพอ้างอิงสูงสุด 10 ภาพ คุณจึงสามารถส่งภาพร่างการเคลื่อนไหวและภาพตัวละครในคำขอเดียวกัน
ใช้วิธีนี้เมื่อจังหวะเวลาเป็นองค์ประกอบสำคัญ เช่น ท่าทางสามจังหวะ การหมุนตัว หรือจังหวะหยุดเพื่อสร้างอารมณ์ขัน Omni-Video รองรับวิดีโออ้างอิงความยาว 3–30 วินาที ดังนั้นให้วน GIF จนครบอย่างน้อยสามวินาทีก่อนส่งออก หรือใช้ 12 เฟรม เฟรมละ 250 มิลลิวินาทีเพื่อให้ได้ระยะเวลาเท่ากัน
โมเดลวิดีโอจะอ้างอิงจังหวะและท่าทางโดยรวมของวิดีโอ ไม่ได้สร้างภาพซ้ำแบบเฟรมต่อเฟรม หากต้องการกำหนดสถานะเริ่มต้นและสิ้นสุดที่เฉพาะเจาะจง ให้ใช้ Keyframes
หรือใช้ GIF เป็นผลงานขั้นสุดท้าย
บางครั้ง GIF ก็เป็นไฟล์ส่งมอบที่ต้องการอยู่แล้ว สติกเกอร์วนซ้ำ สถานะ UI โพสต์บนโซเชียลมีเดีย หรือสไปรต์เกม ไม่จำเป็นต้องใช้โมเดลวิดีโอหรือเพลงประกอบ ตัวอย่างกรณีการใช้งานโมเดล GPT Image 2.6 ของ Felo ได้แก่ GIF ดาบน้ำในรูปแบบ Pixel Art ภาพบุคคลที่หันหน้าและขยิบตา และแบนเนอร์งานอีเวนต์สไตล์ญี่ปุ่น ทั้งสามตัวอย่างเน้นการเคลื่อนไหวขนาดเล็กที่สื่อความหมายได้
รูปแบบไฟล์นี้มีข้อจำกัดจริง ได้แก่ สี 256 สีต่อเฟรม ไม่มีเสียง และขนาดไฟล์ที่เพิ่มขึ้นตามขนาดภาพและจำนวนเฟรม สีพื้นเรียบและฉากหลังเรียบช่วยลดผลกระทบจากข้อจำกัดด้านสีได้ ส่วนการไล่ระดับสีและสีผิวอาจเกิดแถบสีที่ไม่ต่อเนื่อง
GPT Image 2.6 API: ส่งคำขอ ตรวจสอบสถานะ และรวบรวมผลลัพธ์
มนุษย์สามารถเฝ้าดูการสร้าง GIF ผ่านเบราว์เซอร์ได้ แต่เอเจนต์ทำเช่นนั้นไม่ได้ เว้นแต่ API จะมีขั้นตอนการทำงานที่กำหนดไว้อย่างชัดเจน API ของ Felo รองรับรูปแบบนี้ ได้แก่ ส่งคำขอ ตรวจสอบสถานะ และรวบรวมผลลัพธ์
Image Endpoint คือ POST https://openapi.felo.ai/api/v1/images/generations พร้อม Bearer Key ระบบจะส่งสถานะ 202 และ task_id กลับมา จากนั้นเรียก GET /api/v1/images/generations/{task_id} เพื่อตรวจสอบสถานะจนกว่า status จะเป็น succeeded แล้วอ่าน URL สื่อที่มีลายเซ็นจาก outputs
เนื้อหาคำขอรองรับ Model ID, พรอมต์, quality, aspect_ratio, output_format และ input_references สำหรับภาพอ้างอิง หากต้องการใช้ภาพอ้างอิงจากเครื่องของคุณ ให้อัปโหลดก่อนผ่าน POST /api/v1/files Endpoint นี้รองรับ PNG, JPEG, GIF, WebP, MP4 และไฟล์รูปแบบทั่วไปอื่น ๆ ขนาดสูงสุด 100 MiB พร้อมส่งคืนข้อมูลไฟล์ นำ id ที่ได้รับไปใส่ใน file_id ภายใน input_references
สำหรับเอเจนต์ที่ต้องสร้าง GIF รูปแบบที่เหมาะสมคือขอให้ระบบสร้างแอ็กชันทั้งหมดเป็นชีตภาพสตอรีบอร์ดในการเรียกภาพเพียงครั้งเดียว แล้วแบ่งชีตออกเป็นเฟรม การเรียกคำขอหนึ่งครั้งจะสร้างท่าทางเก้าท่า การแบ่งภาพมีขั้นตอนที่แน่นอน และการประกอบ GIF เป็นขั้นตอนที่ทำบนเครื่อง เฟรมเหล่านี้ยังเป็นข้อมูลที่ขั้นตอนสร้างวิดีโอต้องใช้ จึงไม่ต้องสร้างภาพซ้ำ
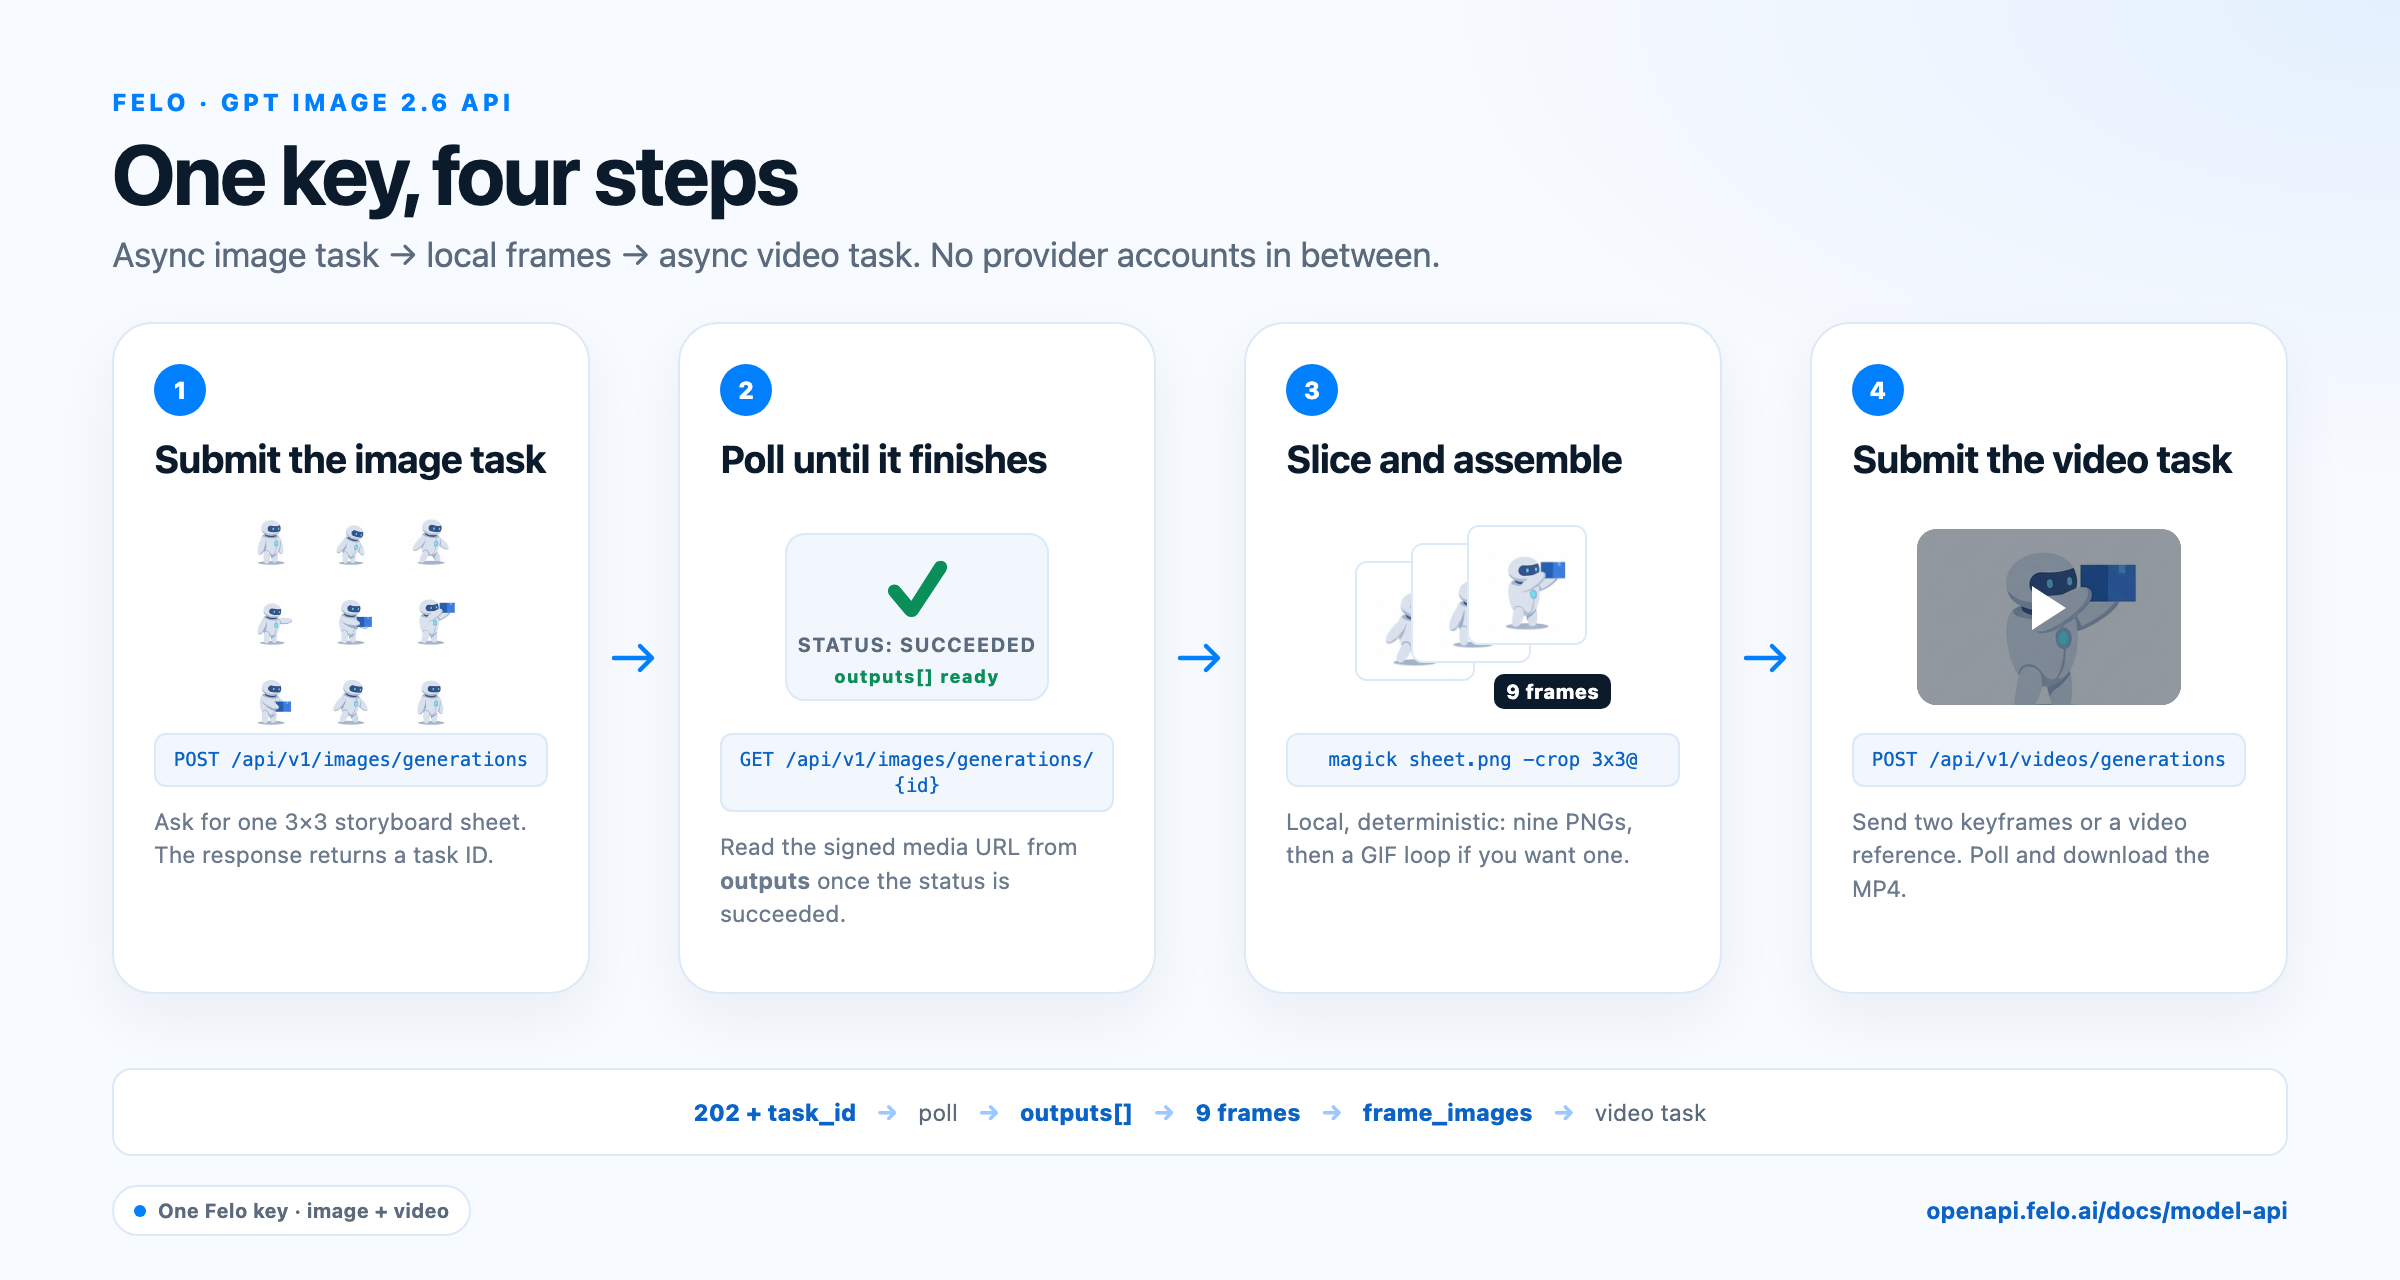
โครงสร้างงาน: ส่งคำขอสร้างภาพ ตรวจสอบผลลัพธ์ แบ่งชีตภาพบนเครื่อง แล้วส่งคำขอสร้างวิดีโอพร้อมเฟรม
ขอท่าทางเก้าท่าในการเรียก API ครั้งเดียว
ตัวอย่างพรอมต์สตอรีบอร์ดสำหรับคำขอนี้:
ชีตสตอรีบอร์ดขนาด 3 × 3 บนพื้นหลังสีขาวเรียบ มีช่องภาพสี่เหลี่ยมจัตุรัสขนาดเท่ากันเก้าช่องเรียงชิดกัน ไม่มีช่องว่าง ตัวละครผู้ส่งพัสดุคนเดิมสวมแจ็กเก็ตสีเหลืองมัสตาร์ดปรากฏในทุกช่องภาพ มุมมองด้านข้าง เห็นร่างกายเต็มตัว มีสัดส่วน สี และกระเป๋าสะพายเหมือนกันทุกช่อง ช่องที่ 1 ยืนอยู่ ช่องที่ 2 ถ่ายน้ำหนักตัว ช่องที่ 3 เอื้อมมือเข้าไปในกระเป๋าสะพาย ช่องที่ 4 เปิดกระเป๋า ช่องที่ 5 หยิบพัสดุสีน้ำเงินออกมา ช่องที่ 6 ยื่นพัสดุไปด้านหน้า ช่องที่ 7 ลดพัสดุลง ช่องที่ 8 วางมือไว้ข้างลำตัว ช่องที่ 9 ใช้ท่าเดียวกับช่องที่ 1 แสงเรียบสม่ำเสมอ ขนาดตัวละครคงที่ ไม่มีข้อความ ไม่มีคำบรรยาย และไม่มีหมายเลขช่องภาพ
ชีตภาพขนาด 1K จะให้ภาพย่อยขนาดประมาณ 340 พิกเซลหลังการครอป ซึ่งมีความคมชัดน้อยกว่าเฟรมขนาด 512 พิกเซลจากเครื่องมือบนเบราว์เซอร์ หากช่องทางของคุณรองรับ ให้ขอภาพสี่เหลี่ยมขนาดใหญ่ขึ้น ตรวจสอบชีตภาพก่อนแบ่งเฟรม หากช่องภาพมีขนาดไม่เท่ากันหรือตัวละครเปลี่ยนรูปลักษณ์ ให้สร้างภาพใหม่ด้วยคำสั่งจัดวางที่เรียบง่าย แทนการพยายามแก้ไขหลังจากตัดภาพแล้ว
ส่งคำขอ แบ่งเฟรม และประกอบ GIF
import os
import time
import requests

BASE = "https://openapi.felo.ai/api/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['FELO_API_KEY']}"}

def poll(path, timeout=900, interval=5):
    deadline = time.time() + timeout
    while time.time() < deadline:
        response = requests.get(f"{BASE}{path}", headers=HEADERS, timeout=30)
        response.raise_for_status()
        task = response.json()
        if task["status"] in {"succeeded", "failed", "interrupted"}:
            if task["status"] != "succeeded":
                raise RuntimeError(task.get("error", task["status"]))
            return task
        time.sleep(interval)
    raise TimeoutError(path)

STORYBOARD_PROMPT = (
    "A 3x3 storyboard sheet on plain white, nine equal square panels edge to edge, "
    "the same courier in a mustard jacket in every panel, side view, full body, "
    "identical proportions and colors: standing, shifting weight, reaching into a "
    "satchel, opening it, pulling out a blue parcel, holding it forward, lowering it, "
    "hand at side, standing again. Flat lighting, consistent scale, no text, no gutters."
)

response = requests.post(
    f"{BASE}/images/generations",
    headers=HEADERS,
    json={
        "model": "gpt-image-2.6-sunburst",
        "prompt": STORYBOARD_PROMPT,
        "aspect_ratio": "1:1",
        "quality": "medium",
    },
    timeout=60,
)
response.raise_for_status()

result = poll(f"/images/generations/{response.json()['task_id']}")
output = result["outputs"][0]
sheet_url = output["url"] if isinstance(output, dict) else output
with open("sheet.png", "wb") as file:
    file.write(requests.get(sheet_url, timeout=60).content)
จากนั้นแบ่งชีตภาพและประกอบเป็น GIF วนซ้ำบนเครื่อง:
magick sheet.png -crop 3x3@ +repage -resize 512x512! frame-%02d.png
magick -delay 20 -loop 0 frame-*.png action.gif   # 20/100 s = 200 ms per frame
ผู้ใช้ ImageMagick 6 สามารถเปลี่ยน magick เป็น convert ได้ การครอปภาพจะแบ่งช่องได้เท่ากัน เนื่องจากพรอมต์กำหนดให้ไม่มีช่องว่างระหว่างภาพ
ส่งสอง Keyframes ไปยังโมเดลวิดีโอ
def upload(path):
    with open(path, "rb") as file:
        response = requests.post(
            f"{BASE}/files", headers=HEADERS, files={"file": file}, timeout=60
        )
    response.raise_for_status()
    return response.json()["id"]

VIDEO_PROMPT = (
    "The same courier on the same stone street reaches into the satchel and holds "
    "out a blue parcel. Slow push-in, soft late-afternoon light, shallow depth of "
    "field. Keep the face, clothing, and parcel unchanged."
)

# Panels 2 and 6 bracket the change; the loop's matching endpoints do not.
first_id = upload("frame-01.png")
last_id = upload("frame-05.png")

video = requests.post(
    f"{BASE}/videos/generations",
    headers=HEADERS,
    json={
        "model": "kling-4.0/image-to-video",
        "prompt": VIDEO_PROMPT,
        "duration": 5,
        "resolution": "720p",
        "frame_images": [
            {"type": "image_url", "frame_type": "first_frame",
             "image_url": {"file_id": first_id}},
            {"type": "image_url", "frame_type": "last_frame",
             "image_url": {"file_id": last_id}},
        ],
    },
    timeout=60,
)
video.raise_for_status()
video_task = video.json()["task_id"]
ตรวจสอบสถานะงานวิดีโอด้วยวิธีเดียวกัน แล้วดาวน์โหลด URL ผลลัพธ์ที่มีลายเซ็น Endpoint คือ POST https://openapi.felo.ai/api/v1/videos/generations โดยข้อมูลของงานมี status และ outputs เช่นเดียวกับงานสร้างภาพ ดูรายการเส้นทาง Video API ทั้งหมดได้ที่ หน้ารวมโมเดลวิดีโอ
เชื่อมต่อเข้ากับเอเจนต์
เอเจนต์สามารถสร้างชีตแอ็กชันหลายชุดด้วยค่าใช้จ่ายเทียบเท่าการสร้างภาพเพียงไม่กี่ภาพ เปรียบเทียบผลลัพธ์ แล้วจึงเลือกจ่ายเงินเพื่อสร้างวิดีโอ นอกจากนี้ยังสามารถบันทึกว่าพรอมต์ใดสร้างชีตภาพชุดใด ซึ่งทำได้ยากเมื่อมนุษย์ต้องคลิกผ่านหน้าจอ UI
เนื่องจากคีย์เดียวรองรับโมเดลแชต ภาพ และวิดีโอ เวิร์กโฟลว์ทั้งหมดจึงสามารถทำงานภายในเอเจนต์เดียวได้ โมเดลวางแผนเขียนลำดับแอ็กชัน การเรียก Image API สร้างชีตภาพ โมเดลด้านการมองเห็นตรวจสอบความสม่ำเสมอ และการเรียก Video API สร้างช็อตให้เสร็จสมบูรณ์
Felo เผยแพร่ Base URL ที่รองรับ OpenAI และ Anthropic พร้อมคู่มือการตั้งค่าสำหรับ Codex, Claude Code, DeepSeek Harness, OpenClaw และไคลเอนต์เอเจนต์อื่น ๆ เอเจนต์ที่มีอยู่จึงสามารถเชื่อมต่อกับแพลตฟอร์มนี้ได้โดยไม่ต้องสร้างระบบใหม่
สิ่งที่เวิร์กโฟลว์นี้ยังแก้ไม่ได้
วิธีเริ่มต้นด้วย GIF ช่วยลดความคลุมเครือในการออกแบบแอ็กชัน แต่ไม่ได้ทำให้โมเดลวิดีโอสร้างภาพได้ตรงตามเฟรมอย่างแม่นยำ
- การเคลื่อนไหวอาจเปลี่ยนแปลง โมเดลวิดีโอใช้การประมาณค่าระหว่างเฟรม จึงอาจเปลี่ยนตำแหน่งมือหรือรอยพับของเสื้อผ้าระหว่าง Keyframes ภาพอ้างอิงช่วยได้ แต่ยังต้องตรวจสอบผลลัพธ์
- คลิปสั้นก็คือคลิปสั้น เฟรม 2 ถึง 16 เฟรมเหมาะสำหรับท่าทาง ไม่ใช่ฉากเต็มรูปแบบ สร้างฉากจากท่าทางหลายชุด แล้วให้โมเดลวิดีโอจัดการช่วงเปลี่ยนผ่าน
- ข้อความภายในเฟรมมีความเปราะบาง ตัวอักษรอาจสั่นหรือเปลี่ยนรูปทรงระหว่างเฟรม ควรเพิ่มชื่อเรื่องด้วยเครื่องมือออกแบบ ไม่ใช่ใส่ลงในแอนิเมชัน
- รายการโมเดลเปลี่ยนแปลงได้ ข้อกำหนดการทดลองใช้และพารามิเตอร์ที่รองรับเป็นข้อมูลปัจจุบัน โปรดตรวจสอบหน้าโมเดลหรือ Playground ก่อนนำ ID ไปใช้ในระบบจริง
คำถามที่พบบ่อย (FAQ)
GPT Image 2.6 สามารถสร้าง GIF แบบเคลื่อนไหวบน Felo ได้หรือไม่?
ได้ ผ่านเครื่องมือบนเบราว์เซอร์ เลือก GPT Image 2.6 เปิดการตั้งค่า และเลือก GIF แผงควบคุมรองรับ 2 ถึง 16 เฟรม ระยะเวลา 20 ถึง 2000 มิลลิวินาทีต่อเฟรม และขนาดเริ่มต้น 512 × 512 พิกเซล การตั้งค่า 9 เฟรม เฟรมละ 200 มิลลิวินาที จะสร้าง GIF วนซ้ำความยาว 1.8 วินาที
ฉันสามารถเรียกใช้ GPT Image 2.6 ผ่าน API ได้หรือไม่?
ได้ ใช้ Model ID gpt-image-2.6-flare หรือ gpt-image-2.6-sunburst กับ POST /api/v1/images/generations บน Felo API Platform คีย์ Felo เพียงคีย์เดียวรองรับการเรียก API โดยไม่ต้องมีบัญชี OpenAI, Google หรือ Kuaishou การเรียก API ทำงานแบบอะซิงโครนัส ได้แก่ ส่งคำขอ ตรวจสอบสถานะงาน และดาวน์โหลดผลลัพธ์
Image API ส่งคืนไฟล์ GIF หรือไม่?
ยังไม่รองรับในขณะนี้ Image API สาธารณะระบุรูปแบบ png, jpeg และ webp สำหรับโมเดลเหล่านี้ เอเจนต์ยังสามารถสร้าง GIF ได้ด้วยการสร้างชีตเฟรมหรือชุดภาพนิ่ง แล้วนำมาประกอบบนเครื่องด้วย ImageMagick หรือ ffmpeg วิธีนี้มักให้ผลลัพธ์ที่เหมาะกับงานมากกว่า เนื่องจากขั้นตอนสร้างวิดีโอต้องใช้เฟรมแต่ละภาพอยู่แล้ว
ฉันจะแปลง GIF เป็นวิดีโอบน Felo ได้อย่างไร?
ใช้ GIF เป็นแผนการเคลื่อนไหว แล้วส่งต่อไปยัง Image-to-Video API ด้วยหนึ่งในสองวิธี ได้แก่ แยก Keyframes สองภาพที่ครอบคลุมการเปลี่ยนแปลง แล้วส่งเป็น frame_images หรือแปลง GIF วนซ้ำเป็น MP4 แล้วส่งเป็นข้อมูลอ้างอิง video_url Video API ของ Felo ไม่รองรับการส่ง GIF แบบเคลื่อนไหวโดยตรง
การสร้าง GIF ด้วย GPT Image 2.6 มีค่าใช้จ่ายเท่าไร?
โมเดลทั้งสองคิดราคาตามจำนวนโทเค็น โดยมีค่าใช้จ่าย $5 ต่อ 1M input tokens และ $30 ต่อ 1M output tokens ดังนั้นภาพที่มีความละเอียดสูงขึ้นหรือมีภาพอ้างอิงมากขึ้นจะมีค่าใช้จ่ายเพิ่มขึ้น เครื่องมือบนเบราว์เซอร์และ API ใช้โควตา Felo ของคุณ โปรดตรวจสอบหน้าโมเดลเพื่อดูอัตราค่าบริการและข้อกำหนดการทดลองใช้ปัจจุบัน
เริ่มต้นด้วย GIF วนซ้ำ
วิธีที่เชื่อถือได้ในการปรับปรุงวิดีโอ AI คือหยุดขอให้โมเดลสร้างวิดีโอเป็นขั้นตอนแรก ทำแอ็กชันให้เล็กพอที่จะตรวจสอบได้ สร้างภาพวนซ้ำ แก้ไขรอยต่อ แล้วจึงส่งเฟรมให้โมเดลที่สามารถเพิ่มแสง การเคลื่อนกล้อง และเสียงได้
ลองใช้ GPT Image 2.6 บน Felo เพื่อสร้าง GIF วนซ้ำชิ้นแรกผ่านเบราว์เซอร์ เมื่อพร้อมนำเวิร์กโฟลว์ไปใช้ภายในเอเจนต์ ให้เข้าไปที่ Image Model API สร้างคีย์ และส่งคำขอหนึ่งครั้ง GIF คือแผนการเคลื่อนไหว ส่วนวิดีโอคือการแสดงจริง
บทความนี้มีให้อ่านในภาษาต่อไปนี้ด้วย: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, Español, বাংলা and Português