GPT-6.1 Sol API: ประสิทธิภาพใกล้เคียง Astra ในราคาที่ต่ำกว่า
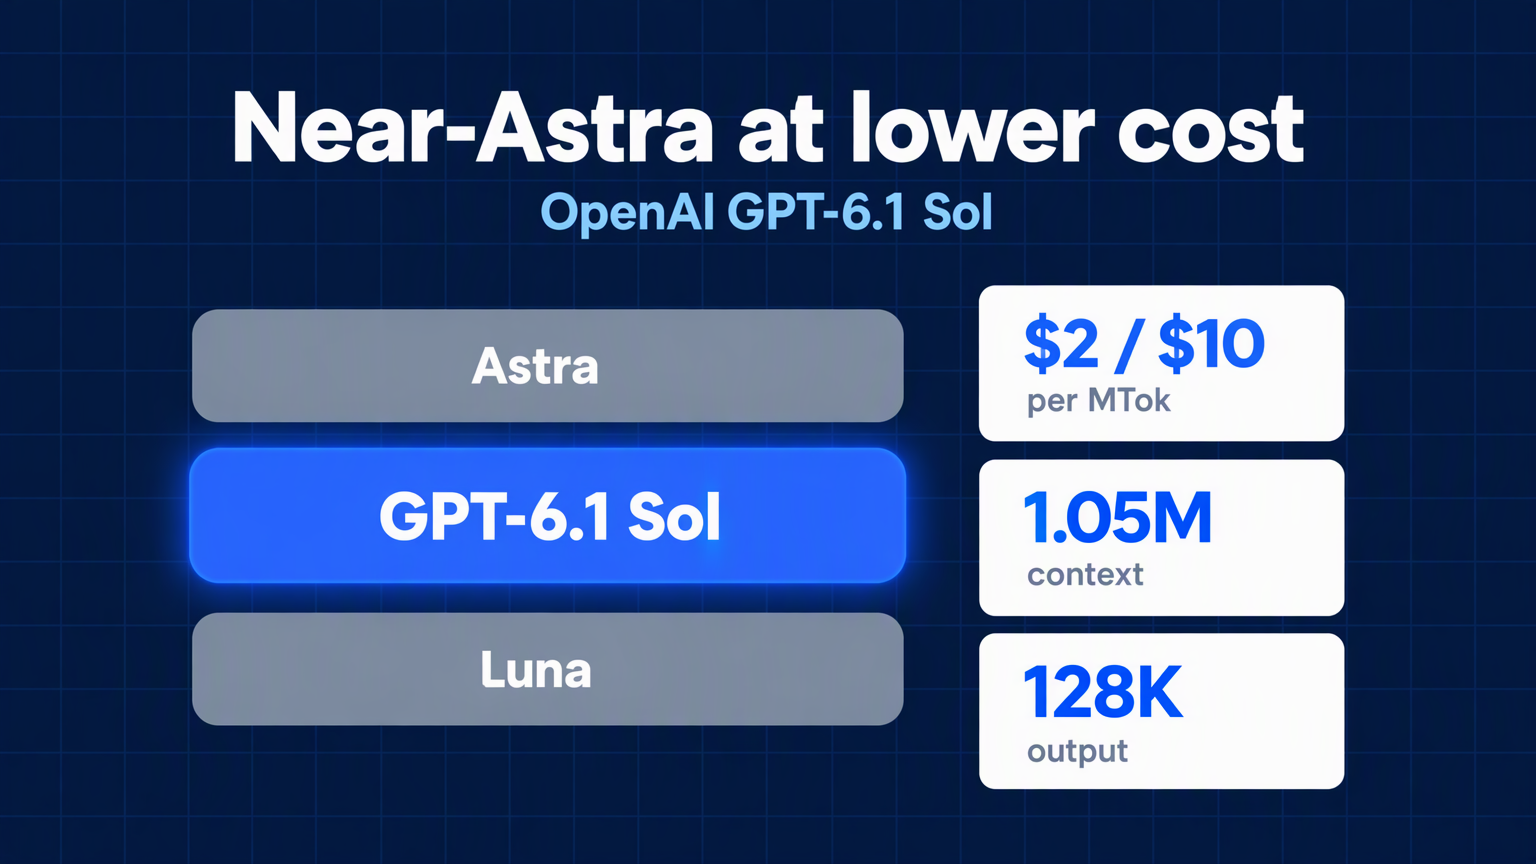
OpenAI GPT-6.1 Sol มอบประสิทธิภาพใกล้เคียง Astra สำหรับงานเขียนโค้ด การใช้งานคอมพิวเตอร์ และงานระดับมืออาชีพ ในราคา $2/$10 ต่อหนึ่งล้านโทเคน พร้อมหน้าต่างบริบท 1.05M
โมเดล Sol รุ่นใหม่ล่าสุดของ OpenAI ไม่ได้พยายามเป็นโมเดลที่ฉลาดที่สุด แต่ต้องการเป็นโมเดลที่คุณสามารถใช้งานได้ตลอดทั้งวันโดยไม่ต้องกังวลเรื่องค่าใช้จ่าย
GPT-6.1 Sol อยู่ระหว่าง GPT-6 Astra รุ่นเรือธงและ GPT-6 Luna รุ่นน้ำหนักเบา หน้าโมเดลของ OpenAI อธิบายไว้สั้น ๆ ว่า "ประสิทธิภาพใกล้เคียง Astra สำหรับงานซับซ้อนในราคาที่ต่ำกว่า" สำหรับทีมที่สร้างเครื่องมือเขียนโค้ดอัตโนมัติ เอเจนต์ใช้งานคอมพิวเตอร์ และเวิร์กโฟลว์ที่เน้นเอกสาร จุดแข็งนี้คือหัวใจสำคัญ
คู่มือนี้สรุปสิ่งที่ GPT-6.1 Sol ให้มา ราคา ความแตกต่างจาก GPT-6 Sol และ Astra และวิธีเรียกใช้งานผ่าน Felo API Platform
GPT-6.1 Sol คืออะไร
GPT-6.1 Sol คือโมเดลด้านเหตุผลที่ออกแบบมาเพื่อ งานเขียนโค้ดซับซ้อน การใช้งานคอมพิวเตอร์ และงานระดับมืออาชีพ OpenAI วางตำแหน่งให้เป็นตัวเลือกสมดุลในตระกูล GPT-6: เก่งกว่า Luna ถูกกว่า Astra และแข็งแกร่งพอสำหรับงานโปรดักชันส่วนใหญ่โดยไม่ต้องใช้รุ่นเรือธง
หน้าโมเดลระบุวิธีใช้งานอย่างตรงไปตรงมา: เปรียบเทียบ Sol กับ Astra บนงานของคุณ แล้วตัดสินใจว่าคุณภาพที่ต่างกันคุ้มกับราคาหรือไม่ คำแนะนำนี้ใช้งานได้จริงและสะท้อนจุดประสงค์ของโมเดล Sol คือเครื่องมือควบคุมต้นทุน ไม่ใช่ถ้วยรางวัลด้านประสิทธิภาพ
หน้าโมเดลของ Felo สรุปจุดยืนเดียวกันจากมุมมองแพลตฟอร์ม GPT-6.1 Sol คือ "การอัปเกรดจาก GPT-6 Sol โดยยังอยู่ต่ำกว่า GPT-6 Astra รุ่นเรือธง" จัดการงานเขียนโค้ดอัตโนมัติ การใช้งานคอมพิวเตอร์ งานเอกสาร และเวิร์กโฟลว์อัตโนมัติหลายขั้นตอน ให้ผลลัพธ์ใกล้เคียง Astra ในราคาต่ำกว่า เมื่อเทียบกับ GPT-6 Sol Felo ระบุว่าข้อผิดพลาดเชิงข้อเท็จจริงลดลงและปฏิบัติตามข้อจำกัดได้ใกล้เคียงขึ้น
GPT-6.1 Sol คือโมเดลที่คุณเลือกใช้เมื่อเจองานยาก งานยาว และต้องทำซ้ำ — และต้องควบคุมค่าใช้จ่ายให้แน่นอน
สเปกของ GPT-6.1 Sol โดยสังเขป
OpenAI เผยแพร่สเปกเต็มบนหน้าโมเดล นี่คือสรุปแบบย่อ
| สเปก | GPT-6.1 Sol |
|---|---|
| Model ID | gpt-6.1-sol |
| Default snapshot | gpt-6.1-sol |
| Context window | 1,050,000 โทเคน |
| Maximum input tokens | 922,000 |
| Maximum output tokens | 128,000 |
| Knowledge cutoff | 30 เมษายน 2026 |
| Input modalities | ข้อความ, รูปภาพ |
| Output modalities | ข้อความ |
| Unsupported modalities | เสียง, วิดีโอ |
| Reasoning token support | รองรับ |
| Reasoning effort | low, medium (ค่าเริ่มต้น), high, xhigh, max |
| Unsupported reasoning effort | none, minimal |
| Data residency | สหรัฐฯ และสหภาพยุโรป |
มีสองรายละเอียดที่สำคัญกว่าตัวเลขหลัก
หนึ่ง, ไม่สามารถปิด reasoning effort ได้ GPT-6.1 Sol ไม่รองรับ none หรือ minimal หากคุณย้ายมาจากโมเดลที่ตั้งค่านี้ได้ OpenAI แนะนำให้เริ่มที่ low แล้วเปรียบเทียบผลลัพธ์กับงานตัวอย่าง
สอง, การเรียกใช้เครื่องมือจำเป็นต้องใช้ Responses API GPT-6.1 Sol รองรับ Chat Completions สำหรับคำขอที่ไม่ใช้เครื่องมือ แต่เวิร์กโฟลว์ที่เรียกฟังก์ชัน ค้นหาไฟล์ ท่องเว็บ หรือควบคุมคอมพิวเตอร์ต้องย้ายไปใช้ Responses ข้อจำกัดนี้ไม่ใช่เฉพาะ Sol — เป็นทิศทางที่ OpenAI ผลักดันทั้งแพลตฟอร์ม
ราคา GPT-6.1 Sol: $2/$10 ได้อะไรบ้าง
OpenAI ตั้งราคา GPT-6.1 Sol ที่ $2 ต่อหนึ่งล้านโทเคนขาเข้า และ $10 ต่อหนึ่งล้านโทเคนขาออก ตารางโทเคนเต็มรวมราคาค่าแคช ซึ่งเปลี่ยนสมการสำหรับเอเจนต์ที่ทำงานต่อเนื่อง
| รายการ | ราคา ต่อ 1M โทเคน |
|---|---|
| Input | $2.00 |
| Cached input | $0.10 |
| Cache writes | $2.50 |
| Output | $10.00 |
มีข้อกำหนดสำคัญใต้ตารางนี้:
- Cached input มีค่าใช้จ่าย 5% ของอัตราปกติ OpenAI คิดราคาอ่านแคช GPT-6.1 Sol ที่ 0.05x เทียบกับ 0.1x ของโมเดล GPT-5.6 ขึ้นไป เหมาะกับเอเจนต์ที่ใช้ system prompt หรือ context เดิมซ้ำทุกครั้ง
- Cache writes มีค่าใช้จ่าย 1.25x ของ input ปกติ เขียน prefix ลงแคช $2.50 ต่อหนึ่งล้านโทเคน แล้วอ่านกลับ $0.10 ต่อหนึ่งล้านโทเคน
- Context ยาวขึ้น ค่าใช้จ่ายสูงขึ้น prompt เกิน 272K โทเคน input คิดราคา 2x ทั้ง input และ cache และ 1.5x output ทั้งคำขอ ที่ขนาดนี้ input เป็น $4, cached input $0.20, cache writes $5, output $15 ต่อหนึ่งล้านโทเคน
- Batch และ Flex ถูกลง 50% ถ้างานของคุณรองรับการประมวลผลแบบอะซิงโครนัส อัตราจะเหลือ $1 input และ $5 output ต่อหนึ่งล้านโทเคน
- Fast mode มีค่าใช้จ่าย 2x Standard จ่ายเพื่อความหน่วงต่ำ ไม่ใช่เพื่อความฉลาดมากขึ้น
- การประมวลผลในภูมิภาคเพิ่มราคา 10% ในพื้นที่ที่รองรับ
ส่วนลดอ่านแคชคือจุดเด่นที่ซ่อนอยู่ เอเจนต์เขียนโค้ดที่ใช้ context repository 100,000 โทเคนเดิมซ้ำ 20 ครั้ง จ่าย $0.10 ต่อหนึ่งล้านโทเคนแคช แทนที่จะเป็น $2.00 ต่อหนึ่งล้านโทเคน input ใหม่ ในเซสชันยาว ๆ ส่วนต่างนี้สะสมเร็วมาก
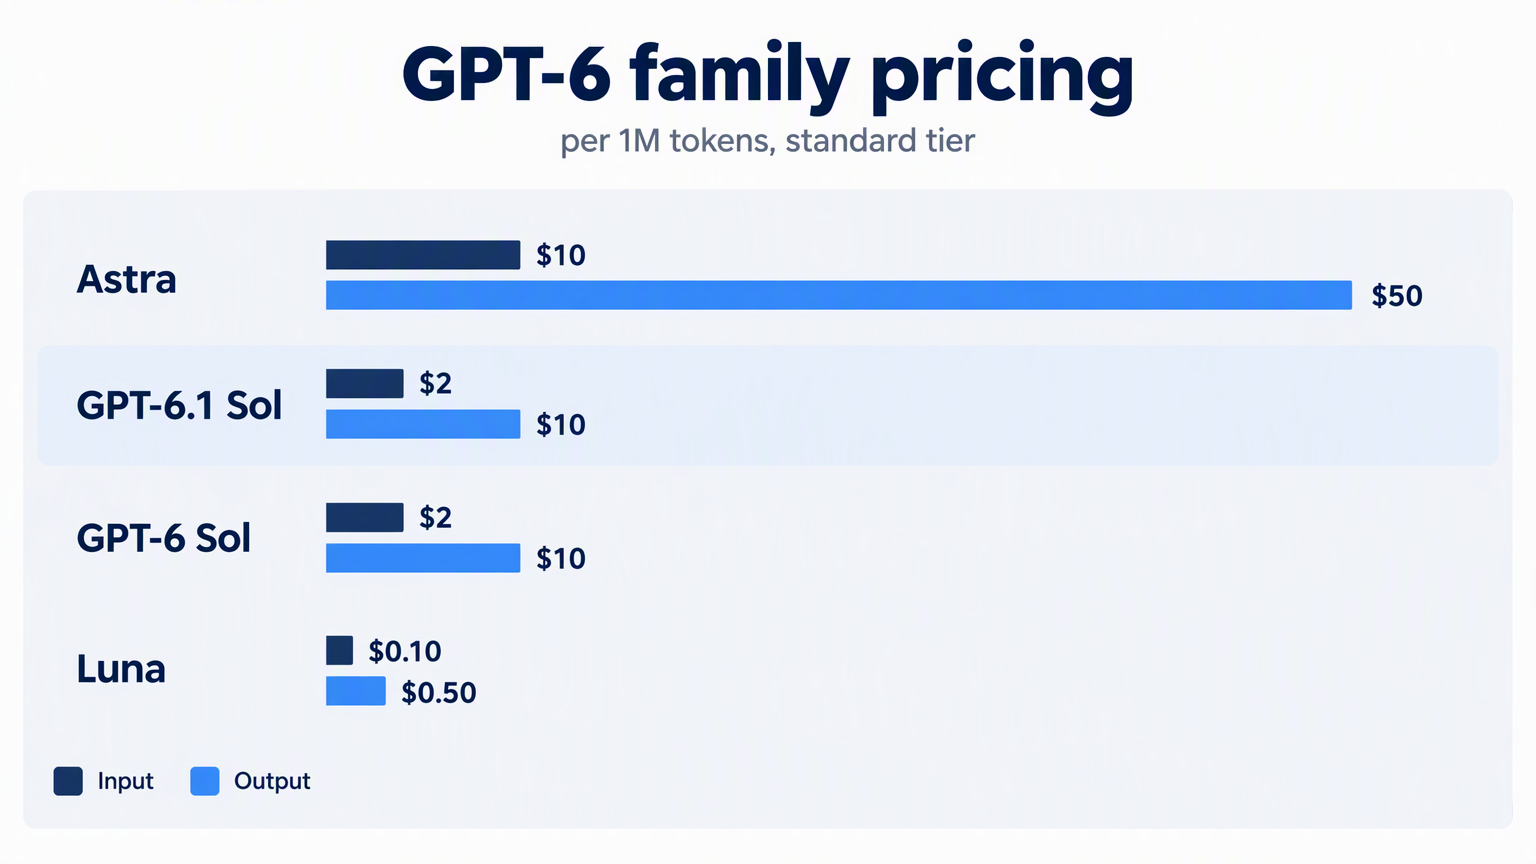
เปรียบเทียบ GPT-6 Astra ราคา $10 input และ $50 output ต่อหนึ่งล้านโทเคน GPT-6.1 Sol มีราคาถูกกว่าห้าเท่าทั้งขาเข้าและขาออก GPT-6 Luna ถูกกว่านั้นที่ $0.10 input และ $0.50 output แต่แลกกับความสามารถใกล้เคียง Astra ที่ทำให้ Sol น่าสนใจ
อะไรใหม่ใน GPT-6 ที่ Sol ใช้ได้
GPT-6.1 Sol รับฟีเจอร์แพลตฟอร์ม GPT-6 ที่ OpenAI เปิดตัวกับ Astra หลายฟีเจอร์สำคัญกับงานเอเจนต์
Async tool calling
โดยปกติ การเรียกฟังก์ชันจะหยุดโมเดลจนแอปพลิเคชันของคุณส่งผลลัพธ์กลับ ด้วย async tool calling คุณตั้ง async: true ในคำจำกัดความเครื่องมือ โมเดลจะทำงานต่อ — ให้เหตุผล เรียกเครื่องมืออื่น หรือตอบส่วนที่แยกจากกัน — ขณะที่แอปพลิเคชันของคุณประมวลผลงานช้าอยู่เบื้องหลัง
แอปพลิเคชันของคุณยังคงรันเครื่องมือและจัดการงานที่ค้างอยู่ เมื่อเสร็จแล้ว ส่ง output กลับในคำขอ Responses ถัดไปโดยใช้ call_id เดิม เอกสารของ OpenAI อธิบายว่านี่คือวิธีเริ่ม lookup ช้าตั้งแต่เนิ่น ๆ แล้วเติมคำตอบเมื่อข้อมูลมาถึง
สำหรับ Sol เหมาะกับงานโดยธรรมชาติ เอเจนต์เขียนโค้ดสามารถรันทดสอบยาว ๆ ตรวจไฟล์อื่นต่อ แล้วรวมผลทดสอบเมื่อเสร็จ
Mid-turn steering
Mid-turn steering ให้ผู้ใช้ส่งคำแก้ไขหรือข้อกำหนดใหม่ขณะโมเดลยังทำงานอยู่ ผ่าน WebSocket ไปยัง Responses API เซิร์ฟเวอร์จะเก็บงานที่เสร็จแล้วและผนวกอัปเดตเข้ากับการดำเนินงานต่อ
ข้อควรระวัง: steering ไม่แก้ output ที่ส่งไปแล้ว ไม่ย้อนการกระทำก่อนหน้า และไม่ยกเลิกเครื่องมือที่เริ่มไปแล้ว มันเปลี่ยนทิศทางงานถัดไป ไม่ใช่สิ่งที่ทำไปแล้ว ถ้า steering ขัดจังหวะการตอบเดิม การตอบนั้นจะจบด้วย incomplete_details.reason: "steered" และมีการตอบใหม่พร้อมอัปเดต
เปลี่ยน reasoning ระหว่างบทสนทนา
คุณเพิ่มหรือลด reasoning effort ระหว่างบทสนทนาได้โดยเพิ่ม input item configuration_update ค่า effort ที่อัปเดตจะใช้จนกว่าจะมีการอัปเดตใหม่ OpenAI แนะนำให้คง reasoning.effort ระดับ request ไว้เพื่อให้ prompt prefix แคชได้
การรวมกันของการอ่านแคชถูกและ reasoning ที่ปรับได้ ทำให้ Sol ประหยัดสำหรับงานผสม ใช้ low กับงานติดตามผล แล้วสลับเป็น xhigh เมื่อเจองานยาก โดยไม่ต้องเขียน prompt ใหม่
Multi-agent (เบต้า)
Multi-agent เปิดให้ใช้แบบเบต้ากับ GPT-6.1 Sol และโมเดล GPT-5.6 ทั้งหมด เอเจนต์หลักสามารถสร้าง subagent ทำงานขนานกัน แต่ละตัวมี context จำกัดของตัวเอง แล้วรวมผลลัพธ์เป็นคำตอบสุดท้าย
เอกสาร OpenAI แนะนำสำหรับงานที่แบ่งเป็นสายงานอิสระ: สำรวจโค้ดเบสขนาดใหญ่หลายส่วน เปรียบเทียบข้อเสนอ ค้นคว้าแหล่งข้อมูลพร้อมกัน หรือสืบหาสาเหตุของปัญหาหลายข้อพร้อมกัน ค่าเริ่มต้น max_concurrent_subagents คือ 3
ข้อแลกเปลี่ยนคือการใช้โทเคนมากขึ้น เอเจนต์มากขึ้นใช้โทเคนมากขึ้น ดังนั้น multi-agent คุ้มเมื่อความเร็วขนานและ context ที่โฟกัสสำคัญกว่าการประหยัดโทเคน
Compaction และ persisted reasoning
เอเจนต์ที่ทำงานนานจะเติม context window ในที่สุด Compaction ลดขนาด context โดยยังเก็บสถานะที่ต้องใช้ในรอบถัดไป เปิด compaction ฝั่งเซิร์ฟเวอร์ได้โดยตั้ง context_management พร้อม compact_threshold ในคำขอ Responses เซิร์ฟเวอร์จะส่ง compaction item ที่เข้ารหัสเมื่อจำนวนโทเคนเกิน threshold
GPT-6.1 Sol ยังรองรับ reasoning.context: "all_turns" ให้ reasoning item ที่เข้ากันได้จากรอบก่อนหน้าถูกนำไปใช้ในรอบถัดไป Persisted reasoning ยังคงเป็นกล่องดำ — API ไม่คืนข้อความ reasoning ดิบของโมเดล — แต่ให้โมเดลมีความต่อเนื่องในเซสชันยาว
WebSocket mode
WebSocket mode รักษาการเชื่อมต่อกับ Responses API และส่งเฉพาะ input ใหม่แต่ละรอบ OpenAI รายงานว่า ประมวลผล end-to-end เร็วขึ้นราว 40% สำหรับงานที่มีการเรียกเครื่องมือ 20 ครั้งขึ้นไป สำหรับโมเดลที่เน้นงานเขียนโค้ดอัตโนมัติและการใช้งานคอมพิวเตอร์ นี่คือชัยชนะด้าน latency โดยตรง
GPT-6.1 Sol vs GPT-6 Sol vs Astra vs Luna
ตระกูล GPT-6 มีสี่ระดับ เลือกใช้งานขึ้นกับคุณภาพที่ต้องการและความถี่ของเวิร์กโฟลว์
| โมเดล | ตำแหน่ง | Input / Output ต่อ 1M | เหมาะกับงาน |
|---|---|---|---|
| GPT-6 Astra | ฉลาดสูงสุด | $10 / $50 | เหตุผลซับซ้อน งานเขียนโค้ด และงานมืออาชีพ |
| GPT-6.1 Sol | ใกล้เคียง Astra ในราคาต่ำกว่า | $2 / $10 | งานเขียนโค้ดซับซ้อน การใช้งานคอมพิวเตอร์ งานเอกสาร |
| GPT-6 Sol | ระดับ Sol เดิม | $2 / $10 | งาน Sol เดิมก่อนอัปเกรด |
| GPT-6 Luna | เร็วและคุ้มค่าที่สุด | $0.10 / $0.50 | งานเฉพาะทาง ปริมาณมาก |
GPT-6.1 Sol และ GPT-6 Sol มีราคาเท่ากัน แต่ไม่ใช่โมเดลเดียวกัน หน้า Felo อธิบายว่า GPT-6.1 Sol คือการอัปเกรดที่ลดข้อผิดพลาดเชิงข้อเท็จจริงและปฏิบัติตามข้อจำกัดได้ใกล้เคียงขึ้น อัตราอ่านแคชก็ถูกลงครึ่งหนึ่ง: $0.10 ต่อหนึ่งล้านโทเคน แทน $0.20 ถ้าคุณใช้ GPT-6 Sol ในโปรดักชันอยู่แล้ว การอัปเกรดนี้เพิ่มทั้งคุณภาพและประสิทธิภาพแคชในราคาเดิม
คู่มือเลือกโมเดลของ OpenAI จับคู่ reasoning effort กับประเภทงาน:
- GPT-6.1 Sol ที่ medium — งานเทคนิคซับซ้อนและงานที่ต้องประสานกันและคาดว่าจะมีการแก้ไข
- GPT-6.1 Sol ที่ extra high — งานสำเร็จรูปที่ต้องความประณีต ระบบภาพที่เชื่อมโยงกัน และการตัดสินใจจากข้อมูลขัดแย้ง
- Astra ที่ low — งานเขียนกระชับและปรับเนื้อหาที่ต้องรักษาข้อเท็จจริงและรายละเอียด
- Astra ที่ medium — โปรเจกต์ใหญ่ที่ต้อง context กว้าง ปฏิสัมพันธ์เชื่อถือได้ และผลลัพธ์สมบูรณ์
- Astra ที่ extra high — การวิเคราะห์เข้มข้นและงานซับซ้อนที่ต้องข้อกำหนดเป๊ะ
- Luna ที่ low — แก้ไขละเอียด งานแก้ปัญหาขอบเขตชัด และดึงข้อมูลง่าย
- Luna ที่ extra high — หบริบทปัจจุบันจากหลายแอป จัดลำดับงาน และแก้ปัญหาข้อจำกัดชัดเจน
กฎปฏิบัติจาก Codex ของ OpenAI: ใช้ Sol กับงานซ้ำ ๆ ยาว ๆ บนโค้ด แอป และเอกสารเมื่อราคาสำคัญ เก็บ Astra สำหรับงานที่ต้องการสูงสุด ใช้ Luna กับงานที่ชัดเจน ทำซ้ำได้
วิธีเรียกใช้ GPT-6.1 Sol ผ่าน Felo API Platform
Felo API Platform เปิดให้ใช้ GPT-6.1 Sol ผ่าน endpoint ที่เข้ากันได้ คุณจึงใช้ SDK เดิมได้โดยเปลี่ยน base URL
โมเดลนี้ใช้งานได้ที่:
- Chat Completions:
POST https://openapi.felo.ai/api/v1/chat/completions - Responses:
POST https://openapi.felo.ai/api/v1/responses - Messages (Anthropic-compatible):
POST https://openapi.felo.ai/api/v1/messages
ขั้นตอนที่ 1: ขอ API key
สร้างคีย์จากบัญชี Felo API Platform แล้ว export:
export FELO_API_KEY="YOUR_API_KEY"
ขั้นตอนที่ 2: ส่งคำขอแรก
curl https://openapi.felo.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "messages": [
      {"role": "user", "content": "Explain the tradeoff between reasoning effort and cost."}
    ]
  }'
ขั้นตอนที่ 3: ใช้ SDK ที่เข้ากันได้
ชี้ SDK ที่รองรับ OpenAI ไปที่ https://openapi.felo.ai/api/v1 สำหรับไคลเอนต์สไตล์ Claude ใช้ base URL ที่เข้ากันกับ Anthropic https://openapi.felo.ai/api
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FELO_API_KEY,
  baseURL: "https://openapi.felo.ai/api/v1",
});

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  input: "Review this pull request for correctness, security, and missing tests.",
});

console.log(response.output_text);
ขั้นตอนที่ 4: เปิดใช้งาน streaming เมื่อจำเป็น
เพิ่ม stream: true เพื่อรับ server-sent events ขณะโมเดลทำงาน
หน้าโมเดลของ Felo ระบุ GPT-6.1 Sol ที่ $2.00 ต่อหนึ่งล้านโทเคนขาเข้า และ $10.00 ต่อหนึ่งล้านโทเคนขาออก พร้อมราคาเปิดตัวที่อาจต่ำกว่าราคา API ของผู้ให้บริการถึง 50% ราคาสุดท้ายขึ้นกับโมเดล สัดส่วน input/output การใช้แคช และแผนที่ใช้งาน ค่าอ่านแคชคิดครึ่งหนึ่งของ GPT-6 Sol
แพลตฟอร์มยังรองรับ reasoning, เครื่องมือ, เอาต์พุต JSON, streaming และ vision สำหรับโมเดลนี้ และมี Playground ให้ทดสอบ prompt ก่อนเขียนโค้ด
กรณีใช้งานที่เหมาะกับ GPT-6.1 Sol
คำแนะนำของ OpenAI ชี้ไปที่โปรเจกต์ซับซ้อนที่ต้องคุมต้นทุน มีรูปแบบเด่น ๆ ดังนี้
เอเจนต์เขียนโค้ดอัตโนมัติขนาดใหญ่
เอเจนต์ที่อ่าน repository เสนอการเปลี่ยนแปลง รันทดสอบ และวนซ้ำ คือเวิร์กโหลดที่ Sol ออกแบบมา หน้าต่าง context 1.05M เก็บโค้ดเบสขนาดใหญ่ ส่วนลดอ่านแคชคุ้มเมื่อใช้ context repository ซ้ำ และ async tool calling ช่วยให้เอเจนต์ทำงานต่อขณะรันทดสอบ
คำแนะนำ Codex ของ OpenAI แนะนำ Sol สำหรับงานซ้ำ ๆ ยาว ๆ บนโค้ดและแอปเมื่อราคาสำคัญ และเก็บ Astra สำหรับงานที่ต้องการสูงสุด
การใช้งานคอมพิวเตอร์และเวิร์กโฟลว์อัตโนมัติ
GPT-6.1 Sol รองรับเครื่องมือ Responses ครบชุด เช่น computer_use, hosted_shell, apply_patch, mcp, และ tool_search เหมาะกับเอเจนต์ที่ควบคุมซอฟต์แวร์ กรอกฟอร์ม ย้ายข้อมูลระหว่างระบบ หรืออัตโนมัติธุรกิจหลายขั้นตอน
หน้าโมเดลของ Felo ระบุการใช้งานคอมพิวเตอร์และเวิร์กโฟลว์อัตโนมัติหลายขั้นตอนเป็นกรณีหลัก
งานเอกสารระดับมืออาชีพ
Sol รับทั้งข้อความและรูปภาพ ครอบคลุมเอกสารสแกน กราฟ ภาพหน้าจอ และสไลด์ คู่มือเลือกโมเดลของ OpenAI ยกตัวอย่างสองกรณี: สร้างพรีเซนต์บอร์ดจากผลประกอบการ และสร้างเว็บไซต์จากบรีฟสินค้า ทั้งสองใช้ input ขนาดใหญ่ แก้ไขหลายรอบ และต้องคุณภาพสูงกว่าระดับ "ถูกและเร็ว" แต่ไม่ถึง "ดีที่สุด"
วิจัยและวิเคราะห์แบบขนาน
เปิด multi-agent beta แล้ว Sol แบ่งงานวิจัยเป็นสายงานอิสระ รันพร้อมกัน แล้วรวมผลลัพธ์ เปรียบเทียบข้อเสนอ vendor ตรวจ pull request หลายมุม หรือสืบหาสาเหตุปัญหาหลายข้อ เหมาะกับรูปแบบนี้
ประมวลผลชุดใหญ่ปริมาณมาก
Batch และ Flex ลดราคา Sol เหลือ $1 input และ $5 output ต่อหนึ่งล้านโทเคน สำหรับประมวลผลเอกสารข้ามคืน สรุปผลจำนวนมาก หรือดึงข้อมูลขนาดใหญ่ที่ต้องตรวจ output ราคานี้เปลี่ยนสิ่งที่ทำได้ในเชิงเศรษฐกิจ
เช็กลิสต์ย้ายจาก GPT-6 Sol ไป GPT-6.1 Sol
OpenAI แนะนำให้ตรวจคู่มือย้ายโมเดลก่อนเปลี่ยนจาก gpt-6-sol เป็น gpt-6.1-sol นี่คือสรุปแบบย่อ
- ตั้ง model ID เปลี่ยน
modelเป็นgpt-6.1-sol - แก้ reasoning effort GPT-6.1 Sol ไม่รองรับ
noneหรือminimalแทนที่noneด้วยlowและทดสอบย้ายminimalโดยเริ่มที่low - ย้ายการเรียกเครื่องมือไป Responses Chat Completions ใช้ได้กับคำขอที่ไม่มีเครื่องมือ งานที่เรียกฟังก์ชัน ค้นเว็บ ค้นไฟล์ ใช้งานคอมพิวเตอร์ หรือเวิร์กโฟลว์ MCP ต้องใช้ Responses API
- ลบพารามิเตอร์ที่ไม่รองรับ เมื่อ reasoning effort ไม่ใช่
noneให้ลบtemperature,top_p, และtop_logprobsใน Chat Completions ให้ลบlogprobsใน Responses ให้ลบmessage.output_text.logprobsออกจากinclude - อัปเดต config แคช prompt หากย้ายจาก GPT-5.5 หรือต่ำกว่า ให้แทนที่
prompt_cache_retentionด้วยprompt_cache_options.ttlเป็น"30m" - ใช้
configuration_updateสำหรับเปลี่ยน reasoning หากแอปของคุณปรับ effort ระหว่างรอบ ให้ใช้ itemconfiguration_updateแทนการเปลี่ยนreasoning.effortระดับ request เพื่อให้ prompt prefix แคชได้ - ตรวจสอบ data residency GPT-6.1 Sol รองรับ data residency สหรัฐฯ และสหภาพยุโรป Fast mode ใช้ไม่ได้กับ EU data residency
- ทดสอบเทียบ Astra รันทั้งสองโมเดลกับงานตัวอย่าง เปรียบเทียบคุณภาพ ความหน่วง และต้นทุนรวม — รวม reasoning token ที่คิดเป็น output token
ข้อจำกัดและการให้บริการ
GPT-6.1 Sol ไม่ใช่ตัวแทน Astra ได้ทุกกรณี และยังไม่เปิดให้ใช้ทุกที่
ข้อจำกัดด้านความสามารถ OpenAI วาง Sol ต่ำกว่า Astra งานที่ต้องเหตุผลสูงสุดและผลลัพธ์สำคัญมาก Astra ยังเป็นโมเดลแนะนำ Sol เหมาะกับงานซับซ้อนที่คุ้มค่า ไม่ใช่งานที่ต้องคุณภาพสูงสุด
ไม่มี fine-tuning GPT-6.1 Sol ไม่รองรับ fine-tuning หรือ output ที่คาดการณ์ล่วงหน้า ไม่รองรับ embeddings, สร้างภาพ, วิดีโอ, เสียง, ถอดเสียง, แปลภาษา หรือ endpoint moderation เป็นโมเดลรับข้อความและรูปภาพ ส่งออกข้อความพร้อม reasoning
ไม่มี input เสียงหรือวิดีโอ รับเฉพาะข้อความและรูปภาพ
ปิด reasoning ไม่ได้ ไม่รองรับ effort none และ minimal ทุกคำขอมี overhead reasoning
ยังทยอยเปิดให้ใช้ การเปิดตัวของ OpenAI ครอบคลุม Plus, Pro, Business, Enterprise, และ Edu ใน Codex บนเดสก์ท็อปและ CLI และ ChatGPT Work บนเว็บและมือถือ สำหรับ Enterprise และ Edu โมเดลปิดไว้จนแอดมินเปิด Free และ Go ไม่รวมในช่วงเปิดตัว
Fast mode มีข้อควรระวัง Standard และ Fast mode เปิดให้ใช้ตั้งแต่แรก แต่ Fast mode มีค่าใช้จ่าย 2x Standard และใช้ไม่ได้กับ EU data residency Ultrafast สำหรับ GPT-6.1 Sol จะตามมา
มี rate limit Standard rate limit อยู่ที่ 500 RPM และ 500,000 TPM ใน Tier 1 ถึง 15,000 RPM และ 40,000,000 TPM ใน Tier 5
คำถามที่พบบ่อย
GPT-6.1 Sol คืออะไร
GPT-6.1 Sol คือโมเดล GPT-6 สมดุลของ OpenAI อยู่ระหว่าง GPT-6 Astra รุ่นเรือธงและ GPT-6 Luna รุ่นน้ำหนักเบา OpenAI อธิบายว่าให้ประสิทธิภาพใกล้เคียง Astra สำหรับงานเขียนโค้ดซับซ้อน การใช้งานคอมพิวเตอร์ และงานมืออาชีพในราคาต่ำกว่า
GPT-6.1 Sol ราคาเท่าไร
OpenAI ระบุ GPT-6.1 Sol ที่ $2 ต่อหนึ่งล้านโทเคนขาเข้า และ $10 ต่อหนึ่งล้านโทเคนขาออก Cached input $0.10 ต่อหนึ่งล้านโทเคน Cache writes $2.50 ต่อหนึ่งล้านโทเคน Prompt เกิน 272K โทเคน input คิดราคาสูงขึ้น
Context window ของ GPT-6.1 Sol คือเท่าไร
GPT-6.1 Sol มี context window 1,050,000 โทเคน รับ input สูงสุด 922,000 โทเคน และ output สูงสุด 128,000 โทเคน
GPT-6.1 Sol รองรับการเรียกเครื่องมือหรือไม่
รองรับ แต่การเรียกเครื่องมือต้องใช้ Responses API Chat Completions ใช้ได้กับคำขอที่ไม่มีเครื่องมือ
ปิด reasoning ใน GPT-6.1 Sol ได้หรือไม่
ไม่ได้ GPT-6.1 Sol รองรับ reasoning effort low, medium, high, xhigh, และ max ไม่รองรับ none หรือ minimal
GPT-6.1 Sol ต่างจาก GPT-6 Sol อย่างไร
GPT-6.1 Sol คือการอัปเกรดจาก GPT-6 Sol ลดข้อผิดพลาดเชิงข้อเท็จจริงและปฏิบัติตามข้อจำกัดได้ใกล้เคียงขึ้น ตามหน้าโมเดล Felo ทั้งสองมีราคาโทเคนเท่ากัน แต่ GPT-6.1 Sol ลดอัตรา cached input เหลือ $0.10 ต่อหนึ่งล้านโทเคน
GPT-6.1 Sol มีใน Felo API Platform หรือไม่
มี Felo API Platform เปิดให้ใช้ GPT-6.1 Sol ผ่าน Chat Completions, Responses และ Messages ที่เข้ากันกับ Anthropic ราคาเปิดตัวอาจต่ำกว่าราคา API ของผู้ให้บริการถึง 50% และค่าอ่านแคชคิดครึ่งหนึ่งของ GPT-6 Sol
สรุป
GPT-6.1 Sol คือคำตอบของ OpenAI ต่อปัญหาจริง: โมเดลที่ดีที่สุดมักแพงเกินไปสำหรับทุกงาน ส่วนโมเดลที่ถูกที่สุดมักไม่ดีพอ Sol อยู่ตรงกลางด้วยความสามารถใกล้ Astra context window 1.05M อัตราอ่านแคช 5% และราคาหนึ่งในห้าของ Astra
สำหรับทีมที่สร้างเอเจนต์เขียนโค้ด เวิร์กโฟลว์คอมพิวเตอร์ และอัตโนมัติเอกสารขนาดใหญ่ นี่คือโมเดลที่ควรทดสอบก่อน เปรียบเทียบกับ Astra บนงานของคุณ ดูการใช้ reasoning token แล้วให้ต้นทุนและคุณภาพเป็นตัวตัดสิน
คุณลอง GPT-6.1 Sol ได้ใน Felo API Platform Playground หรือเรียกใช้ตรงด้วย Felo API key
แหล่งข้อมูล
- GPT-6.1 Sol model page — OpenAI
- Using GPT-6 — OpenAI
- Model selection — OpenAI
- API pricing — OpenAI
- Codex and ChatGPT model availability — OpenAI
- Async tool calling — OpenAI
- Mid-turn steering — OpenAI
- Reasoning models — OpenAI
- Prompt caching — OpenAI
- Compaction — OpenAI
- Multi-agent — OpenAI
- WebSocket mode — OpenAI
- Fast mode — OpenAI
- Data residency — OpenAI
- GPT-6.1 Sol — Felo API Platform
บทความนี้มีให้อ่านในภาษาต่อไปนี้ด้วย: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, Español, বাংলা and Português