Ayrımcı Yapay Zekâ: Karar Modelleri, Örnekler ve Kullanım Alanları

Ayrımcı yapay zekânın ve karar modellerinin girdileri nasıl sınıflandırdığını, yönlendirdiğini ve puanladığını, üretken yapay zekâdan farklarını ve geliştiricilerin bu modelleri kullanabileceği alanları öğrenin.
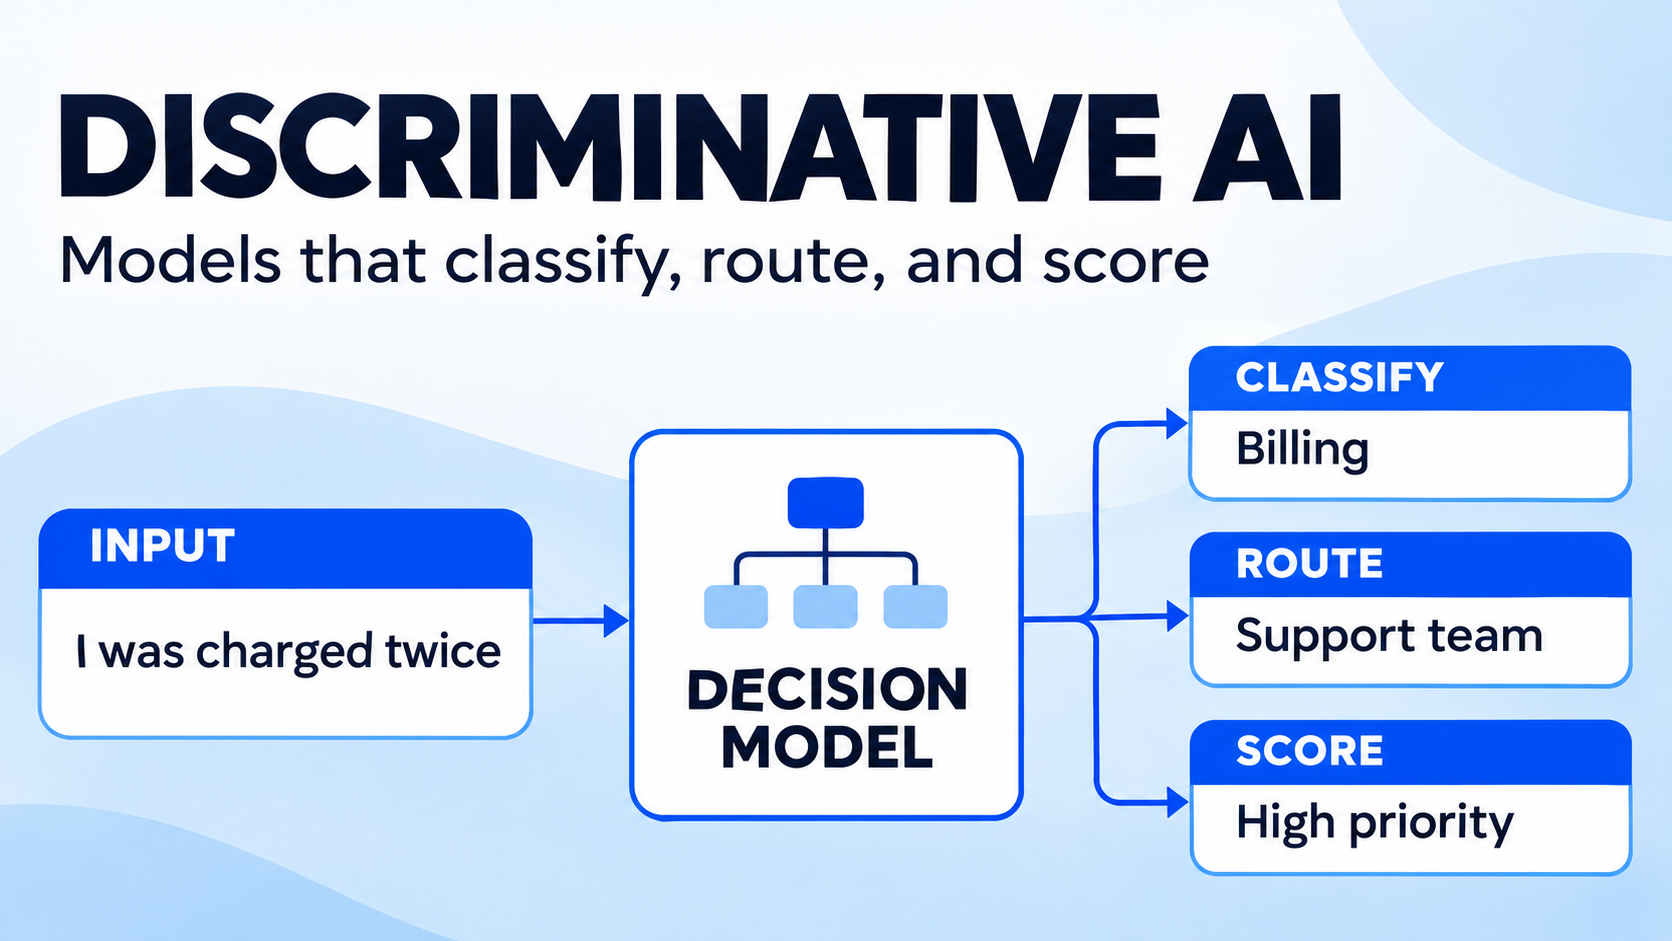
Bir destek talebi geliyor: “Benden iki kez ücret alındı ve para iadesi istiyorum.” Uygulamanızın bir yapay zekâ modelinden paragraf uzunluğunda bir yanıt alması gerekmeyebilir. Uygulamanın ilk ihtiyacı bir karar olabilir: Bu talep faturalandırma, teknik destek veya satış ekibine mi yönlendirilmeli?
Ayrımcı yapay zekâ (Discriminative AI), bir girdiden etiket, puan veya başka bir hedef tahmin etmek üzere tasarlanmıştır. Yeni bir karar modeli grubu, bu yaklaşımı geliştirici API'lerine taşıyor: Modele bağlam ve tanımlı bir soru verirsiniz; model, yazılımın kullanabileceği yapılandırılmış bir karar veya olasılık değerleri döndürür. Bu rehber, bu modellerin çalışma prensiplerini, üretken yapay zekâ ile birlikte hangi alanlarda kullanılabileceğini ve nasıl değerlendirileceğini açıklar.
Ayrımcı yapay zekâ nedir?
Ayrımcı yapay zekâ, bir girdi hakkında tahmin üretir. Bir spam filtresi e-postanın spam olup olmadığını tahmin eder; bir sınıflandırıcı destek talebini bir ekibe atar; bir risk modeli belirli bir sonucun gerçekleşme olasılığını hesaplar.
Makine öğreniminde ayrımcı modeller, genellikle girdiler x ile hedef y arasında bir eşleme öğrenir veya koşullu olasılığı P(y | x) tahmin eder. Hedef; bir sınıf, sayısal bir değer veya başka bir yapılandırılmış çıktı olabilir. Lojistik regresyon, destek vektör makineleri ve birçok sinir ağı sınıflandırıcısı ayrımcı yaklaşım örnekleridir. Her ayrımcı model olasılık döndürmez ve her sayısal puan kalibre edilmiş değildir.
Bu yaklaşımın temel fikri, günümüzün yapay zekâ asistanlarından çok daha eskiye dayanır. Yeni olan, doğal dilde görev açıklamalarını ve yanıt seçeneklerini kabul eden genel amaçlı karar API'lerinin kullanılabilir hâle gelmesidir. Bu sayede geliştiriciler, aynı arayüzü farklı sınıflandırma ve puanlama görevlerinde kullanabilir.
Yapay zekâ karar modeli nedir?
Günümüzün API ekosisteminde karar modeli (decision model), sağlanan bir girdi hakkında sınırları belirlenmiş soruları yanıtlamak üzere tasarlanan model veya hizmet anlamına gelir. Serbest biçimli bir yanıt oluşturmak yerine aşağıdaki gibi türlendirilmiş bir sonuç döndürür:
- Evet/hayır olasılığı: Bu mesajın para iadesi talebi içerme olasılığı nedir?
- Seçim: Bu destek talebini hangi departman karşılamalı?
- Puan: Bu yanıt, tanımlanmış kalite değerlendirme ölçütünde hangi seviyede yer alıyor?
Örneğin bir karar modeli, talebi faturalandırma kategorisine atayabilir ve her departman için olasılık tahminleri döndürebilir. Uygulamanız bu sonuçları kullanarak talebi yönlendirebilir, ek bilgi isteyebilir veya bir insan denetçiye iletebilir.
TypeSafe, Jev ailesini “System One” modelleri olarak adlandırır. Liquid AI, d1 karar modelini metin ve görüntü girdilerini kabul eden, çıktı belirteçleri üretmeden olasılık döndüren bir model olarak tanımlar. Google'ın ayrımcı modeller hakkındaki Codelab çalışması, bir uygulamada karar modelinin üretken modelle birlikte nasıl kullanılabileceğini gösterir.
Bu terimler birbiriyle ilişkilidir ancak birbirinin yerine kullanılamaz. Ayrımcı modelleme, geniş kapsamlı bir makine öğrenimi kavramıdır; karar modeli ise sınırları belirlenmiş kararlar için sunulan bir ürün veya arayüzdür. Üretken bir model de temel üretim süreci ve yanıt biçimi farklı olsa bile verilen istem aracılığıyla metin sınıflandırabilir.
Ayrımcı yapay zekâ ve üretken yapay zekâ karşılaştırması
| Ayrımcı Yapay Zekâ | Üretken Yapay Zekâ | |
|---|---|---|
| Tipik soru | “Bu girdiye hangi kategori uygun?” | “Hangi yanıt veya içerik üretilmeli?” |
| Yaygın çıktı | Etiket, tahmin, puan veya olasılık | Metin, kod, görüntü, ses veya başka bir üretilmiş içerik |
| Görev örneği | Müşteri talebini yönlendirmek | Müşteriye gönderilecek yanıtı hazırlamak |
| İncelenmesi gereken güçlü yön | Tutarlı, sınırları belirlenmiş kararlar ve kullanılabilir puanlar | Esnek sentez, açıklama ve içerik oluşturma |
| Temel değerlendirme konusu | Sınıflandırma hataları, kalibrasyon ve eşikler | Doğruluk, talimatlara uyum, güvenlik ve kullanışlılık |
Bu ayrım, bir modelin yalnızca tek bir görevi yerine getirebileceği anlamına gelmez. Bir LLM, JSON biçiminde etiketler döndürebilir; bir karar sistemi de daha geniş bir iş akışında üretken bir model kullanabilir. Uygulamadaki temel fark, her bileşenin hangi görevi yerine getirmek üzere optimize edildiği ve hangi işlevle sunulduğudur. Tek başına yapılandırılmış bir API yanıtı, olasılıkların kalibre edildiğini veya temel modelin ayrımcı olduğunu kanıtlamaz.
Para iadesi talebini ele alalım. Bir karar modeli sorunu faturalandırma olarak tanımlayabilir ve aciliyet düzeyini tahmin edebilir. Ardından üretken bir model, ilgili iade politikasını kullanarak empati içeren bir yanıt hazırlayabilir. Uygulama, işlem yapmadan önce politikayı, izinleri ve gerekli insan onaylarını kontrol etmelidir.
Karar modellerinin bir uygulamada çalışma şekli
Kesin şema sağlayıcıya göre değişir ancak tipik bir karar isteği üç bölümden oluşur:
- Durum: Değerlendirilecek bilgiler; örneğin destek talebinin metni veya bir görüntü.
- Soru ve ölçütler: Verilecek karar ve izin verilen yanıtların veya puan seviyelerinin açıklamaları.
- Türlendirilmiş yanıt: Uygulamanın yorumlaması için döndürülen etiket, puan veya olasılık dağılımı.
Örneğin:
State: "I was charged twice for my subscription."
Question: Which team should handle this request?
Options: billing, technical support, sales
Illustrative result: billing
Bu, kavramsal bir örnektir; gerçek bir API yanıtı değildir. Uç noktaya bağlı olarak model güven düzeyi veya olasılık değerleri de sağlayabilir. Tüm sağlayıcıların aynı istek biçimini kullandığını veya aynı girdi türlerini desteklediğini varsaymak yerine ilgili modelin ve API'nin belgelerini inceleyin.
Olasılık puanları ne anlama gelir?
Tahmin edilen bir olasılık, güvenilirliğini anlamanız durumunda işe yarar. Bir sistem benzer tahminlere 0,8 değeri atıyorsa iyi kalibre edilmiş bir sistemde bu gruptaki tahminlerin yaklaşık %80'inin doğru olması beklenir. Tek bir 0,8 puanı, belirli bir kararın doğru olduğunu garanti etmez.
Özellikle model, etiketler, diller veya girdi kaynakları değiştiğinde kendi verileriniz üzerinde kalibrasyonu kontrol edin. Güven düzeyi düşük durumları incelemeye yönlendirmek için eşikler kullanabilirsiniz. Ancak bu eşikleri yanlış pozitif ve yanlış negatif sonuçların maliyetlerine göre belirleyin. Dolandırıcılık inceleme kuyruğu ile zararsız bir içerik önerisi farklı kurallar gerektirir.
Ayrımcı yapay zekâ örnekleri ve kullanım alanları
Destek taleplerinin sınıflandırılması ve yönlendirilmesi
Bir karar modeli gelen mesajları faturalandırma, teknik destek veya hesap yönetimi kategorilerine atayabilir. Belirsiz talepler için “diğer” veya “inceleme gerekli” seçenekleri ekleyin ve birden fazla sorun içeren mesajları test edin. Yalnızca genel doğruluğu değil, her kategorideki hata oranını değerlendirin. Acil faturalandırma şikâyetlerini gözden kaçıran bir model, rutin soruların ağırlıkta olduğu bir veri kümesinde başarılı görünebilir.
İçerik denetimi
Bir içerik denetleme iş akışı, içeriğin tanımlanmış bir politika kategorisine girip girmediğini sorabilir. Modele açık ölçütler ve örnekler sağlayın, sınır durumlarını değerlendirin ve belirsiz veya önemli sonuçlar doğurabilecek durumları eğitimli denetçilere yönlendirin. Karar puanı, politika sürecine girdi sağlar; içeriğin bir kuralı ihlal ettiğinin kanıtı değildir.
LLM ve ajan yönlendirmesi
Bir LLM çağrısından önce uygulama, isteği konuya, karmaşıklığa veya gereken girdi türüne göre sınıflandırabilir. Yönlendirme bileşeni, ardından bir iş akışı seçebilir veya ek bilgi isteyebilir. Yönlendirmeyi sonraki sistemle birlikte test edin: İlk adımın maliyeti düşük olsa bile zor istekleri sürekli yanlış iş akışına gönderiyorsa bu yaklaşım işe yaramaz.
Belge ve görüntü ön sınıflandırması
Çok modlu bir karar modeli, bir görüntünün veya belgenin fatura, makbuz ya da destek ekran görüntüsü gibi önceden tanımlanmış bir kategoriye ait olup olmadığını sınıflandırabilir. İhtiyaç duyduğunuz girdi biçiminin ve görüntü işleme özelliklerinin ilgili uç nokta tarafından desteklendiğini doğrulayın. Sınıflandırma, belgedeki tüm alanları çıkarmaktan farklı bir görevdir. Seçtiğiniz modelin ve API'nin her iki görevi de destekleyip desteklemediğini kontrol edin.
Değerlendirme ölçütlerine göre puanlama
Bir model, “temel kanıt eksik”, “kısmen desteklenmiş” ve “tamamen desteklenmiş” gibi açıklamalar kullanarak bir yanıtı sıralı bir ölçeğe yerleştirebilir. Denetçilerin etiketler konusunda uzlaşıp uzlaşmadığını ve modelin benzer yanıtları tutarlı biçimde değerlendirip değerlendirmediğini test edin. Doğrulama olmadan değerlendirme puanlarını nesnel ölçümler olarak sunmayın.
Felo model kataloğunda bulunan karar modelleri
Felo model kataloğunda Decisions adlı bir çıktı filtresi bulunur. 2 Kasım 2026 tarihindeki katalog listesine göre örnekler şunlardır:
| Katalog listesi | Açıklanan kullanım alanı | Katalogda gösterilen girdiler |
|---|---|---|
| TypeSafe Jev 1.14 | Yönlendirme, sınıflandırma ve içerik denetimi | Metin ve görüntü; listede görüntü desteğinin deneysel olduğu belirtiliyor |
| LiquidAI d1.1 | Evet/hayır, seçim ve puan kararları | Metin ve görüntü |
| Baseten Joey 1 | Sınıflandırma ve yönlendirme | Metin ve görüntü |
| Perplexity Decider Flash V1.2 | Sınıflandırma, yönlendirme ve puanlama | Metin ve görüntü |
Bu açıklamalar katalog bilgilerini yansıtır; bağımsız performans testleri veya herhangi bir modelin en iyi seçenek olduğuna dair öneriler değildir. Kullanılabilirlik, özellik desteği, bağlam sınırları ve fiyatlandırma değişebilir. Özellikle deneysel veya çok modlu özellikler için geliştirmeye başlamadan önce güncel listeyi ve uç nokta belgelerini kontrol edin. Bir modelin katalogda listelenmesi, her sağlayıcının yerel API özelliğinin her platform üzerinden kullanılabildiğini kanıtlamaz.
Yapay zekâ karar modeli nasıl değerlendirilir?
Sınırları belirlenmiş tek bir kararla ve güvenilir etiketler içeren temsili örneklerden oluşan bir veri kümesiyle başlayın. Zor durumları, azınlık kategorilerini, eksik bağlamı ve insan müdahalesi gerektiren örnekleri dahil edin. Ardından modeli basit bir temel yöntem, mevcut bir sınıflandırıcı veya yapılandırılmış çıktı sağlayan bir LLM ile karşılaştırın.
Doğruluğun ötesinde şu ölçümleri değerlendirin:
- Kesinlik ve duyarlılık: Hangi hatalar önem taşıyor ve her sınıfta ne sıklıkta ortaya çıkıyor?
- Kalibrasyon: Tahmin edilen olasılıklar, vaka gruplarında gözlemlenen sonuçlarla örtüşüyor mu?
- Kapsama oranı: Seçtiğiniz eşik değerinde isteklerin ne kadarı otomatik olarak işlenebiliyor?
- Gecikme ve güvenilirlik: API çağrısının tamamı üretim gereksinimlerinizi karşılıyor mu?
- Maliyet: Yeniden denemeler, birden fazla soru, görüntü işleme ve insan incelemesi dahil olmak üzere kullanılabilir karar başına maliyet nedir?
- Sağlamlık: Performans farklı dillerde, biçimlerde, bilinmeyen örneklerde ve değişen trafik koşullarında korunuyor mu?
Etiketleri ve eşikleri ayarladıktan sonra modelin performansını eğitimde kullanılmamış bir test veri kümesiyle ölçün. Üretim ortamında uygun olduğu durumlarda sonuçları kaydedin, görüş ayrılıklarını inceleyin ve model sürümü, politika veya girdi dağılımı değiştiğinde yeniden değerlendirme yapın. Önemli sonuçlar doğuran kararlar için anlamlı insan denetimi tasarlayın ve geçerli gereklilikleri doğrulayın.
Sıkça sorulan sorular
Ayrımcı yapay zekâ ile karar modeli aynı şey midir?
Tam olarak değil. Ayrımcı yapay zekâ, bir girdiden hedef tahmin etmeye yönelik geniş kapsamlı bir yaklaşımı tanımlar. Karar modelleri ise seçimler, puanlar ve olasılıklar gibi sınırları belirlenmiş çıktılara odaklanan yeni bir ürün kategorisidir. Bazı karar modelleri ayrımcı teknikler kullanır ancak bu iki terim aynı kavramı ifade etmez.
Bir LLM sınıflandırma veya karar verme işlemi yapabilir mi?
Evet. Üretken bir LLM, içeriği sınıflandırmak veya yapılandırılmış çıktılar döndürmek üzere yönlendirilebilir. Özel bir karar modelinin daha iyi, daha hızlı veya daha düşük maliyetli performans gösterip göstermeyeceği göreve, modele, sağlayıcıya ve değerlendirme yöntemine bağlıdır. Her iki yaklaşımı da kendi örnekleriniz üzerinde test edin.
Karar modellerinin olasılık değerleri her zaman doğru mudur?
Hayır. Bir model, belirli bir veri kümesinde veya alt grupta hatalı kalibre edilmiş olasılıklar üretebilir. Bir iş akışını otomatikleştirmek için eşikler kullanmadan önce kalibrasyonu ve hataların sonuçlarını ölçün.
Üretken yapay zekâyı ne zaman kullanmalıyım?
Görev; metin hazırlama, açıklama, sentez veya açık uçlu içerik üretimi gerektiriyorsa üretken bir model kullanın. Birçok uygulamada karar modeli ve üretken model birlikte çalışır: Biri yönlendirme veya sınıflandırma yaparken diğeri yanıtı oluşturur.
Ayrımcı yapay zekâ, geliştiricilere iş akışlarına açık ve ölçülebilir kararlar ekleme olanağı sunar. Sınırları belirlenmiş tek bir görevle başlayın, önemli hataları test edin ve elde edilen kanıtların desteklediği otomasyon düzeyini belirleyin.
Felo kataloğundaki karar modellerini keşfedin →
Bu yazı şu dillerde de mevcut: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Italiano, ไทย, Español, বাংলা and Português.