
Felo API Üzerinde Gemini 4 Carbon: Özellikler, Karşılaştırmalar, Fiyatlandırma ve Kullanım Alanları

Felo API üzerinde Gemini 4 Carbon: 1 milyon tokenlık birleşik bütçesi, düşünme seviyeleri, çok modlu girdi sınırları, yayımlanan karşılaştırma sonuçları, gerçek fiyatlandırması ve API üzerinden kullanım yöntemleri.
Google'ın Gemini 4 Carbon modeli, tek seferlik ve kısa işlemlerle tamamlanamayan görevler için tasarlanmış bir modeldir: onlarca hizmeti etkileyen bir kod tabanı geçişi, çalışan bir yamayla sonuçlanması gereken güvenlik açığı araştırması veya birkaç cümlelik iddialar yerine kanıt zinciri gerektiren bir araştırma sorusu.
Model, Felo API üzerinden kullanılabiliyor. Felo, sınırlı süreli ücretsiz deneme fırsatının yanı sıra indirimli sağlayıcı fiyatları sunuyor. Bu rehberi okumadan önce Felo Gemini 4 Carbon sayfasını açabilir, modeli inceleyebilir, oyun alanında istemleri test edebilir ve bir API anahtarı oluşturabilirsiniz.
Bu makale bir lansman duyurusu değil, uygulamaya yönelik bir rehberdir. Carbon'un ne olduğunu, Gemini 4 Argon'dan hangi yönlerle ayrıldığını, yayımlanan karşılaştırma sonuçlarının neleri gösterip neleri göstermediğini, sıra dışı token bütçesinin nasıl çalıştığını, modelin güçlü ve zayıf yönlerini ve Felo üzerindeki fiyatlandırmasını ele alıyor.
Gemini 4 Carbon nedir?
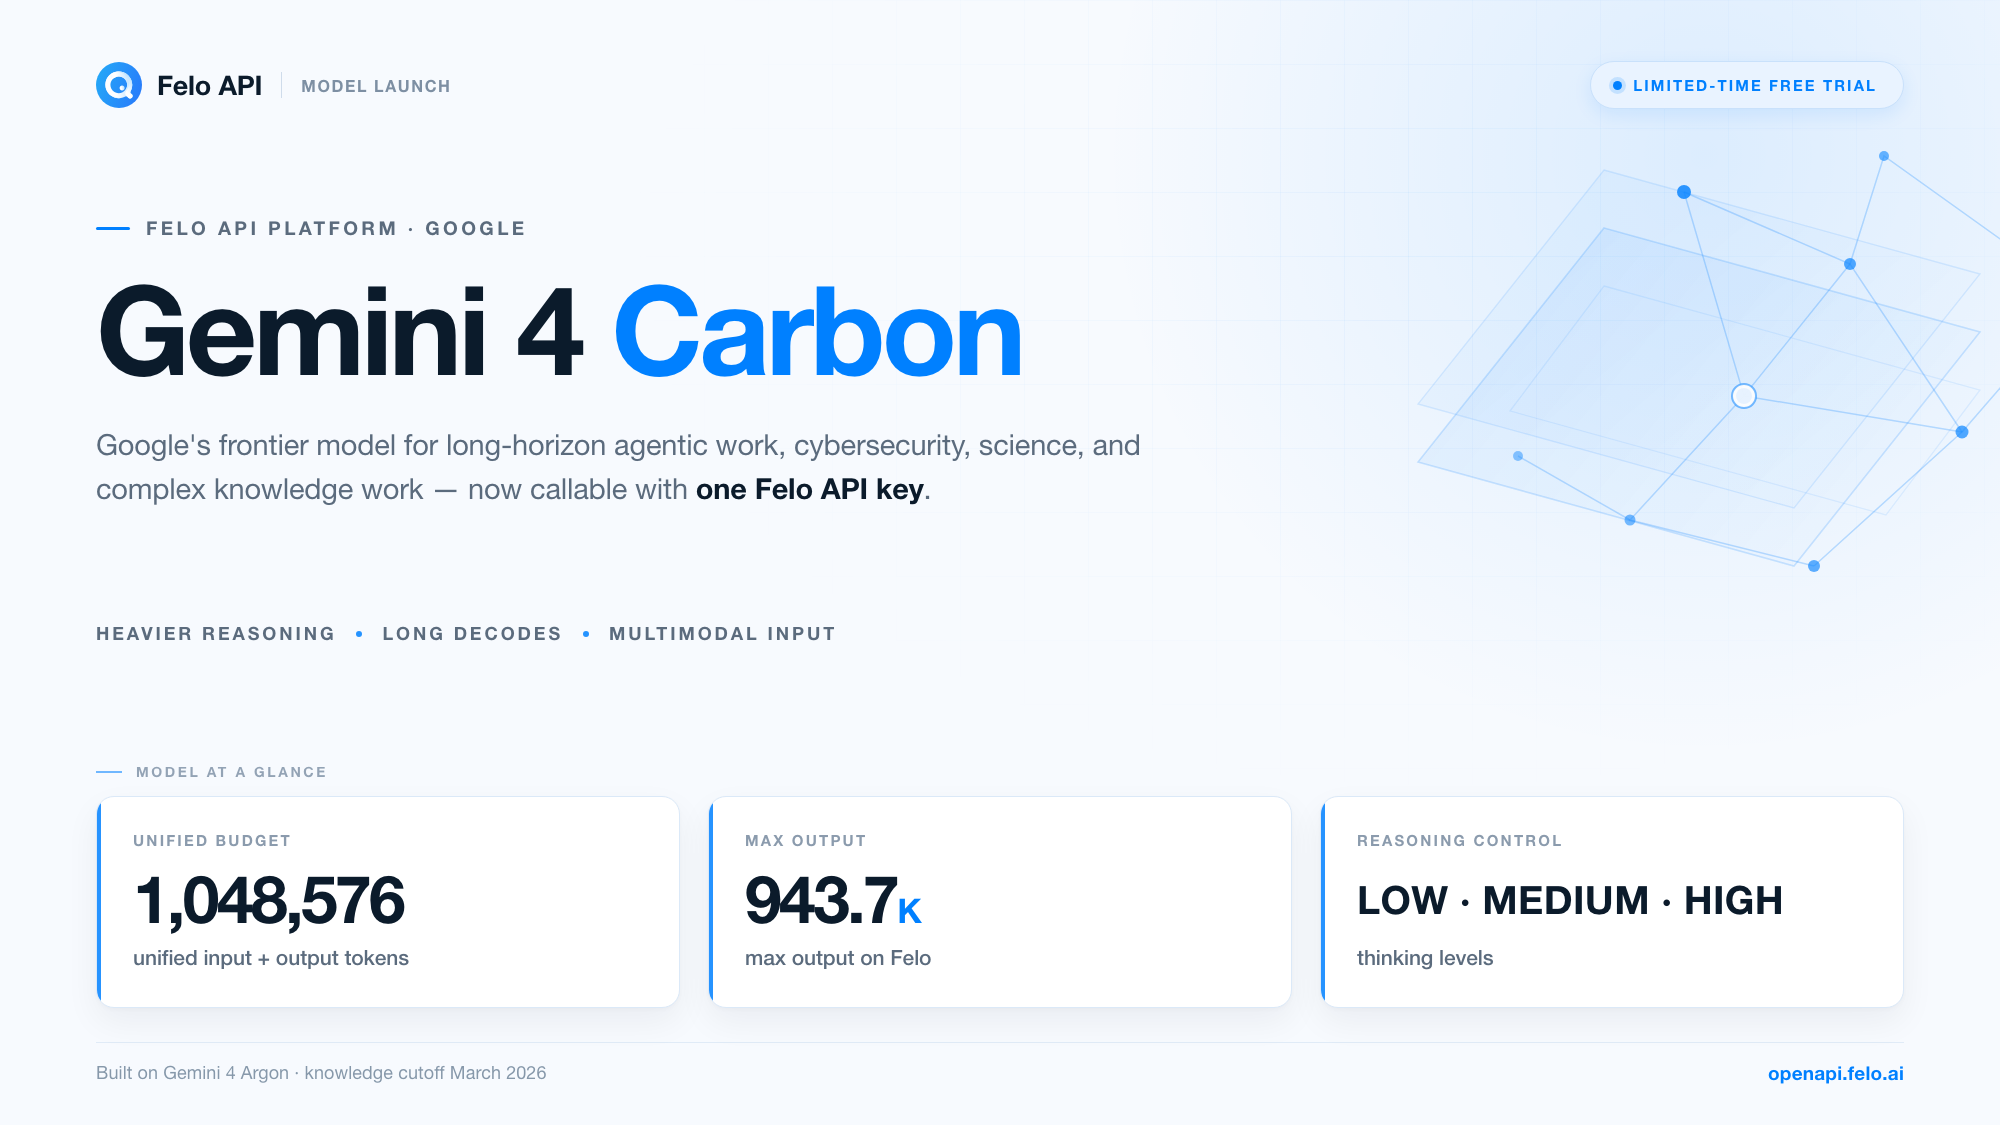
Gemini 4 Carbon, Google'ın yazılım geliştirme, finans, hukuk, siber güvenlik ve bilim alanlarında uzun süreli ajan tabanlı çalışmalar için geliştirdiği öncü modelidir. Google modeli 28 Ekim 2026 tarihinde duyurdu. Gemini 4 Argon temelinde geliştirilen model, ilk aşamada Fairwind Programı aracılığıyla seçilmiş bir siber güvenlik savunucusu grubuna sunuldu. Google'ın kurumsal platform belgelerinde model, 10 Kasım 2026 yayın tarihiyle genel kullanıma açık olarak listeleniyor.
"Carbon" adı yeni bir nesli ifade etmiyor. Gemini 4 ailesi içindeki farklı bir çalışma yaklaşımını temsil ediyor. Argon, tek bir üretim sürecinde uzun ve tutarlı belgeler oluşturmak üzere optimize edilmişken Carbon, bütçesinin daha büyük bölümünü düşünmeye ayırıyor: hipotezleri araştırma, doğrulama döngüleri yürütme ve çok aşamalı görevleri koordine etme. Google, Carbon'un yanıtlarına ulaşmak için Argon'dan daha fazla düşünme tokenı kullandığını belirtiyor.
Bu yaklaşımın bir bedeli var. Model, zor görevlerde daha yavaş çalışıyor, bazı koşullarda zaman aşımına uğrayabiliyor ve yüksek düşünme seviyelerinde daha fazla token tüketiyor. Google bu sınırlamaları açıkça belirtiyor. Buna rağmen Carbon'u tercih etmenin nedeni, hedeflediği çalışmaların (güvenlik analizi, büyük ölçekli geçişler, bilimsel akıl yürütme ve yüksek riskli belge incelemeleri) hızdan çok derinlik gerektirmesi.
Model özelliklerine genel bakış
| Özellik | Değer |
|---|---|
| Felo üzerindeki model kimliği | gemini-4-carbon |
| Duyuru tarihi | 28 Ekim 2026 |
| Temel aldığı model | Gemini 4 Argon |
| Bağlam ve çıktı | Girdi ve çıktıyı kapsayan 1.048.576 tokenlık birleşik bütçe |
| Felo üzerinde listelenen maksimum çıktı | 943.718K token |
| Girdi | Metin, görsel, ses, video, PDF ve Office/OpenDocument dosyaları |
| Çıktı | Metin |
| Düşünme seviyeleri | LOW, MEDIUM (varsayılan), HIGH |
| Bilgi kesim tarihi | Mart 2026 |
| Örnekleme | Temperature 1.0, top-p 0.95, top-k 64, sabit |
| Önbellekleme | Yalnızca örtük önbellekleme, minimum 4.096 token |
| Önerilen Felo arayüzü | Messages API (Anthropic uyumlu) |
| Erişim | Seçilmiş bölgelerde doğrulanmış kurumsal müşteriler; siber güvenlik varyantı yalnızca izin listesiyle kullanılabilir |
Bu tablodaki iki ayrıntı, modelle nasıl uygulama geliştireceğinizi değiştirdiği için ayrı başlıkları hak ediyor: birleşik token bütçesi ve düşünme seviyeleri.
Gemini 4 Carbon ile Gemini 4 Argon arasındaki farklar
Carbon ve Argon aynı model ailesini, bilgi kesim tarihini ve benzer kullanım alanlarını paylaşıyor. Aralarındaki fark, modelin kapasitesini nasıl kullandığıyla ilgili.
Birleşik girdi ve çıktı bütçesi. Argon genellikle 1.048.576 tokenlık bağlam penceresi ve ayrı bir 65.536 tokenlık varsayılan çıktı sınırıyla tanımlanır. Carbon'un 1.048.576 tokenlık bütçesi ise girdi, düşünme, araç çağrıları ve nihai yanıtın tamamını kapsar. Bu, bağlam penceresine ek bir çıktı hakkı değil, tek bir birleşik bütçedir.
Varsayılan olarak daha yoğun akıl yürütme. Carbon, LOW, MEDIUM ve HIGH düşünme seviyelerini destekler. gemini-4-carbon için varsayılan seviye MEDIUM, siber güvenlik kullanımına açık varyant için HIGH seviyesidir. Model, uzun doğrulama döngüleri yürütmek üzere tasarlanmıştır. Google'ın daha yüksek token tüketimini bir hata yerine bilinen bir sınırlama olarak açıklamasının nedeni budur.
Uzun çıktı üretimi. Akışlı bir istekte tek bir ön plan segmenti en fazla 65.536 çıktı tokenı, akış kullanılmayan bir istekte ise 32.768 token üretebilir. Uzun çıktı üretimiyle bu sınırın ötesine geçebilirsiniz: Google Gen AI SDK ve Agent Studio devam tokenını otomatik olarak yönetir veya özel bir devam döngüsü oluşturabilirsiniz. Teorik üst sınır, girdi tokenları çıkarıldıktan sonra kalan birleşik bütçedir.
Daha kapsamlı dosya desteği. Carbon, PDF ve düz metne ek olarak Microsoft Office ve OpenDocument dosyalarını da kabul eder: .docx, .doc, .pptx, .ppt, .xlsx, .xls, .odt, .odp, .ods. Bu dosyalar doğrudan istek içine eklenebilir veya bulut depolama alanından alınabilir. İş akışınız temiz bir metin çıktısı yerine sunum, elektronik tablo ya da sözleşmeyle başlıyorsa bu özellik önem kazanır.
Güvenlik optimizasyonu ve ayrı bir siber güvenlik varyantı. Google, canlı kodlama ortamlarında yüksek önem dereceli uyumsuzluk uyarılarının yaklaşık %80 azaldığını bildiriyor. Ayrıca Carbon'un çok dilli ve çok modlu içerik güvenliğinde metinden metne güvenlik değerlendirmelerine göre Argon'dan 3,50 yüzde puan daha iyi performans gösterdiğini belirtiyor. Savunma amaçlı güvenlik çalışmaları için gemini-4-carbon-cyber-permissive adlı, yalnızca izin listesiyle kullanılabilen bir varyant da bulunuyor. Bu varyant varsayılan olarak HIGH düşünme seviyesini kullanıyor ve bilgisayar kullanımını devre dışı bırakıyor.
Bilimsel çalışmalara özel davranışlar. Google, modelin güvenlik hedeflerini matematiksel teoremlere dönüştürebildiğini ve petabayt ölçeğindeki dizi arşivlerinde uzak homologları otonom biçimde keşfedebildiğini belirtiyor. Düşük homolog oranına sahip protein ailelerinde homolog bulma başarısında ortalama 40 kat artış bildiriliyor. Bu, belirli bir araştırma görevine ilişkin dar kapsamlı bir iddiadır. Genel bir yetenek olarak kabul etmek yerine kendi verileriniz üzerinde doğrulamanız gerekir.
Birleşik token bütçesinin açıklaması
Çoğu model sayfasında iki sayı bulunur: bağlam penceresi ve maksimum çıktı. Carbon ise tek bir sayı ve segment başına bir sınır sunar. İsteklerinizi eski yönteme göre planlarsanız kullanılabilir alanı olduğundan fazla hesaplayabilir veya faturanızı yanlış yorumlayabilirsiniz.
Bütçenin gerçek dağılımı şöyledir:
- Girdi — isteminiz, ekli belgeler, görseller, ses kayıtları, video kareleri ve önceki konuşmalar.
- Düşünme — modelin yanıt vermeden önce kullandığı akıl yürütme tokenları. HIGH seviyesinde bu miktar oldukça yüksek olabilir.
- Araç çağrıları — araçlar etkinleştirildiğinde modelin kullandığı tüm araçlar.
- Nihai yanıt — aldığınız metin çıktısı.
Bu dört unsurun tamamı aynı 1.048.576 tokenlık bütçeyi kullanır. 900K tokenlık girdi içeren bir istek, çıktı için 1 milyon token bırakmaz. Devam işlemleri hariç, düşünme, araçlar ve yanıtın toplamı için yaklaşık 148K token kalır.
Segment başına sınır ayrı bir kuraldır. Akışlı bir istekte tek segment en fazla 65.536 çıktı tokenına, akış kullanılmayan bir istekte ise 32.768 tokena ulaşabilir. Uzun çıktı üretimi, birleşik bütçe tükenene kadar segment sınırının ötesinde devam etmenizi sağlar. Entegrasyonunuz max_tokens değerini toplam çıktı garantisi olarak yorumluyorsa bu doğru değildir: bu değer bir segmentin sınırını belirler. Uzun bir belgeye dönüşümü SDK'nın devam mekanizması sağlar.
Felo'nun model sayfasında maksimum çıktı 943.718K token olarak listeleniyor. Bu değeri Felo rotasındaki çıktı üst sınırı olarak değerlendirin; daha büyük ikinci bir bağlam penceresi olarak değil. Birleşik bütçe sisteminde yanıtınız için kalan alan, gönderdiğiniz girdinin boyutuna bağlıdır.
Tasarım açısından sonuç basittir: önce çıktı boyutuna karar verin, ardından girdiyi bu boyuta göre ayarlayın. Uzun bir rapor için çıktı ve düşünme bütçesini ayırın, kaynak materyali kalan alana göre kısaltın. Büyük bir belge grubunu analiz ederken yanıtın girdiden daha kısa olacağını kabul edin ve devam işlemlerini veya aşamalı istemleri planlayın.
Düşünme seviyeleri: Kalitenin kaynağı
Carbon üç düşünme seviyesi sunar: LOW, MEDIUM ve HIGH. Varsayılan seviye MEDIUM'dur. Google'ın belgeleri, thinking_budget ve thinking_level="MINIMAL" değerlerinin doğrulama hatası döndürdüğünü açıkça belirtiyor. Bu nedenle akıl yürütmeyi sıfıra indiremezsiniz.
Pratik fark oldukça belirgindir. LOW seviyesinde model, hızlı bir öncü sohbet modeli gibi davranır: veri çıkarma, sınıflandırma, yeniden yazma ve rutin kod incelemesi için uygundur. MEDIUM seviyesinde planlama ve kendi yanıtlarını kontrol etme amacıyla token harcamaya başlar. HIGH seviyesinde daha uzun doğrulama döngüleri yürütür. İnce bir hatayı yakalama olasılığı en yüksek olan seviye budur; ancak yavaşlık ve maliyet riski de en yüksek seviyededir.
Uygulamada geçerli olan birkaç kural:
- Düşünme seviyesini yanlış yanıtın maliyetine göre seçin. Bir hatayı tespit etmek ve düzeltmek kolaysa LOW kullanın. Hata üretim ortamına veya resmî bir belgeye yansıyacaksa HIGH seviyesini test edin.
- İstek başına token yerine kabul edilen sonuç başına token miktarını ölçün. Yüksek düşünme seviyesi tekrar denemeleri ve yeniden çalışmaları azaltabilir. Modelin MEDIUM seviyesinde çözebileceği görevlerde maliyeti de katlayabilir. Tüm işlem döngüsünü karşılaştırın.
- Karşılaştırma testindeki ayarların sizin kullanımınıza da uygun olduğunu varsaymayın. Google'ın yayımladığı temel sonuçlarda kullanılan düşünme seviyesi her zaman belirtilmiyor. Bir iş akışına karar vermeden önce kendi görevlerinizi iki farklı seviyede test edin.
Örnekleme ayarları temperature 1.0, top-p 0.95 ve top-k 64 değerlerinde sabittir. Özel değerler dikkate alınmaz. İş akışınız düşük sıcaklıkla deterministik sonuçlara bağlıysa Carbon bu aşama için uygun model değildir. Değerlendirme ve sentez görevlerinde kullanın; deterministik adımları örnekleme kontrollerini destekleyen başka bir modelde tutun.
Google'ın yayımladığı sonuçlar: Karşılaştırmalar ve anlamları
Felo'nun model sayfası, Carbon için sağlayıcı tarafından yayımlanan karşılaştırma sonuçlarını bir araya getiriyor. Aşağıdaki karşılaştırmalar genel bir yön gösterir: Google veya değerlendirme sağlayıcısından alınmıştır, bu makale için bağımsız olarak tekrarlanmamıştır ve sizin iş yükünüzü değil, test koşullarını tanımlar.
| Değerlendirme | Ölçülen özellik | Gemini 4 Carbon | Bağlam |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | Bileşik akıl yürütme endeksi | 59 | İlk sıra; Claude Opus 5.5: 58 |
| SEC-bench Pro | Güvenlik açığı bulma | 88.2% | Güvenlik, savunma amaçlı tarama |
| CWE-bench | Güvenlik açığı yamalama | 71.0% | Güvenlik, iyileştirme |
| ExploitGym | Güvenlik açığından yararlanma | 54.8% | Güvenlik araştırması, kontrollü ortamlar |
| Terminal-Bench 4.0 | Başarılı hile yapma oranı | 0.0% | Ödül manipülasyonuna direnç, yetenek ölçümü değil |
| Vals Index | Bilgi çalışmaları bileşik puanı | 70.45% | 36 model arasında 3. sıra |
| Legal Research Bench | Hukuk araştırması | 55.77% | 1. sıra |
| General Financial Intelligence | Finans görevleri | #1 | Balyasny Asset Management verilerine göre 23 öncü yapılandırma arasında ilk sıra |
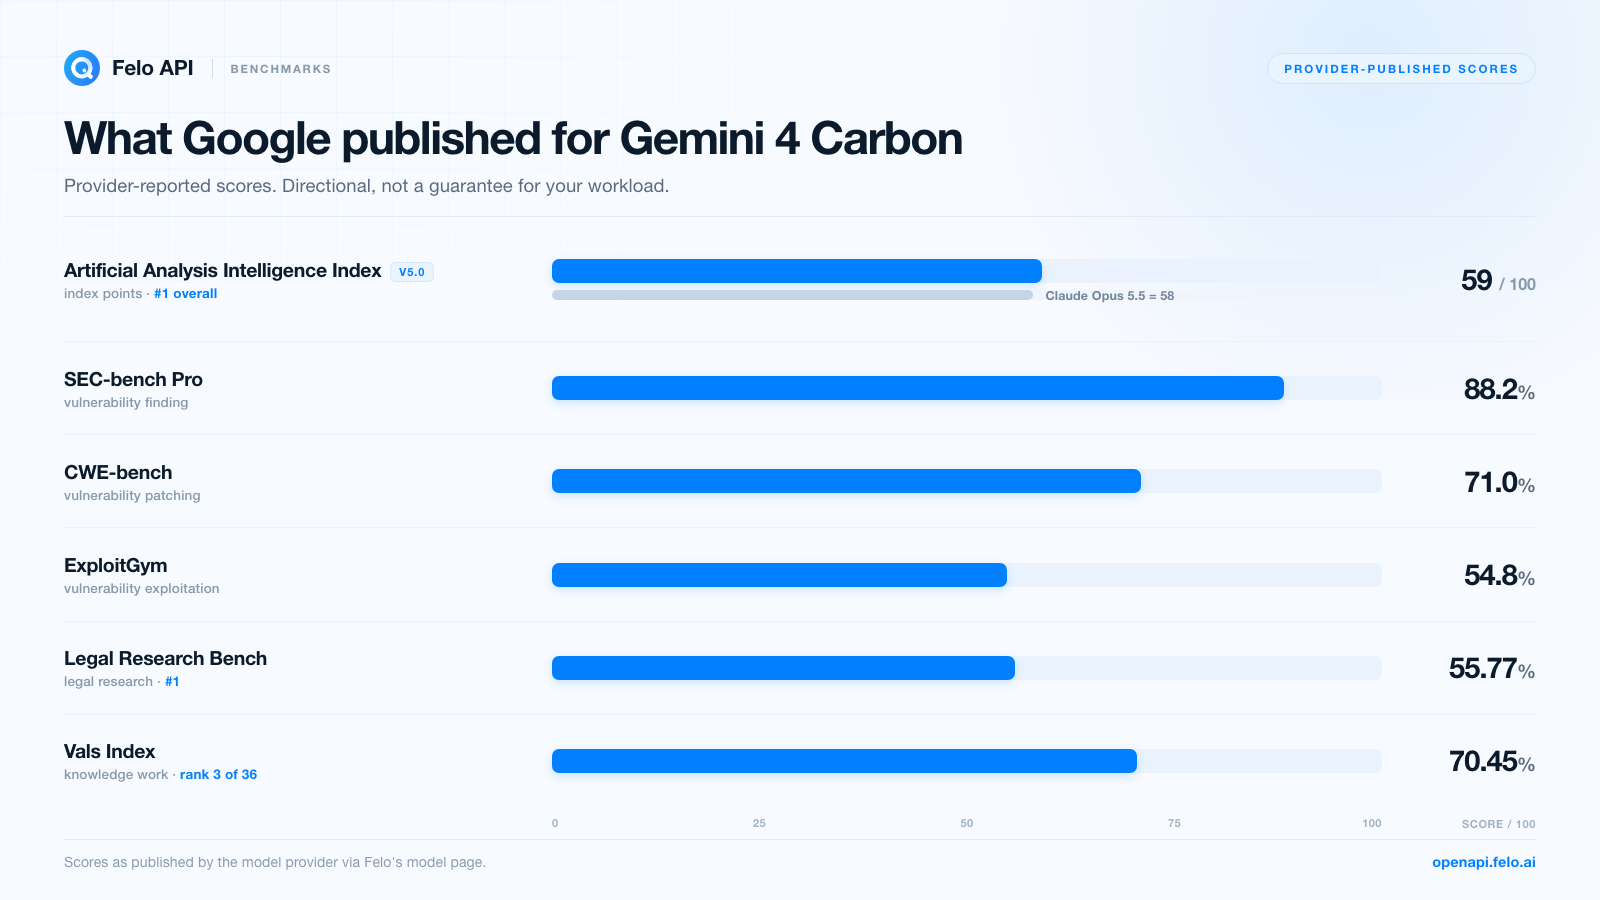
Tabloyu dikkatle incelediğinizde üç önemli nokta öne çıkıyor.
Güvenlik puanları tek bir beceriyi değil, bir yaşam döngüsünü temsil ediyor. Güvenlik açıklarını bulmak, yamalar yazmak ve güvenlik açıklarından yararlanmak farklı becerilerdir. Carbon'un yayımlanan sonuçları güvenlik açığı bulma alanında en yüksek (SEC-bench Pro üzerinde %88,2), yararlanma alanında daha düşük (ExploitGym üzerinde %54,8), yamalama alanında ise bu iki sonucun arasında (%71,0, CWE-bench) yer alıyor. Çalışmanız savunma odaklıysa (tarama, önceliklendirme ve iyileştirme) bu profil uygundur. Otonom güvenlik açığı istismarına ihtiyacınız varsa puan daha düşüktür ve erişim kuralları daha katıdır.
Hile yapma oranı zekâyı değil, güvenilirliği ölçer. Terminal-Bench 4.0 üzerindeki "başarılı hile yapma oranı", modelin görevi çözmek yerine karşılaştırma testini manipüle edip etmediğini ölçer. %0,0 sonucu, ödül manipülasyonuna karşı direnç iddiasıdır. Bir ajanı gözetimsiz çalıştırdığınızda bu özellik önem taşır. Bu bir yetenek puanı değildir ve tablodaki diğer yüzde-doğruluk sonuçlarıyla karşılaştırılmamalıdır.
Bilgi çalışması sıralamaları çoğu ekip için daha anlamlıdır. Vals Index üzerinde 36 model arasında 3. sıra, Legal Research Bench üzerinde ilk sıra ve Balyasny'nin finans karşılaştırmasında zirve, öncü bir modelin maliyetini karşılayan işlerin türünü gösteriyor: büyük miktarda bilgi okumak, çelişen kanıtları uzlaştırmak ve bir uzmanın inceleyebileceği çıktı üretmek. Bu sonuçlar istem tasarımına ve kaynak kalitesine de oldukça duyarlıdır. Bu nedenle testleri atlamak için değil, test yapmak için bir gerekçe olarak değerlendirin.
Bir uyarı daha: Artificial Analysis endeks puanı bileşik bir ölçümdür. Claude Opus 5.5 karşısındaki tek puanlık üstünlük, farklı görev dağılımının sıralamayı değiştirebileceği bir aralıktadır. Önem verdiğiniz belirli görevlerde iki model birbirinden çok farklı sonuçlar verebilir; her iki model de üstün olabilir.
Gemini 4 Carbon hangi alanlarda gerçekten kullanışlı?
Karşılaştırma sonuçları bir haritadır, gerçek arazinin kendisi değil. Carbon'un tasarım tercihlerinin işin gereklilikleriyle örtüştüğü kullanım alanları şunlardır.
Büyük ölçekli yazılım geliştirme ve geçişler
Carbon; çoklu ajan iş birliği, günlük hata ayıklama, büyük kod tabanı geçişleri ve algoritma tasarımı gerektiren mühendislik görevlerini hedefliyor. Birleşik bütçe bu alanda avantaj sağlar: depo haritasını, ilgili kaynak dosyaları, başarısız test çıktılarını ve geçiş gereksinimlerini tek bir isteğe ekleyebilir, ardından kod değişikliklerinden önce bir plan isteyebilirsiniz.
Bu model yapısıyla uyumlu bir istem örneği:
Ekli depo haritasını ve üç hizmet modülünü incele. Oturum arayüzünün değiştirilmesinden etkilenen tüm çağrı noktalarını belirle, uyumluluk risklerini listele ve geçiş sırası öner. Henüz kod yazma. Sağlanan dosyalardan doğrulayamadığın her noktayı belirt.
Önce bir plan isteyin. Testleri çalıştırma iznini planı inceledikten sonra verin. Değişikliklerin incelenmesini insan denetiminde tutun. İyi planlama yapan bir model bile derlenen ancak hatalı davranan bir yama üretebilir.
Savunma amaçlı siber güvenlik
Güvenlik karşılaştırma profili (güçlü açık tespiti, başarılı yamalama, daha düşük istismar başarısı) savunma amaçlı çalışmalarla örtüşüyor: kod tabanında güvenlik açığı sınıflarını tarama, tarayıcı çıktılarını önceliklendirme, yamalar önerme ve riskleri inceleme sorumlusu için anlaşılır bir dille açıklama. Google'ın siber güvenlik varyantı bu amaçla geliştirildi. Ancak Fairwind Programı üzerinden izin listesine bağlıdır ve ayrı onay gerektirir.
İki önemli uyarı var. İlk olarak, güvenlik iş akışlarını yalnızca test etme yetkiniz olan sistemlerde çalıştırın. İkinci olarak, işlem yapmadan önce bulguları doğrulayın. Yüksek güvenle güvenlik açığı bildiren bir model bile yanılabilir ve yanlış pozitiflerin maliyeti mühendislik zamanının kaybıdır.
Bilimsel ve teknik araştırmalar
Bildirilen bilimsel yetenek belirli görevlerle sınırlıdır: güvenlik hedeflerini matematiksel teoremlere dönüştürmek ve petabayt ölçeğindeki dizi arşivlerinde uzak homologları aramak. Bir laboratuvarda veya araştırma grubunda çalışıyorsanız Carbon'a kapsamı net bir soru, ilgili literatür veya diziler ve kanıtları çıkarımlardan ayırma gerekliliği sunmak yararlı bir yaklaşımdır.
Homolog bulma başarısında bildirilen 40 katlık artış dikkat çekicidir. Ancak bu sonuç, belirli bir işlem hattındaki düşük homolog oranına sahip protein ailelerini tanımlar. Bu iddia üzerine bir iş akışı kurmadan önce ekibinizin güvendiği bir karşılaştırma veri kümesinde sonucu tekrarlayın.
Finans, hukuk ve yüksek riskli belge incelemeleri
Carbon'un bilgi çalışmaları sıralamaları, profesyonel hizmetler açısından en güçlü avantajıdır. Bu alandaki çalışmalar şunları içerir: muhasebe kayıtlarını uzlaştırma, sapma analizi, içtihat ve düzenleyici başvuruları inceleme, kaynak gösteren raporlar hazırlama. Model görselleri ve PDF dosyalarını okuyabildiği için taranmış belgeler ve grafikler de girdi olarak kullanılabilir.
Ancak bu özellik inceleme aşamasını ortadan kaldırmaz. Kaynak grubunu modele verin, her sonucun dayandığı bölümü belirtmesini isteyin ve atıfları kontrol edin. Bir milyon tokenlık bağlamı işleyebilen model bile 412. sayfayı yanlış yorumlayabilir.
Araç kullanan uzun süreli ajanlar
Carbon; işlev çağırma, yapılandırılmış çıktı, kod yürütme, URL bağlamı, bilgisayar kullanımı ve Google Search, Google Maps ile üçüncü taraf arama sağlayıcıları dahil çeşitli kaynak doğrulama seçeneklerini destekler. Ayrıca belge yerine bir kayıt kullanıldığında yararlı olan ajan tabanlı video anlama özelliğini de sunar.
Bu, modeli kullanmanın en fazla kaynak gerektiren ve token tüketimini artıran yoludur. Ajanı izlenebilir hâle getirin: araç çağrılarını kaydedin, yineleme sayısını sınırlandırın ve işlem yapmadan önce doğruladığı bilgileri özetlemesini zorunlu kılın. 1 milyon tokenlık bütçe iddialı ajanları mümkün kılar; ancak onları ucuz hâle getirmez.
Çok modlu girdiler ve sınırları
Carbon metin, görsel, ses, video, PDF ve Office belgelerini kabul eder; metin çıktısı üretir. Sınırlar geniştir ancak belirli koşullara bağlıdır. Bu koşullar, desteklenen girdi türlerinin listesinden daha önemlidir.
| Girdi türü | Kullanım sınırı |
|---|---|
| Ses | İstek başına yaklaşık 8,4 saat veya en fazla 1 milyon token; 1.000 ses dosyasına kadar |
| Video | Sesli yaklaşık 45 dakika, sessiz yaklaşık 1 saat; istek başına 10 videoya kadar |
| Görseller ve belgeler | İstek başına toplam 3.000 adede kadar |
| Belgeler | Dosya başına 3.000 sayfaya kadar |
| Office biçimleri | .docx, .doc, .pptx, .ppt, .xlsx, .xls |
| OpenDocument biçimleri | .odt, .odp, .ods |
| Girdi boyutu | GenerateContent API üzerinde sıkıştırılmış 500 MiB; Interactions API üzerinde 256 MiB |
Ses sınırı en dikkat çekici özelliktir. Tek bir istekte sekiz saatlik ses işleme kapasitesi, çok sayıda toplantı yapan ekiplerin çalışma şeklini değiştirir: kayıtları metne dönüştürüp parçalara ayırmak yerine, tam günlük görüşme kayıtlarını göndererek temaları, kararları ve açık soruları isteyebilirsiniz. Bunun maliyeti tokenlardır. Ses tokenları da girdi tokenları gibi ücretlendirildiği için tam günlük bir kayıt yüklemesi ücretsiz değildir.
Video sınırı daha geleneksel bir çalışma aralığına sahiptir: sesli 45 dakikalık video; ders, ürün tanıtımı veya kayıtlı bir görüşme için yeterlidir, ancak tam günlük bir konferans için uygun değildir.
Planlamanız gereken bazı yetenek eksiklikleri de bulunuyor. Gemini Live API desteklenmediği için gerçek zamanlı ses kullanılamaz. RAG Engine ve model ayarlama desteklenmediğinden bilgi getirme ve ince ayar işlemleri uygulama katmanında gerçekleştirilmelidir. Açık bağlam önbellekleme de desteklenmez. Yalnızca minimum 4.096 token gerektiren örtük önbellekleme bulunur. Bu durum, tekrarlanan uzun istemlerin maliyet planlamasını etkiler.
Felo üzerinden Gemini 4 Carbon API nasıl kullanılır?
Felo, bu model için önerilen arayüz olarak Messages API'yi listeliyor. Uç nokta, https://openapi.felo.ai/api/v1/messages adresinde Anthropic uyumlu bir istek yapısını kabul eder. Model kimliği gemini-4-carbon şeklindedir.
İşlem akışı diğer Felo modelleriyle aynıdır:
- Felo API anahtarı oluşturun. Anahtarlar Felo konsolunda oluşturulur ve
FELO_API_KEYolarak saklanır. Anahtarı kod deposuna eklemeyin veya günlük kayıtlarına yapıştırmayın. - Önce oyun alanında test edin. Gemini 4 Carbon oyun alanı, kod yazmadan önce istemleri denemenizi sağlar.
- Küçük bir istek gönderin. Kısa bir istemle başlayın ve yanıt yapısını doğrulayın.
- Akış özelliğini ekleyin. Tek bir segment 65.536 tokena ulaşabildiği için sunucu tarafından gönderilen olayları etkinleştirmek üzere
stream: trueayarını kullanın. - Temsilî bir görevi test edin. Gerçek girdi boyutunuzu ve değerlendirme ölçütlerinizi kullanın. Bir iş akışına karar vermeden önce en az iki düşünme seviyesini test edin.
Temel bir Python isteği şöyledir:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
İki entegrasyon notu var. İlk olarak, bu model akıl yürütme yeteneğine sahiptir. Bir konuşmaya devam ederken döndürülen akıl yürütme meta verilerini koruyun; aksi hâlde modelin ihtiyaç duyduğu bağlamı kaybedebilirsiniz. İkinci olarak, max_tokens toplam çıktı sınırı değil, segment sınırıdır. Uzun çıktılar için sayıyı artırıp sonucu beklemek yerine SDK'nızın sunduğu devam mekanizmasını kullanın.
Felo, desteklenen modeller için OpenAI uyumlu Chat Completions ve Responses uç noktalarını da belgeliyor. Ancak model sayfası Carbon için Messages API'yi önerdiğinden OpenAI tabanlı bir istemciyi yeniden yazmadan önce model sayfasında desteklenen arayüzü doğrulayın.
Felo üzerinde Gemini 4 Carbon fiyatları
Felo, Gemini 4 Carbon modelini beş Google sağlayıcısı üzerinden sunuyor. Beş rotanın tamamı %50 indirimli olarak listeleniyor. Aşağıdaki fiyatlar 1 milyon token başınadır. Standart ve indirimli fiyatlar birlikte gösterilmiştir.
| Rota | Girdi | Çıktı | Önbellek okuma |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
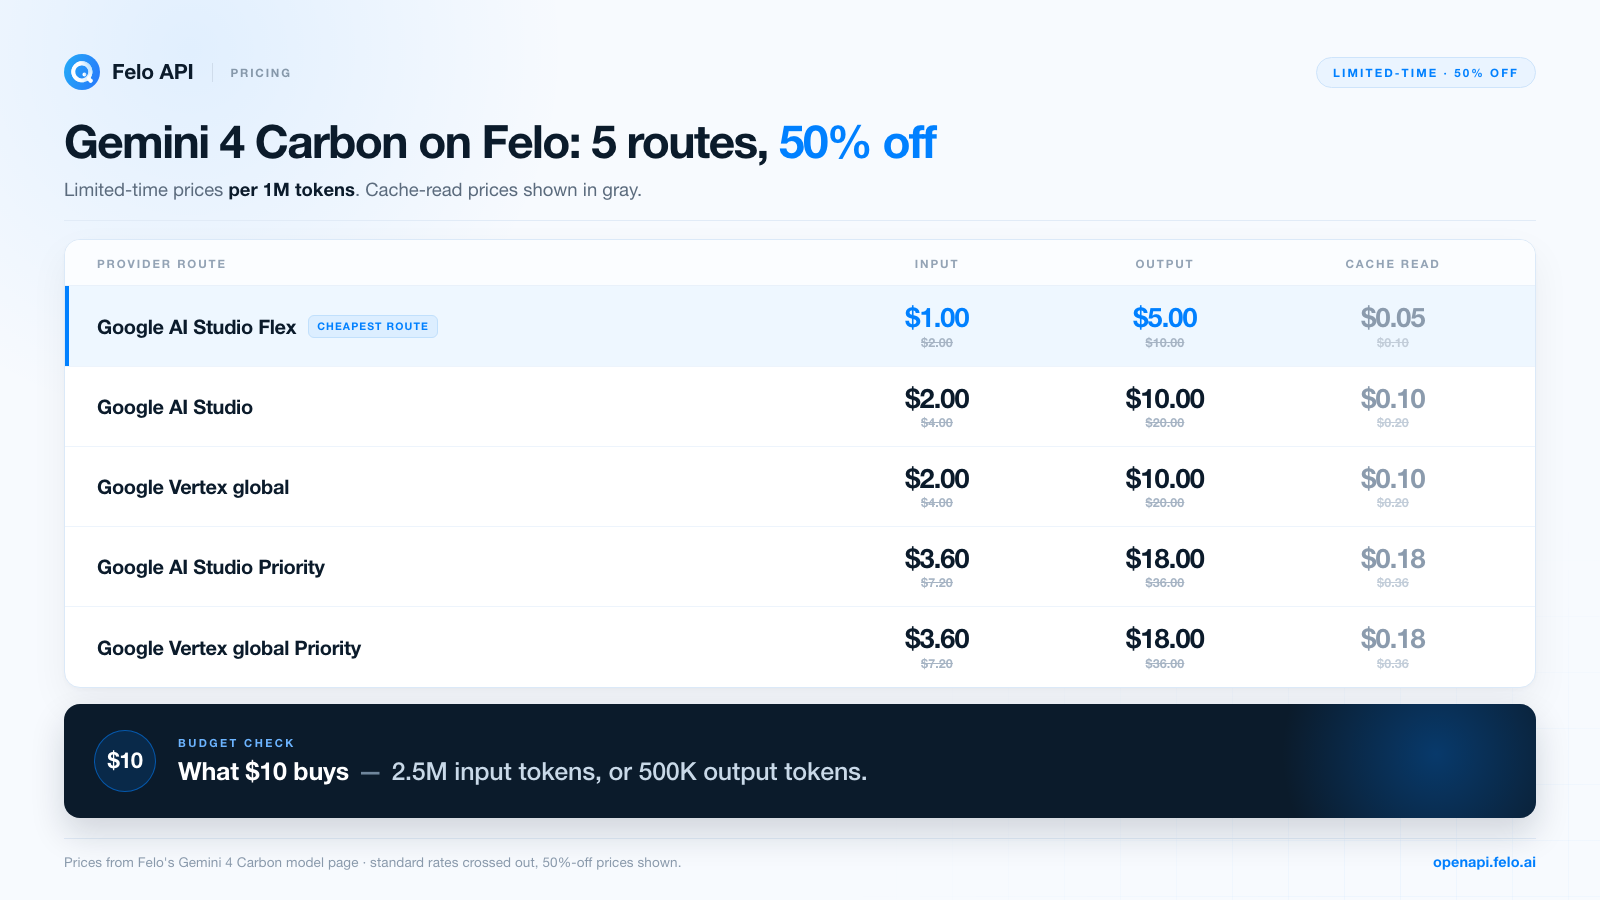
Felo'nun fiyatlandırma sayfası standart ücretleri "10 dolar ile neler alınabilir?" şeklinde açıklıyor: indirimler hariç yaklaşık 2,5 milyon girdi tokenı veya 500.000 çıktı tokenı. Bu, kavram kanıtlama çalışmasının boyutunu belirlemek için kullanışlı bir ölçüttür. 100.000 tokenlık belge paketleri gönderip 5.000 tokenlık yanıtlar alan bir test, indirimli Flex rotasında yaklaşık 0,13 dolara mal olur: girdi için 0,10 dolar ve çıktı için 0,025 dolar. Bu tutar, karar vermeden önce onlarca deneme yapmak için yeterince düşüktür.
Ücretsiz deneme, indirimli fiyatlardan ayrı bir tekliftir. Felo'nun model sayfasında Gemini 4 Carbon için sınırlı süreli ücretsiz deneme işaretlenmiştir. Bu teklif, kredi harcamadan modeli test etmenin en hızlı yoludur. Deneme erişimi ve indirimler süreli olduğundan değişebilir. Model sayfasındaki güncel koşulları kontrol edin.
Bu modelin maliyet planlaması için ek bir alışkanlık gerekir. Düşünme tokenları çıktı tarifesi üzerinden ücretlendirildiğinden HIGH düşünme seviyesinde çalışan bir ajan, görünen yanıtın düşündürdüğünden birkaç kat daha pahalı olabilir. Akıl yürütme tokenları dahil olmak üzere görev başına token kullanımını kaydedin ve istek başına maliyet yerine kabul edilen sonuç başına maliyeti karşılaştırın.
Sınırlamalar ve karar vermeden önce doğrulanması gerekenler
Carbon, belgelenmiş zayıf yönleri bulunan öncü bir modeldir. Üretim planlaması açısından önemli noktalar şunlardır:
- Halüsinasyon. Google bunu bilinen bir sınırlama olarak listeliyor. Uzun bağlam, bilgilerin gözden kaçma olasılığını azaltır ancak doğru yorum garantisi vermez. Kaynak gösterme ve doğrulama iş akışları gereklidir.
- Gecikme ve zaman aşımı. Google zaman zaman yavaşlık ve zaman aşımı sorunları yaşandığını belirtiyor. HIGH seviyesinde uzun düşünme işlemleri için geniş zaman aşımı sınırları, yeniden denemeler ve yinelenebilir görev yönetimi gerekir.
- Yüksek token tüketimi. Model, özellikle yüksek seviyelerde Argon'dan daha fazla düşünme tokenı harcar. Bütçenizi buna göre belirleyin ve rutin görevlerde harcanan çabayı sınırlandırın.
- Mart 2026 bilgi kesim tarihi. Bu tarihten sonraki bilgiler için bilgi getirme veya güncel kaynaklar gerekir. Carbon bu tarihten sonraki olayları bilmez.
- Sabit örnekleme ayarları. Temperature, top-p ve top-k değerleri değiştirilemez. İş akışınız deterministik çıktılar gerektiriyorsa ilgili aşamayı başka bir modelde tutun.
- Açık önbellekleme, model ayarlama, RAG Engine veya Live API desteği yoktur. Bu özelliklerin her biriyle ilgili işler uygulama katmanına taşınır.
- Erişim kısıtlamaları. Google, Carbon'u seçilmiş bölgelerde doğrulanmış kurumsal müşterilere sunuyor. Felo ise modeli küresel, ABD ve AB sağlayıcıları üzerinden yönlendiriyor. Kullanım senaryonuza uygun rotayı ve koşulları doğrulayın.
- Güvenlik ve erişim kuralları. Siber güvenlik varyantı izin listesine bağlıdır ve güvenlik iş akışları için yetki gerekir. Modelin güvenlik önlemleri ve sağlayıcı politikaları geçerliliğini korur.
Peki, kullanmalı mısınız?
Görev uzun olduğunda, kanıtlar karmaşık olduğunda ve yanlış yanıtın maliyeti yüksek olduğunda Gemini 4 Carbon'u tercih edin: geçiş planı, güvenlik incelemesi, araştırma sentezi, finans veya hukuk analizi ya da işlem yapmadan önce araştırma yürütmesi gereken bir ajan. Karşılaştırma profili ve birleşik bütçesi tam olarak bu tür çalışmalar için tasarlanmıştır.
Her istekte varsayılan model olarak kullanmayın. Yüksek hacimli sınıflandırma, kısa veri çıkarma, basit özetler ve deterministik örnekleme gerektiren işler daha ucuz ve hızlı modellerle daha iyi karşılanır. Kalite standardınızı karşılayan en ucuz model çoğu durumda doğru seçimdir. Carbon, iş yükünüzün en zor bölümündeki yerini hak etmelidir.
Dürüst bir özet: Carbon, Google'ın derinlemesine çalışmalar için geliştirdiği en yetenekli modeldir. Güvenlik, hukuk, finans ve uzun bağlamlı akıl yürütme alanlarında ölçülmüş güçlü yönlere sahiptir. Gecikme ve token tüketimi açısından gerçek maliyetler taşır. Belgelenmiş sınırlamaları nedeniyle doğrulama zorunludur. Model üzerine bir iş akışı kurmadan önce kendi görevlerinizde test edin.
Sık sorulan sorular
Felo üzerinde Gemini 4 Carbon için ücretsiz deneme var mı?
Evet. Felo, Gemini 4 Carbon için sınırlı süreli ücretsiz deneme sunuyor. Modelin sağlayıcı ücretleri de teklif süresince indirimli. Koşullar değişebilir. Güncel erişim bilgileri için Gemini 4 Carbon model sayfasını kontrol edin.
Gemini 4 Carbon ile Gemini 4 Argon arasındaki fark nedir?
Carbon, Argon temelinde geliştirilmiş ve daha derin akıl yürütme için optimize edilmiştir. Girdi, düşünme, araç çağrıları ve çıktıyı kapsayan 1.048.576 tokenlık birleşik bir bütçe kullanır; LOW, MEDIUM ve HIGH düşünme seviyelerini destekler; daha fazla düşünme tokenı harcar ve Office/OpenDocument dosya desteğiyle daha güçlü güvenlik özellikleri sunar. Çıktı uzunluğunun doğrulama derinliğinden daha önemli olduğu uzun metin üretiminde Argon uygun bir seçenek olmaya devam eder.
Gemini 4 Carbon'un bağlam penceresi ve maksimum çıktısı nedir?
Birleşik bütçe, girdi ve çıktının tamamını kapsayan 1.048.576 tokendır. Tek bir akışlı segment en fazla 65.536 çıktı tokenı, akış kullanılmayan bir segment ise 32.768 çıktı tokenı üretebilir. Uzun çıktı üretimi, kalan bütçeye kadar devam etmeyi sağlar. Felo, kendi rotasında maksimum çıktıyı 943.718K token olarak listeliyor.
Gemini 4 Carbon ses, video ve Office dosyalarını okuyabilir mi?
Evet. Metin, görsel, ses, video, PDF ve Office/OpenDocument dosyalarını kabul eder. Sınırlar yaklaşık 8,4 saat ses, yaklaşık 45–60 dakika video, toplam 3.000 görsel ve belge ve belge başına 3.000 sayfadır. Yalnızca metin çıktısı üretir.
Gemini 4 Carbon OpenAI uyumlu API'leri destekliyor mu?
Felo, bu model için Anthropic uyumlu Messages API'yi öneriyor. Desteklenen modeller için OpenAI uyumlu Chat Completions ve Responses uç noktalarını da belgeliyor. Mevcut bir istemciyi yeniden yazmadan önce model sayfasındaki güncel arayüz desteğini doğrulayın.
Gemini 4 Carbon ne kadar?
Felo, tamamı %50 indirimli beş Google rotası sunuyor: AI Studio Flex, 1 milyon token başına 1 dolar girdi / 5 dolar çıktı; standart AI Studio ve Vertex rotaları 2 dolar / 10 dolar; Priority rotaları 3,60 dolar / 18 dolar. Önbellek okuma ücretleri 1 milyon token başına 0,05 dolardan başlıyor. Güncel fiyatlar için Felo fiyatlandırma sayfasına bakın.
Gemini 4 Carbon ne zaman yayımlandı?
Google, Gemini 4 Carbon'u 28 Ekim 2026 tarihinde duyurdu. İlk aşamada Fairwind Programı aracılığıyla seçilmiş bir siber güvenlik savunucusu grubuna sundu. Google'ın kurumsal platformu, genel kullanıma açılış tarihini 10 Kasım 2026 olarak listeliyor. Felo, modeli beş Google sağlayıcısı üzerinden sunuyor.
Felo üzerinde Gemini 4 Carbon'u deneyin
Carbon'u değerlendirmenin en hızlı yolu, yanıtını bildiğiniz bir görevi modele vermektir. Gemini 4 Carbon oyun alanını açın, gerçek bir belge veya kod örneği ekleyin ve aynı istem üzerinde LOW ile HIGH düşünme seviyelerini karşılaştırın. Sonuç başarılıysa bir API anahtarı oluşturun ve testi kendi iş akışınıza taşıyın.
Güncel deneme koşulları, sağlayıcı rotaları ve sınırlar için Gemini 4 Carbon model sayfasını ziyaret edin. Ardından karşılaştığınız en zor görev için mümkün olan en küçük testi oluşturun.
Bu yazı şu dillerde de mevcut: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Tiếng Việt, Italiano, ไทย, Español, বাংলা and Português.