امتیازی AI: فیصلہ ساز ماڈلز، مثالیں اور استعمالات

جانیں کہ امتیازی AI اور فیصلہ ساز ماڈلز ان پٹس کی درجہ بندی، روٹنگ اور اسکورنگ کیسے کرتے ہیں، یہ جنریٹو AI سے کیسے مختلف ہیں، اور ڈویلپرز انہیں کہاں استعمال کر سکتے ہیں۔
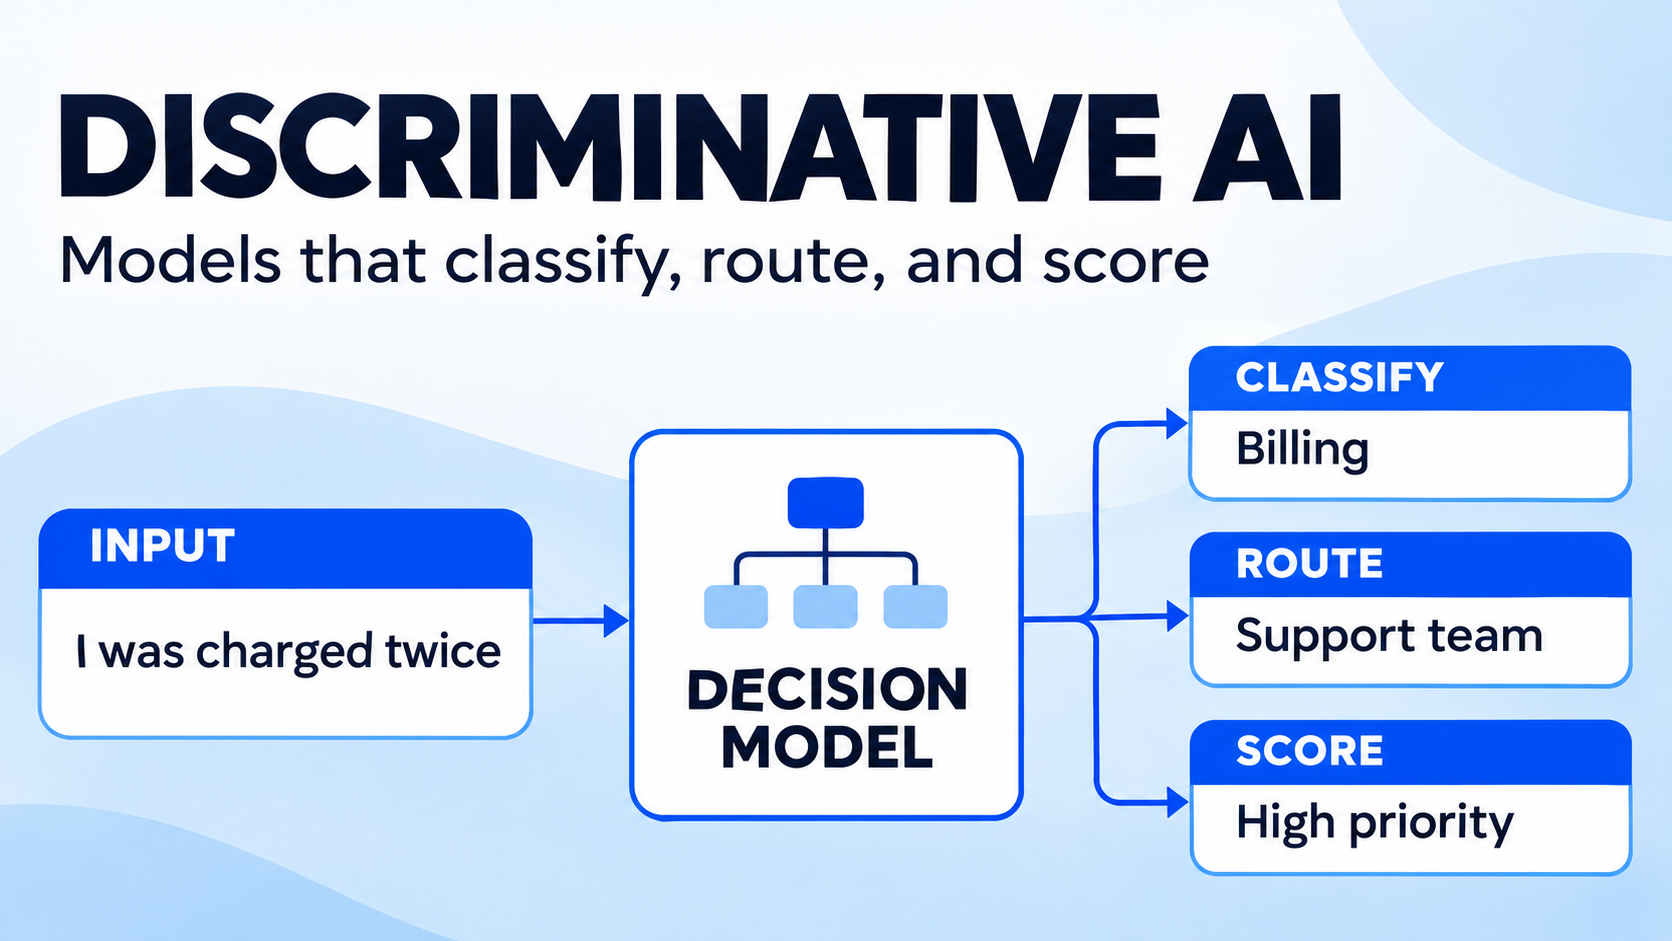
ایک سپورٹ درخواست موصول ہوتی ہے: "مجھ سے دو مرتبہ رقم وصول کی گئی ہے اور مجھے رقم کی واپسی درکار ہے۔" آپ کی ایپلیکیشن کو AI ماڈل سے ایک پیراگراف حاصل کرنے کی ضرورت نہیں ہے۔ اسے پہلے ایک فیصلہ درکار ہو سکتا ہے: کیا اس ٹکٹ کو بلنگ، تکنیکی معاونت یا سیلز کے شعبے میں بھیجا جانا چاہیے؟
امتیازی AI (Discriminative AI) کو کسی ان پٹ سے ایک لیبل، اسکور یا دوسرے ہدف کی پیش گوئی کے لیے تیار کیا گیا ہے۔ فیصلہ ساز ماڈلز کا ایک نیا گروپ اس تصور کو ڈویلپر APIs تک پہنچاتا ہے: ماڈل کو سیاق و سباق اور ایک متعین سوال دیں، اور یہ ایک منظم فیصلہ یا احتمالات واپس کرتا ہے جنہیں سافٹ ویئر استعمال کر سکتا ہے۔ یہ گائیڈ وضاحت کرتی ہے کہ یہ ماڈلز کیسے کام کرتے ہیں، جنریٹو AI کے ساتھ ان کی کیا جگہ ہے، اور ان کی جانچ کیسے کی جائے۔
امتیازی AI کیا ہے؟
امتیازی AI کسی ان پٹ کے بارے میں پیش گوئی کرتا ہے۔ اسپیم فلٹر یہ پیش گوئی کرتا ہے کہ آیا کوئی ای میل اسپیم ہے؛ ایک کلاسیفائر سپورٹ ٹکٹ کو کسی ٹیم سے منسلک کرتا ہے؛ ایک رسک ماڈل کسی متعین نتیجے کے امکان کا اندازہ لگاتا ہے۔
مشین لرننگ میں امتیازی ماڈلز عموماً ان پٹ x سے ہدف y تک ایک میپنگ سیکھتے ہیں، یا مشروط احتمال P(y | x) کا اندازہ لگاتے ہیں۔ ہدف کوئی کلاس، عددی قدر یا دوسرا منظم آؤٹ پٹ ہو سکتا ہے۔ لاجسٹک ریگریشن، سپورٹ ویکٹر مشینز اور بہت سے نیورل کلاسیفائر امتیازی طریقوں کی مثالیں ہیں۔ ہر امتیازی ماڈل احتمال واپس نہیں کرتا، اور ہر عددی اسکور کی کیلِبریشن درست نہیں ہوتی۔
اس تصور کی بنیاد آج کے AI معاونین سے پہلے رکھی گئی تھی۔ نئی پیش رفت عمومی مقاصد کے فیصلہ ساز APIs کی دستیابی ہے، جو قدرتی زبان میں کام کی وضاحت اور جواب کے انتخاب قبول کرتے ہیں۔ اس طرح ڈویلپرز ایک ہی انٹرفیس کو درجہ بندی یا اسکورنگ کے متعدد کاموں پر لاگو کر سکتے ہیں۔
AI فیصلہ ساز ماڈل کیا ہے؟
موجودہ API منظرنامے میں، فیصلہ ساز ماڈل (Decision Model) سے مراد عموماً ایسا ماڈل یا سروس ہے جو فراہم کردہ ان پٹ کے بارے میں محدود دائرہ کار کے سوالات کا جواب دینے کے لیے تیار کیا گیا ہو۔ آزادانہ انداز میں جواب لکھنے کے بجائے، یہ ایک متعین قسم کا نتیجہ واپس کرتا ہے، مثلاً:
- ہاں/نہیں کا احتمال: اس پیغام میں رقم کی واپسی کی درخواست ہونے کا کتنا امکان ہے؟
- انتخاب: یہ ٹکٹ کس شعبے کو موصول ہونا چاہیے؟
- اسکور: یہ جواب متعین معیارِ معیار بندی میں کس مقام پر آتا ہے؟
مثال کے طور پر، ایک فیصلہ ساز ماڈل بلنگ کا لیبل اور ہر شعبے کے لیے احتمالی اندازے واپس کر سکتا ہے۔ آپ کی ایپلیکیشن ان نتائج کو ٹکٹ کی روٹنگ، مزید معلومات کی درخواست یا انسانی جائزہ لینے والے کو بھیجنے کے لیے استعمال کر سکتی ہے۔
TypeSafe اپنی Jev فیملی کو "System One" ماڈلز کہتا ہے۔ Liquid AI اپنے d1 فیصلہ ساز ماڈل کو ایسا ماڈل قرار دیتا ہے جو متن اور تصاویر قبول کرتا ہے اور آؤٹ پٹ ٹوکنز تیار کیے بغیر احتمالات واپس کرتا ہے۔ امتیازی ماڈلز سے متعلق Google Codelab یہ دکھاتا ہے کہ کسی ایپلیکیشن میں فیصلہ ساز ماڈل کو جنریٹو ماڈل کے ساتھ کیسے استعمال کیا جا سکتا ہے۔
یہ اصطلاحات ایک دوسرے سے متعلق ہیں، لیکن ایک دوسرے کا متبادل نہیں ہیں۔ امتیازی ماڈلنگ مشین لرننگ کا ایک وسیع تصور ہے؛ فیصلہ ساز ماڈل محدود دائرہ کار کے فیصلوں کے لیے تیار کردہ ایک پروڈکٹ یا انٹرفیس ہے۔ جنریٹو ماڈل بھی پرامپٹ کے ذریعے متن کی درجہ بندی کر سکتا ہے، اگرچہ اس کا بنیادی جنریشن عمل اور جوابی فارمیٹ مختلف ہوتا ہے۔
امتیازی AI بمقابلہ جنریٹو AI
| امتیازی AI | جنریٹو AI | |
|---|---|---|
| عام سوال | "اس ان پٹ کے لیے کون سی کیٹیگری موزوں ہے؟" | "کون سا جواب یا مواد تیار کیا جائے؟" |
| عام آؤٹ پٹ | لیبل، پیش گوئی، اسکور یا احتمال | متن، کوڈ، تصویر، آڈیو یا دیگر تیار کردہ مواد |
| کام کی مثال | کسٹمر ٹکٹ کو متعلقہ شعبے میں بھیجنا | کسٹمر کے لیے جواب کا مسودہ تیار کرنا |
| قابلِ تحقیق خوبی | یکساں محدود فیصلے اور قابلِ استعمال اسکورز | لچکدار مواد کی ترکیب، وضاحتیں اور تخلیق |
| جانچ کا بنیادی پہلو | درجہ بندی کی غلطیاں، کیلِبریشن اور حدیں | درستگی، ہدایات پر عمل، حفاظت اور افادیت |
یہ حد اس بات کا اصول نہیں کہ ایک ماڈل صرف ایک ہی کام کر سکتا ہے۔ ایک LLM JSON لیبلز واپس کر سکتا ہے، اور فیصلہ ساز نظام بڑے ورک فلو کے اندر جنریٹو ماڈل استعمال کر سکتا ہے۔ عملی فرق اس بات میں ہے کہ ہر جزو کو کس کام کے لیے بہتر بنایا گیا ہے اور اسے کون سا کام انجام دینے کے لیے پیش کیا گیا ہے۔ صرف منظم API جواب اس بات کا ثبوت نہیں کہ اس کے احتمالات کی کیلِبریشن درست ہے یا اس کا بنیادی ماڈل امتیازی نوعیت کا ہے۔
رقم کی واپسی والے ٹکٹ کی مثال لیں۔ ایک فیصلہ ساز ماڈل مسئلے کو بلنگ سے متعلق شناخت کر سکتا ہے اور اس کی فوری نوعیت کا اندازہ لگا سکتا ہے۔ اس کے بعد ایک جنریٹو ماڈل متعلقہ رقم کی واپسی کی پالیسی استعمال کرتے ہوئے ہمدردانہ جواب کا مسودہ تیار کر سکتا ہے۔ کوئی کارروائی کرنے سے پہلے ایپلیکیشن کو پالیسی، اجازتوں اور انسانی منظوری کی ضروریات کی جانچ کرنی چاہیے۔
ایپلیکیشن میں فیصلہ ساز ماڈلز کیسے کام کرتے ہیں؟
درست اسکیما فراہم کنندہ کے لحاظ سے مختلف ہوتا ہے، لیکن ایک عام فیصلہ ساز درخواست میں تین حصے شامل ہوتے ہیں:
- حالت (State): جانچ کے لیے معلومات، جیسے ٹکٹ کا متن یا کوئی تصویر۔
- سوال اور معیار: کیا فیصلہ کرنا ہے اور قابلِ قبول جوابات یا اسکور کی سطحوں کی وضاحت۔
- متعین قسم کا جواب (Typed Response): ایپلیکیشن کی تشریح کے لیے واپس کیا گیا لیبل، اسکور یا احتمالات کی تقسیم۔
مثال کے طور پر:
State: "I was charged twice for my subscription."
Question: Which team should handle this request?
Options: billing, technical support, sales
Illustrative result: billing
یہ ایک تصوری مثال ہے، حقیقی API جواب نہیں۔ اینڈ پوائنٹ کے لحاظ سے ماڈل اعتماد کی سطح یا احتمالات بھی فراہم کر سکتا ہے۔ مخصوص ماڈل اور API کی دستاویزات پر عمل کریں، اور یہ فرض نہ کریں کہ تمام فراہم کنندگان ایک ہی درخواست کا فارمیٹ استعمال کرتے ہیں یا ایک جیسی موڈیلیٹیز کی معاونت کرتے ہیں۔
احتمالی اسکورز کا کیا مطلب ہے؟
پیش گوئی کردہ احتمال اسی وقت مفید ہوتا ہے جب آپ اس کی قابلِ اعتماد ہونے کی سطح سمجھتے ہوں۔ اگر کوئی نظام متعدد یکساں پیش گوئیوں کو 0.8 اسکور دیتا ہے، تو درست کیلِبریشن والا نظام اس گروپ میں تقریباً 80% مرتبہ درست ہونا چاہیے۔ ایک واحد 0.8 اسکور اس بات کی ضمانت نہیں کہ کوئی انفرادی فیصلہ درست ہے۔
اپنے ڈیٹا پر کیلِبریشن کی جانچ کریں، خاص طور پر ماڈل، لیبلز، زبانوں یا ان پٹ کے ذرائع میں تبدیلی کے بعد۔ کم اعتماد والے معاملات کو جائزے کے لیے بھیجنے کی خاطر آپ حدیں مقرر کر سکتے ہیں، لیکن ان حدوں کا انتخاب غلط مثبت اور غلط منفی نتائج کے اخراجات کو مدنظر رکھ کر کریں۔ فراڈ کے جائزے کی قطار اور بے ضرر مواد کی سفارش کے لیے مختلف قواعد درکار ہوتے ہیں۔
امتیازی AI کی مثالیں اور استعمالات
سپورٹ ٹکٹ کی درجہ بندی اور روٹنگ
ایک فیصلہ ساز ماڈل موصول ہونے والے پیغامات کو بلنگ، تکنیکی معاونت یا اکاؤنٹ مینجمنٹ سے منسلک کر سکتا ہے۔ مبہم درخواستوں کے لیے "دیگر" یا "جائزے کی ضرورت ہے" کا راستہ شامل کریں، اور متعدد مسائل پر مشتمل پیغامات کی جانچ کریں۔ غلطیوں کی شرح ہر کیٹیگری کے لحاظ سے جانچیں، صرف مجموعی درستگی کی بنیاد پر نہیں: ایسا ماڈل جو فوری بلنگ شکایات کو نظرانداز کرتا ہو، معمول کے سوالات پر مشتمل ڈیٹاسیٹ میں اچھی کارکردگی دکھا سکتا ہے۔
مواد کی نگرانی
مواد کی نگرانی کا ورک فلو یہ سوال کر سکتا ہے کہ آیا کوئی مواد پالیسی کی متعین کیٹیگری میں آتا ہے۔ ماڈل کو واضح معیار اور مثالیں فراہم کریں، مشکل صورتوں کی جانچ کریں، اور غیر یقینی یا اہم نتائج والے معاملات کو تربیت یافتہ جائزہ لینے والوں کے حوالے کریں۔ فیصلہ ساز اسکور آپ کے پالیسی عمل میں ایک ان پٹ ہے، اس بات کا ثبوت نہیں کہ مواد کسی اصول کی خلاف ورزی کرتا ہے۔
LLM اور ایجنٹ کی روٹنگ
LLM کو کال کرنے سے پہلے، کوئی ایپلیکیشن درخواست کو موضوع، پیچیدگی یا درکار موڈیلیٹی کے لحاظ سے درجہ بند کر سکتی ہے۔ اس کے بعد روٹنگ کا جزو کسی ورک فلو کا انتخاب یا اضافی معلومات کی درخواست کر سکتا ہے۔ روٹنگ کو اگلے نظام کے ساتھ جانچیں: کم لاگت والا ابتدائی مرحلہ مفید نہیں اگر وہ مشکل درخواستوں کو غلط راستے پر بھیجتا رہے۔
دستاویزات اور تصاویر کی ابتدائی درجہ بندی
ملٹی موڈل فیصلہ ساز ماڈل یہ درجہ بندی کر سکتا ہے کہ آیا کوئی تصویر یا دستاویز پہلے سے متعین کیٹیگری سے تعلق رکھتی ہے، جیسے انوائس، رسید یا سپورٹ اسکرین شاٹ۔ تصدیق کریں کہ مخصوص اینڈ پوائنٹ آپ کے مطلوبہ ان پٹ فارمیٹ اور تصویر کے انتظام کی معاونت کرتا ہے۔ درجہ بندی اور کسی دستاویز کے تمام فیلڈز نکالنا الگ کام ہیں؛ جانچیں کہ منتخب کردہ ماڈل اور API دونوں کاموں کی معاونت کرتے ہیں یا نہیں۔
معیار کے مطابق اسکورنگ
ایک ماڈل کسی جواب کو وضاحتی درجات کے ساتھ ترتیب وار پیمانے پر رکھ سکتا ہے، جیسے "اہم شواہد غائب ہیں"، "جزوی معاونت موجود ہے" اور "مکمل معاونت موجود ہے"۔ جانچیں کہ جائزہ لینے والے ان لیبلز سے متفق ہیں یا نہیں اور ماڈل یکساں جوابات کے ساتھ یکساں سلوک کرتا ہے یا نہیں۔ تصدیق کے بغیر معیار پر مبنی اسکورز کو معروضی پیمائش کے طور پر پیش کرنے سے گریز کریں۔
Felo ماڈل کیٹلاگ میں دستیاب فیصلہ ساز ماڈلز
Felo ماڈل کیٹلاگ میں آؤٹ پٹ کے لیے Decisions فلٹر شامل ہے۔ 2 نومبر 2026 کو درج مثالوں میں شامل ہیں:
| کیٹلاگ میں درج ماڈل | بیان کردہ استعمال | کیٹلاگ میں دکھائے گئے ان پٹس |
|---|---|---|
| TypeSafe Jev 1.14 | روٹنگ، درجہ بندی اور مواد کی نگرانی | متن اور تصویر؛ فہرست میں تصویر کی معاونت کو تجرباتی قرار دیا گیا ہے |
| LiquidAI d1.1 | ہاں/نہیں، انتخاب اور اسکور کے فیصلے | متن اور تصویر |
| Baseten Joey 1 | درجہ بندی اور روٹنگ | متن اور تصویر |
| Perplexity Decider Flash V1.2 | درجہ بندی، روٹنگ اور اسکورنگ | متن اور تصویر |
یہ تفصیلات کیٹلاگ کی عکاسی کرتی ہیں، آزادانہ کارکردگی کے ٹیسٹ یا کسی ایک ماڈل کو بہترین قرار دینے کی سفارش نہیں ہیں۔ دستیابی، فیچر کی معاونت، کانٹیکسٹ کی حدود اور قیمتیں تبدیل ہو سکتی ہیں۔ ڈیولپمنٹ سے پہلے موجودہ فہرست اور اینڈ پوائنٹ کی دستاویزات دیکھیں، خاص طور پر تجرباتی یا ملٹی موڈل فیچرز کے لیے۔ کسی ماڈل کا کیٹلاگ میں درج ہونا اس بات کا ثبوت نہیں کہ ہر فراہم کنندہ کا مقامی API فیچر ہر پلیٹ فارم کے ذریعے دستیاب ہے۔
AI فیصلہ ساز ماڈل کی جانچ کیسے کریں؟
ایک محدود فیصلے اور قابلِ اعتماد لیبلز والی نمائندہ مثالوں کے مجموعے سے آغاز کریں۔ مشکل معاملات، کم تعداد والی کیٹیگریز، نامکمل سیاق و سباق اور ایسی مثالیں شامل کریں جن میں انسانی مداخلت ضروری ہو۔ اس کے بعد ماڈل کا موازنہ ایک سادہ بنیادی معیار، موجودہ کلاسیفائر یا منظم آؤٹ پٹ والے LLM سے کریں۔
صرف درستگی کی پیمائش نہ کریں:
- پریسیژن اور ریکال: کون سی غلطیاں اہم ہیں، اور ہر کلاس میں ان کی شرح کیا ہے؟
- کیلِبریشن: کیا پیش گوئی کردہ احتمالات مختلف کیسز کے گروپس میں مشاہدہ شدہ نتائج سے مطابقت رکھتے ہیں؟
- کوریج: آپ کی منتخب کردہ حد پر کتنی درخواستیں خودکار طریقے سے نمٹائی جا سکتی ہیں؟
- تاخیر اور قابلِ اعتماد کارکردگی: کیا مکمل API کال آپ کی پروڈکشن ضروریات پوری کرتی ہے؟
- لاگت: ہر مفید فیصلے کی لاگت کیا ہے، جس میں دوبارہ کوششیں، متعدد سوالات، تصویر کی پروسیسنگ اور انسانی جائزہ شامل ہوں؟
- مضبوطی: کیا مختلف زبانوں، فارمیٹس، نامانوس مثالوں اور بدلتے ہوئے ٹریفک میں کارکردگی برقرار رہتی ہے؟
لیبلز اور حدوں کو بہتر بنانے کے بعد ایک الگ ٹیسٹ سیٹ استعمال کریں۔ پروڈکشن میں، جہاں مناسب ہو نتائج کا لاگ رکھیں، اختلافات کا جائزہ لیں، اور ماڈل کے ورژن، پالیسی یا ان پٹ کی تقسیم میں تبدیلی کے بعد دوبارہ جانچ کریں۔ اہم نتائج والے فیصلوں کے لیے بامعنی انسانی نگرانی کا نظام بنائیں اور متعلقہ تقاضوں کی تصدیق کریں۔
اکثر پوچھے جانے والے سوالات
کیا امتیازی AI اور فیصلہ ساز ماڈل ایک ہی چیز ہیں؟
نہیں، مکمل طور پر نہیں۔ امتیازی AI کسی ان پٹ سے ہدف کی پیش گوئی کرنے کے وسیع طریقے کو بیان کرتا ہے۔ فیصلہ ساز ماڈلز ایک نئی پروڈکٹ کیٹیگری ہیں جو محدود آؤٹ پٹس، جیسے انتخاب، اسکورز اور احتمالات پر مرکوز ہیں۔ کچھ فیصلہ ساز ماڈلز امتیازی تکنیکیں استعمال کرتے ہیں، لیکن دونوں اصطلاحات ایک ہی چیز کی وضاحت نہیں کرتیں۔
کیا LLM درجہ بندی یا فیصلے کر سکتا ہے؟
جی ہاں۔ ایک جنریٹو LLM کو مواد کی درجہ بندی یا منظم آؤٹ پٹس واپس کرنے کی ہدایت دی جا سکتی ہے۔ آیا کوئی مخصوص فیصلہ ساز ماڈل بہتر، تیز یا کم خرچ کارکردگی دکھاتا ہے، اس کا انحصار کام، ماڈل، فراہم کنندہ اور جانچ کے طریقے پر ہے۔ اپنے نمونوں پر دونوں کی جانچ کریں۔
کیا فیصلہ ساز ماڈلز کے احتمالات ہمیشہ درست ہوتے ہیں؟
نہیں۔ کسی مخصوص ڈیٹاسیٹ یا ذیلی گروپ پر ماڈل ایسے احتمالات پیدا کر سکتا ہے جن کی کیلِبریشن درست نہ ہو۔ ورک فلو کو خودکار بنانے کے لیے حدیں استعمال کرنے سے پہلے کیلِبریشن اور غلطیوں کے نتائج کی پیمائش کریں۔
مجھے اس کے بجائے جنریٹو AI کب استعمال کرنا چاہیے؟
جب کسی کام میں مسودہ تیار کرنا، وضاحت کرنا، معلومات کو یکجا کرنا یا کھلے انداز کا مواد تخلیق کرنا شامل ہو تو جنریٹو ماڈل استعمال کریں۔ بہت سی ایپلیکیشنز میں فیصلہ ساز ماڈل اور جنریٹو ماڈل مل کر کام کرتے ہیں: ایک روٹنگ یا درجہ بندی کرتا ہے، جبکہ دوسرا جواب تیار کرتا ہے۔
امتیازی AI ڈویلپرز کو ورک فلو میں واضح اور قابلِ پیمائش فیصلے شامل کرنے کا طریقہ فراہم کرتا ہے۔ ایک محدود کام سے آغاز کریں، اہم غلطیوں کی جانچ کریں، اور شواہد کی بنیاد پر خودکاری کی مناسب سطح کا تعین کریں۔
فیلـو کیٹلاگ میں فیصلہ ساز ماڈلز دیکھیں →
یہ مضمون ان زبانوں میں بھی دستیاب ہے: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português۔