
Felo API پر Gemini 4 Carbon: خصوصیات، بینچ مارکس، قیمتیں اور استعمال کے طریقے

Felo API پر Gemini 4 Carbon: اس کا 1M ٹوکن کا متحد بجٹ، سوچنے کی سطحیں، ملٹی موڈل حدود، شائع شدہ بینچ مارکس، حقیقی قیمتیں اور اسے استعمال کرنے کا طریقہ۔
Google کا Gemini 4 Carbon ایک ایسا ماڈل ہے جسے کمپنی ان پیچیدہ کاموں کے لیے پیش کرتی ہے جو مختصر وقت میں مکمل نہیں ہو سکتے۔ ان میں درجنوں سروسز پر اثر انداز ہونے والی کوڈ بیس کی منتقلی، ایسا سکیورٹی مسئلہ تلاش کرنا جس کا اختتام ایک قابلِ عمل پیچ پر ہو، یا ایسا تحقیقی سوال شامل ہے جس کے لیے محض پراعتماد پیراگراف کے بجائے شواہد کی ایک مربوط زنجیر درکار ہو۔
اب اسے Felo API کے ذریعے استعمال کیا جا سکتا ہے۔ Felo اس وقت محدود مدت کے مفت ٹرائل کے ساتھ فراہم کنندہ کی رعایتی قیمتیں بھی پیش کر رہا ہے۔ اس گائیڈ کو پڑھنے سے پہلے آپ Felo پر Gemini 4 Carbon کا صفحہ کھول کر ماڈل تک رسائی حاصل کر سکتے ہیں، پلے گراؤنڈ میں پرامپٹس آزما سکتے ہیں اور API key بنا سکتے ہیں۔
یہ مضمون کسی ماڈل کے اجرا کا اعلان نہیں بلکہ ایک عملی رہنما ہے۔ اس میں بتایا گیا ہے کہ Carbon کیا ہے، یہ Gemini 4 Argon سے کس طرح مختلف ہے، شائع شدہ بینچ مارکس سے کیا معلومات ملتی ہیں اور کن باتوں کی تصدیق ضروری ہے، اس کا غیر معمولی ٹوکن بجٹ کیسے کام کرتا ہے، یہ کن کاموں میں بہتر کارکردگی دکھاتا ہے، کن حالات میں توقعات پوری نہیں کرتا اور Felo پر اس کی موجودہ قیمت کیا ہے۔
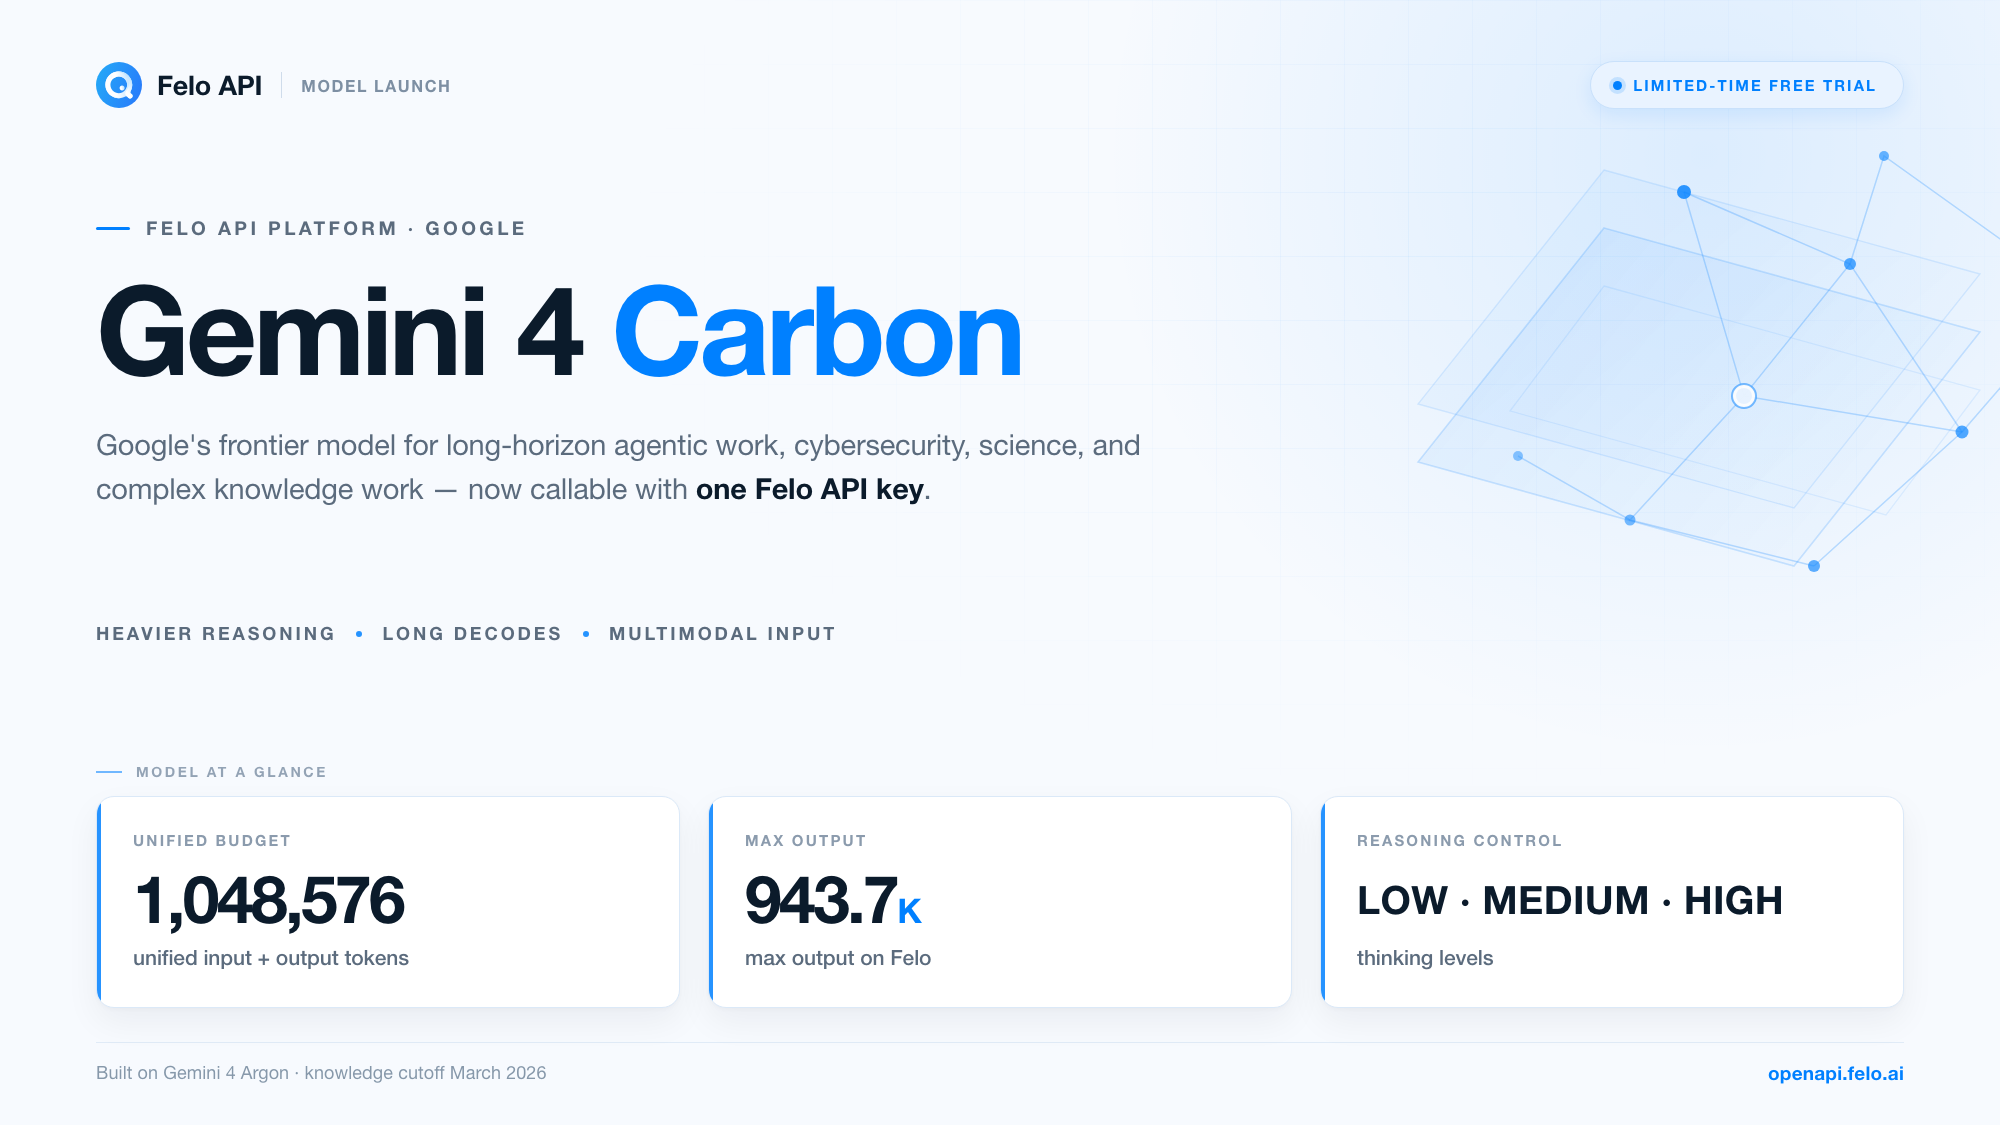
Gemini 4 Carbon کیا ہے؟
Gemini 4 Carbon، Google کا جدید ترین فرنٹیئر ماڈل ہے، جسے کوڈنگ، فنانس، قانونی امور، سائبر سکیورٹی اور سائنس کے طویل المدتی ایجنٹ پر مبنی کاموں کے لیے تیار کیا گیا ہے۔ Google نے 28 اکتوبر 2026 کو اس کا اعلان کیا۔ یہ ماڈل Gemini 4 Argon کی بنیاد پر تیار کیا گیا اور ابتدائی طور پر Fairwind Program کے ذریعے سائبر سکیورٹی کے منتخب دفاعی ماہرین کے لیے جاری کیا گیا۔ Google کے انٹرپرائز پلیٹ فارم کی دستاویزات میں اب اسے عمومی دستیابی کے ساتھ درج کیا گیا ہے، جس کی ریلیز کی تاریخ 10 نومبر 2026 ہے۔
"Carbon" نام کسی نئی نسل کی نشاندہی نہیں کرتا۔ یہ Gemini 4 فیملی کے اندر ایک مختلف عملی ترجیح کو ظاہر کرتا ہے۔ Argon کو ایک ہی عمل کے دوران طویل اور مربوط دستاویزات تیار کرنے کے لیے بہتر بنایا گیا تھا، جبکہ Carbon اپنے بجٹ کا بڑا حصہ سوچنے کے عمل پر خرچ کرتا ہے، جس میں مفروضوں کی جانچ، تصدیقی مراحل اور متعدد اقدامات پر مشتمل کاموں کی ہم آہنگی شامل ہے۔ Google کے مطابق Carbon اپنے جوابات تک پہنچنے کے لیے Argon سے زیادہ thinking tokens استعمال کرتا ہے۔
اس حکمتِ عملی کی ایک قیمت بھی ہے۔ مشکل کاموں میں یہ ماڈل سست ہو سکتا ہے، بعض حالات میں ٹائم آؤٹ ہو سکتا ہے اور سوچنے کی اعلیٰ سطحوں پر زیادہ ٹوکن استعمال کرتا ہے۔ Google ان حدود کو اپنی دستاویزات میں واضح کرتا ہے۔ اس کے باوجود Carbon استعمال کرنے کی وجہ یہ ہے کہ اس کے لیے منتخب کام، مثلاً سکیورٹی تجزیہ، بڑی سطح پر سافٹ ویئر کی منتقلی، سائنسی استدلال اور اہم دستاویزات کا جائزہ، رفتار کے مقابلے میں گہرائی کو زیادہ اہمیت دیتے ہیں۔
ماڈل کی خصوصیات ایک نظر میں
| خصوصیت | قدر |
|---|---|
| Felo پر Model ID | gemini-4-carbon |
| اعلان کی تاریخ | 28 اکتوبر 2026 |
| بنیادی ماڈل | Gemini 4 Argon |
| کانٹیکسٹ اور آؤٹ پٹ | 1,048,576 ٹوکن کا ایک متحد بجٹ، جس میں ان پٹ اور آؤٹ پٹ دونوں شامل ہیں |
| Felo پر درج زیادہ سے زیادہ آؤٹ پٹ | 943.718K ٹوکن |
| ان پٹ | متن، تصاویر، آڈیو، ویڈیو، PDF اور Office/OpenDocument فائلیں |
| آؤٹ پٹ | متن |
| سوچنے کی سطحیں | LOW، MEDIUM (ڈیفالٹ)، HIGH |
| معلومات کی آخری تاریخ | مارچ 2026 |
| سیمپلنگ | Temperature 1.0، top-p 0.95، top-k 64، مقررہ |
| کیشنگ | صرف Implicit Caching، کم از کم 4,096 ٹوکن |
| تجویز کردہ Felo انٹرفیس | Messages API (Anthropic-compatible) |
| رسائی | منتخب علاقوں میں تصدیق شدہ انٹرپرائز صارفین؛ سائبر ویرینٹ کے لیے Allowlist ضروری ہے |
اس جدول کی دو خصوصیات پر الگ سے بات ضروری ہے، کیونکہ یہ طے کرتی ہیں کہ آپ اس ماڈل کے لیے اپنی ایپلی کیشن کس طرح تیار کریں گے: متحد ٹوکن بجٹ اور سوچنے کی سطحیں۔
Gemini 4 Carbon اور Gemini 4 Argon میں فرق
Carbon اور Argon ایک ہی فیملی، معلومات کی ایک ہی آخری تاریخ اور اپنی خصوصیات کے کئی مشترکہ پہلو رکھتے ہیں۔ ان کے درمیان بنیادی فرق ماڈل کی صلاحیتوں کے استعمال کے طریقے میں ہے۔
ان پٹ اور آؤٹ پٹ کا متحد بجٹ۔ Argon کو عموماً 1,048,576 ٹوکن کی کانٹیکسٹ ونڈو اور الگ سے 65,536 ٹوکن کے ڈیفالٹ آؤٹ پٹ کے ساتھ بیان کیا جاتا ہے۔ Carbon کے 1,048,576 ٹوکن ان پٹ، سوچنے کے عمل، ٹول کالز اور حتمی جواب سب کے لیے مشترکہ ہیں۔ یہ ایک ہی بجٹ ہے، نہ کہ کانٹیکسٹ ونڈو کے ساتھ اضافی آؤٹ پٹ کی گنجائش۔
ڈیفالٹ طور پر گہرا استدلال۔ Carbon میں LOW، MEDIUM اور HIGH سوچنے کی سطحیں دستیاب ہیں۔ gemini-4-carbon میں MEDIUM ڈیفالٹ ہے، جبکہ سائبر پرمسیو ویرینٹ میں HIGH ڈیفالٹ ہے۔ اسے طویل تصدیقی مراحل کے لیے تیار کیا گیا ہے۔ اسی وجہ سے Google زیادہ ٹوکن استعمال ہونے کو ایک معلوم حد قرار دیتا ہے، نہ کہ کسی خرابی کو۔
طویل آؤٹ پٹ۔ ایک اسٹریمنگ سیگمنٹ زیادہ سے زیادہ 65,536 آؤٹ پٹ ٹوکن تیار کر سکتا ہے، جبکہ نان اسٹریمنگ کی صورت میں یہ حد 32,768 ٹوکن ہے۔ اس حد سے آگے جانے کے لیے Long Decodes استعمال کیے جاتے ہیں۔ Google Gen AI SDK اور Agent Studio خودکار طور پر Continuation Token کا انتظام کرتے ہیں، یا آپ اپنی مرضی کا Continuation Loop تیار کر سکتے ہیں۔ نظریاتی طور پر زیادہ سے زیادہ حد، متحد بجٹ میں سے ان پٹ کے ٹوکن نکالنے کے بعد باقی رہ جانے والی گنجائش ہے۔
فائلوں کی وسیع معاونت۔ Carbon، Microsoft Office اور OpenDocument فائلیں قبول کرتا ہے، جن میں .docx، .doc، .pptx، .ppt، .xlsx، .xls، .odt، .odp اور .ods شامل ہیں۔ ان فائلوں کو براہِ راست یا کلاؤڈ اسٹوریج سے فراہم کیا جا سکتا ہے۔ PDF اور سادہ متن کی معاونت بھی موجود ہے۔ یہ سہولت ان ورک فلو کے لیے اہم ہے جو صاف ٹیکسٹ ایکسپورٹ کے بجائے پریزنٹیشن، اسپریڈشیٹ یا معاہدے سے شروع ہوتے ہیں۔
سکیورٹی کے لیے بہتر تربیت اور الگ سائبر ویرینٹ۔ Google کے مطابق لائیو کوڈنگ ماحول میں شدید نوعیت کے Misalignment Alerts میں تقریباً 80% کمی ہوئی ہے۔ ٹیکسٹ ٹو ٹیکسٹ سیفٹی کے جائزوں میں Carbon نے کثیر لسانی اور ملٹی موڈل مواد کی حفاظت کے حوالے سے Argon سے 3.50 فیصد پوائنٹس بہتر کارکردگی دکھائی ہے۔ اس کے علاوہ gemini-4-carbon-cyber-permissive بھی موجود ہے۔ یہ دفاعی سکیورٹی کے لیے Allowlist تک محدود ویرینٹ ہے، جس میں HIGH سوچنے کی سطح ڈیفالٹ ہے اور Computer Use کی سہولت شامل نہیں۔
سائنس سے متعلق خصوصی صلاحیتیں۔ Google کے مطابق یہ ماڈل سکیورٹی اہداف کو ریاضیاتی قضیوں میں تبدیل کر سکتا ہے اور Petabase سطح کے Sequence Archives میں دور کے Homologs تلاش کر سکتا ہے۔ کم Homolog رکھنے والے پروٹین خاندانوں میں Homolog Retrieval کی اوسط شرح میں 40 گنا اضافے کی اطلاع بھی دی گئی ہے۔ یہ ایک مخصوص تحقیقی کام سے متعلق محدود دعویٰ ہے۔ اسے عمومی صلاحیت سمجھنے کے بجائے اپنے ڈیٹا پر اس کی تصدیق کرنا بہتر ہے۔
متحد ٹوکن بجٹ کی وضاحت
زیادہ تر ماڈلز کے صفحات پر دو اعداد درج ہوتے ہیں: ایک کانٹیکسٹ ونڈو اور دوسرا زیادہ سے زیادہ آؤٹ پٹ۔ Carbon میں ایک ہی عدد اور فی سیگمنٹ ایک الگ حد موجود ہے۔ اگر آپ پرانے طریقے سے درخواستوں کی منصوبہ بندی کریں گے تو دستیاب گنجائش کا اندازہ غلط ہو سکتا ہے یا بلنگ کی تفصیل سمجھنے میں مشکل پیش آ سکتی ہے۔
یہاں بجٹ کی اصل تقسیم دیکھی جا سکتی ہے:
- ان پٹ (Input) — آپ کا پرامپٹ، منسلک دستاویزات، تصاویر، آڈیو، ویڈیو فریمز اور سابقہ گفتگو۔
- سوچنے کا عمل (Thinking) — وہ Reasoning Tokens جو ماڈل جواب دینے سے پہلے استعمال کرتا ہے۔ HIGH سطح پر ان کی تعداد کافی زیادہ ہو سکتی ہے۔
- ٹول کالز (Tool Calls) — وہ تمام ٹولز جنہیں فعال ہونے کی صورت میں ماڈل استعمال کرتا ہے۔
- حتمی جواب (Final Answer) — وہ متن جو آپ کو موصول ہوتا ہے۔
یہ چاروں حصے اسی 1,048,576 ٹوکن کے بجٹ سے استعمال ہوتے ہیں۔ اگر کسی درخواست میں 900K ٹوکن ان پٹ کے طور پر استعمال ہوں تو آؤٹ پٹ کے لیے 1M ٹوکن باقی نہیں رہتے۔ اس کے بجائے سوچنے کے عمل، ٹولز اور جواب کے لیے مجموعی طور پر تقریباً 148K ٹوکن دستیاب ہوتے ہیں، اور اس میں Continuation شامل نہیں۔
فی سیگمنٹ کی حد الگ ہے۔ اسٹریمنگ درخواست میں ایک سیگمنٹ زیادہ سے زیادہ 65,536 آؤٹ پٹ ٹوکن تک جا سکتا ہے، جبکہ نان اسٹریمنگ میں یہ حد 32,768 ہے۔ Long Decodes کے ذریعے سیگمنٹ کی حد کے بعد بھی کام جاری رکھا جا سکتا ہے، یہاں تک کہ متحد بجٹ ختم ہو جائے۔ اگر آپ کی انٹیگریشن max_tokens کو کل آؤٹ پٹ کی ضمانت سمجھتی ہے تو یہ درست نہیں۔ یہ صرف ایک سیگمنٹ کی حد مقرر کرتا ہے۔ طویل دستاویز تیار کرنے کے لیے SDK کا Continuation Management ضروری ہے۔
Felo کے ماڈل صفحے پر زیادہ سے زیادہ آؤٹ پٹ 943.718K ٹوکن درج ہے۔ اسے Felo کے روٹ پر آؤٹ پٹ کی زیادہ سے زیادہ حد سمجھیں، نہ کہ ایک دوسری اور بڑی کانٹیکسٹ ونڈو۔ متحد بجٹ کے تحت آپ کے جواب کے لیے دستیاب اصل گنجائش اس بات پر منحصر ہے کہ آپ نے ان پٹ میں کیا فراہم کیا ہے۔
اس ڈیزائن کا عملی نتیجہ سادہ ہے: پہلے آؤٹ پٹ کا حجم طے کریں، پھر اسی کے مطابق ان پٹ کی گنجائش مقرر کریں۔ طویل رپورٹ کے لیے آؤٹ پٹ اور سوچنے کے عمل کا بجٹ محفوظ رکھیں اور ماخذ مواد کو اس حد کے مطابق مختصر کریں۔ بڑی دستاویزات کے مجموعے کے تجزیے میں یہ تسلیم کریں کہ جواب ان پٹ سے مختصر ہوگا اور Continuation یا مرحلہ وار پرامپٹس کی منصوبہ بندی کریں۔
سوچنے کی سطحیں: معیار کہاں سے آتا ہے؟
Carbon میں سوچنے کی تین سطحیں دستیاب ہیں: LOW، MEDIUM اور HIGH۔ MEDIUM ڈیفالٹ ہے۔ Google کی دستاویزات میں واضح کیا گیا ہے کہ thinking_budget اور thinking_level="MINIMAL" استعمال کرنے پر Validation Error موصول ہوتا ہے۔ اس لیے استدلال کی صلاحیت کو مکمل طور پر ختم کرنا ممکن نہیں۔
عملی طور پر ان سطحوں کے درمیان فرق نمایاں ہے۔ LOW پر ماڈل ایک تیز فرنٹیئر چیٹ ماڈل کی طرح کام کرتا ہے۔ یہ معلومات نکالنے، درجہ بندی، تحریر کی اصلاح اور معمول کے کوڈ ریویو کے لیے موزوں ہے۔ MEDIUM پر یہ منصوبہ بندی اور خود جانچ کے لیے ٹوکن استعمال کرتا ہے۔ HIGH پر طویل تصدیقی مراحل چلتے ہیں۔ اس سطح پر باریک غلطی پکڑنے کا امکان زیادہ ہوتا ہے، مگر رفتار کم اور لاگت زیادہ ہو سکتی ہے۔
عملی استعمال کے لیے چند اصول:
- غلط جواب کی لاگت کے مطابق سطح منتخب کریں۔ اگر غلطی کی شناخت اور اصلاح کم خرچ ہے تو LOW استعمال کریں۔ اگر غلطی پروڈکشن سسٹم یا کسی قانونی دستاویز تک پہنچ سکتی ہے تو HIGH آزمائیں۔
- ہر درخواست کے ٹوکن کے بجائے ہر منظور شدہ نتیجے کے ٹوکن ناپیں۔ زیادہ سوچنے سے دوبارہ کوشش اور اصلاح کی ضرورت کم ہو سکتی ہے۔ لیکن ان کاموں پر لاگت بھی کئی گنا بڑھ سکتی ہے جنہیں ماڈل MEDIUM پر حل کر سکتا تھا۔ پورے ورک فلو کا موازنہ کریں۔
- یہ فرض نہ کریں کہ بینچ مارک کی سیٹنگ آپ کے کام پر بھی لاگو ہوگی۔ Google کے شائع شدہ اہم اعداد میں استعمال ہونے والی سوچنے کی سطح ہر جگہ درج نہیں۔ کسی ورک فلو کے انتخاب سے پہلے اپنے کاموں کو کم از کم دو سطحوں پر آزمائیں۔
Sampling کی سیٹنگ Temperature 1.0، top-p 0.95 اور top-k 64 پر مقرر ہے، اور کسٹم اقدار نظر انداز کر دی جاتی ہیں۔ اگر آپ کی پائپ لائن کم Temperature کے ساتھ Deterministic نتائج پر منحصر ہے تو Carbon اس مرحلے کے لیے موزوں ماڈل نہیں۔ اسے فیصلہ سازی اور معلومات کے امتزاج کے لیے استعمال کریں، جبکہ Deterministic مراحل ایسے ماڈل پر رکھیں جو Sampling Controls کو قبول کرتا ہو۔
Google کی شائع کردہ معلومات: بینچ مارکس اور ان کا مطلب
Felo کے ماڈل صفحے پر Carbon کے فراہم کنندہ کی جانب سے شائع کردہ بینچ مارک نتائج جمع کیے گئے ہیں۔ ذیل میں موجود موازنہ صرف عمومی سمت کی نشاندہی کرتا ہے۔ یہ اعداد Google یا متعلقہ جائزہ فراہم کرنے والوں سے لیے گئے ہیں، اس مضمون کے لیے ان کی آزادانہ تصدیق نہیں کی گئی، اور یہ مخصوص ٹیسٹ حالات کی عکاسی کرتے ہیں، نہ کہ آپ کے ورک لوڈ کی۔
| جائزہ | پیمائش | Gemini 4 Carbon | تفصیل |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | مشترکہ استدلالی انڈیکس | 59 | پہلی پوزیشن؛ Claude Opus 5.5 کا اسکور 58 |
| SEC-bench Pro | سکیورٹی خامیوں کی تلاش | 88.2% | سکیورٹی، دفاعی اسکیننگ |
| CWE-bench | سکیورٹی خامیوں کے پیچ | 71.0% | سکیورٹی، اصلاح |
| ExploitGym | سکیورٹی خامیوں کا استحصال | 54.8% | سکیورٹی تحقیق، کنٹرول شدہ ماحول |
| Terminal-Bench 4.0 | کامیاب دھوکہ دہی کی شرح | 0.0% | Reward Hacking کے خلاف مزاحمت، صلاحیت کی پیمائش نہیں |
| Vals Index | علمی کاموں کا مشترکہ انڈیکس | 70.45% | 36 ماڈلز میں تیسری پوزیشن |
| Legal Research Bench | قانونی تحقیق | 55.77% | پہلی پوزیشن |
| General Financial Intelligence | مالیاتی کام | #1 | Balyasny Asset Management کے مطابق 23 فرنٹیئر کنفیگریشنز میں پہلی پوزیشن |
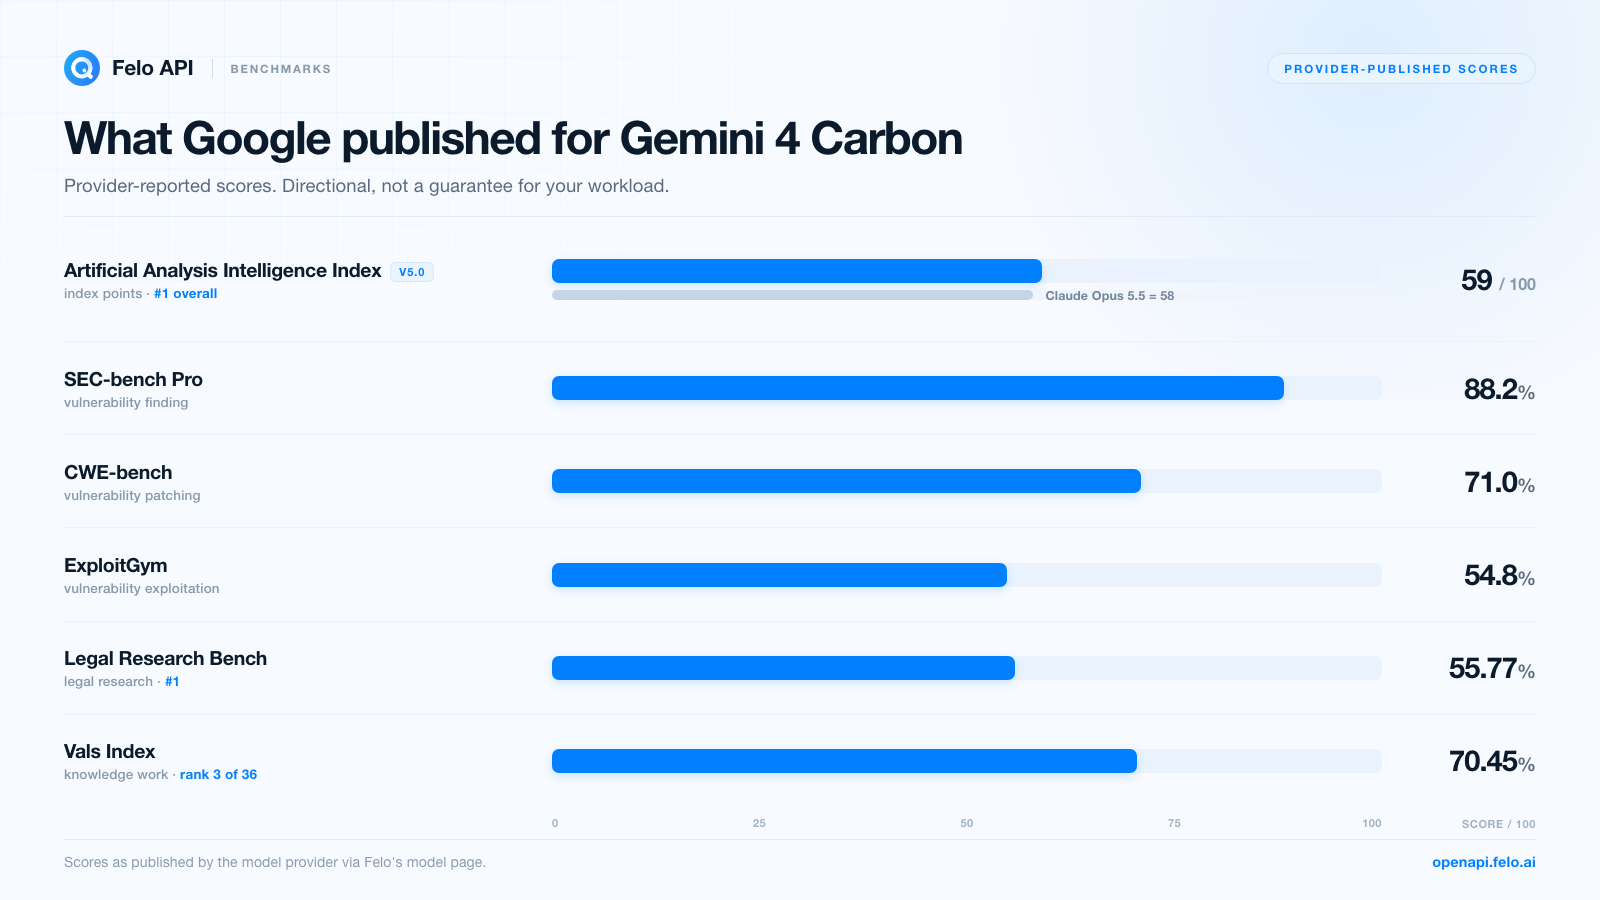
اس جدول کو غور سے دیکھنے پر تین اہم نکات سامنے آتے ہیں۔
سکیورٹی کے اسکور ایک مکمل عمل کی نمائندگی کرتے ہیں، نہ کہ کسی ایک صلاحیت کی۔ سکیورٹی خامیوں کی تلاش، پیچ لکھنا اور خامیوں کا استحصال کرنا تین مختلف مہارتیں ہیں۔ Carbon کے شائع شدہ اعداد میں خامیوں کی تلاش کا نتیجہ سب سے مضبوط ہے (SEC-bench Pro پر 88.2%)، جبکہ استحصال کا اسکور نسبتاً کم ہے (ExploitGym پر 54.8%)۔ پیچنگ کا اسکور ان دونوں کے درمیان ہے (CWE-bench پر 71.0%)۔ اگر آپ کا کام دفاعی نوعیت کا ہے، جیسے اسکیننگ، درجہ بندی اور اصلاح، تو یہ کارکردگی موزوں ہے۔ اگر آپ کو خودکار استحصال درکار ہے تو اس کا اسکور کم ہے اور رسائی کے ضوابط بھی سخت ہیں۔
دھوکہ دہی کی شرح کا تعلق اعتماد سے ہے، ذہانت سے نہیں۔ Terminal-Bench 4.0 کا "successful cheating rate" یہ جانچتا ہے کہ آیا ماڈل کام حل کرنے کے بجائے بینچ مارک کے نظام سے فائدہ اٹھاتا ہے۔ 0.0% کا نتیجہ Reward Hacking کے خلاف مزاحمت کا دعویٰ ہے۔ یہ اس وقت اہم ہوتا ہے جب آپ کسی ایجنٹ کو انسانی نگرانی کے بغیر کام کرنے دیتے ہیں۔ یہ صلاحیت کا اسکور نہیں ہے اور اسے جدول کے دیگر فیصدی درست نتائج کے ساتھ موازنہ نہیں کرنا چاہیے۔
علمی کاموں کی درجہ بندی زیادہ تر ٹیموں کے لیے اہم ہے۔ Vals Index میں 36 میں سے تیسری پوزیشن، Legal Research Bench میں پہلی پوزیشن اور Balyasny کے مالیاتی موازنے میں سرفہرست مقام اس قسم کے کاموں کی عکاسی کرتے ہیں جن کے لیے فرنٹیئر ماڈل کی لاگت قابلِ جواز ہوتی ہے: بڑی مقدار میں معلومات پڑھنا، متضاد شواہد کا موازنہ کرنا اور ایسی دستاویز تیار کرنا جس کا کوئی ماہر جائزہ لے سکے۔ ان نتائج پر پرامپٹ کے ڈیزائن اور ماخذ کے معیار کا بھی گہرا اثر پڑتا ہے۔ اس لیے انہیں ٹیسٹنگ کی وجہ سمجھیں، ٹیسٹنگ چھوڑنے کی نہیں۔
ایک اور بات قابلِ توجہ ہے: Artificial Analysis انڈیکس کا اسکور مشترکہ پیمائش ہے، اور Claude Opus 5.5 پر ایک پوائنٹ کی برتری ایسی حد کے اندر ہے جہاں مختلف کاموں کا انتخاب درجہ بندی بدل سکتا ہے۔ آپ کے مخصوص کاموں پر دونوں ماڈلز کی کارکردگی میں کسی بھی سمت نمایاں فرق ہو سکتا ہے۔
Gemini 4 Carbon کہاں واقعی مفید ہے؟
بینچ مارکس ایک نقشہ ہیں، اصل کام کی جگہ نہیں۔ ذیل میں وہ ورک لوڈ دیے گئے ہیں جہاں Carbon کا ڈیزائن کام کی ضروریات سے مطابقت رکھتا ہے۔
بڑے پیمانے پر کوڈنگ اور سافٹ ویئر کی منتقلی
Carbon کو ایسے انجینئرنگ کاموں کے لیے تیار کیا گیا ہے جن میں متعدد ایجنٹس کا اشتراک، روزمرہ کی ڈیبگنگ، بڑی کوڈ بیس کی منتقلی اور الگورتھم ڈیزائن شامل ہیں۔ متحد بجٹ یہاں مددگار ہے۔ آپ ایک ہی درخواست میں Repository Map، متعلقہ Source Files، ناکام ٹیسٹ کے نتائج اور منتقلی کی ضروریات فراہم کر سکتے ہیں، پھر کوڈ میں تبدیلی سے پہلے ایک منصوبہ طلب کر سکتے ہیں۔
اس قسم کے ماڈل کے لیے موزوں پرامپٹ کی مثال:
منسلک Repository Map اور تین Service Modules کا جائزہ لیں۔ Session Interface کی تبدیلی سے متاثر ہونے والے تمام Call Sites کی شناخت کریں، Compatibility Risks کی فہرست بنائیں اور Migration Order تجویز کریں۔ ابھی کوڈ نہ لکھیں۔ فراہم کردہ فائلوں سے جن باتوں کی تصدیق ممکن نہ ہو، ان کی نشاندہی کریں۔
پہلے منصوبہ طلب کریں۔ منصوبے کا جائزہ لینے کے بعد ہی ماڈل کو ٹیسٹ چلانے کی اجازت دیں۔ Diff کا انسانی جائزہ برقرار رکھیں۔ اچھی منصوبہ بندی کرنے والا ماڈل بھی ایسا پیچ تیار کر سکتا ہے جو Compile تو ہو جائے مگر غلط رویہ دکھائے۔
دفاعی سائبر سکیورٹی
سکیورٹی بینچ مارک کا پروفائل، یعنی خامیوں کی تلاش میں مضبوط، پیچنگ میں اچھی اور استحصال میں نسبتاً کم کارکردگی، دفاعی کاموں سے مطابقت رکھتا ہے۔ ان میں کوڈ بیس میں سکیورٹی خامیوں کی اقسام تلاش کرنا، اسکینر کے نتائج کی درجہ بندی، پیچ تجویز کرنا اور جائزہ لینے والے کے لیے خطرات کی وضاحت شامل ہے۔ Google کا سائبر ویرینٹ اسی مقصد کے لیے تیار کیا گیا ہے، لیکن Fairwind Program کے ذریعے اس تک رسائی Allowlist تک محدود ہے اور الگ منظوری درکار ہے۔
دو احتیاطیں ضروری ہیں۔ پہلی، سکیورٹی ورک فلو صرف ان سسٹمز پر چلائیں جن کی جانچ کی آپ کو اجازت حاصل ہے۔ دوسری، کسی بھی کارروائی سے پہلے نتائج کی تصدیق کریں۔ زیادہ اعتماد کے ساتھ سکیورٹی خامی کی اطلاع دینے والا ماڈل بھی غلط ہو سکتا ہے، اور غلط مثبت نتیجے سے انجینئرنگ کا وقت ضائع ہوتا ہے۔
سائنسی اور تکنیکی تحقیق
سائنس سے متعلق رپورٹ کردہ صلاحیتیں مخصوص ہیں: سکیورٹی اہداف کو ریاضیاتی قضیوں میں تبدیل کرنا اور Petabase سطح کے Sequence Archives میں دور کے Homologs تلاش کرنا۔ اگر آپ کسی لیبارٹری یا تحقیقی گروپ میں کام کرتے ہیں تو مفید طریقہ یہ ہے کہ Carbon کو ایک واضح تحقیقی سوال، متعلقہ لٹریچر یا Sequences اور شواہد کو قیاس آرائی سے الگ رکھنے کی ہدایت فراہم کریں۔
Homolog Retrieval میں 40 گنا اضافے کا دعویٰ قابلِ توجہ ہے، لیکن یہ ایک مخصوص Pipeline میں کم Homolog رکھنے والے پروٹین خاندانوں سے متعلق ہے۔ اس کے گرد اپنا ورک فلو تیار کرنے سے پہلے اپنی ٹیم کے قابلِ اعتماد بینچ مارک پر اس نتیجے کو دوبارہ جانچیں۔
فنانس، قانونی امور اور اہم دستاویزات کا جائزہ
علمی کاموں میں Carbon کی درجہ بندی پیشہ ورانہ خدمات کے لیے اس کی سب سے مضبوط خصوصیت ہے۔ ان کاموں میں مالیاتی کھاتوں کا موازنہ، Variance Analysis، عدالتی فیصلوں اور ریگولیٹری فائلنگز کا جائزہ اور حوالہ جات کے ساتھ میمو تیار کرنا شامل ہیں۔ یہ ماڈل تصاویر اور PDFs پڑھ سکتا ہے، اس لیے اسکین شدہ دستاویزات اور چارٹس بھی قابلِ استعمال ان پٹ ہیں۔
تاہم یہ انسانی جائزے کی ضرورت ختم نہیں کرتا۔ ماخذ دستاویزات فراہم کریں، ہر نتیجے کے پیچھے موجود عبارت کا حوالہ طلب کریں اور حوالہ جات کی تصدیق کریں۔ ایک ملین ٹوکن کی کانٹیکسٹ رکھنے والا ماڈل بھی صفحہ 412 کو غلط سمجھ سکتا ہے۔
ٹولز کے ساتھ طویل عرصے تک کام کرنے والے ایجنٹس
Carbon میں Function Calling، Structured Output، Code Execution، URL Context، Computer Use اور کئی Grounding Options کی معاونت موجود ہے۔ ان میں Google Search، Google Maps اور تھرڈ پارٹی سرچ فراہم کنندگان شامل ہیں۔ یہ Agentic Video Understanding کو بھی سپورٹ کرتا ہے، جو اس وقت مفید ہے جب ان پٹ کسی دستاویز کے بجائے ریکارڈنگ ہو۔
ماڈل استعمال کرنے کا یہ سب سے زیادہ وسائل طلب کرنے والا طریقہ ہے اور ٹوکن خرچ کرنے کا سب سے آسان راستہ بھی۔ اپنے ایجنٹ کی کارکردگی ریکارڈ کریں: Tool Calls کے لاگز رکھیں، Iterations کی حد مقرر کریں اور کسی بھی کارروائی سے پہلے ایجنٹ سے تصدیق شدہ معلومات کا خلاصہ طلب کریں۔ 1M ٹوکن کا بجٹ وسیع صلاحیتوں والے ایجنٹس کی تعمیر ممکن بناتا ہے، مگر اس کا مطلب کم لاگت نہیں۔
ملٹی موڈل ان پٹ اور ان کی حدود
Carbon متن، تصاویر، آڈیو، ویڈیو، PDFs اور Office دستاویزات قبول کرتا ہے اور متن کی صورت میں آؤٹ پٹ فراہم کرتا ہے۔ اس کی حدود وسیع ضرور ہیں، لیکن مخصوص ہیں۔ ان حدود کو سمجھنا صرف موڈیلٹیز کی فہرست جاننے سے زیادہ اہم ہے۔
| ان پٹ کی قسم | عملی حد |
|---|---|
| آڈیو | فی پرامپٹ تقریباً 8.4 گھنٹے، یا زیادہ سے زیادہ 1M ٹوکن؛ 1,000 آڈیو فائلوں تک |
| ویڈیو | آڈیو کے ساتھ تقریباً 45 منٹ، آڈیو کے بغیر تقریباً 1 گھنٹہ؛ فی پرامپٹ 10 ویڈیوز تک |
| تصاویر اور دستاویزات | فی پرامپٹ مجموعی طور پر 3,000 تک |
| دستاویزات | فی فائل 3,000 صفحات تک |
| Office فارمیٹس | .docx، .doc، .pptx، .ppt، .xlsx، .xls |
| OpenDocument فارمیٹس | .odt، .odp، .ods |
| ان پٹ سائز | GenerateContent API پر کمپریسڈ 500 MiB؛ Interactions API پر 256 MiB |
آڈیو کی حد سب سے نمایاں ہے۔ ایک درخواست میں آٹھ گھنٹے کا آڈیو فراہم کرنے کی سہولت ان ٹیموں کے لیے کام کا نیا طریقہ پیش کرتی ہے جن کی زیادہ تر سرگرمیاں میٹنگز پر مشتمل ہیں۔ ٹرانسکرپشن اور چھوٹے حصوں میں تقسیم کرنے کے بجائے آپ پورے دن کی کالز فراہم کر سکتے ہیں اور اہم موضوعات، فیصلوں اور زیرِ التوا سوالات کا خلاصہ طلب کر سکتے ہیں۔ اس کی لاگت ٹوکنز کی صورت میں آتی ہے۔ آڈیو ٹوکنز کی بلنگ بھی ان پٹ ٹوکنز کے مطابق ہوتی ہے، اس لیے پورے دن کی آڈیو اپ لوڈ کرنا مفت نہیں۔
ویڈیو کی حد معمول کے کاموں کے زیادہ قریب ہے۔ آڈیو کے ساتھ 45 منٹ کی ویڈیو کسی لیکچر، پروڈکٹ ڈیمو یا ریکارڈ شدہ انٹرویو کے لیے کافی ہے، لیکن پوری کانفرنس کے لیے نہیں۔
کچھ صلاحیتیں دستیاب نہیں، جنہیں ورک فلو کی منصوبہ بندی میں شامل کرنا ضروری ہے۔ Gemini Live API کی معاونت موجود نہیں، اس لیے حقیقی وقت میں وائس انٹریکشن ممکن نہیں۔ RAG Engine اور Model Tuning بھی دستیاب نہیں، لہٰذا Retrieval اور Fine-tuning کا انتظام آپ کی ایپلی کیشن کی سطح پر کرنا ہوگا۔ Explicit Context Caching بھی موجود نہیں۔ صرف Implicit Caching دستیاب ہے، جس کی کم از کم حد 4,096 ٹوکن ہے۔ اس کا اثر بار بار استعمال ہونے والے طویل پرامپٹس کی لاگت پر پڑتا ہے۔
Felo پر Gemini 4 Carbon کو کیسے استعمال کریں؟
Felo اس ماڈل کے لیے Messages API کو تجویز کردہ انٹرفیس قرار دیتا ہے۔ اس کا Endpoint، https://openapi.felo.ai/api/v1/messages پر Anthropic-compatible Request Structure قبول کرتا ہے، جبکہ Model ID gemini-4-carbon ہے۔
اس کا طریقہ Felo کے دیگر ماڈلز جیسا ہے:
- Felo API Key بنائیں۔ Felo Console میں Keys بنائی جاتی ہیں اور انہیں
FELO_API_KEYکے نام سے محفوظ کیا جاتا ہے۔ اپنی Key کو کسی Repository میں Commit نہ کریں اور نہ ہی Logs میں شامل کریں۔ - پہلے Playground میں ٹیسٹ کریں۔ Gemini 4 Carbon Playground میں کوڈ لکھنے سے پہلے پرامپٹس آزما سکتے ہیں۔
- ایک مختصر درخواست بھیجیں۔ مختصر پرامپٹ سے آغاز کریں اور Response Structure کی تصدیق کریں۔
- Streaming شامل کریں۔ Server-Sent Events کے لیے
stream: trueمقرر کریں۔ یہ اس لیے اہم ہے کہ ایک سیگمنٹ 65,536 ٹوکن تک جا سکتا ہے۔ - اپنے کام سے متعلق ٹیسٹ کریں۔ حقیقی ان پٹ سائز، حقیقی Evaluation Criteria اور کم از کم دو Thinking Levels استعمال کریں، پھر کسی Pipeline کا انتخاب کریں۔
Python کی ایک بنیادی درخواست اس طرح نظر آتی ہے:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
انٹیگریشن سے متعلق دو نکات اہم ہیں۔ پہلی بات، یہ ماڈل Reasoning کی صلاحیت رکھتا ہے۔ گفتگو جاری رکھتے وقت موصول ہونے والا Reasoning Metadata محفوظ رکھیں، ورنہ ماڈل اپنی متوقع معلومات سے محروم ہو سکتا ہے۔ دوسری بات، max_tokens مجموعی آؤٹ پٹ کے بجائے ایک سیگمنٹ کی حد مقرر کرتا ہے۔ طویل آؤٹ پٹ کے لیے عدد بڑھانے پر انحصار کرنے کے بجائے اپنے SDK میں موجود Continuation Mechanism استعمال کریں۔
Felo ان ماڈلز کے لیے OpenAI-compatible Chat Completions اور Responses Endpoints کی دستاویزات بھی فراہم کرتا ہے جو ان کی معاونت کرتے ہیں۔ چونکہ Carbon کے لیے ماڈل کا صفحہ Messages API تجویز کرتا ہے، اس لیے OpenAI پر مبنی کلائنٹ میں تبدیلی سے پہلے ماڈل کے صفحے پر معاون انٹرفیس کی تصدیق کریں۔
Felo پر Gemini 4 Carbon کی قیمت کیا ہے؟
Felo، Gemini 4 Carbon کو Google کے پانچ فراہم کنندگان کے ذریعے پیش کرتا ہے اور تمام روٹس پر اس وقت 50% رعایت درج ہے۔ ذیل میں قیمتیں فی 1 ملین ٹوکن دی گئی ہیں، جن میں معیاری اور رعایتی دونوں نرخ شامل ہیں۔
| روٹ | ان پٹ | آؤٹ پٹ | کیش ریڈ |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
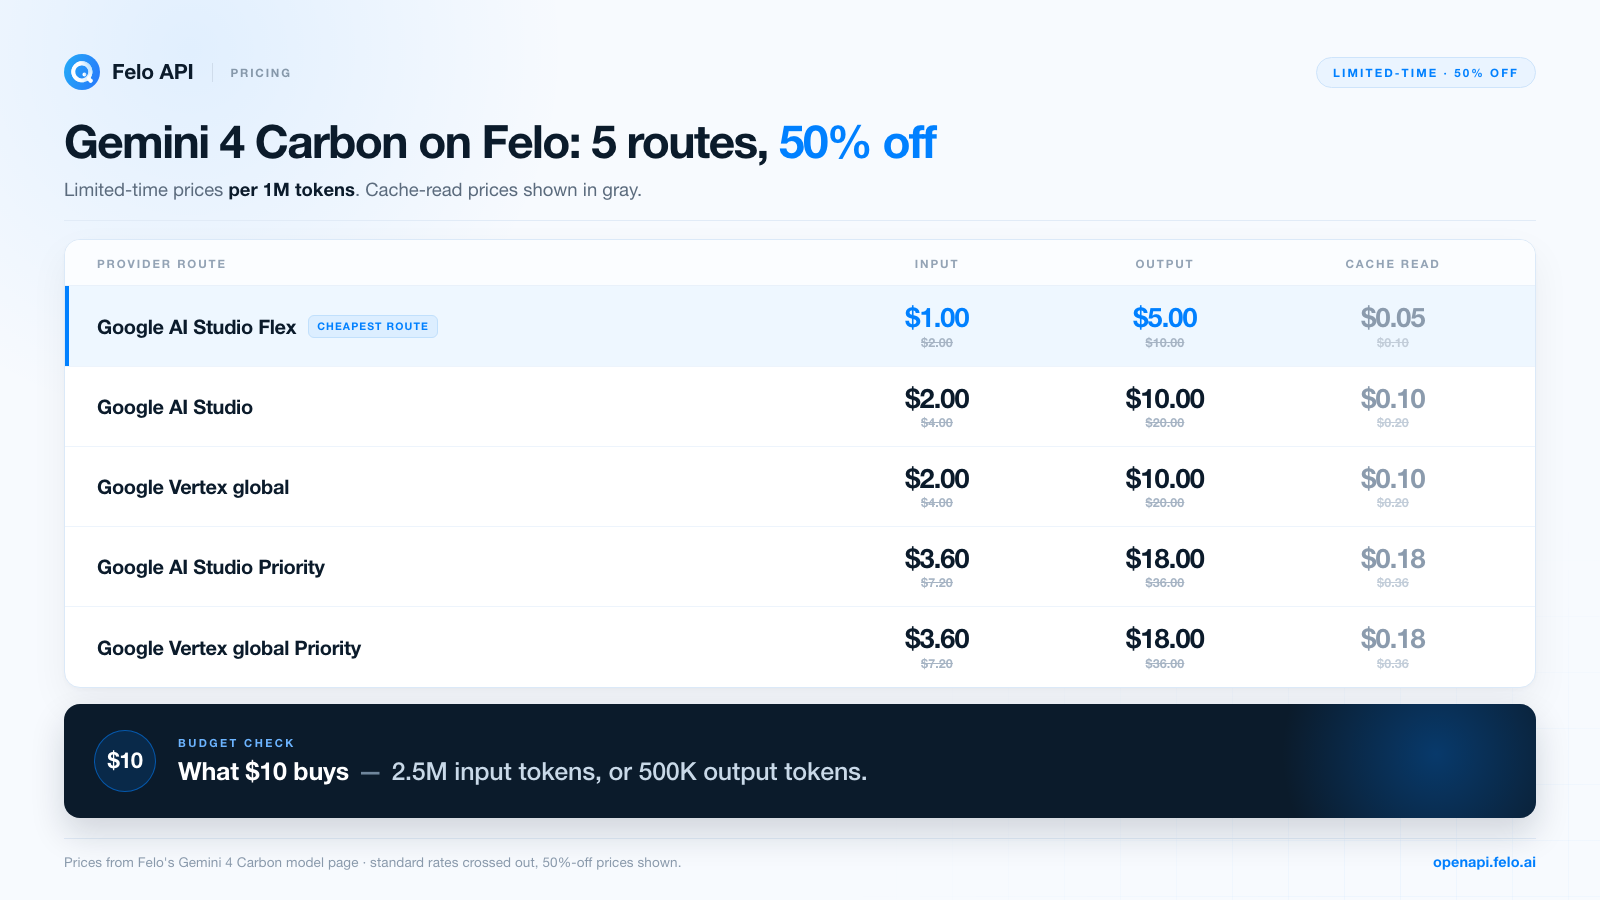
Felo کا Pricing Page معیاری قیمتوں کو "What $10 Buys" کے عنوان سے واضح کرتا ہے۔ اس کے مطابق $10 میں تقریباً 2.5 ملین ان پٹ ٹوکن یا 500,000 آؤٹ پٹ ٹوکن حاصل کیے جا سکتے ہیں، رعایت سے پہلے۔ Proof of Concept کی لاگت کا اندازہ لگانے کے لیے یہ ایک مفید طریقہ ہے۔ اگر کسی ٹیسٹ میں 100,000 ٹوکن والی دستاویزات کے مجموعے بھیجے جائیں اور 5,000 ٹوکن کے جوابات موصول ہوں تو رعایتی Flex روٹ پر لاگت تقریباً $0.13 ہوگی۔ اس میں ان پٹ کے لیے $0.10 اور آؤٹ پٹ کے لیے $0.025 شامل ہیں۔ یہ لاگت کسی حتمی فیصلے سے پہلے متعدد آزمائشوں کے لیے مناسب ہے۔
مفت ٹرائل رعایتی قیمتوں سے الگ پیشکش ہے۔ Felo کے ماڈل صفحے پر Gemini 4 Carbon کے لیے محدود مدت کا مفت ٹرائل درج ہے۔ کریڈٹس خرچ کیے بغیر ماڈل کی جانچ کے لیے یہ ایک موزوں موقع ہے۔ ماڈل کے صفحے پر موجودہ شرائط دیکھیں، کیونکہ ٹرائل کی دستیابی اور قیمتوں میں رعایت محدود مدت کے لیے ہیں اور تبدیل ہو سکتی ہیں۔
اس ماڈل کی لاگت کی منصوبہ بندی میں ایک اضافی عادت ضروری ہے۔ چونکہ Thinking Tokens کی بلنگ آؤٹ پٹ ریٹ کے مطابق ہوتی ہے، اس لیے HIGH Thinking پر چلنے والے ایجنٹ کی لاگت نظر آنے والے جواب کی بنیاد پر لگائے گئے اندازے سے کئی گنا زیادہ ہو سکتی ہے۔ ہر کام کے لیے ٹوکن کے استعمال کا ریکارڈ رکھیں، جس میں Reasoning Tokens بھی شامل ہوں، اور فی درخواست لاگت کے بجائے فی منظور شدہ نتیجے کی لاگت کا موازنہ کریں۔
حدود اور فیصلہ کرنے سے پہلے تصدیق طلب امور
Carbon ایک فرنٹیئر ماڈل ہے اور اس کی کمزوریاں دستاویزی شکل میں موجود ہیں۔ پروڈکشن کی منصوبہ بندی کے لیے درج ذیل نکات اہم ہیں:
- Hallucination۔ Google اسے ایک معلوم حد قرار دیتا ہے۔ طویل کانٹیکسٹ معلومات چھوٹ جانے کے امکانات کم کرتا ہے، لیکن درست تشریح کی ضمانت نہیں دیتا۔ حوالہ دینے اور تصدیق کرنے والا ورک فلو ضروری ہے۔
- Latency اور Timeouts۔ Google نے بعض حالات میں سست رفتار اور ٹائم آؤٹ کے مسائل کی نشاندہی کی ہے۔ HIGH Thinking پر طویل عمل کے لیے زیادہ Timeout، Retries اور Idempotent Task Handling درکار ہیں۔
- زیادہ ٹوکن کا استعمال۔ یہ ماڈل Argon کے مقابلے میں زیادہ Thinking Tokens استعمال کرتا ہے، خاص طور پر اعلیٰ سطحوں پر۔ اسی کے مطابق بجٹ بنائیں اور معمول کے کاموں کے لیے کوششوں کی حد مقرر کریں۔
- معلومات کی آخری تاریخ مارچ 2026۔ اس تاریخ کے بعد کے واقعات کے لیے Retrieval یا موجودہ ذرائع درکار ہیں۔ Carbon اس تاریخ کے بعد ہونے والے واقعات سے واقف نہیں۔
- مقررہ Sampling۔ Temperature، top-p اور top-k تبدیل نہیں کیے جا سکتے۔ اگر آپ کی Pipeline کو Deterministic آؤٹ پٹ درکار ہے تو اس مرحلے کے لیے کوئی دوسرا ماڈل استعمال کریں۔
- Explicit Caching، Tuning، RAG Engine اور Live API کی عدم دستیابی۔ ان میں سے ہر سہولت کی عدم موجودگی اضافی کام آپ کی Application Layer پر منتقل کرتی ہے۔
- دستیابی کی پابندیاں۔ Google منتخب علاقوں میں تصدیق شدہ انٹرپرائز صارفین کو Carbon فراہم کرتا ہے، جبکہ Felo اسے Global، US اور EU فراہم کنندگان کے ذریعے پیش کرتا ہے۔ اپنے استعمال کے مطابق روٹ اور شرائط کی تصدیق کریں۔
- حفاظتی ضوابط اور رسائی کی شرائط۔ سائبر ویرینٹ کے لیے Allowlist ضروری ہے اور سکیورٹی ورک فلو کے لیے مجاز ہونا لازمی ہے۔ ماڈل کے حفاظتی نظام اور فراہم کنندگان کی پالیسیاں بھی لاگو رہتی ہیں۔
تو کیا آپ کو اسے استعمال کرنا چاہیے؟
Gemini 4 Carbon اس وقت استعمال کریں جب کام طویل ہو، شواہد پیچیدہ ہوں اور غلط جواب کی قیمت زیادہ ہو۔ اس کی مثالوں میں Migration Plan، Security Review، Research Synthesis، مالیاتی یا قانونی تجزیہ اور ایسا ایجنٹ شامل ہے جسے کارروائی سے پہلے تحقیق کرنا ضروری ہو۔ اس کا بینچ مارک پروفائل اور متحد بجٹ اسی نوعیت کے کاموں کے لیے تیار کیے گئے ہیں۔
اسے ہر درخواست کے لیے ڈیفالٹ ماڈل نہ بنائیں۔ زیادہ تعداد میں Classification، مختصر Extraction، سادہ خلاصے اور ایسے کام جن میں Deterministic Sampling ضروری ہو، کم قیمت اور تیز رفتار ماڈلز کے لیے زیادہ موزوں ہیں۔ تقریباً ہر صورت میں وہ سب سے کم قیمت والا ماڈل بہتر انتخاب ہوتا ہے جو آپ کے معیار پر پورا اترے۔ Carbon کو آپ کے ورک لوڈ کے مشکل ترین حصے میں اپنی افادیت ثابت کرنی چاہیے۔
حقیقت پسندانہ خلاصہ یہ ہے: Carbon، گہرے اور پیچیدہ کاموں کے لیے Google کا سب سے زیادہ صلاحیت رکھنے والا ماڈل ہے۔ سکیورٹی، قانونی امور، فنانس اور طویل کانٹیکسٹ والے استدلال میں اس کی کارکردگی مضبوط ہے، لیکن اس کے ساتھ Latency اور ٹوکن کی اضافی لاگت بھی آتی ہے۔ اس کی دستاویزی حدود کے باعث تصدیق ناگزیر ہے۔ اپنے ورک فلو کی بنیاد اس پر رکھنے سے پہلے اسے اپنے حقیقی کاموں پر آزمائیں۔
اکثر پوچھے جانے والے سوالات
کیا Felo پر Gemini 4 Carbon کا مفت ٹرائل دستیاب ہے؟
جی ہاں۔ Felo نے Gemini 4 Carbon کے لیے محدود مدت کا مفت ٹرائل درج کیا ہے۔ اس پیشکش کی مدت کے دوران ماڈل کے فراہم کنندگان کے نرخوں پر بھی رعایت موجود ہے۔ شرائط تبدیل ہو سکتی ہیں، اس لیے موجودہ دستیابی کے لیے Gemini 4 Carbon کا ماڈل صفحہ دیکھیں۔
Gemini 4 Carbon اور Gemini 4 Argon میں کیا فرق ہے؟
Carbon، Argon کی بنیاد پر تیار کیا گیا ہے اور اسے گہرے استدلال کے لیے بہتر بنایا گیا ہے۔ یہ 1,048,576 ٹوکن کا متحد بجٹ استعمال کرتا ہے، جس میں ان پٹ، سوچنے کا عمل، ٹول کالز اور آؤٹ پٹ شامل ہیں۔ اس میں LOW، MEDIUM اور HIGH سوچنے کی سطحیں موجود ہیں، یہ زیادہ Thinking Tokens استعمال کرتا ہے اور Office/OpenDocument فائلوں کی معاونت کے ساتھ بہتر حفاظتی خصوصیات فراہم کرتا ہے۔ طویل تحریر تیار کرنے کے ایسے کاموں کے لیے Argon بہتر انتخاب ہے جہاں تصدیق کی گہرائی کے مقابلے میں آؤٹ پٹ کی لمبائی زیادہ اہم ہو۔
Gemini 4 Carbon کی Context Window اور زیادہ سے زیادہ Output کتنی ہے؟
اس کا متحد بجٹ 1,048,576 ٹوکن ہے، جس میں ان پٹ اور آؤٹ پٹ دونوں شامل ہیں۔ ایک اسٹریمنگ سیگمنٹ زیادہ سے زیادہ 65,536 آؤٹ پٹ ٹوکن تیار کر سکتا ہے، جبکہ نان اسٹریمنگ میں یہ حد 32,768 ہے۔ Long Decodes کے ذریعے باقی بجٹ تک آؤٹ پٹ جاری رکھا جا سکتا ہے۔ Felo اپنے روٹ پر زیادہ سے زیادہ 943.718K ٹوکن آؤٹ پٹ درج کرتا ہے۔
کیا Gemini 4 Carbon آڈیو، ویڈیو اور Office فائلیں پڑھ سکتا ہے؟
جی ہاں۔ یہ متن، تصاویر، آڈیو، ویڈیو، PDF اور Office/OpenDocument فائلیں قبول کرتا ہے۔ اس کی حدود میں تقریباً 8.4 گھنٹے کا آڈیو، تقریباً 45 سے 60 منٹ کی ویڈیو، مجموعی طور پر 3,000 تصاویر اور دستاویزات، اور فی دستاویز 3,000 صفحات شامل ہیں۔ آؤٹ پٹ صرف متن کی صورت میں فراہم ہوتا ہے۔
کیا Gemini 4 Carbon OpenAI-compatible APIs کو سپورٹ کرتا ہے؟
Felo اس ماڈل کے لیے اپنی Anthropic-compatible Messages API تجویز کرتا ہے۔ اس کے علاوہ، معاون ماڈلز کے لیے OpenAI-compatible Chat Completions اور Responses Endpoints کی دستاویزات بھی موجود ہیں۔ کسی موجودہ کلائنٹ میں تبدیلی سے پہلے ماڈل کے صفحے پر موجودہ انٹرفیس کی تصدیق کریں۔
Gemini 4 Carbon کی قیمت کتنی ہے؟
Felo پر Google کے پانچ روٹس دستیاب ہیں اور تمام پر اس وقت 50% رعایت ہے۔ AI Studio Flex کی قیمت فی ملین ٹوکن $1 ان پٹ اور $5 آؤٹ پٹ ہے۔ معیاری AI Studio اور Vertex روٹس کی قیمت $2 ان پٹ اور $10 آؤٹ پٹ ہے، جبکہ Priority روٹس کے نرخ $3.60 اور $18 ہیں۔ Cache Read کی قیمت فی ملین ٹوکن $0.05 سے شروع ہوتی ہے۔ موجودہ نرخوں کے لیے Felo Pricing Page دیکھیں۔
Gemini 4 Carbon کب جاری کیا گیا؟
Google نے 28 اکتوبر 2026 کو Gemini 4 Carbon کا اعلان کیا۔ ابتدائی طور پر اسے Fairwind Program کے ذریعے سائبر سکیورٹی کے منتخب دفاعی ماہرین کے لیے جاری کیا گیا۔ Google کے انٹرپرائز پلیٹ فارم پر 10 نومبر 2026 سے عمومی دستیابی درج ہے۔ Felo اب اس ماڈل کو Google کے پانچ فراہم کنندگان کے ذریعے پیش کرتا ہے۔
Felo پر Gemini 4 Carbon آزمائیں
Carbon کی صلاحیت جانچنے کا بہترین طریقہ یہ ہے کہ اسے ایسا کام دیں جس کا جواب آپ پہلے سے جانتے ہوں۔ Gemini 4 Carbon Playground کھولیں، کوئی حقیقی دستاویز یا کوڈ سیمپل فراہم کریں اور ایک ہی پرامپٹ پر LOW اور HIGH Thinking کا موازنہ کریں۔ اگر نتائج معیار پر پورا اتریں تو API Key بنائیں اور ٹیسٹ کو اپنی Pipeline میں شامل کریں۔
موجودہ ٹرائل کی شرائط، فراہم کنندگان کے روٹس اور استعمال کی حدود کے لیے Gemini 4 Carbon کے ماڈل صفحے سے آغاز کریں۔ اس کے بعد اپنے سب سے مشکل حقیقی کام کے گرد ایک مختصر ترین ممکنہ ٹیسٹ تیار کریں۔
یہ مضمون ان زبانوں میں بھی دستیاب ہے: English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, Bahasa Indonesia, Deutsch, Tiếng Việt, Türkçe, Italiano, ไทย, Español, বাংলা and Português۔