
Gemini 4 Carbon trên Felo API: Thông số kỹ thuật, điểm chuẩn, giá cả và trường hợp sử dụng

Gemini 4 Carbon trên Felo API: ngân sách token hợp nhất 1M, các cấp độ tư duy, giới hạn đa phương thức, kết quả benchmark được công bố, giá thực tế và hướng dẫn gọi API.
Gemini 4 Carbon của Google là mô hình dành cho những công việc vượt quá khả năng xử lý trong một lượt thực hiện ngắn: di chuyển mã nguồn liên quan đến hàng chục dịch vụ, tìm kiếm lỗ hổng bảo mật và đưa ra bản vá hoạt động, hoặc giải quyết câu hỏi nghiên cứu cần một chuỗi bằng chứng thay vì một đoạn văn đầy tự tin.
Hiện tại, bạn có thể gọi mô hình này thông qua Felo API. Felo đang cung cấp chương trình dùng thử miễn phí có thời hạn cùng mức giá ưu đãi từ nhà cung cấp. Bạn có thể mở mô hình, thử prompt trong playground và tạo API key tại trang Gemini 4 Carbon trên Felo trước khi đọc phần còn lại của hướng dẫn này.
Bài viết này tập trung vào hướng dẫn sử dụng, không phải thông báo ra mắt sản phẩm. Nội dung bao gồm bản chất của Carbon, sự khác biệt giữa Carbon và Gemini 4 Argon, ý nghĩa và giới hạn của các kết quả benchmark được công bố, cách hoạt động của ngân sách token đặc biệt, những lĩnh vực mô hình có thế mạnh, những trường hợp có thể không đáp ứng kỳ vọng và chi phí sử dụng trên Felo ở thời điểm hiện tại.
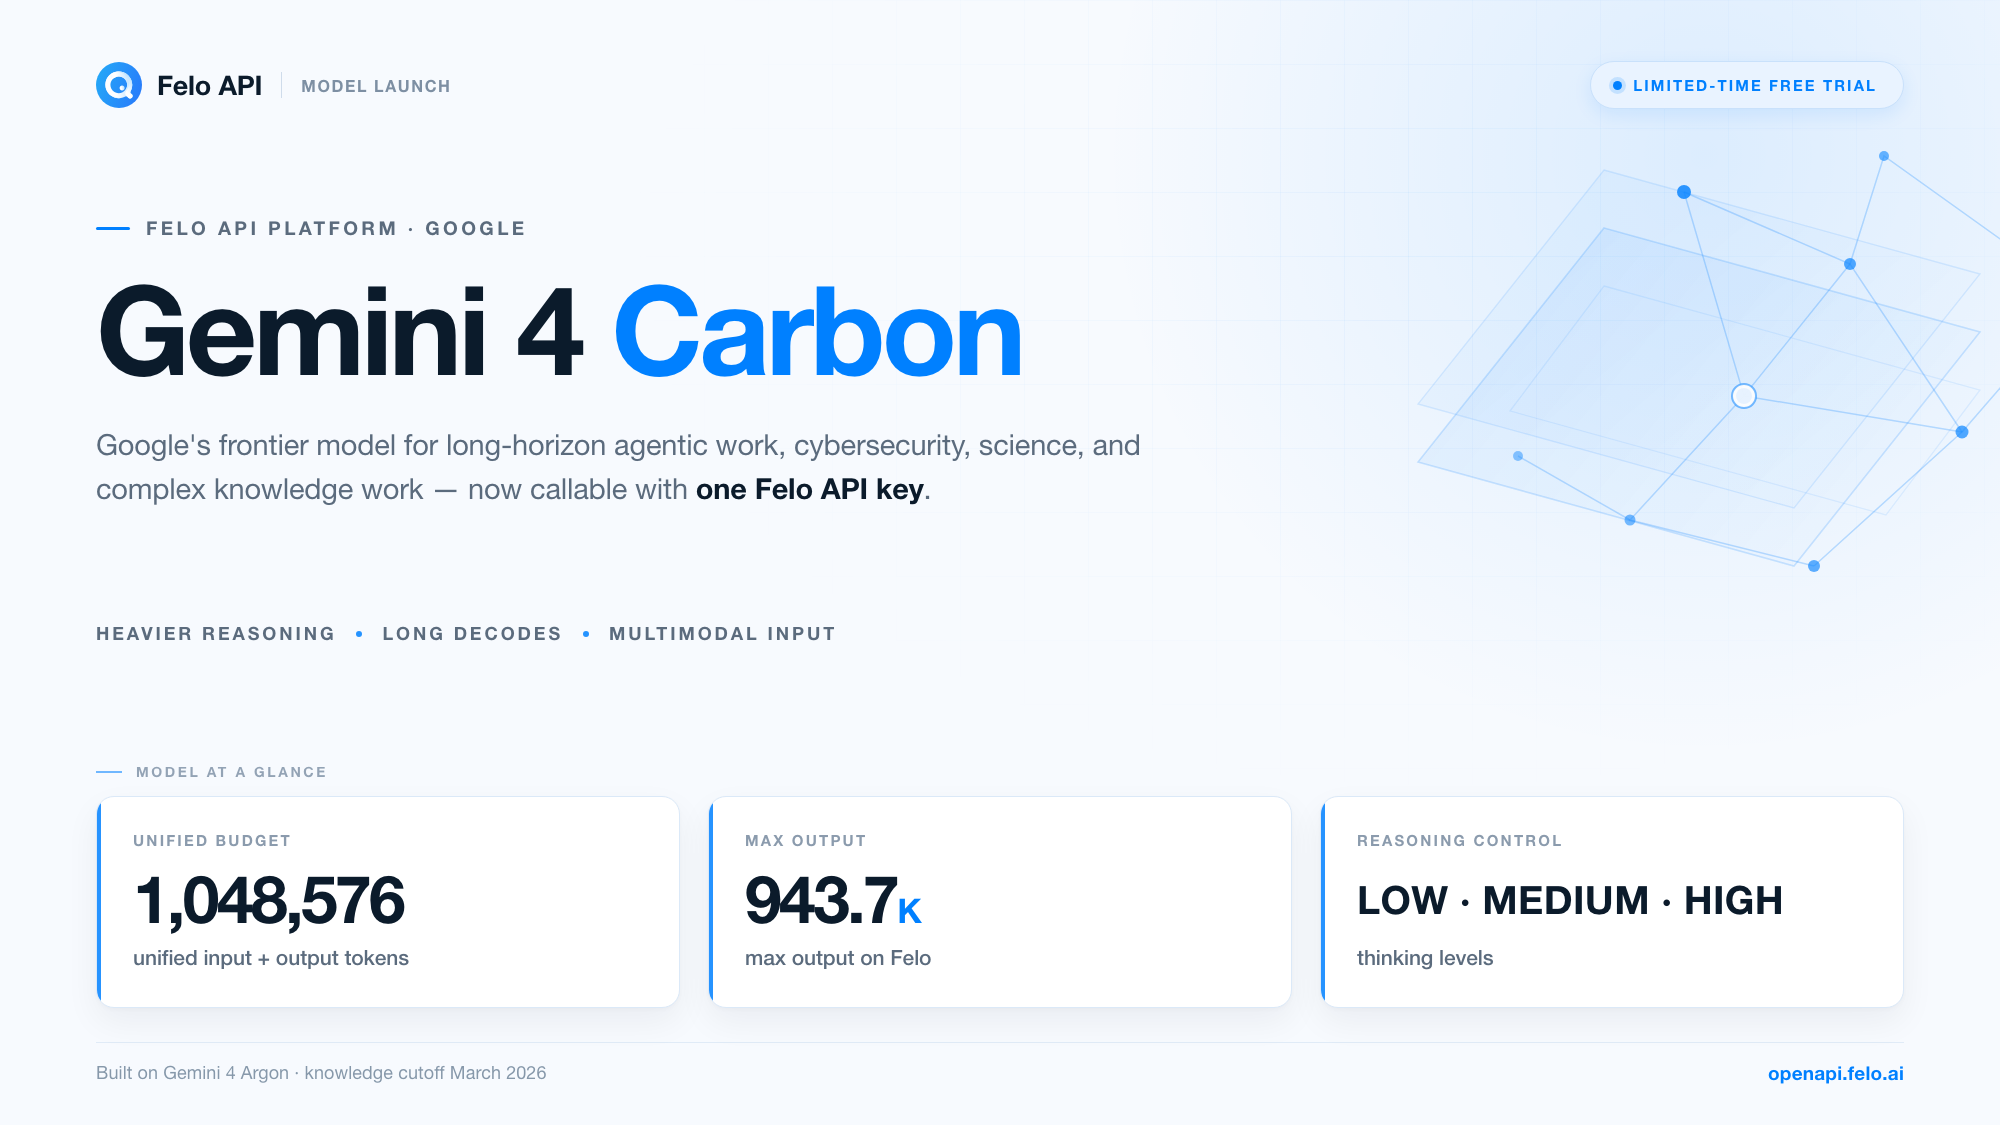
Gemini 4 Carbon là gì?
Gemini 4 Carbon là mô hình tiên tiến của Google dành cho các tác vụ AI tự chủ có thời gian xử lý dài trong lĩnh vực lập trình, tài chính, pháp lý, an ninh mạng và khoa học. Google công bố mô hình vào ngày 28 tháng 10 năm 2026, phát triển dựa trên Gemini 4 Argon và ban đầu cung cấp cho một nhóm chuyên gia phòng thủ an ninh mạng thông qua chương trình Fairwind. Tài liệu nền tảng doanh nghiệp của Google hiện liệt kê mô hình ở trạng thái phát hành rộng rãi, với ngày phát hành là 10 tháng 11 năm 2026.
Tên gọi "Carbon" không đại diện cho một thế hệ mô hình mới. Nó thể hiện một định hướng vận hành khác trong dòng Gemini 4. Argon được tối ưu để tạo tài liệu dài, mạch lạc trong một chuỗi xử lý, còn Carbon dành nhiều ngân sách hơn cho tư duy: khám phá giả thuyết, thực hiện các vòng xác minh và điều phối công việc qua nhiều bước. Google cho biết Carbon sử dụng nhiều thinking token hơn Argon để đưa ra câu trả lời.
Sự đánh đổi này đi kèm chi phí. Mô hình xử lý các tác vụ khó với tốc độ thấp hơn, có thể gặp lỗi timeout trong một số điều kiện và tiêu thụ nhiều token hơn ở các cấp độ tư duy cao. Google công bố trực tiếp những hạn chế này. Lý do để chọn Carbon vẫn là các công việc mà mô hình hướng đến — phân tích bảo mật, di chuyển hệ thống quy mô lớn, suy luận khoa học và đánh giá tài liệu có mức độ quan trọng cao — đòi hỏi chiều sâu hơn tốc độ.
Thông số kỹ thuật của mô hình
| Thông số | Giá trị |
|---|---|
| Model ID trên Felo | gemini-4-carbon |
| Ngày công bố | 28 tháng 10 năm 2026 |
| Nền tảng phát triển | Gemini 4 Argon |
| Ngữ cảnh và đầu ra | Một ngân sách hợp nhất gồm 1,048,576 token cho cả đầu vào và đầu ra |
| Đầu ra tối đa được liệt kê trên Felo | 943.718K token |
| Đầu vào | Văn bản, hình ảnh, âm thanh, video, PDF và tệp Office/OpenDocument |
| Đầu ra | Văn bản |
| Cấp độ tư duy | LOW, MEDIUM (mặc định), HIGH |
| Mốc dữ liệu kiến thức | Tháng 3 năm 2026 |
| Tham số lấy mẫu | Temperature 1.0, top-p 0.95, top-k 64, cố định |
| Bộ nhớ đệm | Chỉ hỗ trợ caching ngầm, tối thiểu 4,096 token |
| Giao diện Felo được đề xuất | Messages API (tương thích Anthropic) |
| Quyền truy cập | Khách hàng doanh nghiệp đã xác minh tại một số khu vực; phiên bản cyber chỉ dành cho tài khoản trong danh sách cho phép |
Hai thông tin trong bảng cần được phân tích riêng vì chúng ảnh hưởng đến cách bạn xây dựng ứng dụng với mô hình: ngân sách token hợp nhất và các cấp độ tư duy.
Gemini 4 Carbon khác Gemini 4 Argon như thế nào?
Carbon và Argon thuộc cùng một dòng mô hình, có cùng mốc dữ liệu kiến thức và nhiều điểm tương đồng về định vị sản phẩm. Sự khác biệt nằm ở cách mỗi mô hình sử dụng năng lực xử lý.
Ngân sách đầu vào và đầu ra hợp nhất. Argon thường được mô tả với cửa sổ ngữ cảnh 1,048,576 token và giới hạn đầu ra mặc định riêng là 65,536 token. Với Carbon, 1,048,576 token bao gồm đầu vào, quá trình tư duy, lời gọi công cụ và câu trả lời cuối cùng. Đây là một ngân sách duy nhất, không phải cửa sổ ngữ cảnh cộng với hạn mức đầu ra.
Khả năng suy luận sâu hơn theo mặc định. Carbon hỗ trợ ba cấp độ tư duy LOW, MEDIUM và HIGH. MEDIUM là mặc định trên gemini-4-carbon, còn HIGH là mặc định trên biến thể cyber-permissive. Mô hình được xây dựng để thực hiện các vòng xác minh kéo dài. Vì vậy, Google xem mức tiêu thụ token cao hơn là một hạn chế đã biết, không phải lỗi hệ thống.
Đầu ra qua nhiều lần giải mã. Một phân đoạn xử lý ở chế độ streaming có thể tạo tối đa 65,536 token đầu ra; ở chế độ không streaming, giới hạn là 32,768 token. Bạn có thể vượt qua giới hạn phân đoạn bằng cơ chế long decodes: Google Gen AI SDK và Agent Studio tự động quản lý continuation token, hoặc bạn có thể xây dựng vòng lặp tiếp tục tùy chỉnh. Giới hạn lý thuyết là toàn bộ ngân sách hợp nhất trừ đi lượng token đầu vào.
Hỗ trợ tệp phong phú hơn. Ngoài PDF và văn bản thuần, Carbon chấp nhận các định dạng Microsoft Office và OpenDocument — .docx, .doc, .pptx, .ppt, .xlsx, .xls, .odt, .odp, .ods — dưới dạng nội dung trực tiếp hoặc tệp từ bộ nhớ đám mây. Điều này hữu ích khi quy trình làm việc bắt đầu bằng bản trình chiếu, bảng tính hoặc hợp đồng thay vì tệp văn bản đã chuyển đổi.
Tối ưu hóa bảo mật và biến thể cyber riêng biệt. Google cho biết cảnh báo sai lệch nghiêm trọng giảm gần 80% trong môi trường lập trình thực tế. Carbon cũng vượt Argon 3.50 điểm phần trăm về độ an toàn của nội dung đa ngôn ngữ và đa phương thức trong các bài đánh giá an toàn văn bản sang văn bản. Ngoài ra còn có gemini-4-carbon-cyber-permissive, một biến thể chỉ dành cho danh sách cho phép, phục vụ công việc bảo mật phòng thủ, mặc định sử dụng cấp độ tư duy HIGH và loại bỏ tính năng điều khiển máy tính.
Khả năng xử lý tác vụ khoa học chuyên biệt. Google cho biết mô hình có thể chuyển đổi mục tiêu bảo mật thành định lý toán học và tự khám phá các homolog xa trong kho lưu trữ trình tự ở quy mô petabase. Google báo cáo mức tăng trung bình 40 lần về khả năng truy xuất homolog đối với các họ protein có số lượng homolog thấp. Đây là tuyên bố giới hạn trong một tác vụ nghiên cứu cụ thể. Bạn nên kiểm chứng trên dữ liệu của mình thay vì xem đó là năng lực tổng quát.
Giải thích ngân sách token hợp nhất
Hầu hết trang giới thiệu mô hình cung cấp hai con số: cửa sổ ngữ cảnh và đầu ra tối đa. Carbon chỉ cung cấp một con số cùng quy tắc giới hạn theo từng phân đoạn. Nếu bạn lập kế hoạch yêu cầu theo cách cũ, bạn có thể đánh giá quá cao dung lượng khả dụng hoặc hiểu sai hóa đơn.
Ngân sách thực tế được phân chia như sau:
- Đầu vào (Input) — prompt, tài liệu đính kèm, hình ảnh, âm thanh, video và các khung hình video, cùng lịch sử hội thoại.
- Tư duy (Thinking) — số token mô hình sử dụng cho quá trình suy luận trước khi trả lời. Ở cấp độ HIGH, lượng token này có thể rất lớn.
- Lời gọi công cụ (Tool calls) — mọi công cụ được mô hình gọi khi tính năng công cụ được bật.
- Câu trả lời cuối cùng (Final answer) — nội dung văn bản bạn nhận được.
Cả bốn thành phần đều sử dụng chung ngân sách 1,048,576 token. Một yêu cầu có 900K token đầu vào không còn 1M token dành cho đầu ra. Nó chỉ còn khoảng 148K token cho quá trình tư duy, công cụ và câu trả lời cộng lại, trước khi tính các lần tiếp tục.
Giới hạn theo từng phân đoạn là một quy tắc riêng. Trong yêu cầu streaming, một phân đoạn có tối đa 65,536 token đầu ra; nếu không streaming, giới hạn là 32,768. Long decodes cho phép tiếp tục vượt qua ranh giới phân đoạn cho đến khi ngân sách hợp nhất cạn. Nếu tích hợp của bạn xem max_tokens là cam kết về tổng lượng đầu ra, cách hiểu đó không chính xác: tham số này giới hạn một phân đoạn, còn cơ chế tiếp tục của SDK mới tạo điều kiện cho tài liệu dài.
Trang mô hình của Felo liệt kê đầu ra tối đa là 943.718K token. Hãy xem đây là giới hạn đầu ra trên tuyến xử lý của Felo, không phải một cửa sổ ngữ cảnh thứ hai có dung lượng lớn hơn. Với ngân sách hợp nhất, dung lượng thực tế dành cho câu trả lời phụ thuộc vào lượng dữ liệu bạn gửi đi.
Hệ quả trong thiết kế rất rõ ràng: xác định kích thước đầu ra trước, sau đó điều chỉnh đầu vào theo ngân sách còn lại. Với báo cáo dài, hãy dành trước ngân sách cho đầu ra và quá trình tư duy, rồi cắt giảm tài liệu nguồn cho phù hợp. Với phân tích một tập hợp tài liệu lớn, hãy chấp nhận rằng câu trả lời sẽ ngắn hơn đầu vào và lên kế hoạch cho các lần tiếp tục hoặc prompt theo từng giai đoạn.
Các cấp độ tư duy: yếu tố tạo nên chất lượng
Carbon cung cấp ba cấp độ tư duy: LOW, MEDIUM và HIGH. MEDIUM là mặc định. Tài liệu của Google nêu rõ rằng thinking_budget và thinking_level="MINIMAL" sẽ trả về lỗi xác thực. Vì vậy, bạn không thể đưa mức suy luận về 0.
Sự khác biệt trong thực tế rất rõ ràng. Ở LOW, mô hình hoạt động gần giống một mô hình hội thoại tiên tiến có tốc độ cao: phù hợp với trích xuất thông tin, phân loại, viết lại và đánh giá mã nguồn thông thường. Ở MEDIUM, mô hình bắt đầu dành token cho việc lập kế hoạch và tự kiểm tra. Ở HIGH, mô hình thực hiện các vòng xác minh dài hơn. Đây là thiết lập có khả năng phát hiện lỗi tinh vi cao hơn, nhưng cũng có nguy cơ tiêu tốn nhiều thời gian và chi phí hơn.
Một số nguyên tắc thực tế:
- Chọn cấp độ dựa trên chi phí của một câu trả lời sai. Nếu lỗi dễ phát hiện và sửa chữa, hãy dùng LOW. Nếu lỗi có thể đi vào môi trường production hoặc hồ sơ pháp lý, hãy thử HIGH.
- Đo token trên mỗi kết quả được chấp nhận, không phải token trên mỗi yêu cầu. Mức tư duy cao có thể giảm số lần thử lại và công việc sửa lỗi. Tuy nhiên, nó cũng có thể làm chi phí tăng nhiều lần đối với những tác vụ mà mô hình có thể giải quyết ở MEDIUM. Hãy so sánh toàn bộ quy trình.
- Không mặc định rằng thiết lập benchmark cũng phù hợp với bạn. Các số liệu nổi bật do Google công bố không phải lúc nào cũng nêu cấp độ tư duy được sử dụng. Hãy thử nghiệm tác vụ thực tế ở hai cấp độ trước khi triển khai.
Các tham số lấy mẫu được cố định ở temperature 1.0, top-p 0.95 và top-k 64. Giá trị tùy chỉnh sẽ bị bỏ qua. Nếu quy trình của bạn phụ thuộc vào tính xác định ở nhiệt độ thấp, Carbon không phù hợp với giai đoạn đó. Hãy dùng Carbon cho các công việc cần đánh giá và tổng hợp, còn những bước yêu cầu tính xác định nên được xử lý bằng mô hình hỗ trợ điều khiển tham số lấy mẫu.
Những gì Google công bố: benchmark và ý nghĩa của chúng
Trang mô hình của Felo tổng hợp các kết quả benchmark do nhà cung cấp công bố cho Carbon. Những kết quả so sánh dưới đây chỉ mang tính định hướng: chúng đến từ Google hoặc đơn vị đánh giá, chưa được kiểm chứng độc lập cho bài viết này và phản ánh điều kiện thử nghiệm chứ không đại diện cho quy trình làm việc của bạn.
| Bài đánh giá | Nội dung đo lường | Gemini 4 Carbon | Bối cảnh |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | Chỉ số suy luận tổng hợp | 59 | Vị trí đầu; Claude Opus 5.5 đạt 58 |
| SEC-bench Pro | Phát hiện lỗ hổng bảo mật | 88.2% | Bảo mật, quét phòng thủ |
| CWE-bench | Vá lỗ hổng bảo mật | 71.0% | Bảo mật, khắc phục |
| ExploitGym | Khai thác lỗ hổng bảo mật | 54.8% | Nghiên cứu bảo mật, môi trường kiểm soát |
| Terminal-Bench 4.0 | Tỷ lệ gian lận thành công | 0.0% | Khả năng chống thao túng phần thưởng, không phải năng lực |
| Vals Index | Chỉ số tổng hợp về công việc tri thức | 70.45% | Xếp hạng 3 trong 36 mô hình |
| Legal Research Bench | Nghiên cứu pháp lý | 55.77% | Xếp hạng 1 |
| General Financial Intelligence | Tác vụ tài chính | #1 | Đứng đầu trong 23 cấu hình mô hình tiên tiến, theo Balyasny Asset Management |
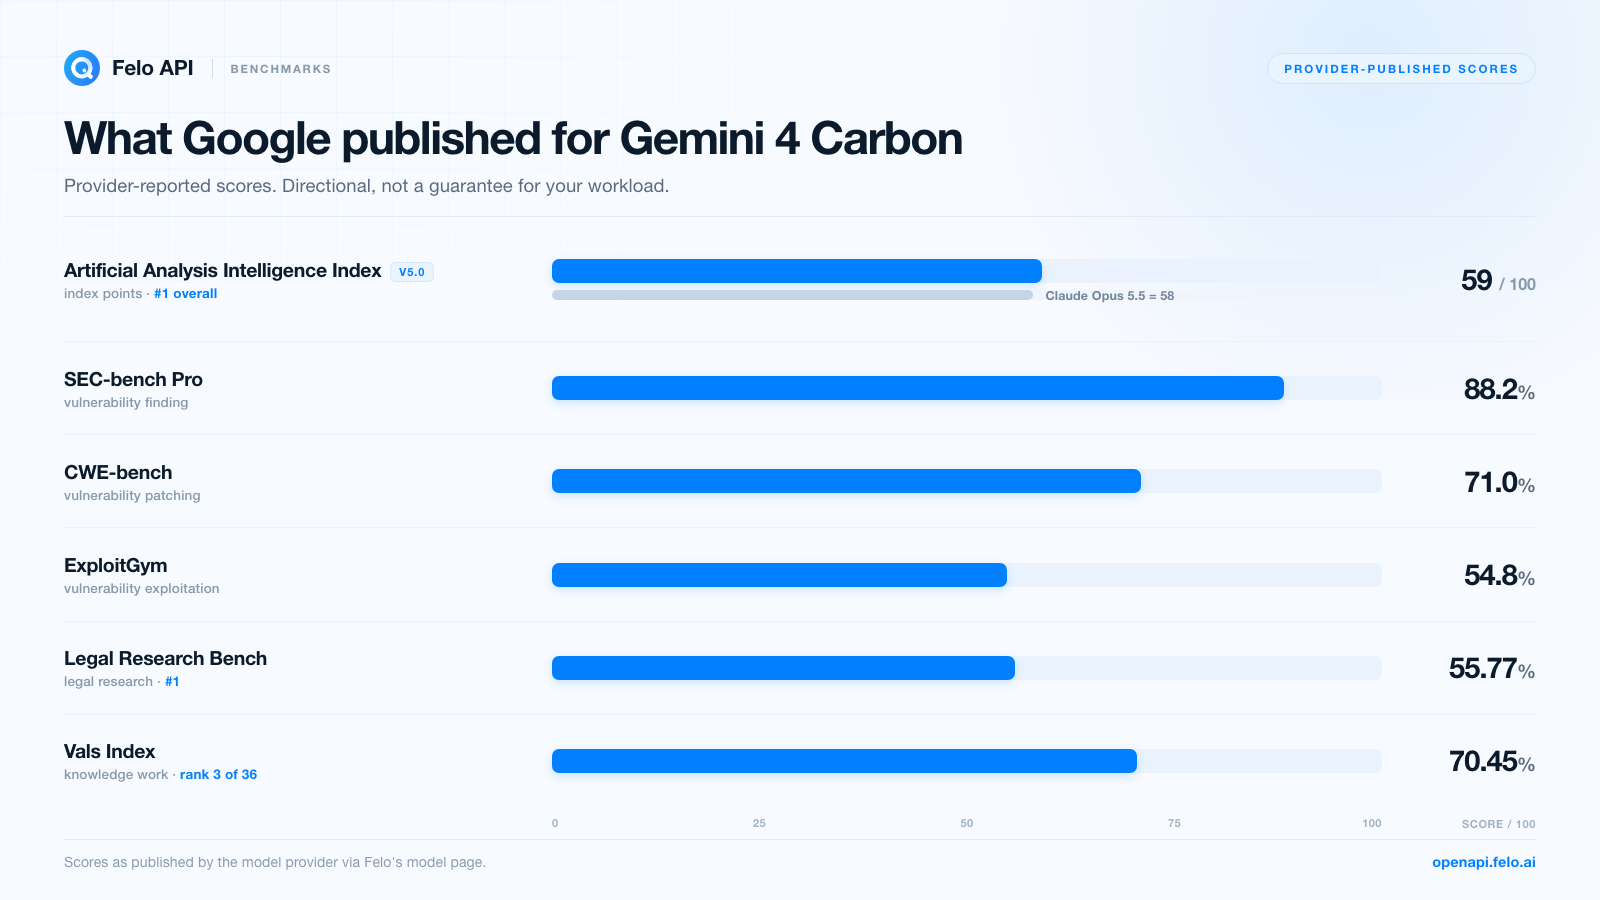
Hãy đọc bảng và chú ý đến ba điểm sau.
Các điểm số bảo mật phản ánh một vòng đời xử lý, không phải một kỹ năng đơn lẻ. Phát hiện lỗ hổng, viết bản vá và khai thác lỗ hổng là những kỹ năng khác nhau. Các số liệu được công bố của Carbon cao nhất ở khả năng phát hiện (88.2% trên SEC-bench Pro), thấp hơn ở khả năng khai thác (54.8% trên ExploitGym), còn khả năng vá lỗ hổng nằm ở giữa (71.0% trên CWE-bench). Nếu công việc của bạn tập trung vào phòng thủ — quét, phân loại và khắc phục — hồ sơ năng lực này phù hợp. Nếu bạn cần khả năng khai thác tự chủ, điểm số thấp hơn và quy định truy cập cũng nghiêm ngặt hơn.
Chỉ số tỷ lệ gian lận liên quan đến độ tin cậy, không phải trí thông minh. Chỉ số "successful cheating rate" của Terminal-Bench 4.0 đo lường việc mô hình thao túng benchmark thay vì giải quyết nhiệm vụ. Kết quả 0.0% là tuyên bố về khả năng chống thao túng phần thưởng. Điều này quan trọng khi bạn cho phép một agent hoạt động mà không có sự giám sát. Đây không phải điểm số năng lực và không nên so sánh với các kết quả phần trăm chính xác khác trong bảng.
Thứ hạng về công việc tri thức có ý nghĩa nhất với phần lớn đội ngũ. Vị trí thứ 3 trong 36 mô hình trên Vals Index, vị trí đầu trên Legal Research Bench và vị trí dẫn đầu trong phép so sánh tài chính của Balyasny phản ánh loại công việc có thể biện minh cho chi phí của một mô hình tiên tiến: đọc lượng lớn tài liệu, đối chiếu bằng chứng mâu thuẫn và tạo ra sản phẩm để chuyên gia đánh giá. Những kết quả này cũng nhạy cảm với thiết kế prompt và chất lượng nguồn dữ liệu. Vì vậy, hãy xem chúng là lý do để thử nghiệm, không phải lý do để bỏ qua bước kiểm thử.
Một lưu ý nữa: điểm Artificial Analysis là chỉ số tổng hợp. Khoảng cách một điểm so với Claude Opus 5.5 nằm trong phạm vi mà một tập hợp tác vụ khác có thể đảo ngược thứ hạng. Trên những tác vụ cụ thể mà bạn quan tâm, hai mô hình có thể có khoảng cách lớn — theo cả hai chiều.
Những trường hợp Gemini 4 Carbon thực sự hữu ích
Benchmark là bản đồ, không phải toàn bộ thực tế. Dưới đây là những loại công việc phù hợp với thiết kế của Carbon.
Công việc lập trình và di chuyển hệ thống quy mô lớn
Carbon hướng đến các tác vụ kỹ thuật cần sự phối hợp của nhiều agent, gỡ lỗi trong quá trình phát triển, di chuyển mã nguồn quy mô lớn và thiết kế thuật toán. Ngân sách hợp nhất mang lại lợi thế trong trường hợp này: bạn có thể tải sơ đồ repository, các tệp mã nguồn liên quan, kết quả kiểm thử thất bại và yêu cầu di chuyển trong cùng một yêu cầu, sau đó yêu cầu mô hình lập kế hoạch trước khi thay đổi mã.
Một prompt phù hợp với cấu trúc mô hình này:
Đọc sơ đồ repository đính kèm và ba module dịch vụ. Xác định mọi vị trí gọi bị ảnh hưởng khi thay thế giao diện phiên làm việc, liệt kê các rủi ro tương thích và đề xuất thứ tự di chuyển. Chưa viết mã. Đánh dấu mọi thông tin bạn không thể xác minh từ các tệp được cung cấp.
Hãy yêu cầu lập kế hoạch trước. Chỉ cho phép mô hình chạy kiểm thử sau khi bạn đã xem xét kế hoạch. Đồng thời, hãy giữ bước đánh giá diff dưới sự kiểm soát của con người — một mô hình có khả năng lập kế hoạch tốt vẫn có thể tạo ra bản vá biên dịch thành công nhưng hoạt động sai.
An ninh mạng phòng thủ
Hồ sơ benchmark bảo mật — khả năng phát hiện mạnh, vá lỗ hổng tốt và khai thác yếu hơn — phù hợp với công việc phòng thủ: quét mã nguồn để tìm các loại lỗ hổng, phân loại kết quả từ công cụ quét, đề xuất bản vá và giải thích rủi ro bằng ngôn ngữ giúp người đánh giá đưa ra hành động. Biến thể cyber của Google được xây dựng cho mục đích này, nhưng quyền truy cập bị giới hạn trong danh sách cho phép thông qua chương trình Fairwind và cần phê duyệt riêng.
Có hai điểm cần lưu ý. Thứ nhất, chỉ thực hiện quy trình bảo mật trên các hệ thống mà bạn có quyền kiểm thử. Thứ hai, hãy xác minh phát hiện trước khi hành động: mô hình có thể báo cáo lỗ hổng với độ tin cậy cao nhưng vẫn sai, còn chi phí của một kết quả dương tính giả là thời gian kỹ thuật bị lãng phí.
Nghiên cứu khoa học và kỹ thuật
Năng lực khoa học được báo cáo có phạm vi cụ thể: chuyển đổi mục tiêu bảo mật thành định lý toán học và tìm kiếm homolog xa trong kho lưu trữ trình tự ở quy mô petabase. Nếu bạn làm việc tại phòng thí nghiệm hoặc nhóm nghiên cứu, cách sử dụng phù hợp là cung cấp cho Carbon một câu hỏi có phạm vi rõ ràng, tài liệu nghiên cứu hoặc chuỗi trình tự liên quan và yêu cầu phân biệt bằng chứng với suy luận.
Tuyên bố về mức tăng 40 lần trong khả năng truy xuất homolog rất đáng chú ý, nhưng chỉ mô tả các họ protein có số lượng homolog thấp trong một quy trình cụ thể. Hãy kiểm chứng bằng benchmark mà nhóm của bạn tin cậy trước khi xây dựng quy trình làm việc dựa trên kết quả này.
Tài chính, pháp lý và đánh giá tài liệu có mức độ quan trọng cao
Thứ hạng về công việc tri thức là lợi thế thương mại nổi bật nhất của Carbon đối với các dịch vụ chuyên nghiệp. Những công việc phù hợp bao gồm đối chiếu sổ cái, phân tích chênh lệch, đánh giá án lệ và hồ sơ pháp lý, cũng như tạo bản ghi nhớ có trích dẫn. Mô hình có thể đọc hình ảnh và PDF, nên tài liệu quét và biểu đồ đều có thể trở thành đầu vào.
Tuy nhiên, điều đó không loại bỏ bước đánh giá của con người. Hãy cung cấp bộ tài liệu nguồn, yêu cầu mô hình trích dẫn đoạn văn làm căn cứ cho từng kết luận và kiểm tra các trích dẫn. Một mô hình có khả năng xử lý một triệu token ngữ cảnh vẫn có thể đọc sai nội dung ở trang 412.
Agent hoạt động dài hạn với công cụ
Carbon hỗ trợ function calling, đầu ra có cấu trúc, thực thi mã, URL context, điều khiển máy tính và nhiều tùy chọn grounding, bao gồm Google Search, Google Maps và các nhà cung cấp dịch vụ tìm kiếm bên thứ ba. Mô hình cũng hỗ trợ hiểu video theo hướng agentic, phù hợp khi đầu vào là bản ghi hình thay vì tài liệu.
Đây là cách sử dụng đòi hỏi nhiều tài nguyên nhất và cũng là cách dễ tiêu tốn token nhất. Hãy trang bị cơ chế giám sát cho agent: ghi nhật ký lời gọi công cụ, giới hạn số vòng lặp và yêu cầu agent tóm tắt những gì đã xác minh trước khi thực hiện hành động. Ngân sách 1M tạo điều kiện xây dựng agent có khả năng xử lý các nhiệm vụ phức tạp; nó không làm cho các agent đó trở nên rẻ hơn.
Đầu vào đa phương thức và các giới hạn
Carbon chấp nhận văn bản, hình ảnh, âm thanh, video, PDF và tài liệu Office, đồng thời trả về văn bản. Các giới hạn khá rộng nhưng có quy định cụ thể, và chúng quan trọng hơn danh sách phương thức đầu vào nổi bật.
| Loại đầu vào | Giới hạn thực tế |
|---|---|
| Âm thanh | Khoảng 8.4 giờ cho mỗi prompt hoặc tối đa 1M token; tối đa 1,000 tệp âm thanh |
| Video | Khoảng 45 phút nếu có âm thanh, khoảng 1 giờ nếu không có âm thanh; tối đa 10 video cho mỗi prompt |
| Hình ảnh và tài liệu | Tổng cộng tối đa 3,000 mục cho mỗi prompt |
| Tài liệu | Tối đa 3,000 trang cho mỗi tệp |
| Định dạng Office | .docx, .doc, .pptx, .ppt, .xlsx, .xls |
| Định dạng OpenDocument | .odt, .odp, .ods |
| Kích thước đầu vào | 500 MiB sau nén trên GenerateContent API; 256 MiB trên Interactions API |
Giới hạn âm thanh là điểm nổi bật. Khả năng xử lý tám giờ âm thanh trong một yêu cầu mở ra nhiều lựa chọn cho các nhóm có lịch họp dày đặc: thay vì chuyển lời nói thành văn bản rồi chia nhỏ thành nhiều phần, bạn có thể gửi bản ghi âm của cả ngày và yêu cầu mô hình tổng hợp chủ đề, quyết định và câu hỏi còn bỏ ngỏ. Chi phí nằm ở token. Token âm thanh được tính phí như token đầu vào, nên việc tải lên bản ghi âm cả ngày không miễn phí.
Giới hạn video gần với nhu cầu làm việc thông thường hơn: 45 phút video có âm thanh đủ cho một bài giảng, bản giới thiệu sản phẩm hoặc cuộc phỏng vấn được ghi hình, nhưng không đủ cho một hội nghị kéo dài cả ngày.
Có một số khoảng trống về tính năng cần được tính đến. Gemini Live API không được hỗ trợ, nên không thể sử dụng giọng nói theo thời gian thực. RAG Engine và tính năng tinh chỉnh mô hình cũng không được hỗ trợ, do đó hệ thống truy xuất và fine-tuning phải được triển khai ở tầng ứng dụng. Caching ngữ cảnh tường minh cũng không được hỗ trợ — chỉ có caching ngầm với mức tối thiểu 4,096 token — điều này ảnh hưởng đến kế hoạch chi phí khi sử dụng các prompt dài lặp lại.
Cách gọi Gemini 4 Carbon trên Felo
Felo đề xuất Messages API làm giao diện sử dụng cho mô hình này. Endpoint chấp nhận cấu trúc yêu cầu tương thích Anthropic tại https://openapi.felo.ai/api/v1/messages, còn model ID là gemini-4-carbon.
Quy trình tương tự như khi sử dụng bất kỳ mô hình Felo nào khác:
- Tạo Felo API key. API key được tạo trong bảng điều khiển Felo và lưu dưới tên biến môi trường
FELO_API_KEY. Không đưa key vào repository hoặc nhật ký hệ thống. - Thử nghiệm trong playground trước. Gemini 4 Carbon playground cho phép bạn thử prompt trước khi viết mã.
- Gửi một yêu cầu nhỏ. Bắt đầu bằng prompt ngắn và xác nhận cấu trúc phản hồi.
- Bật streaming. Đặt
stream: trueđể nhận sự kiện server-sent events. Điều này quan trọng khi một phân đoạn có thể đạt 65,536 token. - Kiểm thử một tác vụ đại diện. Sử dụng kích thước đầu vào thực tế, tiêu chí đánh giá thực tế và ít nhất hai cấp độ tư duy trước khi triển khai quy trình.
Một yêu cầu Python tối giản có dạng như sau:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
Có hai lưu ý khi tích hợp. Thứ nhất, đây là mô hình có khả năng suy luận: hãy giữ lại metadata suy luận được trả về khi tiếp tục cuộc hội thoại, nếu không bạn có thể làm mất ngữ cảnh mà mô hình cần. Thứ hai, max_tokens là giới hạn cho một phân đoạn chứ không phải tổng đầu ra. Với đầu ra dài, hãy sử dụng cơ chế tiếp tục mà SDK cung cấp thay vì tăng con số này và chờ đợi kết quả.
Felo cũng cung cấp tài liệu về các endpoint Chat Completions và Responses tương thích OpenAI dành cho những mô hình hỗ trợ. Vì trang mô hình đề xuất Messages cho Carbon, hãy xác nhận giao diện được hỗ trợ trên trang mô hình trước khi chuyển đổi một ứng dụng khách dựa trên OpenAI.
Chi phí sử dụng Gemini 4 Carbon trên Felo
Felo định tuyến Gemini 4 Carbon thông qua năm nhà cung cấp Google. Cả năm tuyến hiện được niêm yết với mức giảm giá 50%. Bảng dưới đây thể hiện giá cho mỗi 1 triệu token, bao gồm cả giá tiêu chuẩn và giá ưu đãi.
| Tuyến | Đầu vào | Đầu ra | Đọc cache |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
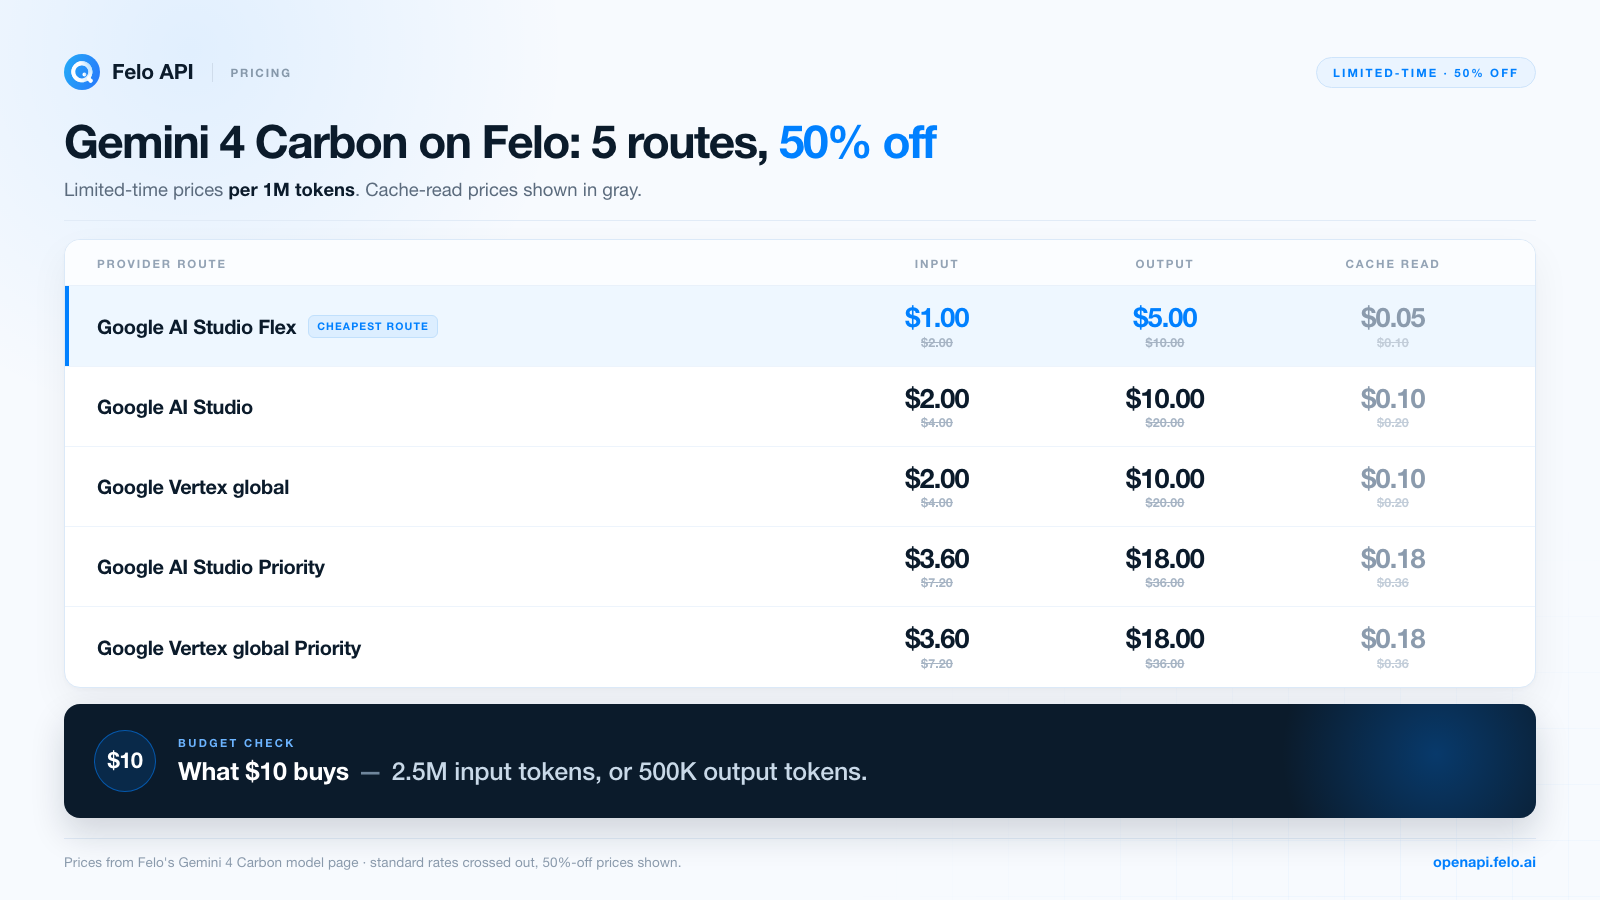
Trang giá của Felo chuyển đổi mức giá tiêu chuẩn thành ví dụ "10 USD mua được gì": khoảng 2.5 triệu token đầu vào hoặc 500,000 token đầu ra, trước khi áp dụng giảm giá. Đây là cách hữu ích để ước tính quy mô cho một dự án thử nghiệm. Một bài kiểm thử gửi các gói tài liệu 100,000 token và nhận câu trả lời 5,000 token có chi phí khoảng $0.13 trên tuyến Flex với giá ưu đãi — $0.10 cho đầu vào và $0.025 cho đầu ra — mức chi phí đủ thấp để thực hiện hàng chục lần thử nghiệm trước khi đưa ra quyết định.
Chương trình dùng thử miễn phí là ưu đãi riêng, không phải một phần của mức giá giảm. Trang mô hình của Felo đánh dấu Gemini 4 Carbon với chương trình dùng thử miễn phí có thời hạn. Đây là cách để thử nghiệm mô hình mà không cần sử dụng tín dụng trả phí. Hãy kiểm tra điều khoản hiện tại trên trang mô hình, vì thời hạn dùng thử và mức giảm giá có thể thay đổi.
Việc lập kế hoạch chi phí cho mô hình này cần thêm một thói quen: thinking token được tính phí theo mức giá đầu ra. Vì vậy, một lần chạy agent ở cấp độ tư duy HIGH có thể tốn chi phí cao gấp nhiều lần so với những gì câu trả lời hiển thị thể hiện. Hãy ghi lại mức sử dụng token cho từng tác vụ, bao gồm cả reasoning token, và so sánh chi phí trên mỗi kết quả được chấp nhận thay vì chi phí trên mỗi yêu cầu.
Hạn chế và những điều cần xác minh trước khi triển khai
Carbon là một mô hình tiên tiến nhưng vẫn có những điểm yếu được ghi nhận. Những vấn đề quan trọng đối với kế hoạch triển khai production bao gồm:
- Ảo giác (Hallucination). Google liệt kê đây là một hạn chế đã biết. Ngữ cảnh dài giúp giảm nguy cơ bỏ sót thông tin nhưng không đảm bảo cách diễn giải chính xác. Quy trình trích dẫn và xác minh vẫn cần thiết.
- Độ trễ và timeout. Google ghi nhận tình trạng phản hồi chậm và lỗi timeout trong một số trường hợp. Các lần chạy ở cấp độ tư duy HIGH với thời gian xử lý dài cần timeout đủ lớn, cơ chế thử lại và xử lý tác vụ theo hướng idempotent.
- Mức tiêu thụ token cao hơn. Mô hình sử dụng nhiều thinking token hơn Argon, đặc biệt ở các cấp độ cao. Hãy phân bổ ngân sách phù hợp và giới hạn mức xử lý cho các tác vụ thông thường.
- Mốc dữ liệu kiến thức tháng 3 năm 2026. Mọi thông tin mới hơn đều cần hệ thống truy xuất hoặc nguồn dữ liệu hiện tại. Carbon không có kiến thức về các sự kiện sau thời điểm này.
- Tham số lấy mẫu cố định. Không thể điều chỉnh temperature, top-p và top-k. Nếu quy trình cần đầu ra có tính xác định, hãy giữ giai đoạn đó trên một mô hình khác.
- Không hỗ trợ caching tường minh, tuning, RAG Engine hoặc Live API. Những tính năng này cần được triển khai ở tầng ứng dụng.
- Giới hạn khả năng truy cập. Google cung cấp Carbon cho khách hàng doanh nghiệp đã xác minh tại một số khu vực; Felo định tuyến mô hình qua các nhà cung cấp toàn cầu, Mỹ và EU. Hãy xác nhận tuyến và điều khoản áp dụng cho trường hợp sử dụng của bạn.
- Quy định an toàn và truy cập. Biến thể cyber chỉ dành cho tài khoản trong danh sách cho phép, còn các quy trình bảo mật phải có sự ủy quyền. Các biện pháp bảo vệ của mô hình và chính sách của nhà cung cấp vẫn có hiệu lực.
Vậy bạn có nên sử dụng Gemini 4 Carbon?
Hãy sử dụng Gemini 4 Carbon khi tác vụ kéo dài, bằng chứng phức tạp và chi phí của một câu trả lời sai ở mức cao: lập kế hoạch di chuyển hệ thống, đánh giá bảo mật, tổng hợp nghiên cứu, phân tích tài chính hoặc pháp lý, hay xây dựng agent cần điều tra trước khi hành động. Hồ sơ benchmark và ngân sách hợp nhất của mô hình được thiết kế cho những loại công việc như vậy.
Không nên sử dụng Carbon làm lựa chọn mặc định cho mọi yêu cầu. Phân loại khối lượng lớn, trích xuất ngắn, tóm tắt đơn giản và các tác vụ cần tham số lấy mẫu có tính xác định phù hợp hơn với những mô hình rẻ và nhanh hơn. Mô hình có chi phí thấp nhất nhưng vẫn đáp ứng tiêu chuẩn chất lượng gần như luôn là lựa chọn phù hợp. Carbon cần chứng minh giá trị của mình trên những phần khó nhất trong khối lượng công việc của bạn.
Tóm lại: Carbon là mô hình mạnh nhất của Google dành cho công việc chuyên sâu, với thế mạnh được đo lường trong lĩnh vực bảo mật, pháp lý, tài chính và suy luận ngữ cảnh dài. Mô hình có chi phí thực tế về độ trễ và token, cùng một số hạn chế đã được ghi nhận khiến việc xác minh trở thành yêu cầu bắt buộc. Hãy thử nghiệm trên các tác vụ của riêng bạn trước khi xây dựng quy trình dựa trên mô hình này.
Câu hỏi thường gặp
Gemini 4 Carbon trên Felo có chương trình dùng thử miễn phí không?
Có. Felo đánh dấu Gemini 4 Carbon với chương trình dùng thử miễn phí có thời hạn. Mức giá từ nhà cung cấp cho mô hình cũng được giảm trong thời gian ưu đãi. Điều khoản có thể thay đổi, vì vậy hãy kiểm tra trang mô hình Gemini 4 Carbon để biết tình trạng cung cấp hiện tại.
Gemini 4 Carbon khác Gemini 4 Argon như thế nào?
Carbon được phát triển dựa trên Argon và tối ưu cho khả năng suy luận chuyên sâu. Mô hình sử dụng ngân sách hợp nhất 1,048,576 token bao gồm đầu vào, quá trình tư duy, lời gọi công cụ và đầu ra; hỗ trợ các cấp độ tư duy LOW, MEDIUM và HIGH; tiêu thụ nhiều thinking token hơn; đồng thời bổ sung hỗ trợ tệp Office/OpenDocument và tăng cường khả năng an toàn, bảo mật. Argon vẫn là lựa chọn phù hợp cho việc tạo nội dung dài khi độ dài đầu ra quan trọng hơn chiều sâu xác minh.
Cửa sổ ngữ cảnh và đầu ra tối đa của Gemini 4 Carbon là bao nhiêu?
Ngân sách hợp nhất là 1,048,576 token, bao gồm cả đầu vào và đầu ra. Một phân đoạn streaming có thể tạo tối đa 65,536 token đầu ra hoặc 32,768 token nếu không streaming. Long decodes cho phép mở rộng đầu ra đến giới hạn ngân sách còn lại. Felo liệt kê đầu ra tối đa 943.718K token trên tuyến của mình.
Gemini 4 Carbon có thể đọc âm thanh, video và tệp Office không?
Có. Mô hình chấp nhận văn bản, hình ảnh, âm thanh, video, PDF và tệp Office/OpenDocument, với giới hạn khoảng 8.4 giờ âm thanh, khoảng 45–60 phút video, tổng cộng 3,000 hình ảnh và tài liệu, cùng 3,000 trang cho mỗi tài liệu. Đầu ra chỉ có văn bản.
Gemini 4 Carbon có hỗ trợ API tương thích OpenAI không?
Felo đề xuất Messages API tương thích Anthropic cho mô hình này. Felo cũng cung cấp tài liệu về các endpoint Chat Completions và Responses tương thích OpenAI dành cho những mô hình được hỗ trợ. Hãy xác nhận giao diện hiện tại trên trang mô hình trước khi viết lại một ứng dụng khách hiện có.
Gemini 4 Carbon có giá bao nhiêu?
Felo liệt kê năm tuyến Google, tất cả đang được giảm giá 50%: AI Studio Flex có giá $1 đầu vào / $5 đầu ra trên mỗi triệu token; các tuyến AI Studio và Vertex tiêu chuẩn có giá $2 / $10; các tuyến Priority có giá $3.60 / $18. Phí đọc cache bắt đầu từ $0.05 trên mỗi triệu token. Xem trang giá của Felo để biết mức giá hiện tại.
Gemini 4 Carbon được phát hành khi nào?
Google công bố Gemini 4 Carbon vào ngày 28 tháng 10 năm 2026, ban đầu dành cho một nhóm chuyên gia phòng thủ an ninh mạng thông qua chương trình Fairwind. Nền tảng doanh nghiệp của Google liệt kê trạng thái phát hành rộng rãi từ ngày 10 tháng 11 năm 2026. Felo hiện định tuyến mô hình qua năm nhà cung cấp Google.
Trải nghiệm Gemini 4 Carbon trên Felo
Cách tốt nhất để đánh giá Carbon là giao cho mô hình một tác vụ mà bạn đã biết câu trả lời. Mở Gemini 4 Carbon playground, dán một tài liệu hoặc đoạn mã thực tế và so sánh cấp độ tư duy LOW với HIGH trên cùng một prompt. Nếu kết quả đáp ứng yêu cầu, hãy tạo API key và chuyển thử nghiệm vào quy trình riêng của bạn.
Bắt đầu tại trang mô hình Gemini 4 Carbon để xem điều khoản dùng thử, các tuyến nhà cung cấp và giới hạn hiện tại — sau đó xây dựng một bài kiểm thử nhỏ nhất có thể cho tác vụ khó nhất mà bạn đang cần giải quyết.
Bài viết này cũng có sẵn bằng English, 简体中文, 日本語, 한국어, 繁體中文, हिन्दी, Français, العربية, Русский, اردو, Bahasa Indonesia, Deutsch, Türkçe, Italiano, ไทย, Español, বাংলা and Português.