AI 文字转视频 用一句话生成完整视频

描述主体、动作、镜头和风格。Felo 会规划分镜、挑选合适的视频模型,并生成可以在同一对话中继续调整的视频——无需拍摄素材、剪辑时间线或剪辑技能。

查看文字转视频示例
时长
2–30 秒
分辨率
480P–2K
画幅
6 种比例
模型
4 个现已可用
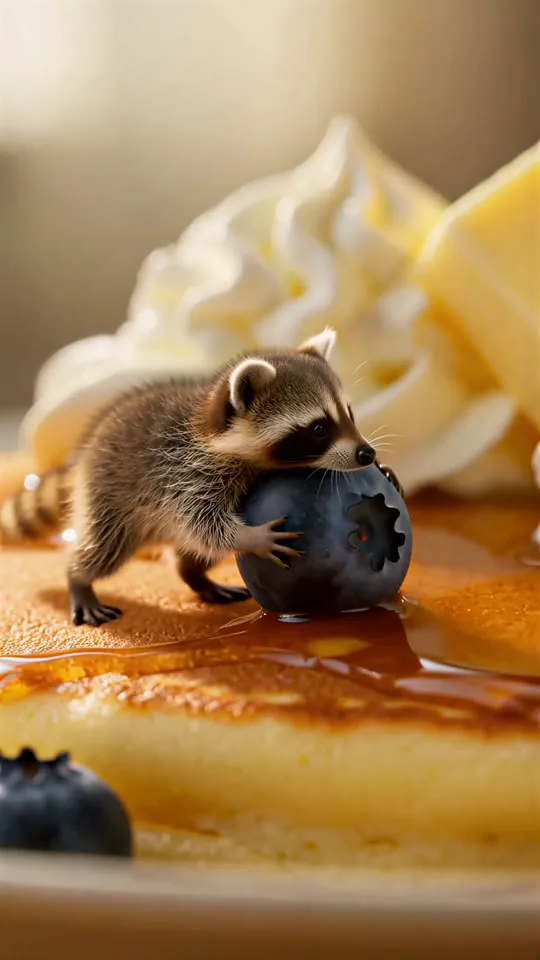
The Pancake Heist9:16 · 6 秒 · 2K · 一条提示词

文字转视频模型目录

Felo 会为每个分镜分配视频模型。MiniMax H3、Seedance 2.5、Wan 3.0 Prime 和 Kling 4.0 现已可用;Gemini Omni Flash 即将上线。你可以在视频设置中自行选择,也可以交给 Agent 决定。

  • MiniMax H3

    现已可用

    基于文字、图片、视频和音频参考生成 2K 短片

    声音: 无声时长: 4–30 秒最高分辨率: 2K

  • Seedance 2.5

    现已可用

    快速、运动感强的短片

    声音: 可生成时长: 4–30 秒最高分辨率: 720P

  • Wan 3.0 Prime

    现已可用

    灵活的生成模式

    声音: 可生成时长: 2–30 秒最高分辨率: 1080P

  • Kling 4.0

    现已可用

    电影感运动与角色一致性

    声音: 无声时长: 3–30 秒最高分辨率: 1080P

  • Gemini Omni Flash

    即将上线

    快速多模态生成

    声音: —时长: —最高分辨率: —

每个模型在时长、分辨率、画幅比例和参考素材上都有各自的限制,选择模型后可在视频设置中查看。

什么是文字转视频 AI?

文字转视频 AI 可以把写好的场景变成会动的视频。你描述画面里有什么、发生什么、镜头怎么运动,模型负责生成画面。Felo 在此基础上增加了 Agent 层:它会把一句话变成分镜清单、选择视频模型并保留上下文,因此你可以在同一对话中继续优化,而不必从头再来。

  • 从文字开始,不需要摄像机、摄制组或剪辑时间线。
  • Agent 规划分镜、镜头运动和节奏。
  • 可选 21:9、16:9、4:3、1:1、3:4 或 9:16。
  • 在同一对话中追问,继续调整。
Phoenix Rising16:9 · 8 秒 · 1080P · 文字转视频 · Kling 4.0
由 Kling 4.0 生成

用文字转视频能做什么

每种用途两条片段,都由 Kling 4.0 根据一段提示词生成。可以复制提示词,或直接填入上方输入框。

9:16 · 5 s · 1080P

Red Coat in Snow提示词1 / 6

Vertical cinematic shot on a quiet narrow street at night with falling snow and warm lantern light. A young woman in a red wool coat walks away from camera, stops, and turns back over her shoulder with a small smile as snowflakes catch in her hair. Slow push-in, consistent face and coat, shallow depth of field, soft bokeh. No readable signs, no text.

如何在 Felo 中使用文字转视频

从写下场景到得到成品,只需三步。

  1. 01

    写下场景

    用一两句话描述主体、动作、镜头和风格。需要的话加上声音。Agent 在规划分镜前还可以联网搜索背景信息。

  2. 02

    让 Agent 规划镜头

    Felo 会生成分镜清单、选择视频模型,并让画幅比例、分辨率和时长贴合你的想法。

  3. 03

    生成、调整并下载

    预览视频,在同一对话中提出修改,然后下载或分享你满意的版本。

如何写文字转视频提示词

好用的提示词读起来像一份镜头说明。覆盖以下五个要素,Agent 就能规划镜头运动和声音。

  1. 01

    主体

    画面里是谁或什么——外观、材质、服装,以及必须保持一致的细节。

  2. 02

    动作

    发生了什么,场景从第一帧到最后一帧如何变化。

  3. 03

    镜头

    景别、角度和运动:推近、跟拍、环绕、拉远。

  4. 04

    风格

    实拍或动画、光线、色调、胶片质感或视觉参考。

  5. 05

    声音

    环境音、音效和音乐。Seedance 2.5 和 Wan 3.0 Prime 会随视频一起生成声音;MiniMax H3 和 Kling 4.0 输出无声视频。

示例提示词
一只拇指大小的浣熊站在巨大的煎饼上,抱着一颗比它脑袋还大的蓝莓。枫糖浆在它的一只前爪下被拉长;它下定决心迈出两步,脚下一滑,划出一道干净的弧线飞进鲜奶油云里。照片级微缩美食喜剧,微距镜头,温暖的早餐光线,轻快的拨弦弦乐。

用 Felo 制作的文字转视频示例

下面每段视频都始于一条文字提示词。播放一条,复制它的提示词,然后改一改主体、风格或画幅比例。

查看完整案例库

The Ring Beyond the Storm

21:9 · 10 s · 2KMiniMax H3

The Pancake Heist

9:16 · 6 s · 2KMiniMax H3

One Last Train

16:9 · 7 s · 768PMiniMax H3

The Cloud Collector

16:9 · 9 s · 768PMiniMax H3

After the Rain

4:3 · 8 s · 768PMiniMax H3

Zero-Gravity Espresso

1:1 · 8 s · 768PMiniMax H3

相关视频工具

按你要做的内容选择对应页面。

要点总结

  • Felo 文字转视频可将一段文字提示词生成 2–30 秒的视频,具体取决于模型。
  • 最高分辨率:MiniMax H3 为 2K,Wan 3.0 Prime 和 Kling 4.0 为 1080P,Seedance 2.5 为 720P。
  • 六种画幅比例覆盖电影感 21:9、横屏 16:9 和竖屏 9:16。
  • Agent 负责规划分镜和选择模型;你可以在同一对话中继续调整。

常见问题

什么是文字转视频 AI 生成器?
文字转视频 AI 生成器可以把写好的描述变成视频。Felo 增加了 Agent 层,负责规划分镜、选择视频模型并保留上下文,因此你可以在同一对话中继续优化视频。
如何用 Felo 把文字变成视频?
在 Felo 视频 Agent 中输入提示词,描述主体、动作、镜头和风格,然后点击生成。Felo 会规划镜头、选择模型,并返回可预览的视频。
文字转视频提示词应该包含什么?
覆盖主体、动作、镜头、风格和声音。一两句话就够了;分镜计划和镜头运动可以交给 Agent 补全。
Felo 的文字转视频使用哪个模型?
MiniMax H3、Seedance 2.5、Wan 3.0 Prime 和 Kling 4.0 现已可用;Gemini Omni Flash 即将上线。Agent 会为每个分镜选择模型,你也可以在视频设置中自行选择。
Felo 文字转视频能生成多长?
时长因模型而异:Wan 3.0 Prime 为 2–30 秒,Kling 4.0 为 3–30 秒,Seedance 2.5 为 4–30 秒,MiniMax H3 为 4–30 秒(1080P 和 2K 下为 4–15 秒)。生成前可以在视频设置中选择时长。
可以用哪些画幅比例和分辨率?
Felo 支持 21:9、16:9、4:3、1:1、3:4 和 9:16,每个模型支持其中一部分。分辨率范围为 480P–2K:MiniMax H3 最高 2K,Wan 3.0 Prime 和 Kling 4.0 最高 1080P,Seedance 2.5 最高 720P。
哪些模型能生成声音?
Seedance 2.5 和 Wan 3.0 Prime 可以随视频一起生成声音。MiniMax H3 和 Kling 4.0 输出无声视频,音乐或音效需要在剪辑软件里添加。
Felo 生成视频后还能编辑吗?
可以。在同一对话中追问,调整镜头、风格或时长,Felo 就会生成新版本,无需从头开始。
可以从图片而不是文字开始吗?
可以。Felo 也支持图片转视频和首尾帧生成。上传参考图并描述它该如何运动即可。
Felo 文字转视频怎么收费?
视频生成会消耗 Felo 积分。消耗量取决于模型、分辨率和时长,生成前视频设置中会显示预估值,实际扣除可能略有出入。各套餐包含的积分可在定价页面查看。

把下一个想法变成视频

用一句话描述,或从示例提示词开始。