判别式 AI:决策模型、示例与应用

了解判别式 AI 和决策模型如何对输入进行分类、路由和评分,它们与生成式 AI 有何区别,以及开发者可以在哪些场景中使用它们。
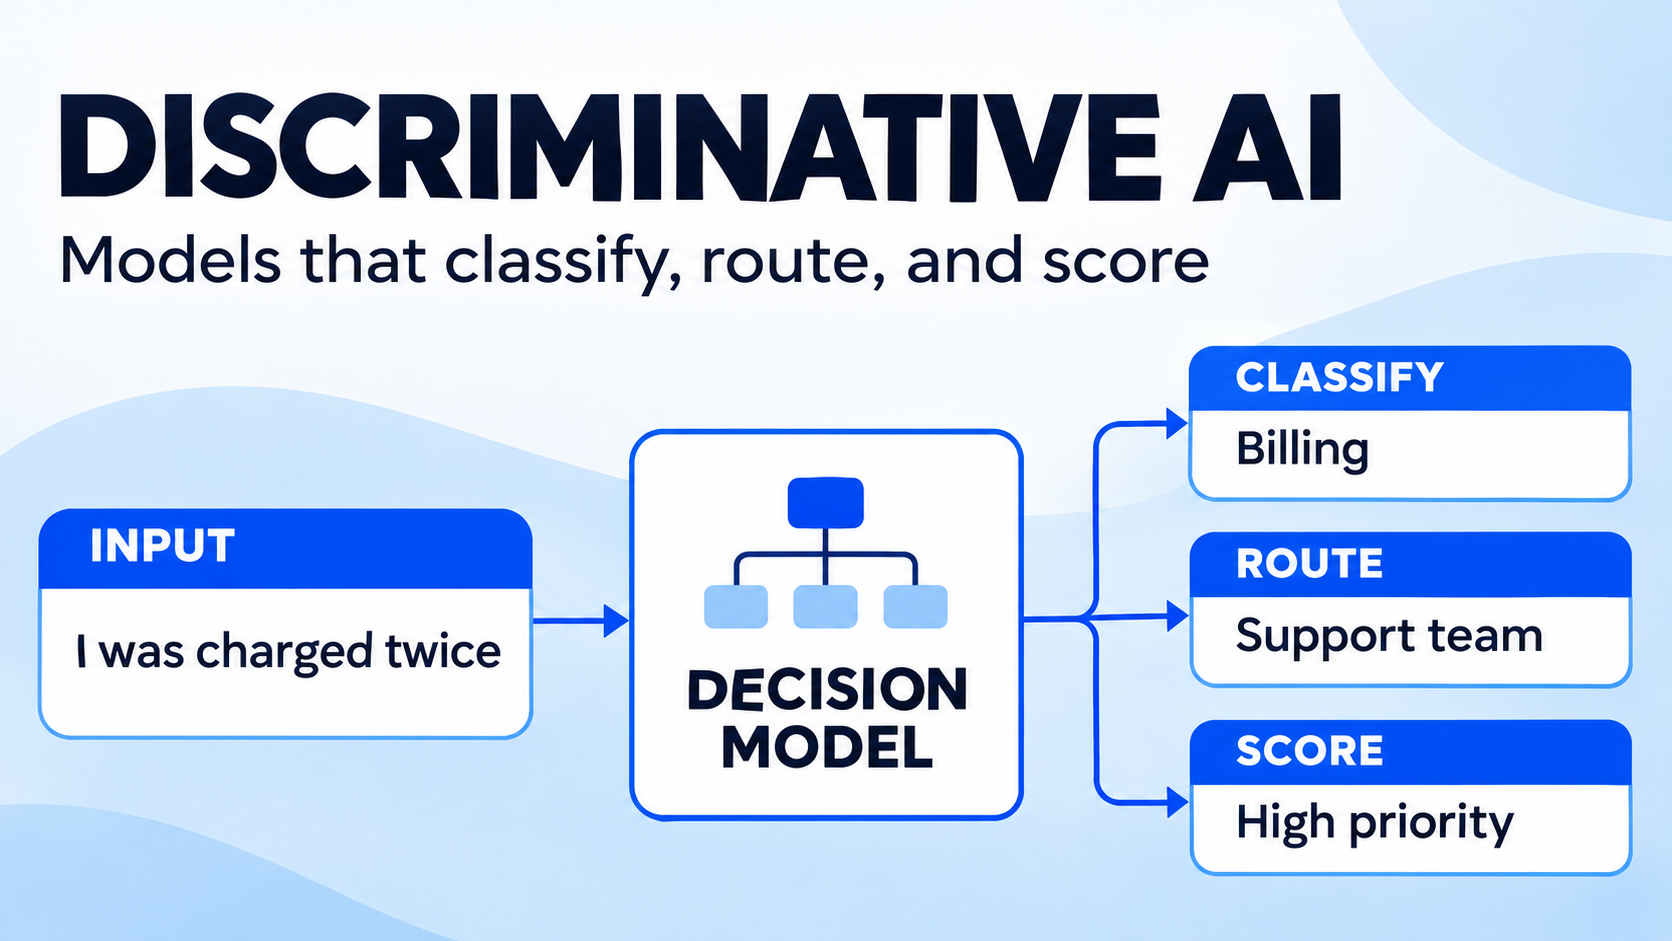
一条客户支持请求进入系统:“我被重复扣费了,需要退款。”你的应用未必需要 AI 模型生成一段文字。它可能首先需要做出一个决定:这张工单应该分配给账单部门、技术支持部门,还是销售部门?
**判别式 AI(Discriminative AI)**旨在根据输入预测标签、分数或其他目标。新一代决策模型将这一理念引入开发者 API:向模型提供上下文和明确的问题,模型便会返回结构化决策或概率结果,供软件使用。本指南将介绍这些模型的工作原理、它们与生成式 AI 的配合方式,以及评估方法。
什么是判别式 AI?
判别式 AI 用于预测输入所对应的结果。例如,垃圾邮件过滤器预测一封电子邮件是否属于垃圾邮件;分类器将客户支持工单分配给某个团队;风险模型则估算特定结果发生的可能性。
在机器学习领域,判别式模型通常学习从输入 x 到目标 y 的映射关系,或估算条件概率 P(y | x)。目标可以是类别、数值或其他结构化输出。逻辑回归、支持向量机和许多神经网络分类器都属于判别式方法。并非所有判别式模型都会返回概率,也并非所有数值评分都经过良好的校准。
这一基本理念早于当今的 AI 助手。较新的发展是通用决策 API 的出现。这类 API 能够接收自然语言形式的任务描述和答案选项,让开发者通过统一接口执行多种分类或评分任务。
什么是 AI 决策模型?
在当前的 API 生态中,**决策模型(Decision Model)**通常指一种专门针对给定输入回答限定问题的模型或服务。它不会生成开放式文本回复,而是返回以下类型的结果:
- 是/否概率: 这条消息包含退款请求的可能性有多大?
- 选项: 这张工单应该分配给哪个部门?
- 评分: 根据既定质量标准,这个答案处于什么水平?
例如,决策模型可能会将某条请求标记为账单问题,并为各个部门提供相应的概率估计。你的应用可以利用这些结果分配工单、请求补充信息,或将工单交给人工审核人员。
TypeSafe 将其 Jev 系列称为“System One”模型。Liquid AI 将其 d1 决策模型描述为一种能够接收文本和图像并返回概率、无需生成输出 token 的模型。Google 关于判别式模型的 Codelab 教程展示了如何在应用中结合使用决策模型和生成式模型。
这些术语彼此相关,但不能互换使用。 判别式建模是一个广泛的机器学习概念;决策模型则是一种用于限定决策的产品或接口。生成式模型也能在提示词的引导下对文本进行分类,只是其底层生成过程和响应格式有所不同。
判别式 AI 与生成式 AI 的区别
| 判别式 AI | 生成式 AI | |
|---|---|---|
| 典型问题 | “哪个类别符合这项输入?” | “应该生成什么回复或内容?” |
| 常见输出 | 标签、预测结果、分数或概率 | 文本、代码、图像、音频或其他生成内容 |
| 示例任务 | 为客户工单分配处理部门 | 为客户起草回复 |
| 值得考察的优势 | 稳定的限定决策和可用的评分结果 | 灵活的内容整合、解释和创作 |
| 主要评估重点 | 分类错误、概率校准和阈值 | 准确性、指令遵循、安全性和实用性 |
这一区别并不意味着一种模型只能执行一种任务。LLM 可以返回 JSON 格式的标签,决策系统也可以在更大的工作流程中使用生成式模型。实际区别在于每个组件经过优化并被设计用于执行什么任务。仅凭结构化 API 响应,无法证明其概率经过校准,也无法证明其底层模型属于判别式模型。
以退款工单为例。决策模型可以识别账单问题并估算紧急程度。随后,生成式模型可以根据相关退款政策起草一份表达理解和关切的回复。在采取行动前,应用仍应检查政策、权限以及所需的人工审批。
决策模型在应用中的工作方式
不同提供商使用的具体 Schema 可能有所不同,但典型的决策请求包含三个部分:
- 状态(State): 需要评估的信息,例如工单文本或图像。
- 问题与标准(Question and Criteria): 需要做出的决策,以及允许的答案或评分等级说明。
- 类型化响应(Typed Response): 返回给应用进行处理的标签、分数或概率分布。
例如:
State: "I was charged twice for my subscription."
Question: Which team should handle this request?
Options: billing, technical support, sales
Illustrative result: billing
这是一个概念示例,并非真实的 API 响应。根据具体端点,模型还可能提供置信度或概率。请遵循特定模型和 API 的文档,不要假设所有提供商都使用相同的请求格式或支持相同的输入模态。
概率分数意味着什么?
只有了解预测概率的可靠性,才能有效使用这些数据。如果系统对许多相似预测都给出 0.8 的概率,那么经过良好校准的系统在这一组案例中的实际正确率应接近 80%。单个 0.8 分数并不能保证某项具体决策正确。
请使用自己的数据检查概率校准情况,尤其是在更换模型、标签、语言或输入来源后。你可以设置阈值,将低置信度案例交由人工审核,但阈值应根据假阳性和假阴性的成本来确定。欺诈审核队列与无害内容推荐需要采用不同的规则。
判别式 AI 的示例与应用场景
客户支持工单分类与路由
决策模型可以将收到的消息分配给账单部门、技术支持部门或账户管理部门。对于含义不明确的请求,应设置“其他”或“需要审核”选项,并测试包含多个问题的消息。评估时应关注各类别的错误率,而不只是整体准确率:如果模型经常漏掉紧急账单投诉,即使数据集以常规问题为主、整体表现良好,也无法说明模型可靠。
内容审核
内容审核工作流程可以要求模型判断内容是否属于某个明确的政策类别。为模型提供清晰的判断标准和示例,评估边界案例,并将不确定或影响重大的案例交给受过培训的审核人员。决策分数只是政策处理流程中的一项输入,并不能证明内容违反了某项规则。
LLM 与智能体路由
在调用 LLM 之前,应用可以根据主题、复杂程度或所需模态对请求进行分类。路由组件随后可以选择相应的工作流程,或请求用户提供更多信息。请将路由环节与下游系统结合起来测试:如果一个低成本的初始步骤总是将复杂请求分配到错误的处理路径,那么它就没有实际价值。
文档与图像分类
多模态决策模型可以判断图像或文档是否属于预定义类别,例如发票、收据或客户支持截图。请确认具体端点支持所需的输入格式和图像处理功能。文档分类与提取文档中的所有字段是不同的任务;请检查所选模型和 API 是否同时支持这两项任务。
评分标准评估
模型可以根据“缺少关键证据”“部分证据支持”和“证据充分”等描述,将回答划分到有序评分等级中。请测试审核人员是否认同这些标签,以及模型对相似答案的评价是否一致。未经验证,不要将评分标准的结果描述为客观测量值。
Felo 模型目录中的决策模型
Felo 模型目录包含一个名为 **Decisions(决策)**的输出筛选器。截至 2026 年 11 月 2 日,目录中的模型示例包括:
| 目录中的模型 | 描述的用途 | 目录显示的输入类型 |
|---|---|---|
| TypeSafe Jev 1.14 | 路由、分类和内容审核 | 文本和图像;目录将图像支持标记为实验性功能 |
| LiquidAI d1.1 | 是/否、选项和评分决策 | 文本和图像 |
| Baseten Joey 1 | 分类和路由 | 文本和图像 |
| Perplexity Decider Flash V1.2 | 分类、路由和评分 | 文本和图像 |
这些描述来自模型目录,并不代表经过独立性能测试,也不构成对某个最佳模型的推荐。模型的可用性、功能支持、上下文限制和定价都可能发生变化。开始开发前,请查看当前目录信息和端点文档,尤其要确认实验性功能或多模态功能的支持情况。模型出现在目录中,并不意味着每个平台都开放了该提供商原生 API 的所有功能。
如何评估 AI 决策模型
从一个范围明确的决策任务和一组带有可信标签的代表性示例开始。测试数据应包含困难案例、少数类别、上下文缺失的案例,以及需要人工接管的案例。然后,将模型与简单基线、现有分类器或采用结构化输出的 LLM 进行比较。
评估指标不应局限于准确率:
- 精确率与召回率: 哪些错误会造成影响?各类别的错误发生频率是多少?
- 概率校准: 在不同案例组中,预测概率是否与实际结果相符?
- 覆盖率: 在设定的阈值下,有多少请求可以由系统自动处理?
- 延迟与可靠性: 完整的 API 调用是否满足生产环境的要求?
- 成本: 每项有效决策的成本是多少?计算时应包括重试、多次提问、图像处理和人工审核。
- 鲁棒性: 在不同语言、格式、陌生示例和流量变化下,模型是否保持稳定表现?
调整标签和阈值后,请使用独立测试集进行评估。在生产环境中,应在适当情况下记录处理结果、检查意见分歧,并在模型版本、政策或输入分布发生变化时重新评估。对于影响重大的决策,应建立有实际意义的人工监督机制,并确认适用的相关要求。
常见问题
判别式 AI 与决策模型是同一种东西吗?
并不完全相同。判别式 AI 描述的是一种广泛的方法,即根据输入预测目标。决策模型则是一个较新的产品类别,专注于选项、分数和概率等限定输出。一些决策模型采用判别式技术,但这两个术语并不代表完全相同的概念。
LLM 能进行分类或做出决策吗?
可以。生成式 LLM 可以通过提示词对内容进行分类,也可以返回结构化输出。专用决策模型是否具有更好的性能、更快的速度或更低的成本,取决于具体任务、模型、提供商和评估方法。请使用自己的示例测试两种方案。
决策模型给出的概率总是准确的吗?
不是。模型在特定数据集或子群体上的概率可能存在校准偏差。在使用阈值实现工作流程自动化之前,请测量概率校准情况,并评估错误决策带来的影响。
什么情况下应该使用生成式 AI?
如果任务需要起草、解释、整合信息或生成开放式内容,应使用生成式模型。对于许多应用,决策模型和生成式模型可以协同工作:前者负责路由或分类,后者负责生成回复。
判别式 AI 为开发者提供了一种将明确且可衡量的决策纳入工作流程的方法。从一项范围明确的任务开始,测试关键错误,并根据证据确定适合的自动化程度。
本文还提供以下语言版本:English、日本語、한국어、繁體中文、हिन्दी、Français、العربية、Русский、اردو、Bahasa Indonesia、Deutsch、Tiếng Việt、Türkçe、Italiano、ไทย、Español、বাংলা、Português。