
Felo API 上的 Gemini 4 Carbon:规格参数、基准测试、定价与应用场景

Felo API 上的 Gemini 4 Carbon:1M 统一 Token 预算、思考等级、多模态限制、官方公布的基准测试成绩、实际价格及调用方法。
Google 的 Gemini 4 Carbon 是一款面向复杂长期任务的模型,适用于无法通过简单处理完成的工作:涉及数十项服务的代码库迁移、需要以可用补丁收尾的漏洞排查,或需要完整证据链而非简单结论的研究问题。
该模型已接入 Felo API。Felo 提供限时免费试用,并推出优惠后的供应商价格。你可以通过 Felo 上的 Gemini 4 Carbon 页面打开模型、在 Playground 中测试提示词并创建 API 密钥,无需等到阅读完本指南。
本文是一份实用指南,而非产品发布公告。内容涵盖 Carbon 的实际定位、它与 Gemini 4 Argon 的区别、官方公布的基准测试成绩及其局限、特殊 Token 预算的运行方式、模型的优势与不足,以及它在 Felo 平台上的价格。
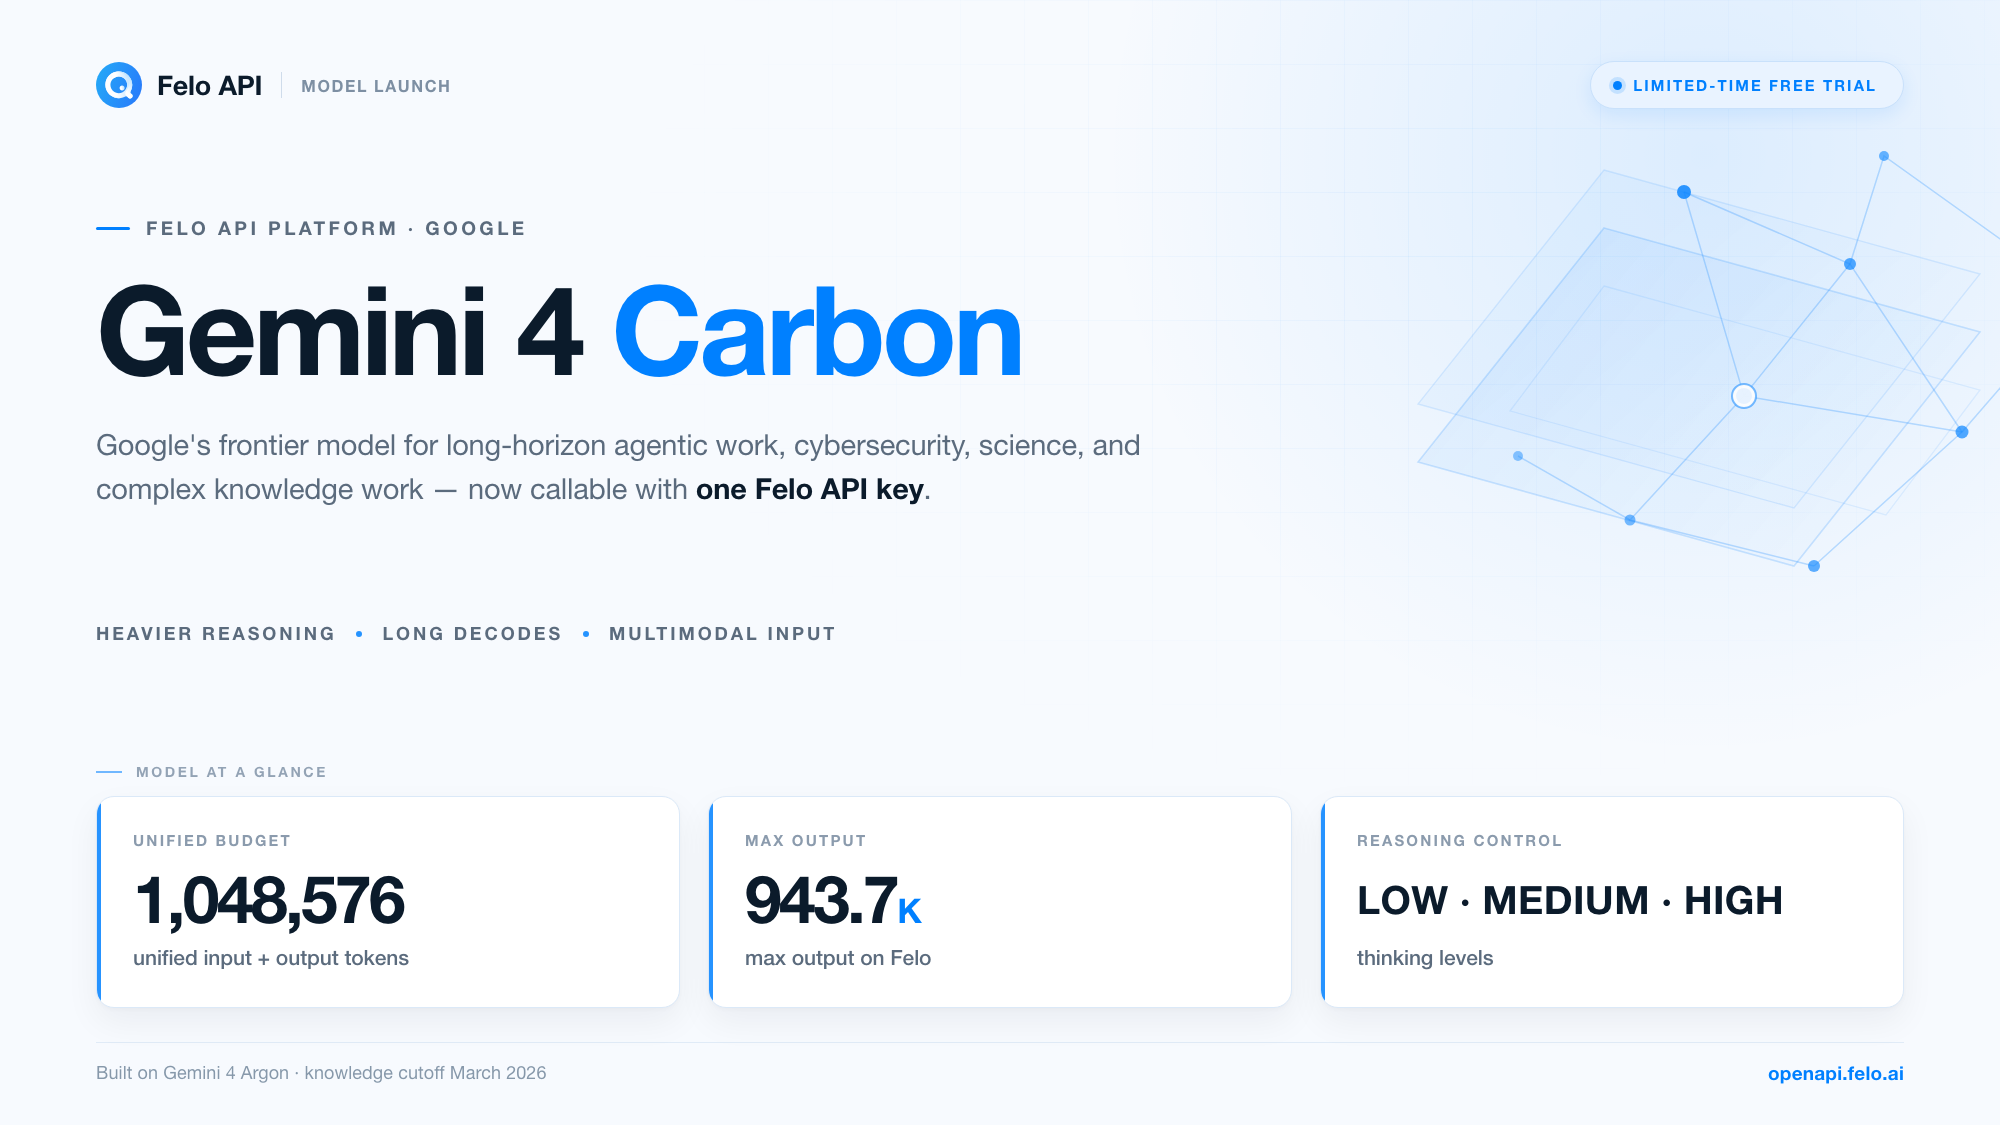
Gemini 4 Carbon 是什么
Gemini 4 Carbon 是 Google 推出的前沿模型,面向编程、金融、法律、网络安全和科学领域的长期智能体任务。Google 于 2026 年 10 月 28 日发布该模型。它基于 Gemini 4 Argon 构建,初期通过 Fairwind Program 向部分网络安全防御人员开放。Google 企业平台文档已将该模型列为正式可用,发布日期为 2026 年 11 月 10 日。
"Carbon" 这个名称并不代表新一代模型,而是代表 Gemini 4 系列中的一种不同运行模式。Argon 的调优方向是通过单次生成轨迹输出篇幅较长、逻辑连贯的文档,而 Carbon 将更多预算用于思考,包括探索假设、执行验证循环和协调多步骤任务。Google 表示,Carbon 为得出答案所使用的思考 Token 数量高于 Argon。
这种设计也有代价。Carbon 处理困难任务时速度较慢,在某些条件下可能出现超时问题,而且较高的思考等级会消耗更多 Token。Google 已将这些限制列为明确的已知问题。选择 Carbon 的理由在于,它所面向的工作——安全分析、大型代码迁移、科学推理和高风险文档审查——更看重深度,而非速度。
模型规格一览
| 规格 | 数值 |
|---|---|
| Felo 上的模型 ID | gemini-4-carbon |
| 发布日期 | 2026 年 10 月 28 日 |
| 基础模型 | Gemini 4 Argon |
| 上下文与输出 | 1,048,576 Token 的统一预算,涵盖输入和输出 |
| Felo 标注的最大输出 | 943.718K Token |
| 输入 | 文本、图像、音频、视频、PDF 和 Office/OpenDocument 文件 |
| 输出 | 文本 |
| 思考等级 | LOW、MEDIUM(默认)、HIGH |
| 知识截止日期 | 2026 年 3 月 |
| 采样参数 | Temperature 1.0、top-p 0.95、top-k 64,固定值 |
| 缓存 | 仅支持隐式缓存,最低 4,096 Token |
| Felo 推荐接口 | Messages API(兼容 Anthropic) |
| 访问权限 | 部分地区的经过验证的企业客户;网络安全变体仅限白名单用户 |
表格中的两个细节值得单独说明,因为它们会影响模型集成方式:统一 Token 预算和思考等级。
Gemini 4 Carbon 与 Gemini 4 Argon 有什么区别
Carbon 和 Argon 同属一个模型系列,拥有相同的知识截止日期,定位也有不少重叠。两者的区别主要体现在模型如何分配计算能力。
统一输入与输出预算。 Argon 通常采用 1,048,576 Token 的上下文窗口,以及独立的 65,536 Token 默认输出额度。Carbon 的 1,048,576 Token 则同时涵盖输入、思考、工具调用和最终答案。这是一笔统一预算,而不是上下文窗口加独立输出额度。
默认侧重深度推理。 Carbon 支持 LOW、MEDIUM 和 HIGH 三种思考等级。gemini-4-carbon 默认使用 MEDIUM,而网络安全宽松变体默认使用 HIGH。该模型专为长时间验证循环设计,因此 Google 将更高的 Token 消耗列为已知限制,而非程序错误。
长文本解码。 流式传输时,单个前台生成片段最多输出 65,536 Token;非流式传输时,单个片段最多输出 32,768 Token。借助长文本解码机制,可以突破单个片段的限制。Google Gen AI SDK 和 Agent Studio 会自动管理续接 Token,也可以通过自定义续接循环实现。理论上的输出上限是统一预算减去输入所占用的 Token。
更丰富的文件支持。 除 PDF 和纯文本外,Carbon 还支持 Microsoft Office 和 OpenDocument 文件,包括 .docx、.doc、.pptx、.ppt、.xlsx、.xls、.odt、.odp 和 .ods。文件可以直接内嵌,也可以从云存储读取。如果工作流程从演示文稿、电子表格或合同开始,而非纯文本导出文件,这项功能就很有价值。
安全调优与独立网络安全变体。 Google 表示,在真实代码环境中,高严重性失准警报减少了近 80%;在文本到文本安全评估中,Carbon 的多语言和多模态内容安全表现比 Argon 高出 3.50 个百分点。此外,Google 还提供 gemini-4-carbon-cyber-permissive,这是面向防御性安全工作的白名单专用变体,默认使用 HIGH 思考等级,并移除了计算机使用功能。
面向科学研究的特殊能力。 Google 表示,该模型能够将安全目标转换为数学定理,并在 PB 级序列档案中自主发现远缘同源序列。对于低同源蛋白质家族,同源序列检索量平均提升了 40 倍。这是一项针对特定研究任务的有限声明。与其将其视为通用能力,不如在自己的数据上复现测试结果。
统一 Token 预算详解
大多数模型页面会提供两个数字:上下文窗口和最大输出长度。Carbon 只提供一个总预算,并设有单个生成片段的限制。如果沿用传统模型的请求规划方式,就可能高估可用空间,或误读实际账单。
Token 预算由以下部分组成:
- 输入(Input)——提示词、附件文档、图像、音频、视频帧和此前的对话内容。
- 思考(Thinking)——模型在回答前消耗的推理 Token。HIGH 等级下,这部分开销可能很大。
- 工具调用(Tool calls)——启用工具后,模型执行的所有工具调用。
- 最终答案(Final answer)——你实际收到的文本。
以上四项共享 1,048,576 Token 的总预算。输入已经占用 900K Token 的请求,不会剩下 1M Token 用于输出,而是只剩约 148K Token,供思考、工具调用和答案共同使用,续接生成还会进一步消耗预算。
单个生成片段的限制是另一项独立规则。流式请求的单个片段最多输出 65,536 Token;非流式请求最多输出 32,768 Token。长文本解码可以在片段边界后继续生成,直到统一预算耗尽。如果你的集成将 max_tokens 理解为总输出承诺,这种理解并不正确:它限制的是单个片段,SDK 的续接处理机制才是生成长文档的关键。
Felo 的模型页面标注了 943.718K Token 的最大输出。应将其理解为 Felo 路由上的输出上限,而不是一个更大的独立上下文窗口。在统一预算机制下,答案的实际可用空间取决于输入内容占用的 Token 数量。
这项设计带来的规划原则很简单:先确定输出规模,再根据剩余空间安排输入。 对于长篇报告,应预留输出和思考预算,再调整源材料的规模。对于大型文档集分析,应接受答案长度可能短于输入,并提前规划续接生成或分阶段提示词。
思考等级:模型质量的来源
Carbon 提供三个思考等级:LOW、MEDIUM 和 HIGH。默认等级为 MEDIUM。Google 文档明确指出,设置 thinking_budget 或 thinking_level="MINIMAL" 会触发验证错误,因此无法将推理消耗调至零。
不同等级带来的实际差异十分明显。LOW 模式下,模型更接近响应速度较快的前沿聊天模型,适合信息提取、分类、改写和常规代码审查。MEDIUM 模式会将更多 Token 用于规划和自我检查。HIGH 模式会执行更长的验证循环,更有机会发现隐蔽错误,但也最容易出现响应延迟和成本上升。
以下几条经验值得参考:
- 根据错误答案的代价选择等级。 如果错误容易发现和修复,使用 LOW。如果错误可能进入生产环境或正式申报材料,应测试 HIGH。
- 衡量每个合格结果的 Token 成本,而非每次请求的 Token 成本。 更高的思考等级可能减少重试和返工,也可能让 MEDIUM 本可完成的任务产生数倍费用。应比较完整工作流程的成本。
- 不要假设基准测试使用的设置适用于你的任务。 Google 公布的主要测试数据并不总会注明思考等级。正式接入前,应使用自己的任务在两个等级下进行测试。
采样参数固定为 temperature 1.0、top-p 0.95 和 top-k 64,自定义数值会被忽略。如果你的工作流程依赖低温度带来的确定性输出,Carbon 就不适合承担该环节。可以将它用于判断和综合分析,并将确定性步骤交给支持采样参数控制的其他模型。
Google 公布的基准测试:成绩与实际意义
Felo 的模型页面汇总了 Carbon 的供应商公布基准测试结果。以下对比仅供参考:数据来自 Google 或评测机构,未经本文独立复现,反映的是特定测试条件,而非你的实际工作负载。
| 评测项目 | 衡量内容 | Gemini 4 Carbon | 说明 |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | 综合推理指数 | 59 | 排名第一;Claude Opus 5.5 为 58 |
| SEC-bench Pro | 漏洞发现 | 88.2% | 网络安全、防御性扫描 |
| CWE-bench | 漏洞修补 | 71.0% | 网络安全、漏洞修复 |
| ExploitGym | 漏洞利用 | 54.8% | 安全研究、受控环境 |
| Terminal-Bench 4.0 | 成功作弊率 | 0.0% | 抵抗奖励操纵的能力,而非模型能力评分 |
| Vals Index | 知识工作综合评估 | 70.45% | 36 个模型中排名第 3 |
| Legal Research Bench | 法律研究 | 55.77% | 排名第 1 |
| General Financial Intelligence | 金融任务 | #1 | 根据 Balyasny Asset Management 的评测,在 23 种前沿模型配置中排名第一 |
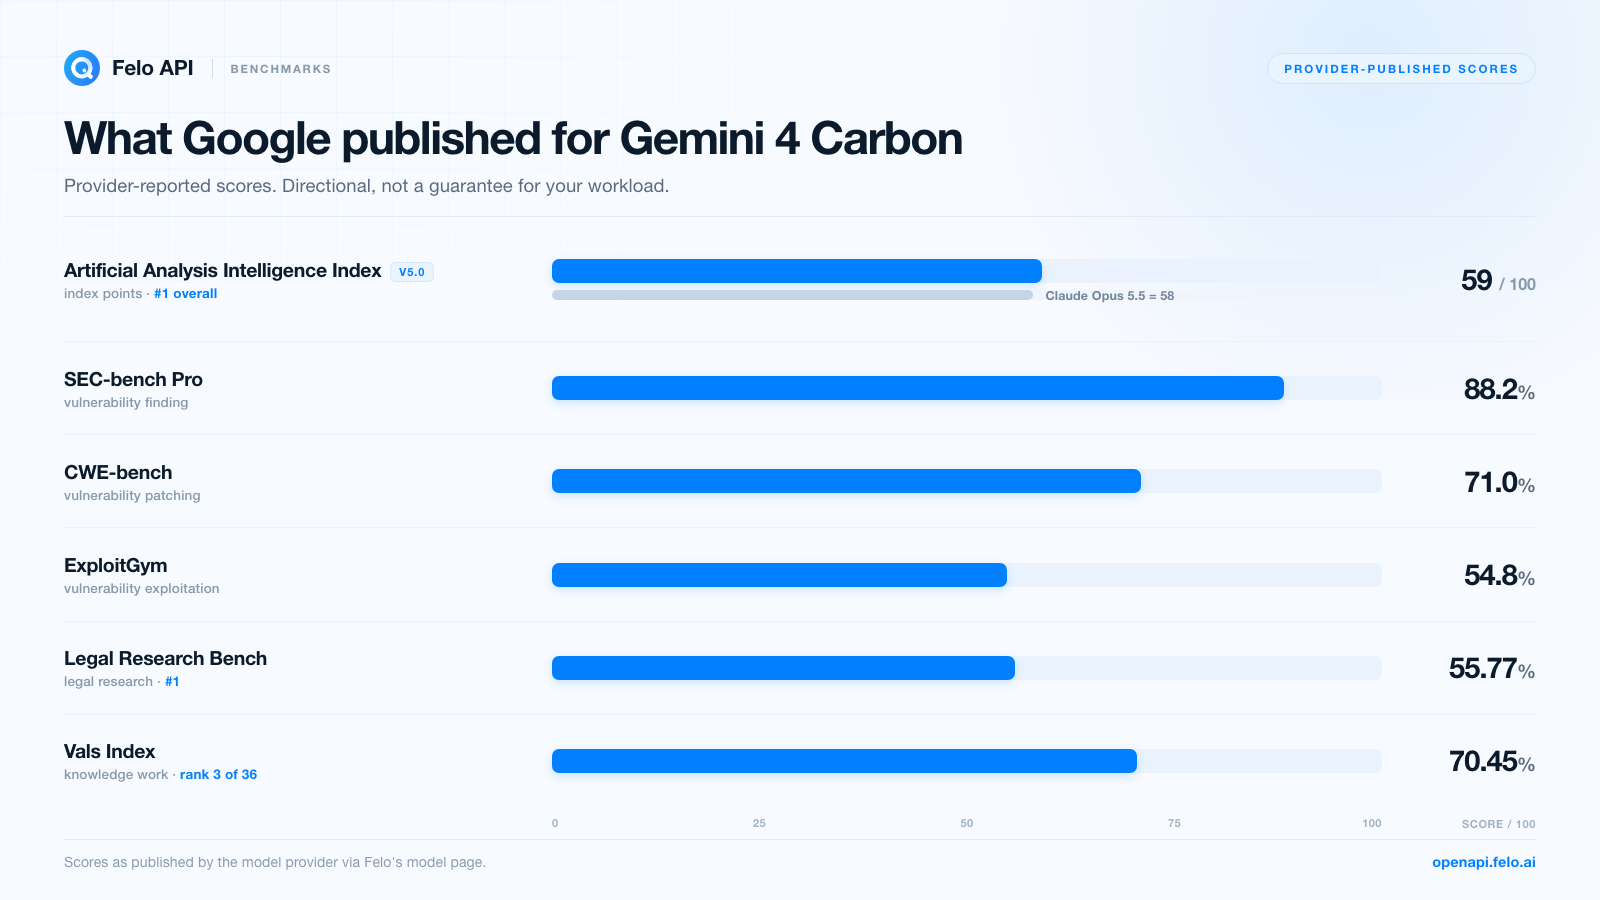
仔细阅读表格,可以发现三个值得关注的方面。
网络安全成绩体现的是完整漏洞处理流程,而非单一技能。 发现漏洞、编写补丁和利用漏洞属于不同能力。Carbon 公布的成绩在漏洞发现方面最强(SEC-bench Pro 为 88.2%),在漏洞利用方面较弱(ExploitGym 为 54.8%),漏洞修补成绩居中(CWE-bench 为 71.0%)。如果你的工作属于防御领域,包括扫描、分类和修复,这组成绩符合需求。如果需要自主执行漏洞利用,成绩就相对较低,访问权限也更严格。
作弊率指标衡量的是可信度,而非智能水平。 Terminal-Bench 4.0 的"成功作弊率"用于判断模型是否通过操纵基准测试来获取奖励,而非真正完成任务。0.0% 的成绩代表模型具有抵抗奖励操纵的能力。在允许智能体无人值守运行时,这项指标很重要。但它不是模型能力评分,不应与表格中其他项目的正确率百分比进行比较。
知识工作排名对大多数团队更有参考价值。 Vals Index 的 36 个模型中排名第 3、Legal Research Bench 排名第一,以及 Balyasny 金融评测中的领先成绩,体现了前沿模型适合承担的专业工作:阅读大量材料、协调相互冲突的证据,并生成供专业人员审查的成果。这些结果也容易受到提示词设计和信息源质量的影响,因此应将其视为开展测试的理由,而不是跳过测试的依据。
还有一点需要注意:Artificial Analysis 指数属于综合评分。Carbon 领先 Claude Opus 5.5 一分,这种差距很容易因任务组合变化而逆转。在你关注的具体任务上,两款模型可能存在明显差距,领先方向也可能不同。
Gemini 4 Carbon 的实际应用场景
基准测试是一张地图,而非真实环境。以下工作负载与 Carbon 的设计方向高度契合。
大型代码工程与迁移
Carbon 面向需要多智能体协作、日常调试、大型代码库迁移和算法设计的工程任务。统一预算在这些场景中很有帮助:你可以在一次请求中提交代码仓库结构图、相关源文件、失败测试输出和迁移要求,然后要求模型在修改代码前制定计划。
适合这类模型的提示词示例:
阅读附件中的代码仓库结构图和三个服务模块。找出替换会话接口后受到影响的所有调用位置,列出兼容性风险,并提出迁移顺序。暂时不要编写代码。标记所有无法通过所提供文件验证的信息。
先要求模型制定计划。审查计划后,再允许模型运行测试。差异代码审查应由人工完成——即使模型擅长制定计划,生成的补丁也可能通过编译,却存在行为错误。
防御性网络安全
网络安全基准测试表现——漏洞发现能力强、修补能力较好、漏洞利用能力较弱——与防御性工作高度契合,包括扫描代码库中的漏洞类型、分类扫描器输出、提出修补方案,以及向审查人员解释风险。Google 的网络安全变体专为这类任务设计,但访问权限通过 Fairwind Program 白名单管理,需要单独审批。
需要注意两点。第一,只能针对你获得授权测试的系统执行安全工作流程。第二,采取行动前必须验证发现结果:即使模型以很高的置信度报告漏洞,也可能出现误判,而误报会浪费工程时间。
科学与技术研究
Google 报告的科学研究能力有明确范围:将安全目标转换为数学定理,以及在 PB 级序列档案中搜索远缘同源序列。如果你在实验室或研究团队工作,可以向 Carbon 提供范围明确的问题、相关文献或序列,并要求它区分证据与推断。
40 倍的同源序列检索提升是一项引人注目的结果,但它针对特定工作流程中的低同源蛋白质家族。在围绕该能力构建工作流程前,应使用团队认可的基准进行复现。
金融、法律与高风险文档审查
知识工作排名是 Carbon 在专业服务领域的主要优势。典型任务包括账簿核对、差异分析、判例和监管文件审查,以及生成带有引用的备忘录。该模型能够读取图像和 PDF,因此扫描文档和图表也可以作为输入。
但这并不意味着可以省略人工审查。向模型提供源材料,要求它为每项结论引用对应段落,并核对所有引用。即使模型能够处理一百万 Token 的上下文,也可能误读第 412 页的内容。
配备工具的长期运行智能体
Carbon 支持函数调用、结构化输出、代码执行、URL 上下文、计算机使用,以及多种信息依据功能,包括 Google Search、Google Maps 和第三方搜索服务。它还支持智能体式视频理解,适用于输入内容为录像而非文档的场景。
这是对模型要求最高、也最容易消耗大量 Token 的使用方式。应为智能体配置监控机制:记录工具调用、限制迭代次数,并要求智能体在采取行动前总结已经验证的内容。1M Token 预算让复杂智能体成为可能,但不代表运行成本低廉。
多模态输入及其限制
Carbon 接受文本、图像、音频、视频、PDF 和 Office 文档,并以文本形式输出。各类输入的限制较宽松,但都有明确上限,其重要性高于简单的多模态支持列表。
| 输入类型 | 实际限制 |
|---|---|
| 音频 | 每个提示词约 8.4 小时,或最多 1M Token;最多 1,000 个音频文件 |
| 视频 | 带音频约 45 分钟,不带音频约 1 小时;每个提示词最多 10 个视频 |
| 图像和文档 | 每个提示词合计最多 3,000 个 |
| 文档 | 每个文件最多 3,000 页 |
| Office 格式 | .docx、.doc、.pptx、.ppt、.xlsx、.xls |
| OpenDocument 格式 | .odt、.odp、.ods |
| 输入大小 | GenerateContent API 支持压缩后 500 MiB;Interactions API 支持 256 MiB |
音频限制最值得关注。单次请求处理八小时音频,会改变会议密集型团队的工作方式:无需先转录再分段,可以提交一整天的通话录音,并要求模型总结主题、决策和待解决问题。代价是 Token 消耗。音频 Token 按输入 Token 计费,因此上传全天录音并非免费。
视频的限制更接近日常工作需求:45 分钟的带音频视频足以处理讲座、产品演示或录制的访谈,但无法覆盖整场会议。
还有一些功能缺口需要纳入规划。Gemini Live API 不受支持,因此无法实现实时语音交互。RAG Engine 和模型调优也不受支持,检索和微调工作需要放在应用层完成。显式上下文缓存同样不受支持,只有最低 4,096 Token 的隐式缓存。这些限制会影响重复提交长提示词时的成本规划。
如何通过 Felo 调用 Gemini 4 Carbon
Felo 将 Messages API 列为该模型的推荐接口。该接口在 https://openapi.felo.ai/api/v1/messages 接受兼容 Anthropic 的请求格式,模型 ID 为 gemini-4-carbon。
调用流程与其他 Felo 模型相同:
- 创建 Felo API 密钥。 在 Felo 控制台创建密钥,并将其保存为
FELO_API_KEY。不要将密钥提交到代码仓库,也不要将其写入日志。 - 先在 Playground 中测试。 Gemini 4 Carbon Playground 支持在编写代码前测试提示词。
- 发送一个小型请求。 从简短提示词开始,确认响应格式。
- 启用流式传输。 设置
stream: true,以使用服务器发送事件(SSE)。当单个生成片段可能达到 65,536 Token 时,这项设置很重要。 - 测试有代表性的任务。 使用真实输入规模和评估标准,并在至少两个思考等级下完成测试,再决定是否接入工作流程。
一个最简 Python 请求示例如下:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
还有两项集成注意事项。第一,该模型具备推理能力:继续对话时,应保留返回的推理元数据,否则模型可能丢失所需上下文。第二,max_tokens 限制的是单个生成片段,而非总输出长度。对于长文本输出,应使用 SDK 提供的续接机制,而不是单纯提高参数值并寄希望于完整输出。
Felo 还为支持相关功能的模型提供兼容 OpenAI 的 Chat Completions 和 Responses 接口文档。由于 Carbon 的模型页面推荐使用 Messages 接口,在改造基于 OpenAI 的客户端前,应先查看模型页面,确认支持的接口类型。
Gemini 4 Carbon 在 Felo 上的价格
Felo 通过五条 Google 供应商路线提供 Gemini 4 Carbon,所有路线均标注 50% 折扣。以下价格均按每 100 万 Token 计算,同时列出标准价格和优惠价格。
| 路线 | 输入 | 输出 | 缓存读取 |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
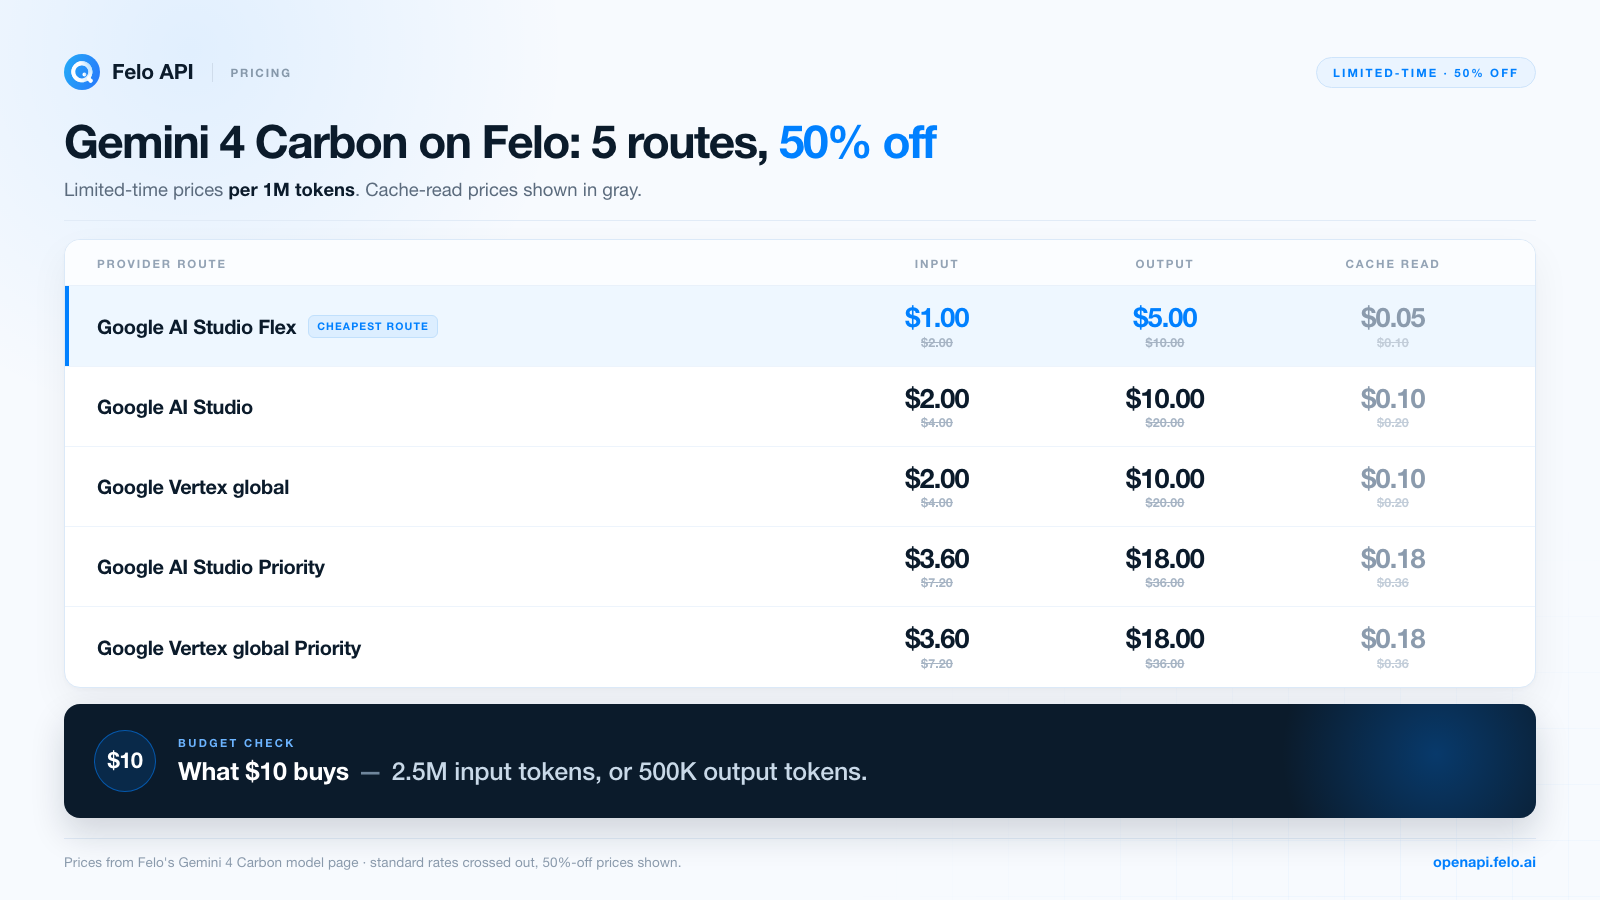
Felo 的定价页面将标准价格换算为"$10 可以购买什么":约 250 万输入 Token,或 50 万输出 Token,未计入折扣。这种方式适合估算概念验证项目的成本。例如,一次测试发送包含 100,000 Token 的文档集合,并接收 5,000 Token 的答案,在 Flex 优惠路线上的费用约为 $0.13,其中输入费用为 $0.10,输出费用为 $0.025。这个成本足以支持数十次测试,再决定是否正式采用。
免费试用与价格折扣是两项独立优惠。Felo 的模型页面为 Gemini 4 Carbon 标注了限时免费试用,这是无需消耗账户额度即可测试模型的便捷方式。由于试用资格和价格折扣均有时间限制,可能发生变化,请查看模型页面上的当前条款。
使用该模型进行成本规划,还需要养成一项额外习惯。思考 Token 按输出价格计费,因此 HIGH 思考等级下的智能体运行费用,可能达到可见答案所显示成本的数倍。应记录每项任务的 Token 使用情况,包括推理 Token,并比较每个合格结果的成本,而非每次请求的成本。
正式接入前需要了解的限制
Carbon 是一款前沿模型,但也存在已记录的弱点。以下问题对生产环境规划影响较大:
- 幻觉。 Google 将幻觉列为已知限制。长上下文能够降低遗漏信息的概率,但无法保证解释正确。引用与验证流程仍然不可缺少。
- 延迟与超时。 Google 提到模型偶尔会出现响应缓慢和超时问题。长时间的 HIGH 思考任务需要设置充足的超时时间、重试机制和幂等任务处理。
- Token 消耗较高。 与 Argon 相比,Carbon 使用更多思考 Token,较高思考等级下尤为明显。应预留相应预算,并限制常规任务的计算投入。
- 知识截止日期为 2026 年 3 月。 更新日期之后的信息需要通过检索或当前信息源获取。Carbon 不掌握该日期之后发生的事件。
- 采样参数固定。 Temperature、top-p 和 top-k 均无法调整。如果工作流程需要确定性输出,应将该环节交给其他模型。
- 不支持显式缓存、模型调优、RAG Engine 或 Live API。 这些功能对应的工作需要转移到应用层处理。
- 访问限制。 Google 向部分地区经过验证的企业客户开放 Carbon;Felo 通过全球、美国和欧盟供应商提供该模型。应确认适用于自身使用场景的路线和条款。
- 安全与访问规则。 网络安全变体采用白名单机制,安全工作流程必须获得授权。模型的安全防护机制和供应商政策仍然适用。
那么,是否值得使用 Gemini 4 Carbon?
当任务周期较长、证据复杂且错误答案代价高昂时,可以选择 Gemini 4 Carbon。例如迁移计划、安全审查、研究综合分析、金融或法律分析,以及需要调查后才能采取行动的智能体。它的基准测试表现和统一预算正是为这类工作设计的。
不要将它作为所有请求的默认模型。高频分类、短文本提取、简单摘要,以及需要确定性采样的任务,更适合成本更低、速度更快的模型。只要能够达到质量标准,价格最低的模型通常就是最佳选择。Carbon 应通过最困难的工作负载证明自身价值。
客观来看:Carbon 是 Google 面向深度工作的高能力模型,在网络安全、法律、金融和长上下文推理方面展现出经过测试的优势,但也伴随延迟和 Token 成本,并存在必须认真验证的已知限制。在围绕它构建工作流程前,应先使用自己的任务进行测试。
常见问题
Felo 上的 Gemini 4 Carbon 是否提供免费试用?
是的。Felo 为 Gemini 4 Carbon 提供限时免费试用,在优惠期内,该模型的供应商价格也享有折扣。优惠条款可能变化,请查看 Gemini 4 Carbon 模型页面,了解当前试用资格。
Gemini 4 Carbon 与 Gemini 4 Argon 有什么区别?
Carbon 基于 Argon 构建,调优方向是更深层次的推理。它使用 1,048,576 Token 的统一预算,涵盖输入、思考、工具调用和输出;支持 LOW、MEDIUM 和 HIGH 三种思考等级;消耗更多思考 Token;增加 Office/OpenDocument 文件支持,并强化安全能力和网络安全定位。Argon 更适合重视输出长度而非验证深度的长篇内容生成任务。
Gemini 4 Carbon 的上下文窗口和最大输出是多少?
统一预算为 1,048,576 Token,输入和输出共同占用这笔预算。单个流式生成片段最多输出 65,536 Token,非流式生成最多输出 32,768 Token。长文本解码可以在剩余预算范围内继续生成。Felo 标注的该路线最大输出为 943.718K Token。
Gemini 4 Carbon 能否读取音频、视频和 Office 文件?
可以。它支持文本、图像、音频、视频、PDF 和 Office/OpenDocument 文件。限制包括约 8.4 小时音频、约 45–60 分钟视频、图像与文档合计 3,000 个,以及每份文档最多 3,000 页。输出仅支持文本。
Gemini 4 Carbon 是否支持兼容 OpenAI 的 API?
Felo 推荐使用兼容 Anthropic 的 Messages API 调用该模型,同时也为受支持的模型提供兼容 OpenAI 的 Chat Completions 和 Responses 接口文档。在改造现有客户端前,应通过模型页面确认当前支持的接口类型。
Gemini 4 Carbon 的价格是多少?
Felo 提供五条 Google 路线,所有路线均享受 50% 折扣:AI Studio Flex 的输入价格为每百万 Token $1,输出价格为 $5;标准 AI Studio 和 Vertex 路线为 $2 / $10;Priority 路线为 $3.60 / $18。缓存读取价格低至每百万 Token $0.05。实时价格请查看 Felo 定价页面。
Gemini 4 Carbon 是什么时候发布的?
Google 于 2026 年 10 月 28 日宣布推出 Gemini 4 Carbon,初期通过 Fairwind Program 向部分网络安全防御人员开放。Google 企业平台将 2026 年 11 月 10 日列为正式可用日期。Felo 已通过五条 Google 供应商路线提供该模型。
在 Felo 上试用 Gemini 4 Carbon
评估 Carbon 的最快方式,是给它一个你已经知道答案的任务。打开 Gemini 4 Carbon Playground,粘贴真实文档或代码示例,并使用相同提示词对比 LOW 和 HIGH 两种思考等级。如果结果符合预期,就创建 API 密钥,将测试接入自己的工作流程。
从 Gemini 4 Carbon 模型页面开始,查看当前试用条款、供应商路线和使用限制,然后围绕你实际面临的最困难任务,构建一个规模最小的测试项目。
本文还提供以下语言版本:English、日本語、한국어、繁體中文、हिन्दी、Français、العربية、Русский、اردو、Bahasa Indonesia、Deutsch、Tiếng Việt、Türkçe、Italiano、ไทย、Español、বাংলা、Português。