
Felo 上的 GPT Image 2.6:将 GIF 转换为视频镜头

Felo 上的 GPT Image 2.6:制作循环 GIF,通过 API 构建动作帧,再使用 Kling 将其转换为动画。包含代码示例和使用限制。
当你要求视频模型生成“一名挥剑的骑士”时,得到的挥剑动作通常只能算勉强符合要求。剑刃会变得模糊,人物身体比例在不同帧之间发生变化,摄像机还会自行添加没人要求的运镜效果。
导演通过场面调度解决这个问题:角色站在哪里、哪个动作先发生,以及动作在哪里结束。Felo 上的 GPT Image 2.6 可以在浏览器中将这份动作方案制作成 1.8 秒的循环 GIF,也可以通过图像 API 生成 3 × 3 帧图。无论哪种方式,成本都低于先支付视频模型费用,再让它完成布光、构图和配乐后才确定动作。
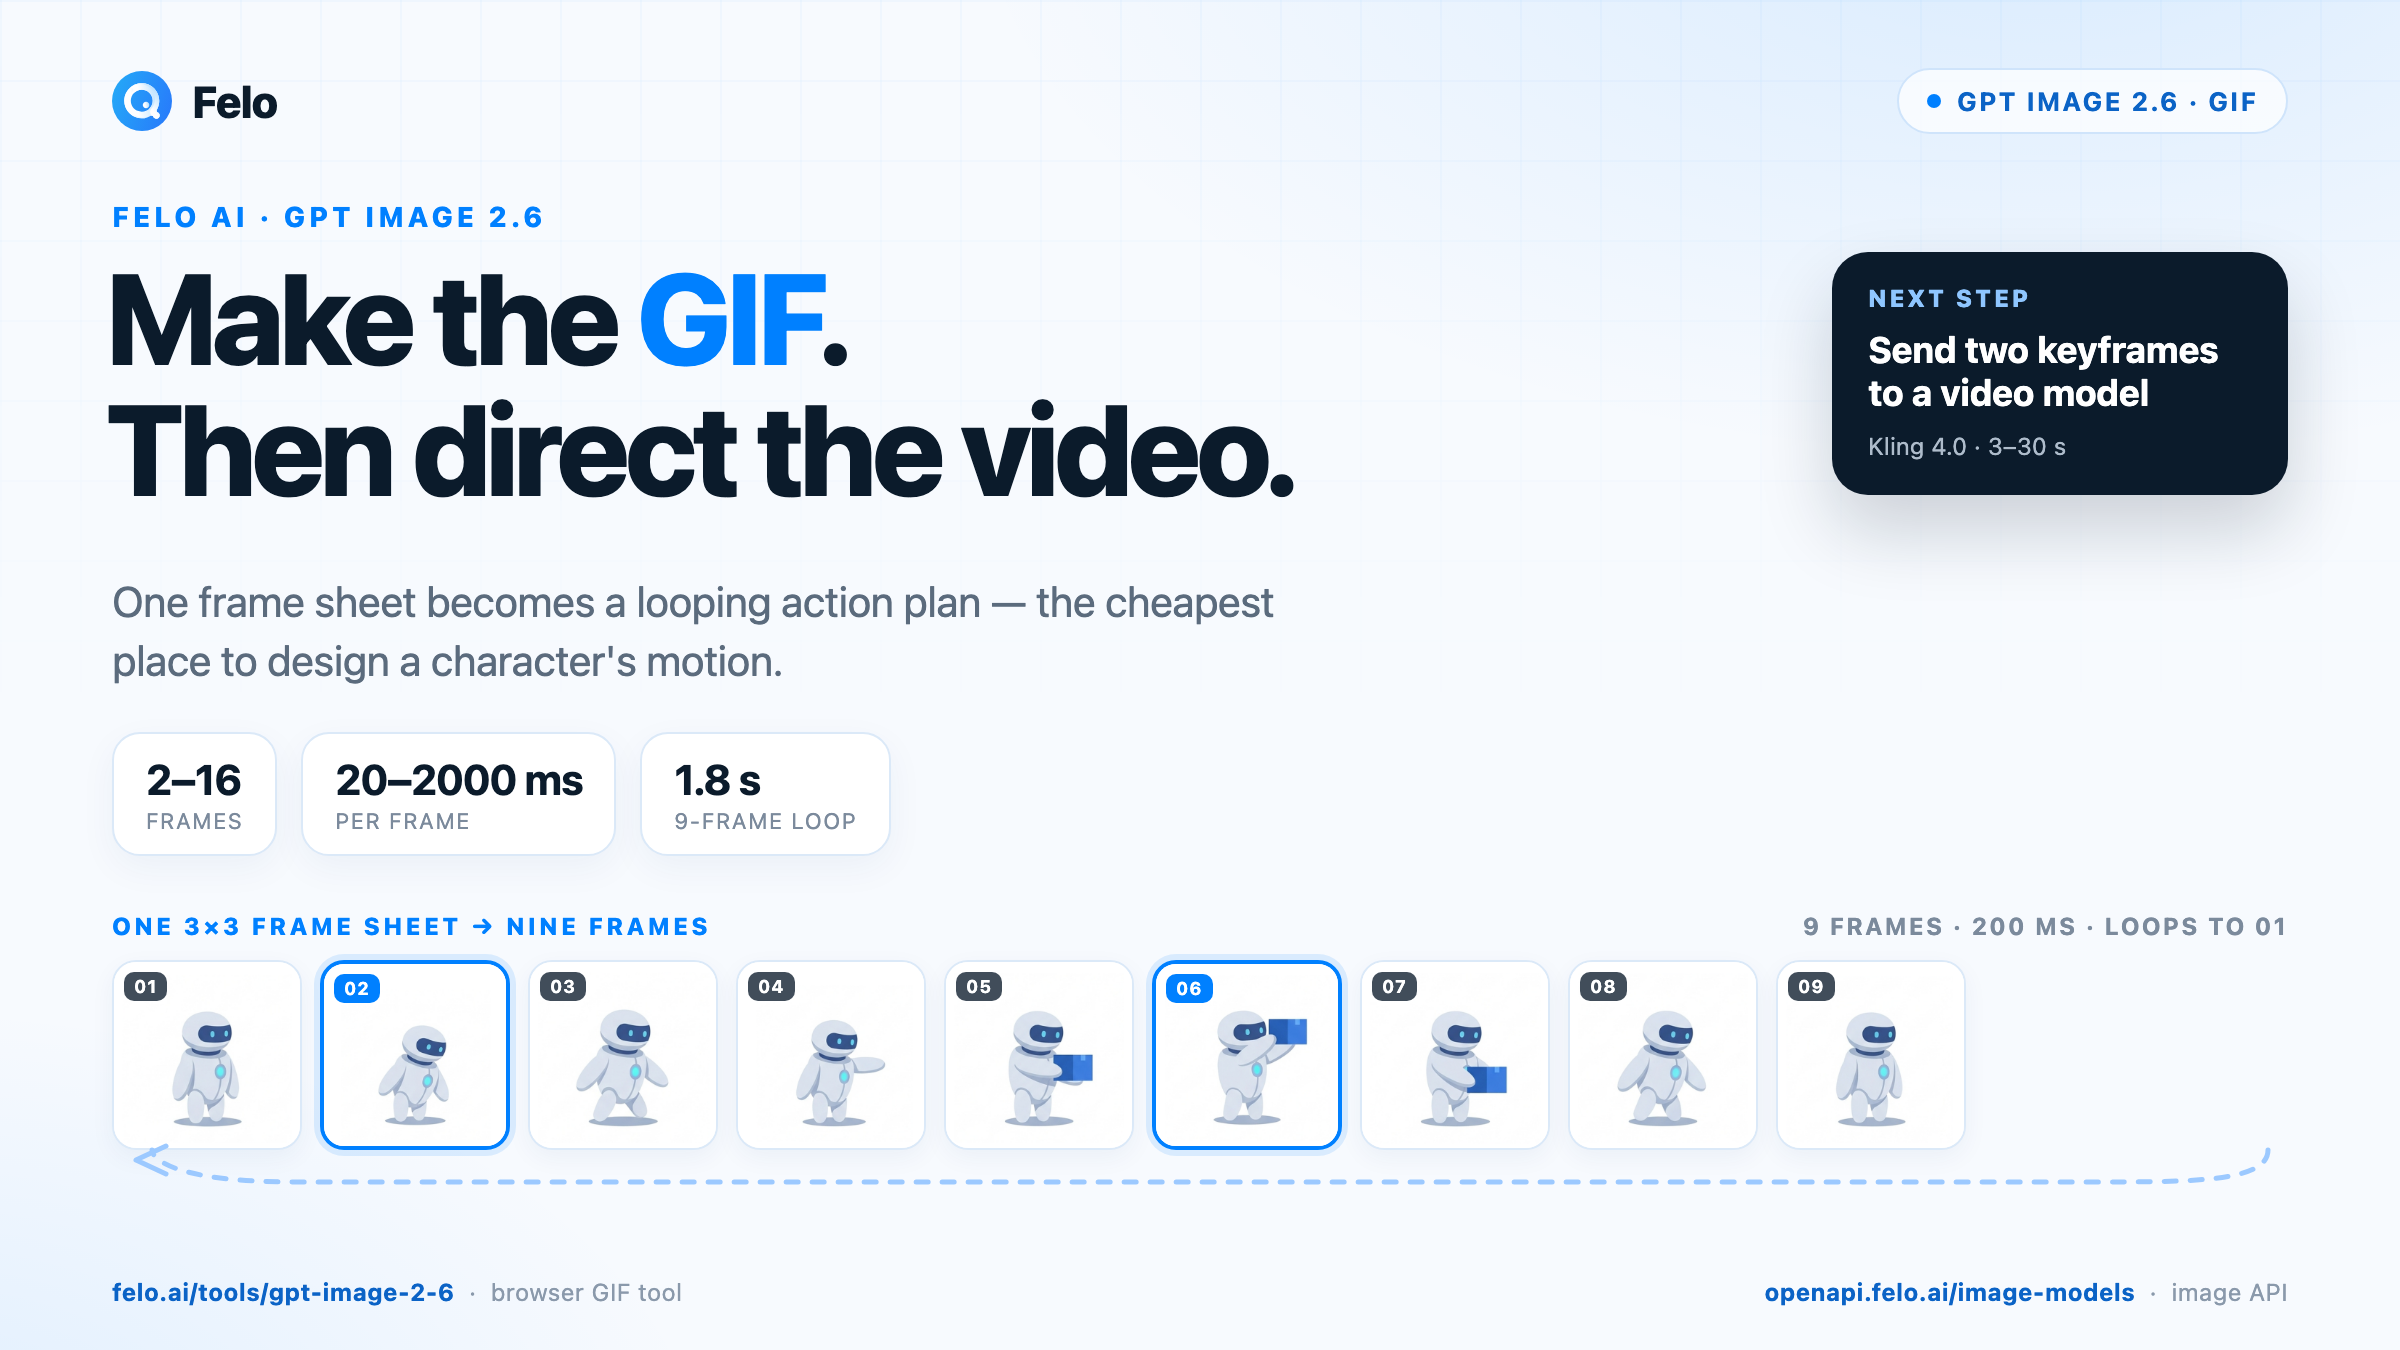
在 Felo 上使用 GPT Image 2.6 的两种方式
浏览器端:AI GIF 生成器
打开 felo.ai/tools/gpt-image-2-6,描述图像内容并选择模型。输入框默认使用 GPT Image 2.6 Flare 模型,输出格式为 PNG。若要制作动画,请打开设置并选择 GIF。仅在提示词中写入“GIF”不会改变输出格式。
GIF 控件采用精简设计:支持 2 至 16 帧,每帧时长为 20 至 2000 毫秒,初始帧尺寸为 512 × 512。Felo 默认生成 9 帧,每帧 200 毫秒,最终形成一个 1.8 秒的循环动画。这个时长确实很短,但足以判断一个动作是否清晰易懂。
你可以上传参考图、提出编辑要求,也可以使用草图控件标记特定区域。首次测试动作时,建议使用单个主体、纯色背景和一个简单动作。
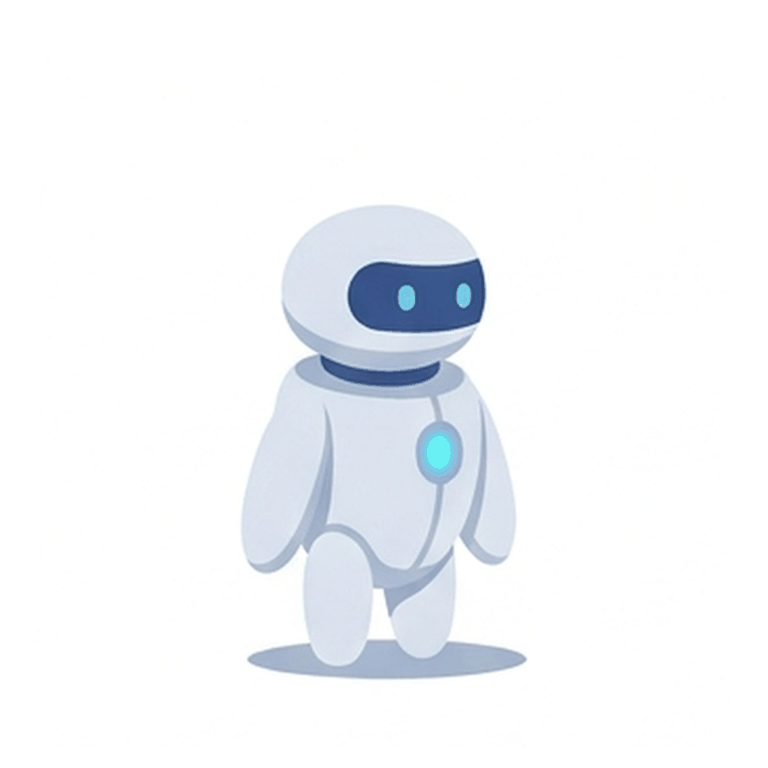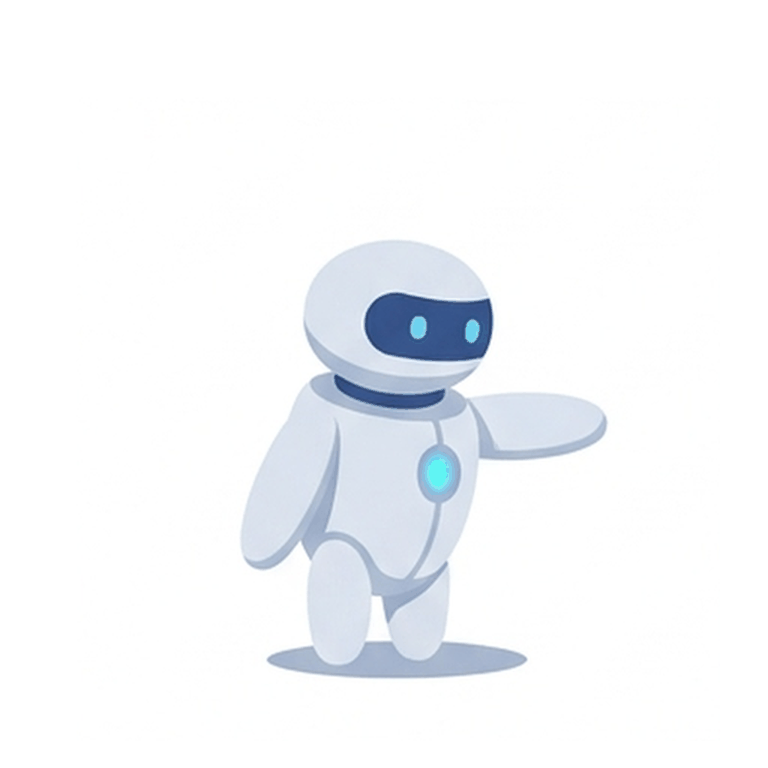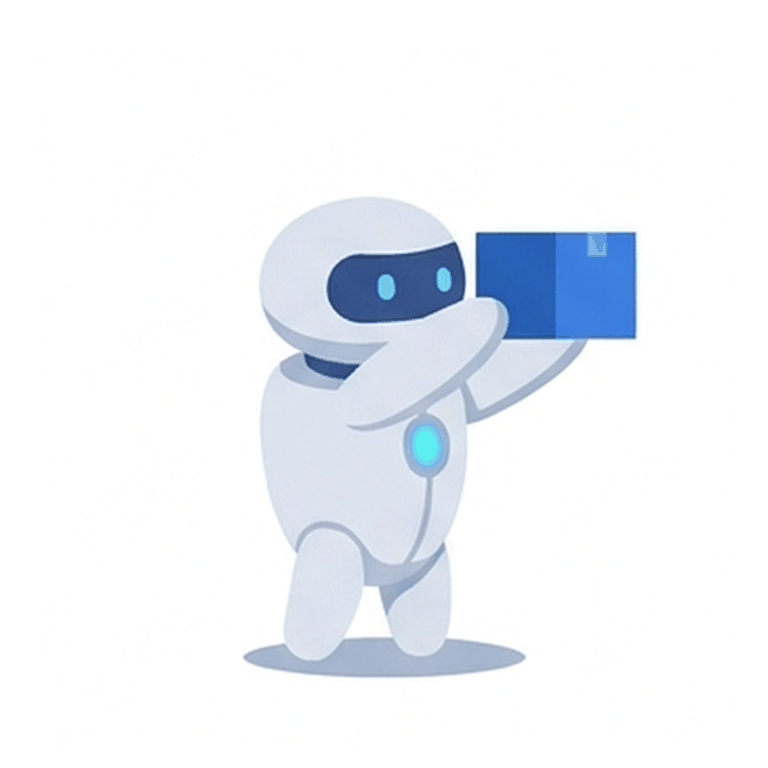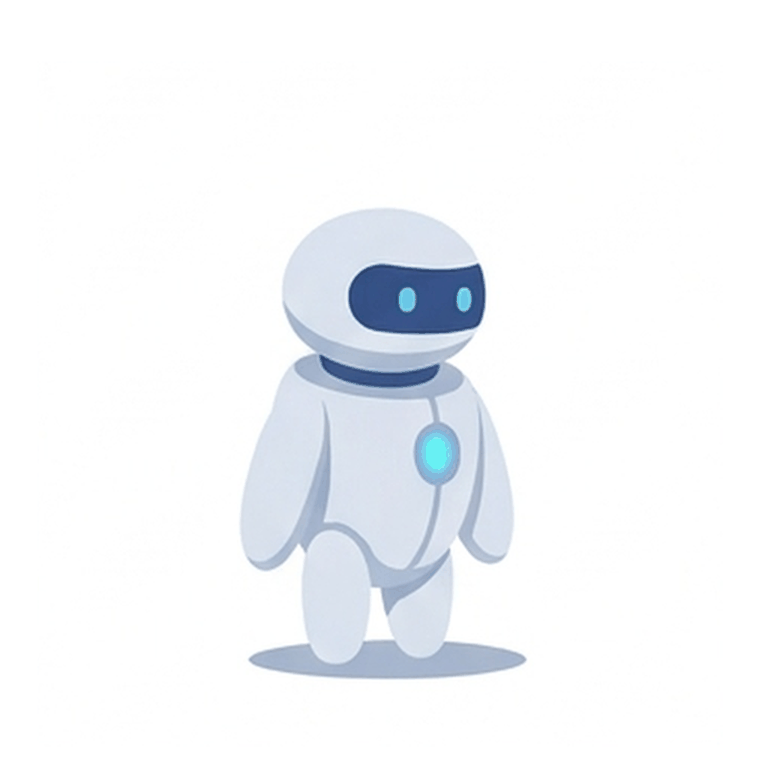
输出效果示意:一个由 9 帧组成、每帧 200 毫秒的循环动画。浏览器工具可以直接生成 GIF;下文的智能体工作流程则通过一张 3 × 3 帧图构建相同的帧序列。
通过 API 使用:面向智能体和应用程序
相同的两个模型也可以在 Felo 的图像模型目录中找到,对应的模型 ID 分别为 gpt-image-2.6-flare 和 gpt-image-2.6-sunburst。一个密钥可以调用来自 8 家提供商的 18 个图像模型,因此智能体无需分别注册不同提供商的账户,就能比较或切换模型。
| GPT Image 2.6 Flare | GPT Image 2.6 Sunburst | |
|---|---|---|
| 设计用途 | 快速草稿和频繁修改 | 精细图像和精准编辑 |
| 模型 ID | gpt-image-2.6-flare | gpt-image-2.6-sunburst |
| 输入 / 输出 | 文本、图像 → 图像 | 文本、图像 → 图像 |
| 适用场景 | 快速探索动作创意 | 保持不同画面中的角色一致性 |
| 标示价格 | 每 1M 输入 tokens 收费 $5,每 1M 输出 tokens 收费 $30 | 每 1M 输入 tokens 收费 $5,每 1M 输出 tokens 收费 $30 |
价格按 token 计算,而不是按图像计算,因此分辨率和参考图都会影响费用。两个模型页面都显示限时免费试用标识;在规划生产任务前,请核实当前条款和费率。
浏览器可以输出 GIF,而图像 API 返回静态图像。这些模型的 output_format 枚举值为 png、jpeg 或 webp,因此智能体需要使用生成的帧自行构建 GIF。下方的 API 部分会展示具体实现方式。
为什么 GIF 比视频提示词更适合作为初稿
视频模型本质上是插值引擎。它们擅长填充两个状态之间的内容,却不擅长判断哪些状态值得保留。文本提示词只给模型一句需要理解的描述,而九帧 GIF 则明确规定了九个关于姿势、轮廓和时间节奏的决定。
九帧预算也会迫使你作出选择。每帧 200 毫秒的情况下,没有空间容纳含糊的“动态动作场景”。你必须明确描述:准备姿势、蓄力、出击、动作延续、恢复原位。视频提示词效果不佳,通常是因为创作者从未明确作出这些决定。
循环效果还带来第二个限制。要让 GIF 实现无缝循环,角色必须回到起始姿势。这也让镜头更容易编辑。如果角色手臂最终停在一个新位置,下一个镜头的起始身体姿势就会发生变化。
你还可以在几秒内检查整个动画。观察角色轮廓、双手、道具,以及最后一帧与第一帧之间的衔接。智能体可以比较不同帧,也可以让视觉模型描述画面变化,完成这些检查后再决定是否支付视频生成费用。
Felo 的工具页面明确说明:“GIF 是无声循环动画。如果需要声音、长场景或多个镜头,请使用视频工具。”这句话正是整个工作流程的起点,而不是终点。
在浏览器中构建动作
下面介绍一种实用的循环流程,用于在角色动作成为视频镜头前完成设计。
1. 先固定角色形象
不要从动画开始。先生成一张角色静态参考图,采用正面视角、自然站立姿势和纯色背景。开始制作动画时,提示词中的所有细节都必须保持一致:发型、服装颜色、配饰、武器和身体比例。不同批次的生成结果容易出现一致性偏差,因此描述越具体,模型在帧与帧之间需要自行补充的内容就越少。
2. 将动作写成循环,而不是场景
一个实用的动作提示词包含四个部分:
- 设置场景。画面中有哪些元素、角色站在哪里、外观是什么样。
- 指定一个动作。什么部位发生移动,以及动作顺序是什么。
- 固定不变的元素。摄像机、双脚、标志和双手。
- 要求回到起点。以返回初始姿势的方式结束动作。
例如:
一名穿着芥末黄色夹克的快递员站在浅色石板街道上,侧面视角,全身入镜,摄像机固定。角色调整身体重心,将手伸进邮差包,取出一个蓝色小包裹,并将其向前举起。保持夹克、邮差包和摄像机不动。随后放下包裹,恢复初始姿势。让动作形成流畅循环。背景简洁,不包含文字。
这个提示词刻意保持简单。在这里,简单是优点:一个清晰的动作足以在 512 × 512 的画面和九帧预算中呈现。人群、雨景和运镜效果可以留给视频模型处理。
3. 在设置中选择 GIF,从简单参数开始
设置分辨率为 512 × 512、帧数为 9、每帧时长为 200 毫秒,然后生成动画。在基本动作清晰之前,不要增加帧数。
如果循环效果不理想,请按以下顺序调整:先减少帧数并简化动作,再延长每帧时长,最后补充需要保持一致的细节。
4. 检查首尾衔接,而不只是中间画面
连续观看循环动画两遍。最后一帧与第一帧之间的衔接是大多数问题出现的位置:肩膀位置突然跳变、道具换手,或者背景发生位移。
随后每次只调整一个变量。新的姿势创意意味着新的提示词。时间节奏调整意味着修改帧数或单帧时长。同时修改两者,就无法判断哪项调整带来了改善。
从 GIF 到视频:两种交接方式
Felo 的视频 API 不支持动画 GIF 输入。它接受静态图像或视频,因此交接前需要增加一个格式转换步骤。以下两种方式都很实用,第三种方式则保留 GIF 作为最终交付成果。
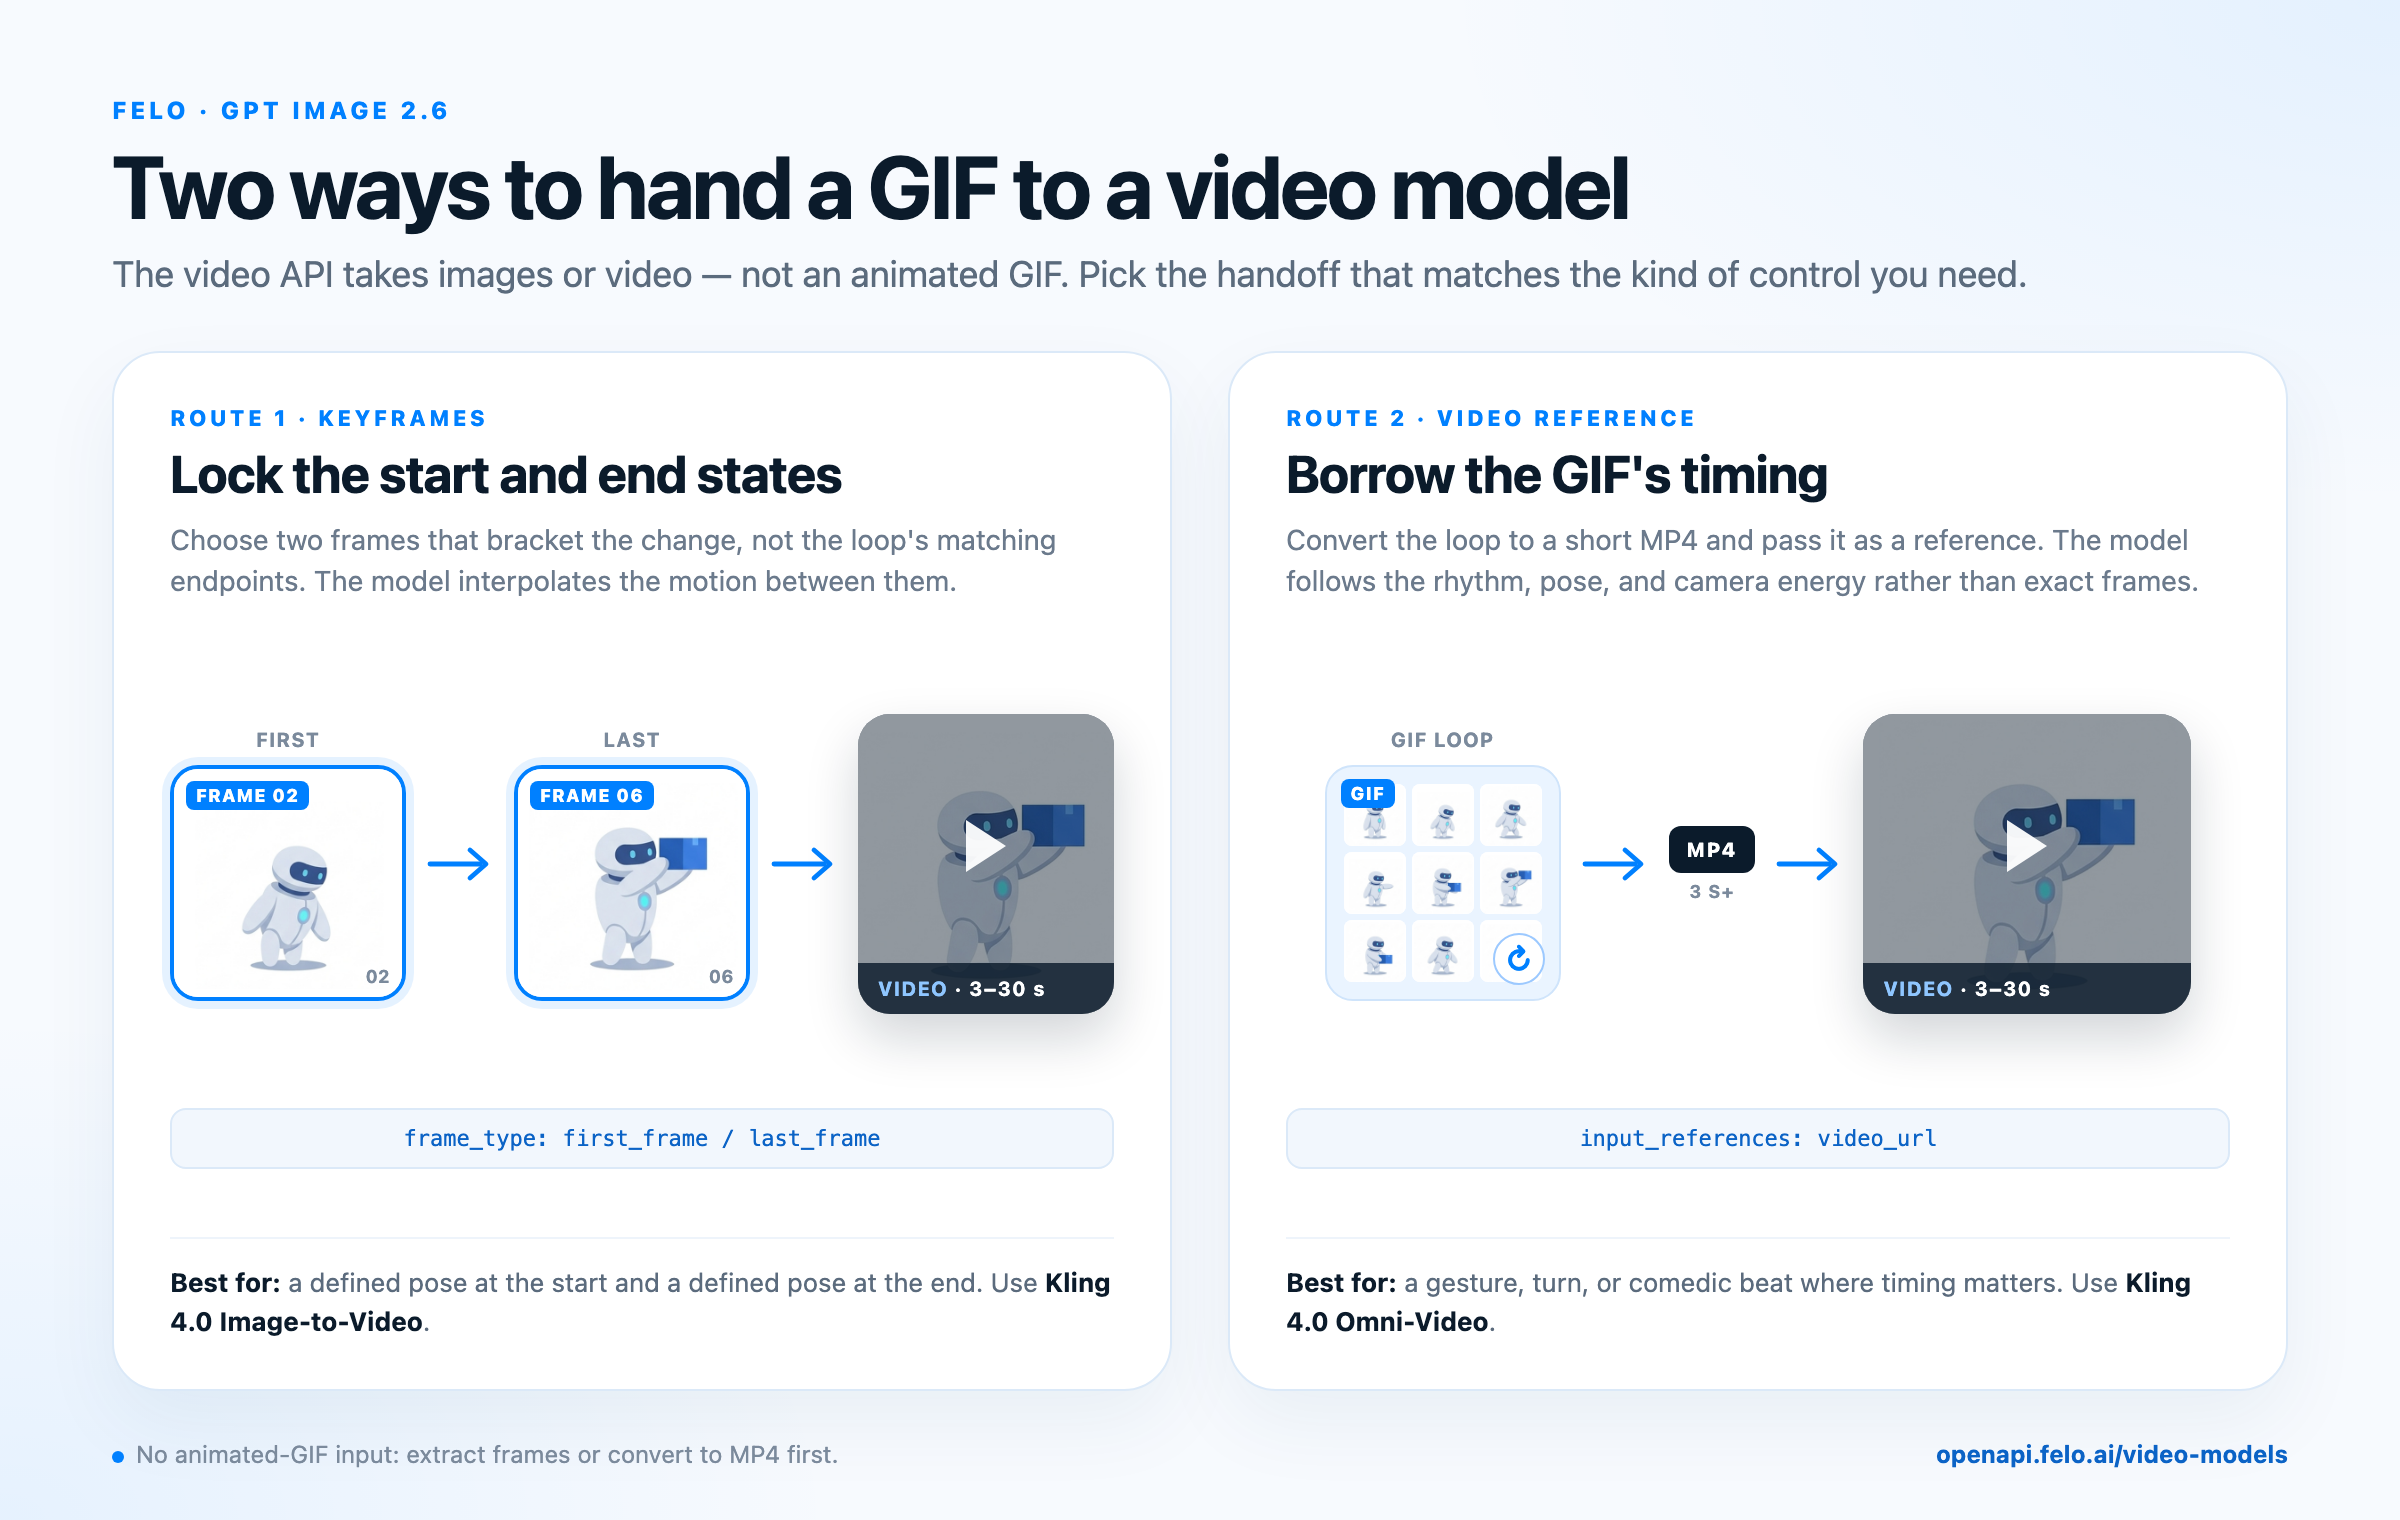
关键帧用于固定起始和结束状态;视频参考用于借用循环动画的时间节奏。
方式一:关键帧,适合明确的起始和结束状态
选择能够确定目标动作变化范围的两帧。对于快递员示例,应选择第 2 帧(调整身体重心)和第 6 帧(向前举起包裹),而不是循环动画中有意保持相同的第一帧和最后一帧。将它们作为 frame_images 发送,并将 frame_type 设置为 first_frame 或 last_frame。
这样就能固定你选择的起始和结束状态。提示词只需要描述两张图像无法体现的内容:摄像机运动、光线和节奏。
Kling 4.0 Image-to-Video 很适合这种方式。模型页面将 frame_images 列为支持的参数,并说明支持生成 3 至 30 秒、带立体声的片段。输入选定的两个姿势后,模型会对它们之间的动作进行插值。
关键帧方式的简短提示词示例:
同一名穿着芥末黄色夹克的快递员,站在同一条石板街道上,将手伸进邮差包并向前举起一个蓝色包裹。摄像机缓慢推进,柔和的午后光线,浅景深。保持角色面部、服装和包裹不变。加入自然的街道环境音。
视频模型负责填充两个姿势之间的动作。与要求模型根据一句话自行创造整个动作相比,这种方式需要模型完成的创意推断更少。
方式二:视频参考,适合沿用原有时间节奏
如果希望视频遵循 GIF 的节奏,可以将循环动画转换成较短的 MP4 文件,并将其作为视频参考传入。在视频 API 中,input_references 支持 video_url 条目,也支持 image_url 参考图。
ffmpeg -stream_loop 1 -i action.gif -t 3 -movflags +faststart -pix_fmt yuv420p action.mp4
Kling 4.0 Omni-Video 是适合参考驱动生成的选择。其页面列出最多 5 个 3 至 30 秒的视频片段,合计时长不超过 30 秒,同时支持最多 10 张图像参考。这意味着你可以在同一个请求中发送动作草图和角色图像。
当时间节奏是重点时,请选择这种方式,例如三拍手势、转身动作或喜剧停顿。Omni-Video 支持 3–30 秒的视频参考,因此导出前应将 GIF 循环延长至至少三秒;也可以使用 12 帧、每帧 250 毫秒的设置达到这一时长。
视频模型会遵循参考视频的整体节奏和姿势,而不会逐帧复刻。如果需要精确控制起始和结束状态,请使用关键帧方式。
或者直接保留 GIF
有时 GIF 本身就是最终交付成果。循环贴纸、UI 状态、社交媒体帖子或游戏精灵图都不需要视频模型或配乐。Felo 的 GPT Image 2.6 模型案例包括像素风水剑循环动画、人像转身眨眼动画,以及日本活动横幅;这三个案例都以简短、清晰的动作作为核心。
这种格式也存在实际限制:每帧最多 256 种颜色、不支持音频,而且文件大小会随尺寸和帧数增加而快速增长。纯色和简洁背景可以很好地掩盖颜色数量限制,而渐变和肤色则可能出现色带现象。
GPT Image 2.6 API:提交、轮询、获取结果
人工可以在浏览器中持续关注 GIF 生成过程,但智能体无法完成这项工作,除非 API 提供清晰的任务流程契约。Felo 提供了这样的流程:提交、轮询、获取结果。
图像接口为 POST https://openapi.felo.ai/api/v1/images/generations,需要携带 bearer 密钥。接口返回 202 和一个 task_id。持续调用 GET /api/v1/images/generations/{task_id},直到 status 变为 succeeded,随后从 outputs 中读取签名媒体 URL。
请求正文支持模型 ID、提示词、quality、aspect_ratio、output_format,以及用于参考图像的 input_references。如果需要使用本地参考图,请先通过 POST /api/v1/files 上传。该接口接受 PNG、JPEG、GIF、WebP、MP4 等常见格式,文件大小上限为 100 MiB,并返回文件记录。在 input_references 中将其 id 作为 file_id 传入。
对于需要生成 GIF 的智能体,最简洁的方案是在一次图像调用中要求生成包含完整动作的故事板帧图,然后将其切分为独立帧。一次请求生成九个姿势;切分过程具有确定性;GIF 则在本地完成组装。这些帧也正是视频生成步骤所需的内容,因此无需重复生成。
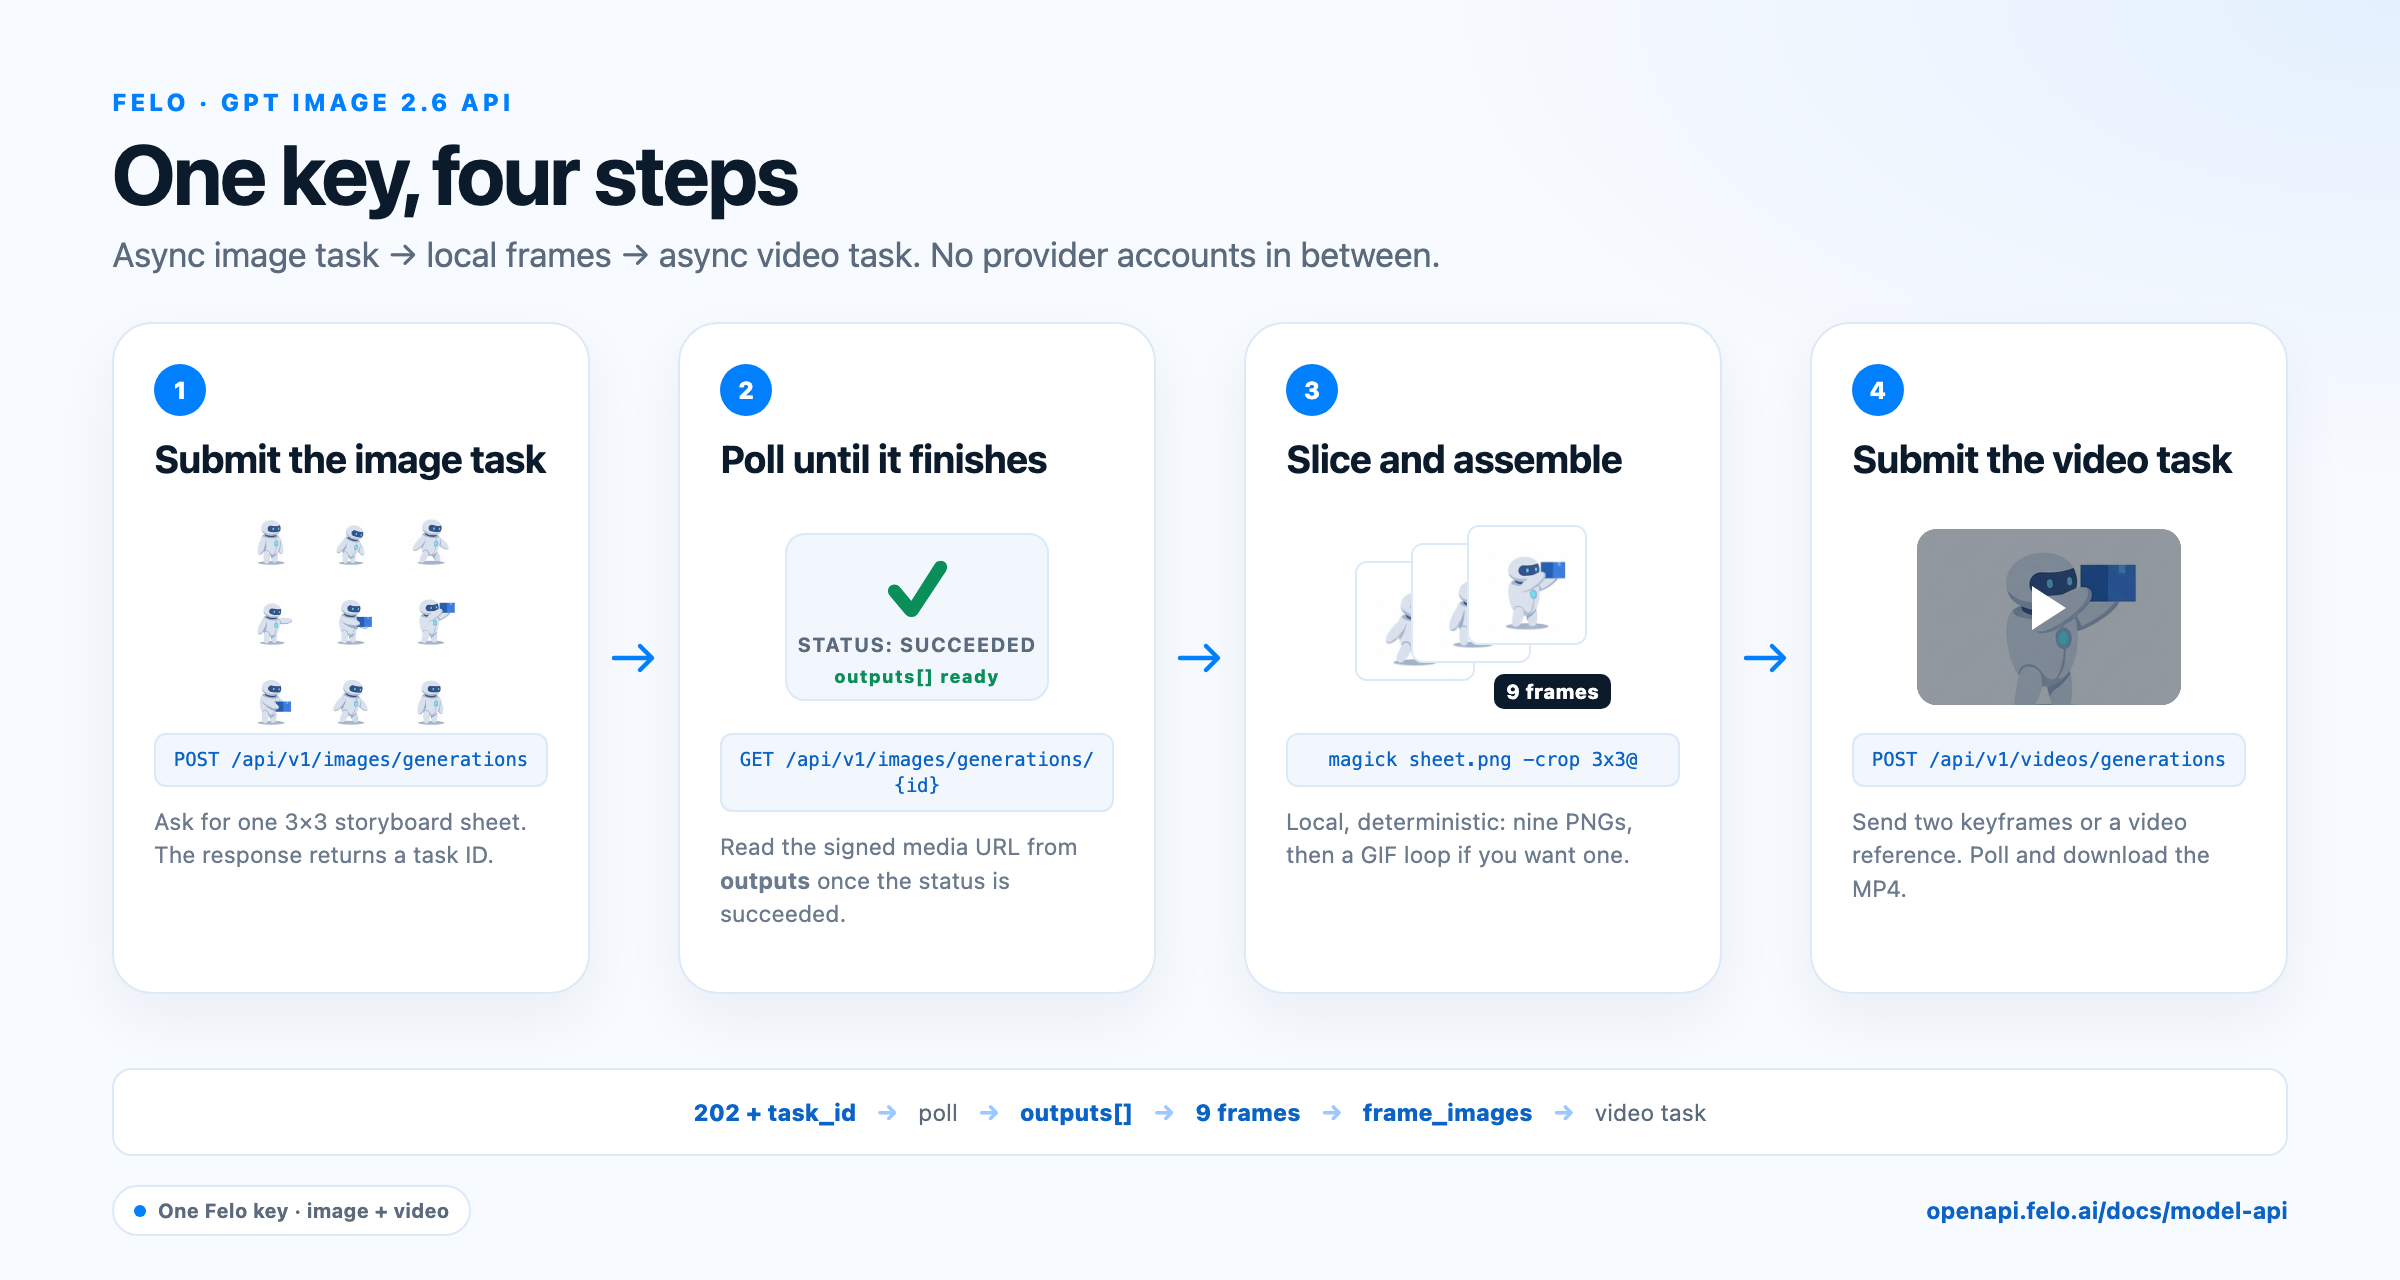
任务流程:提交图像任务、轮询生成结果、在本地切分帧图,然后使用这些帧提交视频任务。
一次调用生成九个姿势
该请求可以使用以下故事板提示词:
一张 3 × 3 故事板帧图,背景为纯白色,包含九个大小相同、边缘相接的正方形画面,不留间隔。每个画面中都是同一名穿着芥末黄色夹克的快递员:侧面视角、全身入镜,身体比例、颜色和邮差包保持一致。第 1 格站立;第 2 格调整身体重心;第 3 格将手伸进邮差包;第 4 格打开邮差包;第 5 格取出一个蓝色包裹;第 6 格向前举起包裹;第 7 格放下包裹;第 8 格将手放回身体一侧;第 9 格恢复与第 1 格相同的姿势。光线平整,比例一致,不包含文字、说明和画面编号。
1K 帧图在裁剪后会得到约 340 像素的单格画面,清晰度低于浏览器工具生成的 512 像素帧。如果你的使用渠道支持更高分辨率,请选择更大的正方形尺寸。在切分前检查整张帧图:如果画面大小不均,或者角色形象发生变化,请使用更简单的布局指令重新生成,而不是尝试在裁剪后修复问题。
提交、切分、组装
import os
import time
import requests

BASE = "https://openapi.felo.ai/api/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['FELO_API_KEY']}"}

def poll(path, timeout=900, interval=5):
    deadline = time.time() + timeout
    while time.time() < deadline:
        response = requests.get(f"{BASE}{path}", headers=HEADERS, timeout=30)
        response.raise_for_status()
        task = response.json()
        if task["status"] in {"succeeded", "failed", "interrupted"}:
            if task["status"] != "succeeded":
                raise RuntimeError(task.get("error", task["status"]))
            return task
        time.sleep(interval)
    raise TimeoutError(path)

STORYBOARD_PROMPT = (
    "A 3x3 storyboard sheet on plain white, nine equal square panels edge to edge, "
    "the same courier in a mustard jacket in every panel, side view, full body, "
    "identical proportions and colors: standing, shifting weight, reaching into a "
    "satchel, opening it, pulling out a blue parcel, holding it forward, lowering it, "
    "hand at side, standing again. Flat lighting, consistent scale, no text, no gutters."
)

response = requests.post(
    f"{BASE}/images/generations",
    headers=HEADERS,
    json={
        "model": "gpt-image-2.6-sunburst",
        "prompt": STORYBOARD_PROMPT,
        "aspect_ratio": "1:1",
        "quality": "medium",
    },
    timeout=60,
)
response.raise_for_status()

result = poll(f"/images/generations/{response.json()['task_id']}")
output = result["outputs"][0]
sheet_url = output["url"] if isinstance(output, dict) else output
with open("sheet.png", "wb") as file:
    file.write(requests.get(sheet_url, timeout=60).content)
随后在本地切分帧图并组装循环动画:
magick sheet.png -crop 3x3@ +repage -resize 512x512! frame-%02d.png
magick -delay 20 -loop 0 frame-*.png action.gif   # 20/100 s = 200 ms per frame
ImageMagick 6 用户可以将 magick 替换为 convert。由于提示词要求画面之间不留间隔,因此裁剪结果会保持均匀。
向视频模型发送两个关键帧
def upload(path):
    with open(path, "rb") as file:
        response = requests.post(
            f"{BASE}/files", headers=HEADERS, files={"file": file}, timeout=60
        )
    response.raise_for_status()
    return response.json()["id"]

VIDEO_PROMPT = (
    "The same courier on the same stone street reaches into the satchel and holds "
    "out a blue parcel. Slow push-in, soft late-afternoon light, shallow depth of "
    "field. Keep the face, clothing, and parcel unchanged."
)

# Panels 2 and 6 bracket the change; the loop's matching endpoints do not.
first_id = upload("frame-01.png")
last_id = upload("frame-05.png")

video = requests.post(
    f"{BASE}/videos/generations",
    headers=HEADERS,
    json={
        "model": "kling-4.0/image-to-video",
        "prompt": VIDEO_PROMPT,
        "duration": 5,
        "resolution": "720p",
        "frame_images": [
            {"type": "image_url", "frame_type": "first_frame",
             "image_url": {"file_id": first_id}},
            {"type": "image_url", "frame_type": "last_frame",
             "image_url": {"file_id": last_id}},
        ],
    },
    timeout=60,
)
video.raise_for_status()
video_task = video.json()["task_id"]
按照相同方式轮询视频任务,并下载带签名的输出 URL。接口为 POST https://openapi.felo.ai/api/v1/videos/generations;任务包含 status 和 outputs,与图像任务相同。完整的视频接口目录可在视频模型页面查看。
将工作流程接入智能体
智能体可以用相当于生成少量图像的成本制作多张动作帧图,对它们进行比较,然后再决定是否支付视频生成费用。它还可以记录每张帧图对应的提示词,这种记录方式比人工通过 UI 点击操作更容易管理。
由于同一个密钥可以调用聊天、图像和视频模型,整个流程都能在一个智能体中完成:规划模型编写动作节拍,图像调用生成帧图,视觉模型检查一致性,视频调用完成镜头。Felo 提供兼容 OpenAI 和 Anthropic 的基础 URL,以及面向 Codex、Claude Code、DeepSeek Harness、OpenClaw 和其他智能体客户端的配置指南。因此,现有智能体无需重建,就能接入该平台。
这套工作流程无法解决的问题
GIF 优先的方法可以减少动作设计中的模糊空间,但无法让视频模型实现逐帧精准控制。
- 动作仍会发生偏移。 视频模型通过插值生成画面;在关键帧之间,它可能改变手部位置或衣物褶皱。参考图有助于改善一致性,但仍需检查生成结果。
- 短片段就是短片段。 2 至 16 帧只能呈现一个手势,而不是完整场景。可以通过多个手势构建场景,再让视频模型处理转场。
- 帧内文字不稳定。 字母和文字在不同帧之间可能发生抖动。标题应在设计工具中添加,而不是放进动画中生成。
- 模型列表会发生变化。 试用条款和支持的参数都属于实时数据,因此在将模型 ID 接入生产环境前,请检查模型页面或 Playground。
常见问题
GPT Image 2.6 能在 Felo 上生成动画 GIF 吗?
可以,通过浏览器工具即可实现。选择 GPT Image 2.6,打开设置并选择 GIF。该面板支持 2 至 16 帧,每帧时长为 20 至 2000 毫秒,初始尺寸为 512 × 512;使用 9 帧、每帧 200 毫秒的设置,可以生成一个 1.8 秒的循环动画。
我可以通过 API 调用 GPT Image 2.6 吗?
可以。在 Felo API Platform 中使用模型 ID gpt-image-2.6-flare 或 gpt-image-2.6-sunburst,并调用 POST /api/v1/images/generations。一个 Felo 密钥即可完成调用,无需注册 OpenAI、Google 或快手账户。该调用采用异步方式:提交任务、轮询任务状态,然后下载输出结果。
图像 API 会返回 GIF 文件吗?
目前不会。这些模型的公开图像 API 支持的格式为 png、jpeg 和 webp。智能体仍然可以通过生成帧图或静态图像序列,再使用 ImageMagick 或 ffmpeg 在本地组装,完成 GIF 制作。这种方式通常能得到更实用的产物,因为视频生成步骤本身也需要独立帧。
如何在 Felo 上将 GIF 转换为视频?
将 GIF 作为动作方案,然后通过以下两种方式之一交给图生视频 API:提取能够确定动作变化范围的两个关键帧,并将其作为 frame_images 发送;或者将循环动画转换为 MP4,并将其作为 video_url 参考传入。Felo 的视频 API 不接受动画 GIF 作为直接输入。
制作 GPT Image 2.6 GIF 需要多少费用?
两个模型都按 token 计费:每 1M 输入 tokens 收费 $5,每 1M 输出 tokens 收费 $30。因此,更高的分辨率或更多参考图会增加费用。浏览器工具和 API 使用同一 Felo 账户额度;当前费率和试用条款请以模型页面为准。
从一个循环动画开始
提升 AI 视频质量的可靠方式,是先不要直接要求模型生成视频。先将动作缩小到可以清楚观察的程度,制作循环动画,修复首尾衔接,然后再将帧交给能够添加光线、摄像机效果和声音的视频模型。
访问 Felo 上的 GPT Image 2.6,在浏览器中制作你的第一个循环动画。当你准备将这套工作流程接入智能体时,可以浏览图像模型 API,创建密钥并发送第一个请求。
GIF 是动作方案,视频则是最终演绎。
本文还提供以下语言版本:English、日本語、한국어、繁體中文、हिन्दी、Français、العربية、Русский、اردو、Bahasa Indonesia、Deutsch、Tiếng Việt、Türkçe、Italiano、ไทย、Español、বাংলা、Português。