GPT-6.1 Sol API:以更低成本实现近乎 Astra 的性能
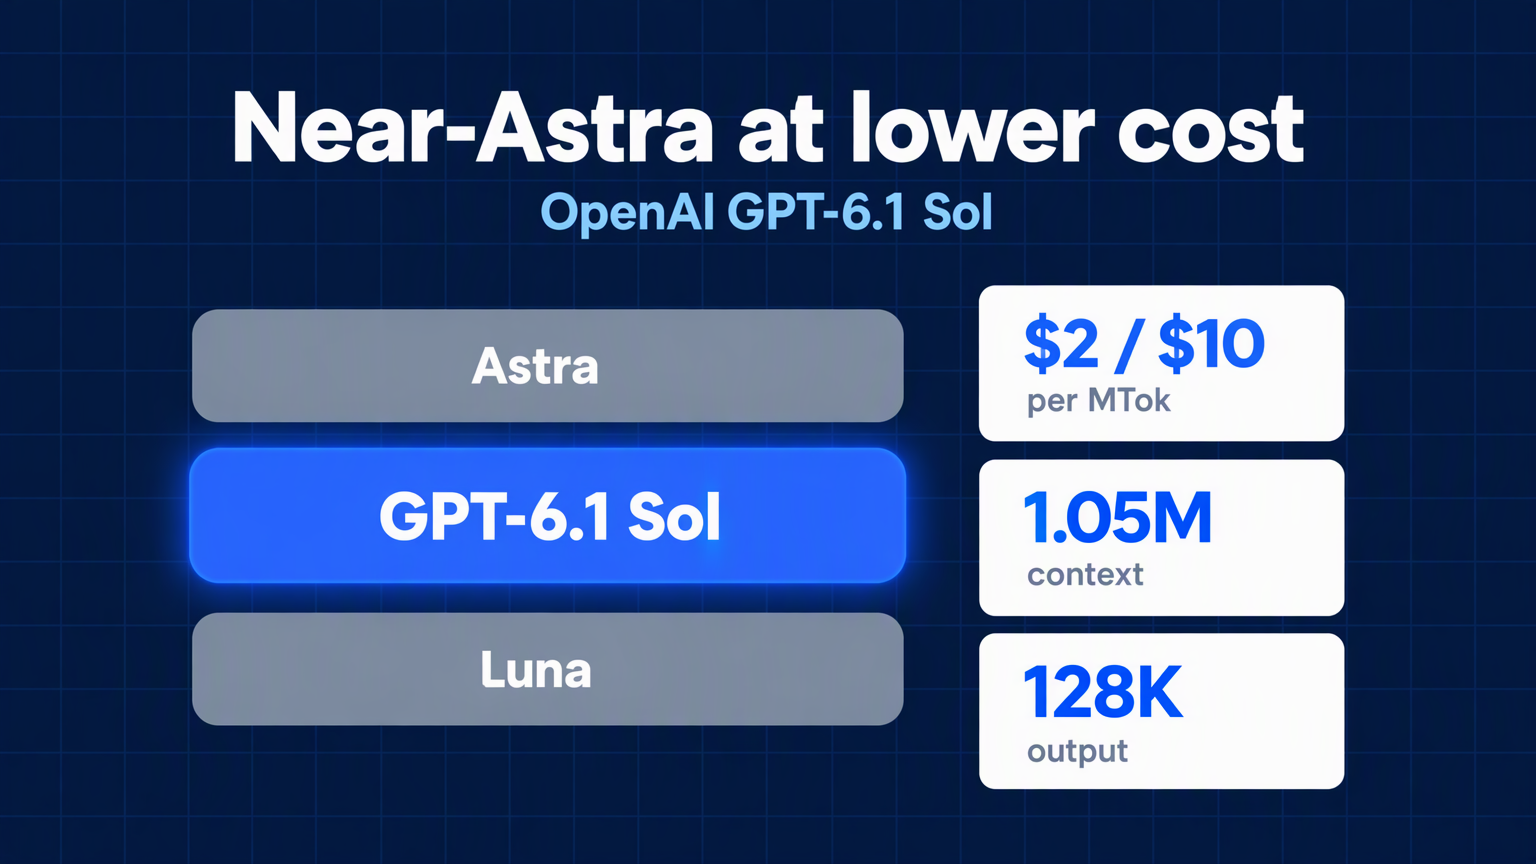
OpenAI GPT-6.1 Sol 以每百万 tokens $2/$10 的价格和 1.05M 上下文窗口,为编程、计算机使用和专业工作带来近乎 Astra 的性能。
OpenAI 最新的 Sol 模型不追求成为最聪明的模型,而是让你可以全天候负担得起地运行。
GPT-6.1 Sol 处于旗舰 GPT-6 Astra 与轻量级 GPT-6 Luna 之间。OpenAI 官方模型页面用一句话描述它:“以更低成本实现复杂工作的近乎 Astra 性能。” 对于构建智能编程工具、计算机操作代理和文档密集型流程的团队来说,这种权衡正是核心。
本指南介绍 GPT-6.1 Sol 的实际功能、定价、与 GPT-6 Sol 和 Astra 的区别,以及如何通过 Felo API Platform 调用它。
什么是 GPT-6.1 Sol
GPT-6.1 Sol 是为复杂编程、计算机使用和专业工作设计的推理模型。OpenAI 将其定位为 GPT-6 系列中的平衡选择:能力强于 Luna,价格低于 Astra,足以让许多生产场景无需旗舰型号。
模型页面直接给出使用建议:在自己的任务上对比 Sol 和 Astra,然后决定质量差异是否值得价格差异。这种建议非常实用,体现了模型的定位。Sol 是成本控制工具,而不是性能标杆。
Felo 的模型页面从平台角度总结了相同定位。GPT-6.1 Sol 是“GPT-6 Sol 的升级版,仍然位于旗舰 GPT-6 Astra 之下。”它适用于智能编程、计算机操作、文档密集型专业工作和多步骤流程自动化,在这些任务上以更低成本接近 Astra 水平。与 GPT-6 Sol 相比,Felo 指出事实错误更少,对显式限制遵循更严格。
当任务复杂、流程长且需反复执行,同时账单必须可控时,GPT-6.1 Sol 就是你的选择。
GPT-6.1 Sol 规格一览
OpenAI 在模型页面公布了完整规格。以下为简要版。
| 规格 | GPT-6.1 Sol |
|---|---|
| 模型 ID | gpt-6.1-sol |
| 默认快照 | gpt-6.1-sol |
| 上下文窗口 | 1,050,000 tokens |
| 最大输入 tokens | 922,000 |
| 最大输出 tokens | 128,000 |
| 知识截止日期 | 2026 年 4 月 30 日 |
| 输入模态 | 文本、图片 |
| 输出模态 | 文本 |
| 不支持的模态 | 音频、视频 |
| 支持推理 tokens | 是 |
| 推理强度 | low、medium(默认)、high、xhigh、max |
| 不支持的推理强度 | none、minimal |
| 数据驻留 | 美国和欧盟 |
有两个细节比主流参数更重要。
首先,推理强度无法关闭。GPT-6.1 Sol 不支持 none 或 minimal。如果你从允许这些设置的模型迁移,OpenAI 建议从 low 开始,并在代表性任务上对比结果。
其次,工具调用需要使用 Responses API。GPT-6.1 Sol 支持无工具请求的 Chat Completions,但涉及函数调用、文件搜索、网页浏览或计算机操作的流程都需迁移到 Responses。这不是 Sol 独有的限制,而是 OpenAI 推动整个平台的方向。
GPT-6.1 Sol 定价:$2/$10 能买到什么
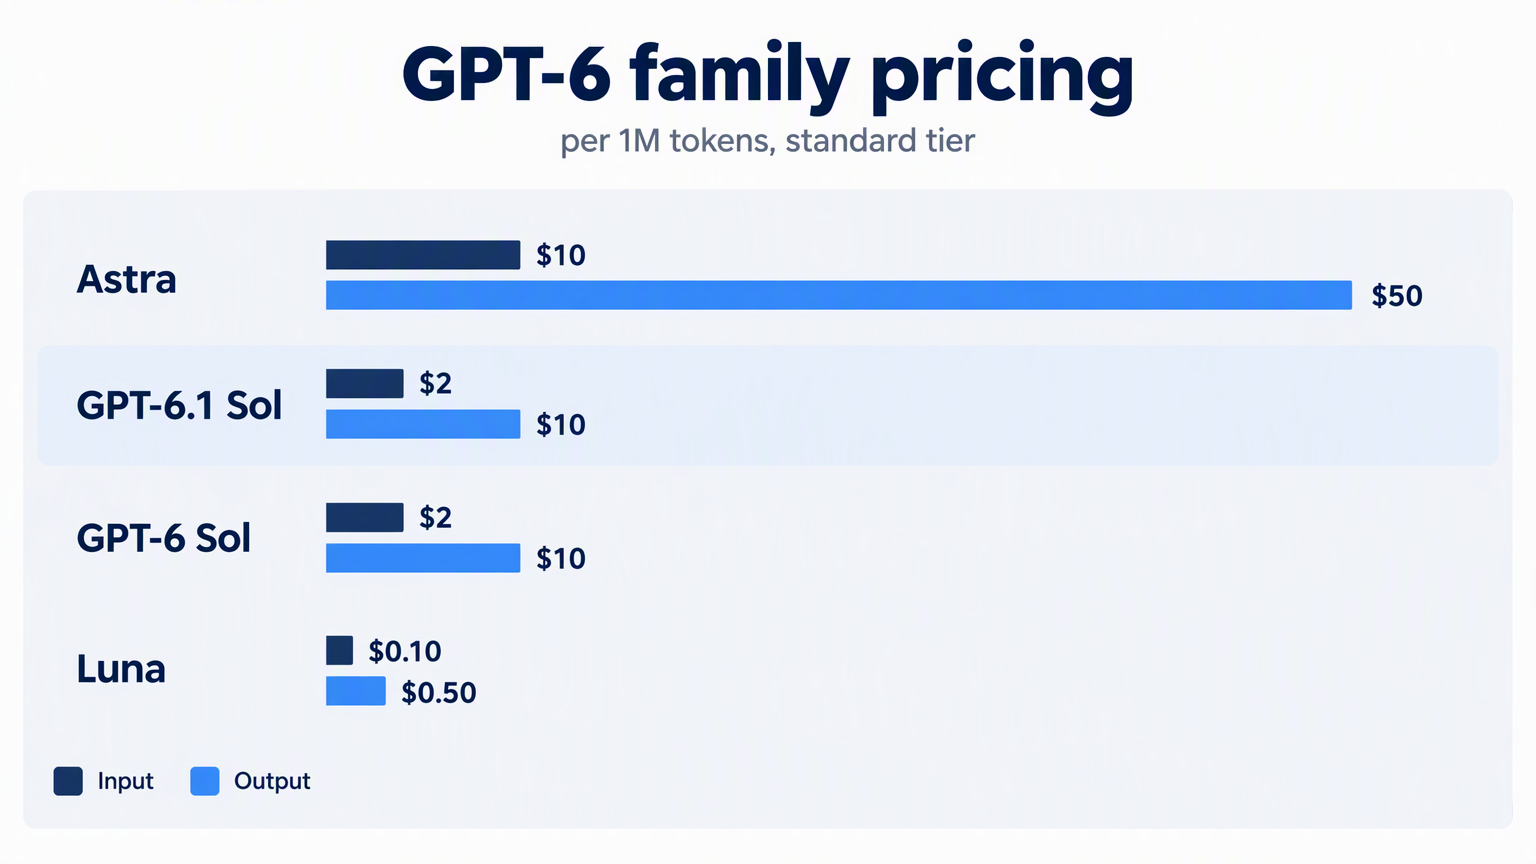
OpenAI 对 GPT-6.1 Sol 的标准定价为每百万输入 tokens $2,每百万输出 tokens $10。完整 token 表还包括缓存定价,对长时间运行的代理影响较大。
| 指标 | 每百万 tokens 价格 |
|---|---|
| 输入 | $2.00 |
| 缓存输入 | $0.10 |
| 缓存写入 | $2.50 |
| 输出 | $10.00 |
该表下有几条规则:
- 缓存输入仅为未缓存价格的 5%。 OpenAI 将 GPT-6.1 Sol 的缓存读取定价为 0.05 倍,大多数 GPT-5.6 及以后模型为 0.1 倍。对于每轮都复用大型系统提示或仓库上下文的代理,这一折扣非常明显。
- 缓存写入为未缓存输入价格的 1.25 倍。 将前缀写入缓存需 $2.50/百万 tokens,读取时每百万仅 $0.10。
- 长上下文更贵。 输入 tokens 超过 272K 时,整个请求的输入和缓存价格翻倍,输出价格为 1.5 倍。此时输入 $4,缓存输入 $0.20,缓存写入 $5,输出 $15/百万 tokens。
- Batch 和 Flex 便宜 50%。 如果你的工作负载可接受异步处理,实际输入 $1、输出 $5/百万 tokens。
- Fast 模式价格为标准的 2 倍。 你为更低延迟付费,而非更高智能。
- 区域处理加收 10% 费用(如可用)。
缓存读取折扣是隐藏的重点。一个智能编程代理,每轮复用同样的 10 万 token 仓库上下文,缓存读取每百万 tokens 仅 $0.10,而新输入需 $2.00。长会话中,这一差异迅速累积。
对比来看,GPT-6 Astra 输入 $10、输出 $50/百万 tokens。GPT-6.1 Sol 价格仅为其五分之一。GPT-6 Luna 更便宜,输入 $0.10、输出 $0.50,但放弃了 Sol 的近 Astra 能力。
GPT-6 新特性,Sol 可用哪些
GPT-6.1 Sol 继承了 OpenAI 在 Astra 代引入的 GPT-6 平台特性,其中多项专为智能代理场景设计。
异步工具调用
通常,函数调用会让模型暂停,直到应用返回结果。有了异步工具调用,你在工具定义中设置 async: true,模型继续工作——推理、调用其他工具或回答请求的独立部分——而应用在后台执行慢任务。
应用仍需执行工具并管理待处理任务。任务完成后,你在后续 Responses 请求中用原始 call_id 返回输出。OpenAI 文档将其描述为提前启动慢查询,数据到达时补全答案。
对 Sol 来说,这非常适用。编程代理可启动长时间测试,继续审查其他文件,测试结果到达时再整合。
轮次中途引导
轮次中途引导允许用户在模型工作时发送修正或新需求。通过 WebSocket 连接 Responses API,服务器保留已完成工作,将更新内容融入后续流程。
注意:引导不会重写已发送输出、撤销已执行操作或取消已启动工具。它只改变后续流程方向,不影响已完成部分。如果引导中断原始响应,该响应以 incomplete_details.reason: "steered" 结束,新响应携带更新内容。
会话中调整推理强度
你可通过添加 configuration_update 输入项,在会话中提升或降低推理强度。更新后的强度持续生效,直到下次更新覆盖。OpenAI 建议保持请求级 reasoning.effort 不变,以便提示前缀可缓存。
这种组合——低价缓存读取加可调推理——让 Sol 在混合工作负载下经济高效。常规跟进用 low,遇到难题切换到 xhigh,无需重写会话。
多代理(测试版)
多代理作为测试功能,适用于 GPT-6.1 Sol 及所有 GPT-5.6 模型。主代理可并行生成子代理,每个子代理有独立上下文,最后合成结果。
OpenAI 文档建议用于可拆分为独立流程的任务:探索大型代码库不同部分、对比方案、并行查找资料或同时排查多种故障原因。默认 max_concurrent_subagents 为 3。
权衡点在于 token 用量。代理越多,token 消耗越大,因此多代理适合对并行速度和聚焦上下文有需求的场景。
上下文压缩与推理持久化
长时间运行的代理最终会填满上下文窗口。压缩功能在保留后续轮次所需状态的同时减少上下文体积。你可在 Responses 请求中设置 context_management 和 compact_threshold 启用服务器端压缩;当渲染 token 数超阈值时,服务器会发出加密压缩项。
GPT-6.1 Sol 还支持 reasoning.context: "all_turns",允许前几轮兼容的推理项延续到下次采样。推理持久化过程对用户不可见——API 不返回模型原始推理文本——但能让模型在长会话中保持连贯。
WebSocket 模式
WebSocket 模式与 Responses API 保持持久连接,每轮只发送新增输入项。OpenAI 报告,20 次以上工具调用的流程,端到端执行速度提升约40%。对于以智能编程和计算机操作为核心的模型,这直接降低延迟。
GPT-6.1 Sol、GPT-6 Sol、Astra、Luna 对比
GPT-6 系列现有四个层级。选择主要取决于所需质量和流程频率。
| 模型 | 定位 | 每百万输入/输出 | 适用场景 |
|---|---|---|---|
| GPT-6 Astra | 智能最高 | $10 / $50 | 高要求推理、编程、专业工作 |
| GPT-6.1 Sol | 近 Astra,成本更低 | $2 / $10 | 复杂编程、计算机操作、文档密集型工作 |
| GPT-6 Sol | 旧版 Sol 层级 | $2 / $10 | 升级前的 Sol 工作负载 |
| GPT-6 Luna | 速度最快、性价比最高 | $0.10 / $0.50 | 聚焦、高频任务 |
GPT-6.1 Sol 与 GPT-6 Sol 价格相同,但并非同一模型。Felo 页面称 GPT-6.1 Sol 为升级版,事实错误更少,对显式限制遵循更严格。缓存读取价格也减半:每百万 tokens $0.10,而非 $0.20。如果你已在生产环境运行 GPT-6 Sol,升级后质量和缓存经济性均提升,价格不变。
OpenAI 的模型选择指南将推理强度与任务类型对应:
- GPT-6.1 Sol 中等强度——复杂技术工作、需多次修订的协作交付。
- GPT-6.1 Sol 超高强度——高质量交付、视觉系统集成、基于冲突证据的决策。
- Astra 低强度——简明写作、内容适配,兼顾事实与细节。
- Astra 中等强度——需广泛上下文、可靠交互、完整结果的项目。
- Astra 超高强度——高要求分析、复杂交付、精确需求。
- Luna 低强度——细致编辑、范围明确的问题解决、简单数据提取。
- Luna 超高强度——多应用上下文查找、任务优先级排序、明确定义约束下的问题解决。
OpenAI Codex 指南的实用规则:**Sol 适合跨代码、应用和文档的重复、长时间工作,注重成本。**最苛刻的任务用 Astra。Luna 适合明确、可重复的任务。
如何通过 Felo API Platform 调用 GPT-6.1 Sol
Felo API Platform 通过兼容端点开放 GPT-6.1 Sol,你可保留现有 SDK,仅需更改 base URL。
模型可通过以下方式访问:
- Chat Completions:
POST https://openapi.felo.ai/api/v1/chat/completions - Responses:
POST https://openapi.felo.ai/api/v1/responses - Messages(兼容 Anthropic):
POST https://openapi.felo.ai/api/v1/messages
第一步:获取 API 密钥
在 Felo API Platform 账户中创建密钥并导出:
export FELO_API_KEY="YOUR_API_KEY"
第二步:发起首次请求
curl https://openapi.felo.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $FELO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "messages": [
      {"role": "user", "content": "Explain the tradeoff between reasoning effort and cost."}
    ]
  }'
第三步:使用兼容 SDK
将任意 OpenAI 兼容 SDK 指向 https://openapi.felo.ai/api/v1。Claude 风格客户端用兼容 Anthropic 的 base URL https://openapi.felo.ai/api。
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FELO_API_KEY,
  baseURL: "https://openapi.felo.ai/api/v1",
});

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  input: "Review this pull request for correctness, security, and missing tests.",
});

console.log(response.output_text);
第四步:按需启用流式输出
添加 stream: true,即可在模型工作时接收服务器推送事件。
Felo 模型页面显示 GPT-6.1 Sol 每百万输入 tokens $2.00、输出 $10.00,首发价格可能比官方 API 低 50%。最终费用取决于模型、输入/输出比例、缓存使用和当前套餐。缓存读取按 GPT-6 Sol 一半计费。
平台还支持推理、工具、JSON 输出、流式输出和视觉输入,并提供 Playground 便于测试提示词。
GPT-6.1 Sol 最佳应用场景
OpenAI 指南推荐在注重成本的复杂项目中使用。以下几种模式尤为突出。
大规模智能编程
编程代理读取仓库、提出修改、运行测试并迭代,正是 Sol 的典型工作负载。1.05M 上下文窗口可容纳大型代码库,缓存读取折扣鼓励复用仓库上下文,异步工具调用让测试期间代理持续高效。
OpenAI Codex 指南建议,成本敏感的重复、长时间跨代码和应用工作用 Sol,最苛刻任务用 Astra。
计算机操作与流程自动化
GPT-6.1 Sol 支持全套 Responses 工具,包括 computer_use、hosted_shell、apply_patch、mcp 和 tool_search。这让其适用于操作软件、填写表单、系统间数据迁移或多步骤业务流程自动化的代理。
Felo 模型页面将计算机操作和多步骤流程自动化列为主要应用场景。
文档密集型专业工作
Sol 支持文本和图片输入,涵盖扫描文档、图表、截图和演示文稿。OpenAI 模型选择指南举例:根据财务结果制作董事会演示、根据产品简介搭建网站。这类任务输入量大、多次修订,质量要求高于“便宜快速”,但低于“极致最佳”。
并行流程的研究与分析
启用多代理测试版后,Sol 可将研究任务拆分为独立流程并发执行,最后整合结果。对比供应商方案、从多个角度审查 pull request 或同时排查多种故障假设都很适合。
高频批量处理
Batch 和 Flex 定价将 Sol 价格降至每百万 tokens 输入 $1、输出 $5。用于夜间文档处理、批量摘要或大规模抽取且需人工复核的场景,这一价格极具吸引力。
迁移清单:从 GPT-6 Sol 升级到 GPT-6.1 Sol
OpenAI 建议在从 gpt-6-sol 切换到 gpt-6.1-sol 前,先查阅迁移指南。简要步骤如下:
- 设置模型 ID。 将
model改为gpt-6.1-sol。 - 修正推理强度。 GPT-6.1 Sol 不支持
none或minimal。将none替换为low,minimal迁移时从low开始测试。 - 将工具调用迁移到 Responses。 无工具请求可用 Chat Completions。涉及函数调用、网页搜索、文件搜索、计算机操作或 MCP 流程需用 Responses API。
- 移除不支持参数。 推理强度非
none时,去掉temperature、top_p、top_logprobs。Chat Completions 还需移除logprobs,Responses 移除message.output_text.logprobs。 - 更新提示缓存配置。 从 GPT-5.5 或更早版本迁移时,将
prompt_cache_retention替换为prompt_cache_options.ttl,值设为"30m"。 - 用
configuration_update动态调整推理。 应用在轮次间调整强度时,用configuration_update项而非直接改请求级reasoning.effort,以便提示前缀可缓存。 - 检查数据驻留。 GPT-6.1 Sol 支持美国和欧盟数据驻留。欧盟数据驻留下不支持 Fast 模式。
- 对比 Astra。 在代表性任务上同时运行两种模型,比较质量、延迟和总成本——包括按输出计费的推理 tokens。
限制与可用性
GPT-6.1 Sol 并非 Astra 的通用替代品,且尚未全面开放。
能力限制。 OpenAI 将 Sol 定位于 Astra 之下。最苛刻推理和最高风险交付仍推荐 Astra。Sol 适合复杂工作,追求性价比,而非极致质量。
不支持微调。 GPT-6.1 Sol 不支持微调或预测输出,也不支持嵌入、图片生成、视频、语音、转录、翻译或审核端点。它是文本和图片输入、文本输出的推理模型。
不支持音频或视频输入。 输入模态仅限文本和图片。
推理无法关闭。 不支持 none 和 minimal,每个请求都包含推理开销。
尚在逐步开放。 OpenAI 首批开放对象包括 Codex 桌面和 CLI 的 Plus、Pro、Business、Enterprise、Edu 计划,以及网页版和移动端的 ChatGPT Work。Enterprise 和 Edu 默认关闭,需管理员手动开启。Free 和 Go 计划首发不包含。
Fast 模式有限制。 首发支持 Standard 和 Fast,Fast 模式价格为标准 2 倍,欧盟数据驻留下不可用。GPT-6.1 Sol 的 Ultrafast 支持后续上线。
有速率限制。 标准速率限制为 Tier 1 每分钟 500 次、每分钟 50 万 tokens,Tier 5 每分钟 1.5 万次、每分钟 4000 万 tokens。
常见问题
什么是 GPT-6.1 Sol?
GPT-6.1 Sol 是 OpenAI 的平衡型 GPT-6 模型,定位介于旗舰 GPT-6 Astra 与轻量级 GPT-6 Luna 之间。OpenAI 称其以更低成本为复杂编程、计算机使用和专业工作带来近乎 Astra 的性能。
GPT-6.1 Sol 多少钱?
OpenAI 定价为每百万输入 tokens $2,每百万输出 tokens $10。缓存输入 $0.10/百万 tokens,缓存写入 $2.50/百万 tokens。输入 tokens 超过 272K 时,按长上下文更高费率计费。
GPT-6.1 Sol 的上下文窗口多大?
GPT-6.1 Sol 拥有 1,050,000 tokens 上下文窗口,最大输入 922,000 tokens,最大输出 128,000 tokens。
GPT-6.1 Sol 支持工具调用吗?
支持,但需使用 Responses API。无工具请求可用 Chat Completions。
可以关闭 GPT-6.1 Sol 的推理吗?
不能。GPT-6.1 Sol 仅支持 low、medium、high、xhigh、max 推理强度。不支持 none 或 minimal。
GPT-6.1 Sol 与 GPT-6 Sol 有何区别?
GPT-6.1 Sol 是 GPT-6 Sol 的升级版,Felo 模型页面称其事实错误更少,对显式限制遵循更严格。两者 token 定价相同,但 GPT-6.1 Sol 的缓存输入价格减半至 $0.10/百万 tokens。
GPT-6.1 Sol 可在 Felo API Platform 使用吗?
可以。Felo API Platform 通过 Chat Completions、Responses 和兼容 Anthropic 的 Messages 端点开放 GPT-6.1 Sol。首发价格可能比官方 API 低 50%,缓存读取按 GPT-6 Sol 一半计费。
总结
GPT-6.1 Sol 针对实际问题给出 OpenAI 的答案:最强模型往往太贵,最便宜模型又不够好。Sol 以近乎 Astra 的能力、1.05M 上下文窗口、5% 缓存读取费率和 Astra 五分之一的价格实现平衡。
对于构建编程代理、计算机操作流程和文档密集型自动化的团队,Sol 是首选测试模型。在自己的任务上对比 Astra,关注推理 token 用量,让成本与质量权衡决定选择。
你可以在 Felo API Platform Playground 体验 GPT-6.1 Sol,或用 Felo API 密钥直接调用。
参考资料
- GPT-6.1 Sol 模型页面 — OpenAI
- 使用 GPT-6 — OpenAI
- 模型选择 — OpenAI
- API 定价 — OpenAI
- Codex 与 ChatGPT 模型可用性 — OpenAI
- 异步工具调用 — OpenAI
- 轮次中途引导 — OpenAI
- 推理模型 — OpenAI
- 提示缓存 — OpenAI
- 上下文压缩 — OpenAI
- 多代理 — OpenAI
- WebSocket 模式 — OpenAI
- Fast 模式 — OpenAI
- 数据驻留 — OpenAI
- GPT-6.1 Sol — Felo API Platform
本文还提供以下语言版本:English、日本語、한국어、繁體中文、हिन्दी、Français、العربية、Русский、اردو、Bahasa Indonesia、Deutsch、Tiếng Việt、Türkçe、Italiano、ไทย、Español、বাংলা、Português。