视频转提示词:将镜头拆解为 AI 提示词

通过镜头拆解、原创示例、连贯性说明和实用审核流程,将视频参考素材转化为 AI 提示词。
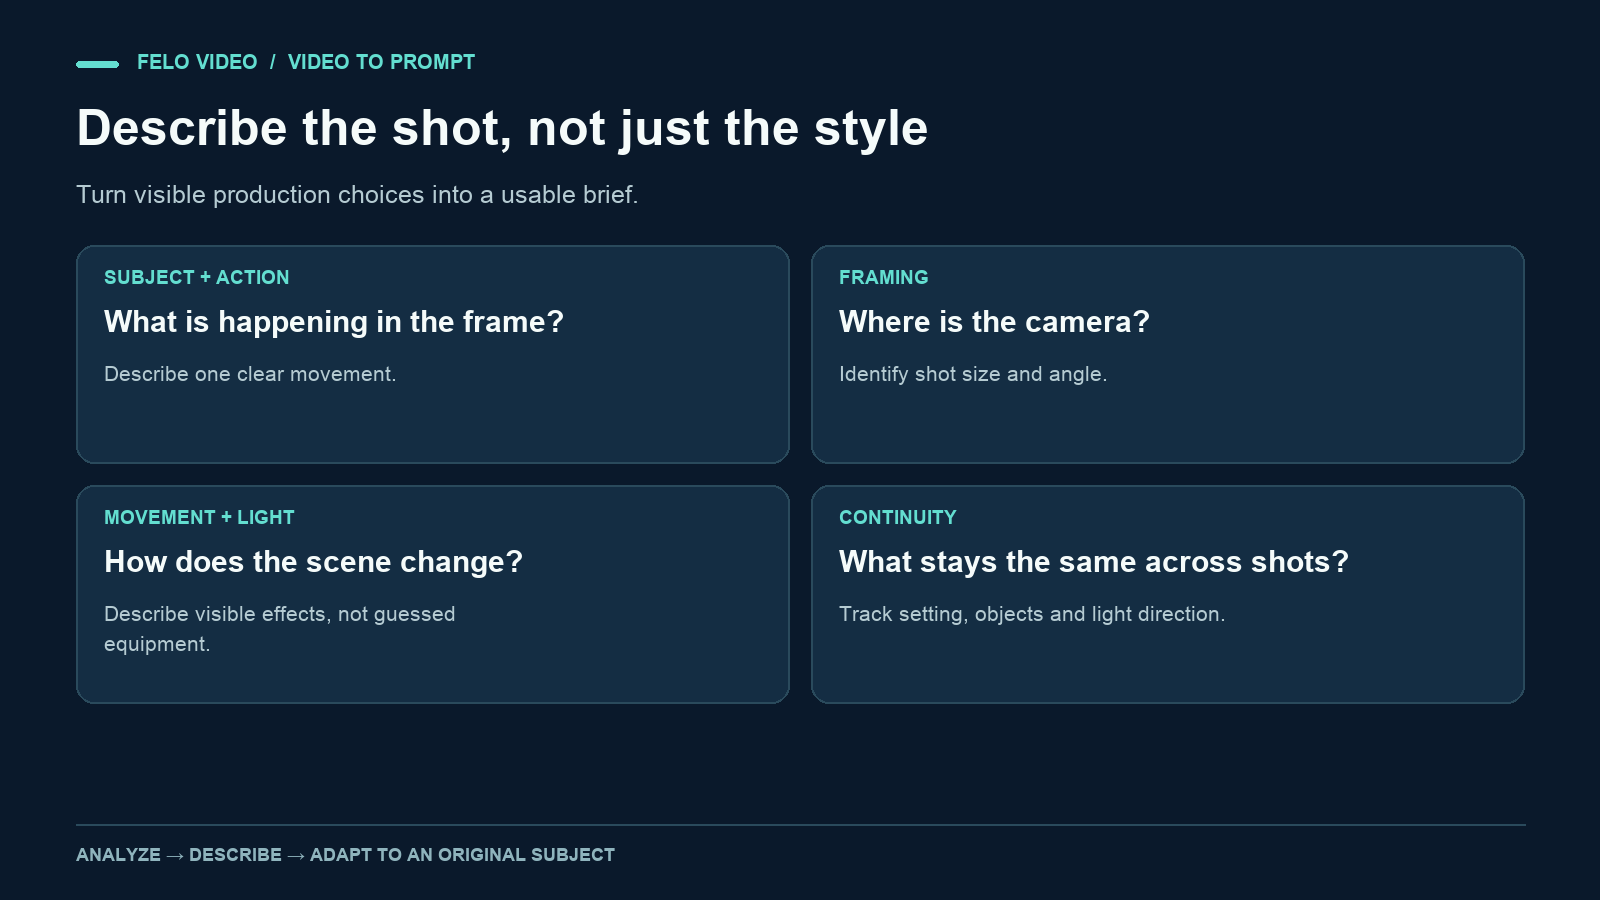
即使你将一段视频描述为具有电影质感,也可能仍然没有说明它究竟是如何呈现的。一个实用的提示词需要包含可见的细节:什么在移动、摄像机位于何处、画面如何变化,以及不同镜头之间如何衔接。
视频转提示词的工作流程始于一段现有视频片段,并将对它的观察转化为可供检查和调整的文本。这有助于你研究视觉结构,也可以帮助你准备新的创意简报。
它无法还原某个隐藏的原始提示词,也不能保证其他模型生成相同的结果。最终输出只是对可见内容的一种解读。你仍然需要判断它是否准确描述了视频,以及调整后的提示词是否符合你自己的项目需求。
视频转提示词究竟能提供什么
你可以将输出理解为一份关于制作选择的文字说明。
单个镜头的提示词可以描述主体、动作、构图、摄像机运动、场景、光线和视觉风格。完整视频的提示词则可以概括整个镜头序列及其节奏。单独的分析还可以解释开场如何吸引观众,或者最后一个镜头如何完成动作的收尾。
即使你不打算复刻参考视频,这些描述仍然很有价值。例如,你可能会注意到,视频一开始展示的是完成后的物品,接着切换到两个制作阶段,最后又回到成品。这样的结构可以启发你制作一部以其他主题为内容的原创教程。
要将观察与推测区分开来。“摄像机缓慢向物体靠近”描述的是可见的运动。“创作者使用了某种特定镜头和生成模型”则可能只是一种猜测,除非你掌握了其他证据。
还要区分视觉描述和文字转录。对话内容和屏幕上的文字可能很重要,但如果提示词只是复制了人物说的话,就无法解释画面的构图和运动方式。
从可用的参考视频开始
选择一段可以访问且适合分析的视频片段。如果用于制作项目,请使用你自己的素材、获得授权的素材,或其他你有权按照预期方式使用的参考内容。
仅仅拥有一个公开视频链接,并不意味着所有再利用方式都没有限制。你可以研究视频的一般结构,但不应因此将原创作者的身份、标志、角色或具有鲜明辨识度的素材视为可以直接复制的内容。
与冗长的合集相比,简短清晰的参考视频更容易检查。寻找明显的场景边界,以及能够概括的视频序列。如果视频每秒都在切换主题,那么第一个有价值的任务可能是先选取其中一个片段,而不是一次性分析全部内容。
记录你选择它的原因。“我想要清晰的揭示过程”比“让这个视频爆红”更适合作为起点。前者描述了一种可以评估的制作特点,后者则要求实现提示词无法保证的受众效果。
将视频片段拆解为可观察的镜头
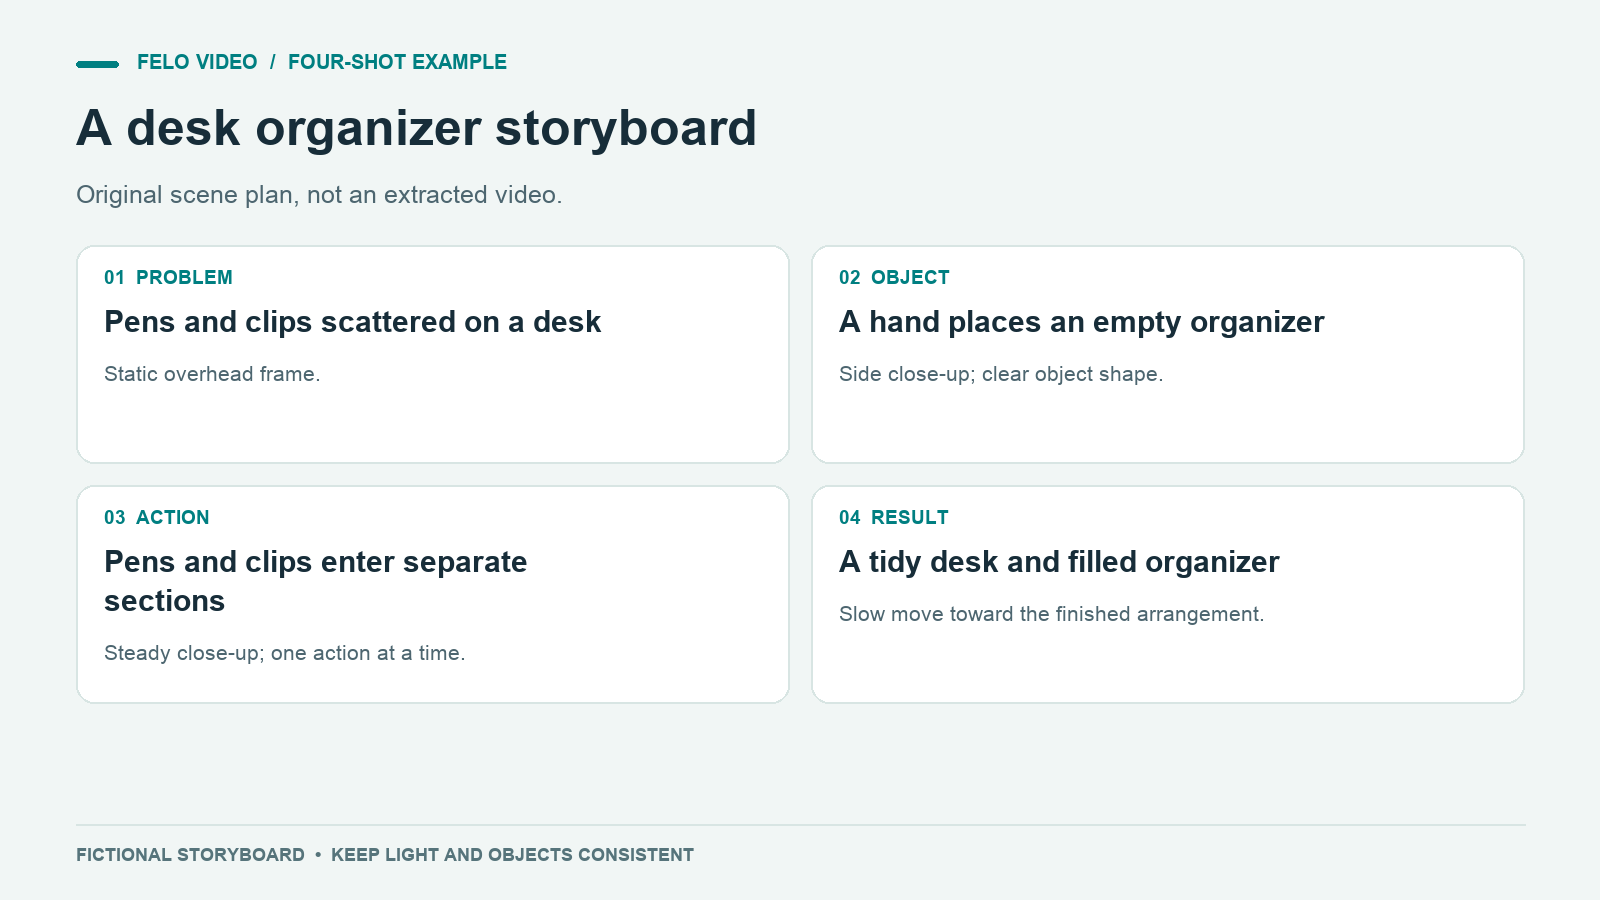
在编写提示词之前,先创建一个镜头表。你可以手动制作,也可以检查工具生成的表格并进行调整。
下面的示例是一份原创分镜脚本,主题是虚构的桌面收纳演示。它并非从任何现有创作者的视频中提取,也不代表任何实际生成结果。
| 镜头 | 可见动作 | 摄像机与构图 | 镜头的作用 |
|---|---|---|---|
| 1 | 钢笔和回形针散落在桌面上 | 固定的俯拍视角 | 展示需要整理的问题 |
| 2 | 一只手将一个空收纳盒放在桌面上 | 侧面中近景 | 引出收纳物品 |
| 3 | 钢笔被放入一个隔层,回形针被放入另一个隔层 | 摄像机保持稳定的特写镜头 | 清晰展示操作过程 |
| 4 | 展示整理完成后的桌面,没有手出现在画面中 | 缓慢向整理好的物品靠近 | 为观众呈现最终效果 |
这组镜头传达了一个简单的逻辑:这里是问题,这里是物品,这里是使用方法,这里是最终结果。你可以将这一逻辑运用到许多不同的原创演示中。
分析真实视频时,不要凭记忆指定精确的时间戳。应直接检查场景边界。提示词可能不需要精确到每一帧的时间,但剪辑计划应以实际观察到的时间为依据,而不是编造看似精确的数据。
为每个镜头编写清晰的提示词
从动作开始,然后补充让动作清晰易懂所需的视觉细节。
对于这个虚构的桌面收纳场景,提示词可以这样写:
镜头 1:展示问题
固定俯拍视角,画面中是一张浅色木质桌面,中央附近散落着少量普通钢笔、回形针和空白便签卡片。柔和的日光从左侧照入。让物品之间保持适当距离,以便清楚辨认。不要出现标志、可读的品牌名称或额外的装饰物品。整个场景应具有实用的桌面演示氛围。
镜头 2:引入物品
从侧面拍摄同一张浅色木质桌面的中近景。一只手将一个简洁、空置的双隔层桌面收纳盒放在画面中央。清楚展示收纳盒的形状和比例。保持与前一个镜头相同的左侧柔和日光,并使用稳定的摄像机。只展示一次明确的放置动作,不添加文字或背景活动。
镜头 3:展示使用方法
桌面上简洁的双隔层收纳盒特写。一只手先将钢笔放入其中一个隔层,再将回形针放入另一个隔层。保持摄像机稳定,使分类整理的动作容易理解。确保桌面材质、收纳盒和来自左侧的日光与前面的镜头保持一致。避免出现额外的隔层、标签或无法解释的物品变化。
镜头 4:展示最终效果
清晰展示整理完成后的桌面:钢笔和回形针分别放在收纳盒的不同隔层中,附近整齐叠放着空白便签卡片。画面中不要出现手。摄像机缓慢、克制地向收纳盒移动,同时确保观众能够看清整个摆放效果。保持相同的物品设计、木质桌面和柔和日光。最后以整理完成的桌面作为画面结尾。
这些提示词传达的是一套原创场景方案。它们并不保证任何特定生成工具都能正确保留每件物品或每个动作。你需要检查模型的输出,并在必要时修改提示词或调整镜头顺序。
在单个提示词之外保持连贯性
每个镜头的提示词单独来看可能都很准确,但组合起来却可能显得不一致。收纳盒可能改变形状,光线可能从另一侧照射,或者桌面可能变成其他颜色。
生成之前,先创建一份简短的连贯性说明:
共享场景:
浅色木质桌面,简洁的双隔层收纳盒,柔和的日光从左侧照入,
中性色背景,不出现品牌标识。

保持一致:
收纳盒的形状和颜色;物品类别;桌面材质;
光线方向;整体视觉风格。

目的:
清晰展示一个简单的整理操作。
如果你使用的视频工具支持参考图像或其他连贯性控制功能,请使用它实际支持的选项。不要认为在不同的独立生成任务中重复相同的文字,就一定能保证物品完全一致。
提示词的细节程度应与镜头相匹配。一个展示手放置钢笔的特写镜头,可能需要精确描述动作和构图。一个结尾的广角镜头,则可能更需要说明物品的摆放方式和摄像机运动。反复添加冗长的风格描述,反而可能掩盖真正重要的动作。
将结构调整为原创主题
假设你的项目主题是整理旅行收纳包,而不是桌面。你可以保留原有镜头的功能,然后替换具体场景细节。
开场展示散落的旅行用品。第二个镜头引出收纳包。第三个镜头展示如何将物品放入不同隔层。最后一个镜头展示整理完成后的效果。
不要只是在每句话中替换一个名词。收纳包与硬质收纳盒的弯曲和打开方式不同。摄像机角度需要能够展示开口。为了让画面清晰易懂,演示中可能还需要减少物品数量。新的主题应决定这些具体选择。
你也可以改变原有结构。如果最终效果本身就很吸引人,可以先展示装满物品的收纳包,再解释它是如何整理的。参考视频只是帮助你做出剪辑决策的起点,而不是必须照搬的规则。
不要仅仅因为某位创作者的可辨识面孔、姓名、标志或独特角色出现在参考视频中,就将它们带入自己的作品。描述你需要的视觉功能,并以此为基础构建属于自己的场景。
使用 Felo 准备镜头级别的初始方案
Felo 视频转提示词 可以分析公开视频链接,并返回镜头级提示词、完整视频提示词以及结构拆解。根据目前公布的功能范围,它支持分析视频开头的 60 秒,最多可处理 24 个镜头。对于更长的参考视频,不应将分析结果视为对整段视频的完整分析。
粘贴受支持的公开视频链接,选择可用的提示词目标,然后将返回的文本与原始视频进行对照检查。只保留能够验证的细节。如果打算将其用于制作计划,请先在工具中确认当前的可用性和使用限制。
接下来最有价值的步骤是编辑。删除缺乏依据的猜测,纠正遗漏的动作,并根据自己的主题调整素材。即使提示词是根据参考视频生成的,你仍然需要由自己决定新视频应该实现什么目标。
在投入时间生成之前检查提示词
假设你从未看过参考视频,请以这种方式阅读提示词。你能否识别主体、动作以及摄像机的作用?整个镜头序列是否有清晰的开头和有意义的最终画面?
留意相互矛盾的指示。“固定摄像机”和“围绕主体旋转”描述的是不同的运动方式。如果工具需要生成多个剪辑镜头,那么“一个不间断的镜头”就与要求多个切换镜头相冲突,除非你希望工具重新诠释原有结构。
删除原始素材无法证实的细节。如果模型在没有证据的情况下指定了镜头类型、摄像机品牌或制作技术,请将这些说法替换为你真正想要的可见效果。
生成完成后,将结果与你自己的创意简报进行比较。即使镜头看起来有所不同,只要能够清晰展示动作,仍然可能具有实用价值。而一个虽然美观却掩盖了关键动作的镜头,则可能需要重新生成。
关于视频转提示词的常见问题
它能还原制作视频时使用的确切提示词吗?
不能。仅凭可见的视频画面,无法唯一确定原始提示词。许多不同的提示词、工具和剪辑选择,都可能生成相似的场景。
提示词能生成完全相同的视频吗?
它可以描述目标效果,但实际输出取决于生成工具、控制选项、素材和制作选择。应将提示词视为创意简报,而不是结果保证。
我应该使用一个提示词,还是多个镜头提示词?
使用完整视频描述来确定整个镜头序列。当你需要控制单个动作和画面构图时,则使用镜头级提示词。合适的制作方法还取决于你用来生成和编辑结果的工具。
这和文章转视频是一回事吗?
不是。文章转视频 是将书面信息转化为讲解视频的过程。而视频转提示词则是将视觉素材及其结构转化为文字描述。两者解决的是不同的起始需求。
选择一段具有研究价值的参考视频,然后利用拆解结果规划属于自己的场景。