AI Agent 記憶技術解析——Context Window、RAG、持久工作區的差異

解析 AI Agent 三種記憶技術的運作原理與適用場景——Context Window、RAG 檢索增強生成、持久工作區,幫你選對方案。
你跟 AI 助手說「記住這個決策」,它說「好的,已記住」。但下次開 session,它什麼都不記得。
這不是它在騙你。它確實在那個 session 裡「記住」了——問題是,那個 session 結束後,記憶就消失了。
要理解為什麼,以及怎麼解決,你需要知道 AI agent 的記憶是怎麼運作的。這篇文章用台灣開發者熟悉的語境,解析三種主流的 AI 記憶技術:Context Window、RAG、持久工作區。
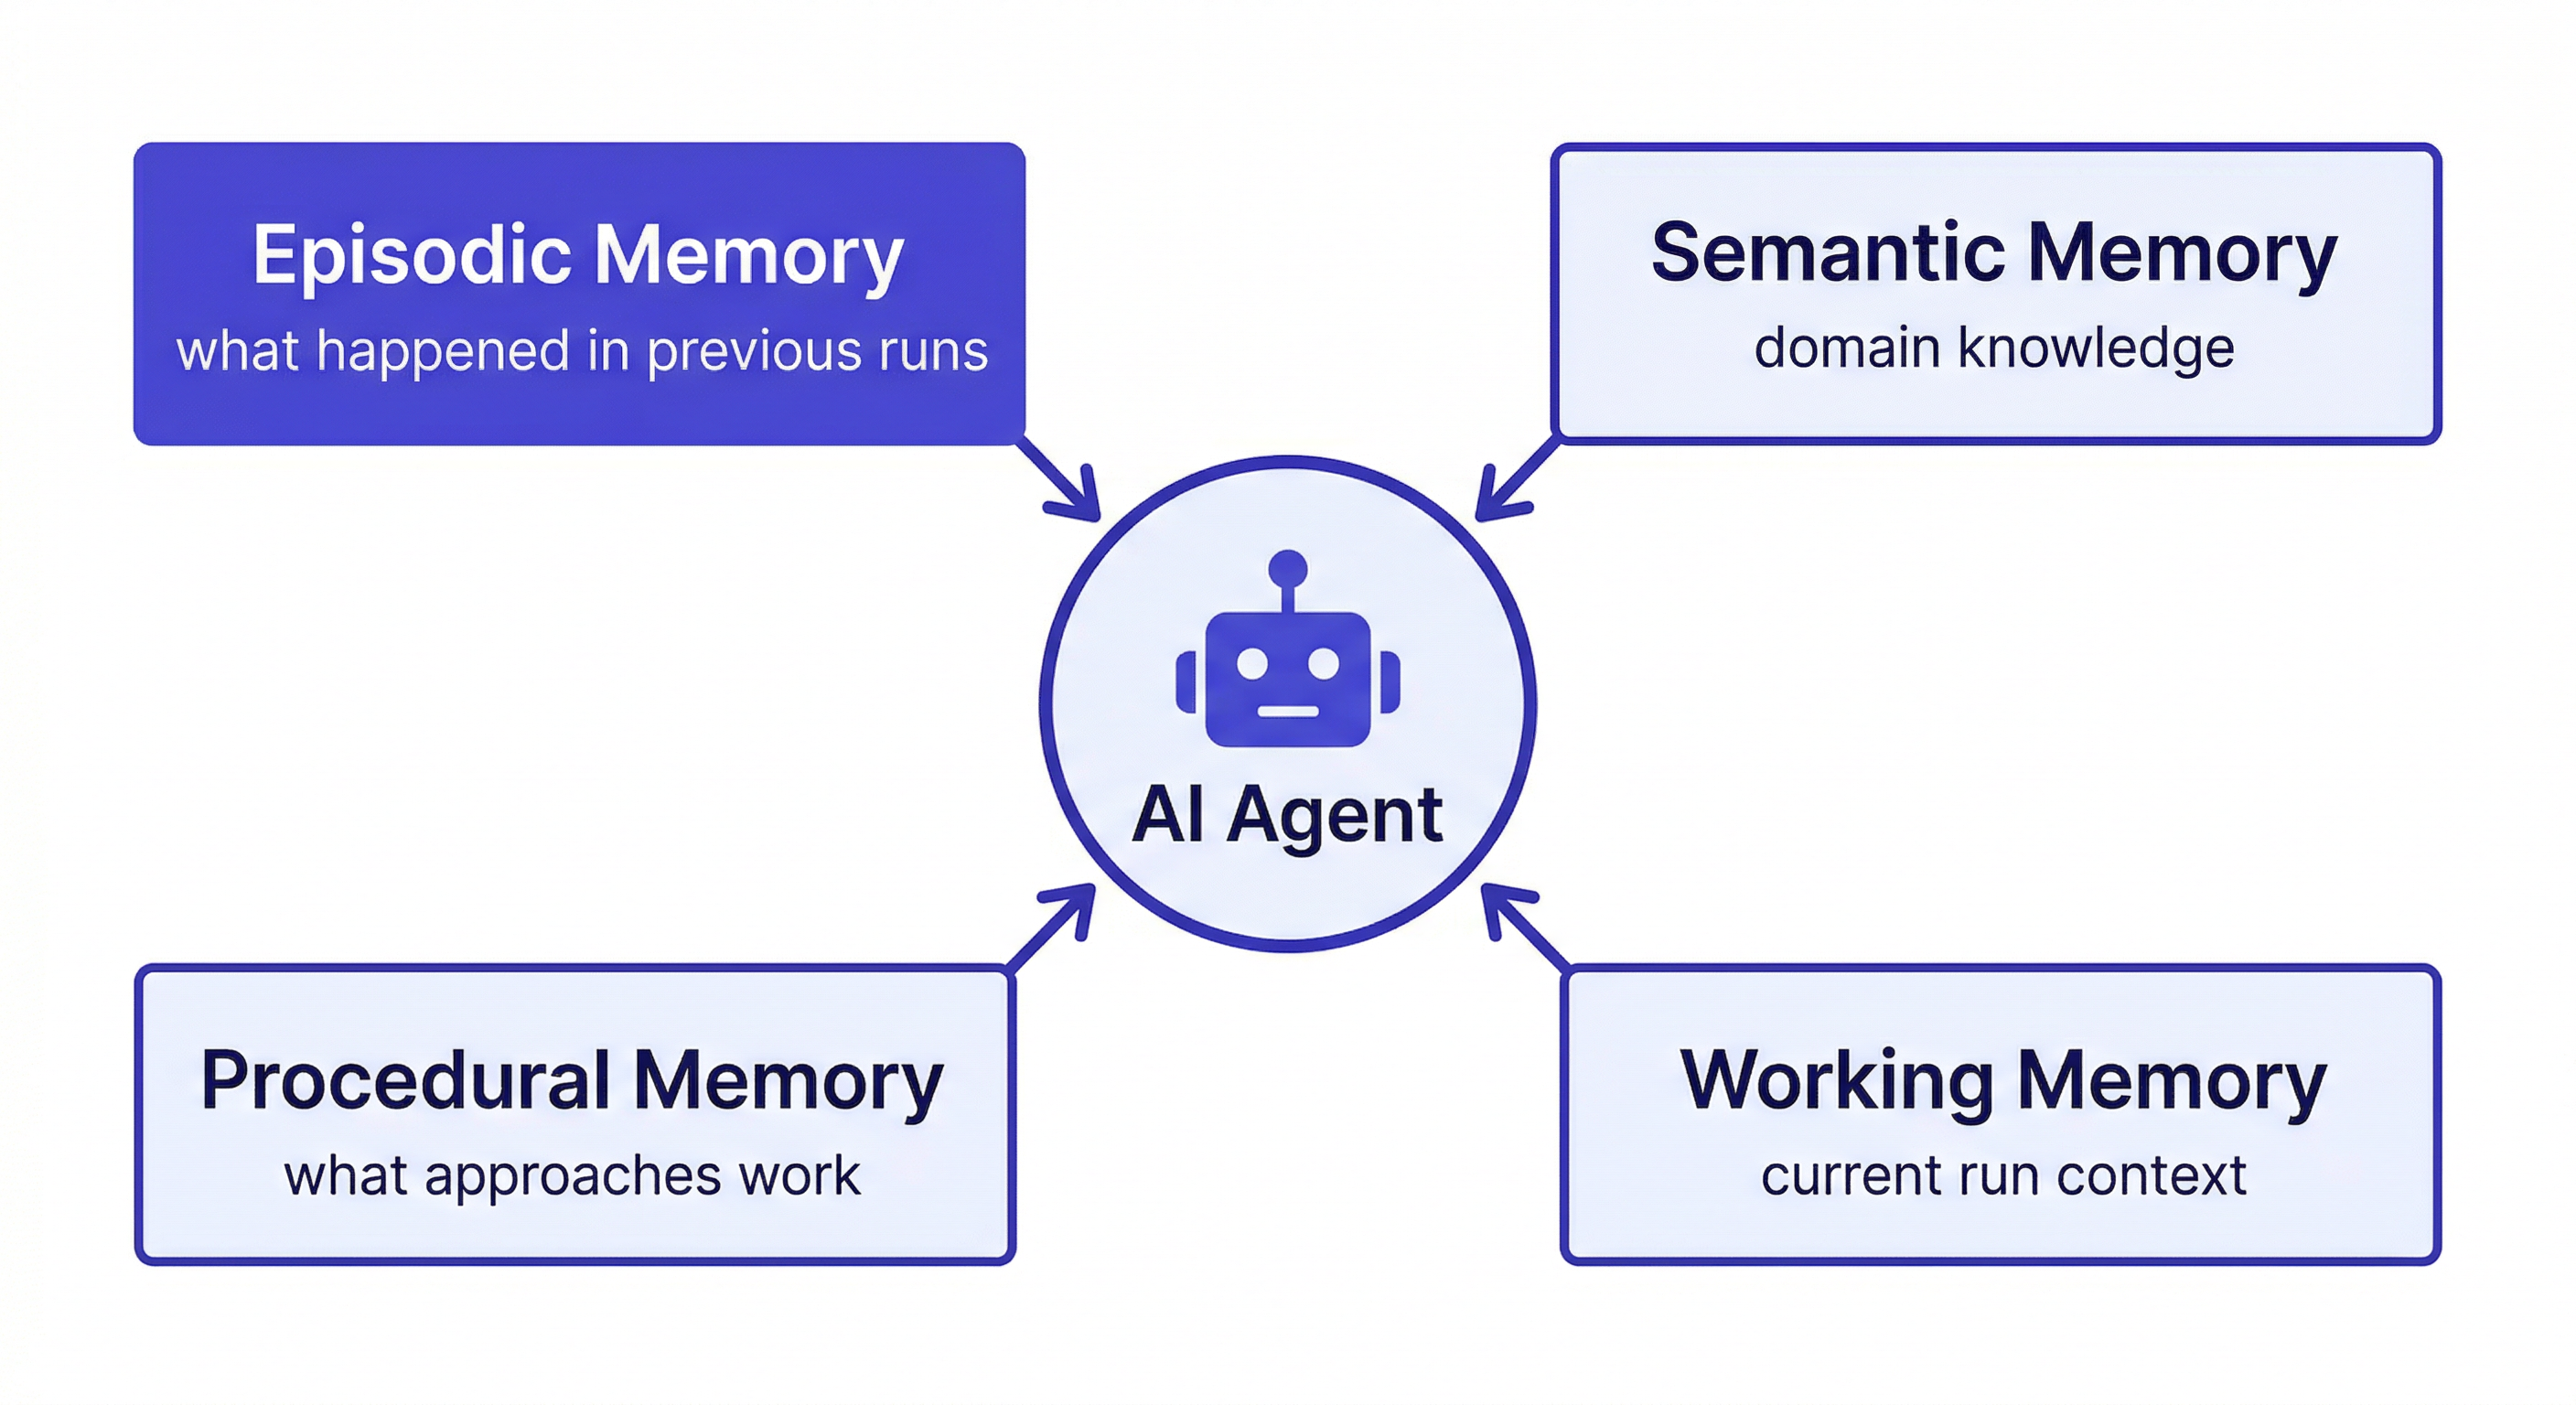
為什麼 AI Agent 會「忘記」?
大型語言模型(LLM)本質上是無狀態的函式。給它一段輸入,它產生一段輸出。沒有內建的記憶機制。
你跟 Claude 的每一次對話,其實是這樣運作的:
輸入 = 系統提示 + 對話歷史 + 你的最新訊息
輸出 = 模型的回應
「對話歷史」就是你在這個 session 裡說過的所有話。模型看起來「記得」前面的對話,其實只是因為整段對話歷史都被塞進了輸入裡。
session 結束,對話歷史消失,模型就「忘記」了一切。
這就是為什麼你需要外部的記憶機制。目前有三種主流方案。
方案一:Context Window——即時記憶
運作原理
Context Window 是模型一次能處理的最大輸入量。你可以把它想像成模型的「工作記憶」——就像人類同時能在腦中保持的資訊量。
Context Window = 系統提示 + CLAUDE.md + 對話歷史 + 工具結果 + 你的訊息
2026 年主流模型的 Context Window 大小:
| 模型 | Context Window |
|---|---|
| Claude Opus/Sonnet | 200K tokens |
| GPT-4o | 128K tokens |
| Gemini 1.5 Pro | 1M tokens |
200K tokens 大約等於 15 萬個中文字,或一本中等厚度的書。聽起來很大,但在實際開發中消耗得很快——讀取幾個檔案、跑幾次工具、來回討論幾輪,token 就用掉大半了。
能力
- 即時可用:不需要任何設定
- 高品質理解:模型直接看到完整脈絡,理解最準確
- 零延遲:不需要額外的檢索步驟
局限
- 有上限:不管 Context Window 多大,總有用完的時候
- 不跨 session:session 結束就消失
- 越長越貴:token 用量直接影響 API 費用
- 越長品質越差:研究顯示,當 Context Window 塞太滿時,模型對中間部分的注意力會下降(「lost in the middle」問題)
適合場景
- 單次任務(一個 session 內完成)
- 短期對話(不超過幾十輪)
- 不需要跨 session 記憶的場景
延伸技巧:/compact
Claude Code 的 /compact 指令可以壓縮對話歷史,保留重點、丟棄細節。這相當於在 Context Window 快滿時「清理工作記憶」,騰出空間繼續工作。
但 /compact 是有損壓縮——壓縮過程中一定會丟失一些資訊。而且它只解決「這個 session 太長」的問題,不解決「跨 session 記憶」的問題。
方案二:RAG——檢索增強生成
運作原理
RAG(Retrieval-Augmented Generation)的核心思路是:不把所有資訊塞進 Context Window,而是在需要時去「查」。
1. 使用者提問
2. 系統根據問題,從知識庫中檢索相關文件
3. 把檢索到的文件片段塞進 Context Window
4. 模型基於這些片段生成回答
知識庫通常是向量資料庫(Vector Database),文件被切成小段、轉成向量(embedding),存進資料庫。檢索時,把問題也轉成向量,找出最相似的文件片段。
能力
- 知識庫可以很大:不受 Context Window 限制,理論上可以存無限量的文件
- 持久化:知識庫存在資料庫裡,不會因為 session 結束而消失
- 可更新:隨時可以往知識庫加新文件
局限
- 檢索品質不穩定:向量相似度不等於語義相關性。你問「上週的架構決策」,RAG 可能檢索到一篇關於「架構」的技術文章,而不是你上週的會議記錄。
- 缺乏結構:RAG 把所有東西當成「文件片段」,沒有「這是決策」「這是進度」「這是待辦」的區分。
- 設定複雜:需要向量資料庫、embedding 模型、檢索管線。對個人開發者來說門檻偏高。
- 碎片化:檢索到的是片段,不是完整的專案脈絡。模型看到的是拼湊的資訊,不是連貫的故事。
適合場景
- 大量文件的問答系統(技術文件、知識庫)
- 客服機器人
- 需要從海量資料中找答案的場景
不太適合的場景
- 專案記憶管理(需要結構化的進度、決策、待辦)
- 多專案隔離(RAG 的知識庫通常是共享的)
- 需要完整脈絡而非片段的場景
方案三:持久工作區——結構化專案記憶
運作原理
持久工作區的思路跟 RAG 不同。它不是「有問題時去查」,而是「每次開始時就載入完整的專案脈絡」。
1. Session 開始
2. 載入工作區(Living README + 最近的 Artifacts + 待辦事項)
3. 工作區內容塞進 Context Window
4. 開始工作
5. 工作過程中,工作區自動更新
6. Session 結束,工作區持久保存
MemClaw 是這個方案的代表。每個專案一個工作區,工作區裡有:
- Living README:結構化的專案摘要,包含背景、偏好、進度、決策。AI 啟動時讀取,8 秒還原脈絡。
- Artifacts:保存的文件、報告、分析結果。需要時查詢。
- Tasks:待辦事項,AI 工作時自動追蹤進度。
能力
- 結構化:不是一堆文件片段,而是有組織的專案記憶(進度、決策、待辦各有歸屬)
- 完全隔離:每個專案一個工作區,脈絡不會交叉
- 自動更新:不用手動維護,工作區隨著你的工作演進
- 跨 agent:OpenClaw 和 Claude Code 共享同一個工作區
- 即時載入:不需要檢索,直接載入完整脈絡
局限
- 工作區大小有限:Living README 不能無限長,需要定期精簡
- 不適合海量文件:如果你需要從 10 萬份文件中找答案,RAG 更適合
- 需要外部服務:工作區資料存在雲端
適合場景
- 多專案並行開發
- 需要跨 session 保留進度和決策
- 接案者管理多個客戶
- 團隊協作開發
免費開始使用持久工作區 → memclaw.me
三種方案的比較
| 維度 | Context Window | RAG | 持久工作區 |
|---|---|---|---|
| 持久性 | 僅限當前 session | 持久 | 持久 |
| 結構化 | 無 | 低(文件片段) | 高(進度/決策/待辦) |
| 檢索品質 | 不需要檢索 | 依賴向量相似度 | 直接載入 |
| 多專案隔離 | 無 | 需要手動分庫 | 內建隔離 |
| 設定複雜度 | 零 | 高 | 低 |
| 適合資料量 | 小(Context Window 內) | 大(海量文件) | 中(專案級別) |
| 自動更新 | 否 | 手動加文件 | 自動 |
實際選擇建議
你只需要 Context Window 如果:
- 任務在一個 session 內完成
- 不需要跨 session 記憶
你需要 RAG 如果:
- 有大量技術文件需要問答
- 在做知識庫或客服系統
你需要持久工作區如果:
- 同時跑多個專案
- 需要 AI 記住進度、決策、待辦
- 需要跨 session 的連續工作體驗
最常見的組合: Context Window(即時記憶)+ CLAUDE.md(靜態規範)+ MemClaw(動態脈絡)。三層各司其職。
技術細節:為什麼持久工作區比 RAG 更適合專案記憶?
這個問題值得深入說明,因為很多人的第一反應是「用 RAG 不就好了」。
問題一:檢索 vs 載入
RAG 的核心是「檢索」——你問一個問題,系統找出最相關的文件片段。但專案記憶不是問答場景。你不是在問「Stripe 的 webhook 怎麼設定」,你是在說「接續昨天的進度繼續做」。
「接續昨天的進度」需要的是完整的專案狀態——做到哪了、還剩什麼、有什麼決策。這不是一個可以用向量相似度檢索的問題。
持久工作區的做法是直接載入 Living README——一份結構化的專案摘要。不需要檢索,因為它就是你需要的全部脈絡。
問題二:片段 vs 完整脈絡
RAG 檢索到的是文件片段。模型看到的是:
[片段 1] 上週決定用 Redis 做快取
[片段 2] Payment endpoint 的測試覆蓋率要求 80%
[片段 3] 客戶要求下週三前完成 MVP
這些片段之間沒有連貫性。模型需要自己拼湊出完整的專案狀態。
持久工作區載入的是結構化的摘要:
## 目前狀態
Payment 功能完成,測試通過。下一步:notification service。

## 關鍵決策
- 快取:Redis(需要 pub/sub)
- 認證:JWT httpOnly cookies

## 待辦
- [ ] Notification service
- [ ] 前端購物車元件
- 截止日:下週三 MVP
模型一次看到完整的、有結構的專案狀態。理解品質完全不同。
問題三:更新機制
RAG 的知識庫更新是手動的——你需要把新文件加進去、重新做 embedding。
持久工作區的更新是自動的——你跟 AI 工作的過程中,工作區就在更新。你不需要額外做任何事。
常見問題
Context Window 越來越大,還需要外部記憶嗎?
需要。即使 Context Window 到了 1M tokens,它依然不跨 session。而且越大的 Context Window 意味著越高的 API 費用和越慢的回應速度。外部記憶的價值不只是「裝更多東西」,而是「持久化」和「結構化」。
RAG 和持久工作區可以同時用嗎?
可以。RAG 處理海量文件檢索(技術文件、歷史記錄),持久工作區處理專案級別的脈絡管理。兩者不衝突。
MemClaw 的工作區底層用了 RAG 嗎?
MemClaw 的 Artifacts 查詢功能使用了語義檢索(類似 RAG),但 Living README 的載入是直接讀取,不經過檢索。兩種機制結合使用。
我是後端工程師,可以自己搭一個持久工作區嗎?
技術上可以——用一個資料庫存專案狀態,寫一個 MCP 伺服器讓 AI 讀寫。但你需要處理結構設計、自動摘要、多專案隔離、跨 agent 相容等問題。MemClaw 已經把這些都做好了,而且免費開始。
總結
AI agent 的記憶不是一個單一問題,而是三個層次:
- Context Window:即時記憶,session 內有效
- RAG:知識庫檢索,適合海量文件問答
- 持久工作區:結構化專案記憶,適合多專案開發
對大多數開發者來說,最實用的組合是:Context Window + CLAUDE.md + 持久工作區。
從這裡開始:
- 了解你目前的記憶瓶頸在哪(跨 session?多專案?進度追蹤?)
- 安裝 MemClaw 建立持久工作區——免費開始
- 讓 CLAUDE.md 管靜態規範,MemClaw 管動態脈絡
延伸閱讀: