判別式 AI:決策模型、範例與應用

了解判別式 AI 與決策模型如何分類、路由及評分輸入資料,認識它們與生成式 AI 的差異,以及開發者可運用這些模型的場景。
收到一則客服請求:「我被重複扣款了,需要退款。」你的應用程式需要的未必是 AI 模型生成的一段文字,而可能是先做出一項決策:這張工單應該交給帳務部門、技術支援團隊,還是業務部門?
判別式 AI(Discriminative AI) 的設計目標,是根據輸入資料預測標籤、分數或其他目標值。新一代決策模型將這個概念帶入開發者 API:提供模型背景資訊與明確的問題,模型便會回傳軟體可使用的結構化決策或機率。本指南將說明這些模型的運作方式、它們與生成式 AI 的搭配場景,以及評估方法。
什麼是判別式 AI?
判別式 AI 會根據輸入資料預測特定結果。垃圾郵件過濾器會判斷電子郵件是否為垃圾郵件;分類器會將客服工單分配給適當的團隊;風險模型則會估算特定結果發生的可能性。
在機器學習領域,判別式模型的常見做法是學習從輸入值 x 到目標值 y 的映射關係,或估算條件機率 P(y | x)。目標值可以是類別、數值或其他結構化輸出。邏輯迴歸、支援向量機,以及許多神經網路分類器,都是判別式方法的例子。並非每個判別式模型都會回傳機率,而數值分數也不一定經過良好的校準。
判別式 AI 的核心概念早於現今的 AI 助理。較新的發展是通用型決策 API 的問世。這類 API 能接受自然語言撰寫的任務描述與答案選項,讓開發者透過相同的介面執行各類分類或評分任務。
什麼是 AI 決策模型?
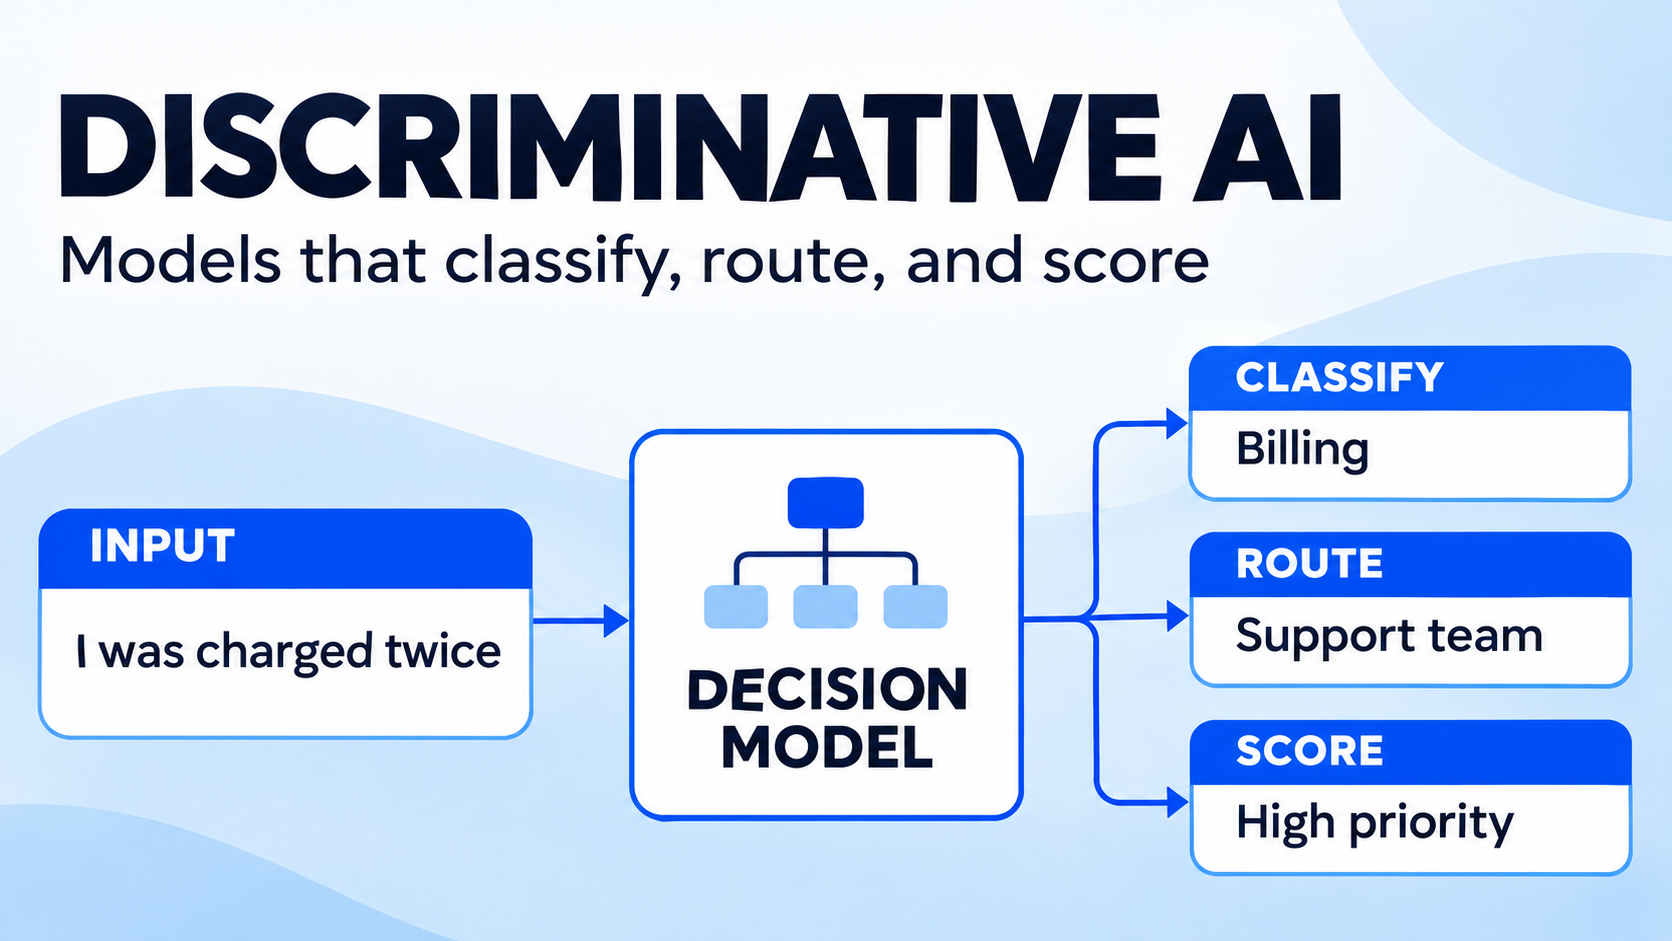
在目前的 API 生態系中,決策模型(Decision Model) 通常是指專門針對指定輸入回答有限範圍問題的模型或服務。它不會撰寫自由形式的回覆,而是回傳具有明確型別的結果,例如:
- 是/否機率: 這則訊息包含退款請求的可能性有多高?
- 選項: 這張工單應該交由哪個部門處理?
- 分數: 這份回答在指定的品質評分標準中落在哪個等級?
例如,決策模型可能會回傳「帳務」標籤,以及各部門對應的機率估計。你的應用程式可以使用這些結果分派工單、要求使用者提供更多資訊,或將工單交由人工審查。
TypeSafe 將其 Jev 系列稱為「System One」模型。Liquid AI 將其 d1 決策模型描述為能接收文字與圖片,並回傳機率,而不生成輸出 Token。Google 關於判別式模型的 Codelab 則展示如何在應用程式中搭配使用決策模型與生成式模型。
這些術語彼此相關,但不能互換。 判別式建模是廣泛的機器學習概念;決策模型則是專為有限範圍決策設計的產品或介面。生成式模型也能透過提示詞分類文字,只是其底層生成流程與回應格式有所不同。
判別式 AI 與生成式 AI 的差異
| 判別式 AI | 生成式 AI | |
|---|---|---|
| 典型問題 | 「這筆輸入資料屬於哪個類別?」 | 「應該產生什麼回覆或內容?」 |
| 常見輸出 | 標籤、預測結果、分數或機率 | 文字、程式碼、圖片、音訊或其他生成內容 |
| 範例任務 | 分派客戶服務工單 | 撰寫客戶回覆 |
| 值得評估的優勢 | 穩定的有限範圍決策與可用分數 | 彈性的內容整合、解釋與創作 |
| 主要評估重點 | 分類錯誤、校準與閾值 | 準確性、指令遵循、安全性與實用性 |
這項區別並不代表每種模型只能執行一種任務。LLM 可以回傳 JSON 標籤,決策系統也能在更大的工作流程中使用生成式模型。實務上的差異在於各個元件的最佳化目標,以及它們對外提供的功能。API 回傳結構化資料,並不能單憑這點證明其機率已經過校準,也不能證明底層模型屬於判別式模型。
以退款工單為例。決策模型可以將問題判定為帳務問題,並估算其緊急程度。接著,生成式模型可以根據相關退款政策,撰寫一封具有同理心的回覆。應用程式在採取行動前,仍應檢查政策、權限,以及必要的人工核准程序。
決策模型在應用程式中的運作方式
各家供應商使用的確切結構不同,但典型的決策請求包含三個部分:
- 狀態(State): 需要評估的資訊,例如工單文字或圖片。
- 問題與判定標準: 要做出的決策,以及允許的答案或分數等級說明。
- 型別化回應(Typed Response): 回傳給應用程式解讀的標籤、分數或機率分布。
例如:
State: "I was charged twice for my subscription."
Question: Which team should handle this request?
Options: billing, technical support, sales
Illustrative result: billing
這是概念示例,並非實際的 API 回應。模型也可能提供信心分數或機率,具體取決於使用的端點。請依照特定模型與 API 的文件操作,不要假設所有供應商採用相同的請求格式,或支援相同的輸入類型。
機率分數代表什麼?
只有在了解預測機率的可靠程度後,這項數值才具有參考價值。如果系統對許多相似的預測都給出 0.8 的機率,經過良好校準的系統在這組案例中的正確率應接近 80%。單一的 0.8 分數並不保證個別決策正確。
請使用自己的資料檢查校準情況,尤其是在更換模型、標籤、語言或輸入來源後。你可以設定閾值,將低信心案例交由人工審查,但閾值應根據誤報與漏報的成本決定。詐欺審查佇列與無害的內容推薦,需要不同的判定規則。
判別式 AI 的範例與應用場景
客服工單分類與分派
決策模型可以將收到的訊息分配給帳務、技術支援或帳戶管理部門。對於模糊的請求,應加入「其他」或「需要審查」的處理路徑,並測試包含多個問題的訊息。
評估時應檢查各類別的錯誤率,而不只是整體準確率。如果資料集以一般問題為主,模型即使漏掉緊急的帳務投訴,整體表現仍可能看起來很好。
內容審核
內容審核工作流程可以詢問模型,內容是否符合指定的政策類別。請提供明確的判定標準與範例,評估邊界案例,並將不確定或影響重大的案例交由受過訓練的審查人員處理。決策分數只是政策審查流程的參考資料,不能作為內容違規的證明。
LLM 與 AI Agent 路由
在呼叫 LLM 之前,應用程式可以依據主題、複雜程度或所需的輸入類型分類請求。路由元件接著可以選擇工作流程,或要求使用者提供更多資訊。
請將路由流程與下游系統一併測試:如果第一個步驟雖然成本低,卻持續將困難的請求導向錯誤的處理路徑,就無法發揮效益。
文件與圖片分類
多模態決策模型可以判斷圖片或文件是否屬於預先定義的類別,例如發票、收據或客服截圖。請確認指定的 API 端點支援所需的輸入格式與圖片處理功能。
文件分類與擷取文件中的所有欄位是不同的任務;請確認選用的模型與 API 是否同時支援這兩項功能。
評分規準
模型可以根據「缺少關鍵證據」、「部分獲得支持」及「獲得完整支持」等描述,將回答歸入有順序的評分等級。
請測試審查人員是否認同這些標籤,以及模型對相似回答的評分是否一致。未經驗證前,請勿將評分規準的分數描述為客觀測量結果。
Felo 模型目錄中的決策模型
Felo 模型目錄 提供 Decisions(決策) 輸出篩選條件。截至 2026 年 11 月 2 日,目錄中的模型範例包括:
| 目錄項目 | 描述的用途 | 目錄列出的輸入類型 |
|---|---|---|
| TypeSafe Jev 1.14 | 路由、分類與內容審核 | 文字與圖片;目錄將圖片支援標示為實驗性功能 |
| LiquidAI d1.1 | 是/否、選項與分數決策 | 文字與圖片 |
| Baseten Joey 1 | 分類與路由 | 文字與圖片 |
| Perplexity Decider Flash V1.2 | 分類、路由與評分 | 文字與圖片 |
這些描述反映的是模型目錄中的資訊,並非獨立效能測試,也不代表推薦其中某個模型。模型供應情況、功能支援、上下文限制與價格都可能變動。開始建置前,請檢查最新的目錄資訊與端點文件,特別是實驗性功能或多模態功能。
模型目錄中的項目本身,並不能證明每家供應商的原生 API 功能都能透過所有平台使用。
如何評估 AI 決策模型
從範圍明確的決策任務開始,準備一組具有代表性且標籤可信的範例。納入困難案例、少數類別、缺少背景資訊的案例,以及需要人工接手的案例。接著,將模型與簡單的基準方法、現有分類器,或使用結構化輸出的 LLM 進行比較。
評估項目不應只有準確率:
- 精確率與召回率(Precision and Recall): 哪些錯誤會造成影響?各類別的錯誤發生頻率為何?
- 校準(Calibration): 在不同案例群組中,預測機率是否符合實際結果?
- 涵蓋率(Coverage): 在指定閾值下,有多少比例的請求能由系統自動處理?
- 延遲與可靠性(Latency and Reliability): 完整的 API 呼叫是否符合正式環境的需求?
- 成本(Cost): 每項有效決策的成本是多少?計算時應納入重試、多個問題、圖片處理及人工審查的費用。
- 穩健性(Robustness): 模型在不同語言、格式、陌生範例及流量變化下,是否維持相同的效能?
調整標籤與閾值後,請使用保留的測試資料集進行評估。在正式環境中,應於適當情況下記錄結果、檢查不一致的判斷,並在模型版本、政策或輸入資料分布變更時重新評估。
對於影響重大的決策,請設計具實質意義的人工監督機制,並確認適用的法規要求。
常見問題
判別式 AI 與決策模型是同一回事嗎?
不完全相同。判別式 AI 描述的是一種廣泛的方法,目的是根據輸入資料預測目標值。決策模型則是較新的產品類別,專注於選項、分數與機率等有限範圍的輸出。
部分決策模型採用判別式技術,但這兩個術語並不代表相同的概念。
LLM 可以進行分類或做出決策嗎?
可以。生成式 LLM 可以透過提示詞分類內容,或回傳結構化輸出。
專用決策模型是否能提供更好的效能、更快的速度或更低的成本,取決於任務、模型、供應商與評估方法。請使用自己的範例測試兩種方案。
決策模型提供的機率一定準確嗎?
不一定。模型在特定資料集或子群組中,可能產生校準不佳的機率。使用閾值自動化工作流程前,請測量校準情況與錯誤造成的影響。
什麼時候應該使用生成式 AI?
如果任務需要撰寫、解釋、整合資訊或產生開放式內容,請使用生成式模型。
許多應用程式可以搭配使用決策模型與生成式模型:前者負責路由或分類,後者負責產生回覆。
判別式 AI 讓開發者能將明確且可衡量的決策整合進工作流程。從一項範圍明確的任務開始,測試重要的錯誤類型,再根據評估結果決定適合的自動化程度。
本文也提供以下語言版本:English、简体中文、日本語、한국어、हिन्दी、Français、العربية、Русский、اردو、Bahasa Indonesia、Deutsch、Tiếng Việt、Türkçe、Italiano、ไทย、Español、বাংলা、Português。